Kurs
Yapay Zekayı Anlamak
2 sa
426.1K
Çoğu YZ kıyaslaması aynı formülü izler: modele bir soru verin, bir yanıt alın, doğru olup olmadığını kontrol edin. Yıllarca bu yaklaşım yeterince iyi işledi. Ancak sınırdaki modeller neredeyse tüm büyük değerlendirmelerde %90’ın üzerine çıkmaya başlayınca tanıdık bir sorun ortaya çıktı. Kıyaslamalar, bir modeli diğerinden ayırt etme yeteneklerini yitirmeye başladı.
ARC-AGI-3 farklı bir yaklaşım benimsiyor. Açık giriş-çıktı eşleşmelerine sahip statik bulmacalar sunmak yerine, YZ ajanlarını talimatsız, belirtilmiş hedefler ve açık kurallar olmadan etkileşimli ortamlara bırakıyor. Ajan, daha önce hiç görmediği bir oyunu eline alan bir insan gibi, deneme ve gözlem yoluyla her şeyi kendi başına çözmek zorunda.
25 Mart 2026’da ARC Prize Foundation tarafından başlatılan ARC-AGI-3, yayımlandığında dikkat çekici bir sonuç üretti: tüm sınırdaki YZ modelleri %1’in altında puan alırken insanlar kıyaslamadaki tüm ortamları çözdü.
ARC-AGI-3, Keras’ın yaratıcısı YZ araştırmacısı François Chollet ve Zapier’in kurucu ortağı Mike Knoop tarafından kurulan ARC Prize Foundation tarafından oluşturulmuş etkileşimli bir akıl yürütme kıyaslamasıdır. Kıyaslama, ARC Prize ekibinin temel bir ilke olarak gördüğü şeye dayanır: gerçek zekâ, bir sistemin ne kadar çok şey bildiğiyle değil, tamamen yeni bir şeyi ne kadar verimli öğrenebildiğiyle ilgilidir.
Önceki YZ değerlendirmeleri kristalize bilgiyi (ezberlenmiş gerçeklerin geri çağrımı, eğitilmiş sezgilerin uygulanması) test ederken, ARC-AGI-3 akışkan zekâyı hedefler; yani eğitim sırasında öğrenilene güvenmek yerine yeni durumlara uyum sağlama ve yeni problemleri akıl yürüterek çözme becerisini. Bu kıyaslama bir YZ ajanının tanıdık olmayan bir ortamı keşfedip kuralları anlamasını, "kazanmanın" neye benzediğini belirlemesini ve ardından bu anlayışa dayanarak verimli biçimde harekete geçmesini ölçer.
Kıyaslama, herkese açık, yarı özel ve tamamen özel setlere dağıtılmış 135 ortam içerir. Her ortam, kurum içi tasarım ekibi tarafından oluşturulan, sıra tabanlı oyun benzeri bir senaryodur. Ajanın elinde hiçbir ipucu yoktur. Sadece dünyanın durumunu gözlemler, bir eylem yapar, ne olduğunu görür ve tekrarlar.
Teknik makale kıyaslamayı dört temel yeteneği sınayan bir araç olarak tanımlar: keşif, modelleme, hedef belirleme ve planlama.
Kıyaslamanın eğitim verisi geri çağrımını değil akıl yürütmeyi ölçtüğünden emin olmak için, ARC-AGI-3 ortamları dil, sayılar, harfler, kültürel semboller veya tanınabilir gerçek dünya nesnelerinden kaçınır. Bunun yerine ARC Prize ekibinin "Core Knowledge önkabulleri" adını verdiği, tüm insanların paylaştığı temel bilişsel yeteneklere dayanır.
Bu önkabuller; nesnellik (şeylerin hareket edebilen veya çarpışabilen kalıcı varlıklar olduğunu anlama), temel geometri ve topoloji (simetri, dönme, "içeride" ile "dışarıda" ayrımı), temel fizik (momentum, yerçekimi, zıplama) ve ajanlık (ortamdaki bir şeyin niyetle hareket ettiğini fark etme) gibi unsurları içerir. Bir ortamın bir anahtarın kilidi açtığını bilmeyi gerektirmesi, akıl yürütmeyi değil eğitim verisini test ederdi.
Statik değerlendirmeden etkileşimli ortamlara geçiş, kıyaslamanın gerçekte neyi ölçebileceğini değiştiriyor.
Her ARC-AGI-3 ortamı, her hücrenin 16 olası renkten birini gösterdiği 64×64’lük bir ızgara sunar. Ajan, JSON nesnesi olarak bir görsel durum ("kare" olarak adlandırılır) alır ve tur başına tek bir eylem gönderir. Eylem uzayı küçüktür: tipik olarak beş yönsel veya tuş tabanlı komut ve belirli ızgara hücrelerini seçmek için isteğe bağlı koordinat tabanlı bir "tıklama" eylemi.
Ortamlar kesinlikle sıra tabanlıdır. Ajan harekete geçmeden hiçbir şey değişmez; bu da kıyaslamanın hızlı refleksler yerine dikkatli akıl yürütmeyi ödüllendirdiği anlamına gelir. Önemli olarak, akıl yürütme adımları, yeniden denemeler veya araç çağrıları gibi dahili işlemler eylem olarak sayılmaz. Yalnızca ortam durumunu gerçekten değiştiren komutlar ajanın puanına dâhil edilir.
Her ortam, zorluk düzeyi artacak şekilde sıralanmış birden çok bölüm içerir. İlk bölüm bir öğretici işlevi görür; temel mekaniği asgari karmaşıklıkla tanıtır. Sonraki bölümler yeni kurallar ve etkileşimler ekler; böylece ajan öğrendiklerini ileriye taşıyıp daha karmaşık durumlarda uygulamak zorunda kalır.
ARC-AGI-3’te zorluk, gizemlilikten veya ölçekten gelmez. Bölümler boyunca öğrenilen birden fazla mekaniğin bileşiminden gelir. Tek mekanikli bir ortam, kaba kuvvetle çözmek için fazla kolay olurdu. Asıl sınav, ajanın daha önce hiç görmediği bir problemi çözmek için birkaç öğrenilmiş dinamiği birleştirmesidir.
Kıyaslama, başsız modda 1.000 FPS performans eşiğini karşılayacak şekilde tasarlanmış özel bir Python tabanlı motor üzerinde çalışır. Geliştiriciler pip install arc-agi ile başlayabilir ve ortamlara SDK veya bir REST API üzerinden etkileşim sağlayabilir. Ayrıca bu oyunların nasıl göründüğünü hissetmek için tarayıcınızda herkese açık ortamları oynayabilirsiniz.
Ön not: Bu puanlar Mart 2026 sonu itibarıyla skor tablosunun durumunu yansıtır ve araştırmacılar yeni yaklaşımlar geliştirdikçe neredeyse kesinlikle değişecektir.
Yayın sırasında, ARC Prize Foundation birkaç sınırdaki modeli yarı özel değerlendirme setinde test etti.
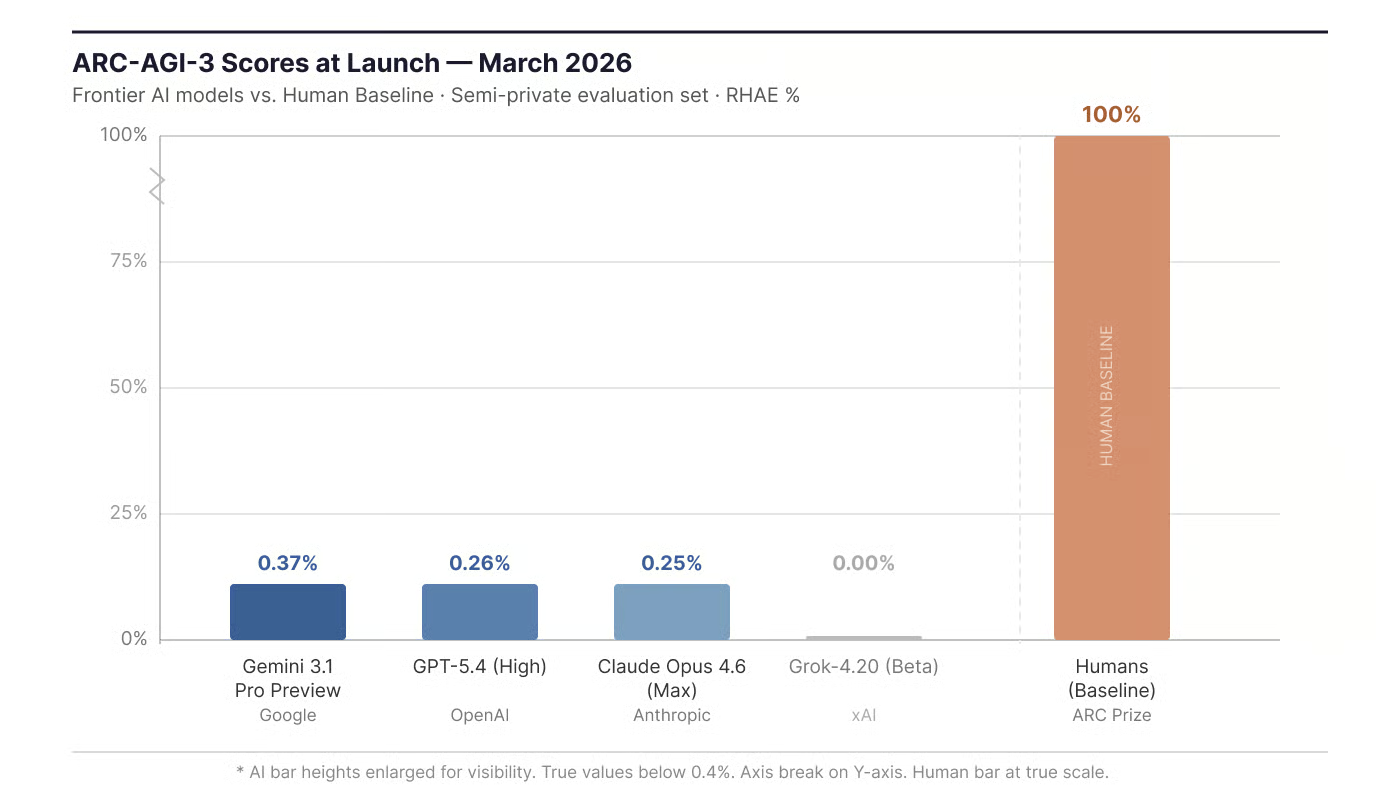
Yayın anındaki puanlar (Mart 2026): sınırdaki YZ ve insan temel çizgisi. Görsel: Yazar.
Bağlam olarak, aynı sınırdaki modeller diğer çoğu YZ kıyaslamasında baskındır. ARC-AGI-1 doygunluğa yaklaşıyor; en iyi modeller artık %90’ın oldukça üzerinde puan alıyor. ARC-AGI-3’te %1’in altına düşüş, burada sınanan yeteneklerin mevcut modellerin iyi yaptığı şeylerden farklı olduğunu düşündürüyor.
Grok-4.20 için %0 puan, modelin hiç eylemde bulunmadığı anlamına gelmez. Modelin her bölümde kıyaslamanın eylem sınırını aştığı anlamına gelir. Bu sınırın nasıl çalıştığını puanlama bölümünde açıklayacağım.
Ön izleme döneminde en yüksek puanı alan ajanlar dil modelleri değildi. Ön izleme yarışmasında (gizli değerlendirme seti olarak 3 herkese açık ve 3 özel ortam kullanıldı), Tufa Labs’in StochasticGoose adlı sistemi pekiştirmeli öğrenme yaklaşımı ve evrişimsel sinir ağlarıyla %12,58’e ulaştı.
Ancak StochasticGoose, yayın sırasında tam resmi kıyaslamada değerlendirildiğinde puanı %0,25’e düştü; bu da sınırdaki LLM’lerle yaklaşık aynı düzeydir. Bu sonuç öğreticidir: Az sayıda bilinen ortamda iyi çalışan bir yaklaşım, görülmemiş ortamların tam yelpazesiyle karşılaşınca çok daha kötü performans gösterdi ve ARC-AGI-3’ün görev-özel optimizasyondan ziyade genel uyarlanabilirliğe ne kadar bağlı olduğunu pekiştirdi.
Bu da etkileşimli biçimin farklı mimarilerle daha iyi çalışabileceğini düşündürüyor; çünkü gerekli bilgi ancak her eylemden sonra ortaya çıktığında bir dil modeli yalnızca akıl yürüterek sorunu çözemez.
En güncel puanları ARC-AGI-3 skor tablosunda kontrol edebilirsiniz.
Önceki ARC kıyaslamalarının neyi test ettiğini bildiğinizde bu sayılar farklı görünüyor. 2019’da Chollet tarafından yayımlanan ARC-AGI-1, soyut görsel bulmacalar üzerinden akışkan zekâyı ölçme fikrini tanıttı. Biçim statikti: model birkaç giriş-çıkış ızgara örneği görür, dönüşüm kuralını çıkarır ve tek bir çıktı üretirdi. Mart 2025’te yayımlanan ARC-AGI-2 aynı statik biçimi kullandı ancak daha zor, daha bileşimsel görevler sundu.
ARC-AGI-1, büyük akıl yürütme modellerinin yeni bir kategori olarak ortaya çıkışını belirlemeye yardımcı oldu; OpenAI’nin o3 modeli ilk net işaretti. ARC-AGI-2, bu akıl yürütme yeteneğinin ne kadar hızlı ölçeklendiğini takip etti. Ancak statik biçimin bir zayıflığı vardı: test zamanı hesaplama ölçeklemesi. Laboratuvarlar çıkarım sırasında binlerce aday çözümü paralel üreterek, ARC-AGI-2 puanlarını bir yıl içinde tek hanelerden %50’nin oldukça üzerine itti.
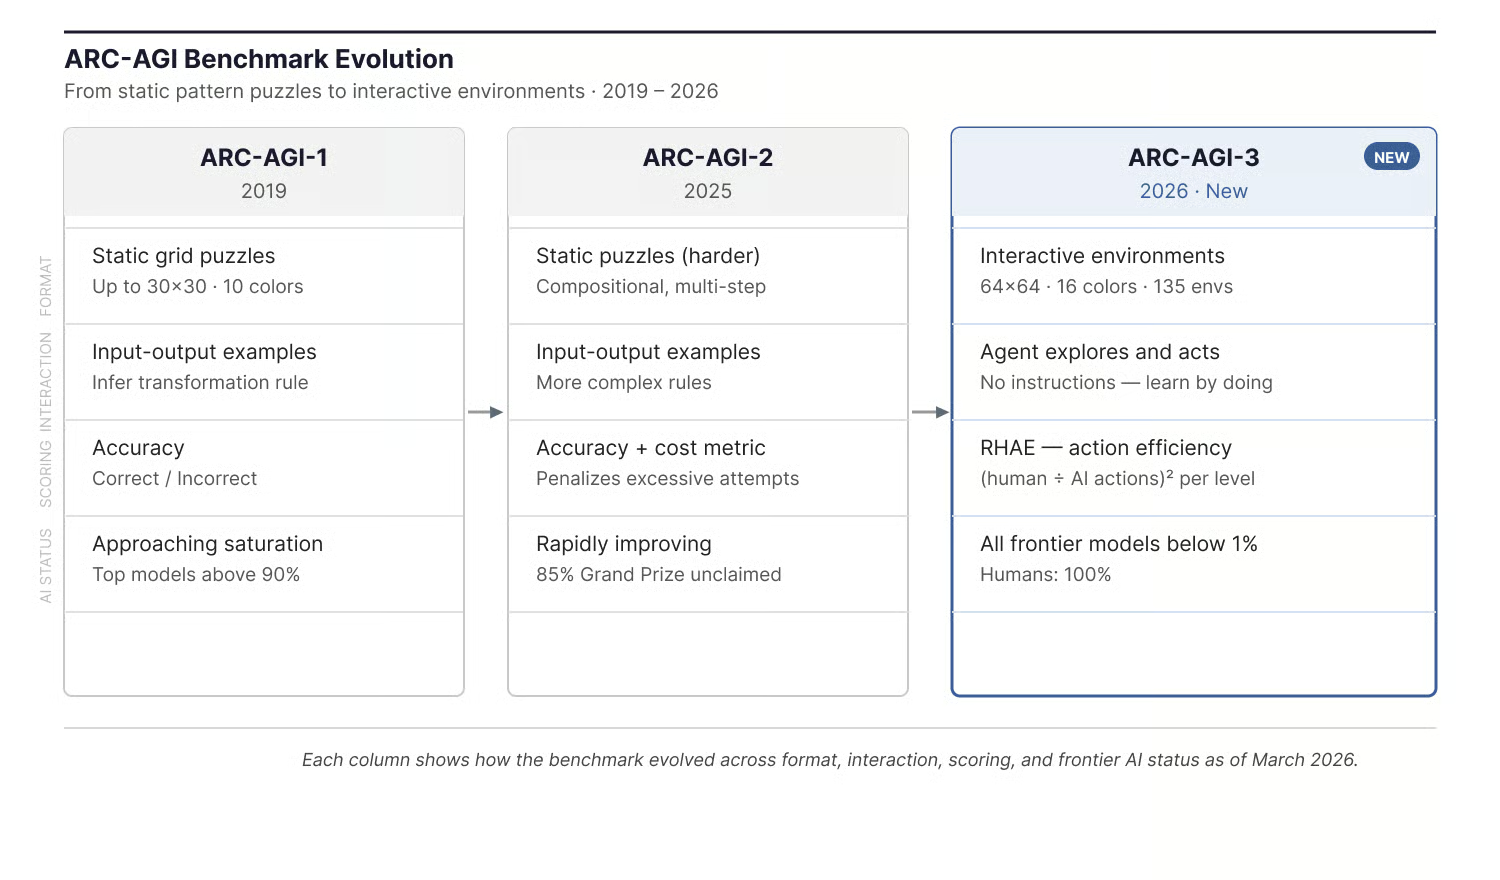
Zaman içindeki ARC-AGI kıyaslaması evrimi. Görsel: Yazar.
ARC-AGI-3, kaba kuvvetle örnekleme stratejisini uygulamayı çok daha zor hâle getiriyor; çünkü daha önce belirttiğim gibi, ortam kurallarını ancak ajan harekete geçtikten sonra ortaya koyuyor. Sorun her eylemle değişirken bir bağlam penceresinde 10.000 aday çözüm üretemezsiniz.
Etkileşimli biçimin ötesinde, ARC-AGI-3, önceki sürümleri etkileyen veri bulaşması ve sentetik üretim kestirmelerine karşı koymayı amaçlayan özel tasarım tercihleri içerir. En dikkat çekici değişiklik, tersine çevrilmiş veri kümesi oranıdır. ARC-AGI-1 ve ARC-AGI-2’de herkese açık görevlerin özel görevlere oranı yaklaşık 10:1 idi ve araştırmacılara kapsamlı eğitim materyali sağlıyordu. ARC-AGI-3 bunu tersine çeviriyor: Yalnızca 25 ortam herkese açık; ezici çoğunluk değerlendirme için kullanılan yarı özel ve tamamen özel setlerde tutuluyor.
ARC Prize ekibi ayrıca bazı sınırdaki modellerin eğitim setlerinde ARC verisi bulunabileceğini düşündüren kanıtları işaret etti. ARC-AGI-2 değerlendirmesi sırasında Gemini 3’ün düşünce zinciri akıl yürütmesi, istenmeden ARC’ye özgü renk eşlemelerine atıf yaptı; bu da eğitim verisi doygunluğunu ima ediyor. Yayın alanını küçülterek ve statik kalıplar olarak ezberlenemeyen etkileşimli ortamlara geçerek, ARC-AGI-3 bu tür kestirme yolları çok daha zor hâle getirmeyi amaçlıyor.
Bu tasarım tercihleri, kıyaslamanın gerçekte neyi test etmeye çalıştığını anladığınızda daha anlamlı hâle gelir. Kıyaslama, ARC Prize ekibinin "beceri edinim verimliliği" olarak tanımladığı şeyi hedefler: bir YZ ajanının daha önce hiç karşılaşmadığı bir şeyi ne kadar verimli öğrenebildiği.
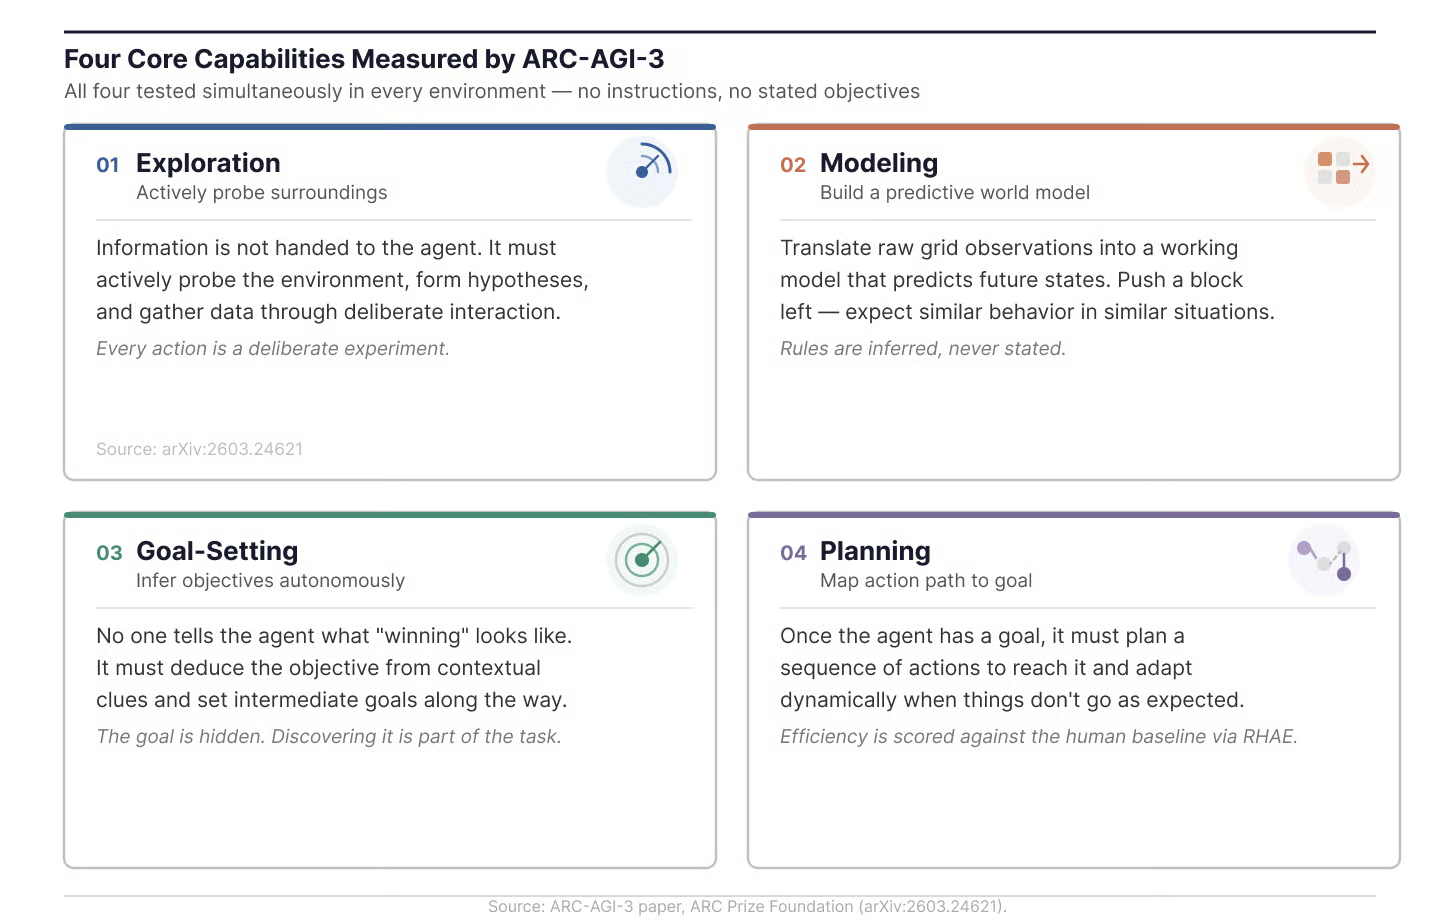
ARC-AGI-3 tarafından ölçülen dört temel yetenek. Görsel: Yazar.
Bu dört alan, hiçbir noktada talimat veya belirtilmiş hedef olmadan her ortamda eşzamanlı olarak sınanır.
ARC-AGI-3’te %100 puan, bir YZ ajanının her ortamı ikinci en iyi insan test edeni kadar verimli çözebildiği anlamına gelir. ARC Prize ekibi bunun AGI’ye eşit olmayacağını açıkça belirtiyor. Bu, YZ ile insan öğrenimi arasındaki belirli bir farkın kapandığı anlamına gelir.
Puanlama, ARC-AGI-3’ün önceki kıyaslamalardan en çok ayrıldığı noktadır. Yalnızca ajanın sonunda tesadüfen çözüme ulaşıp ulaşmadığını kontrol etmez. Ajanın oraya ne kadar verimli vardığını ölçer.
Metrik RHAE olarak adlandırılır; İnsanlara Göre Bağıl Eylem Verimliliği (Relative Human Action Efficiency). Bölüm başına formül şöyledir:
Bölüm Puanı = min(1.0, (human_baseline_actions / AI_actions))²
Kilit ayrıntı, kare terimidir. Bu doğrusal bir ilişki değildir. Eylem sayısını ikiye katlamak puanı yarıya indirmez; dörtte bire düşürür. Eylem sayısını onla çarpmak puanı neredeyse sıfıra indirir. Bu üs yasası tasarımı, kaba kuvvet yaklaşımlarını ağır şekilde cezalandırır ve ortamın nasıl çalıştığını gerçekten öğrenen ajanları ödüllendirir.
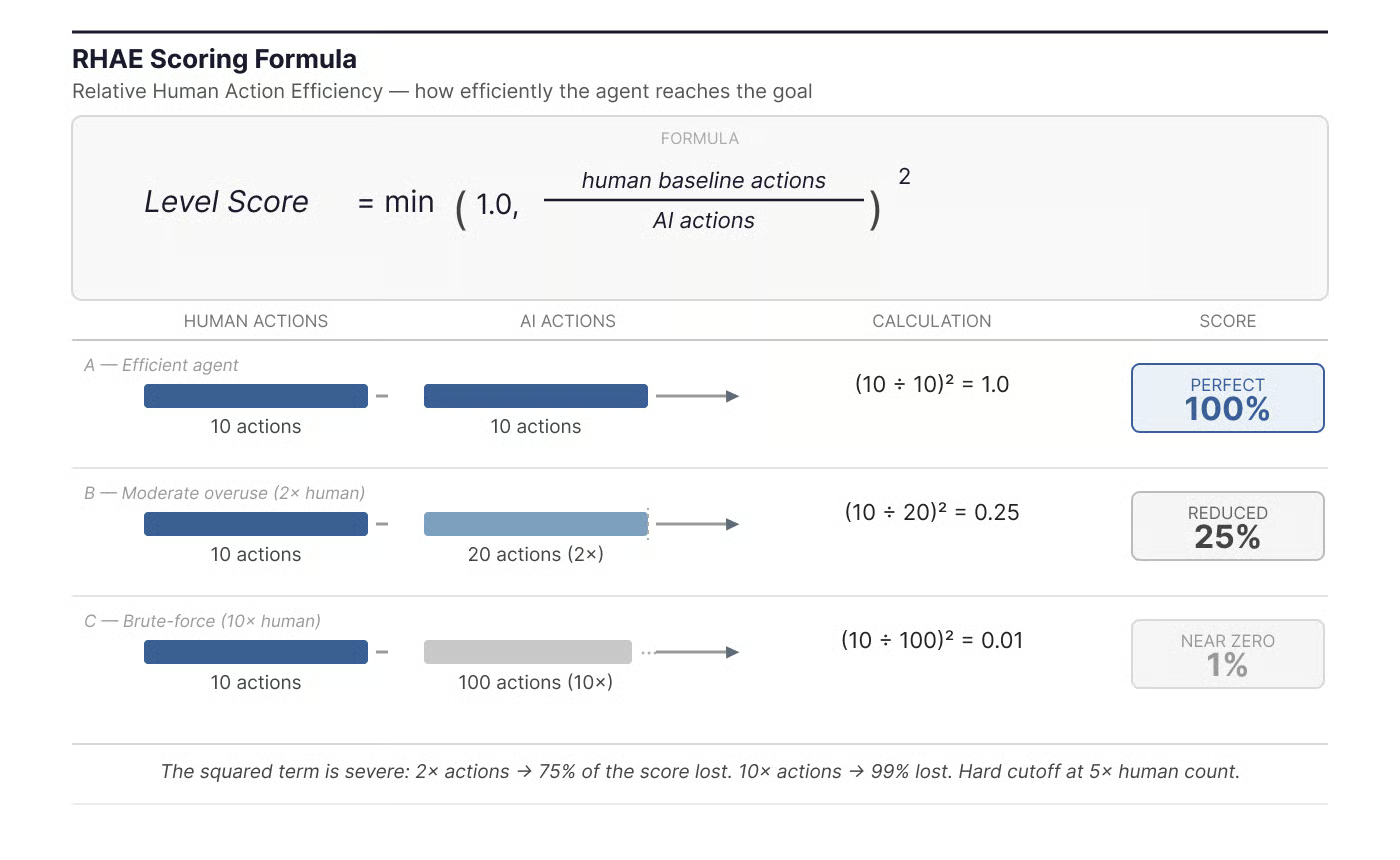
RHAE puanlama formülü ve örnek hesaplamalar. Görsel: Yazar.
İnsan temel çizgisi, her ortamı ilk maruz kalmada deneyen 10 test edenden ikinci en iyi performans gösterenin değeriyle belirlenir. En iyisi yerine ikinci en iyinin kullanılması, şanslı aykırı değerleri filtrelerken gerçek oynanışa dayanmayı sürdürür.
Ayrıca sert bir kesme noktası vardır: bir ajan herhangi bir bölümde insan eylem sayısının 5 katından fazla eylem yaparsa kesilir ve o bölüm için sıfır puan alır. Ve puanlar 1.0 ile sınırlandırılır; bu nedenle insan temel çizgisini aşan beklenmedik bir kestirme yol bulunması ekstra puan vermez.
Her ortam içinde, sonraki bölümler daha çok önem taşır. Puanlama, 1. Bölümün ağırlığının 1, 2. Bölümün ağırlığının 2 olduğu vb. bir ağırlıklı ortalama kullanır. Bu da öğretici bölümlerin puanı zar zor etkilediği, birden çok öğrenilmiş mekaniğin birleştirilmesini gerektiren daha zor bölümlerin ise en büyük ağırlığı taşıdığı anlamına gelir.
ARC-AGI-3, farklı kurallara sahip iki ayrı skor tablosu tutar. Resmî skor tablosu, ARC-AGI-3 için özel olarak hazırlanmış olmayan genel amaçlı API sistemleri kullanan sınırdaki modelleri değerlendirir. Topluluk skor tablosu, kendi bildirilen sonuçlara izin verir ve kılıflara (harness) müsaade eder. Bu ayrım önemlidir; çünkü daha önce belirttiğim gibi, el yapımı kılıflar bilinen ortamlarda puanları dramatik biçimde şişirebilirken görülmemiş ortamlarda tamamen başarısız olabilir. Resmî skor tablosu, geliştiricinin iskelesini değil, YZ’nin gerçek uyarlanabilirliğini ölçmek için tasarlanmıştır.
ARC-AGI-3 bu yılın yarışmasının odak noktasıdır, ancak tek kulvar değildir.
ARC Prize 2026, üç kulvara dağıtılmış 2 milyon doların üzerinde toplam ödül havuzuna sahiptir. ARC-AGI-3 kulvarı, toplam 850.000 dolar ödül sunar; bunun başını, tam özel değerlendirme setinde %100’e ulaşan ilk uygun ajan için 700.000 dolarlık Büyük Ödül çeker. Bu yıl kimse kazanamazsa, fonlar 2027’ye devredilir. Büyük Ödülün ötesinde, ilk beş bitirici arasında paylaştırılan 75.000 dolarlık en yüksek puan ödülü ve her biri o tarihteki ilk üç ekip arasında 37.500 dolar dağıtan iki kilometre taşı kontrol noktası (30 Haziran ve 30 Eylül 2026) vardır.
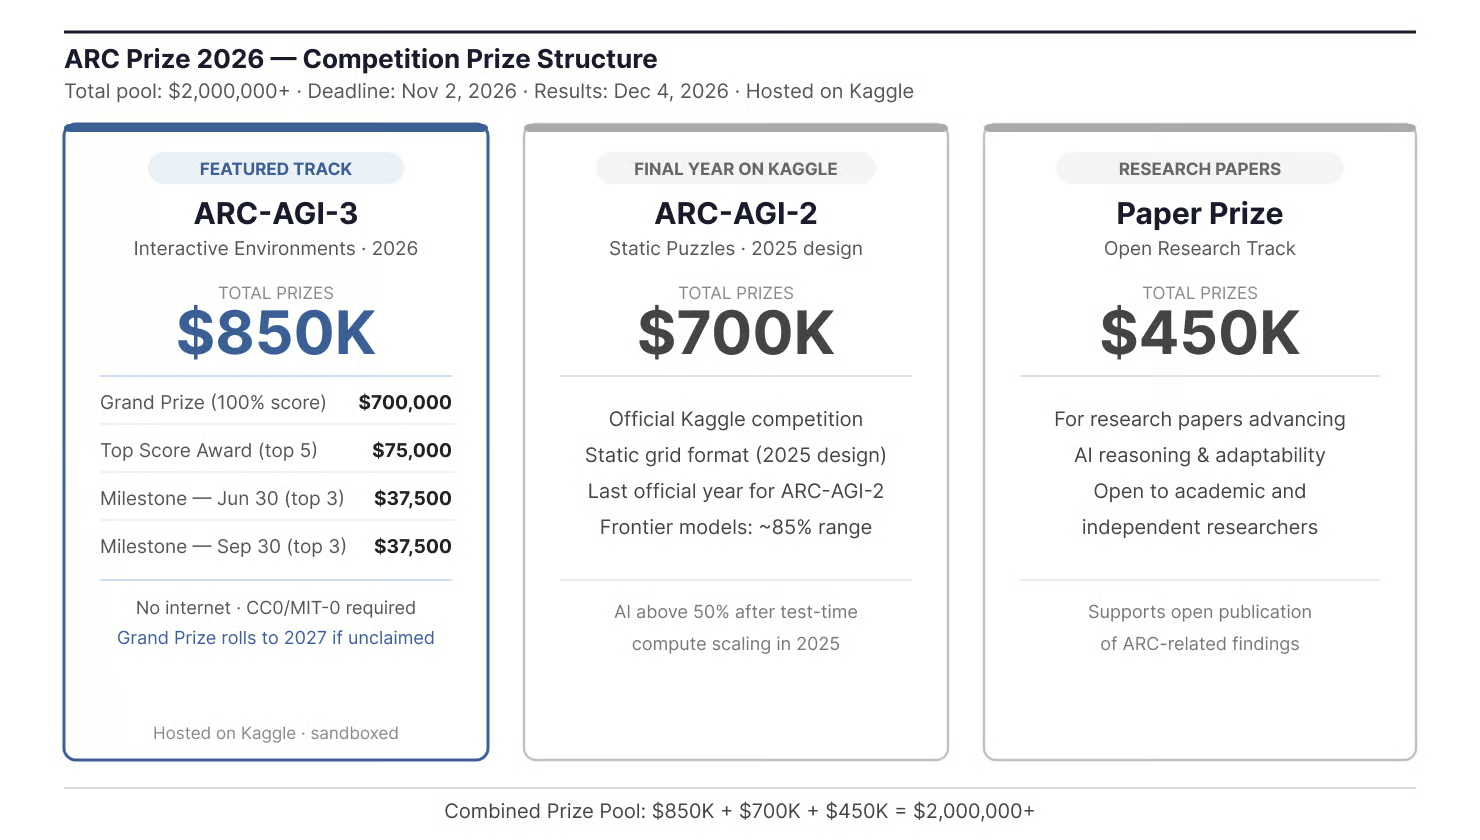
ARC Prize 2026 yarışması ödül yapısı. Görsel: Yazar.
Diğer iki kulvar, bir ARC-AGI-2 kulvarı (700.000 dolar ve dikkat çekici olarak ARC-AGI-2’nin resmî bir Kaggle yarışmasında kullanılacağı son yıl) ve bir Makale Ödülü kulvarıdır (araştırma makaleleri için 450.000 dolar).
Yarışma Kaggle üzerinde yürütülür; ancak tipik bir Kaggle yarışmasından ayrışan kurallarla. Gönderimler internet erişimi olmayan korumalı bir ortamda değerlendirilir; bu da GPT, Claude veya Gemini gibi barındırılan modellere API çağrılarını dışlar. Ödüle uygun tüm çözümler, özel değerlendirme puanlarını almadan önce hoşgörülü veya kamu malı lisans (CC0 veya MIT-0) altında yayımlanmalıdır. Yarışma 25 Mart 2026’da açıldı; son gönderim tarihi 2 Kasım 2026 ve sonuçlar 4 Aralık 2026’da açıklanacak.
Kıyaslamalar, en çok, daha önce fark edilmeyen bir boşluğu ortaya çıkardıklarında önem kazanır. Bu ölçüte göre, ilk iki ARC kıyaslaması yerini hak etti: ARC-AGI-1 büyük akıl yürütme modellerinin ortaya çıkışını görünür kıldı ve ARC-AGI-2 test zamanı hesaplama ölçeklemesinin ne kadar ileri gidebileceğini takip etti. ARC-AGI-3 farklı bir sorunu işaret ediyor.
Bu kıyaslamayı şu anda ilgili kılan şey bağlamdır. 2026 başı itibarıyla, yaygın kullanılan birçok YZ kıyaslaması doygunluğa yaklaşıyor. Sınırdaki modeller, MMLU, HumanEval ve GSM8K gibi pek çoğunda %90’ın üzerinde puan alıyor; bu da bu değerlendirmelerin sistemler arasındaki farklar hakkında bize anlatabileceklerini sınırlıyor. ARC-AGI-3, mevcut modellerin eksik olduğu görünen bir yeteneği test ediyor: tanıdık olmayan ortamlarda anlık öğrenme. %1’in altındaki YZ puanları ile %100 insan çözülebilirliği arasındaki fark, bunun aynı testin daha zor bir versiyonu değil, farklı bir tür meydan okuma olduğunu düşündürecek kadar büyük.
ARC Prize, ARC-AGI-3’ü etkileşimli akıl yürütmenin en önemli testi olarak konumlandırıyor; ancak bu çerçevenin kıyaslamayı yürüten organizasyondan geldiğini unutmamak gerekir. Bunun kalıcılığı, araştırmacıların bu kıyaslamaya uyum sağladıkça nasıl sonuçlar verdiğine bağlı olacak.
Hiçbir kıyaslama mükemmel değildir ve ARC-AGI-3’e değinmeye değer bazı eleştiriler yöneltildi.
Yaygın endişelerden biri puanlama formülünün kendisidir. Kareli verimlilik metriği, belki de başarısızlık değil zekânın bir işareti olan keşfi ağır şekilde cezalandırır. Bir ajan çözüme ulaşmadan önce sınır koşullarını dikkatle haritalamak için 50 eylem harcarsa, kuralı 5 eylemde tahmin eden bir insana kıyasla çok daha kötü puan alır. Bazı topluluk üyeleri bunun performans farkını yapay olarak büyük gösterdiğini savundu.
Ayrıca temel çizgi seçimi sorusu da var. Puanlama bölümünde ele aldığım gibi, kıyaslama ortalama yerine ikinci en iyi insan test edeni kullanır; bu da çıtayı yüksek belirler. Bu yaklaşımla tipik insanlar bile %100’ün altında puan alacaktır.
ARC Prize ekibi kıyaslamayı, genel zekânın kesin bir testi değil, eksik olduğu düşünülen belirli bir yeteneği ölçmeye yönelik bilimsel bir girişim olarak sunuyor. Bugün bildiklerimiz göz önüne alındığında bu değerlendirme makuldür.
ARC-AGI-3, YZ sistemlerini değerlendirmeye farklı bir yaklaşım getiriyor. Statik bulmacalardan etkileşimli ortamlara geçerek, modellerin talimatlar yerine deneyim yoluyla keşfedip kendi hedeflerini belirleyip işleri çözüp çözemediklerini test ediyor.
Erken gelen sayılar çarpıcı. Kodlama kıyaslamalarında, matematik yarışmalarında ve bilgi testlerinde üstünlük kuran modeller burada %1’i aşmakta zorlanıyor. Bu farkın, önceki ARC kıyaslamalarında olduğu gibi hızla kapanıp kapanmayacağı ya da etkileşimli biçimin çözülmesinin daha zor çıkıp çıkmayacağı, yakından izlemeye değer.
Uyarlanabilir YZ sistemlerinin arkasındaki kavramlar hakkında daha fazlası için AI Fundamentals beceri yolumuzu veya Ölçeklenebilir Ajanik Sistemler Kurma kursumuzu inceleyin.
DataCamp ile Öğrenin
Kurs
Kurs
Kurs
blog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Adel Nehme
Eğitim
Kurtis Pykes
8 dk.