Curso
Entendendo a inteligência artificial
2 h
426.1K
A maioria dos benchmarks de IA segue a mesma fórmula: faça uma pergunta ao modelo, receba uma resposta e verifique se está certa. Por anos, isso funcionou bem. Mas, à medida que modelos de ponta passaram a marcar acima de 90% em praticamente todas as grandes avaliações, surgiu um problema conhecido: os benchmarks começaram a perder a capacidade de diferenciar um modelo do outro.
ARC-AGI-3 segue outro caminho. Em vez de apresentar quebra-cabeças estáticos com pares claros de entrada e saída, ele coloca agentes de IA em ambientes interativos sem instruções, sem objetivos declarados e sem regras explícitas. O agente precisa descobrir tudo sozinho, por tentativa e observação — como uma pessoa faria ao receber um jogo que nunca viu antes.
Lançado em 25 de março de 2026, pela ARC Prize Foundation, o ARC-AGI-3 trouxe um resultado marcante: todos os modelos de IA de fronteira ficaram abaixo de 1%, enquanto humanos resolveram todos os ambientes do benchmark.
ARC-AGI-3 é um benchmark de raciocínio interativo criado pela ARC Prize Foundation, cofundada pelo pesquisador de IA François Chollet (criador do Keras) e por Mike Knoop (cofundador da Zapier). O benchmark parte de um princípio central, segundo a equipe do ARC Prize: inteligência de verdade não é sobre quanto um sistema sabe, e sim sobre quão eficientemente ele consegue aprender algo totalmente novo.
Enquanto avaliações anteriores de IA testam conhecimento cristalizado (recuperar fatos memorizados, aplicar heurísticas treinadas), o ARC-AGI-3 mira a inteligência fluida — a capacidade de raciocinar sobre problemas inéditos e se adaptar a novas situações, em vez de depender do que foi aprendido no treinamento. Ele mede se um agente de IA consegue explorar um ambiente desconhecido, descobrir as regras, identificar o que significa “vencer” e, então, agir com eficiência a partir desse entendimento.
O benchmark inclui 135 ambientes distribuídos entre conjuntos públicos, semiprivados e totalmente privados. Cada ambiente é um cenário por turnos, com dinâmica de jogo, criado por uma equipe interna de design. O agente não recebe nenhuma pista. Ele simplesmente observa o estado do mundo, realiza uma ação, vê o que acontece e repete.
O artigo técnico descreve o benchmark como um teste de quatro capacidades centrais: exploração, modelagem, definição de objetivos e planejamento.
Para garantir que o benchmark mede raciocínio e não mera lembrança de treinamento, os ambientes do ARC-AGI-3 evitam linguagem, números, letras, símbolos culturais ou objetos reais reconhecíveis. Em vez disso, baseiam-se apenas no que a equipe do ARC Prize chama de "Core Knowledge priors" — habilidades cognitivas básicas compartilhadas por todos os humanos.
Esses conhecimentos incluem “objetualidade” (entender que coisas são entidades persistentes que podem se mover ou colidir), geometria e topologia básicas (simetria, rotação, "dentro" versus "fora"), física básica (momento, gravidade, quique) e “agentividade” (reconhecer quando algo no ambiente age com intenção). Se um ambiente exigisse saber que uma chave abre uma fechadura, estaria testando dados de treinamento, não raciocínio.
A mudança de avaliações estáticas para ambientes interativos altera o que o benchmark consegue medir de fato.
Cada ambiente do ARC-AGI-3 apresenta uma grade de 64×64 em que cada célula exibe uma de 16 cores possíveis. O agente recebe um estado visual (um “frame”) como objeto JSON e envia uma única ação por turno. O espaço de ações é pequeno: normalmente cinco comandos direcionais ou baseados em teclas, mais uma ação opcional de “clique” por coordenadas para selecionar células específicas da grade.
Os ambientes são estritamente baseados em turnos. Nada muda até o agente agir, o que significa que o benchmark privilegia raciocínio cuidadoso em vez de reflexos rápidos. Importante: operações internas como passos de raciocínio, tentativas adicionais ou chamadas a ferramentas não contam como ações. Só contam os comandos que realmente mudam o estado do ambiente — e são eles que entram na pontuação do agente.
Cada ambiente contém vários níveis em ordem de dificuldade crescente. O primeiro nível funciona como um tutorial, apresentando mecânicas básicas com mínima complexidade. Nos níveis seguintes, novas regras e interações são adicionadas, então o agente precisa levar adiante o que aprendeu e aplicar em situações mais complexas.
A dificuldade no ARC-AGI-3 não vem de obscuridade ou escala. Ela nasce da composição de múltiplas mecânicas aprendidas ao longo dos níveis. Um ambiente com uma única mecânica seria fácil de resolver por força bruta. O verdadeiro teste é combinar várias dinâmicas aprendidas para solucionar um problema que o agente nunca viu antes.
O benchmark roda em um engine customizado, baseado em Python, projetado para atingir 1.000 FPS em modo headless. Desenvolvedores podem começar com pip install arc-agi e interagir com os ambientes via SDK ou API REST. Você também pode jogar os ambientes públicos no navegador para sentir como esses jogos funcionam.
Um aviso importante: estas pontuações refletem o estado do ranking no fim de março de 2026 e quase certamente mudarão conforme pesquisadores desenvolvem novas abordagens.
No lançamento, a ARC Prize Foundation testou vários modelos de ponta no conjunto de avaliação semiprivado.
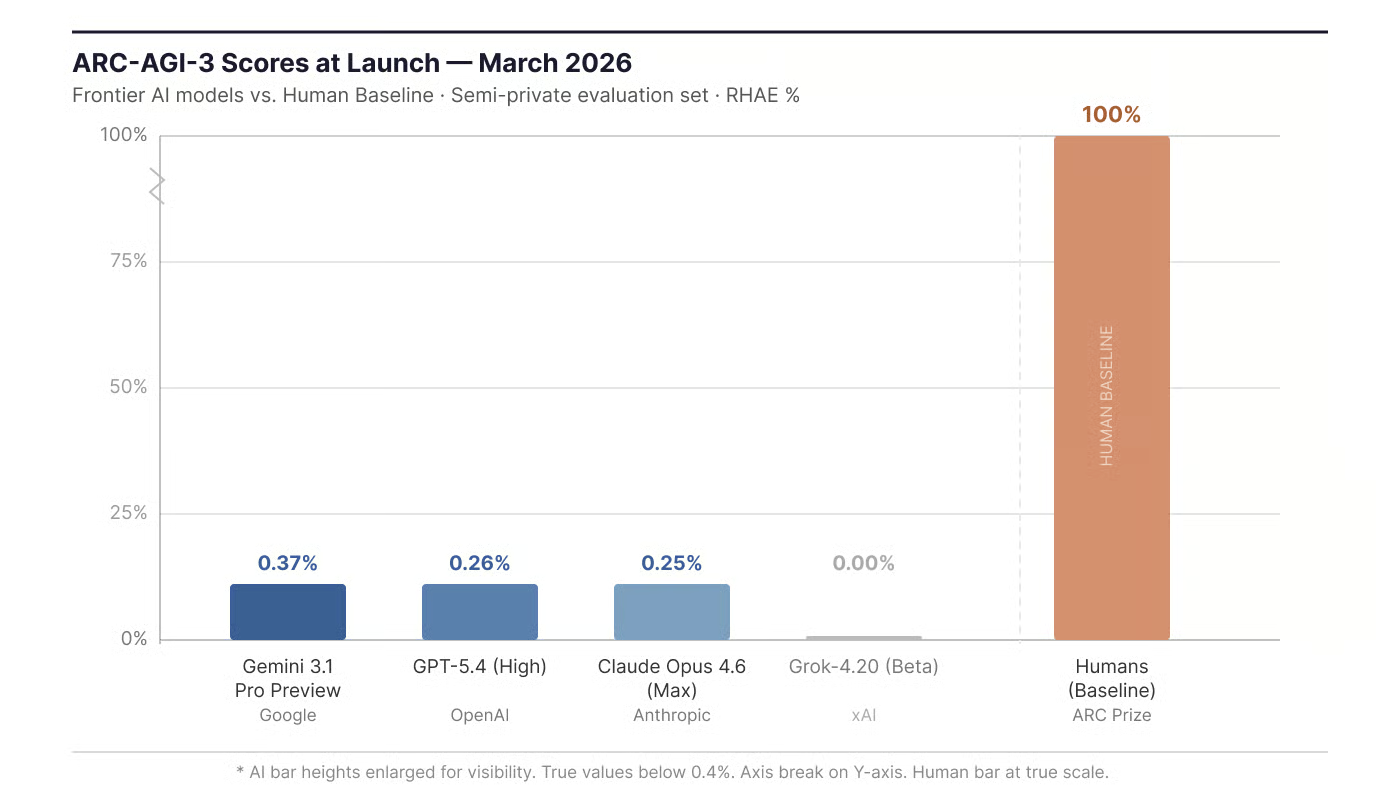
Pontuações no lançamento (março de 2026): IA de fronteira versus linha de base humana. Imagem do autor.
Para contextualizar: esses mesmos modelos dominam a maioria dos outros benchmarks de IA. O ARC-AGI-1 caminha para a saturação, com os modelos no topo marcando bem acima de 90%. A queda para menos de 1% no ARC-AGI-3 sugere que as capacidades testadas aqui são diferentes daquilo em que os modelos atuais vão bem.
A pontuação de 0% do Grok-4.20 não significa que o modelo nunca agiu. Significa que ele excedeu o limite de ações do benchmark em todos os níveis. Vou explicar como esse limite funciona na seção de pontuação.
Os agentes com melhor desempenho durante o período de prévia não eram modelos de linguagem. Na competição de prévia (que usou 3 ambientes públicos e 3 privados como conjunto oculto de avaliação), um sistema chamado StochasticGoose, da Tufa Labs, alcançou 12,58% usando uma abordagem de aprendizado por reforço com redes neurais convolucionais.
Quando o StochasticGoose foi avaliado no benchmark oficial completo no lançamento, porém, sua pontuação caiu para 0,25%, aproximadamente o mesmo nível dos LLMs de ponta. Esse resultado é revelador: uma abordagem que funcionou bem em alguns ambientes conhecidos foi muito pior diante do conjunto completo de ambientes inéditos, reforçando o quanto o ARC-AGI-3 depende de adaptabilidade geral, não de otimização específica por tarefa.
Isso sugere que o formato interativo pode funcionar melhor com arquiteturas diferentes, já que um modelo de linguagem não consegue raciocinar totalmente sobre um problema quando as informações necessárias só aparecem após cada ação.
Você pode conferir as pontuações mais recentes no ranking do ARC-AGI-3.
Esses números fazem mais sentido quando você entende o que os benchmarks ARC anteriores testavam. O ARC-AGI-1, lançado por Chollet em 2019, introduziu o conceito de medir inteligência fluida por meio de quebra-cabeças visuais abstratos. O formato era estático: o modelo via alguns exemplos de grade com entrada e saída, inferia a regra de transformação e produzia uma única resposta. O ARC-AGI-2, lançado em março de 2025, manteve o formato estático, mas com tarefas mais difíceis e mais composicionais.
O ARC-AGI-1 ajudou a identificar o surgimento dos grandes modelos de raciocínio como uma nova categoria, com o o3 da OpenAI sendo o primeiro sinal claro. O ARC-AGI-2 acompanhou a velocidade com que essa capacidade de raciocínio escalou. Mas o formato estático tinha uma vulnerabilidade: o aumento de computação em tempo de teste. Gerando milhares de soluções candidatas em paralelo durante a inferência, os laboratórios empurraram as pontuações do ARC-AGI-2 de dígitos simples para bem acima de 50% em menos de um ano.
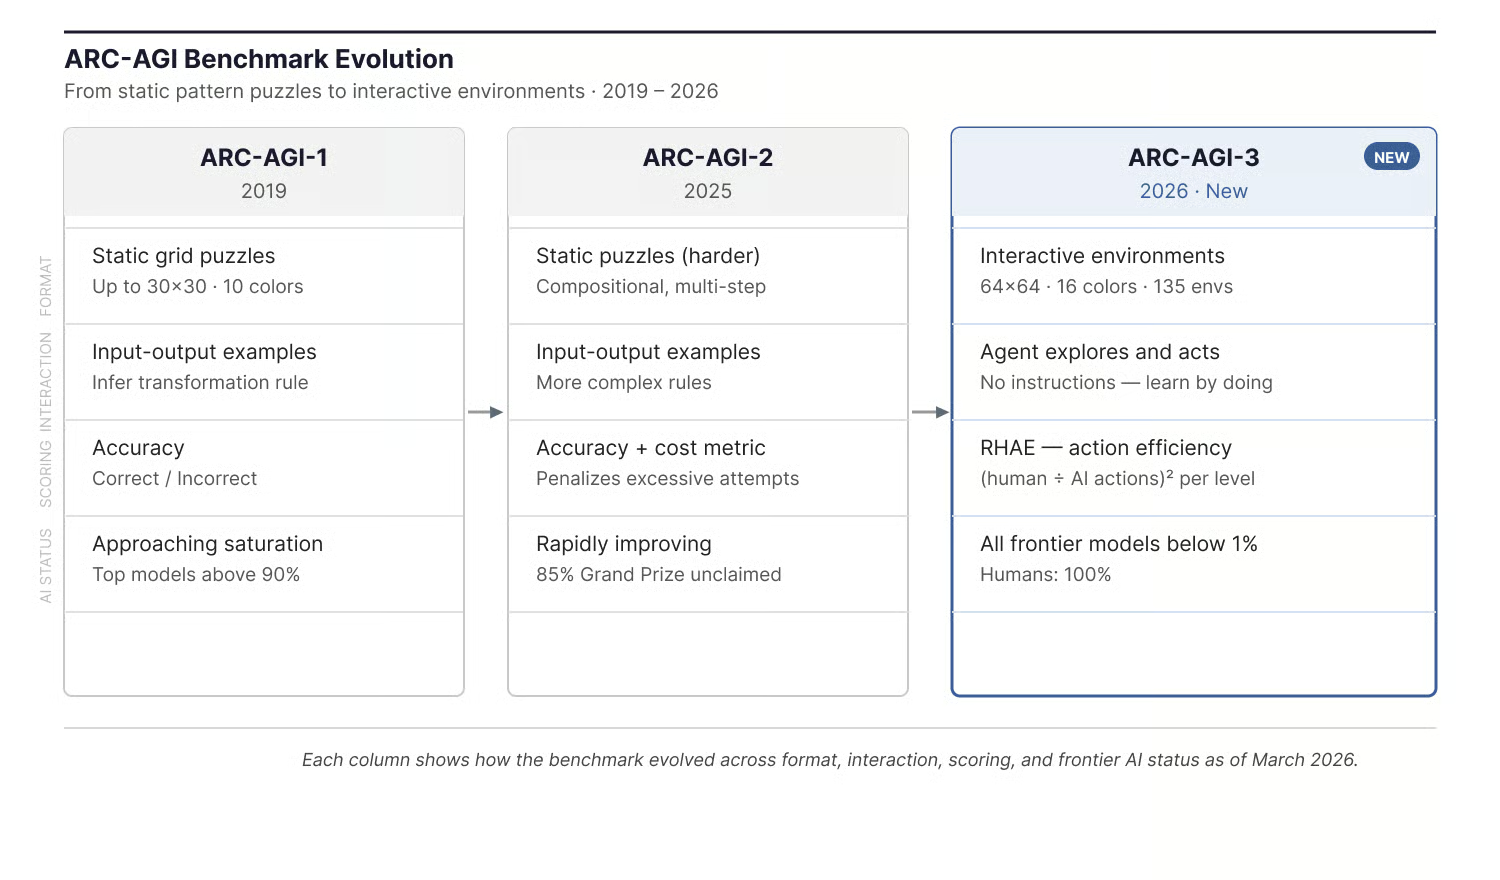
Evolução dos benchmarks ARC-AGI ao longo do tempo. Imagem do autor.
O ARC-AGI-3 torna a estratégia de amostragem por força bruta muito mais difícil, porque, como mencionei, o ambiente só revela suas regras depois que o agente age. Não dá para gerar 10.000 soluções candidatas em uma janela de contexto quando o problema muda a cada ação.
Além do formato interativo, o ARC-AGI-3 traz escolhas de design específicas para mitigar contaminação de dados e atalhos de geração sintética que afetaram versões anteriores. A mudança mais notável é a inversão da razão entre conjuntos. ARC-AGI-1 e ARC-AGI-2 tinham cerca de 10:1 de tarefas públicas para privadas, oferecendo amplo material de treino. O ARC-AGI-3 inverte: apenas 25 ambientes são públicos, enquanto a grande maioria fica reservada em conjuntos semiprivados e totalmente privados para avaliação.
A equipe do ARC Prize também sinalizou evidências de que alguns modelos de fronteira podem ter dados do ARC em seus conjuntos de treinamento. Durante a avaliação do ARC-AGI-2, o raciocínio em cadeia do Gemini 3 mencionou mapeamentos de cores específicos do ARC sem ter sido solicitado, o que sugere saturação de dados de treino. Ao reduzir a área pública e migrar para ambientes interativos que não podem ser memorizados como padrões estáticos, o ARC-AGI-3 busca tornar esse tipo de atalho muito mais difícil.
Essas decisões de design ficam mais claras quando você entende o que o benchmark realmente tenta testar. O foco é o que a equipe do ARC Prize descreve como "eficiência de aquisição de habilidades": quão eficientemente um agente de IA consegue aprender algo que nunca encontrou antes.
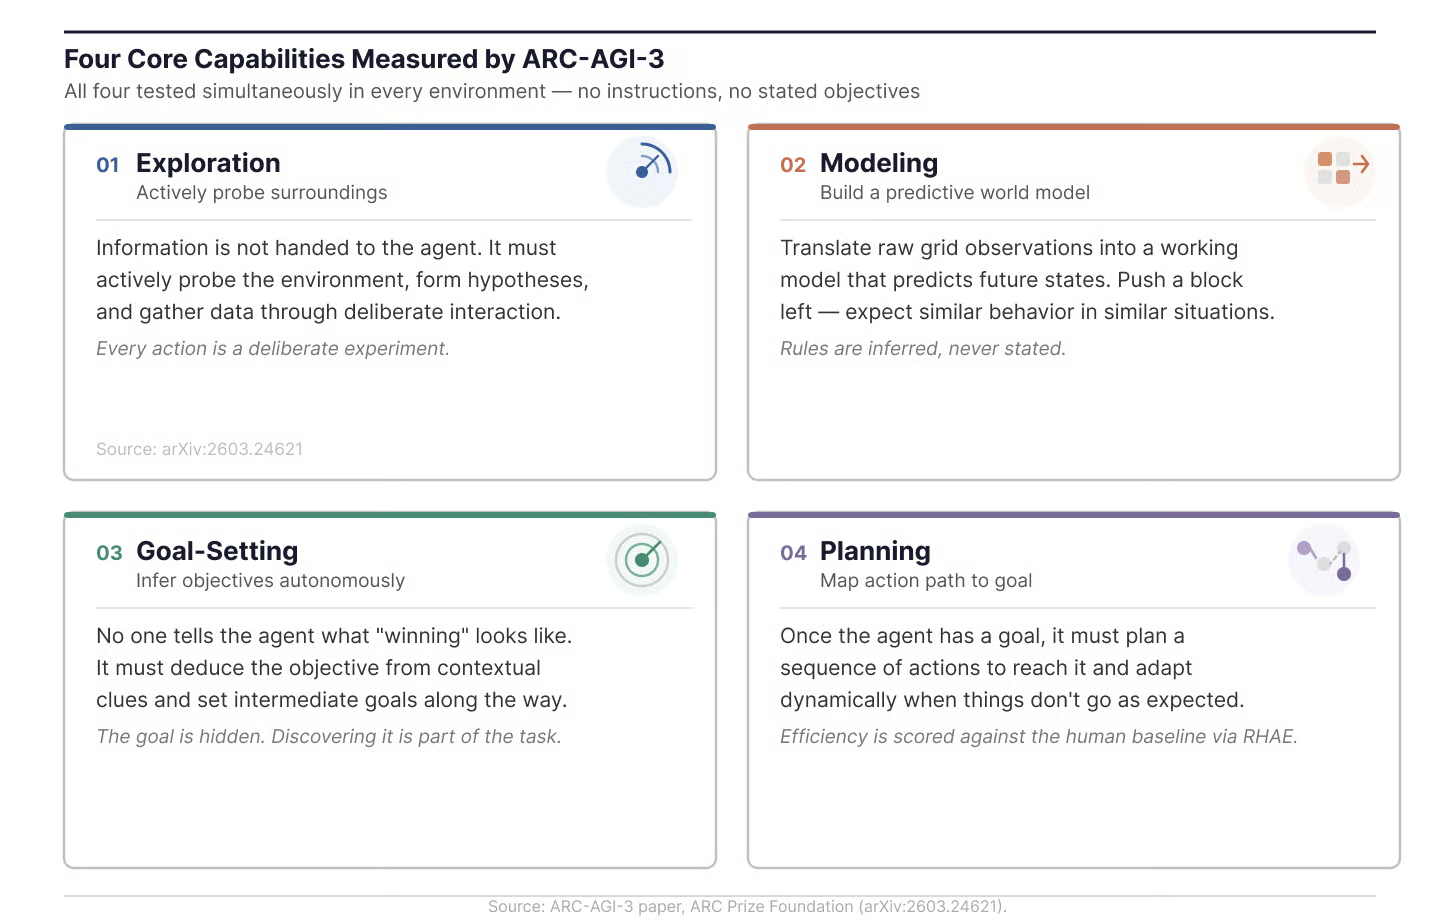
Quatro capacidades centrais medidas pelo ARC-AGI-3. Imagem do autor.
Essas quatro áreas são testadas simultaneamente em todo ambiente, sem instruções e sem objetivos declarados em nenhum momento.
Uma pontuação de 100% no ARC-AGI-3 significaria que um agente de IA consegue resolver todos os ambientes com a mesma eficiência do segundo melhor testador humano. A equipe do ARC Prize deixa claro: isso não equivale a AGI. Significa que um gap específico entre aprendizado de IA e humano foi fechado.
A pontuação é onde o ARC-AGI-3 mais difere de benchmarks anteriores. Ele não verifica apenas se o agente eventualmente tropeça em uma solução. Mede quão eficientemente o agente chega lá.
A métrica se chama RHAE, de Relative Human Action Efficiency (eficiência relativa de ações humanas). A fórmula por nível é:
Pontuação do nível = min(1.0, (human_baseline_actions / AI_actions))²
O detalhe-chave é o expoente ao quadrado. Não é uma relação linear. Dobrar o número de ações não reduz a pontuação pela metade; reduz para um quarto. Dez vezes o número de ações derruba a pontuação para quase zero. Esse desenho em lei de potência penaliza fortemente abordagens por força bruta e recompensa agentes que de fato aprendem como o ambiente funciona.
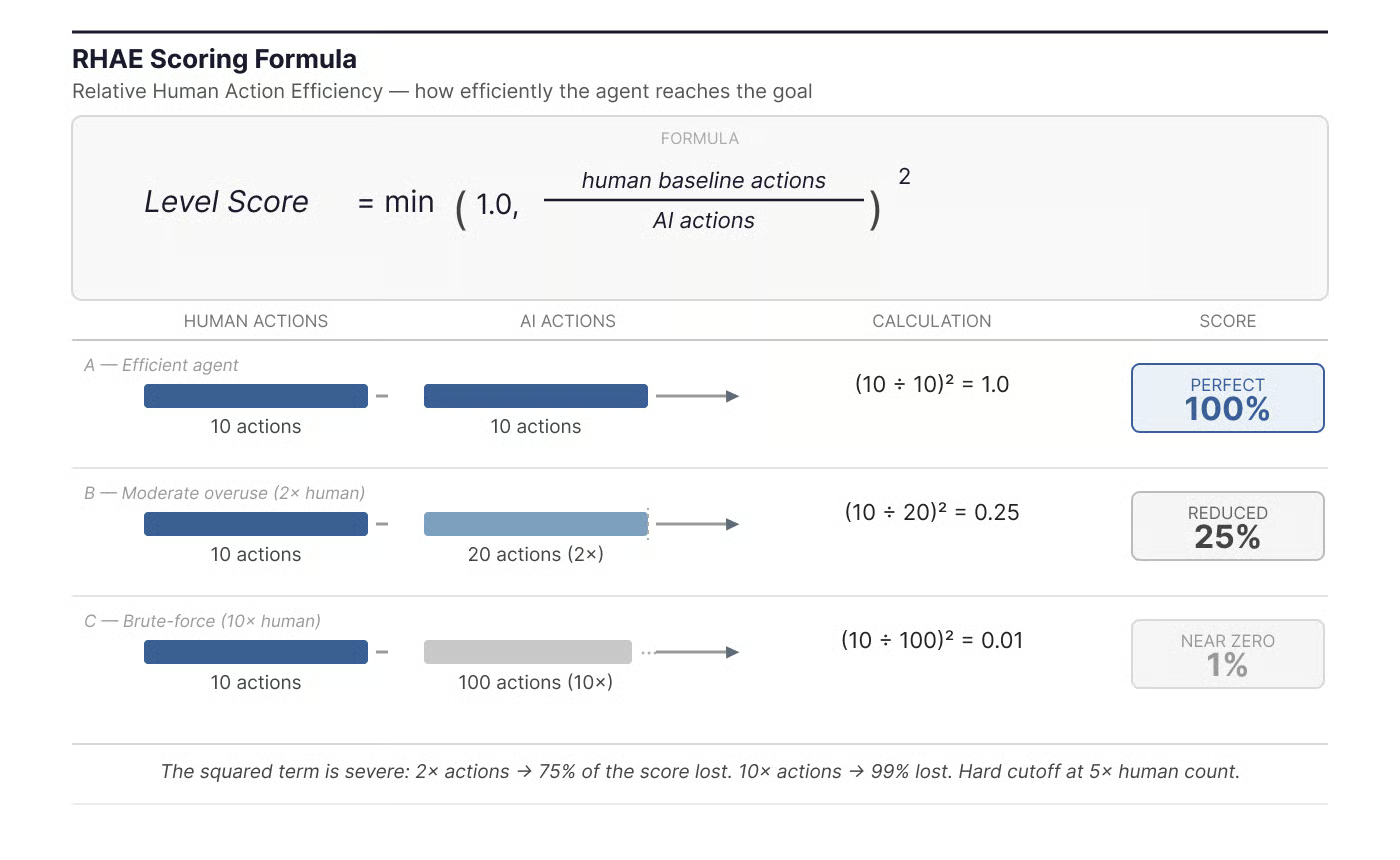
Fórmula de pontuação RHAE com exemplos. Imagem do autor.
A linha de base humana é definida pelo segundo melhor desempenho entre 10 testadores que tentaram cada ambiente na primeira exposição. Usar o segundo melhor, e não o absoluto melhor, filtra casos de sorte sem perder o pé na prática real.
Há também um corte rígido: se um agente usa mais de 5x o número de ações humanas em um nível, ele é interrompido e marca zero naquele nível. E as pontuações são limitadas a 1,0 — descobrir um atalho não intencional que supere a linha de base humana não rende bônus.
Dentro de cada ambiente, níveis posteriores valem mais. A pontuação usa média ponderada: o Nível 1 tem peso 1, o Nível 2 tem peso 2 e assim por diante. Isso significa que os níveis tutoriais quase não afetam a nota, enquanto os mais difíceis — que exigem combinar múltiplas mecânicas aprendidas — carregam mais peso.
O ARC-AGI-3 mantém dois rankings separados com regras distintas. O ranking Official avalia modelos de fronteira usando sistemas de API de uso geral que não foram especialmente preparados para o ARC-AGI-3. O ranking Community permite resultados auto-relatados e admite harnesses. Essa distinção importa porque, como mencionei, harnesses artesanais podem inflar dramaticamente as pontuações em ambientes conhecidos enquanto falham completamente nos inéditos. O ranking Official foi projetado para medir a adaptabilidade real da IA, não o “andamento” construído pelo desenvolvedor.
O ARC-AGI-3 é o carro-chefe da competição deste ano, mas não é a única trilha.
O ARC Prize 2026 tem um prêmio total de mais de US$ 2 milhões distribuído em três trilhas. A trilha do ARC-AGI-3 oferece US$ 850.000 em prêmios, com destaque para um Grand Prize de US$ 700.000 para o primeiro agente elegível que atingir 100% no conjunto de avaliação totalmente privado. Se ninguém levar neste ano, o valor rola para 2027. Além do Grand Prize, há um prêmio de US$ 75.000 para as maiores pontuações, dividido entre os cinco primeiros colocados, e dois checkpoints (30 de junho e 30 de setembro de 2026), cada um distribuindo US$ 37.500 entre os três melhores times na data.
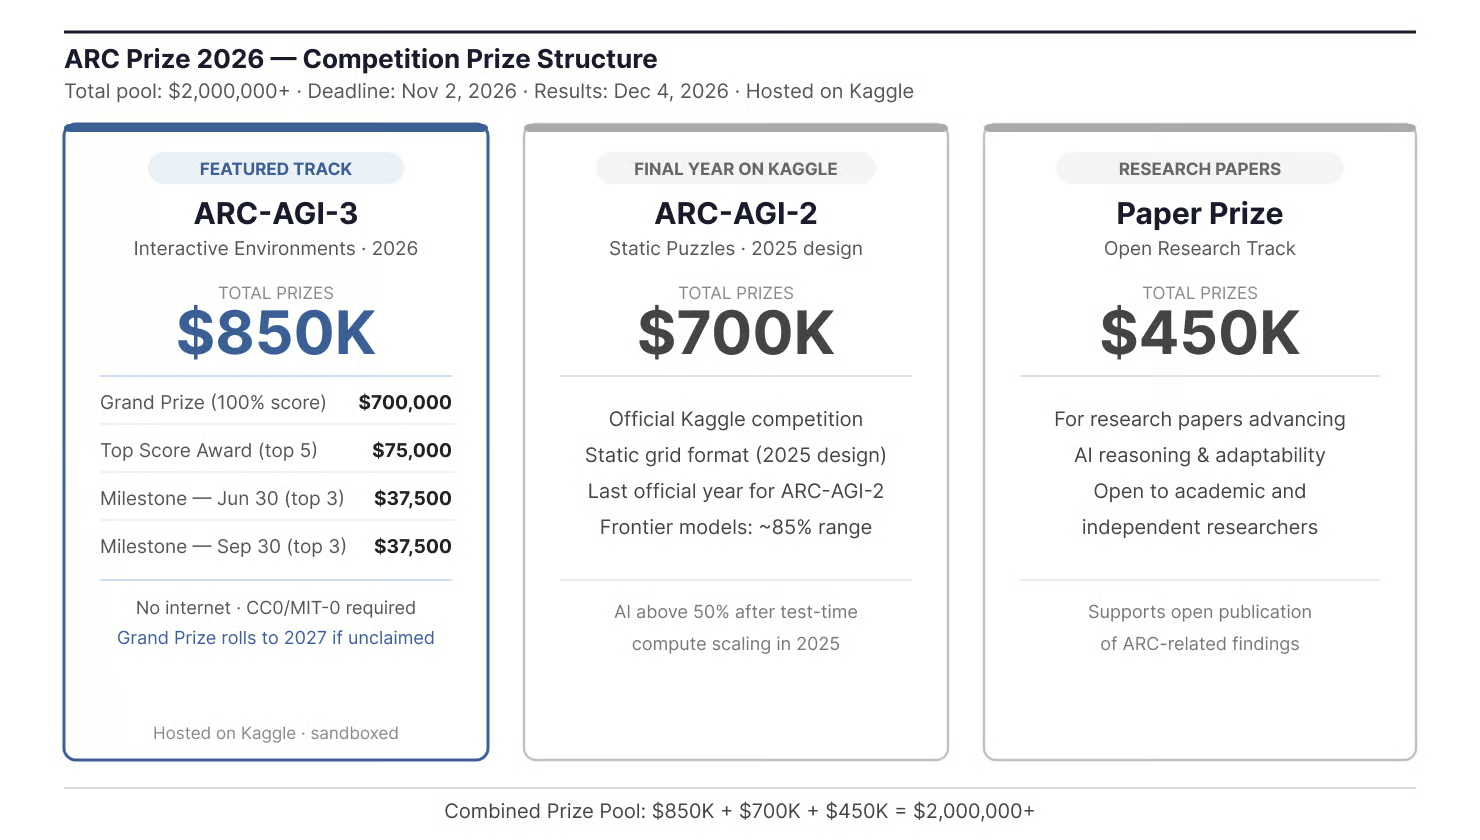
Estrutura de prêmios da competição ARC Prize 2026. Imagem do autor.
As outras duas trilhas são a trilha ARC-AGI-2 (US$ 700.000, e, vale notar, o último ano em que o ARC-AGI-2 será usado em uma competição oficial no Kaggle) e a trilha Paper Prize (US$ 450.000 para artigos de pesquisa).
A competição acontece no Kaggle, mas com regras diferentes de uma competição típica. As submissões são avaliadas em ambiente isolado, sem acesso à internet, o que elimina chamadas a APIs de modelos hospedados como GPT, Claude ou Gemini. Todas as soluções elegíveis a prêmios devem ser liberadas sob licença permissiva ou de domínio público (CC0 ou MIT-0) antes de receber as pontuações da avaliação privada. A competição abriu em 25 de março de 2026, com prazo final em 2 de novembro de 2026 e resultados anunciados em 4 de dezembro de 2026.
Benchmarks importam mais quando revelam um gap que antes não parecia existir. Nesse sentido, os dois primeiros ARC ganharam seu lugar: o ARC-AGI-1 revelou o surgimento dos grandes modelos de raciocínio, e o ARC-AGI-2 mostrou até onde o aumento de computação em tempo de teste conseguiria levar. O ARC-AGI-3 aponta para outro problema.
O que torna esse benchmark especialmente relevante agora é o contexto. No início de 2026, muitos benchmarks amplamente usados estão próximos da saturação. Modelos de fronteira marcam acima de 90% no MMLU, HumanEval e GSM8K, entre outros, o que limita o quanto essas avaliações conseguem diferenciar sistemas. O ARC-AGI-3 testa uma capacidade que os modelos atuais parecem não ter: aprender em tempo real dentro de ambientes desconhecidos. O gap entre as pontuações abaixo de 1% das IAs e 100% de resolubilidade humana é grande o suficiente para sugerir que não é apenas uma versão mais difícil do mesmo teste, e sim um tipo diferente de desafio.
O ARC Prize apresenta o ARC-AGI-3 como o teste mais importante de raciocínio interativo, embora valha lembrar que esse enquadramento vem da organização que conduz o benchmark. Se essa visão se sustenta depende de como o benchmark se sai conforme a comunidade de pesquisa se adapta a ele.
Nenhum benchmark é perfeito, e o ARC-AGI-3 recebeu algumas críticas relevantes.
Uma preocupação comum é a própria fórmula de pontuação. A métrica de eficiência ao quadrado penaliza fortemente a exploração — que, por si só, pode ser um sinal de inteligência, não de falha. Se um agente gasta 50 ações mapeando cuidadosamente as condições de contorno antes de chegar à solução, ele marca muito pior do que um humano que acerta a regra em 5 ações. Alguns membros da comunidade argumentam que isso pode ampliar artificialmente o gap de desempenho.
Há também a questão da linha de base. Como citei na seção de pontuação, o benchmark usa o segundo melhor testador humano, e não a média, o que define uma barra alta. Mesmo humanos típicos ficariam abaixo de 100% nesse esquema.
A equipe do ARC Prize apresenta o benchmark como uma tentativa científica de medir uma capacidade ausente específica, não um teste definitivo de inteligência geral. Dado o que sabemos hoje, essa leitura é justa.
O ARC-AGI-3 traz uma nova forma de avaliar sistemas de IA. Ao sair de quebra-cabeças estáticos para ambientes interativos, ele testa se os modelos conseguem explorar, definir seus próprios objetivos e aprender pela experiência — não por instruções.
Os primeiros números chamam atenção. Modelos que dominam benchmarks de código, competições de matemática e testes de conhecimento mal passam de 1% aqui. Se esse gap fecha rápido, como aconteceu nos ARC anteriores, ou se o formato interativo se mostra mais difícil de quebrar, é algo que vale acompanhar de perto.
Para saber mais sobre conceitos por trás de sistemas de IA adaptativos, confira nossa trilha de habilidade AI Fundamentals ou nosso curso Building Scalable Agentic Systems.
Aprenda com a DataCamp
Curso
Curso
Curso
blog
blog
Khalid Abdelaty
15 min
blog
Josep Ferrer
8 min
blog
Adel Nehme
15 min
Tutorial
Zoumana Keita
12 min
Tutorial
Zoumana Keita
14 min