Cours
Comprendre l'intelligence artificielle
2 h
426.1K
La plupart des benchmarks en IA suivent la même recette : poser une question au modèle, récupérer une réponse, vérifier si elle est correcte. Pendant des années, cette approche a suffi. Mais à mesure que les modèles de pointe dépassaient 90 % sur presque toutes les grandes évaluations, un problème bien connu est apparu : les benchmarks ont commencé à perdre leur pouvoir de différenciation entre les modèles.
ARC-AGI-3 adopte une autre voie. Plutôt que de proposer des casse-têtes statiques avec des paires entrée-sortie claires, il plonge des agents d’IA dans des environnements interactifs sans instruction, sans objectif explicite et sans règle énoncée. L’agent doit tout découvrir par l’essai et l’observation, comme une personne à qui l’on confie un jeu qu’elle n’a jamais vu.
Lancé le 25 mars 2026 par la ARC Prize Foundation, ARC-AGI-3 a livré un résultat marquant dès sa sortie : tous les modèles d’IA de pointe ont obtenu moins de 1 %, tandis que les humains ont résolu l’ensemble des environnements du benchmark.
ARC-AGI-3 est un benchmark d’inérence interactive créé par l’ARC Prize Foundation, cofondée par le chercheur en IA François Chollet (créateur de Keras) et Mike Knoop (cofondateur de Zapier). Le benchmark s’articule autour d’un principe clé défendu par l’équipe ARC : la véritable intelligence ne réside pas dans l’étendue des connaissances, mais dans la capacité à apprendre efficacement quelque chose de totalement nouveau.
Alors que les évaluations précédentes testent des connaissances cristallisées (rappeler des faits mémorisés, appliquer des heuristiques apprises), ARC-AGI-3 cible l’intelligence fluide : la capacité à raisonner face à des problèmes inédits et à s’adapter à de nouvelles situations plutôt que de s’appuyer sur l’apprentissage préalable. Il mesure si un agent d’IA peut explorer un environnement inconnu, en déduire les règles, identifier à quoi ressemble la « réussite », puis agir efficacement en conséquence.
Le benchmark comprend 135 environnements répartis entre des ensembles publics, semi-privés et entièrement privés. Chaque environnement est un scenario ludique au tour par tour conçu par une équipe interne. L’agent ne reçoit aucun indice. Il observe l’état du monde, effectue une action, constate ce qui se passe, et recommence.
L’article technique présente le benchmark comme un test de quatre capacités fondamentales : exploration, modélisation, définition d’objectifs et planification.
Pour s’assurer que le benchmark mesure le raisonnement et non la remémoration des données d’entraînement, les environnements d’ARC-AGI-3 évitent le langage, les chiffres, les lettres, les symboles culturels ou des objets réels reconnaissables. Ils s’appuient uniquement sur ce que l’équipe ARC Prize appelle les « Core Knowledge priors », c’est-à-dire des capacités cognitives de base partagées par tous les humains.
Ces a priori incluent l’objectité (comprendre que les choses sont des entités persistantes susceptibles de se déplacer ou d’entrer en collision), la géométrie et la topologie de base (symétrie, rotation, « dedans » contre « dehors »), la physique élémentaire (moment, gravité, rebonds) et l’agentivité (reconnaître quand quelque chose dans l’environnement agit avec une intention). Si un environnement exigeait de savoir qu’une clef ouvre une serrure, il testerait des données d’entraînement, pas le raisonnement.
Le passage d’une évaluation statique à des environnements interactifs change ce que le benchmark peut réellement mesurer.
Chaque environnement ARC-AGI-3 présente une grille 64×64 où chaque cellule affiche l’une des 16 couleurs possibles. L’agent reçoit un état visuel (appelé « frame ») sous forme d’objet JSON, puis soumet une action unique par tour. L’espace d’action est réduit : en général cinq commandes directionnelles ou liées aux touches, plus une éventuelle action de « clic » à base de coordonnées pour sélectionner des cellules spécifiques de la grille.
Les environnements sont strictement au tour par tour. Rien ne change tant que l’agent n’agit pas, ce qui signifie que le benchmark valorise le raisonnement soigné plutôt que les réflexes. Point essentiel : les opérations internes comme les chaînes de raisonnement, les essais/erreurs ou les appels d’outils ne comptent pas comme actions. Seules les commandes qui modifient effectivement l’état de l’environnement sont prises en compte dans le score de l’agent.
Chaque environnement contient plusieurs niveaux, du plus simple au plus difficile. Le premier niveau fait office de tutoriel, en introduisant des mécaniques de base avec une complexité minimale. Les niveaux suivants ajoutent de nouvelles règles et interactions, de sorte que l’agent doit capitaliser sur ce qu’il a appris et l’appliquer à des situations plus complexes.
Dans ARC-AGI-3, la difficulté ne vient ni de l’obscurité ni de l’échelle, mais de la composition de multiples mécaniques apprises au fil des niveaux. Un environnement à mécanique unique serait trop facile à forcer. Le véritable test consiste à combiner plusieurs dynamiques pour résoudre un problème jamais vu par l’agent.
Le benchmark s’exécute sur un moteur personnalisé basé sur Python, conçu pour atteindre 1 000 FPS en mode sans interface graphique. Les développeurs peuvent démarrer avec pip install arc-agi et interagir avec les environnements via le SDK ou une API REST. Vous pouvez aussi jouer aux environnements publics dans votre navigateur pour vous faire une idée de ces jeux.
Précision importante : ces scores reflètent l’état du classement à fin mars 2026 et évolueront très probablement au fur et à mesure que de nouvelles approches verront le jour.
Au lancement, l’ARC Prize Foundation a testé plusieurs modèles de pointe sur l’ensemble d’évaluation semi-privé.
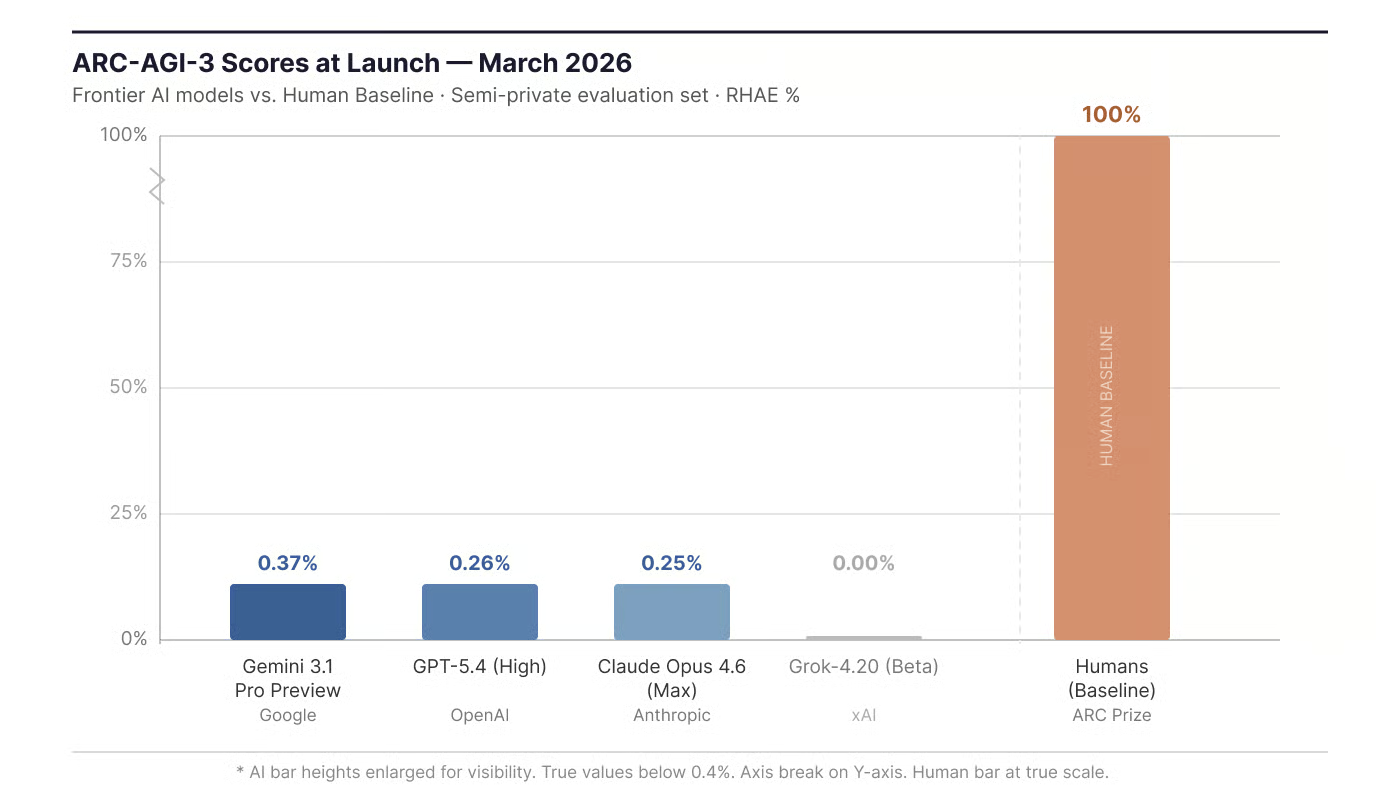
Scores au lancement (mars 2026) : IA de pointe contre référentiel humain. Image de l’auteur.
Pour contexte, ces mêmes modèles dominent la plupart des autres benchmarks d’IA. ARC-AGI-1 est proche de la saturation, avec des scores bien au-delà de 90 % pour les meilleurs modèles. La chute sous 1 % sur ARC-AGI-3 suggère que les capacités testées ici diffèrent de ce que réussissent les modèles actuels.
Le score de 0 % pour Grok-4.20 ne signifie pas que le modèle n’a pas agi. Il signifie qu’il a dépassé le seuil d’actions autorisé sur chaque niveau. J’expliquerai ce seuil dans la section sur le scoring.
Les meilleurs agents pendant la période de prévisualisation n’étaient pas des modèles de langage. Lors de cette compétition (3 environnements publics et 3 privés en évaluation cachée), un système appelé StochasticGoose de Tufa Labs a atteint 12,58 % avec une approche d’apprentissage par renforcement avec réseaux neuronaux convolutionnels.
Cependant, évalué sur le benchmark officiel complet au lancement, StochasticGoose est tombé à 0,25 %, soit à peu près le niveau des LLM de pointe. Ce résultat est éloquent : une approche efficace sur quelques environnements connus performe bien moins face à l’ensemble d’environnements inédits, ce qui renforce l’idée qu’ARC-AGI-3 dépend fortement de l’adaptabilité générale plutôt que de l’optimisation spécifique à une tâche.
Cela suggère que le format interactif pourrait mieux convenir à d’autres architectures, puisqu’un modèle de langage ne peut pas raisonner pleinement si l’information nécessaire n’apparaît qu’après chaque action.
Vous pouvez consulter les derniers scores sur le classement ARC-AGI-3.
Ces chiffres prennent un autre sens quand on sait ce que testaient les versions précédentes. Publié par Chollet en 2019, ARC-AGI-1 a introduit l’idée de mesurer l’intelligence fluide via des puzzles visuels abstraits. Le format était statique : le modèle voyait quelques exemples entrée-sortie, déduisait une règle de transformation et produisait une sortie unique. ARC-AGI-2, publié en mars 2025, a conservé ce format statique mais avec des tâches plus dures et plus compositionnelles.
ARC-AGI-1 a permis d’identifier l’émergence d’une nouvelle catégorie de modèles de raisonnement, avec o3 d’OpenAI comme premier signal clair. ARC-AGI-2 a montré à quelle vitesse cette capacité de raisonnement pouvait évoluer. Mais le format statique avait une faille : l’escalade du calcul à l’inference. En générant des milliers de solutions candidates en parallèle à l’inference, les laboratoires ont fait passer les scores d’ARC-AGI-2 de quelques points à bien plus de 50 % en moins d’un an.
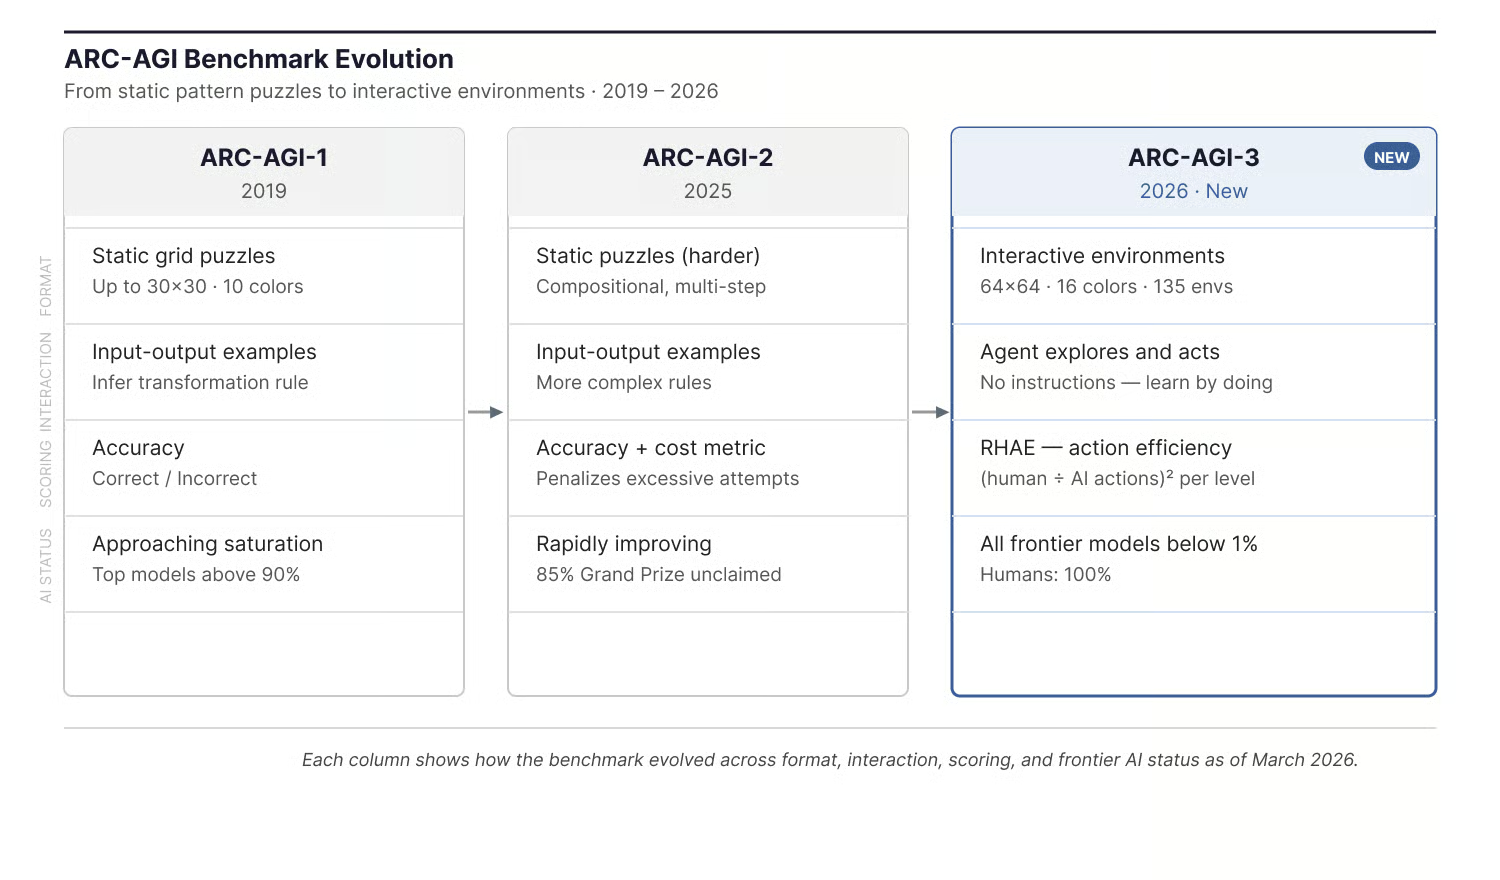
Évolution des benchmarks ARC-AGI dans le temps. Image de l’auteur.
ARC-AGI-3 rend la stratégie d’échantillonnage brutale bien plus difficile, car — comme indiqué plus haut — l’environnement ne révèle ses règles qu’après l’action de l’agent. Impossible de générer 10 000 solutions candidates dans une fenêtre de contexte quand le problème évolue à chaque action.
Au-delà du format interactif, ARC-AGI-3 inclut des choix de conception destinés à contrer la contamination des données et les générations synthétiques qui ont affecté les versions précédentes. Le changement le plus notable est l’inversion du ratio de jeux de données. ARC-AGI-1 et ARC-AGI-2 proposaient environ 10 fois plus de tâches publiques que privées, offrant beaucoup de matière d’entraînement aux chercheurs. ARC-AGI-3 renverse la logique : seulement 25 environnements sont publics, tandis que la grande majorité est conservée dans des ensembles semi-privés et privés pour l’évaluation.
L’équipe ARC Prize a également signalé des indices laissant penser que certains modèles de pointe contiennent des données ARC dans leur entraînement. Lors de l’évaluation d’ARC-AGI-2, la chaîne de pensée de Gemini 3 référençait des correspondances de couleurs propres à ARC sans y être invité, ce qui suggère une saturation des données d’entraînement. En réduisant la surface publique et en passant à des environnements interactifs impossibles à mémoriser sous forme de motifs statiques, ARC-AGI-3 vise à rendre ces raccourcis bien plus difficiles.
Ces choix de conception prennent tout leur sens une fois que l’on comprend ce que le benchmark cherche à tester. Il cible ce que l’équipe ARC Prize décrit comme l’« efficacité d’acquisition de compétences » : la vitesse et l’efficacité avec lesquelles un agent d’IA peut apprendre quelque chose qu’il n’a jamais rencontré.
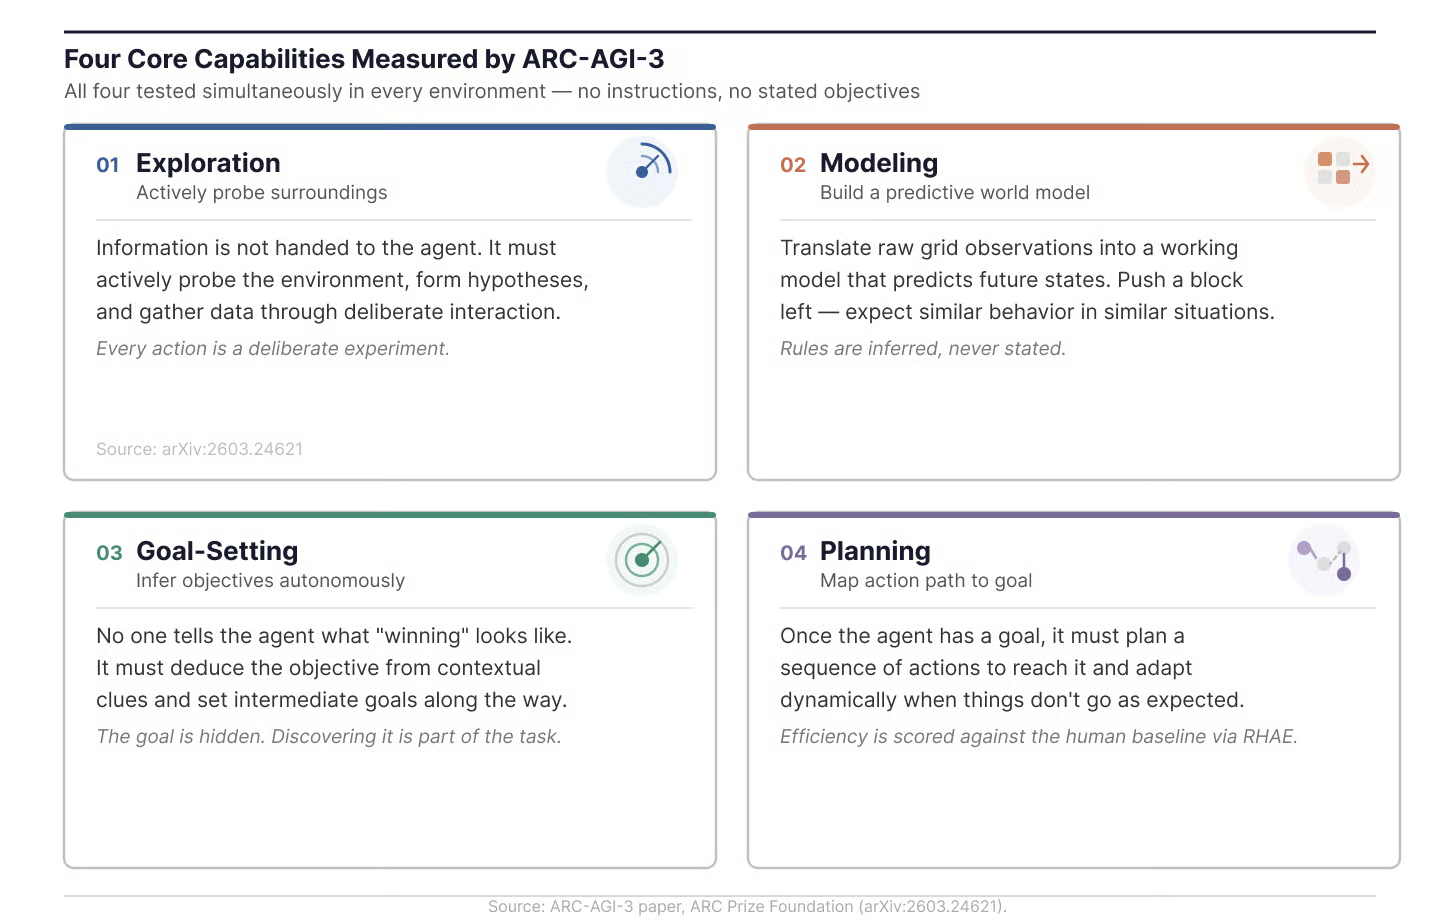
Quatre capacités fondamentales mesurées par ARC-AGI-3. Image de l’auteur.
Ces quatre dimensions sont testées simultanément dans chaque environnement, sans instruction ni objectif énoncé à aucun moment.
Un score de 100 % sur ARC-AGI-3 signifierait qu’un agent d’IA résout chaque environnement aussi efficacement que le deuxième meilleur testeur humain. L’équipe ARC Prize est claire : cela ne vaudrait pas AGI. Cela indiquerait qu’un écart particulier entre l’apprentissage humain et celui des IA a été comblé.
Le scoring est là où ARC-AGI-3 diffère le plus des benchmarks précédents. Il ne se contente pas de vérifier si l’agent finit par tomber sur une solution : il mesure l’efficacité avec laquelle il y parvient.
La métrique s’appelle RHAE, pour Relative Human Action Efficiency. La formule par niveau est :
Score du niveau = min(1,0, (actions_humain_réf / actions_IA))²
Le détail clé est l’exposant au carré. La relation n’est pas linéaire. Doubler le nombre d’actions ne divise pas le score par deux : il le divise par quatre. Dix fois plus d’actions font chuter le score à presque zéro. Cette loi de puissance pénalise fortement les approches « brute force » et récompense les agents qui apprennent vraiment le fonctionnement de l’environnement.
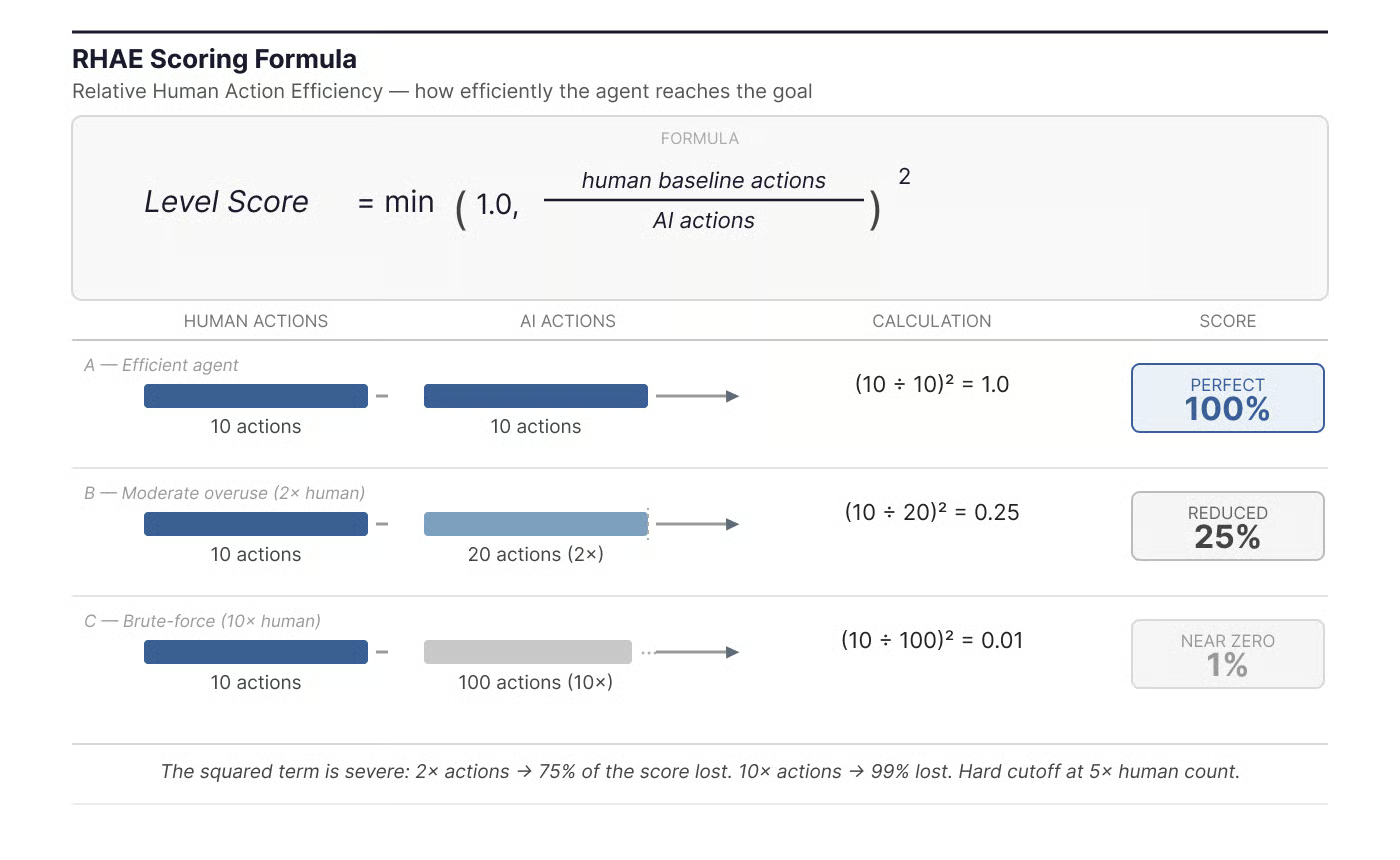
Formule RHAE avec exemples chiffrés. Image de l’auteur.
La référence humaine est fixée par le deuxième meilleur performeur parmi 10 testeurs, chacun tentant l’environnement en première exposition. Utiliser le deuxième meilleur plutôt que l’absolu meilleur évite les coups de chance tout en restant ancré dans le jeu réel.
Il existe aussi une coupure franche : si un agent dépasse 5 fois le nombre d’actions humaines sur un niveau, il est interrompu et obtient zéro pour ce niveau. Les scores sont plafonnés à 1,0 : découvrir un raccourci imprévu meilleur que la référence humaine n’octroie pas de bonus.
Au sein d’un environnement, les niveaux avancés pèsent davantage. Le score est une moyenne pondérée où le niveau 1 a un poids de 1, le niveau 2 un poids de 2, etc. Les niveaux tutoriels influent donc peu, tandis que les niveaux difficiles, qui exigent de combiner plusieurs mécaniques apprises, comptent le plus.
ARC-AGI-3 maintient deux classements distincts, avec des règles différentes. Le classement Officiel évalue des modèles de pointe via des systèmes API généralistes non préparés spécifiquement pour ARC-AGI-3. Le classement Communauté accepte des résultats auto-déclarés et autorise les harnais. Cette distinction est importante car, comme indiqué plus haut, des harnais conçus à la main peuvent gonfler les scores sur des environnements connus tout en échouant complètement sur des inédits. Le classement Officiel vise à mesurer la véritable adaptabilité de l’IA, pas l’ingénierie d’encadrement du développeur.
ARC-AGI-3 est la pièce maîtresse de la compétition de cette année, mais ce n’est pas l’unique parcours.
ARC Prize 2026 propose une dotation totale de plus de 2 millions de dollars, répartie sur trois parcours. Le parcours ARC-AGI-3 offre 850 000 $ de prix au total, dont un Grand Prix de 700 000 $ pour le premier agent éligible atteignant 100 % sur l’ensemble d’évaluation entièrement privé. Si personne ne le remporte cette année, les fonds sont reportés à 2027. Au-delà du Grand Prix, un prix « top score » de 75 000 $ est partagé entre les cinq premiers, et deux jalons (30 juin et 30 septembre 2026) distribuent chacun 37 500 $ aux trois meilleures équipes à ces dates.
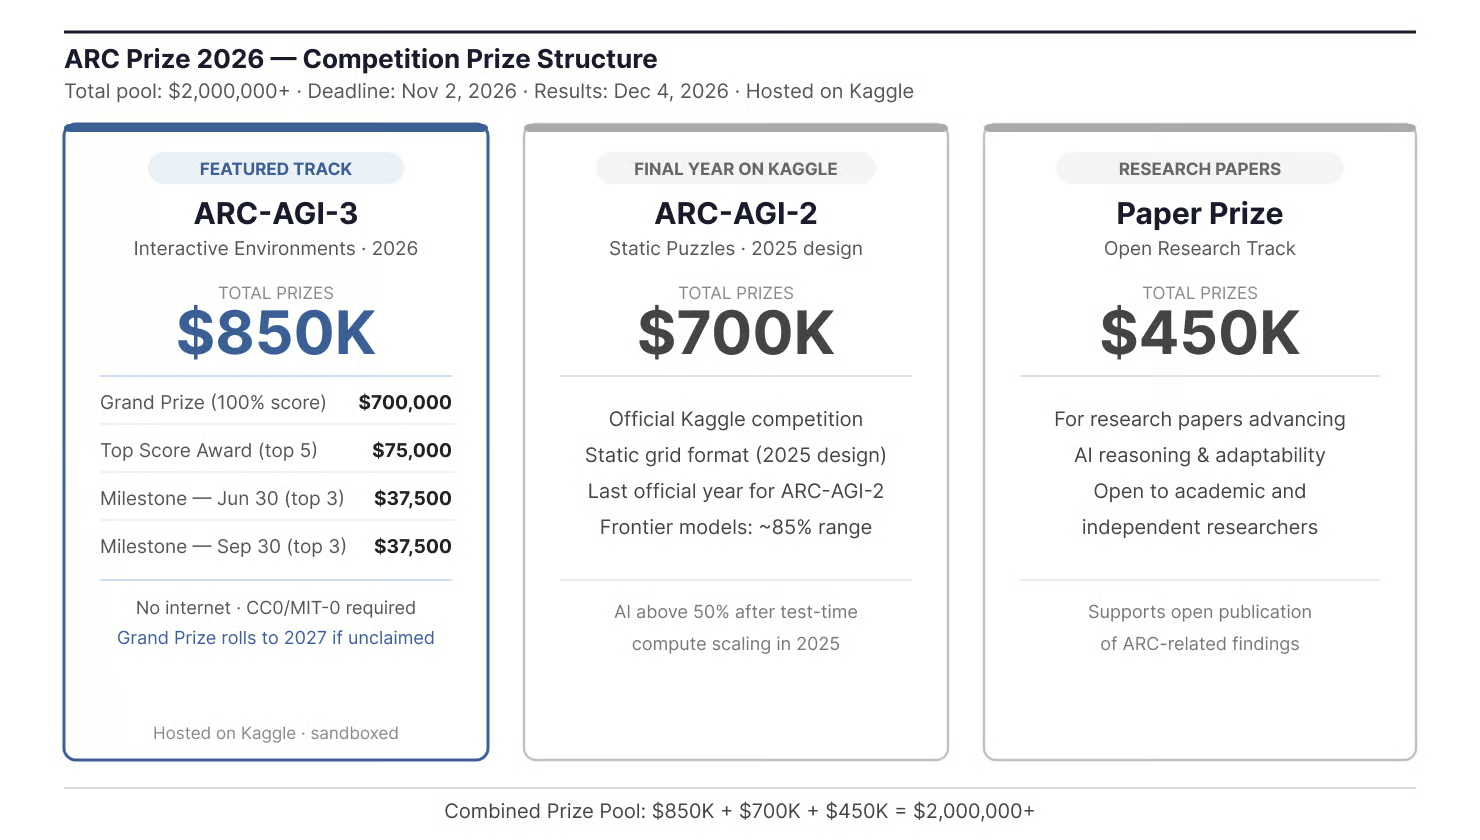
Structure des prix de la compétition ARC Prize 2026. Image de l’auteur.
Les deux autres parcours sont un parcours ARC-AGI-2 (700 000 $, et dernière année d’utilisation d’ARC-AGI-2 dans une compétition officielle Kaggle) et un parcours Paper Prize (450 000 $ pour des articles de recherche).
La compétition se déroule sur Kaggle, avec des règles qui la distinguent d’un concours Kaggle classique. Les soumissions sont évaluées dans un environnement sandbox sans accès Internet, excluant les appels API à des modèles hébergés comme GPT, Claude ou Gemini. Toutes les solutions éligibles aux prix doivent être publiées sous une licence permissive ou domaine public (CC0 ou MIT-0) avant de recevoir les scores sur l’évaluation privée. La compétition a ouvert le 25 mars 2026, avec une date limite de soumission au 2 novembre 2026 et des résultats annoncés le 4 décembre 2026.
Un benchmark est utile lorsqu’il met en évidence un écart qui ne paraissait pas évident. À ce titre, les deux premiers ARC ont fait leurs preuves : ARC-AGI-1 a révélé l’émergence de grands modèles de raisonnement, et ARC-AGI-2 a montré jusqu’où pouvait aller l’escalade du calcul à l’inference. ARC-AGI-3 pointe un autre problème.
Ce qui rend ce benchmark pertinent aujourd’hui, c’est le contexte. Début 2026, nombre de benchmarks très utilisés sont proches de la saturation. Les modèles de pointe dépassent 90 % sur MMLU, HumanEval, GSM8K, etc., ce qui limite leur pouvoir discriminant entre systèmes. ARC-AGI-3 teste une capacité dont les modèles actuels semblent dépourvus : apprendre « en direct » dans des environnements inconnus. L’écart entre des scores IA sous 1 % et une réussite humaine à 100 % laisse penser qu’il ne s’agit pas seulement d’une version plus dure du même test, mais d’un défi de nature différente.
ARC Prize présente ARC-AGI-3 comme le test de référence pour le raisonnement interactif, même s’il faut garder à l’esprit que ce cadrage vient de l’organisation qui pilote le benchmark. Sa pertinence dépendra de la façon dont la recherche s’y adaptera.
Aucun benchmark n’est parfait, et ARC-AGI-3 a reçu des critiques à considérer.
Une inquiétude récurrente porte sur la formule de score elle-même. La métrique d’efficacité au carré pénalise fortement l’exploration, qui peut pourtant être un signe d’intelligence. Si un agent passe 50 actions à cartographier précisément les limites avant de trouver la solution, il obtient un score bien pire qu’un humain devinant la règle en 5 actions. Certains membres de la communauté jugent que cela amplifie artificiellement l’écart de performance.
Se pose aussi la question du choix du référentiel : comme vu plus haut, le benchmark utilise le deuxième meilleur testeur humain plutôt que la moyenne, ce qui fixe la barre haut. Même des humains « typiques » n’atteindraient pas 100 % dans cette approche.
L’équipe ARC Prize présente le benchmark comme une tentative scientifique de mesurer une capacité manquante spécifique, non comme un test définitif d’intelligence générale. Au vu des connaissances actuelles, c’est une lecture raisonnable.
ARC-AGI-3 change la façon d’évaluer les systèmes d’IA. En passant de puzzles statiques à des environnements interactifs, il teste si les modèles peuvent explorer, se fixer des objectifs et apprendre par expérience plutôt que par instruction.
Les premiers chiffres sont frappants. Des modèles qui dominent les benchmarks de code, les compétitions de mathématiques et les tests de connaissances peinent à dépasser 1 % ici. Savoir si cet écart se refermera rapidement, comme pour les versions précédentes d’ARC, ou si le format interactif s’avérera plus réfractaire, sera à surveiller de près.
Pour en savoir plus sur les concepts derrière les systèmes d’IA adaptatifs, consultez notre parcours skill AI Fundamentals ou notre cours Building Scalable Agentic Systems.
Apprenez avec DataCamp
Cours
Cours
Cours
blog
Lynn Heidmann
blog
blog
Kurtis Pykes
9 min
blog
Zoumana Keita
15 min
blog
Kurtis Pykes
15 min
Tutoriel