Kursus
Memahami Kecerdasan Buatan
2 jam
426.1K
Kebanyakan tolok ukur AI mengikuti formula yang sama: berikan pertanyaan ke model, dapatkan jawaban, periksa apakah benar. Selama bertahun-tahun, pendekatan ini cukup berhasil. Namun ketika model-model terdepan mulai mencetak lebih dari 90% pada hampir semua evaluasi besar, masalah yang familiar muncul. Tolok ukur mulai kehilangan kemampuannya untuk membedakan satu model dari yang lain.
ARC-AGI-3 mengambil pendekatan berbeda. Alih-alih menyajikan teka-teki statis dengan pasangan input-output yang jelas, benchmark ini menempatkan agen AI ke dalam lingkungan interaktif tanpa instruksi, tanpa tujuan yang dinyatakan, dan tanpa aturan eksplisit. Agen harus mencari tahu semuanya sendiri melalui percobaan dan pengamatan, sama seperti seseorang ketika diberi sebuah gim yang belum pernah mereka lihat sebelumnya.
Diluncurkan pada 25 Maret 2026 oleh ARC Prize Foundation, ARC-AGI-3 menghasilkan temuan mencolok saat rilis: setiap model AI terdepan mendapat skor di bawah 1%, sementara manusia menyelesaikan semua lingkungan dalam tolok ukur ini.
ARC-AGI-3 adalah tolok ukur penalaran interaktif yang dibuat oleh ARC Prize Foundation, yang didirikan bersama oleh peneliti AI François Chollet (pencipta Keras) dan Mike Knoop (co-founder Zapier). Tolok ukur ini dibangun berdasarkan prinsip yang dilihat tim ARC Prize sebagai inti: kecerdasan sejati bukan tentang seberapa banyak sebuah sistem mengetahui, melainkan seberapa efisien ia dapat mempelajari sesuatu yang benar-benar baru.
Jika evaluasi AI sebelumnya menguji pengetahuan terkristalisasi (mengambil fakta yang dihafal, menerapkan heuristik yang dilatih), ARC-AGI-3 menargetkan kecerdasan cair, kemampuan untuk menalar melalui masalah baru dan beradaptasi dengan situasi baru alih-alih mengandalkan apa yang dipelajari saat pelatihan. Benchmark ini mengukur apakah sebuah agen AI dapat mengeksplorasi lingkungan yang belum dikenal, memahami aturannya, mengidentifikasi seperti apa "menang", lalu bertindak berdasarkan pemahaman itu secara efisien.
Tolok ukur ini mencakup 135 lingkungan di set publik, semi-pribadi, dan sepenuhnya pribadi. Setiap lingkungan adalah skenario berbasis giliran mirip gim yang dibuat oleh tim desain internal. Agen tidak menerima petunjuk apa pun. Agen hanya mengamati keadaan dunia, mengambil tindakan, melihat apa yang terjadi, dan mengulanginya.
Makalah teknis menjelaskan tolok ukur ini sebagai pengujian empat kemampuan inti: eksplorasi, pemodelan, penetapan tujuan, dan perencanaan.
Untuk memastikan tolok ukur ini mengukur penalaran alih-alih ingatan terhadap data pelatihan, lingkungan ARC-AGI-3 menghindari bahasa, angka, huruf, simbol budaya, atau objek dunia nyata yang mudah dikenali. Sebagai gantinya, lingkungan-lingkungan ini hanya mengandalkan apa yang disebut tim ARC Prize sebagai "Core Knowledge priors", kemampuan kognitif dasar yang dimiliki semua manusia.
Priors ini mencakup sifat kebendaan (memahami bahwa benda adalah entitas yang persisten yang dapat bergerak atau bertabrakan), geometri dan topologi dasar (simetri, rotasi, "di dalam" versus "di luar"), fisika dasar (momentum, gravitasi, pantulan), dan sifat keagenan (mengenali ketika sesuatu di lingkungan bertindak dengan niat). Jika suatu lingkungan mengharuskan mengetahui bahwa kunci membuka gembok, itu akan menguji data pelatihan, bukan penalaran.
Peralihan dari evaluasi statis ke lingkungan interaktif mengubah apa yang sebenarnya dapat diukur oleh tolok ukur ini.
Setiap lingkungan ARC-AGI-3 menyajikan grid 64×64 di mana setiap sel menampilkan satu dari 16 warna yang mungkin. Agen menerima keadaan visual (disebut "frame") sebagai objek JSON, lalu mengirimkan satu tindakan per giliran. Ruang aksi kecil: biasanya lima perintah arah atau berbasis tombol, ditambah aksi "klik" opsional berbasis koordinat untuk memilih sel grid tertentu.
Lingkungan bersifat ketat berbasis giliran. Tidak ada yang berubah sampai agen bertindak, yang berarti tolok ukur ini memberi penghargaan pada penalaran yang saksama ketimbang refleks cepat. Yang penting, operasi internal seperti langkah penalaran, percobaan ulang, atau pemanggilan alat tidak dihitung sebagai tindakan. Hanya perintah yang benar-benar mengubah keadaan lingkungan yang dihitung terhadap skor agen.
Setiap lingkungan berisi beberapa level yang disusun menurut tingkat kesulitan yang meningkat. Level pertama bertindak sebagai tutorial, memperkenalkan mekanik dasar dengan kompleksitas minimal. Level selanjutnya menambahkan aturan dan interaksi baru, sehingga agen harus membawa pembelajaran sebelumnya dan menerapkannya dalam situasi yang lebih kompleks.
Kesulitan di ARC-AGI-3 tidak berasal dari hal yang samar atau skala besar. Kesulitan muncul dari komposisi beberapa mekanik yang dipelajari di berbagai level. Lingkungan dengan satu mekanik saja akan terlalu mudah untuk di-brute force. Ujian sesungguhnya adalah menggabungkan beberapa dinamika yang telah dipelajari untuk menyelesaikan masalah yang belum pernah dilihat agen sebelumnya.
Tolok ukur ini berjalan pada mesin kustom berbasis Python yang dirancang untuk memenuhi ambang kinerja 1.000 FPS dalam mode headless. Pengembang dapat memulai dengan pip install arc-agi dan berinteraksi dengan lingkungan melalui SDK atau REST API. Anda juga dapat memainkan lingkungan publik di peramban Anda untuk merasakan seperti apa gim-gim ini.
Satu hal yang perlu dicatat sejak awal: skor ini mencerminkan kondisi papan peringkat pada akhir Maret 2026 dan hampir pasti akan berubah seiring para peneliti mengembangkan pendekatan baru.
Saat peluncuran, ARC Prize Foundation menguji beberapa model terdepan pada set evaluasi semi-pribadi.
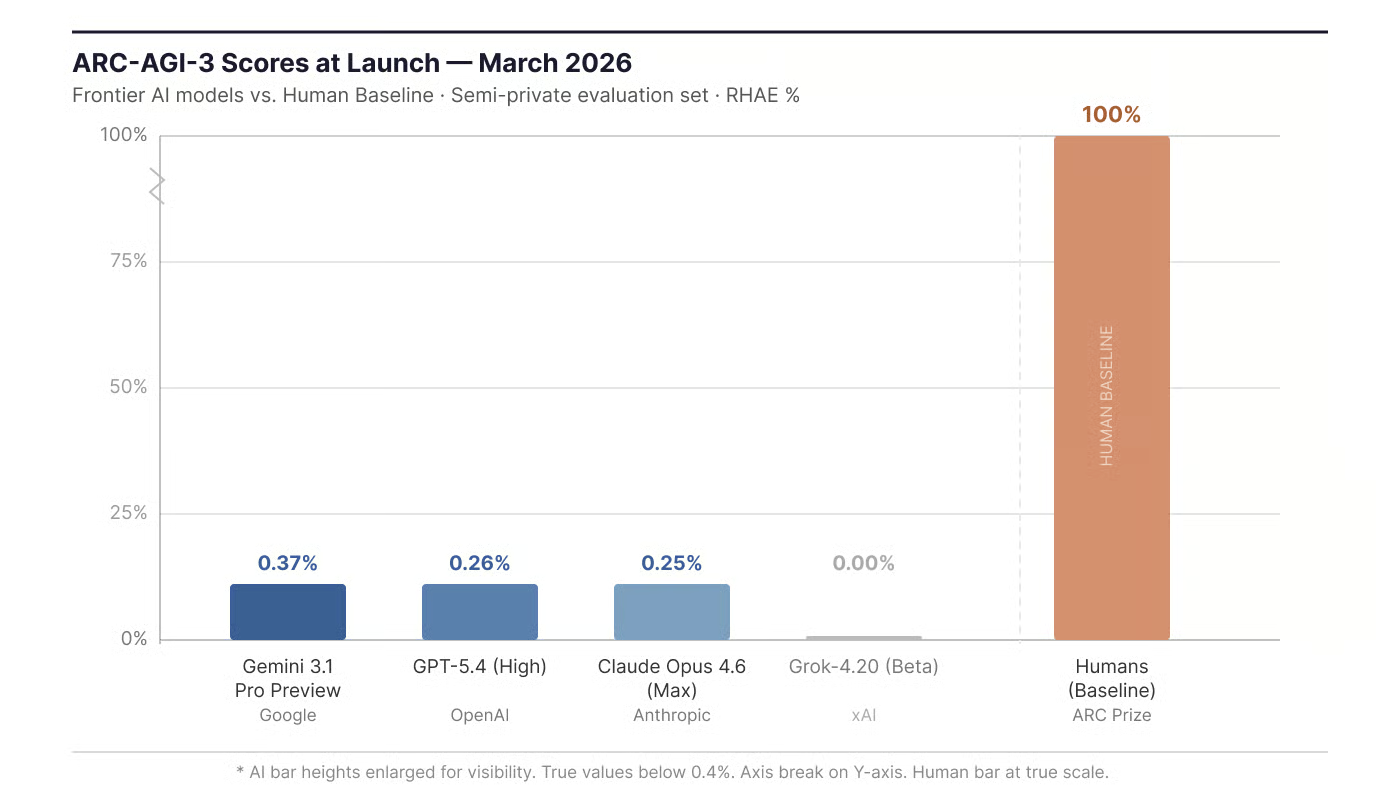
Skor saat peluncuran (Maret 2026): AI terdepan versus baseline manusia. Gambar oleh Penulis.
Sebagai konteks, model-model terdepan yang sama mendominasi sebagian besar tolok ukur AI lainnya. ARC-AGI-1 mendekati kejenuhan, dengan model-model teratas kini mencetak jauh di atas 90%. Penurunan menjadi di bawah 1% pada ARC-AGI-3 menunjukkan bahwa kapabilitas yang diuji di sini berbeda dari hal yang saat ini dikuasai model-model tersebut.
Skor 0% untuk Grok-4.20 bukan berarti model tersebut tidak pernah melakukan tindakan. Artinya, model melampaui batas tindakan tolok ukur pada setiap level. Saya akan jelaskan bagaimana batas itu bekerja di bagian penilaian.
Agen dengan skor tertinggi selama periode pratinjau bukanlah model bahasa. Selama kompetisi pratinjau (yang menggunakan 3 lingkungan publik dan 3 lingkungan privat sebagai set evaluasi tersembunyi), sebuah sistem bernama StochasticGoose dari Tufa Labs mencapai 12,58% menggunakan pendekatan reinforcement learning dengan convolutional neural networks.
Namun ketika StochasticGoose dievaluasi pada tolok ukur resmi penuh saat peluncuran, skornya turun menjadi 0,25%, kira-kira setara dengan LLM terdepan. Hasil ini mencerminkan: pendekatan yang bekerja baik pada segelintir lingkungan yang sudah dikenal menjadi jauh lebih buruk saat menghadapi rentang penuh lingkungan yang belum terlihat, menegaskan betapa ARC-AGI-3 sangat bergantung pada kemampuan adaptasi umum alih-alih optimasi spesifik tugas.
Ini menunjukkan format interaktif mungkin lebih cocok dengan arsitektur berbeda, karena model bahasa tidak dapat menalar sebuah masalah ketika informasi yang diperlukan baru muncul setelah setiap tindakan.
Anda dapat memeriksa skor terbaru di papan peringkat ARC-AGI-3.
Angka-angka itu terlihat berbeda setelah Anda mengetahui apa yang diuji oleh tolok ukur ARC sebelumnya. ARC-AGI-1, dirilis oleh Chollet pada 2019, memperkenalkan konsep pengukuran kecerdasan cair melalui teka-teki visual abstrak. Formanya statis: model melihat beberapa contoh grid input-output, menyimpulkan aturan transformasi, dan menghasilkan satu output. ARC-AGI-2, dirilis pada Maret 2025, menggunakan format statis yang sama tetapi dengan tugas yang lebih sulit dan lebih komposisional.
ARC-AGI-1 membantu mengidentifikasi kemunculan model penalaran besar sebagai kategori baru, dengan o3 dari OpenAI menjadi tanda pertama yang jelas. ARC-AGI-2 melacak seberapa cepat kemampuan penalaran itu meningkat. Namun format statis memiliki kerentanan: penskalaan komputasi saat waktu uji. Dengan menghasilkan ribuan kandidat solusi secara paralel selama inferensi, lab mendorong skor ARC-AGI-2 dari angka satu digit menjadi jauh di atas 50% dalam waktu kurang dari setahun.
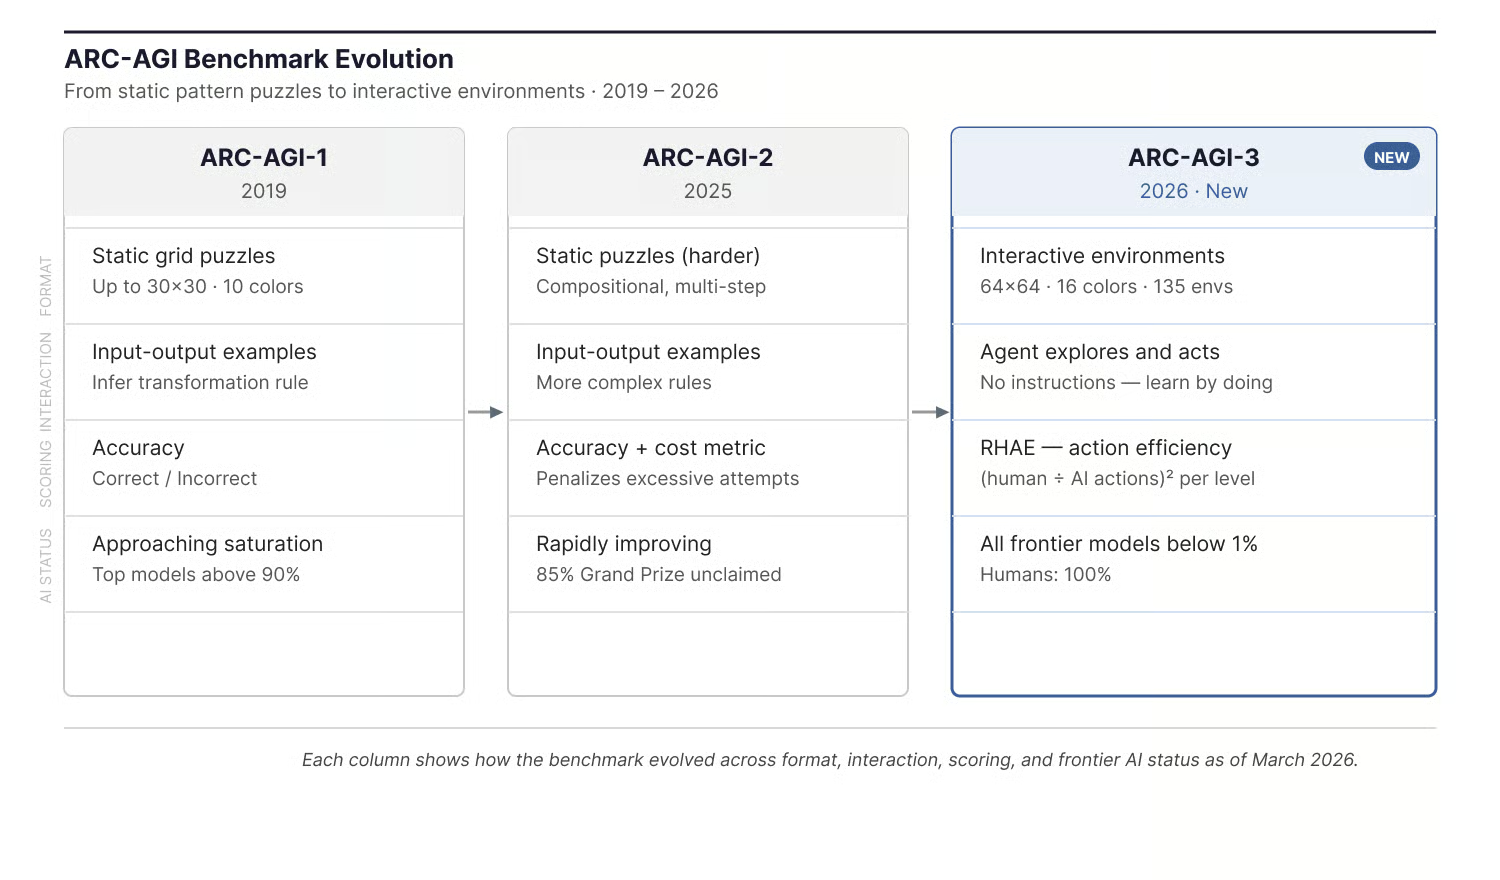
Evolusi tolok ukur ARC-AGI dari waktu ke waktu. Gambar oleh Penulis.
ARC-AGI-3 membuat strategi sampling brute force jauh lebih sulit dilakukan karena, seperti saya sebutkan sebelumnya, lingkungan hanya mengungkap aturannya setelah agen bertindak. Anda tidak dapat menghasilkan 10.000 kandidat solusi dalam jendela konteks ketika masalah berubah dengan setiap tindakan.
Selain format interaktif, ARC-AGI-3 mencakup pilihan rancangan spesifik yang dimaksudkan untuk menanggulangi kontaminasi data dan jalan pintas generasi sintetis yang memengaruhi versi sebelumnya. Perubahan paling mencolok adalah rasio dataset yang dibalik. ARC-AGI-1 dan ARC-AGI-2 memiliki rasio kira-kira 10:1 antara tugas publik dan privat, memberikan peneliti banyak materi pelatihan. ARC-AGI-3 membaliknya: hanya 25 lingkungan yang bersifat publik, sementara sebagian besar disimpan dalam set semi-pribadi dan sepenuhnya pribadi untuk evaluasi.
Tim ARC Prize juga menandai bukti yang menunjukkan beberapa model terdepan mungkin memiliki data ARC dalam set pelatihannya. Selama evaluasi ARC-AGI-2, penalaran rantai-pikir Gemini 3 merujuk pemetaan warna khusus ARC tanpa diminta, yang mengindikasikan kejenuhan data pelatihan. Dengan mengurangi area publik dan beralih ke lingkungan interaktif yang tidak dapat dihafal sebagai pola statis, ARC-AGI-3 bertujuan membuat jenis jalan pintas ini jauh lebih sulit.
Pilihan rancangan tersebut lebih masuk akal setelah Anda memahami apa yang sebenarnya coba diuji oleh tolok ukur ini. Benchmark ini menargetkan apa yang digambarkan tim ARC Prize sebagai "efisiensi perolehan keterampilan": seberapa efisien agen AI dapat mempelajari sesuatu yang belum pernah ditemuinya.
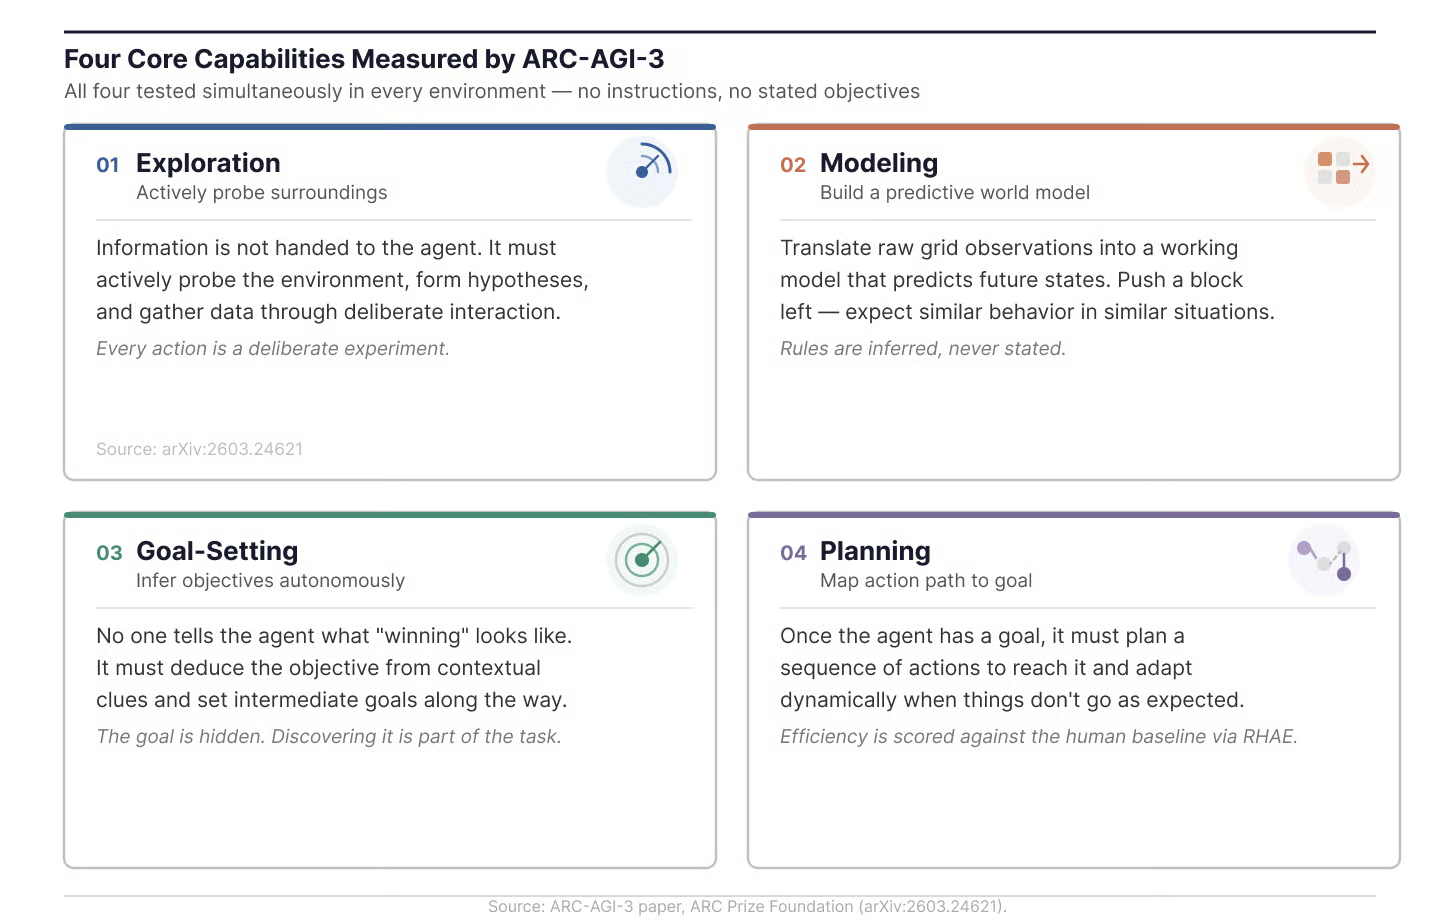
Empat kemampuan inti yang diukur ARC-AGI-3. Gambar oleh Penulis.
Keempat area ini diuji secara bersamaan di setiap lingkungan, tanpa instruksi dan tanpa tujuan yang dinyatakan kapan pun.
Skor 100% pada ARC-AGI-3 berarti agen AI dapat menyelesaikan setiap lingkungan seefisien penguji manusia terbaik kedua. Tim ARC Prize menegaskan bahwa ini tidak sama dengan AGI. Ini berarti satu kesenjangan tertentu antara pembelajaran AI dan manusia telah tertutup.
Penilaian adalah bagian di mana ARC-AGI-3 paling berbeda dari tolok ukur sebelumnya. Ia tidak hanya memeriksa apakah agen pada akhirnya kebetulan menemukan solusi. Benchmark ini mengukur seberapa efisien agen mencapainya.
Metriknya disebut RHAE, singkatan dari Relative Human Action Efficiency. Rumus per level adalah:
Skor Level = min(1.0, (human_baseline_actions / AI_actions))²
Detail kunci adalah suku berpangkat dua. Ini bukan hubungan linear. Melipatgandakan jumlah tindakan tidak mengurangi skor menjadi separuh; melainkan seperempat. Sepuluh kali lipat tindakan menurunkan skor menjadi hampir nol. Desain hukum pangkat ini sangat menghukum pendekatan brute force dan memberi penghargaan pada agen yang benar-benar mempelajari cara kerja lingkungan.
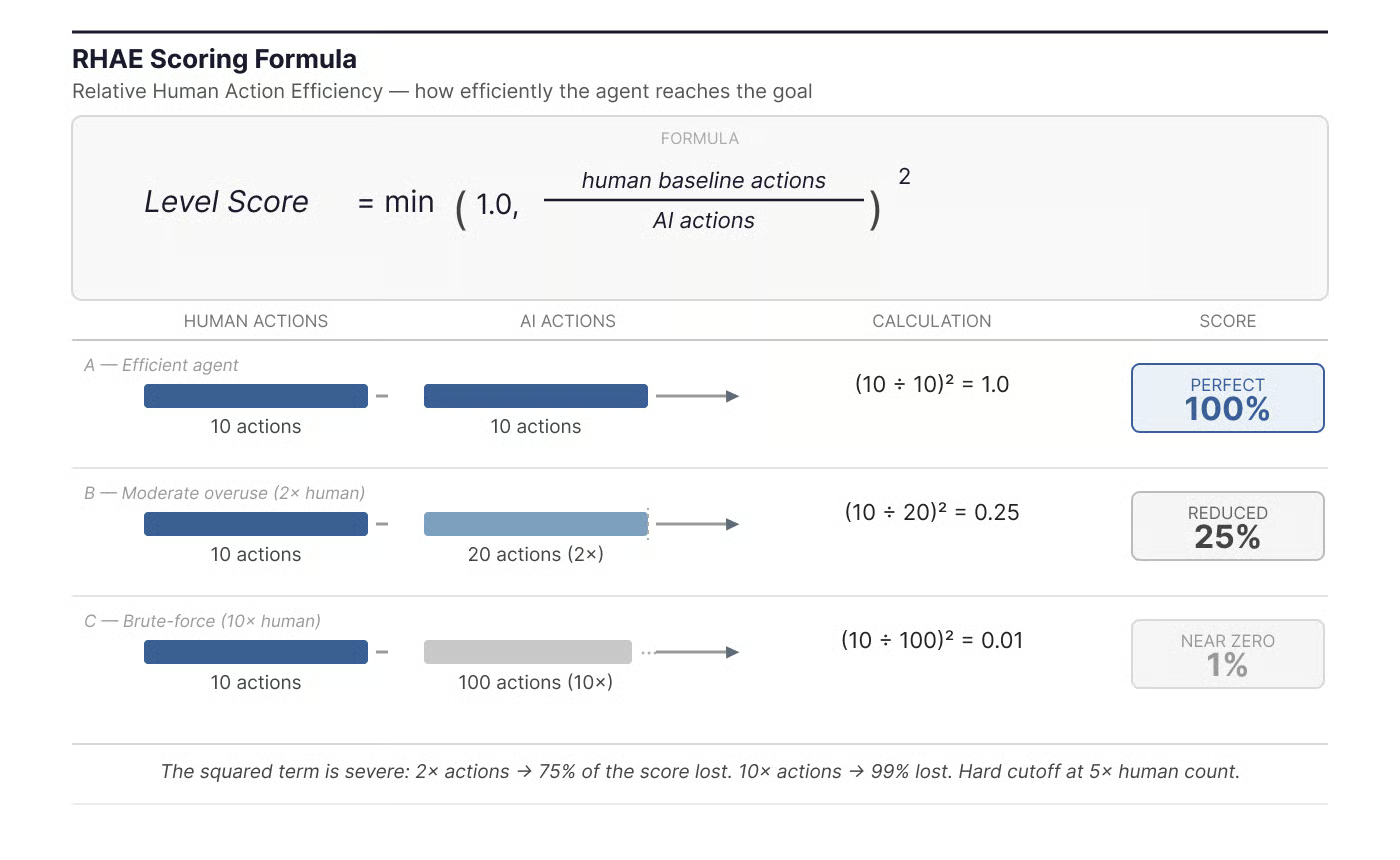
Rumus penilaian RHAE dengan contoh yang diuraikan. Gambar oleh Penulis.
Baseline manusia ditetapkan oleh performer terbaik kedua dari 10 penguji yang mencoba setiap lingkungan pada paparan pertama. Menggunakan yang terbaik kedua alih-alih yang terbaik absolut menyaring outlier beruntung sekaligus tetap berpijak pada permainan nyata.
Ada juga batas keras: jika agen melakukan lebih dari 5× jumlah tindakan manusia pada level mana pun, agen tersebut dihentikan dan mendapat skor nol untuk level itu. Dan skor dibatasi pada 1,0, jadi menemukan jalan pintas tak terduga yang mengalahkan baseline manusia tidak memberi kredit bonus.
Di dalam setiap lingkungan, level yang lebih akhir bernilai lebih besar. Penilaian menggunakan rata-rata berbobot di mana Level 1 berbobot 1, Level 2 berbobot 2, dan seterusnya. Ini berarti level tutorial nyaris tidak memengaruhi skor, sementara level yang lebih sulit yang memerlukan penggabungan beberapa mekanik yang dipelajari memiliki bobot paling besar.
ARC-AGI-3 mempertahankan dua papan peringkat terpisah dengan aturan berbeda. Papan Peringkat Resmi mengevaluasi model terdepan menggunakan sistem API serbaguna yang tidak dipersiapkan secara khusus untuk ARC-AGI-3. Papan Peringkat Komunitas mengizinkan hasil yang dilaporkan sendiri dan memperbolehkan harness. Pembedaan ini penting karena, seperti saya sebutkan sebelumnya, harness buatan tangan dapat secara dramatis menggembungkan skor pada lingkungan yang sudah dikenal tetapi gagal total pada lingkungan yang belum terlihat. Papan Peringkat Resmi dirancang untuk mengukur kemampuan adaptasi AI yang sesungguhnya, bukan perancah pengembang.
ARC-AGI-3 adalah pusat kompetisi tahun ini, namun bukan satu-satunya jalur.
ARC Prize 2026 memiliki total hadiah lebih dari $2 juta yang dibagi di tiga jalur. Jalur ARC-AGI-3 menawarkan $850.000 dalam total hadiah, dipimpin oleh Hadiah Utama $700.000 untuk agen memenuhi syarat pertama yang mencapai 100% pada set evaluasi sepenuhnya privat. Jika tidak ada yang meraihnya tahun ini, dana akan dibawa ke 2027. Selain Hadiah Utama, ada penghargaan skor tertinggi $75.000 yang dibagi di antara lima finisher teratas, dan dua titik pencapaian (30 Juni dan 30 September 2026) masing-masing mendistribusikan $37.500 kepada tiga tim teratas pada tanggal tersebut.
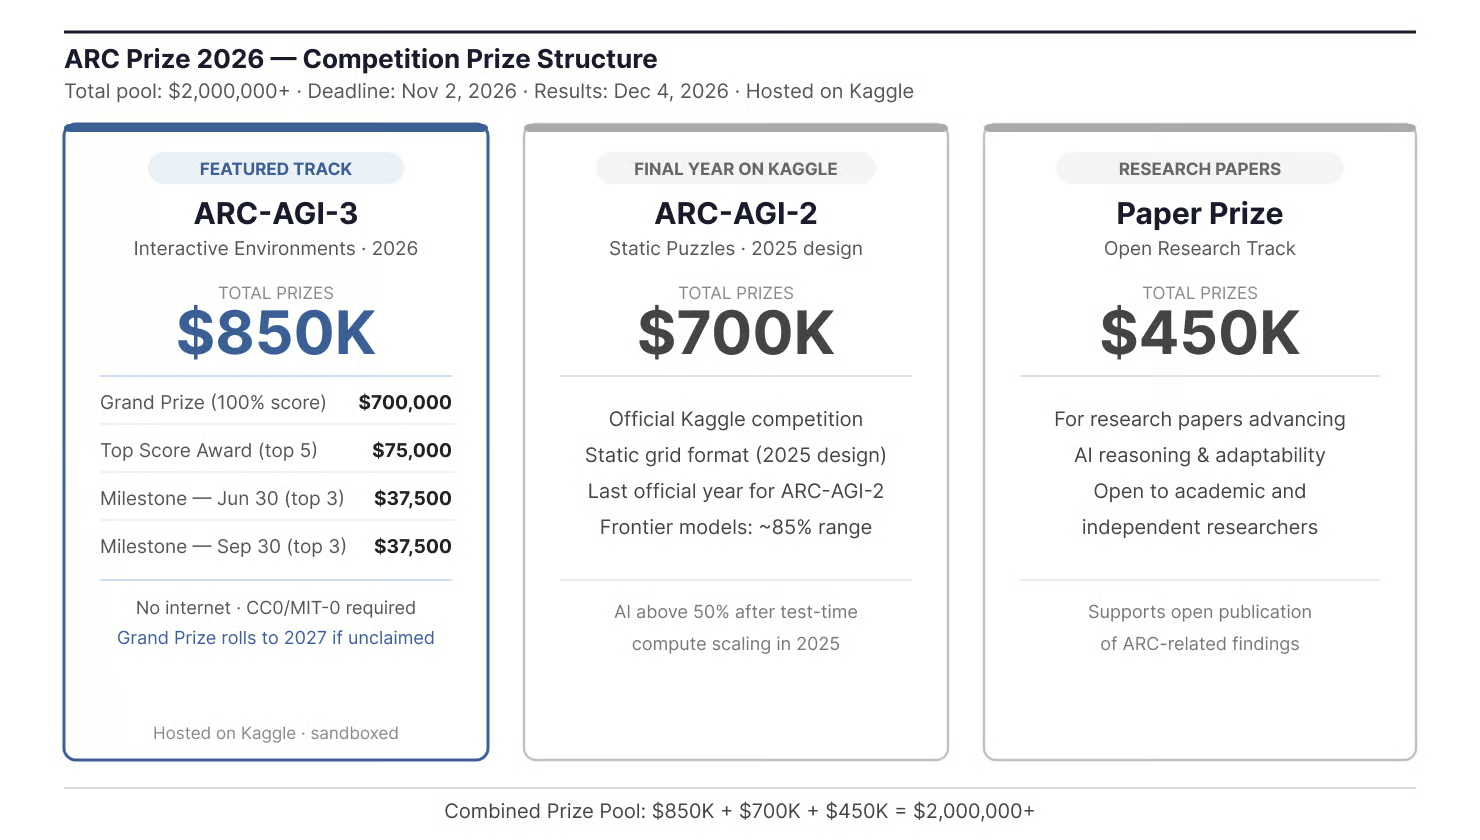
Struktur hadiah kompetisi ARC Prize 2026. Gambar oleh Penulis.
Dua jalur lainnya adalah jalur ARC-AGI-2 ($700.000, dan patut dicatat bahwa ini adalah tahun terakhir ARC-AGI-2 digunakan dalam kompetisi Kaggle resmi) dan jalur Paper Prize ($450.000 untuk makalah riset).
Kompetisi berjalan di Kaggle, tetapi dengan aturan yang membedakannya dari kompetisi Kaggle tipikal. Submisi dievaluasi dalam lingkungan sandbox tanpa akses internet, yang meniadakan pemanggilan API ke model yang dihosting seperti GPT, Claude, atau Gemini. Semua solusi yang memenuhi syarat hadiah harus dirilis di bawah lisensi permisif atau domain publik (CC0 atau MIT-0) sebelum menerima skor evaluasi privat. Kompetisi dibuka pada 25 Maret 2026, dengan tenggat submisi final 2 November 2026, dan hasil diumumkan pada 4 Desember 2026.
Tolok ukur paling berarti ketika mereka mengungkap celah yang sebelumnya tidak terlihat sebagai celah. Dengan ukuran itu, dua tolok ukur ARC pertama layak mendapatkan tempatnya: ARC-AGI-1 menampilkan kemunculan model penalaran besar, dan ARC-AGI-2 melacak seberapa jauh penskalaan komputasi saat waktu uji dapat melaju. ARC-AGI-3 menunjuk pada masalah yang berbeda.
Yang membuat tolok ukur ini relevan saat ini adalah konteks. Per awal 2026, banyak tolok ukur AI yang banyak digunakan mendekati kejenuhan. Model-model terdepan mencetak di atas 90% pada MMLU, HumanEval, dan GSM8K, di antaranya, yang membatasi seberapa banyak evaluasi ini dapat memberi tahu kita tentang perbedaan antar sistem. ARC-AGI-3 menguji kemampuan yang tampaknya kurang pada model saat ini: belajar secara langsung di dalam lingkungan yang tidak dikenal. Kesenjangan antara skor AI di bawah 1% dan keterpecahan 100% oleh manusia cukup besar untuk menyiratkan ini bukan sekadar versi lebih sulit dari tes yang sama, melainkan jenis tantangan yang berbeda.
ARC Prize memosisikan ARC-AGI-3 sebagai tes terpenting untuk penalaran interaktif, meski perlu diingat bahwa framing itu datang dari organisasi yang menjalankan tolok ukur. Apakah klaim itu bertahan tergantung pada bagaimana tolok ukur ini berjalan seiring para peneliti beradaptasi dengannya.
Tidak ada tolok ukur yang sempurna, dan ARC-AGI-3 telah menerima beberapa kritik yang patut dicatat.
Salah satu kekhawatiran umum adalah rumus penilaiannya sendiri. Metrik efisiensi berpangkat dua sangat menghukum eksplorasi, yang bisa dibilang merupakan tanda kecerdasan alih-alih kegagalan. Jika agen menghabiskan 50 tindakan untuk memetakan kondisi batas secara cermat sebelum mencapai solusi, skornya jauh lebih buruk daripada manusia yang menebak aturan dalam 5 tindakan. Beberapa anggota komunitas berpendapat ini membuat kesenjangan kinerja terlihat secara artifisial besar.
Ada juga pertanyaan tentang pemilihan baseline. Seperti yang saya bahas di bagian penilaian, tolok ukur ini menggunakan penguji manusia terbaik kedua alih-alih rata-rata, yang menetapkan standar tinggi. Bahkan manusia rata-rata akan mendapat skor di bawah 100% dengan pendekatan ini.
Tim ARC Prize menyajikan tolok ukur ini sebagai upaya ilmiah untuk mengukur kemampuan yang hilang secara spesifik, bukan tes definitif kecerdasan umum. Itu adalah pembacaan yang wajar mengingat apa yang kita ketahui saat ini.
ARC-AGI-3 mengambil pendekatan berbeda untuk mengevaluasi sistem AI. Dengan beralih dari teka-teki statis ke lingkungan interaktif, tolok ukur ini menguji apakah model dapat mengeksplorasi, menetapkan tujuannya sendiri, dan menemukan solusi melalui pengalaman alih-alih instruksi.
Angka awalnya mencolok. Model yang mendominasi tolok ukur pengkodean, kompetisi matematika, dan uji pengetahuan kesulitan menembus 1% di sini. Apakah kesenjangan itu akan cepat tertutup, seperti pada tolok ukur ARC sebelumnya, atau apakah format interaktif terbukti lebih sulit dipecahkan, adalah sesuatu yang menurut saya layak dipantau secara saksama.
Untuk lebih lanjut tentang konsep di balik sistem AI adaptif, lihat AI Fundamentals skill track kami atau kursus kami tentang Membangun Sistem Agen Skala Besar.
Belajar bersama DataCamp
Kursus
Kursus
Kursus
blogs
Javier Canales Luna
14 mnt
blogs
Dario Radečić
15 mnt
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt