Curso
Comprender la inteligencia artificial
2 h
426.1K
La mayoría de benchmarks de IA siguen la misma fórmula: plantea una pregunta al modelo, obtén una respuesta y comprueba si es correcta. Durante años, este enfoque fue suficiente. Pero a medida que los modelos de frontera empezaron a superar el 90% en casi todas las evaluaciones importantes, surgió un problema conocido: los benchmarks dejaron de diferenciar con precisión entre modelos.
ARC-AGI-3 propone algo distinto. En lugar de presentar puzles estáticos con pares claros de entrada-salida, sitúa a agentes de IA en entornos interactivos sin instrucciones, sin objetivos declarados y sin reglas explícitas. El agente tiene que descubrirlo todo por sí mismo mediante prueba y observación, igual que haría una persona al enfrentarse a un juego que nunca ha visto.
Lanzado el 25 de marzo de 2026 por la ARC Prize Foundation, ARC-AGI-3 ofreció un dato llamativo desde el primer día: todos los modelos de frontera puntuaron por debajo del 1%, mientras que las personas resolvieron todos los entornos del benchmark.
ARC-AGI-3 es un benchmark de razonamiento interactivo creado por la ARC Prize Foundation, cofundada por el investigador en IA François Chollet (creador de Keras) y Mike Knoop (cofundador de Zapier). El benchmark se articula alrededor de un principio clave según el equipo de ARC Prize: la verdadera inteligencia no trata de cuánto sabe un sistema, sino de cuán eficazmente puede aprender algo completamente nuevo.
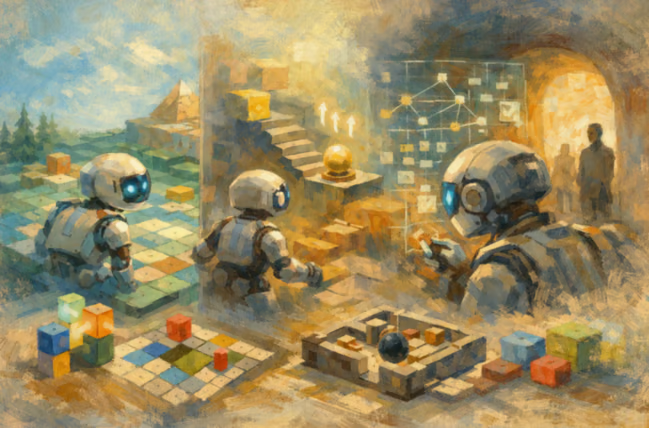
Mientras que las evaluaciones anteriores de IA miden conocimiento cristalizado (recuperar hechos memorizados, aplicar heurísticas aprendidas), ARC-AGI-3 apunta a la inteligencia fluida: la capacidad de razonar ante problemas novedosos y adaptarse a situaciones nuevas en lugar de apoyarse en lo aprendido durante el entrenamiento. Mide si un agente de IA es capaz de explorar un entorno desconocido, deducir sus reglas, identificar qué significa "ganar" y luego actuar con eficiencia en base a ese entendimiento.
El benchmark incluye 135 entornos distribuidos entre conjuntos públicos, semiprivados y totalmente privados. Cada entorno es un escenario por turnos, similar a un juego, diseñado por un equipo interno. El agente no recibe ninguna pista. Simplemente observa el estado del mundo, realiza una acción, ve qué ocurre y repite.
El artículo técnico describe el benchmark como una prueba de cuatro capacidades básicas: exploración, modelado, definición de objetivos y planificación.
Para asegurarse de que el benchmark mide razonamiento y no memoria del conjunto de entrenamiento, los entornos de ARC-AGI-3 evitan el lenguaje, los números, las letras, los símbolos culturales o objetos del mundo real reconocibles. En su lugar, se basan únicamente en lo que el equipo de ARC Prize denomina "conocimientos previos de Core Knowledge": capacidades cognitivas básicas compartidas por todos los humanos.
Estos conocimientos incluyen la noción de objetos (entender que las cosas son entidades persistentes que pueden moverse o chocar), geometría y topología básicas (simetría, rotación, "dentro" frente a "fuera"), física básica (inercia, gravedad, rebote) y la noción de agente (reconocer cuándo algo en el entorno actúa con intención). Si un entorno exigiera saber que una llave abre una cerradura, estaría midiendo datos de entrenamiento, no razonamiento.
El paso de una evaluación estática a entornos interactivos cambia lo que el benchmark puede medir realmente.
Cada entorno de ARC-AGI-3 presenta una cuadrícula de 64×64 donde cada celda muestra uno de 16 colores posibles. El agente recibe un estado visual (un "frame") como objeto JSON y envía una única acción por turno. El espacio de acciones es reducido: normalmente cinco comandos direccionales o de teclas, más una acción opcional de "clic" por coordenadas para seleccionar celdas concretas de la cuadrícula.
Los entornos son estrictamente por turnos. Nada cambia hasta que el agente actúa, lo que significa que el benchmark premia el razonamiento cuidadoso por encima de los reflejos rápidos. Importante: las operaciones internas como pasos de razonamiento, reintentos o llamadas a herramientas no cuentan como acciones. Solo se contabilizan las órdenes que realmente cambian el estado del entorno para la puntuación del agente.
Cada entorno contiene varios niveles ordenados por dificultad creciente. El primer nivel actúa como tutorial, presentando las mecánicas básicas con mínima complejidad. En los niveles posteriores se añaden nuevas reglas e interacciones, así que el agente debe trasladar lo aprendido y aplicarlo en situaciones más complejas.
La dificultad en ARC-AGI-3 no proviene de la rareza ni de la escala, sino de la composición de múltiples mecánicas aprendidas a lo largo de los niveles. Un entorno con una sola mecánica sería demasiado fácil de forzar por ensayo y error. La verdadera prueba es combinar varias dinámicas aprendidas para resolver un problema que el agente nunca ha visto.
El benchmark se ejecuta sobre un motor propio basado en Python diseñado para alcanzar 1.000 FPS en modo headless. Los desarrolladores pueden empezar con pip install arc-agi y conectar con los entornos mediante el SDK o una API REST. También puedes jugar a los entornos públicos en tu navegador para hacerte una idea de cómo son estos juegos.
Un aviso previo: estas puntuaciones reflejan el estado del ranking a finales de marzo de 2026 y casi con seguridad cambiarán a medida que se desarrollen nuevos enfoques.
En el lanzamiento, la ARC Prize Foundation probó varios modelos de frontera en el conjunto de evaluación semiprivado.
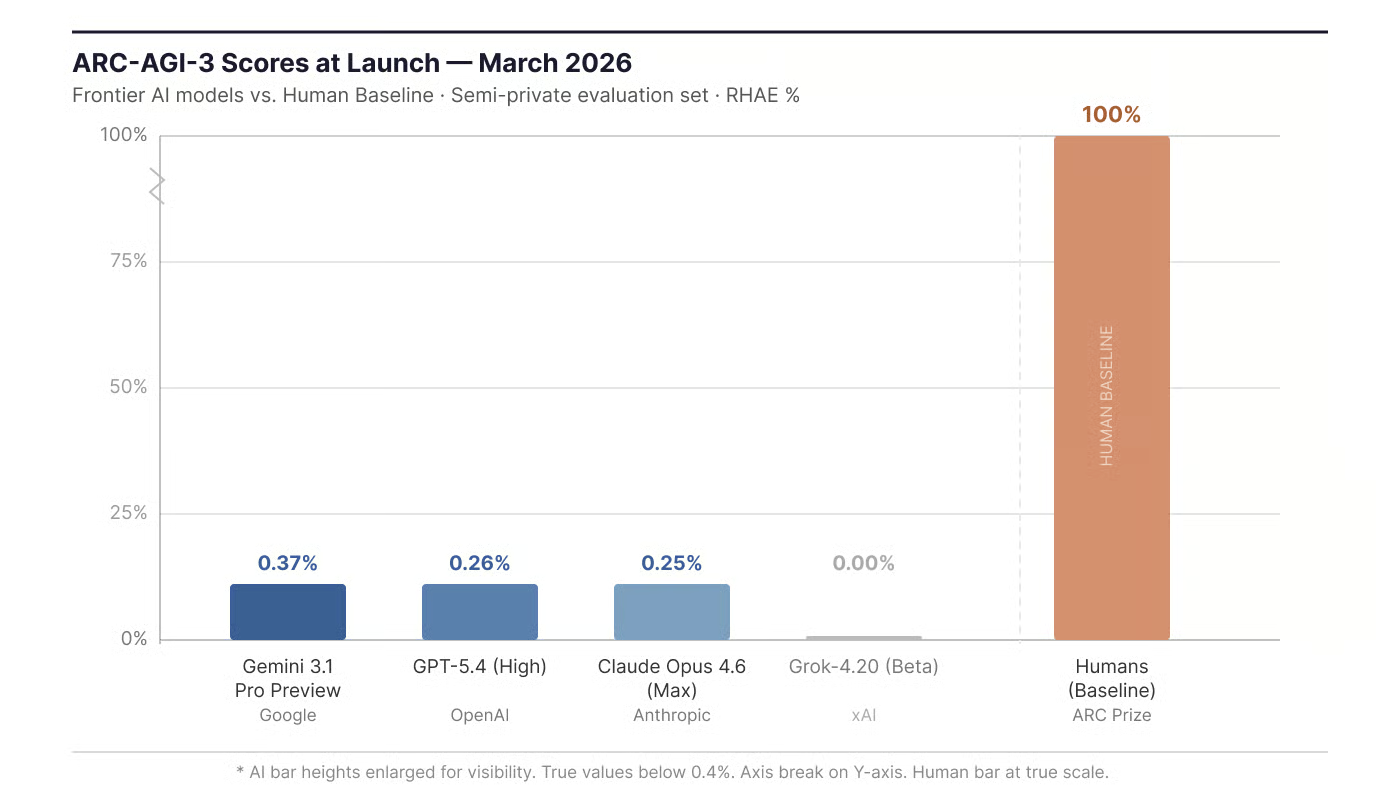
Puntuaciones en el lanzamiento (marzo de 2026): IA de frontera frente a referencia humana. Imagen del autor.
Para situarlo, estos mismos modelos dominan la mayoría de benchmarks de IA. ARC-AGI-1 está cerca de saturarse, con modelos líderes muy por encima del 90%. La caída a menos del 1% en ARC-AGI-3 sugiere que aquí se evalúan capacidades distintas de aquello en lo que los modelos actuales destacan.
El 0% de Grok-4.20 no significa que el modelo no hiciera acciones. Significa que superó el límite de acciones del benchmark en todos los niveles. Explicaré cómo funciona ese límite en la sección de puntuación.
Los agentes con mejor puntuación durante el periodo de vista previa no eran modelos de lenguaje. En la competición preliminar (que usó 3 entornos públicos y 3 privados como conjunto oculto de evaluación), un sistema llamado StochasticGoose de Tufa Labs alcanzó un 12,58% usando un enfoque de aprendizaje por refuerzo con redes neuronales convolucionales.
Sin embargo, al evaluar StochasticGoose en el benchmark oficial completo en el lanzamiento, su puntuación cayó al 0,25%, aproximadamente al nivel de los LLM de frontera. Este resultado es revelador: un enfoque que funcionó bien en unos pocos entornos conocidos rindió mucho peor ante la variedad completa de entornos no vistos, lo que refuerza que ARC-AGI-3 depende sobre todo de la capacidad de adaptación general y no de la optimización específica por tarea.
Esto sugiere que el formato interactivo podría encajar mejor con arquitecturas distintas, ya que un modelo de lenguaje no puede razonar hasta una solución cuando la información necesaria solo aparece tras cada acción.
Puedes consultar las últimas puntuaciones en el ranking de ARC-AGI-3.
Estas cifras se entienden mejor sabiendo qué medían los ARC anteriores. ARC-AGI-1, lanzado por Chollet en 2019, introdujo la idea de medir inteligencia fluida con puzles visuales abstractos. El formato era estático: el modelo veía algunos ejemplos de cuadrículas con pares entrada-salida, infería la regla de transformación y producía una única salida. ARC-AGI-2, lanzado en marzo de 2025, mantuvo el formato estático pero con tareas más difíciles y composicionales.
ARC-AGI-1 ayudó a identificar la aparición de los grandes modelos de razonamiento como nueva categoría, con o3 de OpenAI como primera señal clara. ARC-AGI-2 siguió el ritmo al que escalaba esa capacidad de razonamiento. Pero el formato estático tenía una vulnerabilidad: el escalado del cómputo en tiempo de inferencia. Generando miles de soluciones candidatas en paralelo durante la inferencia, los laboratorios empujaron las puntuaciones de ARC-AGI-2 de un dígito a muy por encima del 50% en menos de un año.
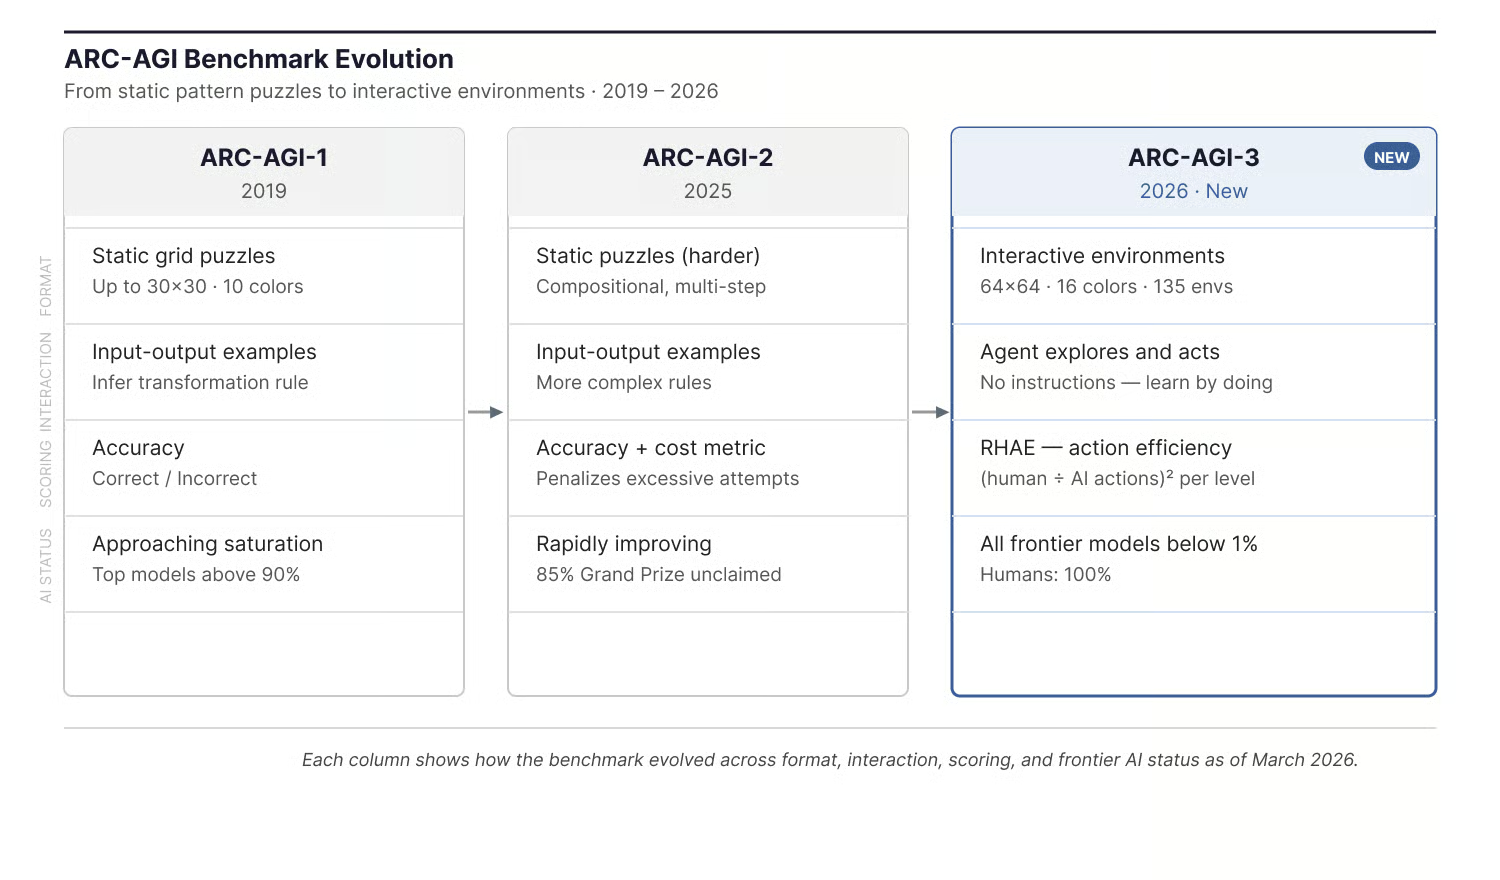
Evolución de los benchmarks ARC-AGI a lo largo del tiempo. Imagen del autor.
ARC-AGI-3 dificulta mucho la estrategia de muestreo por fuerza bruta porque, como comentaba antes, el entorno solo revela sus reglas después de que el agente actúe. No puedes generar 10.000 soluciones candidatas en una ventana de contexto cuando el problema cambia con cada acción.
Más allá del formato interactivo, ARC-AGI-3 incorpora decisiones de diseño para contrarrestar la contaminación de datos y la generación sintética que afectaron a versiones anteriores. El cambio más notable es la inversión de la proporción del conjunto de datos. ARC-AGI-1 y ARC-AGI-2 tenían una relación de aproximadamente 10:1 entre tareas públicas y privadas, ofreciendo abundante material de entrenamiento. ARC-AGI-3 lo invierte: solo 25 entornos son públicos, mientras que la gran mayoría se reserva en conjuntos semiprivados y privados para evaluación.
El equipo de ARC Prize también señaló indicios de que algunos modelos de frontera podrían tener datos de ARC en su entrenamiento. Durante la evaluación de ARC-AGI-2, el razonamiento paso a paso de Gemini 3 hacía referencia a mapeos de colores específicos de ARC sin que se le pidiera, lo que sugiere saturación de datos de entrenamiento. Al reducir la superficie pública y pasar a entornos interactivos que no pueden memorizarse como patrones estáticos, ARC-AGI-3 busca dificultar mucho este tipo de atajo.
Estas decisiones de diseño se entienden mejor al ver qué intenta evaluar en realidad el benchmark. El objetivo es lo que el equipo de ARC Prize denomina "eficiencia en la adquisición de habilidades": cuán rápido y bien puede un agente de IA aprender algo que no ha visto nunca.
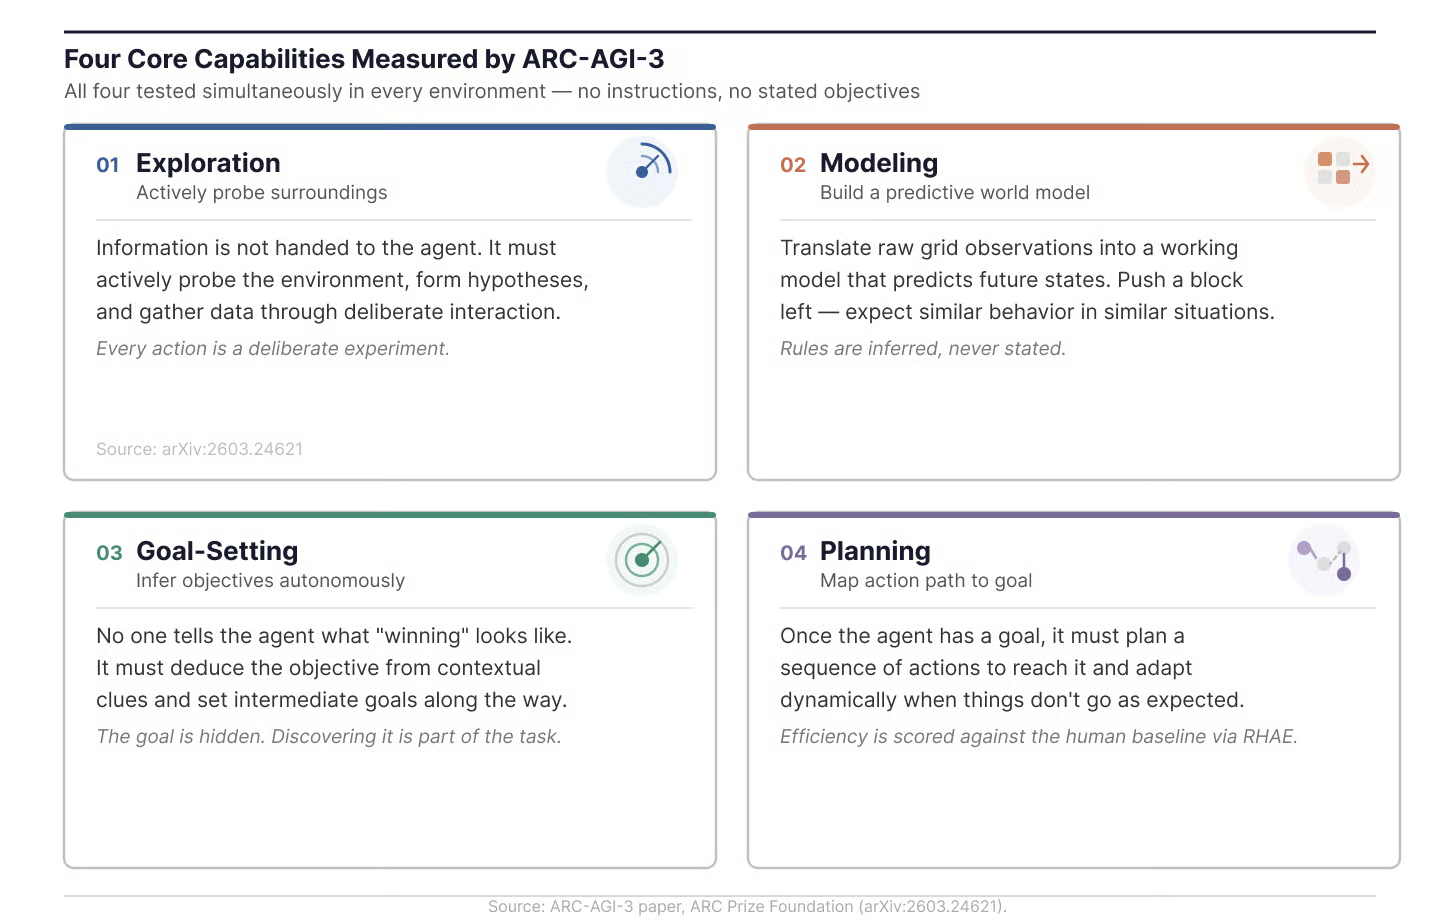
Cuatro capacidades básicas medidas por ARC-AGI-3. Imagen del autor.
Estas cuatro áreas se ponen a prueba de forma simultánea en cada entorno, sin instrucciones ni objetivos explícitos en ningún momento.
Un 100% en ARC-AGI-3 significaría que un agente de IA resuelve todos los entornos con la misma eficiencia que el segundo mejor tester humano. El equipo de ARC Prize deja claro que eso no equivale a AGI. Significa que se habría cerrado una brecha concreta entre el aprendizaje de la IA y el humano.
La puntuación es donde ARC-AGI-3 más se aleja de benchmarks anteriores. No se limita a comprobar si el agente acaba tropezando con la solución. Mide con qué eficiencia llega hasta ella.
La métrica se llama RHAE, de Relative Human Action Efficiency (eficiencia relativa de acciones respecto a humanos). La fórmula por nivel es:
Puntuación de nivel = min(1.0, (acciones_humano_base / acciones_IA))²
La clave es el término al cuadrado. No es una relación lineal. Duplicar el número de acciones no reduce a la mitad la puntuación; la reduce a una cuarta parte. Multiplicarla por diez la deja casi en cero. Este diseño de ley de potencias penaliza con fuerza los enfoques de fuerza bruta y premia a los agentes que realmente aprenden cómo funciona el entorno.
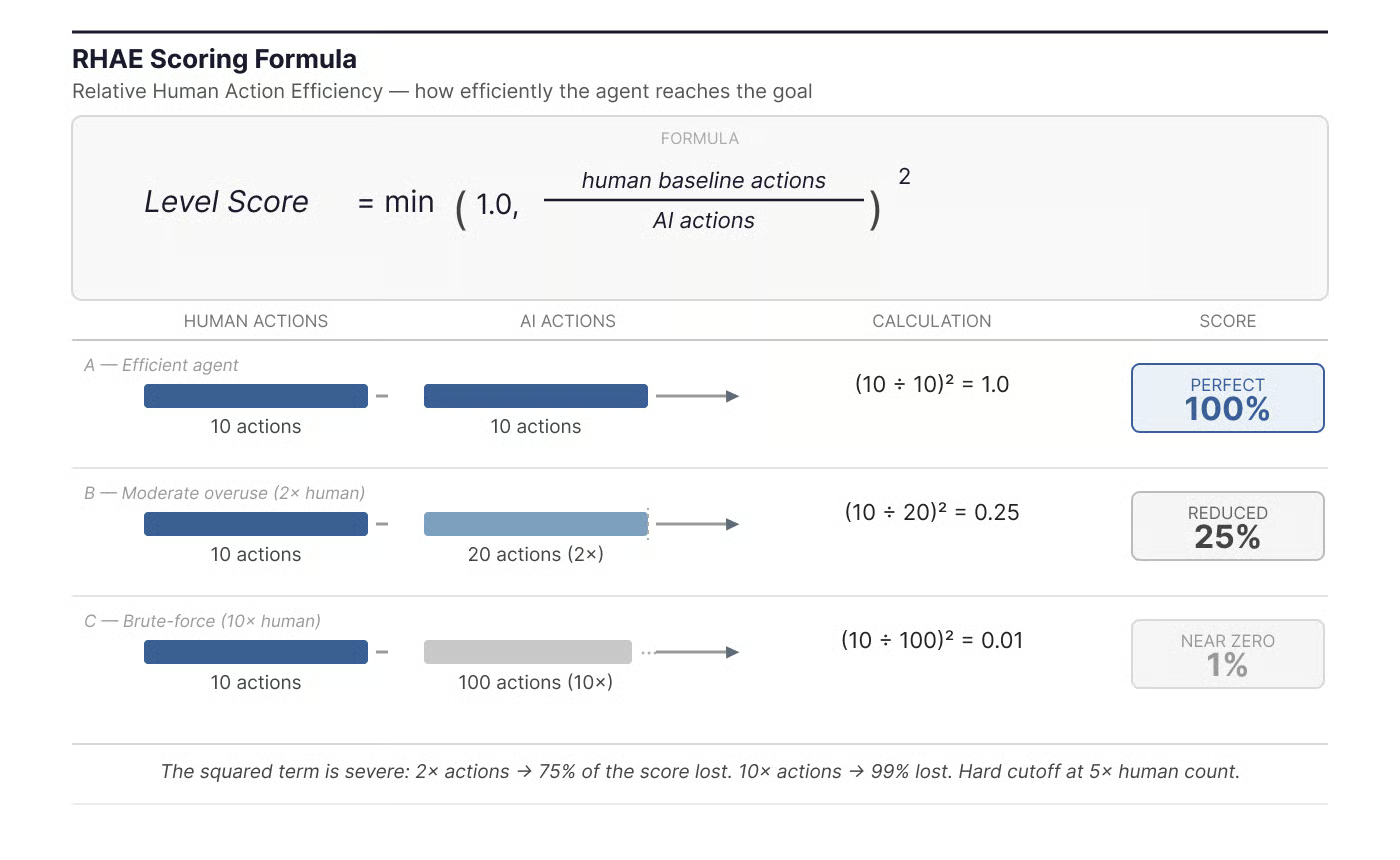
Fórmula RHAE con ejemplos prácticos. Imagen del autor.
La referencia humana se establece con la segunda mejor persona de entre 10 testers que intentaron cada entorno en su primer contacto. Usar la segunda mejor, y no la absoluta mejor, filtra golpes de suerte sin dejar de basarse en juego real.
También hay un corte duro: si un agente realiza más de 5 veces las acciones del humano de referencia en un nivel, se detiene y obtiene cero en ese nivel. Y las puntuaciones se topan en 1,0, así que descubrir un atajo no previsto que mejore la referencia humana no otorga puntos extra.
Dentro de cada entorno, los niveles posteriores pesan más. La puntuación usa una media ponderada donde el nivel 1 tiene peso 1, el nivel 2 peso 2, y así sucesivamente. Esto significa que los niveles tutoriales apenas afectan, mientras que los más difíciles, que exigen combinar varias mecánicas aprendidas, llevan más peso.
ARC-AGI-3 mantiene dos rankings separados con reglas distintas. El ranking Official evalúa modelos de frontera usando sistemas API de propósito general que no han sido preparados específicamente para ARC-AGI-3. El ranking Community permite resultados autoinformados y admite arneses. Esta distinción importa porque, como comenté antes, los arneses hechos a mano pueden inflar de forma notable las puntuaciones en entornos conocidos pero fallar por completo en los no vistos. El ranking Official está diseñado para medir la capacidad real de adaptación de la IA, no el andamiaje del desarrollador.
ARC-AGI-3 es la pieza central de la competición de este año, pero no es el único itinerario.
ARC Prize 2026 reparte más de 2 millones de dólares en premios entre tres itinerarios. El track de ARC-AGI-3 ofrece 850.000 dólares en total, con un Gran Premio de 700.000 dólares para el primer agente elegible que alcance el 100% en el conjunto de evaluación totalmente privado. Si nadie lo consigue este año, los fondos pasarán a 2027. Además del Gran Premio, hay un premio de 75.000 dólares a la mejor puntuación repartido entre los cinco primeros, y dos hitos intermedios (30 de junio y 30 de septiembre de 2026) que distribuyen 37.500 dólares entre los tres mejores equipos en esas fechas.
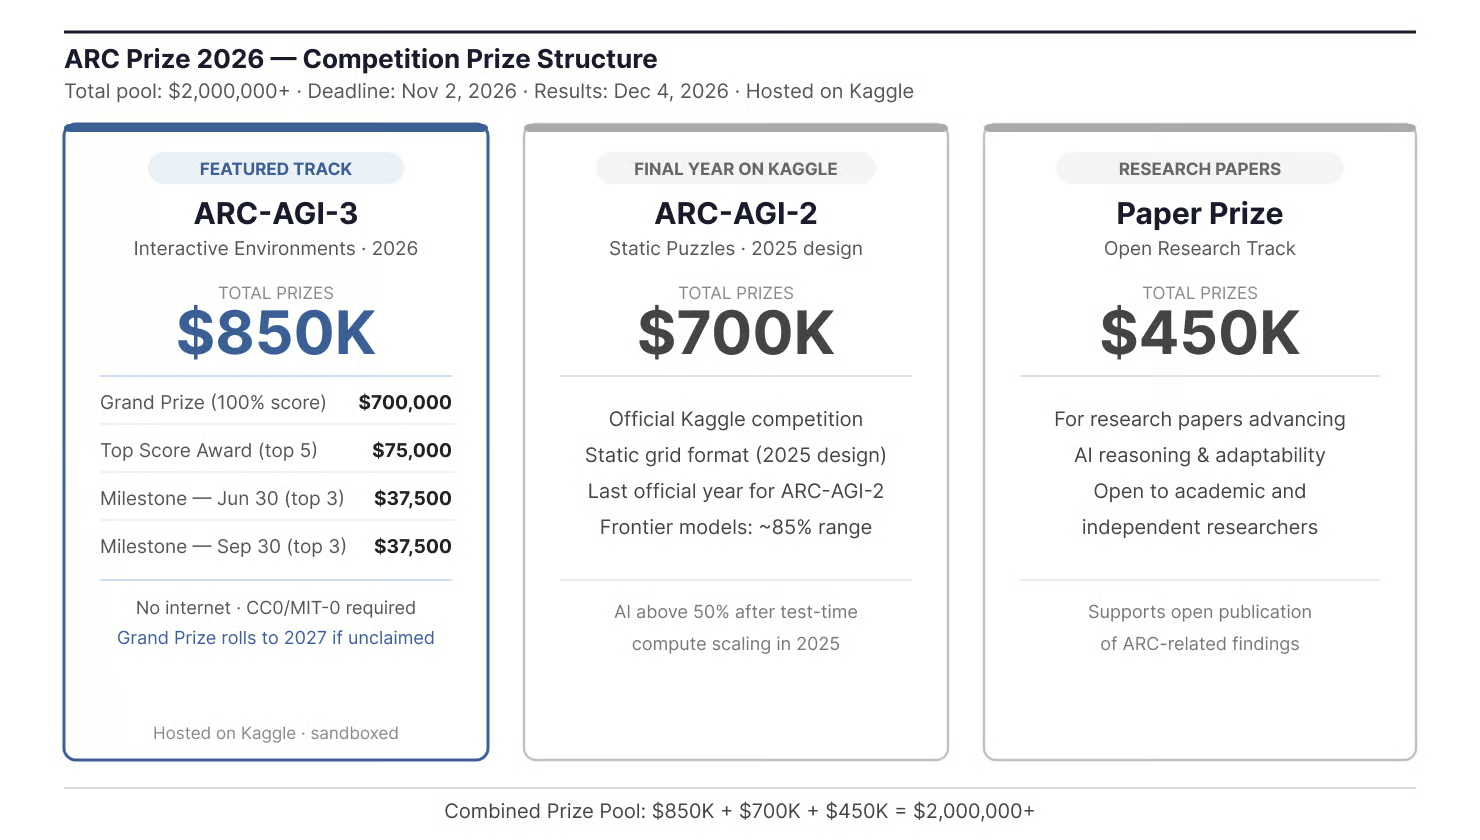
Estructura de premios de la competición ARC Prize 2026. Imagen del autor.
Los otros dos itinerarios son un track de ARC-AGI-2 (700.000 dólares, y además será el último año que ARC-AGI-2 se use en una competición oficial de Kaggle) y un track de Paper Prize (450.000 dólares para trabajos de investigación).
La competición se celebra en Kaggle, pero con reglas distintas a una competición típica. Las propuestas se evalúan en un entorno aislado sin acceso a internet, lo que excluye llamadas a API de modelos alojados como GPT, Claude o Gemini. Todas las soluciones elegibles para premio deben publicarse con una licencia permisiva o de dominio público (CC0 o MIT-0) antes de recibir las puntuaciones de la evaluación privada. La competición se abrió el 25 de marzo de 2026, con fecha límite de envío el 2 de noviembre de 2026 y anuncio de resultados el 4 de diciembre de 2026.
Los benchmarks importan sobre todo cuando revelan una brecha que antes no parecía existir. En ese sentido, los dos primeros ARC se ganaron su lugar: ARC-AGI-1 sacó a la luz la aparición de grandes modelos de razonamiento, y ARC-AGI-2 midió hasta dónde podía llegar el escalado de cómputo en inferencia. ARC-AGI-3 señala un problema diferente.
Lo que hace relevante a este benchmark hoy es el contexto. A comienzos de 2026, muchos benchmarks de IA de uso extendido se acercan a la saturación. Los modelos de frontera superan el 90% en MMLU, HumanEval y GSM8K, entre otros, lo que limita cuánto pueden decirnos estas evaluaciones sobre las diferencias entre sistemas. ARC-AGI-3 evalúa una capacidad que los modelos actuales parecen no tener: aprender sobre la marcha en entornos desconocidos. La brecha entre puntuaciones de IA por debajo del 1% y un 100% de resolubilidad humana es lo bastante grande como para sugerir que no es simplemente una versión más difícil de la misma prueba, sino un desafío de otra naturaleza.
ARC Prize presenta ARC-AGI-3 como la prueba más importante de razonamiento interactivo, aunque conviene recordar que ese encuadre viene de la organización que lleva el benchmark. Si se sostiene dependerá de cómo responda la comunidad investigadora.
Ningún benchmark es perfecto y ARC-AGI-3 ha recibido críticas a tener en cuenta.
Una preocupación habitual es la propia fórmula de puntuación. La métrica de eficiencia al cuadrado penaliza con dureza la exploración, que bien podría ser un signo de inteligencia y no un fallo. Si un agente invierte 50 acciones en cartografiar con cuidado las condiciones límite antes de llegar a la solución, puntuará mucho peor que una persona que adivina la regla en 5 acciones. Parte de la comunidad argumenta que esto agranda artificialmente la brecha de rendimiento.
También está la cuestión de la referencia humana. Como expliqué en la sección de puntuación, el benchmark usa al segundo mejor tester humano y no a la media, lo que fija un listón alto. Incluso personas típicas puntuarían por debajo del 100% con este enfoque.
El equipo de ARC Prize presenta el benchmark como un intento científico de medir una capacidad concreta que falta, no como una prueba definitiva de inteligencia general. A la luz de lo que sabemos hoy, es una lectura razonable.
ARC-AGI-3 propone una forma distinta de evaluar sistemas de IA. Al pasar de puzles estáticos a entornos interactivos, comprueba si los modelos pueden explorar, fijar objetivos y aprender por experiencia en lugar de seguir instrucciones.
Las primeras cifras llaman la atención. Modelos que dominan benchmarks de código, competiciones de matemáticas y pruebas de conocimiento apenas superan aquí el 1%. Si esa brecha se cierra rápido, como ocurrió con benchmarks ARC anteriores, o si el formato interactivo resulta más difícil de descifrar, es algo que merece la pena seguir de cerca.
Si quieres profundizar en los conceptos detrás de sistemas de IA adaptativos, echa un vistazo a nuestro itinerario de aprendizaje AI Fundamentals o a nuestro curso Building Scalable Agentic Systems.
Aprende con DataCamp
Curso
Curso
Curso
blog
blog
Abid Ali Awan
8 min
blog
Abid Ali Awan
10 min
blog
Adel Nehme
15 min
Tutorial
Zoumana Keita
12 min
Tutorial
Moez Ali
11 min