
Cursus
Artificial Intelligence begrijpen
2 uur
426.1K
De meeste AI-benchmarks volgen dezelfde formule: stel het model een vraag, krijg een antwoord, controleer of het klopt. Jarenlang werkte die aanpak prima. Maar toen frontier-modellen op bijna elke grote evaluatie boven de 90% begonnen te scoren, dook een bekend probleem op. De benchmarks raakten hun vermogen kwijt om nog onderscheid te maken tussen modellen.
ARC-AGI-3 pakt het anders aan. In plaats van statische puzzels met duidelijke input-outputparen, zet het AI-agents neer in interactieve omgevingen zonder instructies, zonder expliciete doelen en zonder regels. Het agent moet alles zelf uitvogelen via proberen en observeren, net zoals een mens zou doen wanneer die een spel krijgt dat hij of zij nog nooit heeft gezien.
Gelanceerd op 25 maart 2026 door de ARC Prize Foundation, leverde ARC-AGI-3 bij release een opvallend resultaat op: elk frontier-AI-model scoorde onder de 1%, terwijl mensen alle omgevingen van de benchmark oplosten.
ARC-AGI-3 is een benchmark voor interactieve redenering, ontwikkeld door de ARC Prize Foundation, mede opgericht door AI-onderzoeker François Chollet (maker van Keras) en Mike Knoop (medeoprichter van Zapier). De benchmark is gebaseerd op wat het ARC Prize-team ziet als een kernprincipe: echte intelligentie draait niet om hoeveel een systeem weet, maar om hoe efficiënt het iets totaal nieuws kan leren.
Waar eerdere AI-evaluaties gekristalliseerde kennis testen (het terughalen van gememoriseerde feiten, het toepassen van getrainde heuristieken), richt ARC-AGI-3 zich op vloeiende intelligentie: het vermogen om te redeneren over nieuwe problemen en zich aan te passen aan nieuwe situaties, in plaats van te leunen op wat tijdens training is geleerd. Het meet of een AI-agent een onbekende omgeving kan verkennen, de regels kan achterhalen, kan bepalen hoe "winnen" eruitziet en vervolgens efficiënt op dat begrip kan handelen.
De benchmark omvat 135 omgevingen in publieke, semi-private en volledig private sets. Elke omgeving is een beurtgebaseerd, spelachtig scenario, gebouwd door een intern designteam. Het agent krijgt niets mee. Het observeert simpelweg de toestand van de wereld, onderneemt een actie, ziet wat er gebeurt en herhaalt dat.
Het technische paper beschrijft de benchmark als een test van vier kerncapaciteiten: verkennen, modelleren, doelen stellen en plannen.
Om ervoor te zorgen dat de benchmark redeneren meet in plaats van het terughalen van trainingsdata, vermijden ARC-AGI-3-omgevingen taal, cijfers, letters, culturele symbolen of herkenbare objecten uit de echte wereld. In plaats daarvan leunen ze uitsluitend op wat het ARC Prize-team "Core Knowledge priors" noemt: basale cognitieve vermogens die alle mensen delen.
Deze priors omvatten objectheid (het begrip dat dingen blijvende entiteiten zijn die kunnen bewegen of botsen), basismeetkunde en -topologie (symmetrie, rotatie, "binnen" versus "buiten"), basisfysica (impuls, zwaartekracht, stuiteren) en agentheid (herkennen wanneer iets in de omgeving doelgericht handelt). Als een omgeving vereiste dat je weet dat een sleutel een slot opent, zou dat trainingsdata testen, niet redeneren.
De verschuiving van statische evaluatie naar interactieve omgevingen verandert wat de benchmark daadwerkelijk kan meten.
Elke ARC-AGI-3-omgeving toont een raster van 64×64 waarin elke cel een van 16 mogelijke kleuren weergeeft. De agent ontvangt een visuele toestand (een "frame" genoemd) als een JSON-object en voert vervolgens per beurt één actie uit. De actieruimte is klein: doorgaans vijf richting- of toetsgebaseerde commando's, plus een optionele coördinaatgebaseerde "klik"-actie om specifieke gridcellen te selecteren.
De omgevingen zijn strikt beurtgebaseerd. Er verandert niets totdat de agent handelt, wat betekent dat de benchmark zorgvuldig redeneren beloont boven snelle reflexen. Belangrijk: interne bewerkingen zoals redeneerstappen, retries of toolcalls tellen niet als acties. Alleen commando's die de toestand van de omgeving daadwerkelijk veranderen, tellen mee voor de score van de agent.
Elke omgeving bevat meerdere levels in oplopende moeilijkheidsgraad. Het eerste level fungeert als tutorial en introduceert de basismechanieken met minimale complexiteit. Latere levels stapelen nieuwe regels en interacties, waardoor de agent moet meenemen wat hij geleerd heeft en dit toepassen in complexere situaties.
De moeilijkheid in ARC-AGI-3 komt niet voort uit vaagheid of schaal. Ze komt voort uit de samenstelling van meerdere mechanieken die over levels heen zijn geleerd. Een omgeving met één mechaniek zou te eenvoudig zijn om te brute-forcen. De echte test is het combineren van verschillende geleerde dynamieken om een probleem op te lossen dat de agent nog nooit heeft gezien.
De benchmark draait op een aangepaste Python-engine die is ontworpen om in headless-modus een prestatiedrempel van 1.000 FPS te halen. Ontwikkelaars kunnen beginnen met pip install arc-agi en met omgevingen interacteren via de SDK of een REST API. Je kunt ook de publieke omgevingen in je browser spelen om een gevoel te krijgen bij hoe deze games eruitzien.
Eén ding vooraf: deze scores weerspiegelen de stand van het leaderboard van eind maart 2026 en zullen vrijwel zeker veranderen naarmate onderzoekers nieuwe benaderingen ontwikkelen.
Bij de lancering testte de ARC Prize Foundation verschillende frontier-modellen op de semiprivate evaluatieset.
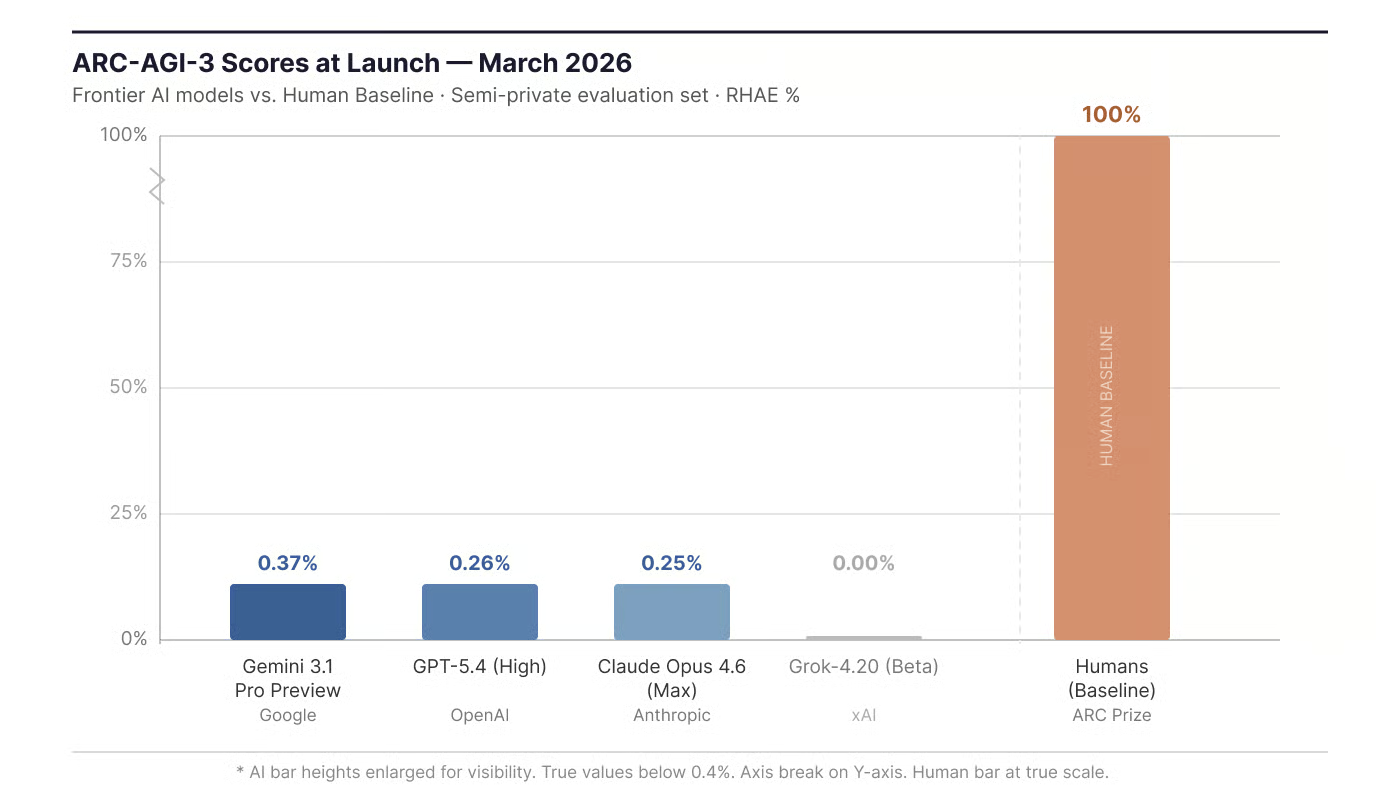
Scores bij lancering (maart 2026): frontier-AI versus menselijke baseline. Afbeelding door de auteur.
Ter context: dezezelfde frontier-modellen domineren de meeste andere AI-benchmarks. ARC-AGI-1 nadert verzadiging, met topmodellen die nu ruim boven de 90% scoren. De daling naar onder de 1% op ARC-AGI-3 suggereert dat de hier geteste capaciteiten anders zijn dan waar huidige modellen goed in zijn.
De score van 0% voor Grok-4.20 betekent niet dat het model nooit acties ondernam. Het betekent dat het model in elk level de actielimiet van de benchmark overschreed. Ik leg in de scoringssectie uit hoe die limiet werkt.
De best scorende agenten tijdens de previewperiode waren geen taalmodellen. Tijdens de previewcompetitie (met 3 publieke omgevingen en 3 private als verborgen evaluatieset) bereikte een systeem genaamd StochasticGoose van Tufa Labs 12,58% met een reinforcement learning-aanpak met convolutionele neurale netwerken.
Toen StochasticGoose bij de lancering werd geëvalueerd op de volledige officiële benchmark, daalde de score echter naar 0,25%, ongeveer hetzelfde niveau als frontier-LLM's. Dat resultaat zegt veel: een aanpak die goed werkte op een handvol bekende omgevingen deed het veel slechter bij de volledige reeks ongeziene omgevingen, wat benadrukt hoezeer ARC-AGI-3 afhankelijk is van algemene aanpassingsvermogen in plaats van taakspecifieke optimalisatie.
Dit suggereert dat het interactieve format beter kan werken met andere architecturen, omdat een taalmodel zich niet door een probleem heen kan redeneren wanneer de benodigde informatie pas na elke actie verschijnt.
Je kunt de laatste scores bekijken op het ARC-AGI-3-leaderboard.
Die cijfers zien er anders uit zodra je weet wat eerdere ARC-benchmarks testten. ARC-AGI-1, uitgebracht door Chollet in 2019, introduceerde het idee om vloeibare intelligentie te meten via abstracte visuele puzzels. Het format was statisch: het model zag enkele input-output-gridvoorbeelden, leidde de transformatieregel af en produceerde één output. ARC-AGI-2, uitgebracht in maart 2025, gebruikte hetzelfde statische format maar met moeilijkere, meer compositionele taken.
ARC-AGI-1 hielp bij het identificeren van het ontstaan van grote redeneermodellen als een nieuwe categorie, waarbij o3 van OpenAI het eerste duidelijke signaal was. ARC-AGI-2 volgde hoe snel dat redeneervermogen opschaalde. Maar het statische format had een kwetsbaarheid: opschalen van compute tijdens testtijd. Door tijdens inferentie duizenden kandidaatoplossingen parallel te genereren, stuwden labs de ARC-AGI-2-scores binnen een jaar van enkele procenten naar ruim boven de 50%.
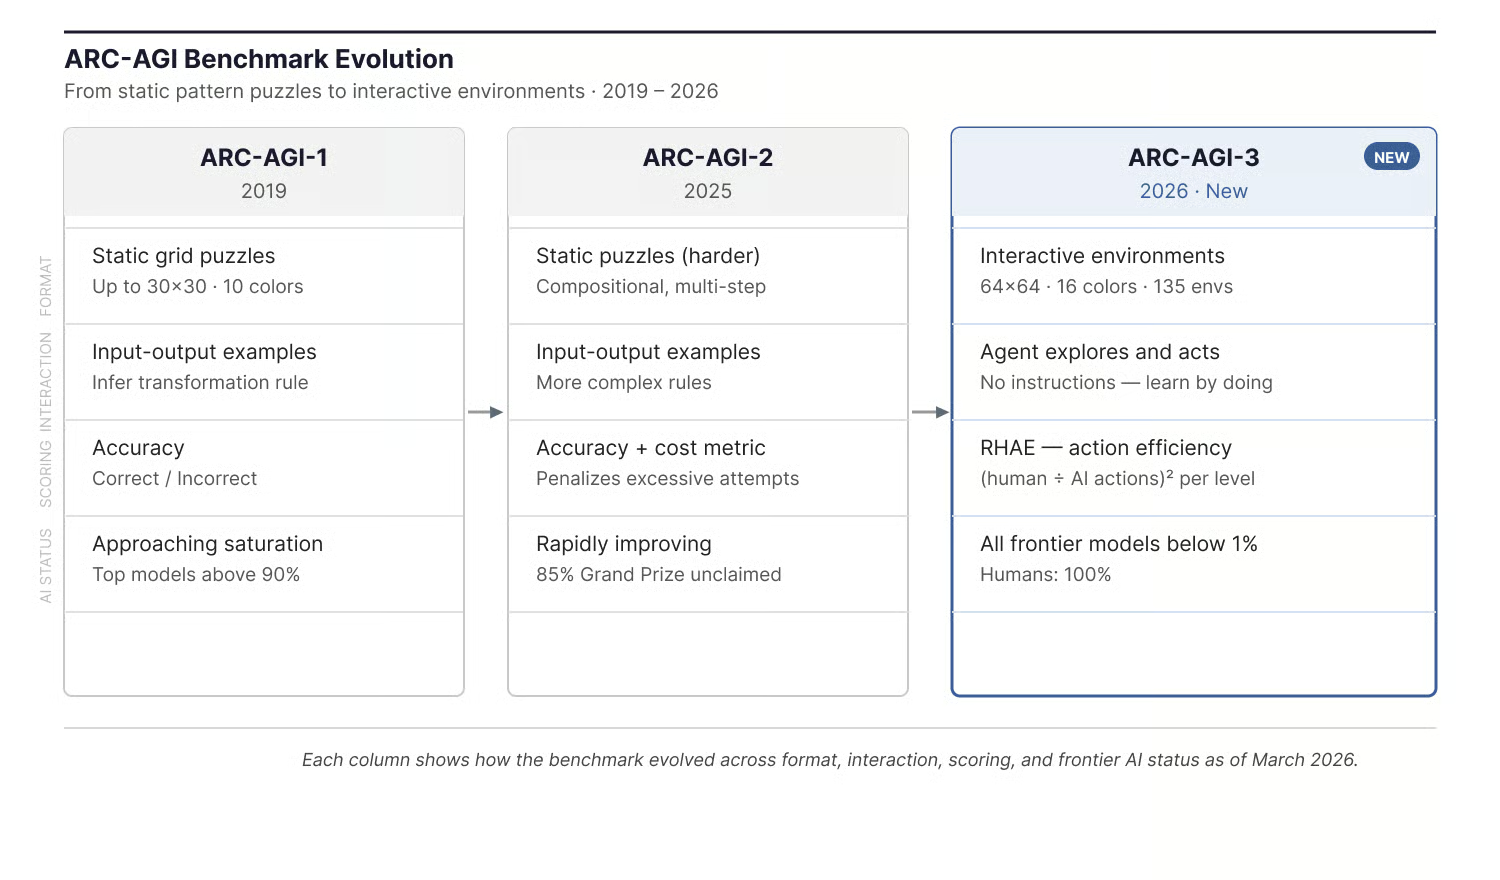
Evolutie van de ARC-AGI-benchmark door de tijd. Afbeelding door de auteur.
ARC-AGI-3 maakt de brute-force samplingstrategie veel moeilijker uit te voeren omdat, zoals ik eerder noemde, de omgeving haar regels pas onthult nadat de agent handelt. Je kunt geen 10.000 kandidaatoplossingen in een contextvenster genereren wanneer het probleem bij elke actie verandert.
Naast het interactieve format bevat ARC-AGI-3 specifieke ontwerpkeuzes die bedoeld zijn om de shortcuts van datacontaminatie en synthetische generatie te bestrijden die eerdere versies troffen. De meest opvallende verandering is de omgekeerde datasetverhouding. ARC-AGI-1 en ARC-AGI-2 hadden ongeveer een verhouding van 10:1 tussen publieke en private taken, wat onderzoekers veel trainingsmateriaal gaf. ARC-AGI-3 draait dit om: slechts 25 omgevingen zijn publiek, terwijl de overgrote meerderheid wordt achtergehouden in semiprivate en volledig private sets die voor evaluatie worden gebruikt.
Het ARC Prize-team signaleerde ook aanwijzingen dat sommige frontier-modellen mogelijk ARC-data in hun trainingssets hebben. Tijdens de ARC-AGI-2-evaluatie verwees de chain-of-thought-redenering van Gemini 3 naar ARC-specifieke kleurtoewijzingen zonder daarom gevraagd te zijn, wat wijst op verzadiging van trainingsdata. Door het publieke oppervlak te verkleinen en over te stappen op interactieve omgevingen die niet als statische patronen kunnen worden gememoriseerd, wil ARC-AGI-3 dit soort shortcut veel lastiger maken.
Die ontwerpkeuzes worden logischer zodra je begrijpt wat de benchmark daadwerkelijk probeert te testen. De benchmark richt zich op wat het ARC Prize-team omschrijft als "vaardigheidsverwervingsefficiëntie": hoe efficiënt een AI-agent iets kan leren dat hij nog nooit eerder is tegengekomen.
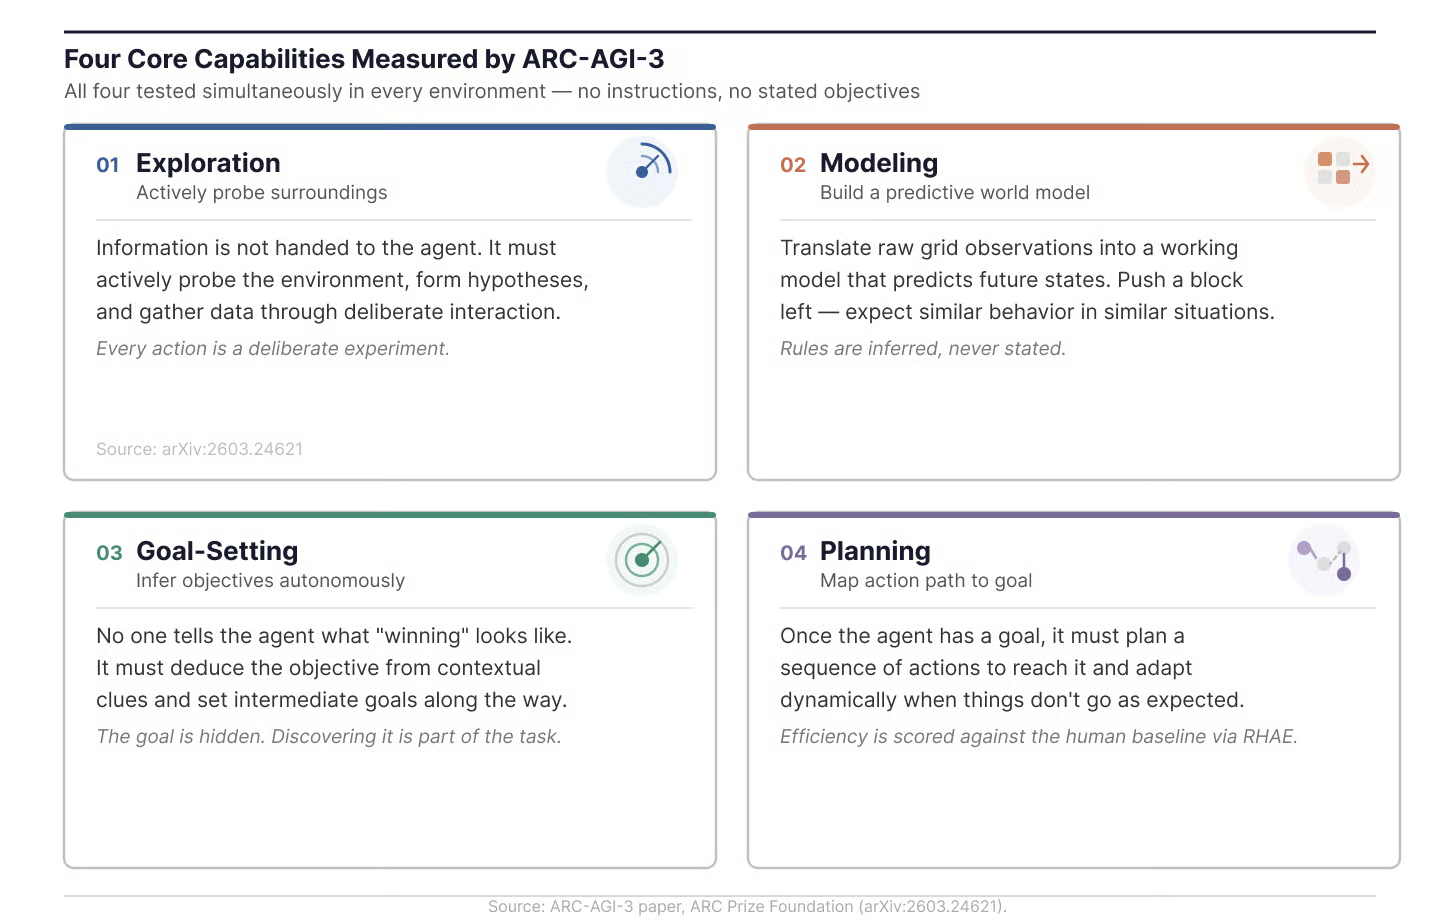
Vier kerncapaciteiten gemeten door ARC-AGI-3. Afbeelding door de auteur.
Deze vier gebieden worden gelijktijdig getest in elke omgeving, zonder instructies en zonder expliciete doelen op enig moment.
Een score van 100% op ARC-AGI-3 zou betekenen dat een AI-agent elke omgeving net zo efficiënt kan oplossen als de op één na beste menselijke tester. Het ARC Prize-team is duidelijk dat dit niet gelijkstaat aan AGI. Het zou betekenen dat één specifieke kloof tussen AI en menselijk leren is gedicht.
Scoring is waar ARC-AGI-3 het meest verschilt van eerdere benchmarks. Er wordt niet alleen gekeken of de agent uiteindelijk toevallig op een oplossing stuit. Er wordt gemeten hoe efficiënt de agent daar komt.
De metriek heet RHAE, wat staat voor Relative Human Action Efficiency. De formule per level is:
Levelscore = min(1,0, (human_baseline_actions / AI_actions))²
Het belangrijkste detail is de kwadraterm. Dit is geen lineair verband. Een verdubbeling van het aantal acties halveert de score niet; ze wordt een kwart. Tien keer zoveel acties doet de score bijna naar nul zakken. Dit powerlaw-ontwerp straft brute-forcebenaderingen zwaar en beloont agenten die daadwerkelijk leren hoe de omgeving werkt.
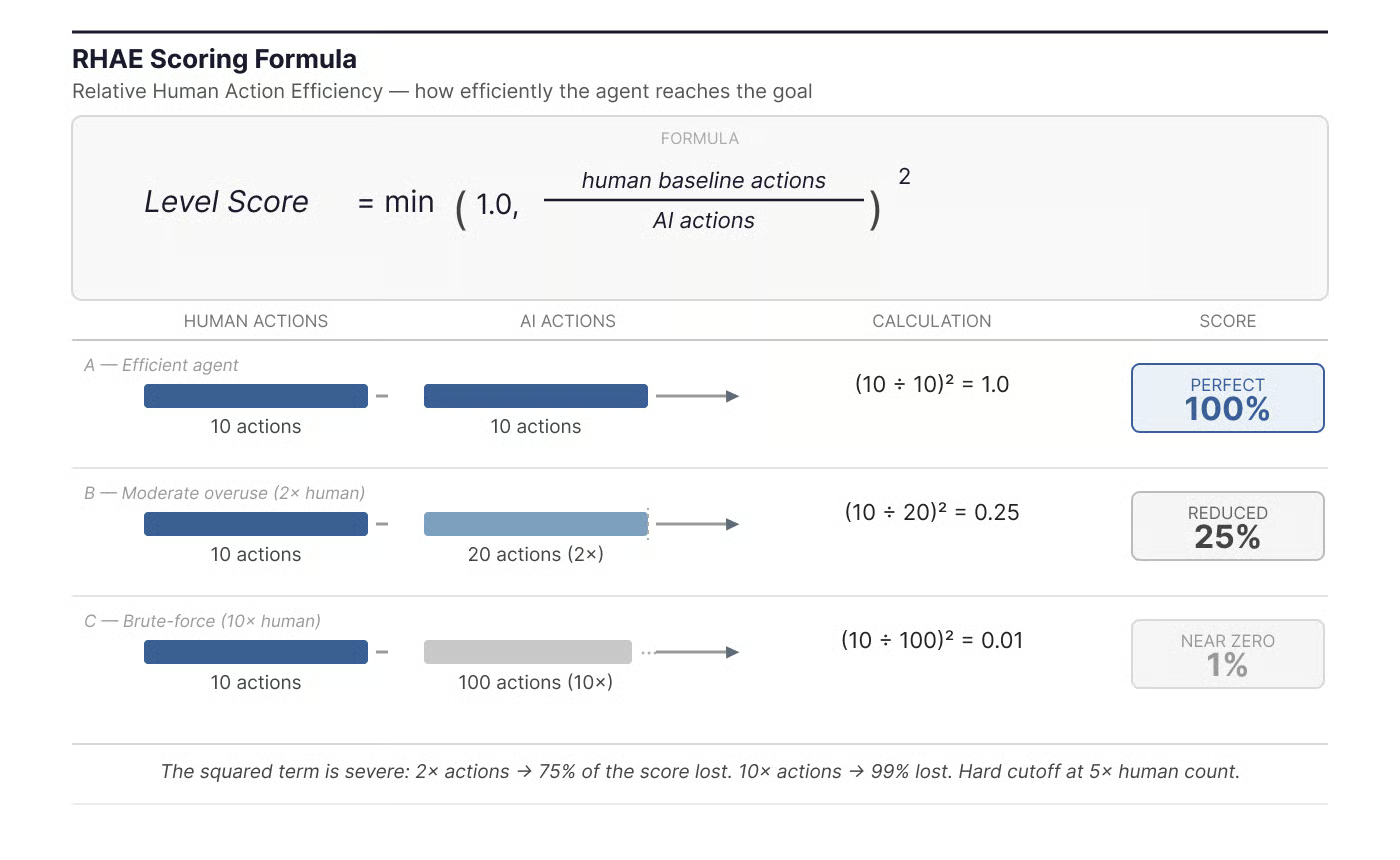
RHAE-scoringsformule met uitgewerkte voorbeelden. Afbeelding door de auteur.
De menselijke baseline wordt bepaald door de op één na beste performer van 10 testers die elke omgeving bij eerste blootstelling probeerden. Door de op één na beste te gebruiken in plaats van de absolute beste, filter je gelukkige uitschieters eruit terwijl je verankerd blijft in echt spel.
Er is ook een harde limiet: als een agent meer dan 5× het aantal menselijke acties in een level nodig heeft, wordt die afgebroken en scoort hij nul voor dat level. En scores zijn begrensd op 1,0, dus het ontdekken van een onbedoelde shortcut die de menselijke baseline verslaat, levert geen bonus op.
Binnen elke omgeving tellen latere levels zwaarder mee. De scoring gebruikt een gewogen gemiddelde waarbij Level 1 gewicht 1 krijgt, Level 2 gewicht 2, enzovoort. Dit betekent dat tutoriallevels nauwelijks effect hebben op de score, terwijl de moeilijkere levels die het combineren van meerdere geleerde mechanieken vereisen het zwaarst wegen.
ARC-AGI-3 onderhoudt twee aparte leaderboards met verschillende regels. Het Official leaderboard evalueert frontier-modellen via algemene API-systemen die niet speciaal voor ARC-AGI-3 zijn voorbereid. Het Community leaderboard staat zelfgerapporteerde resultaten toe en laat harnesses toe. Dit onderscheid is belangrijk omdat, zoals ik eerder noemde, handgemaakte harnesses scores op bekende omgevingen sterk kunnen opblazen terwijl ze volledig falen op ongeziene omgevingen. Het Official leaderboard is bedoeld om de daadwerkelijke aanpassingsvermogen van de AI te meten, niet de scaffolding van de ontwikkelaar.
ARC-AGI-3 is het middelpunt van de competitie van dit jaar, maar het is niet de enige track.
ARC Prize 2026 heeft een totale prijzenpot van meer dan $2 miljoen, verdeeld over drie tracks. De ARC-AGI-3-track biedt in totaal $850.000 aan prijzengeld, met als hoogtepunt een Grand Prize van $700.000 voor de eerste in aanmerking komende agent die 100% haalt op de volledig private evaluatieset. Als niemand die dit jaar claimt, schuift het bedrag door naar 2027. Naast de Grand Prize is er een prijs voor hoogste score van $75.000, verdeeld onder de top vijf, en twee mijlpaal-checkpoints (30 juni en 30 september 2026) die elk $37.500 verdelen onder de top drie teams op die datum.
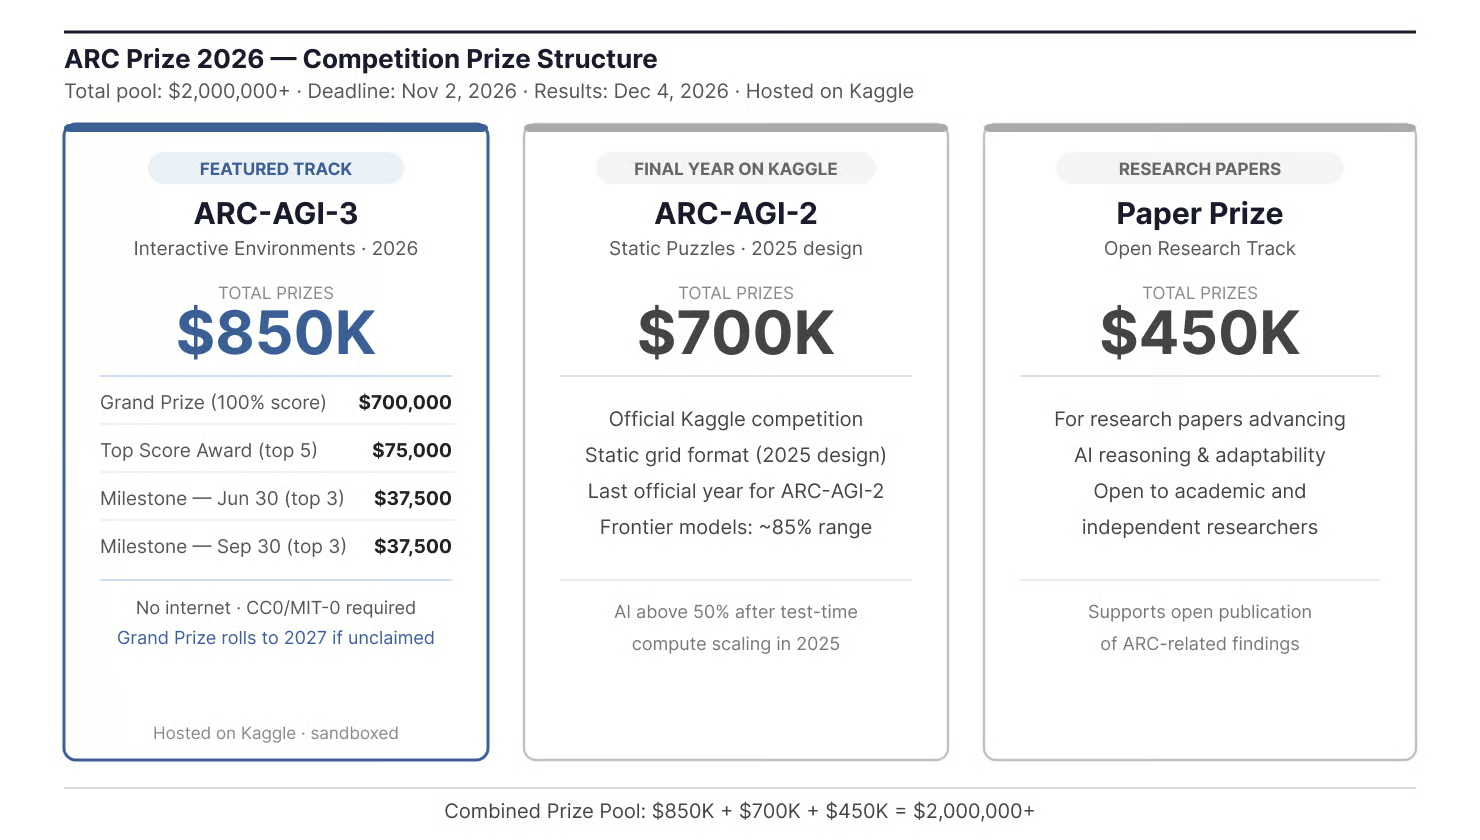
Prijzenstructuur van de ARC Prize 2026-competitie. Afbeelding door de auteur.
De andere twee tracks zijn een ARC-AGI-2-track ($700.000, en opvallend: het laatste jaar van ARC-AGI-2 wordt gebruikt in een officiële Kaggle-competitie) en een Paper Prize-track ($450.000 voor onderzoekspapers).
De competitie loopt op Kaggle, maar met regels die haar onderscheiden van een typische Kaggle-competitie. Inzendingen worden geëvalueerd in een gesandboxte omgeving zonder internettoegang, waardoor API-calls naar gehoste modellen zoals GPT, Claude of Gemini niet mogelijk zijn. Alle prijswaardige oplossingen moeten onder een permissieve of publiekdomeinlicentie (CC0 of MIT-0) worden vrijgegeven voordat ze privéscores voor de evaluatie ontvangen. De competitie opende op 25 maart 2026, met een definitieve inzenddeadline op 2 november 2026 en resultaten die op 4 december 2026 worden aangekondigd.
Benchmarks zijn vooral belangrijk wanneer ze een kloof laten zien die eerder niet als kloof werd gezien. Aan die maat gemeten hebben de eerste twee ARC-benchmarks hun plek verdiend: ARC-AGI-1 maakte de opkomst van grote redeneermodellen zichtbaar, en ARC-AGI-2 volgde hoe ver test-time compute scaling kon gaan. ARC-AGI-3 wijst op een ander probleem.
Wat deze benchmark nu relevant maakt, is de context. Begin 2026 naderen veel veelgebruikte AI-benchmarks verzadiging. Frontiermodellen scoren boven de 90% op MMLU, HumanEval en GSM8K, onder andere, wat beperkt hoeveel deze evaluaties ons nog kunnen vertellen over verschillen tussen systemen. ARC-AGI-3 test een vaardigheid die huidige modellen lijken te missen: al doende leren in onbekende omgevingen. De kloof tussen AI-scores onder de 1% en 100% menselijke oplosbaarheid is groot genoeg om te suggereren dat dit niet slechts een moeilijkere versie van dezelfde test is, maar een ander soort uitdaging.
ARC Prize positioneert ARC-AGI-3 als de belangrijkste test van interactieve redenering, al is het goed om te onthouden dat dat frame komt van de organisatie die de benchmark runt. Of het standhoudt, hangt af van hoe de benchmark presteert terwijl onderzoekers zich eraan aanpassen.
Geen enkele benchmark is perfect, en ARC-AGI-3 heeft kritiek gekregen die het vermelden waard is.
Een veelgehoorde zorg is de scoringsformule zelf. De gekwadrateerde efficiëntiemaatstaf bestraft exploratie zwaar, terwijl dat juist als een teken van intelligentie kan gelden in plaats van een tekortkoming. Als een agent 50 acties besteedt aan het zorgvuldig in kaart brengen van randvoorwaarden voordat een oplossing wordt bereikt, scoort die veel slechter dan een mens die de regel in 5 acties raadt. Sommige communityleden hebben betoogd dat dit de prestatiekloof kunstmatig groot doet lijken.
Er is ook de vraag naar de keuze van de baseline. Zoals ik in de scoringssectie besprak, gebruikt de benchmark de op één na beste menselijke tester in plaats van het gemiddelde, wat de lat hoog legt. Zelfs doorsneemensen zouden onder deze aanpak onder de 100% scoren.
Het ARC Prize-team presenteert de benchmark als een wetenschappelijke poging om een specifieke ontbrekende vaardigheid te meten, niet als een definitieve test van algemene intelligentie. Gezien wat we vandaag weten, is dat een redelijke lezing.
ARC-AGI-3 pakt de evaluatie van AI-systemen anders aan. Door te verschuiven van statische puzzels naar interactieve omgevingen test het of modellen kunnen verkennen, hun eigen doelen kunnen stellen en dingen kunnen uitvinden via ervaring in plaats van instructies.
De vroege cijfers zijn opvallend. Modellen die uitblinken op code-benchmarks, wiskundewedstrijden en kennistests, hebben moeite om hier de 1% te passeren. Of die kloof snel sluit, zoals bij eerdere ARC-benchmarks, of dat het interactieve formaat lastiger te kraken blijkt, is iets wat ik nauwlettend in de gaten zou houden.
Voor meer over de concepten achter adaptieve AI-systemen, bekijk onze AI Fundamentals skill track of onze cursus Building Scalable Agentic Systems.
Leren met DataCamp
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

