
Kurs
Künstliche Intelligenz verstehen
2 Std.
426.1K
Die meisten KI-Benchmarks folgen derselben Formel: Stelle dem Modell eine Frage, erhalte eine Antwort, prüfe, ob sie richtig ist. Über Jahre hat dieser Ansatz gut genug funktioniert. Doch als Spitzenmodelle in nahezu jeder großen Evaluation über 90% erreichten, tauchte ein bekanntes Problem auf. Die Benchmarks verloren ihre Fähigkeit, Modelle klar voneinander zu unterscheiden.
ARC-AGI-3 geht einen anderen Weg. Statt statischer Rätsel mit klaren Input-Output-Paaren setzt es KI-Agenten in interaktive Umgebungen – ohne Anweisungen, ohne Zielvorgaben und ohne explizite Regeln. Der Agent muss alles selbst durch Ausprobieren und Beobachten herausfinden, so wie ein Mensch, dem man ein Spiel gibt, das er noch nie gesehen hat.
Am 25. März 2026 von der ARC Prize Foundation gestartet, lieferte ARC-AGI-3 direkt ein bemerkenswertes Ergebnis: Jedes Spitzen-KI-Modell lag unter 1%, während Menschen alle Umgebungen des Benchmarks lösten.
ARC-AGI-3 ist ein interaktiver Reasoning-Benchmark der ARC Prize Foundation, mitgegründet vom KI-Forscher François Chollet (Erfinder von Keras) und Mike Knoop (Mitgründer von Zapier). Der Benchmark basiert auf einem Kernprinzip des ARC-Teams: Wahre Intelligenz bemisst sich nicht daran, wie viel ein System weiß, sondern daran, wie effizient es etwas vollkommen Neues lernen kann.
Währ frühere KI-Evaluierungen kristallisiertes Wissen testen (Abruf einprägter Fakten, angewandte Heuristiken), zielt ARC-AGI-3 auf fluide Intelligenz: die Fähigkeit, neuartige Probleme zu durchdenken und sich an Unbekanntes anzupassen statt sich auf Trainingswissen zu verlassen. Gemessen wird, ob ein KI-Agent eine unbekannte Umgebung erkunden, die Regeln herausfinden, erkennen kann, was als „Gewinnen“ gilt, und dieses Verständnis effizient in Handeln umsetzt.
Der Benchmark umfasst 135 Umgebungen in öffentlichen, halbprivaten und voll privaten Sets. Jede Umgebung ist ein rundenbasiertes, spielähnliches Szenario aus dem hauseigenen Designteam. Der Agent bekommt keinerlei Hinweise. Er beobachtet einfach den Zustand der Welt, führt eine Aktion aus, sieht, was passiert, und wiederholt den Vorgang.
Das technische Paper beschreibt vier Kernfähigkeiten, die der Benchmark testet: Exploration, Modellbildung, Zielsetzung und Planung.
Damit wirklich Schlussfolgern und nicht Trainingsdatenabruf gemessen wird, vermeiden ARC-AGI-3-Umgebungen Sprache, Zahlen, Buchstaben, kulturelle Symbole oder wiedererkennbare Realweltobjekte. Stattdessen stützen sie sich auf das, was das ARC-Team „Core Knowledge Priors“ nennt – grundlegende kognitive Fähigkeiten, die alle Menschen teilen.
Dazu gehören Objektbezogenheit (Verständnis, dass Dinge persistente Entitäten sind, die sich bewegen oder kollidieren können), einfache Geometrie und Topologie (Symmetrie, Rotation, „innen“ versus „außen“), grundlegende Physik (Impuls, Schwerkraft, Abprallen) sowie Agenthaftigkeit (erkennen, wenn etwas in der Umgebung zielgerichtet handelt). Müsste man etwa wissen, dass ein Schlüssel ein Schloss öffnet, würde das Trainingswissen testen – nicht Reasoning.
Der Wechsel von statischen Tests zu interaktiven Umgebungen verändert, was der Benchmark tatsächlich messen kann.
Jede ARC-AGI-3-Umgebung zeigt ein 64×64-Raster, in dem jede Zelle eine von 16 möglichen Farben anzeigt. Der Agent erhält einen visuellen Zustand (einen „Frame“) als JSON-Objekt und gibt dann pro Zug eine einzelne Aktion ab. Der Aktionsraum ist klein: typischerweise fünf Richtungs- oder Tastenkommandos plus eine optionale koordinatenbasierte „Klick“-Aktion für die Auswahl bestimmter Rasterzellen.
Die Umgebungen sind strikt rundenbasiert. Nichts ändert sich, bis der Agent handelt – das belohnt sauberes Schlussfolgern statt schnelle Reflexe. Wichtig: Interne Abläufe wie Reasoning-Schritte, Retries oder Toolaufrufe zählen nicht als Aktionen. Nur Befehle, die den Umgebungszustand tatsächlich verändern, gehen in die Wertung ein.
Jede Umgebung enthält mehrere Levels in aufsteigender Schwierigkeit. Das erste Level ist ein Tutorial, das mit minimaler Komplexität die Grundmechanik einführt. Spätere Levels führen neue Regeln und Interaktionen ein, sodass der Agent Gelerntes mitnehmen und in komplexeren Situationen anwenden muss.
Schwierigkeit in ARC-AGI-3 entsteht nicht durch Obskurität oder schiere Größe, sondern durch die Komposition mehrerer Mechaniken über Levels hinweg. Eine Umgebung mit nur einer Mechanik wäre zu leicht zu brute-forcen. Die eigentliche Prüfung ist, mehrere gelernte Dynamiken zu kombinieren, um ein Problem zu lösen, das der Agent noch nie gesehen hat.
Der Benchmark läuft auf einer eigenen Python-Engine, die im Headless-Modus eine Performance-Schwelle von 1.000 FPS erreicht. Entwicklerinnen und Entwickler können mit pip install arc-agi starten und über das SDK oder eine REST-API mit Umgebungen interagieren. Du kannst die öffentlichen Umgebungen auch im Browser spielen, um ein Gefühl für diese Spiele zu bekommen.
Wichtig vorweg: Diese Werte spiegeln den Stand der Bestenliste Ende März 2026 wider und werden sich sehr wahrscheinlich ändern, wenn die Forschung neue Ansätze entwickelt.
Zum Start testete die ARC Prize Foundation mehrere Spitzenmodelle auf dem halbprivaten Evaluationsset.
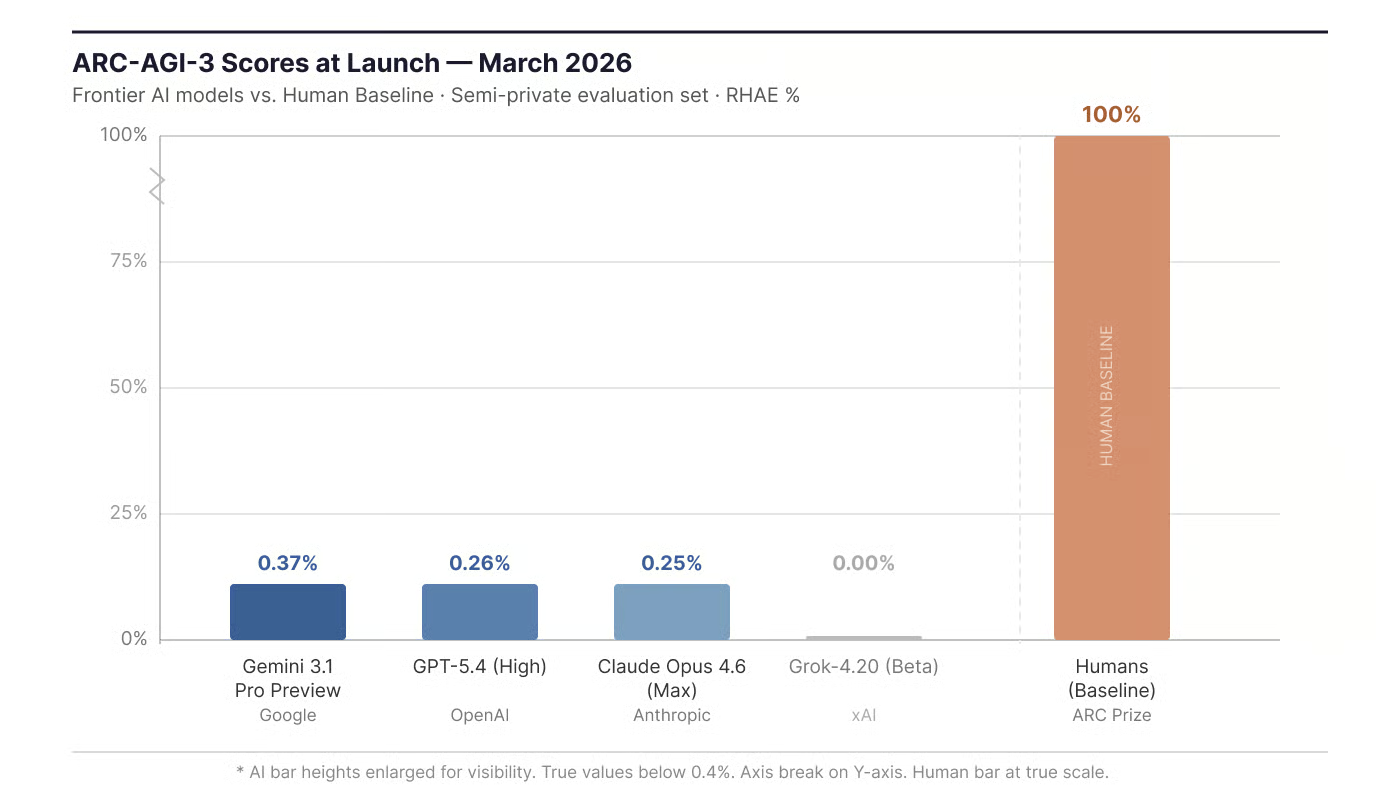
Startwerte (März 2026): Spitzen-KI versus menschliche Basislinie. Bild von der Autorin/dem Autor.
Zum Kontext: Dieselben Spitzenmodelle dominieren die meisten anderen KI-Benchmarks. ARC-AGI-1 ist nahezu gesättigt, Top-Modelle liegen deutlich über 90%. Der Absturz auf unter 1% bei ARC-AGI-3 legt nahe, dass hier Fähigkeiten gefragt sind, in denen aktuelle Modelle nicht stark sind.
Die 0% für Grok-4.20 bedeuten nicht, dass das Modell keine Aktionen ausgeführt hätte. Es überschritt in jedem Level den Aktions-Grenzwert des Benchmarks. Wie dieser Cutoff funktioniert, erkläre ich im Abschnitt zur Wertung.
Die bestplatzierten Agenten in der Vorschauphase waren keine Sprachmodelle. In der Preview Competition (3 öffentliche und 3 private Umgebungen als Hidden-Set) erreichte ein System namens StochasticGoose von Tufa Labs 12,58% mit einem Ansatz aus Reinforcement Learning mit Convolutional Neural Networks.
Beim offiziellen Benchmark zum Start fiel StochasticGoose jedoch auf 0,25% – in etwa auf das Niveau der Spitzen-LLMs. Das ist aufschlussreich: Ein Ansatz, der auf einigen bekannten Umgebungen gut funktionierte, schnitt deutlich schlechter ab, als die volle Breite unbekannter Umgebungen ins Spiel kam. Das unterstreicht, wie sehr ARC-AGI-3 von allgemeiner Anpassungsfähigkeit statt aufgabenspezifischer Optimierung abhängt.
Das deutet darauf hin, dass das interaktive Format eher mit anderen Architekturen harmoniert, denn ein Sprachmodell kann ein Problem nicht „herausraten“, wenn die nötigen Informationen erst nach jeder Aktion sichtbar werden.
Die neuesten Werte findest du auf der ARC-AGI-3-Bestenliste.
Diese Zahlen wirken anders, wenn man weiß, was frühere ARC-Benchmarks testeten. ARC-AGI-1, 2019 von Chollet veröffentlicht, führte das Messen fluider Intelligenz über abstrakte visuelle Rätsel ein. Das Format war statisch: Das Modell sah einige Input-Output-Rasterbeispiele, leitete die Transformationsregel ab und produzierte eine einzelne Ausgabe. ARC-AGI-2, veröffentlicht im März 2025, nutzte dasselbe statische Format, jedoch mit schwierigeren, stärker komponierten Aufgaben.
ARC-AGI-1 half, das Aufkommen großer Reasoning-Modelle als neue Kategorie zu identifizieren – OpenAIs o3 war das erste klare Signal. ARC-AGI-2 zeigte, wie rasant sich diese Reasoning-Fähigkeit skalieren ließ. Doch das statische Format hatte eine Schwachstelle: Testzeit-Compute-Skalierung. Durch das Generieren tausender Kandidatenlösungen parallel während der Inferenz trieben Labs die ARC-AGI-2-Scores binnen eines Jahres von einstelligen Werten weit über 50%.
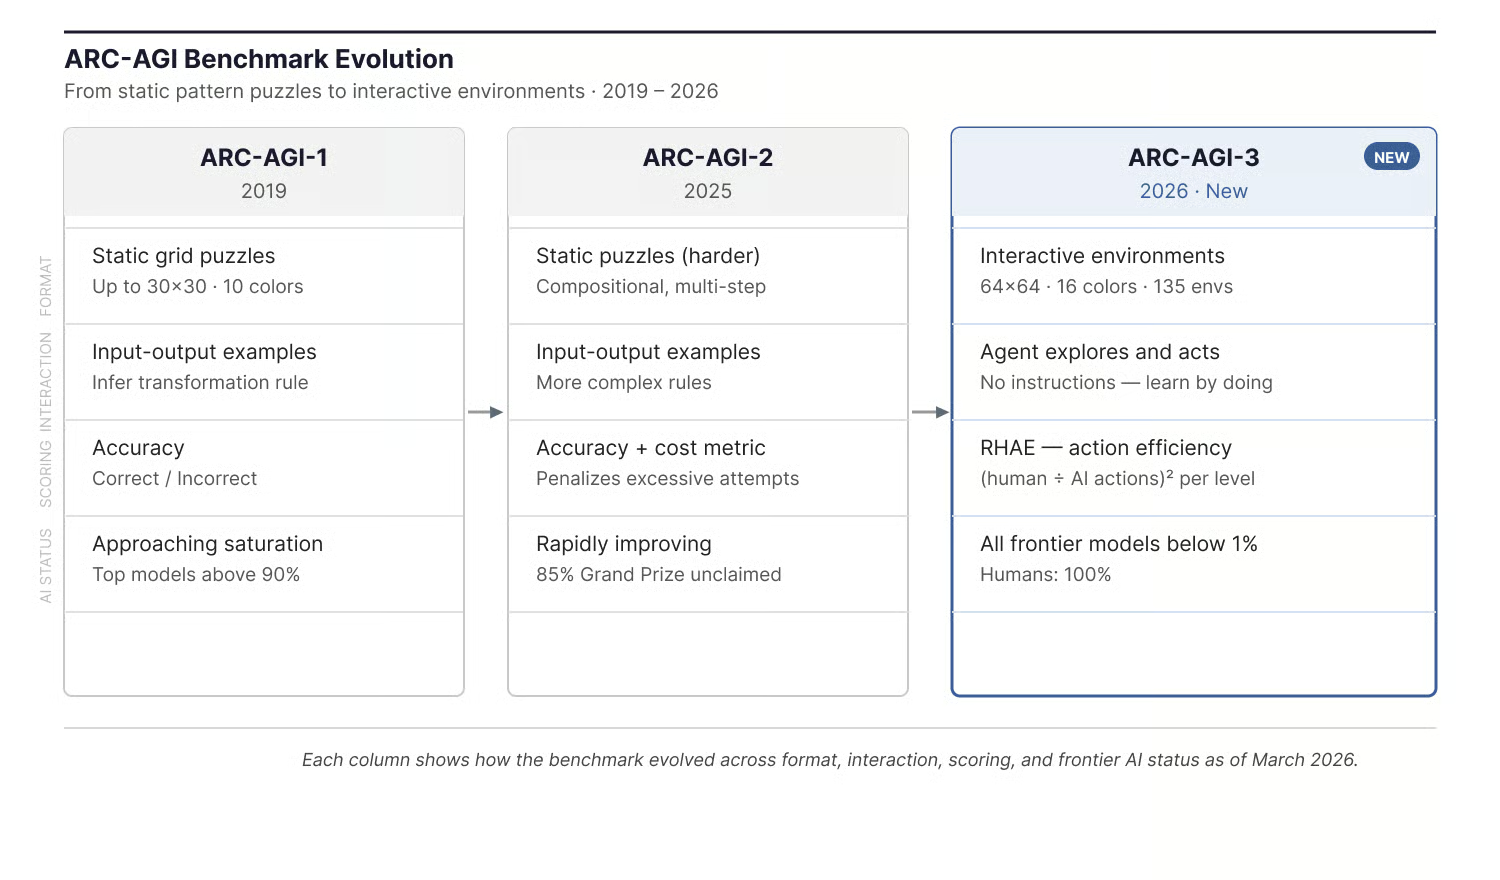
Die Entwicklung der ARC-AGI-Benchmarks im Zeitverlauf. Bild von der Autorin/dem Autor.
ARC-AGI-3 erschwert die Brute-Force-Sampling-Strategie deutlich, weil – wie oben erwähnt – die Umgebung ihre Regeln erst nach Aktionen des Agenten preisgibt. Man kann keine 10.000 Kandidatenlösungen in ein Kontextfenster packen, wenn sich das Problem mit jeder Aktion verändert.
Zusätzlich zum interaktiven Format enthält ARC-AGI-3 gezielte Designentscheidungen gegen Datenkontamination und synthetische Abkürzungen früherer Versionen. Am markantesten ist das umgekehrte Datensatzverhältnis. Bei ARC-AGI-1 und ARC-AGI-2 lag das Verhältnis von öffentlichen zu privaten Aufgaben bei etwa 10:1 – viel Trainingsmaterial für Forschende. ARC-AGI-3 dreht das um: Nur 25 Umgebungen sind öffentlich, der Großteil verbleibt in halbprivaten und voll privaten Sets für die Evaluation.
Das ARC-Team verwies auch auf Hinweise, dass manche Spitzenmodelle ARC-Daten im Training hatten. Während ARC-AGI-2 referenzierte Gemini 3 in Chain-of-Thoughts ohne Prompting ARC-spezifische Farbcodierungen – ein Zeichen für Trainingssättigung. Durch die Reduktion der öffentlichen Fläche und den Wechsel zu interaktiven, nicht memorisierbaren Umgebungen will ARC-AGI-3 solche Abkürzungen deutlich erschweren.
Diese Designwahl wird klarer, wenn man versteht, was hier eigentlich getestet wird: Das Benchmark zielt auf die „Effizienz der Kompetenzakquise“ – wie schnell ein KI-Agent etwas erlernen kann, dem er noch nie begegnet ist.
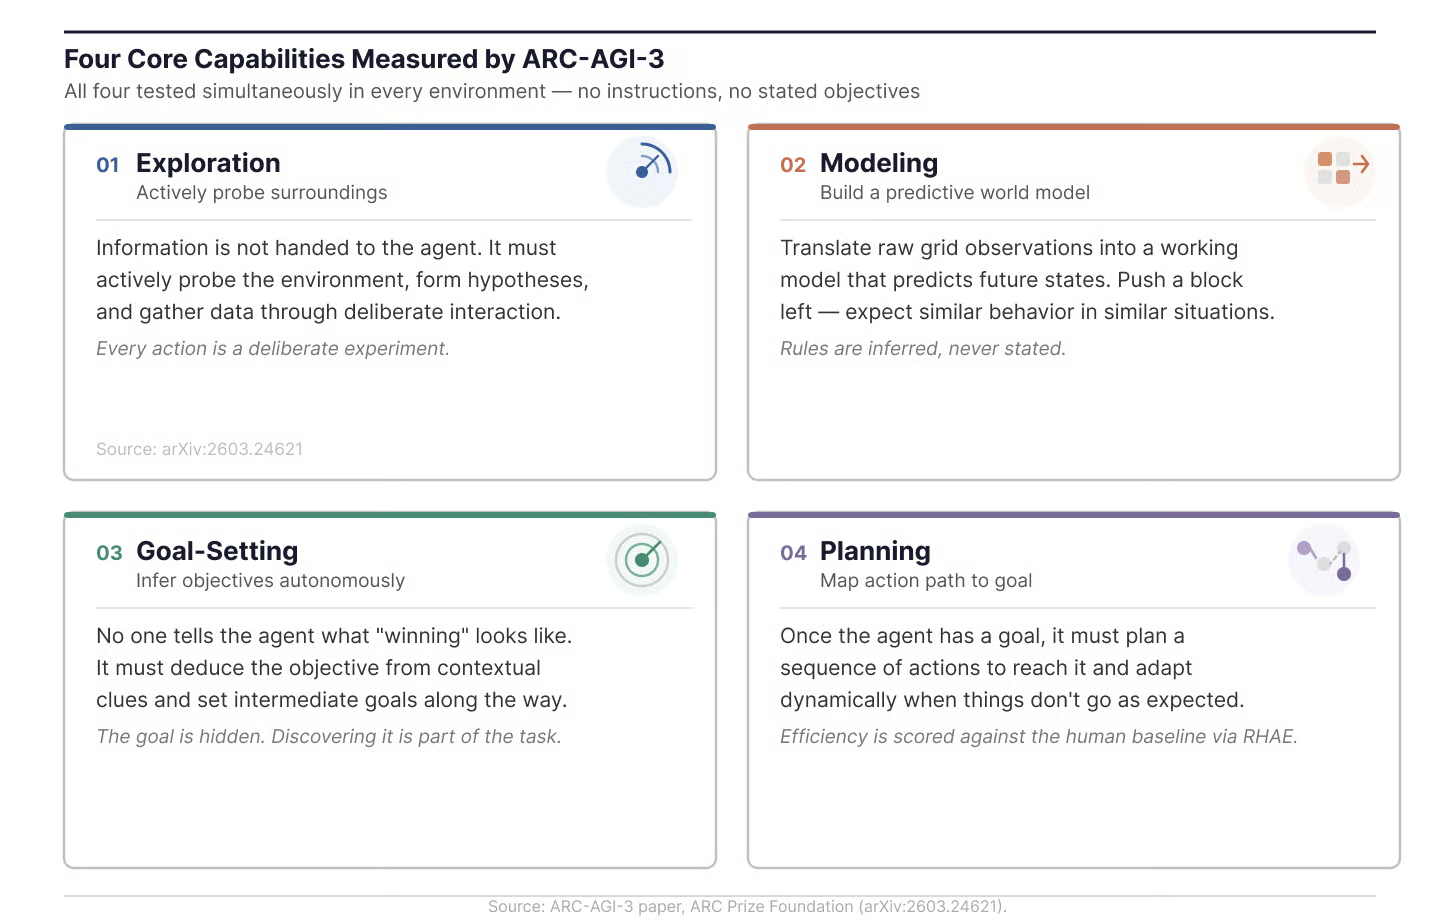
Vier Kernfähigkeiten, die ARC-AGI-3 misst. Bild von der Autorin/dem Autor.
Diese vier Bereiche werden in jeder Umgebung gleichzeitig geprüft – ohne Anweisungen und ohne je Ziele vorzugeben.
100% auf ARC-AGI-3 würden bedeuten, dass ein KI-Agent jede Umgebung so effizient löst wie der zweitbeste menschliche Tester. Das wäre kein AGI-Nachweis, betont das ARC-Team, sondern würde zeigen, dass eine bestimmte Lücke zwischen KI- und menschlichem Lernen geschlossen wurde.
Bei der Wertung unterscheidet sich ARC-AGI-3 am stärksten von früheren Benchmarks. Es prüft nicht nur, ob der Agent irgendwann zufällig zur Lösung stolpert, sondern wie effizient er dorthin gelangt.
Die Metrik heißt RHAE – Relative Human Action Efficiency. Die per-Level-Formel lautet:
Level-Score = min(1.0, (human_baseline_actions / AI_actions))²
Entscheidend ist das Quadrat. Die Beziehung ist nicht linear. Verdoppelt sich die Aktionszahl, halbiert sich der Score nicht – er viertelt sich. Zehnmal so viele Aktionen drücken den Score nahezu auf null. Dieses Power-Law bestraft Brute-Force stark und belohnt Agenten, die die Umgebung wirklich verstehen lernen.
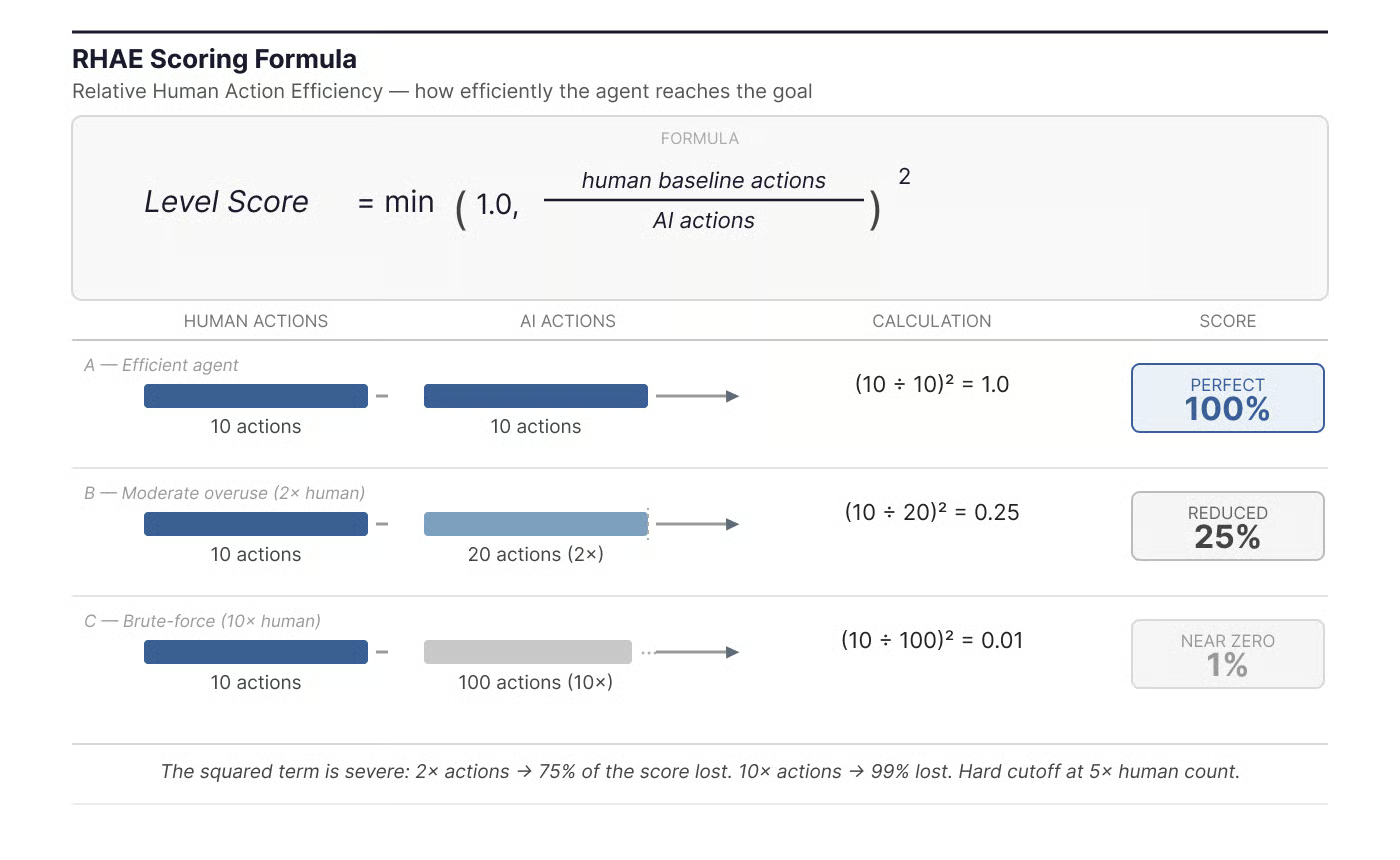
RHAE-Wertungsformel mit Beispielen. Bild von der Autorin/dem Autor.
Die menschliche Basislinie stammt von der zweitbesten Person aus zehn Testern, die jede Umgebung beim ersten Kontakt spielten. Der zweitbeste Wert filtert Glückstreffer heraus und bleibt dennoch praxisnah.
Zudem gibt es einen harten Cutoff: Benötigt ein Agent mehr als das 5-Fache der menschlichen Aktionen in einem Level, wird er abgebrochen und erhält für dieses Level null Punkte. Scores sind bei 1,0 gedeckelt – ungeplante Abkürzungen, die schneller als Menschen sind, bringen keinen Bonus.
Innerhalb einer Umgebung zählen spätere Levels mehr. Gewertet wird ein gewichteter Durchschnitt, bei dem Level 1 das Gewicht 1 erhält, Level 2 das Gewicht 2 und so weiter. Tutorial-Levels beeinflussen den Score also kaum, während die schwereren Levels mit kombinierten Mechaniken am meisten wiegen.
ARC-AGI-3 führt zwei getrennte Bestenlisten mit unterschiedlichen Regeln. Die Official Leaderboard bewertet Spitzenmodelle über allgemeine API-Systeme, die nicht speziell für ARC-AGI-3 vorbereitet wurden. Die Community Leaderboard erlaubt selbstausgewiesene Ergebnisse und gestattet Harnesses. Das ist wichtig, denn wie erwähnt können handgefertigte Harnesses die Werte auf bekannten Umgebungen stark aufblasen, während sie bei unbekannten Umgebungen komplett versagen. Die Official Leaderboard soll die tatsächliche Anpassungsfähigkeit der KI messen – nicht das Gerüst der Entwickler.
ARC-AGI-3 ist das Herzstück des diesjährigen Wettbewerbs, aber nicht der einzige Track.
Der ARC Prize 2026 umfasst über 2 Millionen US-Dollar Preisgeld, verteilt auf drei Tracks. Der ARC-AGI-3-Track bietet insgesamt 850.000 US-Dollar, angeführt von einem Grand Prize über 700.000 US-Dollar für den ersten berechtigten Agenten, der 100% auf dem voll privaten Evaluationsset erreicht. Wird er dieses Jahr nicht vergeben, rollt der Betrag in 2027. Darüber hinaus gibt es 75.000 US-Dollar für die Top-Scores, aufgeteilt auf die fünf besten Teams, sowie zwei Meilensteine (30. Juni und 30. September 2026) mit jeweils 37.500 US-Dollar für die drei besten Teams zu diesem Zeitpunkt.
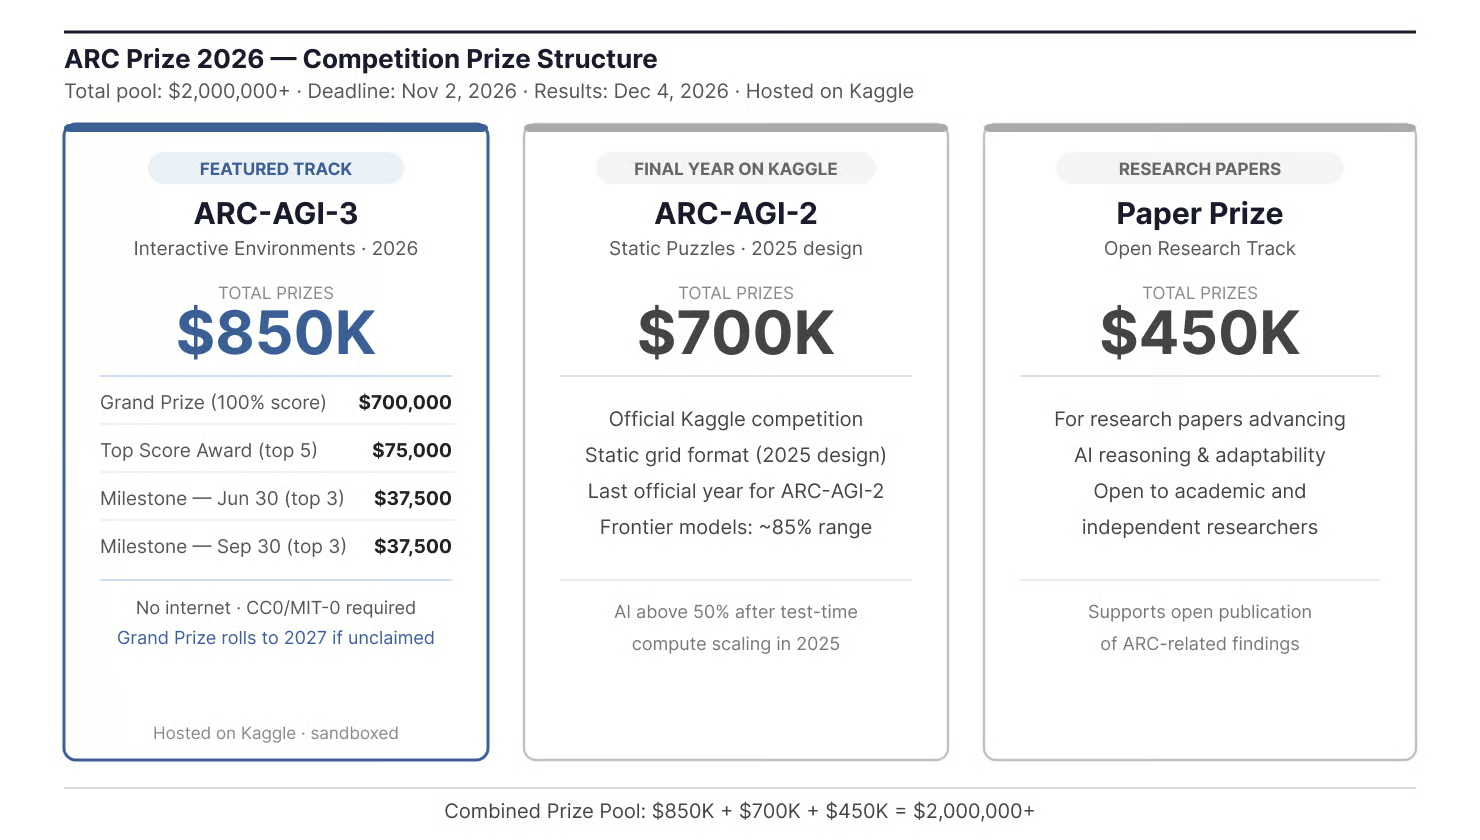
Preisstruktur des ARC Prize 2026. Bild von der Autorin/dem Autor.
Die beiden anderen Tracks sind ein ARC-AGI-2-Track (700.000 US-Dollar und zugleich das letzte Jahr, in dem ARC-AGI-2 in einem offiziellen Kaggle-Wettbewerb genutzt wird) und ein Paper-Prize-Track (450.000 US-Dollar für Forschungspapiere).
Der Wettbewerb läuft über Kaggle, allerdings mit Regeln, die ihn klar von typischen Kaggle-Wettbewerben unterscheiden: Einsendungen werden in einer isolierten Umgebung ohne Internetzugang bewertet – API-Aufrufe zu gehosteten Modellen wie GPT, Claude oder Gemini sind ausgeschlossen. Alle preisfähigen Lösungen müssen vor Erhalt der privaten Bewertung unter einer freizügigen oder Public-Domain-Lizenz (CC0 oder MIT-0) veröffentlicht werden. Der Wettbewerb startete am 25. März 2026, Einsendeschluss ist der 2. November 2026, die Ergebnisse werden am 4. Dezember 2026 bekanntgegeben.
Benchmarks sind dann am wertvollsten, wenn sie eine Lücke sichtbar machen, die zuvor nicht wie eine Lücke aussah. Nach diesem Maßstab haben sich die ersten beiden ARC-Benchmarks bewährt: ARC-AGI-1 machte das Aufkommen großer Reasoning-Modelle sichtbar, ARC-AGI-2 zeichnete nach, wie weit sich Testzeit-Compute treiben lässt. ARC-AGI-3 adressiert ein anderes Problem.
Relevant ist der Benchmark vor allem im aktuellen Kontext. Anfang 2026 sind viele verbreitete KI-Benchmarks nahezu gesättigt. Spitzenmodelle liegen bei MMLU, HumanEval und GSM8K u. a. über 90% – die Aussagekraft zur Differenzierung schrumpft. ARC-AGI-3 testet eine Fähigkeit, die aktuelle Modelle offenbar kaum besitzen: On-the-fly in unbekannten Umgebungen zu lernen. Die Lücke zwischen unter 1% bei KIs und 100% Lösungsrate bei Menschen ist groß genug, um nahe zu legen, dass es sich nicht nur um eine härtere Version desselben Tests handelt, sondern um eine andere Art Herausforderung.
Das ARC-Team positioniert ARC-AGI-3 als wichtigsten Test für interaktives Reasoning – man sollte im Hinterkopf behalten, dass diese Einordnung von der Organisation selbst stammt. Ob sie sich bewährt, hängt davon ab, wie der Benchmark abschneidet, wenn sich die Forschung darauf einstellt.
Kein Benchmark ist perfekt, und ARC-AGI-3 steht zu Recht in mancher Kritik.
Ein häufiger Punkt ist die Wertungsformel selbst. Das quadrierte Effizienzmaß bestraft Exploration stark – die man durchaus als Zeichen von Intelligenz werten kann. Wenn ein Agent 50 Aktionen investiert, um Randbedingungen sauber zu kartieren, bevor er löst, schneidet er deutlich schlechter ab als ein Mensch, der die Regel in 5 Aktionen errät. Einige Community-Mitglieder argumentieren, das lasse die Leistungslücke künstlich groß erscheinen.
Auch die Wahl der Basislinie wirft Fragen auf. Wie oben erläutert, nutzt der Benchmark den zweitbesten Menschen statt den Durchschnitt – die Messlatte liegt hoch. Selbst „typische“ Menschen würden unter diesem Ansatz unter 100% liegen.
Das ARC-Team versteht den Benchmark als wissenschaftlichen Versuch, eine spezifisch fehlende Fähigkeit zu messen – nicht als abschließenden Test allgemeiner Intelligenz. Angesichts des heutigen Wissensstands ist das eine faire Einordnung.
ARC-AGI-3 wählt einen anderen Ansatz zur Bewertung von KI-Systemen. Durch den Wechsel von statischen Rätseln zu interaktiven Umgebungen prüft es, ob Modelle erkunden, eigene Ziele setzen und Dinge durch Erfahrung statt Anleitung herausfinden können.
Die frühen Zahlen sind deutlich: Modelle, die Coding-, Mathe- und Wissensbenchmarks dominieren, kommen hier kaum über 1%. Ob sich diese Lücke schnell schließt – wie bei früheren ARC-Benchmarks – oder ob sich das interaktive Format als zäher erweist, bleibt aus meiner Sicht sehr spannend zu beobachten.
Mehr zu adaptiven KI-Systemen findest du in unserem AI Fundamentals-Lernpfad oder in unserem Kurs Building Scalable Agentic Systems.
Lerne mit DataCamp
Kurs
Kurs
Kurs
Blog
Blog
Hesam Sheikh Hassani
15 Min.
Blog
Zoumana Keita
15 Min.
Blog
Nathaniel Taylor-Leach
8 Min.
Tutorial
Josef Waples
3 Min.
Tutorial
Josef Waples
8 Min.


