
कोर्स
Understanding Artificial Intelligence
2 घंटा
426.1K
अधिकांश AI बेंचमार्क एक ही फ़ॉर्मूला अपनाते हैं: मॉडल को एक प्रश्न दें, उत्तर लें, और जाँचें कि वह सही है या नहीं। वर्षों तक यह तरीका काफी हद तक काम करता रहा। लेकिन जैसे-जैसे फ्रंटियर मॉडल लगभग हर प्रमुख मूल्यांकन में 90% से ऊपर स्कोर करने लगे, एक जानी-पहचानी समस्या उभरी। बेंचमार्क अलग-अलग मॉडलों में फर्क बताने की क्षमता खोने लगे।
ARC-AGI-3 एक अलग राह लेता है। स्पष्ट इनपुट-आउटपुट जोड़ों वाले स्थिर पहेलियों की जगह, यह AI एजेंटों को बिना किसी निर्देश, घोषित लक्ष्य, या स्पष्ट नियमों के इंटरएक्टिव वातावरण में डालता है। एजेंट को हर चीज़ खुद परीक्षण और अवलोकन से समझनी पड़ती है—ठीक वैसे ही जैसे किसी व्यक्ति को ऐसा खेल थमा दिया जाए जिसे उसने पहले कभी न देखा हो।
25 मार्च, 2026 को ARC Prize Foundation द्वारा लॉन्च किए गए ARC-AGI-3 ने जारी होने पर एक उल्लेखनीय नतीजा दिया: हर फ्रंटियर AI मॉडल का स्कोर 1% से नीचे रहा, जबकि मनुष्यों ने बेंचमार्क के सभी वातावरण हल कर लिए।
ARC-AGI-3 एक इंटरएक्टिव रीज़निंग बेंचमार्क है जिसे ARC Prize Foundation ने बनाया है, जिसके सह-संस्थापक AI शोधकर्ता François Chollet (Keras के निर्माता) और Mike Knoop (Zapier के सह-संस्थापक) हैं। यह बेंचमार्क ARC Prize टीम के एक मूल सिद्धांत पर आधारित है: सच्ची बुद्धिमत्ता इस बात पर नहीं टिकी कि कोई प्रणाली कितना जानती है, बल्कि इस पर कि वह पूरी तरह नई चीज़ को कितनी कुशलता से सीख सकती है।
जहां पहले के AI मूल्यांकन स्फटिकीकृत ज्ञान (याद किए तथ्यों की पुनर्प्राप्ति, प्रशिक्षित हीयूरिस्टिक्स का उपयोग) को परखते हैं, ARC-AGI-3 तरल बुद्धिमत्ता को निशाना बनाता है—यानी प्रशिक्षण के दौरान सीखी चीज़ों पर निर्भर रहने के बजाय नए समस्याओं पर तर्क करने और नई स्थितियों के अनुकूल होने की क्षमता। यह मापता है कि क्या कोई AI एजेंट अपरिचित वातावरण का अन्वेषण कर सकता है, नियम समझ सकता है, "जीतने" का स्वरूप पहचान सकता है, और फिर उस समझ पर कुशलता से अमल कर सकता है।
बेंचमार्क में सार्वजनिक, अर्ध-निजी और पूर्ण निजी सेटों में 135 वातावरण शामिल हैं। हर वातावरण एक टर्न-आधारित, गेम-जैसा परिदृश्य है जिसे इन-हाउस डिज़ाइन टीम ने बनाया है। एजेंट को कोई संकेत नहीं दिया जाता। वह बस दुनिया की स्थिति देखता है, एक क्रिया करता है, परिणाम देखता है, और दोहराता है।
इसकी तकनीकी शोध-पत्र में बेंचमार्क को चार मूल क्षमताओं की परीक्षा के रूप में वर्णित किया गया है: अन्वेषण, मॉडलिंग, लक्ष्य-निर्धारण, और योजना बनाना।
यह सुनिश्चित करने के लिए कि बेंचमार्क प्रशिक्षण डेटा की पुनरावृत्ति नहीं बल्कि तर्क को मापे, ARC-AGI-3 के वातावरण भाषा, संख्याएँ, अक्षर, सांस्कृतिक प्रतीक, या पहचाने जाने योग्य वास्तविक वस्तुओं से बचते हैं। इसके बजाय, वे केवल ARC Prize टीम द्वारा कही गई "कोर नॉलेज" पूर्वधारणाओं पर आधारित हैं—ऐसी बुनियादी संज्ञानात्मक क्षमताएँ जो सभी मनुष्यों में साझा होती हैं।
इन पूर्वधारणाओं में वस्तुनिष्ठता (यह समझना कि चीज़ें स्थायी इकाइयाँ हैं जो चल-टकरा सकती हैं), बुनियादी ज्यामिति और टोपोलॉजी (समानता, घूर्णन, "अंदर" बनाम "बाहर"), बुनियादी भौतिकी (संवेग, गुरुत्व, उछाल), और एजेंटनेस (यह पहचानना कि वातावरण में कोई चीज़ उद्देश्यपूर्वक कार्य कर रही है) शामिल हैं। अगर किसी वातावरण में यह जानना ज़रूरी हो कि चाबी ताला खोलती है, तो वह तर्क के बजाय प्रशिक्षण डेटा की परीक्षा होगी।
स्थिर मूल्यांकन से इंटरएक्टिव वातावरण की ओर झुकाव बेंचमार्क के वास्तविक मापन को बदल देता है।
हर ARC-AGI-3 वातावरण 64×64 ग्रिड प्रस्तुत करता है जहां प्रत्येक सेल 16 संभावित रंगों में से एक दिखाता है। एजेंट को दृश्य अवस्था ("फ्रेम") एक JSON ऑब्जेक्ट के रूप में मिलती है, फिर वह प्रति टर्न एक क्रिया सबमिट करता है। एक्शन स्पेस छोटा है: आमतौर पर पाँच दिशात्मक या कुंजी-आधारित कमांड, साथ में विशिष्ट ग्रिड सेल चुनने के लिए वैकल्पिक निर्देशांक-आधारित "क्लिक" क्रिया।
वातावरण सख्ती से टर्न-आधारित हैं। जब तक एजेंट कार्य नहीं करता, कुछ नहीं बदलता—जिसका अर्थ है कि बेंचमार्क तेज़ रिफ्लेक्स के बजाय सावधान तर्क को पुरस्कृत करता है। महत्वपूर्ण रूप से, आंतरिक प्रक्रियाएँ—जैसे रीज़निंग स्टेप्स, रिट्राई, या टूल कॉल—क्रिया नहीं मानी जातीं। केवल वे कमांड जो वास्तव में वातावरण की अवस्था बदलते हैं, एजेंट के स्कोर में गिनी जाती हैं।
हर वातावरण में कई लेवल होते हैं जो कठिनाई के बढ़ते क्रम में व्यवस्थित हैं। पहला लेवल ट्यूटोरियल की तरह काम करता है, जो न्यूनतम जटिलता के साथ बुनियादी यांत्रिकी से परिचय कराता है। बाद के लेवल नए नियम और अंतःक्रियाएँ जोड़ते हैं, इसलिए एजेंट को सीखी हुई चीज़ें आगे बढ़ाकर अधिक जटिल स्थितियों में लागू करनी पड़ती हैं।
ARC-AGI-3 में कठिनाई अस्पष्टता या पैमाने से नहीं आती। यह कई यांत्रिकियों की रचना से आती है, जो लेवल दर लेवल सीखी जाती हैं। एकल-यांत्रिकी वाला वातावरण ब्रूट-फोर्स से बहुत आसान हो जाएगा। असली परीक्षा कई सीखी हुई गतिशीलताओं को जोड़कर ऐसी समस्या हल करना है जिसे एजेंट ने पहले कभी नहीं देखा।
बेंचमार्क एक कस्टम Python-आधारित इंजन पर चलता है जिसे हेडलेस मोड में 1,000 FPS प्रदर्शन सीमा पूरी करने के लिए डिज़ाइन किया गया है। डेवलपर pip install arc-agi से शुरुआत कर सकते हैं और SDK या REST API के माध्यम से वातावरण के साथ इंटरेक्ट कर सकते हैं। आप ब्राउज़र में सार्वजनिक वातावरण खेल कर यह भी देख सकते हैं कि ये गेम कैसे दिखते हैं।
एक बात पहले से जान लें: ये स्कोर मार्च 2026 के अंत तक की लीडरबोर्ड स्थिति दर्शाते हैं और शोधकर्ता नए तरीकों के साथ आते ही लगभग निश्चित रूप से बदलेंगे।
लॉन्च पर, ARC Prize Foundation ने अर्ध-निजी मूल्यांकन सेट पर कई फ्रंटियर मॉडलों का परीक्षण किया।
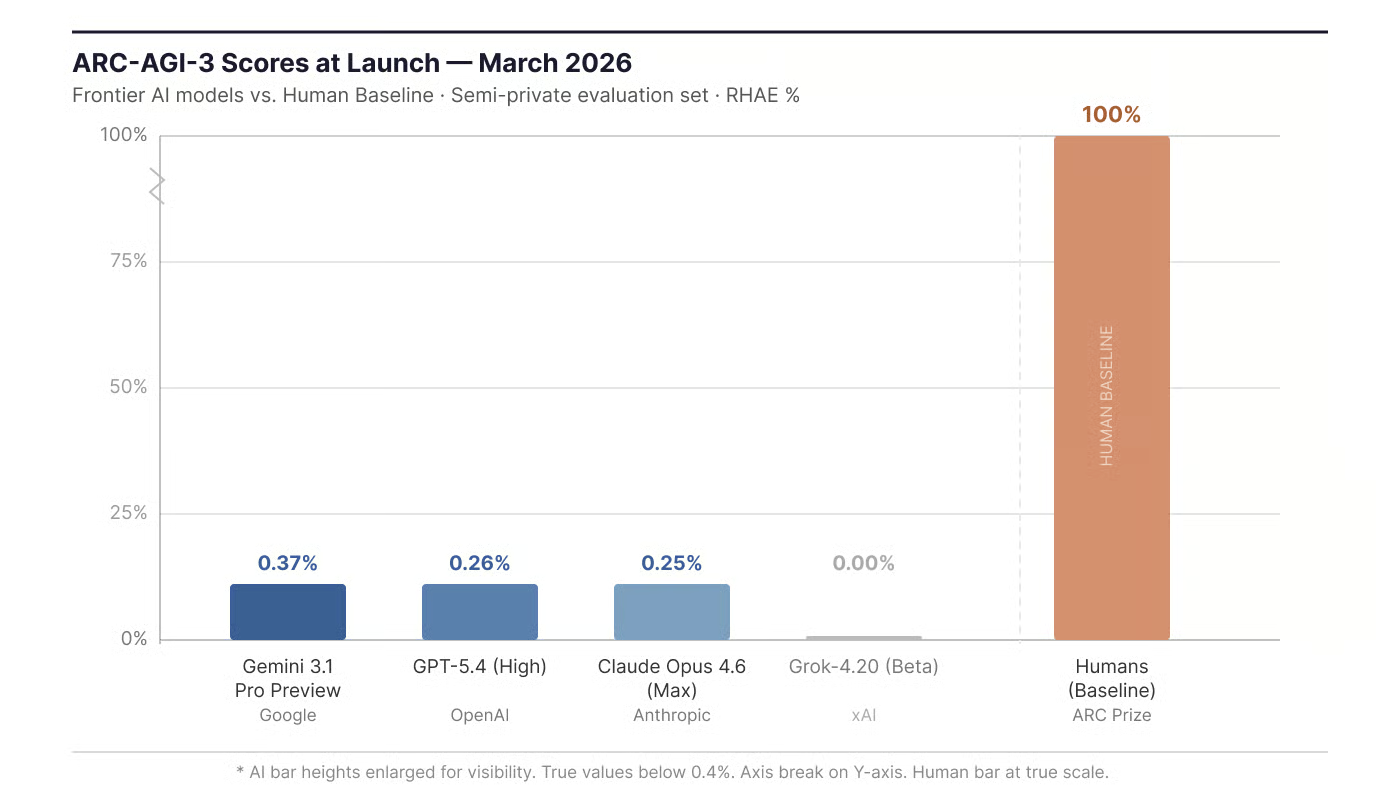
लॉन्च-समय स्कोर (मार्च 2026): फ्रंटियर AI बनाम मानव बेसलाइन। इमेज: लेखक।
संदर्भ के लिए, यही फ्रंटियर मॉडल अधिकांश अन्य AI बेंचमार्क में हावी हैं। ARC-AGI-1 संतृप्ति के करीब है, जहां शीर्ष मॉडल अब 90% से काफी ऊपर स्कोर कर रहे हैं। ARC-AGI-3 पर 1% से कम का गिरना इंगित करता है कि यहां परखी जा रही क्षमताएँ मौजूदा मॉडलों की ताकतों से भिन्न हैं।
Grok-4.20 के लिए 0% स्कोर का मतलब यह नहीं कि मॉडल ने कोई क्रिया नहीं की। इसका अर्थ है कि मॉडल हर लेवल पर बेंचमार्क की एक्शन कटऑफ़ सीमा से अधिक चला गया। स्कोरिंग अनुभाग में मैं बताऊँगा कि वह कटऑफ़ कैसे काम करता है।
प्रीव्यू अवधि में शीर्ष स्कोर करने वाले एजेंट भाषा मॉडल नहीं थे। प्रीव्यू प्रतियोगिता के दौरान (जिसमें 3 सार्वजनिक और 3 निजी वातावरण एक छिपे मूल्यांकन सेट के रूप में थे), Tufa Labs की StochasticGoose प्रणाली ने रीइन्फोर्समेंट लर्निंग और कन्वोल्यूशनल न्यूरल नेटवर्क्स के साथ 12.58% हासिल किया।
हालाँकि, जब StochasticGoose को लॉन्च पर पूरे आधिकारिक बेंचमार्क पर परखा गया, तो इसका स्कोर घटकर 0.25% रह गया—लगभग फ्रंटियर LLMs के बराबर। यह नतीजा बताने वाला है: कुछ जानी-पहचानी वातावरणों पर कारगर तरीका अनदेखे पूरे दायरे के सामने बहुत कमजोर पड़ गया—यह पुष्ट करता है कि ARC-AGI-3 कार्य-विशिष्ट ऑप्टिमाइज़ेशन के बजाय सामान्य अनुकूलनशीलता पर बहुत निर्भर करता है।
यह संकेत देता है कि इंटरएक्टिव फ़ॉर्मेट अलग आर्किटेक्चर के साथ बेहतर काम कर सकता है, क्योंकि भाषा मॉडल ऐसी समस्या पर तर्क से नहीं निकल सकता जिसमें आवश्यक जानकारी हर क्रिया के बाद ही प्रकट होती है।
ताज़ा स्कोर आप ARC-AGI-3 लीडरबोर्ड पर देख सकते हैं।
इन संख्याओं का अर्थ तब बदल जाता है जब आप समझते हैं कि पहले के ARC बेंचमार्क क्या परखते थे। 2019 में Chollet द्वारा जारी ARC-AGI-1 ने अमूर्त दृश्य पहेलियों के माध्यम से तरल बुद्धिमत्ता को नापने की अवधारणा पेश की। फ़ॉर्मेट स्थिर था: मॉडल कुछ इनपुट-आउटपुट ग्रिड उदाहरण देखता, रूपांतरण नियम का अनुमान लगाता, और एक आउटपुट देता। मार्च 2025 में जारी ARC-AGI-2 ने उसी स्थिर फ़ॉर्मेट का इस्तेमाल किया, लेकिन कठिन, अधिक संयोज्य कार्यों के साथ।
ARC-AGI-1 ने बड़े रीज़निंग मॉडलों के उदय को एक नई श्रेणी के रूप में पहचानने में मदद की—OpenAI का o3 पहला स्पष्ट संकेत था। ARC-AGI-2 ने देखा कि वह रीज़निंग क्षमता कितनी तेज़ी से स्केल हुई। लेकिन स्थिर फ़ॉर्मेट में एक कमजोरी थी: टेस्ट-टाइम कम्प्यूट स्केलिंग। इन्फरेंस के दौरान हजारों प्रत्याशी समाधान समानांतर में जनरेट करके, लैब्स ने ARC-AGI-2 स्कोर को एक साल में एकल-अंकों से 50% से काफी ऊपर तक पहुँचा दिया।
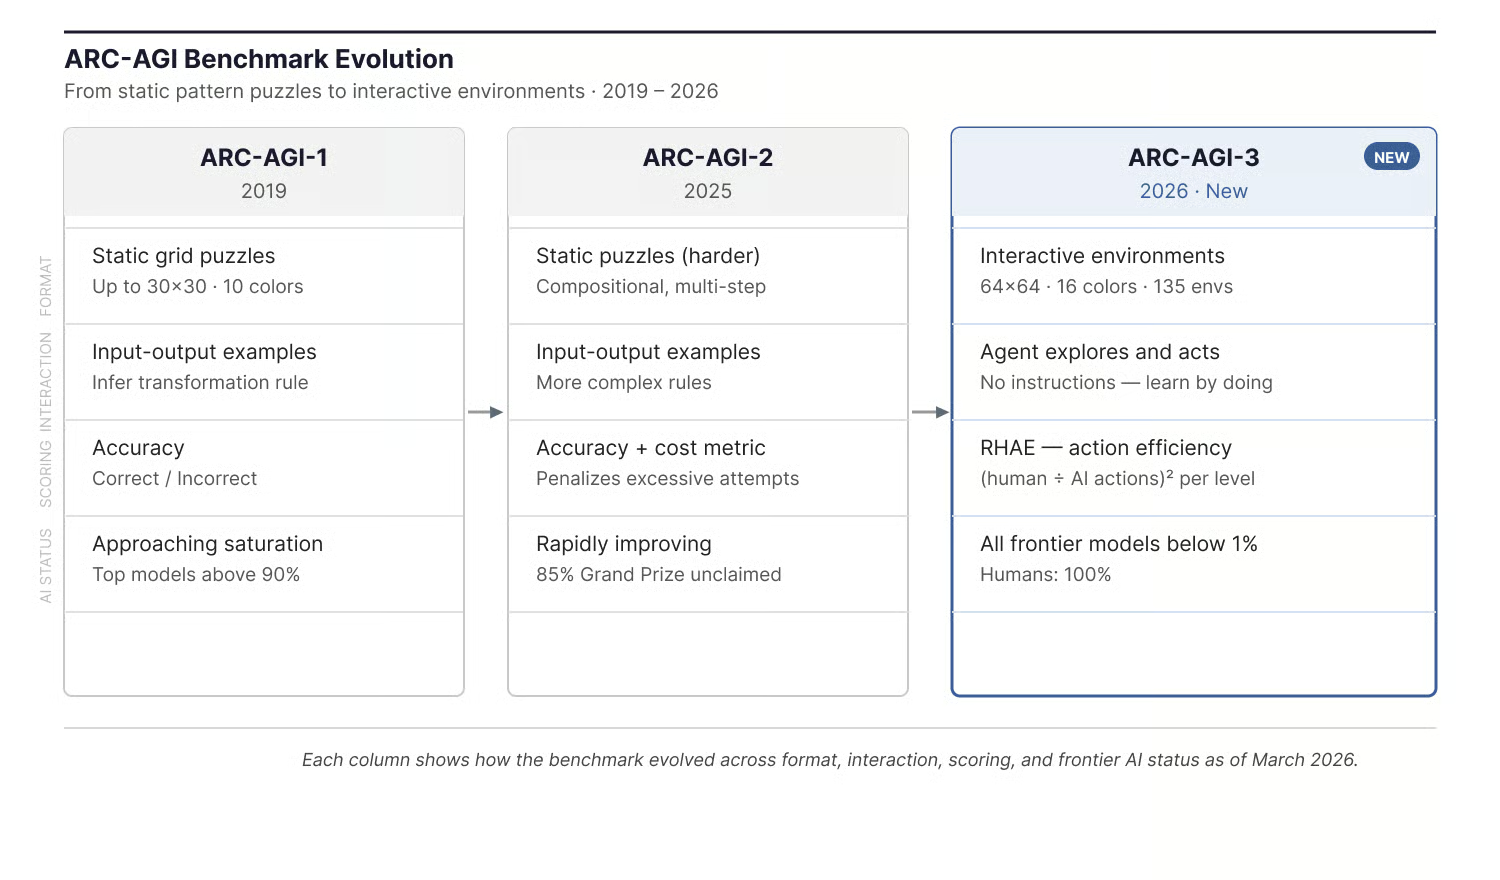
समय के साथ ARC-AGI बेंचमार्क का विकास। इमेज: लेखक।
ARC-AGI-3 ब्रूट-फोर्स सैंपलिंग रणनीति को लागू करना बहुत कठिन बना देता है क्योंकि, जैसा मैंने पहले कहा, वातावरण अपने नियम तभी प्रकट करता है जब एजेंट कार्य करता है। जब समस्या हर क्रिया के साथ बदलती है तो आप कॉन्टेक्स्ट विंडो में 10,000 प्रत्याशी समाधान नहीं जनरेट कर सकते।
इंटरएक्टिव फ़ॉर्मेट के अलावा, ARC-AGI-3 में कुछ विशेष डिज़ाइन विकल्प शामिल हैं जो पहले के संस्करणों को प्रभावित करने वाले डेटा संदूषण और सिंथेटिक जनरेशन शॉर्टकट्स का मुकाबला करने के लिए बनाए गए हैं। सबसे उल्लेखनीय बदलाव है उलटा डेटासेट अनुपात। ARC-AGI-1 और ARC-AGI-2 में सार्वजनिक बनाम निजी कार्यों का अनुपात लगभग 10:1 था, जिससे शोधकर्ताओं को व्यापक प्रशिक्षण सामग्री मिली। ARC-AGI-3 इसे पलट देता है: केवल 25 वातावरण सार्वजनिक हैं, जबकि भारी बहुमत अर्ध-निजी और पूर्ण निजी सेटों में रखा गया है जिनका उपयोग मूल्यांकन के लिए होता है।
ARC Prize टीम ने यह भी संकेत दिया है कि कुछ फ्रंटियर मॉडलों के प्रशिक्षण सेट में ARC डेटा हो सकता है। ARC-AGI-2 के मूल्यांकन के दौरान, Gemini 3 की चेन-ऑफ-थॉट रीज़निंग ने बिना प्रॉम्प्ट के ARC-विशिष्ट रंग मैपिंग का संदर्भ दिया, जो प्रशिक्षण डेटा संतृप्ति का संकेत देता है। सार्वजनिक सतह क्षेत्र को घटाकर और ऐसे इंटरएक्टिव वातावरण पर शिफ्ट होकर जिन्हें स्थिर पैटर्न के रूप में याद नहीं किया जा सकता, ARC-AGI-3 ऐसे शॉर्टकट को बहुत कठिन बनाना चाहता है।
ये डिज़ाइन विकल्प तब और स्पष्ट हो जाते हैं जब आप समझते हैं कि बेंचमार्क असल में क्या परखना चाहता है। बेंचमार्क उस चीज़ को लक्षित करता है जिसे ARC Prize टीम "स्किल-अधिग्रहण दक्षता" कहती है: कोई AI एजेंट किसी ऐसी चीज़ को, जिसका उसने पहले कभी सामना न किया हो, कितनी कुशलता से सीख सकता है।
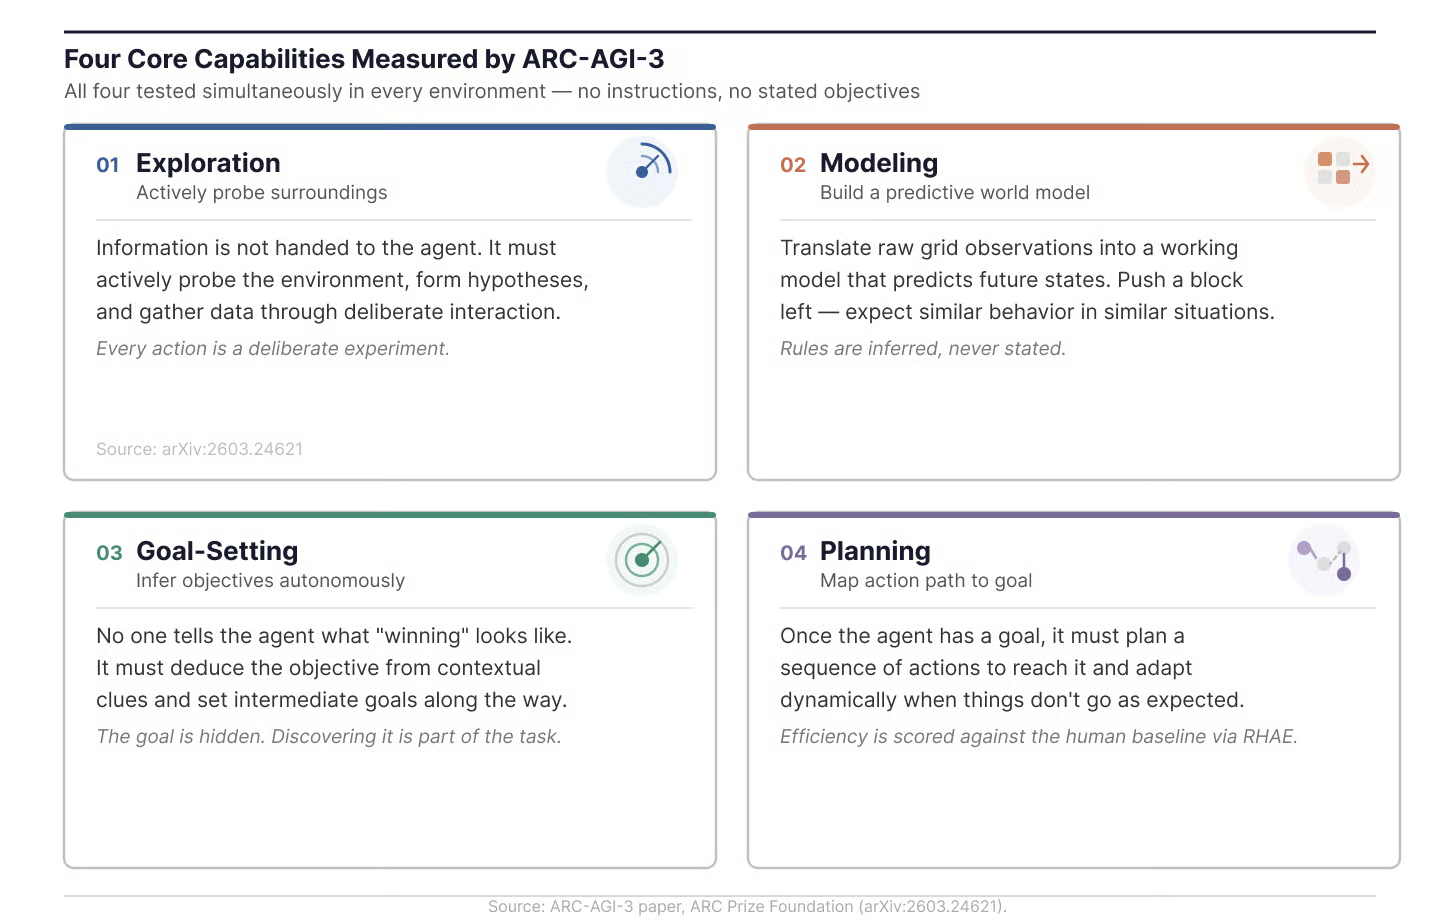
ARC-AGI-3 द्वारा मापी जाने वाली चार मूल क्षमताएँ। इमेज: लेखक।
ये चारों क्षेत्र हर वातावरण में एक साथ परखे जाते हैं—किसी भी चरण पर कोई निर्देश या घोषित उद्देश्य नहीं दिया जाता।
ARC-AGI-3 पर 100% स्कोर का अर्थ होगा कि कोई AI एजेंट हर वातावरण उतनी ही कुशलता से हल कर सकता है जितना कि दूसरे-सर्वश्रेष्ठ मानव परीक्षक। ARC Prize टीम स्पष्ट है कि यह AGI के बराबर नहीं होगा। इसका मतलब होगा कि AI और मानव सीखने के बीच का एक विशेष अंतर पाट दिया गया है।
स्कोरिंग वह क्षेत्र है जहाँ ARC-AGI-3 सबसे अलग है। यह केवल यह नहीं देखता कि एजेंट अंततः किसी समाधान पर टकरा गया या नहीं। यह मापता है कि एजेंट वहाँ तक कितनी कुशलता से पहुँचा।
इस मीट्रिक को RHAE कहा जाता है—Relative Human Action Efficiency। प्रति-लेवल फ़ॉर्मूला है:
Level Score = min(1.0, (human_baseline_actions / AI_actions))²
मुख्य बात है वर्ग (स्क्वायर्ड) पद। यह रैखिक संबंध नहीं है। क्रिया-गिनती दोगुनी करने से स्कोर आधा नहीं, एक-चौथाई हो जाता है। दस गुना क्रिया स्कोर को लगभग शून्य तक गिरा देती है। यह पावर-लॉ डिज़ाइन ब्रूट-फोर्स तरीकों को कड़ी सज़ा देता है और उन एजेंटों को पुरस्कृत करता है जो वास्तव में वातावरण को समझते हैं।
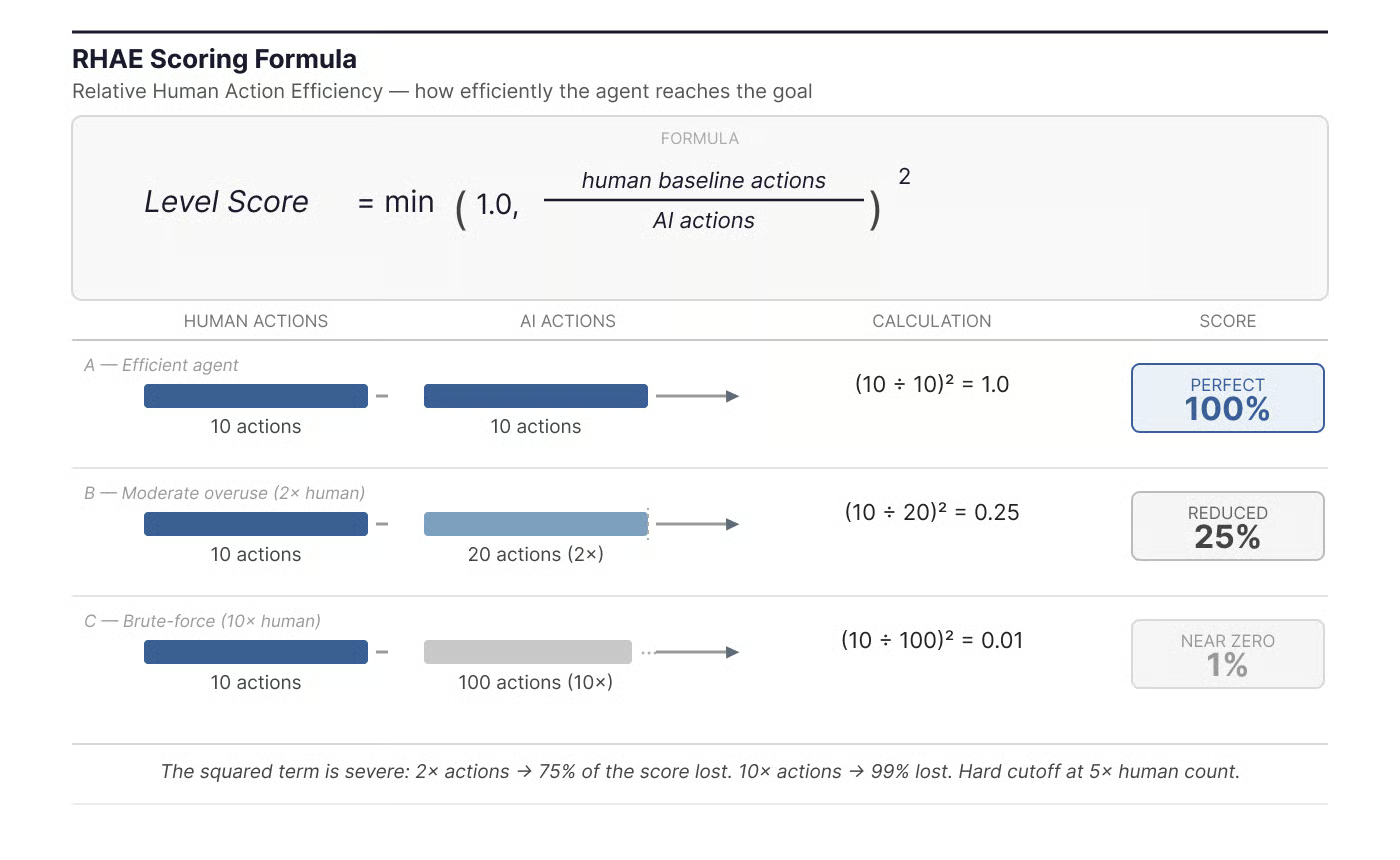
किये गए उदाहरणों के साथ RHAE स्कोरिंग फ़ॉर्मूला। इमेज: लेखक।
मानव बेसलाइन 10 परीक्षकों में से दूसरे-सर्वश्रेष्ठ प्रदर्शनकर्ता द्वारा तय होती है, जिन्होंने हर वातावरण को पहली बार में आज़माया। सर्वोत्तम के बजाय दूसरे-सर्वश्रेष्ठ का उपयोग सौभाग्य से मिलने वाले आउटलायर को फ़िल्टर करता है, जबकि वास्तविक खेल में जमे रहता है।
एक सख्त कटऑफ़ भी है: यदि कोई एजेंट किसी लेवल पर मानव क्रिया-गिनती के 5 गुना से अधिक लेता है, तो उसे काट दिया जाता है और उस लेवल पर शून्य स्कोर मिलता है। और स्कोर 1.0 पर कैप्ड हैं, इसलिए यदि कोई अनपेक्षित शॉर्टकट मानव बेसलाइन को मात देता है, तो भी बोनस क्रेडिट नहीं मिलता।
हर वातावरण के भीतर, बाद के लेवल अधिक मायने रखते हैं। स्कोरिंग वेटेड एवरेज का उपयोग करती है, जहाँ लेवल 1 का वेट 1, लेवल 2 का 2, और इसी तरह बढ़ता है। इसका मतलब है कि ट्यूटोरियल लेवल का प्रभाव मामूली होता है, जबकि वे कठिन लेवल जो कई सीखी हुई यांत्रिकियों को जोड़ना मांगते हैं, सबसे अधिक वजन रखते हैं।
ARC-AGI-3 अलग नियमों के साथ दो स्वतंत्र लीडरबोर्ड बनाए रखता है। आधिकारिक (Official) लीडरबोर्ड फ्रंटियर मॉडलों का मूल्यांकन सामान्य-उद्देश्य API प्रणालियों का उपयोग करके करता है जिन्हें ARC-AGI-3 के लिए विशेष रूप से तैयार नहीं किया गया है। कम्युनिटी लीडरबोर्ड स्व-रिपोर्टेड परिणामों की अनुमति देता है और हार्नेस स्वीकार करता है। यह विभाजन महत्वपूर्ण है क्योंकि, जैसा मैंने पहले कहा, हाथ से बनाए हार्नेस ज्ञात वातावरणों पर स्कोर को नाटकीय रूप से बढ़ा सकते हैं, जबकि अनदेखे पर पूरी तरह विफल हो जाते हैं। आधिकारिक लीडरबोर्ड AI की वास्तविक अनुकूलनशीलता को मापने के लिए बनाया गया है, डेवलपर की स्कैफोल्डिंग को नहीं।
ARC-AGI-3 इस वर्ष की प्रतियोगिता का केंद्रबिंदु है, पर यह एकमात्र ट्रैक नहीं है।
ARC Prize 2026 में कुल $2 मिलियन से अधिक की पुरस्कार-राशि तीन ट्रैक्स में विभाजित है। ARC-AGI-3 ट्रैक में कुल $850,000 के पुरस्कार हैं, जिसमें $700,000 का ग्रैंड प्राइज़ उस पहले पात्र एजेंट के लिए है जो पूर्ण निजी मूल्यांकन सेट पर 100% हासिल करे। यदि यह इस वर्ष नहीं जीता जाता, तो राशि 2027 में रोलओवर हो जाएगी। ग्रैंड प्राइज़ के अलावा, शीर्ष पाँच फिनिशरों में बाँटा जाने वाला $75,000 का टॉप-स्कोर अवॉर्ड है, और दो माइलस्टोन चेकपॉइंट (30 जून और 30 सितंबर, 2026) हैं, जो प्रत्येक तारीख पर शीर्ष तीन टीमों में $37,500 वितरित करते हैं।
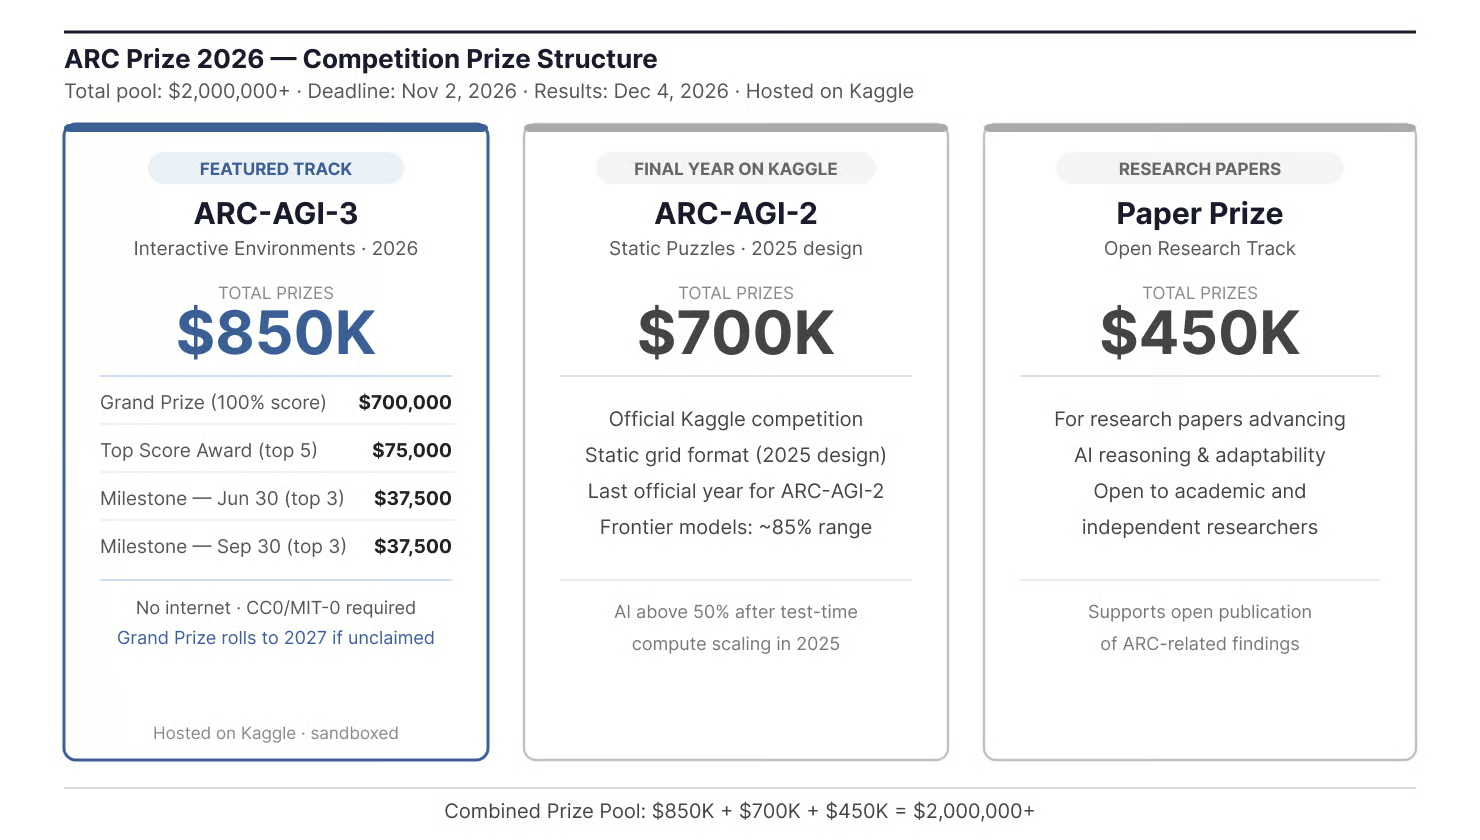
ARC Prize 2026 प्रतियोगिता की पुरस्कार संरचना। इमेज: लेखक।
अन्य दो ट्रैक हैं ARC-AGI-2 ट्रैक ($700,000, और विशेष रूप से ARC-AGI-2 का आधिकारिक Kaggle प्रतियोगिता में उपयोग होने का अंतिम वर्ष) और पेपर प्राइज़ ट्रैक ($450,000 शोध-पत्रों के लिए)।
प्रतियोगिता Kaggle पर चलती है, पर कुछ ऐसे नियमों के साथ जो इसे एक सामान्य Kaggle प्रतियोगिता से अलग करते हैं। सब्मिशन एक सैंडबॉक्स्ड वातावरण में, बिना इंटरनेट एक्सेस के मूल्यांकित होते हैं—जिससे GPT, Claude, या Gemini जैसे होस्टेड मॉडलों को API कॉल संभव नहीं रहती। सभी पुरस्कार-योग्य समाधान निजी मूल्यांकन स्कोर प्राप्त करने से पहले एक अनुमतिपूर्ण या सार्वजनिक-डोमेन लाइसेंस (CC0 या MIT-0) के अंतर्गत जारी किए जाने चाहिए। प्रतियोगिता 25 मार्च, 2026 को खुली, अंतिम सब्मिशन की समय-सीमा 2 नवंबर, 2026 है, और परिणाम 4 दिसंबर, 2026 को घोषित होंगे।
बेंचमार्क तब सबसे अधिक मायने रखते हैं जब वे ऐसा अंतर उजागर करें जो पहले अंतर जैसा नहीं लगता था। इस कसौटी पर पहले दो ARC बेंचमार्क खरे उतरे: ARC-AGI-1 ने बड़े रीज़निंग मॉडलों के उभरने को सामने लाया, और ARC-AGI-2 ने टेस्ट-टाइम कम्प्यूट स्केलिंग कितनी दूर जा सकती है, इसे ट्रैक किया। ARC-AGI-3 एक अलग समस्या की ओर इशारा कर रहा है।
यह बेंचमार्क फिलहाल इसलिए प्रासंगिक है क्योंकि संदर्भ यही है। 2026 की शुरुआत तक, कई व्यापक रूप से प्रयुक्त AI बेंचमार्क संतृप्ति के करीब हैं। फ्रंटियर मॉडल MMLU, HumanEval, और GSM8K सहित अन्य पर 90% से ऊपर स्कोर करते हैं, जिससे ये मूल्यांकन प्रणालियों के बीच फर्क बताने की क्षमता सीमित कर देते हैं। ARC-AGI-3 ऐसी क्षमता की परीक्षा करता है जो मौजूदा मॉडलों में नज़र नहीं आती: अपरिचित वातावरणों के भीतर चलते-फिरते सीखना। 1% से कम AI स्कोर और 100% मानव हल-क्षमता के बीच का अंतर इतना बड़ा है कि यह केवल उसी परीक्षा का कठिन संस्करण नहीं, बल्कि अलग किस्म की चुनौती का संकेत देता है।
ARC Prize ARC-AGI-3 को इंटरएक्टिव रीज़निंग की सबसे महत्वपूर्ण परीक्षा के रूप में पेश करता है—हालाँकि याद रखना चाहिए कि यह फ्रेमिंग उसी संगठन से आती है जो बेंचमार्क चलाता है। यह दावे कितने टिकते हैं, यह इस पर निर्भर करेगा कि शोध समुदाय इसके अनुकूलन के साथ इसे कैसे परखता है।
कोई भी बेंचमार्क परिपूर्ण नहीं होता, और ARC-AGI-3 पर कुछ आलोचनाएँ भी हुई हैं जिनका उल्लेख करना उचित है।
एक आम चिंता स्वयं स्कोरिंग फ़ॉर्मूला है। वर्गीकृत दक्षता मीट्रिक अन्वेषण को कठोरता से दंडित करती है—जबकि तर्कसंगत रूप से अन्वेषण बुद्धिमत्ता का संकेत हो सकता है, विफलता का नहीं। यदि कोई एजेंट समाधान तक पहुँचने से पहले सीमाओं का सावधानीपूर्वक मानचित्रण करने में 50 क्रियाएँ लगाता है, तो उसका स्कोर उस मानव से बहुत खराब होगा जो 5 क्रियाओं में नियम का अनुमान लगा ले। कुछ समुदाय-सदस्यों का तर्क है कि इससे प्रदर्शन-अंतर कृत्रिम रूप से बड़ा दिखता है।
बेसलाइन चयन का प्रश्न भी है। जैसा कि मैंने स्कोरिंग अनुभाग में बताया, बेंचमार्क औसत के बजाय दूसरे-सर्वश्रेष्ठ मानव परीक्षक का उपयोग करता है, जो मानक को ऊँचा रखता है। इस दृष्टिकोण में सामान्य मनुष्य भी 100% से नीचे स्कोर करेंगे।
ARC Prize टीम इस बेंचमार्क को किसी विशिष्ट कमी को मापने का वैज्ञानिक प्रयास मानती है, न कि सामान्य बुद्धिमत्ता की निर्णायक परीक्षा। आज जो हम जानते हैं, उसके आधार पर यह आकलन उचित लगता है।
ARC-AGI-3 AI प्रणालियों के मूल्यांकन के लिए एक अलग तरीका अपनाता है। स्थिर पहेलियों से इंटरएक्टिव वातावरण की ओर बढ़कर, यह परखता है कि क्या मॉडल अन्वेषण कर सकते हैं, अपने लक्ष्य स्वयं तय कर सकते हैं, और निर्देशों के बजाय अनुभव के जरिए चीज़ें समझ सकते हैं।
शुरुआती संख्याएँ चौंकाने वाली हैं। कोडिंग बेंचमार्क, गणित प्रतियोगिताएँ, और ज्ञान परीक्षाओं में हावी मॉडल यहाँ 1% पार करने के लिए भी जूझते हैं। यह अंतर जल्दी पाट दिया जाएगा—जैसा पहले के ARC बेंचमार्क में हुआ था—या इंटरएक्टिव फ़ॉर्मेट को भेदना कठिन साबित होगा—यह ऐसी बात है जिस पर नज़र रखना सार्थक है।
एडैप्टिव AI प्रणालियों के पीछे की अवधारणाओं पर अधिक जानने के लिए हमारा AI Fundamentals स्किल ट्रैक या हमारा Building Scalable Agentic Systems कोर्स देखें।
DataCamp के साथ सीखें
कोर्स
कोर्स
कोर्स