Last chance! 50% off DataCamp Premium
Sale ends in
Se ti stai preparando per un colloquio da cloud engineer, sei nel posto giusto. In questo articolo trovi alcune delle domande più comuni per aiutarti a fare pratica e acquisire sicurezza. Che tu punti a un ruolo nel cloud engineering, nel DevOps o nell'MLOps, queste domande metteranno alla prova la tua comprensione di concetti cloud, architetture e best practice.
Per rendere questa guida ancora più pratica, ho incluso esempi di servizi dei principali provider cloud—AWS, Azure e GCP—così puoi vedere come le diverse piattaforme affrontano le soluzioni cloud. Iniziamo!
Queste domande fondamentali verificano la tua comprensione dei concetti di cloud computing, dei servizi e dei modelli di distribuzione. Il tuo colloquio in genere inizierà con alcune domande simili.
I tre principali modelli di cloud computing sono:
Ecco alcuni dei vantaggi più importanti del cloud computing:
Esistono quattro modelli principali:
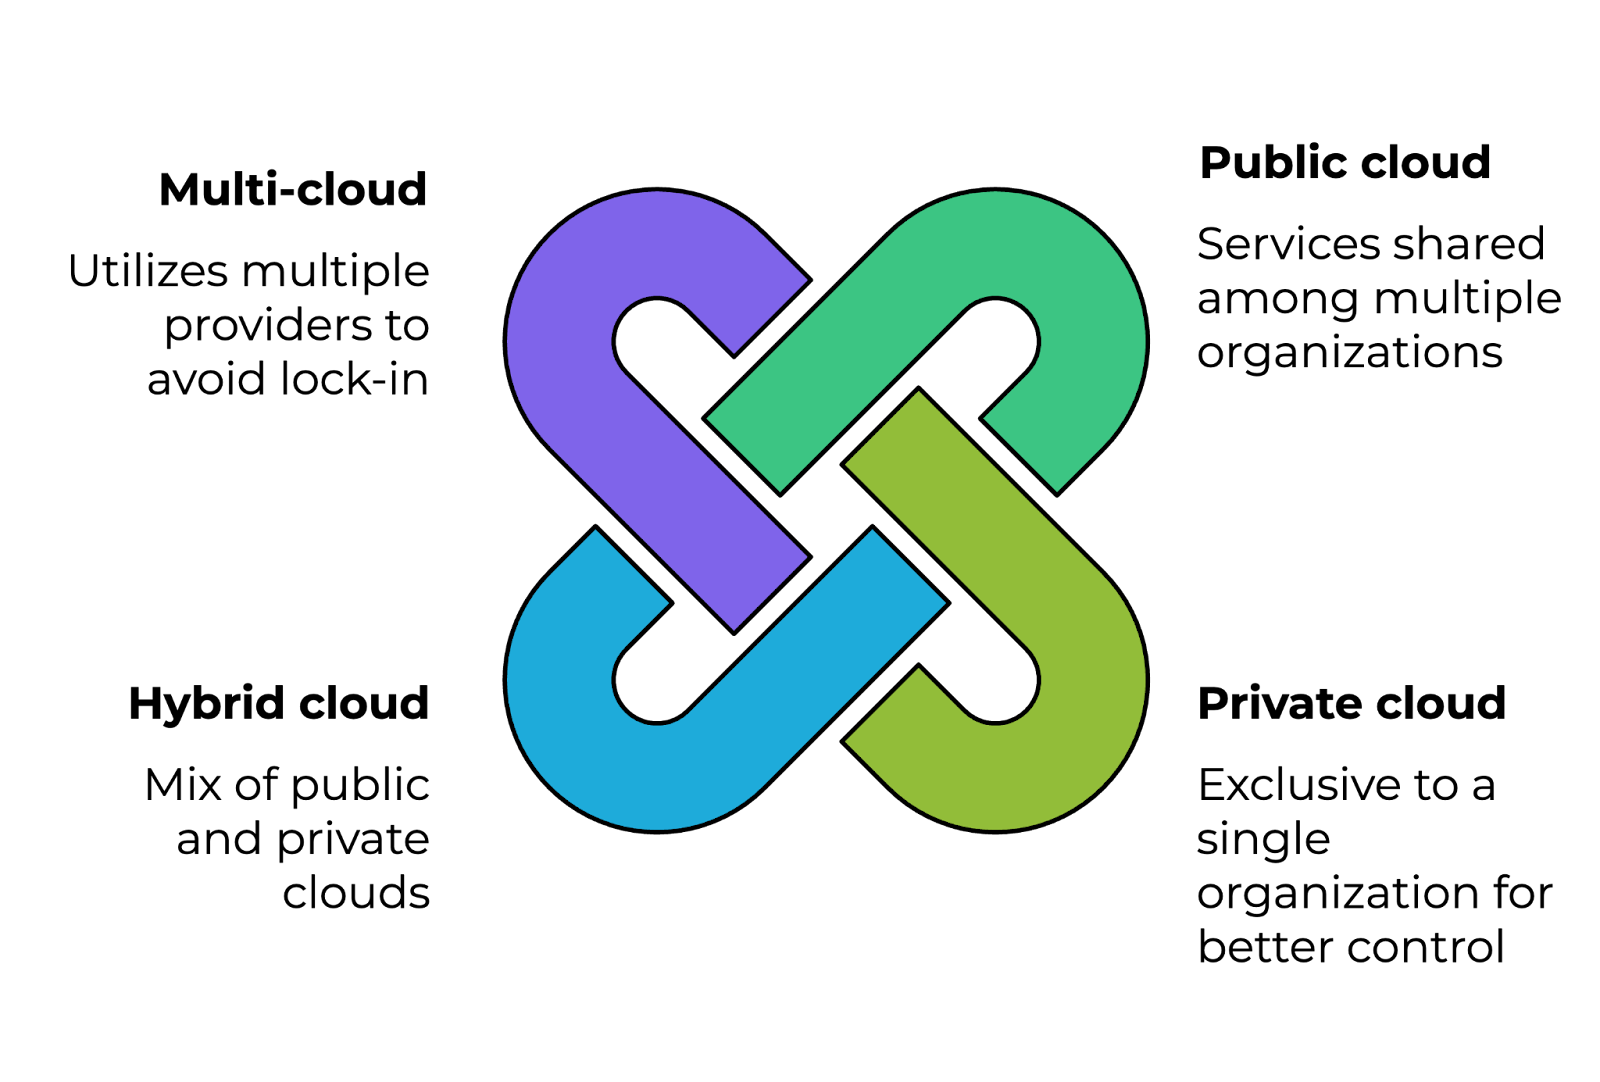
Modelli di distribuzione del cloud. Immagine dell’autore.
La virtualizzazione è il processo di creazione di istanze virtuali di risorse di calcolo, come server, storage e reti, su una singola macchina fisica. Abilita il cloud computing consentendo un’allocazione efficiente delle risorse, multi-tenant e scalabilità.
Tecnologie come Hyper-V, VMware e KVM sono comunemente utilizzate per la virtualizzazione negli ambienti cloud.
Una regione cloud è un’area geografica distinta in cui i provider ospitano più data center. Una availability zone (AZ) è un data center fisicamente separato all’interno di una regione, progettato per offrire ridondanza e alta disponibilità.
Ad esempio, AWS ha più regioni in tutto il mondo, ognuna con due o più AZ per il disaster recovery e la tolleranza ai guasti.
Ecco le differenze tra questi due concetti:
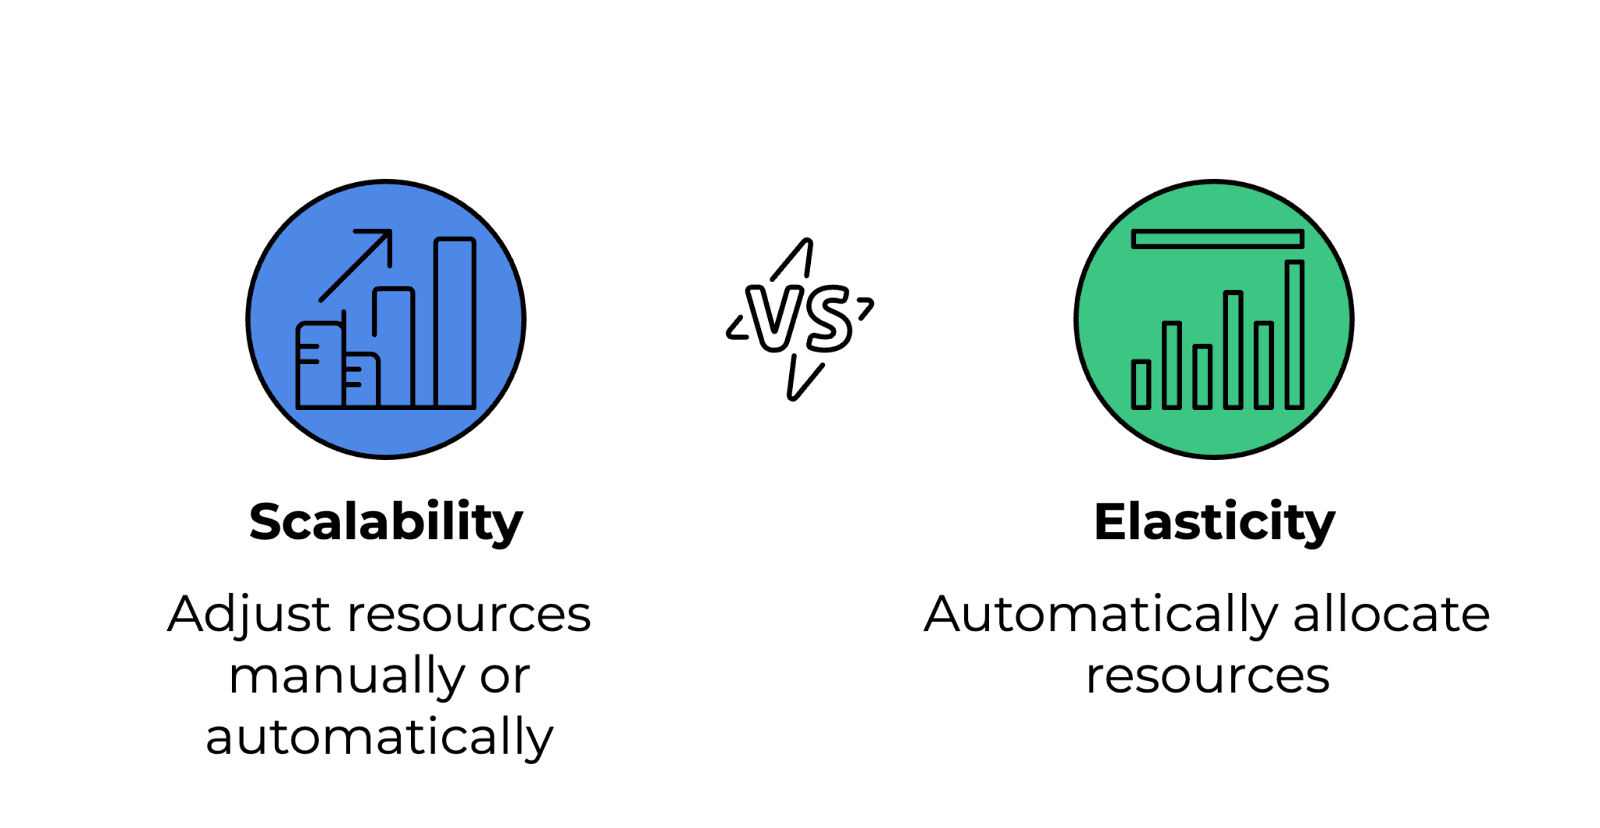
Differenza tra scalabilità ed elasticità. Immagine dell’autore.
La seguente tabella elenca i principali provider cloud, i loro punti di forza e i casi d’uso:
|
Provider cloud |
Punti di forza |
Casi d’uso |
|
Amazon Web Services (AWS) |
Il provider più grande, con una vastissima gamma di servizi. |
Cloud computing generico, serverless, DevOps. |
|
Microsoft Azure |
Forte nelle soluzioni enterprise e nel cloud ibrido. |
Applicazioni enterprise, cloud ibrido, integrazione con l’ecosistema Microsoft. |
|
Google Cloud Platform (GCP) |
Specializzato in big data, AI/ML e Kubernetes. |
Machine learning, data analytics, orchestrazione di container. |
|
IBM Cloud |
Focalizzato su AI e soluzioni cloud per l’impresa. |
Applicazioni basate su AI, trasformazione cloud enterprise. |
|
Oracle Cloud |
Forte su database e applicazioni enterprise. |
Gestione database, applicazioni ERP, carichi di lavoro enterprise. |
Il serverless computing è un modello di esecuzione cloud in cui il provider gestisce automaticamente l’infrastruttura, consentendo agli sviluppatori di concentrarsi sul codice. Si paga solo per il tempo effettivo di esecuzione invece di effettuare il provisioning di risorse fisse. Esempi includono:
L’object storage è un’architettura di archiviazione dati in cui i file sono memorizzati come oggetti discreti all’interno di uno spazio dei nomi piatto, invece che in file system gerarchici. È altamente scalabile ed è usato per dati non strutturati, backup e archiviazione multimediale. Esempi includono:
Una CDN è una rete di server distribuiti che mettono in cache e distribuiscono contenuti (ad es., immagini, video, pagine web) agli utenti in base alla loro posizione geografica. Questo riduce la latenza, migliora le prestazioni del sito e aumenta la disponibilità. CDN popolari includono:
Queste domande approfondiscono networking, sicurezza, automazione e ottimizzazione delle prestazioni nel cloud, mettendo alla prova la tua capacità di progettare, gestire e risolvere problemi in ambienti cloud.
Una virtual private cloud (VPC) è una sezione logicamente isolata di un cloud pubblico che consente di avviare risorse in un ambiente di rete privato. Fornisce maggiore controllo sulle configurazioni di rete, le politiche di sicurezza e la gestione degli accessi.
In una VPC, è possibile definire intervalli di indirizzi IP usando blocchi CIDR. È possibile creare subnet per separare risorse pubbliche e private, mentre security group e ACL di rete aiutano a far rispettare le politiche di accesso.
I load balancer distribuiscono il traffico di rete in ingresso su più server per garantire alta disponibilità, tolleranza ai guasti e prestazioni migliori.
Esistono diversi tipi di load balancer:
IAM è un framework che controlla chi può accedere alle risorse cloud e quali azioni può eseguire. Aiuta a far rispettare il principio del minimo privilegio e a mettere in sicurezza gli ambienti cloud.
In IAM, utenti e ruoli definiscono identità con permessi specifici, le policy concedono o negano accessi tramite regole in JSON e l’autenticazione a più fattori (MFA) aggiunge un ulteriore livello di sicurezza per le operazioni critiche.
I security group e le ACL di rete (access control list) controllano il traffico in entrata e in uscita verso le risorse cloud, ma operano a livelli diversi.
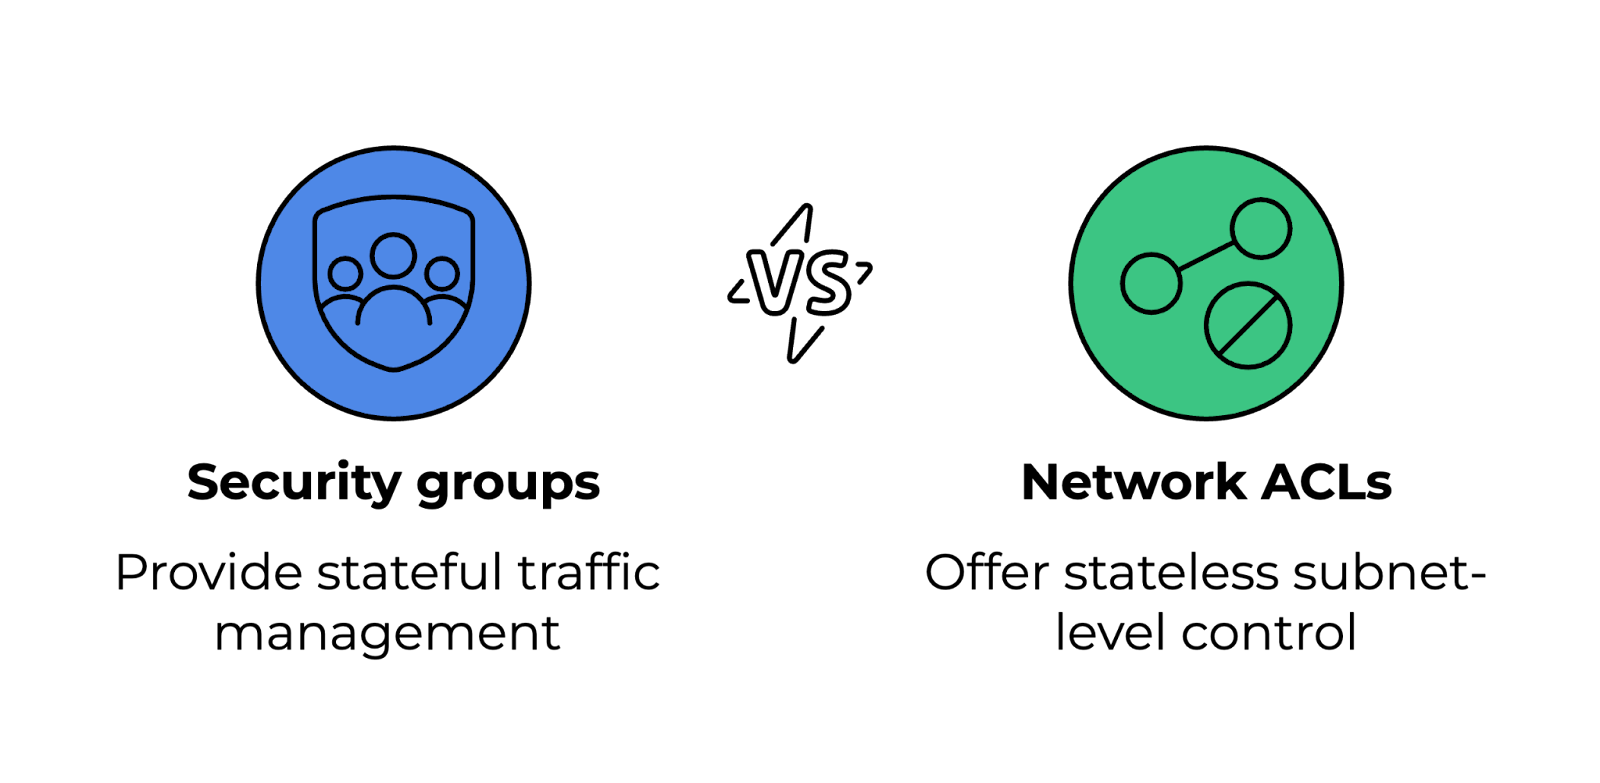
Confronto tra security group e network ACL. Immagine dell’autore.
Un bastion host è un server di salto sicuro per accedere a risorse cloud in una rete privata. Invece di esporre tutti i server a internet, funge da gateway per le connessioni remote.
Per aumentare la sicurezza, dovrebbe avere regole firewall rigorose, consentendo accesso SSH o RDP solo da IP attendibili. È opportuno usare MFA e autenticazione a chiave per l’accesso sicuro ed abilitare logging e monitoraggio per tracciare tentativi di accesso non autorizzati.
L’autoscaling consente agli ambienti cloud di regolare dinamicamente le risorse in base alla domanda, garantendo efficienza dei costi e prestazioni. Funziona in due modi:
I provider cloud offrono gruppi di autoscaling, che lavorano con i load balancer per distribuire il traffico in modo efficace.
Gestire efficacemente i costi cloud richiede monitoraggio dell’uso e scelta dei giusti modelli di prezzo. Le strategie di ottimizzazione includono:
Vuoi padroneggiare la sicurezza AWS e ottimizzare i costi nel cloud? Dai un’occhiata al corso AWS Security and Cost Management per imparare le best practice essenziali.
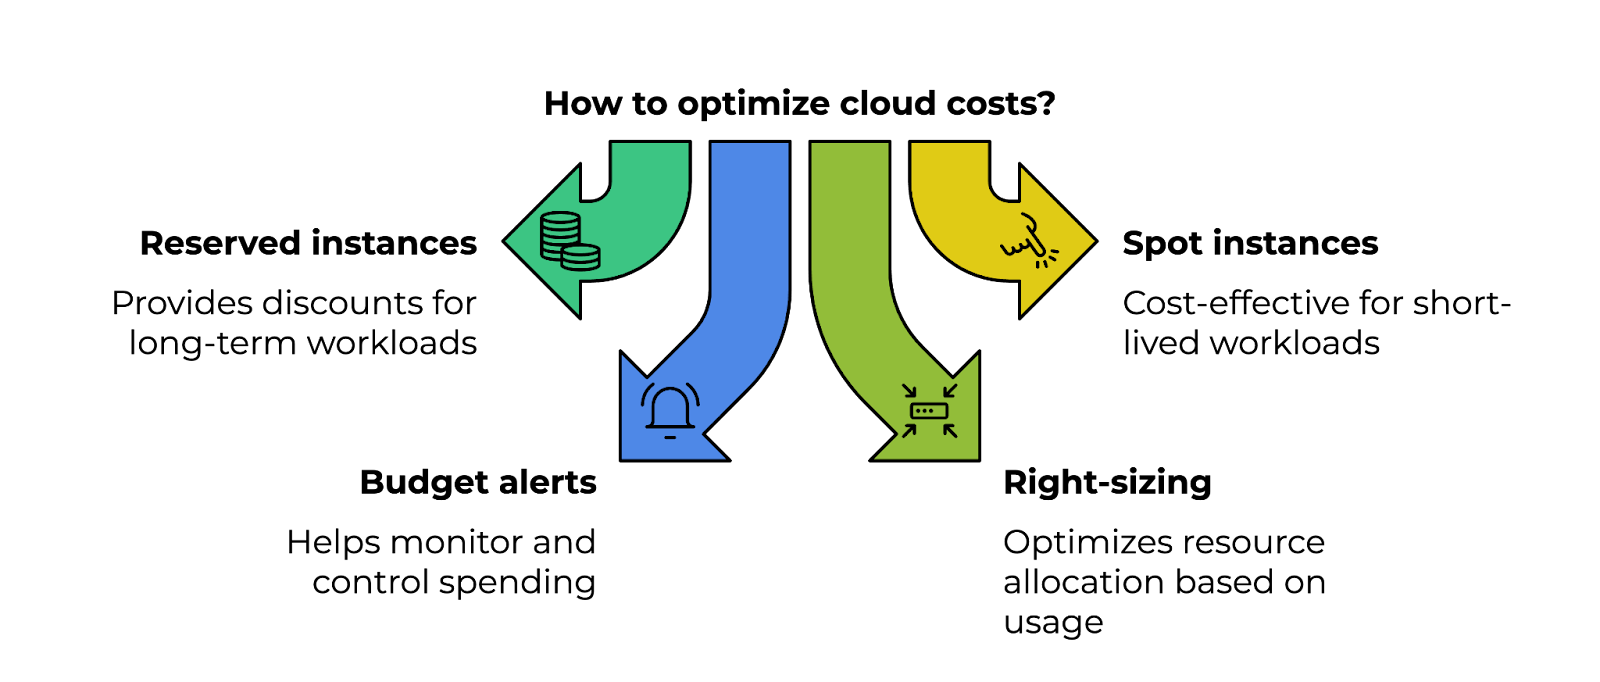
Le quattro colonne dell’ottimizzazione dei costi cloud. Immagine dell’autore.
Terraform e AWS CloudFormation sono entrambi strumenti di Infrastructure as Code (IaC), ma presentano alcune differenze:
|
Caratteristica |
Terraform |
AWS CloudFormation |
|
Supporto cloud |
Cloud-agnostico, supporta AWS, Azure, GCP e altri. |
Specifico per AWS, progettato esclusivamente per risorse AWS. |
|
Linguaggio di configurazione |
Usa l’HCL (HashiCorp Configuration Language). |
Usa template JSON/YAML. |
|
Gestione dello stato |
Mantiene un file di stato per tracciare i cambiamenti dell’infrastruttura. |
Usa stack per gestire e tracciare i deployment. |
Gli strumenti di monitoraggio aiutano a rilevare colli di bottiglia, minacce alla sicurezza e uso eccessivo di risorse. Soluzioni comuni includono:
I container impacchettano le applicazioni con le dipendenze, rendendole leggere, portabili e scalabili. Rispetto alle macchine virtuali, usano meno risorse poiché più container possono girare su un unico OS.
Docker e Kubernetes consentono deployment e rollback più rapidi. Inoltre, scalano facilmente con strumenti di orchestrazione come Kubernetes e Amazon ECS/EKS.
Vuoi affinare le tue competenze di containerizzazione? La track Containerization and Virtualization copre Docker, Kubernetes e altro per aiutarti a creare applicazioni cloud scalabili.
Un service mesh è un livello di infrastruttura che gestisce la comunicazione service-to-service nelle applicazioni cloud basate su microservizi. Fornisce:
Soluzioni popolari includono Istio, Linkerd e AWS App Mesh.
Una strategia multi-cloud prevede l’uso di più provider (AWS, Azure, GCP) per evitare il vendor lock-in e migliorare la resilienza.
Le aziende scelgono questo approccio quando hanno bisogno di ridondanza geografica per il disaster recovery, vogliono sfruttare servizi unici di provider diversi (ad es., AWS per il compute, GCP per l’AI) o devono rispettare normative regionali che limitano la scelta del provider.
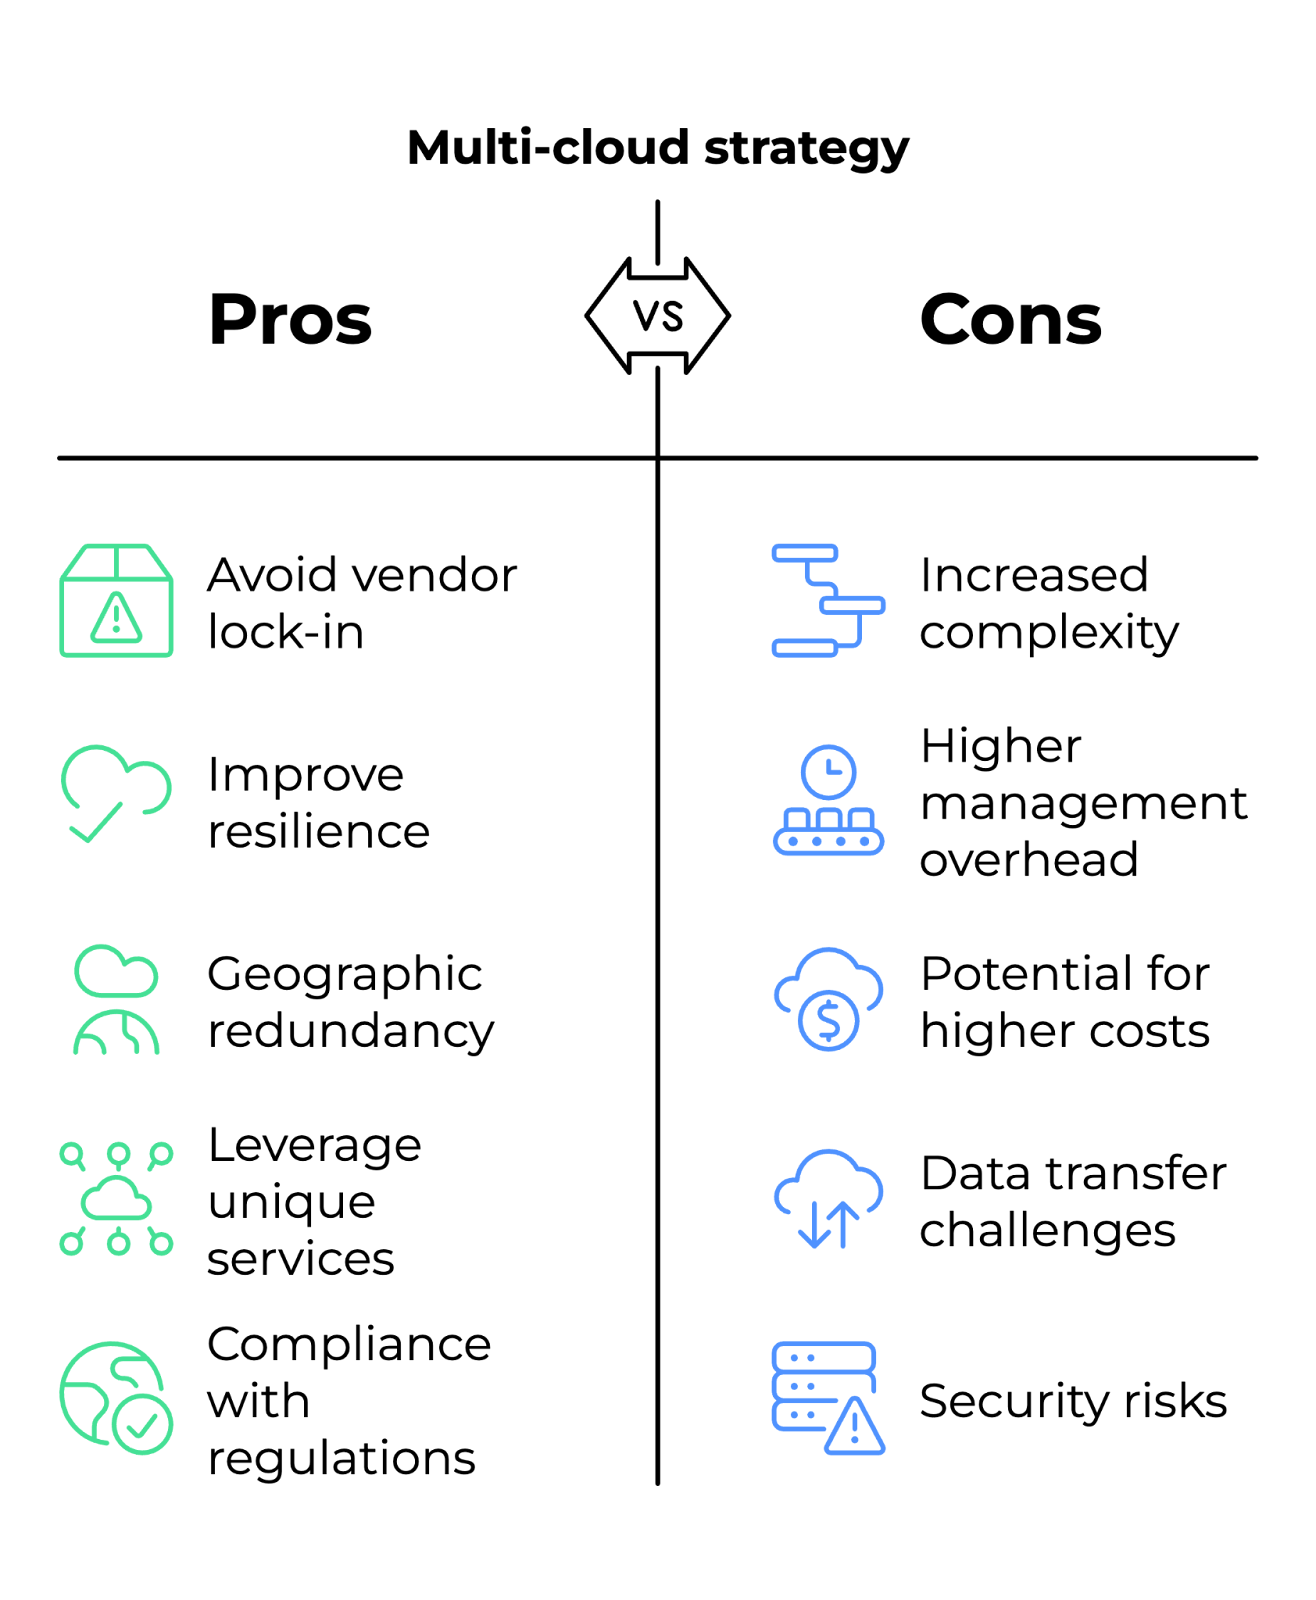
Pro e contro della strategia multi-cloud. Immagine dell’autore.
Queste domande mettono alla prova la tua capacità di progettare soluzioni scalabili, gestire infrastrutture cloud complesse e affrontare scenari critici.
Un’architettura multi-regione riduce al minimo i tempi di inattività e garantisce la continuità operativa distribuendo le risorse in più aree geografiche.
Progettando un’architettura di questo tipo, vanno considerati diversi fattori. Eccone alcuni:
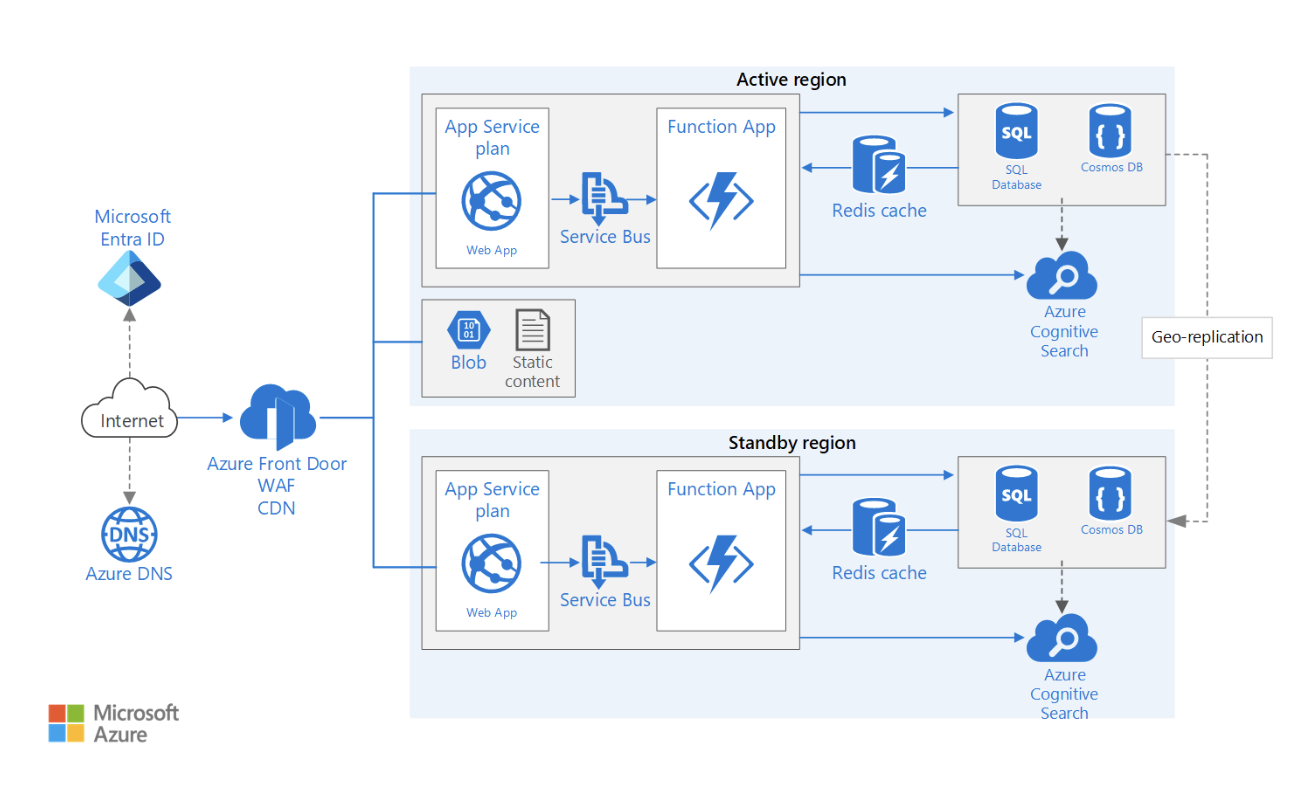
Esempio di architettura web multi-regione ad alta disponibilità. Fonte immagine: Microsoft Learn
Il modello zero trust presume che nessuna entità, interna o esterna alla rete, debba essere considerata attendibile per default.
Per implementare lo zero trust nel cloud:
Una strategia di successo parte da allocazione dei costi e tagging, in cui si impone un tagging strutturato (ad es., dipartimento, progetto, owner) per tracciare la spesa tra i team e migliorare la visibilità finanziaria.
Gli avvisi di budget automatizzati dovrebbero essere impostati con strumenti come AWS Budgets, Azure Cost Management o GCP Billing Alerts per prevenire spese inattese. Queste soluzioni offrono monitoraggio in tempo reale e notifiche quando l’uso si avvicina alle soglie predefinite.
Un altro aspetto è il rightsizing e le istanze riservate. Analizzando continuamente metriche di utilizzo come CPU e memoria, i team possono determinare se adattare i carichi o migrarli a istanze riservate o spot, che offrono risparmi significativi.
L’implementazione delle best practice FinOps migliora ulteriormente l’efficienza dei costi. Strumenti automatici di rilevamento anomalie di costo come Kubecost (per ambienti Kubernetes) e AWS Compute Optimizer aiutano a identificare in modo proattivo le risorse sottoutilizzate e a ottimizzarle.
Infine, le policy di spegnimento automatico svolgono un ruolo essenziale nel ridurre gli sprechi. Funzioni serverless, come AWS Lambda o Azure Functions, possono spegnere automaticamente le risorse sottoutilizzate fuori orario lavorativo, evitando spese inutili.
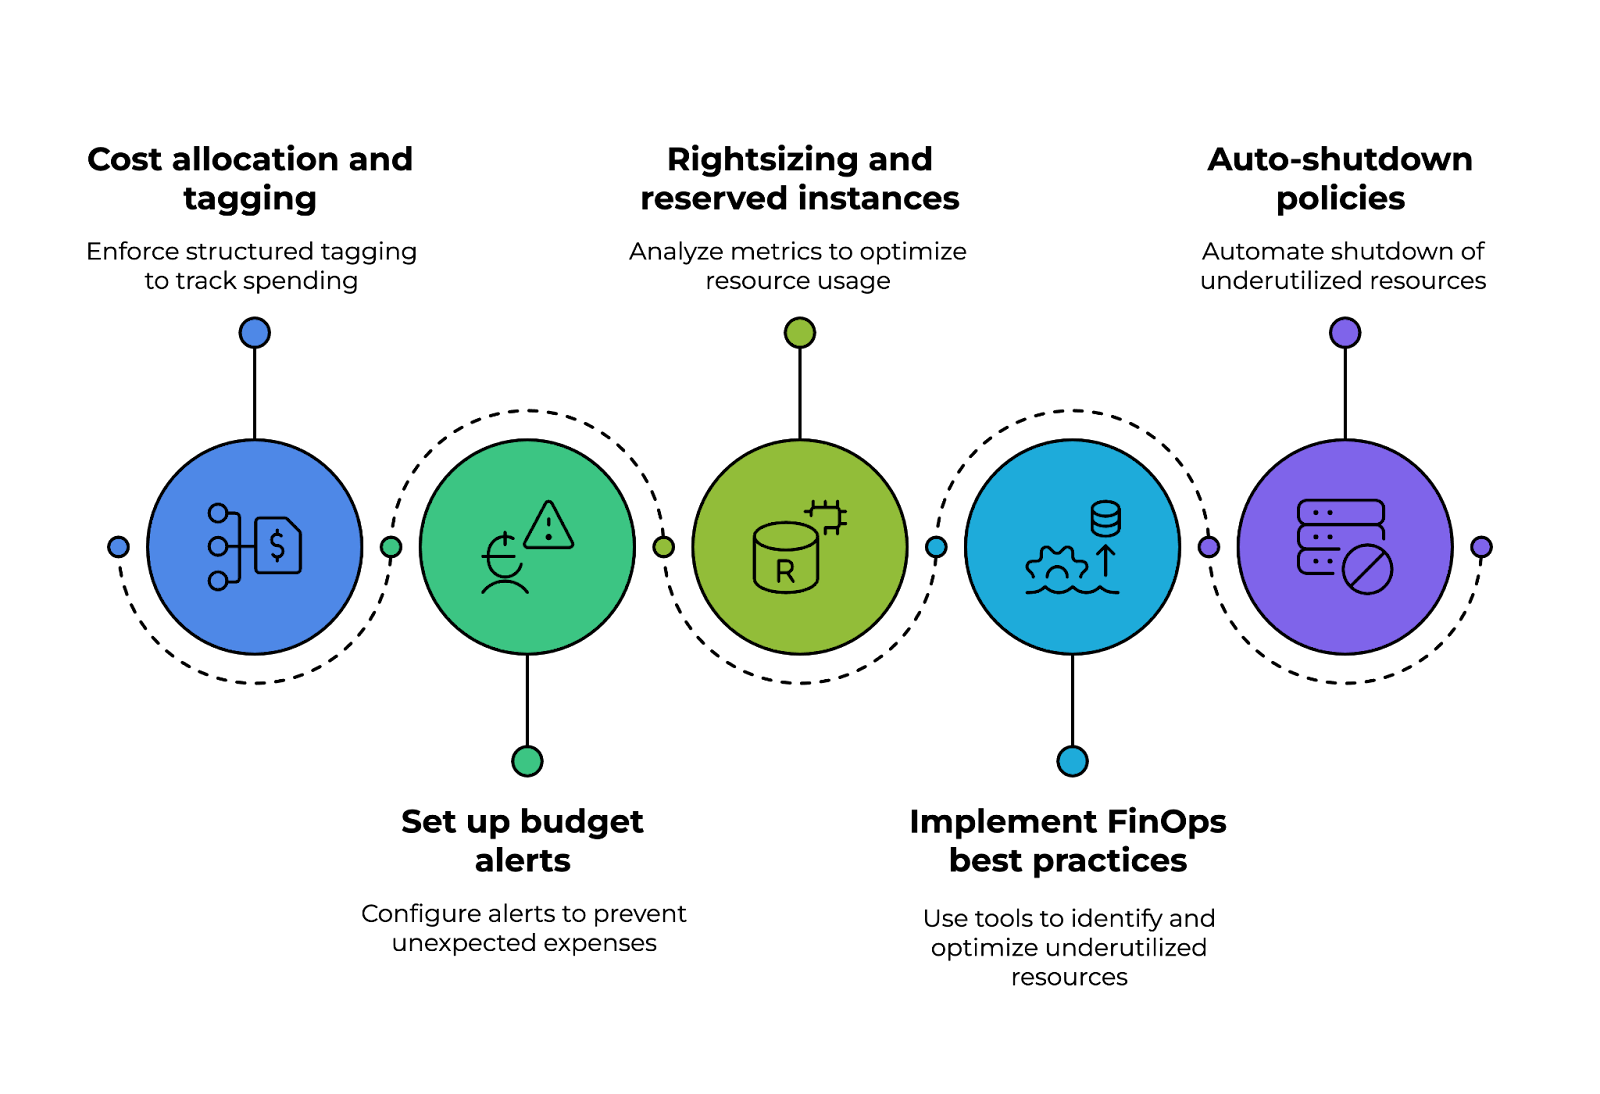
Pilasti di implementazione della strategia di cloud cost governance. Immagine dell’autore.
Un data lake richiede archiviazione, recupero ed elaborazione efficienti di dati su scala petabyte. Alcune strategie di ottimizzazione includono:
Uno degli aspetti fondamentali di una pipeline CI/CD è la gestione del versionamento e dei repository, che abilita collaborazione efficiente e tracciamento dei cambiamenti. Strumenti come GitHub Actions, AWS CodeCommit o Azure Repos aiutano a gestire il codice, applicare strategie di branching e semplificare i workflow di pull request.
L’automazione dei build e la gestione degli artifact sono cruciali per mantenere coerenza e affidabilità. Usando build basati su Docker, JFrog Artifactory o AWS CodeArtifact, i team possono creare build riproducibili, archiviare artefatti in modo sicuro e garantire il versioning tra ambienti.
La sicurezza è un’altra considerazione fondamentale. Integrare strumenti SAST (static application security testing), come SonarQube o Snyk, consente di rilevare presto le vulnerabilità nel codice. Inoltre, imporre immagini container firmate garantisce che vengano distribuiti solo artefatti verificati e attendibili.
Una solida strategia di deployment multi-stage aiuta a ridurre i rischi dei rilasci. Approcci come canary, blue-green o rolling permettono rollout graduali, riducendo i downtime e consentendo il monitoraggio delle prestazioni in tempo reale. Con i feature flag, i team possono controllare quali utenti vedono le nuove funzionalità prima del rilascio completo.
Infine, l’integrazione dell’Infrastructure as Code (IaC) è essenziale per automatizzare e standardizzare gli ambienti cloud. Con Terraform, AWS CloudFormation o Pulumi, i team possono definire l’infrastruttura come codice, mantenere coerenza tra i deployment e abilitare il provisioning delle risorse cloud.
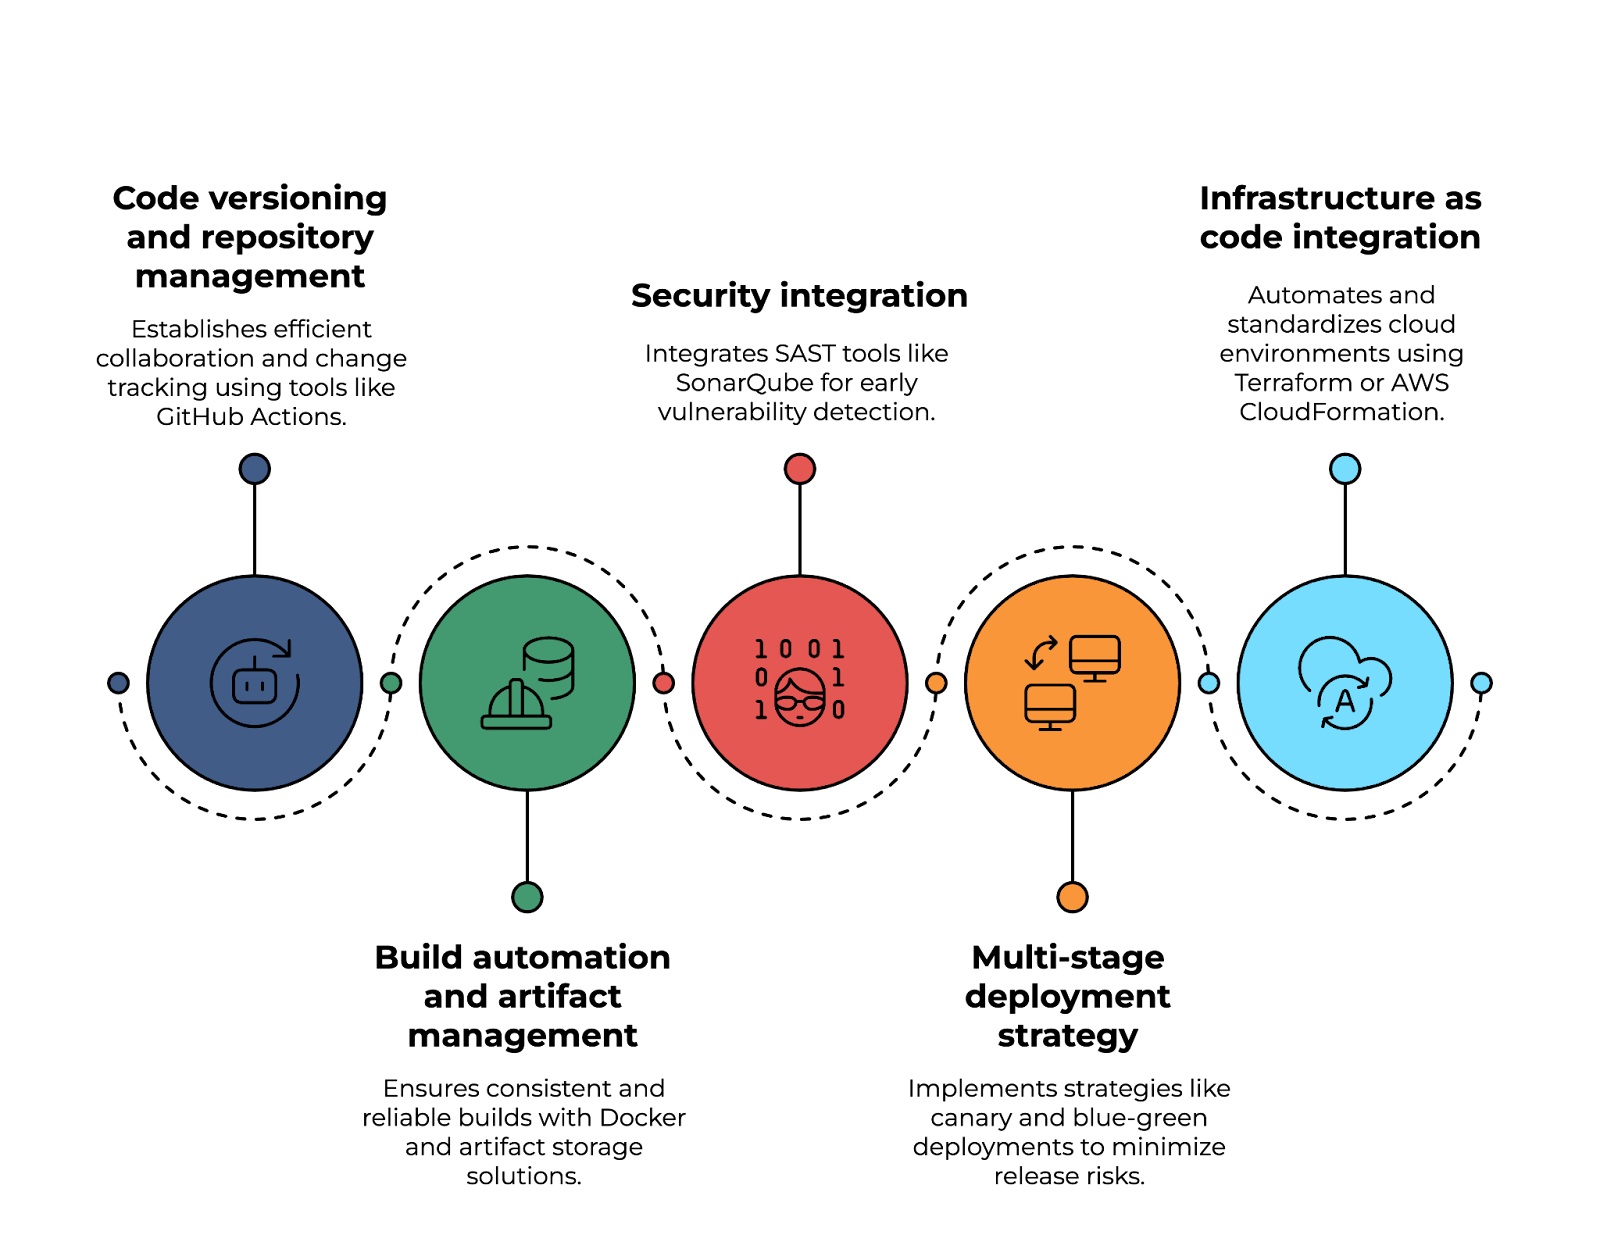
Implementazione di una pipeline CI/CD cloud-native. Immagine dell’autore.
Il disaster recovery (DR) è essenziale per garantire la continuità operativa in caso di outage, attacchi o guasti hardware. Un solido piano di DR include:
Gestire cluster Kubernetes (K8s) su larga scala presenta sfide operative e di prestazioni. Le aree chiave includono:
Le domande basate su scenari valutano la tua capacità di analizzare sfide reali nel cloud, risolvere problemi e prendere decisioni architetturali sotto vincoli diversi.
Le risposte dovrebbero dimostrare esperienza pratica, capacità decisionali e compromessi quando risolvi problemi nel cloud. Poiché non esistono risposte giuste o sbagliate, ho incluso alcuni esempi per guidare il tuo ragionamento.
Esempio di risposta:
L’alta latenza in un’app cloud può essere causata da vari fattori, come congestione di rete, query al database inefficienti, posizionamento subottimale delle istanze o configurazioni errate del load balancing.
Per diagnosticare il problema, inizierei isolando il collo di bottiglia con gli strumenti di monitoraggio del cloud. Il primo passo sarebbe analizzare i tempi di risposta dell’applicazione e la latenza di rete, controllando log, tempi richiesta-risposta e codici di stato HTTP. Se il problema è di rete, userei traceroute o ping per verificare l’aumento dei round-trip time tra utenti e applicazione. In tal caso, abilitare una CDN può aiutare a mettere in cache i contenuti statici vicino agli utenti e ridurre la latenza.
Se le query al database causano ritardi, profilerei le query e le ottimizzerei aggiungendo gli indici corretti o denormalizzando le tabelle. Inoltre, se l’app è sotto traffico elevato, abilitare la scalabilità orizzontale con gruppi di autoscaling o read replica può ridurre il carico sul database primario.
Se la latenza persiste, controllerei le risorse di calcolo dell’app, assicurandomi che giri nella availability zone corretta più vicina agli utenti finali. Se necessario, migrerei i workload a un setup multi-regione o userei soluzioni di edge computing per elaborare le richieste più vicino alla fonte.
Esempio di risposta:
Il primo passo è condurre una valutazione di readiness al cloud, per capire se l’app può essere migrata così com’è o richiede modifiche. Un approccio è usare le “6 R della migrazione al cloud”:
Il lift-and-shift è ideale se l’obiettivo è migrare rapidamente con modifiche minime. Se le priorità sono prestazioni e costi, valuterei il replatforming spostando l’app su container o serverless per una migliore scalabilità. Per applicazioni monolitiche, potrebbe essere necessario il refactoring in microservizi per migliorare prestazioni e manutenibilità.
Mi concentrerei anche sulla migrazione dei dati, assicurando la replica dei database nel cloud con downtime minimo.
Sicurezza e conformità sono un’altra preoccupazione importante. Prima del deployment, mi assicurerei che l’app rispetti i requisiti normativi (ad es., HIPAA, GDPR) implementando crittografia, policy IAM e isolamento in VPC.
Infine, eseguirei test e validazioni in staging prima di deviare il traffico di produzione.
Esempio di risposta:
A livello infrastrutturale, distribuirei il cluster Kubernetes su più availability zone (AZ). Questo assicura che il traffico possa essere instradato a un’altra zona se una AZ non è disponibile. Userei Kubernetes Federation per gestire deployment multi-cluster per setup on-prem o ibridi.
All’interno del cluster, implementerei resilienza a livello di pod con ReplicaSet e HPA per scalare dinamicamente i workload in base a CPU/memoria. Inoltre, i Pod Disruption Budget (PDB) garantirebbero che un numero minimo di pod rimanga disponibile durante aggiornamenti o manutenzione.
Per il networking, userei un service mesh per gestire la comunicazione tra servizi, applicando retry, circuit breaking e politiche di traffic shaping. Un load balancer globale distribuirebbe efficacemente il traffico esterno su più regioni.
Lo storage persistente è un altro aspetto critico. Se i microservizi richiedono persistenza dei dati, userei soluzioni di storage container-native. Configurerei backup cross-region e policy di snapshot automatiche per prevenire la perdita di dati.
Infine, monitoraggio e logging sono essenziali per mantenere alta disponibilità. Integrerei Prometheus e Grafana per il monitoraggio in tempo reale e userei ELK o AWS CloudWatch Logs per tracciare la salute dell’app e rilevare proattivamente i guasti.
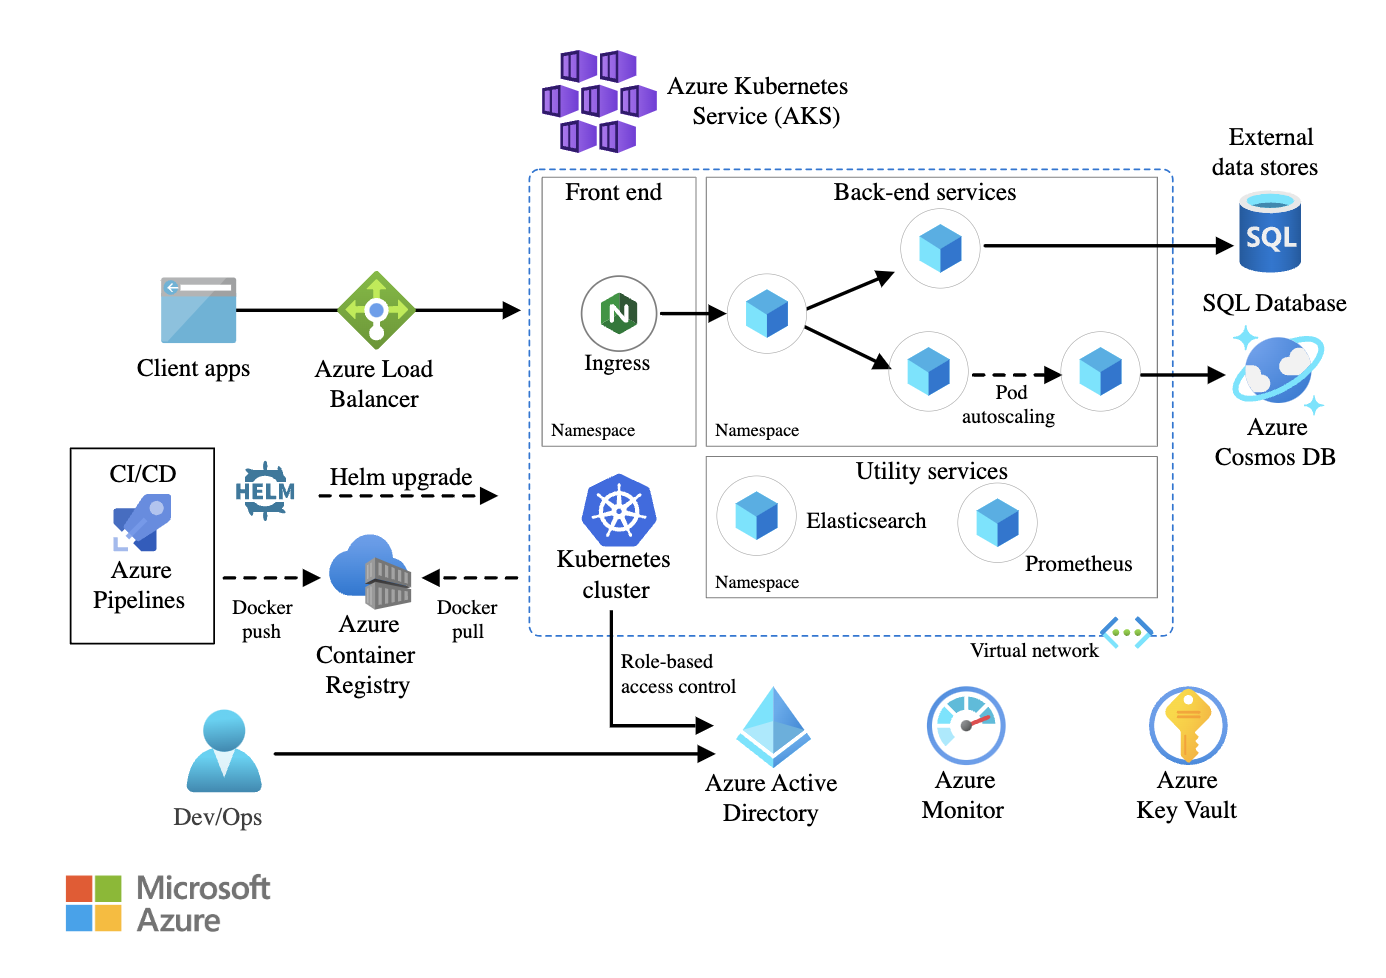
Esempio di architettura a microservizi con Azure Kubernetes Service (AKS). Fonte immagine: Microsoft Learn
Esempio di risposta:
Alla rilevazione di una violazione, la mia risposta immediata sarebbe contenere l’incidente, identificare il vettore d’attacco e prevenire ulteriori sfruttamenti. Per prima cosa isolerei i sistemi coinvolti per limitare i danni, revocando credenziali IAM compromesse, restringendo l’accesso alle risorse colpite e applicando regole nei security group.
Il passo successivo sarebbe l’analisi dei log e l’investigazione. I log di audit rivelerebbero attività sospette come tentativi di accesso non autorizzati, escalation di privilegi o chiamate API inaspettate. Se l’attaccante ha sfruttato una policy di sicurezza mal configurata, identificherei e correggerei la vulnerabilità.
Per mitigare l’impatto, ruoterei le credenziali, revocherei le chiavi API compromesse e imporrei MFA per tutti gli account privilegiati. Se la violazione ha coinvolto esfiltrazione di dati, analizzerei i log per tracciare i movimenti dei dati e notificherei le autorità competenti se la conformità normativa è stata interessata.
Una volta contenuto l’incidente, condurrei una revisione post-evento per rafforzare le policy di sicurezza.
Esempio di risposta:
Per progettare un’architettura multi-cloud, partirei da un framework comune di identity and access management (IAM), come Okta, AWS IAM Federation o Azure AD, per garantire autenticazione tra i cloud. Questo evita controlli di accesso isolati e riduce la proliferazione di identità.
Il networking è una sfida chiave in ambienti multi-cloud. Userei servizi di interconnessione come AWS Transit Gateway, Azure Virtual WAN o Google Cloud Interconnect per facilitare comunicazioni cross-cloud sicure. Inoltre, implementerei un service mesh per standardizzare gestione del traffico e policy di sicurezza.
La consistenza dei dati tra cloud è un altro fattore critico. Garantirei la replica cross-cloud usando database globali come Spanner, Cosmos DB o AWS Aurora Global Database. Se applicazioni sensibili alla latenza richiedono località dei dati, userei soluzioni di edge computing per ridurre i trasferimenti tra cloud.
Infine, monitoraggio dei costi e governance sono essenziali per prevenire il cloud sprawl. Con strumenti FinOps come CloudHealth, AWS Cost Explorer e Azure Cost Management, traccerei la spesa, imporrei limiti di budget e ottimizzerei dinamicamente l’allocazione delle risorse.
Prepararsi a un colloquio da cloud engineer richiede una solida comprensione dei fondamenti del cloud, dell’architettura, della sicurezza e delle best practice. Continua a esplorare i servizi cloud, rimani aggiornato sulle tendenze del settore e, soprattutto, fai esperienza pratica con AWS, Azure o GCP.
La track AWS Cloud Practitioner è un ottimo punto di partenza se vuoi saperne di più su AWS. Se sei alle prime armi con Microsoft Azure, la track Azure Fundamentals (AZ-900) ti aiuterà a costruire basi solide. E se vuoi approfondire Google Cloud Platform (GCP), il corso Introduction to GCP è il punto di partenza perfetto.
In bocca al lupo per il tuo colloquio!
Scopri di più sul cloud computing con questi corsi!
Corso
Corso
Corso
blog
Abid Ali Awan
15 min
blog
Tim Lu
12 min
blog
Abid Ali Awan
10 min