
Cursus
Cloud Computing begrijpen
2 uur
260.2K
Oefen en volg je voortgang.
Ga Verder Met GoogleAls je je voorbereidt op een interview voor cloud engineering, ben je hier aan het juiste adres. In dit artikel vind je een aantal veelgestelde vragen om je te helpen oefenen en vertrouwen op te bouwen. Of je nu mikt op een rol in cloud engineering, DevOps of MLOps, deze vragen toetsen je begrip van cloudconcepten, architectuur en best practices.
Om deze gids nog praktischer te maken, heb ik voorbeelden opgenomen van diensten van de grootste cloudproviders—AWS, Azure en GCP—zodat je kunt zien hoe verschillende platforms cloudoplossingen benaderen. Laten we erin duiken!
Deze fundamentele vragen toetsen je begrip van cloudcomputingconcepten, -diensten en -implementatiemodellen. Je interview begint meestal met een paar soortgelijke vragen.
De drie belangrijkste cloudcomputingmodellen zijn:
Dit zijn enkele van de belangrijkste voordelen van cloudcomputing:
Er zijn vier hoofdmodellen:
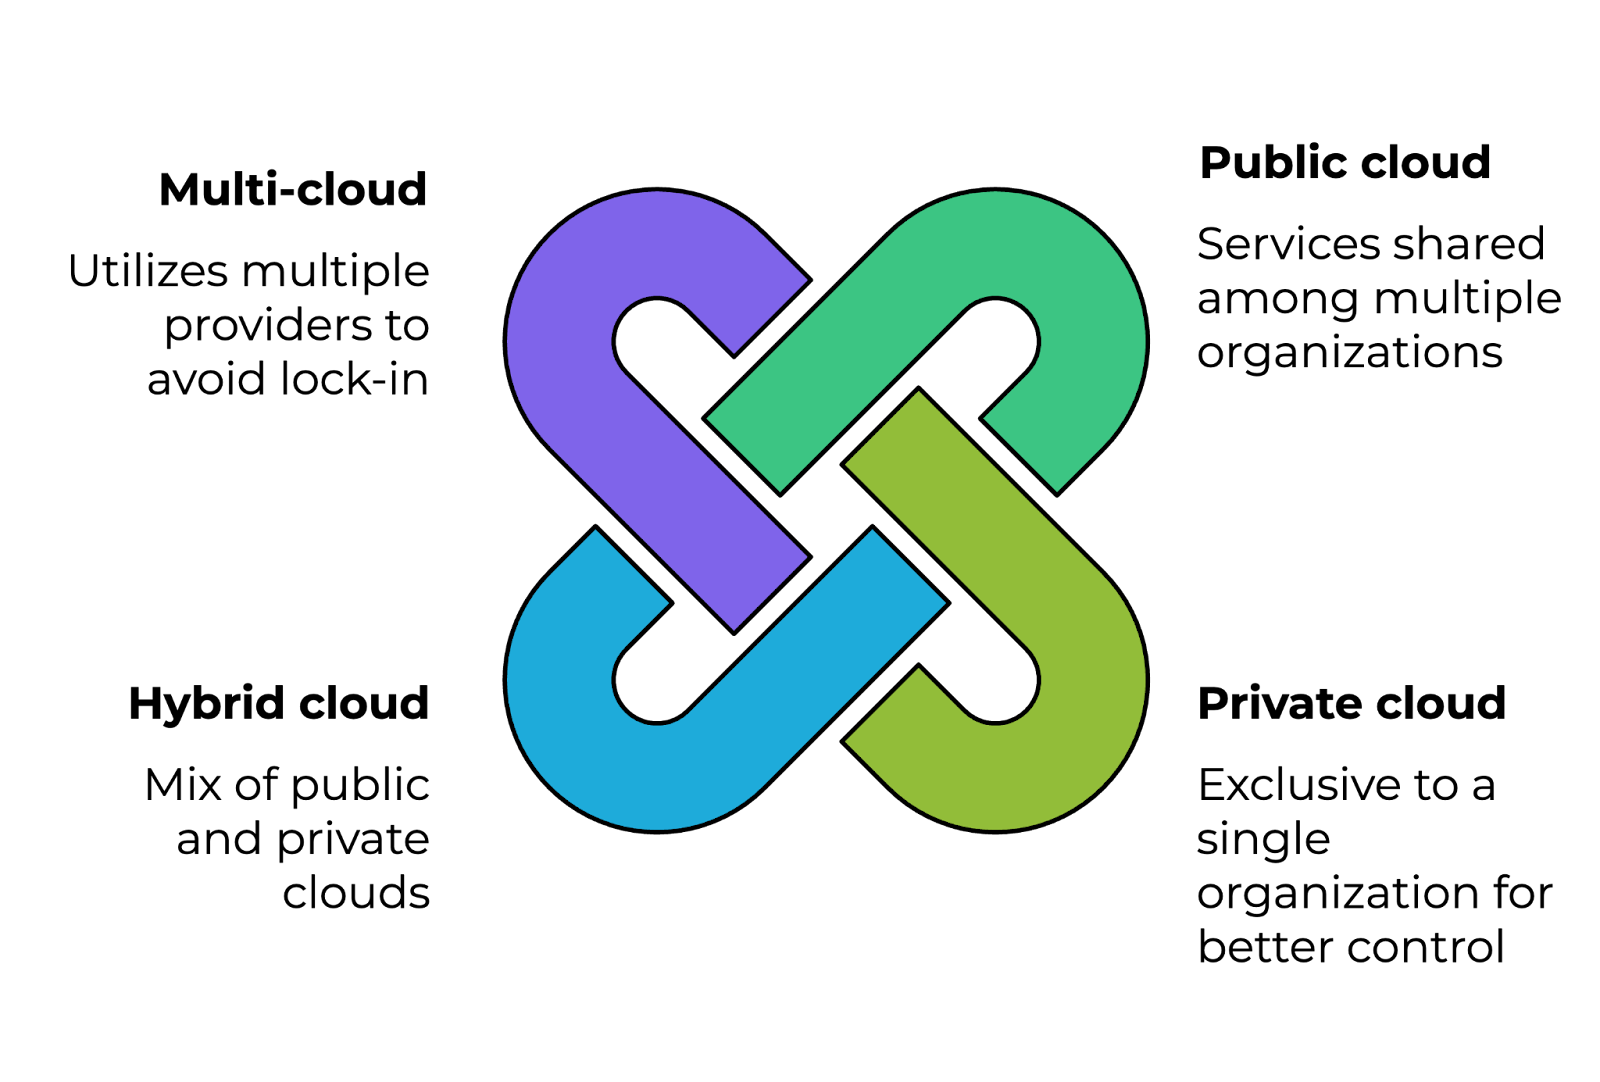
Cloudimplementatiemodellen. Afbeelding door de auteur.
Virtualisatie is het proces waarbij virtuele instanties van compute-resources, zoals servers, storage en netwerken, op één fysieke machine worden aangemaakt. Het maakt cloudcomputing mogelijk door efficiënte resourceallocatie, multi-tenancy en schaalbaarheid.
Technologieën zoals Hyper-V, VMware en KVM worden veel gebruikt voor virtualisatie in cloudomgevingen.
Een cloudregio is een geografisch afzonderlijk gebied waar cloudproviders meerdere datacenters hosten. Een availability zone (AZ) is een fysiek gescheiden datacenter binnen een regio, ontworpen voor redundantie en hoge beschikbaarheid.
Zo heeft AWS wereldwijd meerdere regio’s, elk met twee of meer AZ’s voor disaster recovery en fouttolerantie.
Dit zijn de verschillen tussen deze twee concepten:
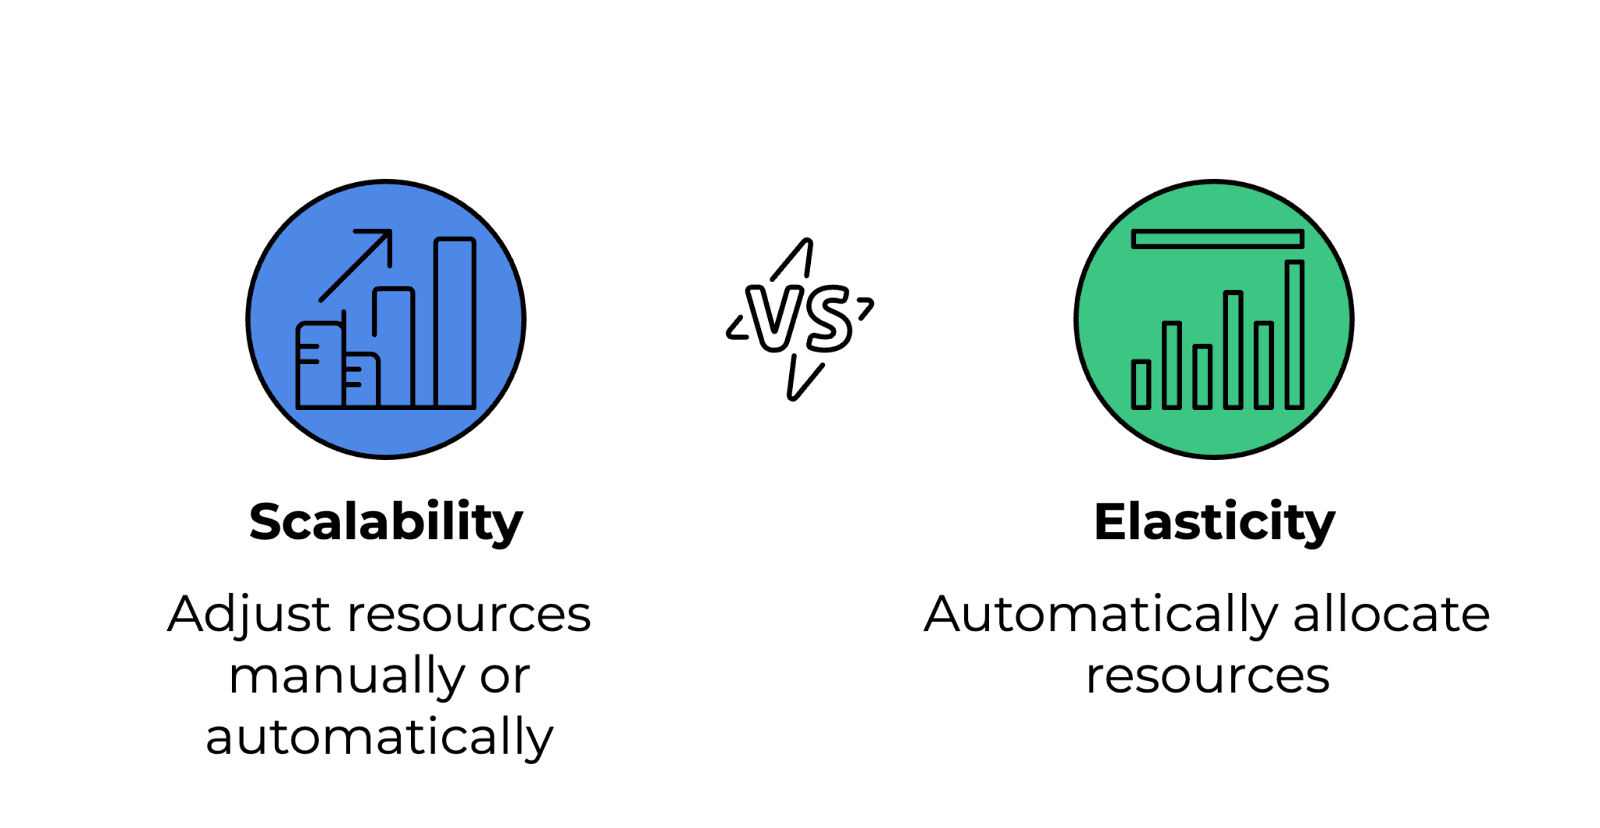
Verschil tussen schaalbaarheid en elasticiteit. Afbeelding door de auteur.
De volgende tabel geeft de grote cloudproviders, hun sterke punten en use-cases weer:
|
Cloudprovider |
Sterke punten |
Use-cases |
|
Amazon Web Services (AWS) |
Grootste cloudprovider met een enorm aanbod aan diensten. |
Algemene cloudcomputing, serverless, DevOps. |
|
Microsoft Azure |
Sterk in enterprise- en hybride cloudoplossingen. |
Enterprise-applicaties, hybride cloud, integratie met Microsoft-ecosysteem. |
|
Google Cloud Platform (GCP) |
Gespecialiseerd in big data, AI/ML en Kubernetes. |
Machine learning, data-analyse, containerorkestratie. |
|
IBM Cloud |
Richt zich op AI en enterprise cloudoplossingen. |
AI-gedreven applicaties, enterprise cloudtransformatie. |
|
Oracle Cloud |
Sterk in databases en enterprise-applicaties. |
Databasemanagement, ERP-applicaties, enterprise-workloads. |
Serverless computing is een clouduitvoeringsmodel waarbij de cloudprovider de infrastructuur automatisch beheert, zodat ontwikkelaars zich kunnen richten op het schrijven van code. Gebruikers betalen alleen voor de daadwerkelijke uitvoeringstijd in plaats van vaste resources te reserveren. Voorbeelden zijn:
Objectopslag is een gegevensopslagarchitectuur waarbij bestanden als afzonderlijke objecten in een vlakke namespace worden opgeslagen in plaats van in hiërarchische bestandssystemen. Het is zeer schaalbaar en wordt gebruikt voor ongestructureerde data, back-ups en multimediaopslag. Voorbeelden zijn:
Een CDN is een netwerk van gedistribueerde servers die content (bijv. afbeeldingen, video’s, webpagina’s) cachen en leveren aan gebruikers op basis van hun geografische locatie. Dit verlaagt de latency, verbetert de websiteprestaties en verhoogt de beschikbaarheid. Populaire CDN’s zijn onder andere:
Deze vragen gaan dieper in op cloudnetwerken, beveiliging, automatisering en prestatieoptimalisatie en testen je vermogen om cloudomgevingen effectief te ontwerpen, beheren en troubleshooten.
Een virtual private cloud (VPC) is een logisch geïsoleerd gedeelte van een public cloud waarin gebruikers resources kunnen starten in een privénetwerkomgeving. Het biedt meer controle over netwerkinstellingen, beveiligingsbeleid en toegangsbeheer.
In een VPC kunnen gebruikers IP-adresbereiken definiëren met CIDR-blokken. Subnets kunnen worden aangemaakt om publieke en private resources te scheiden, en security groups en network ACL’s helpen om netwerktoegang te reguleren.
Load balancers verdelen inkomend netwerkverkeer over meerdere servers om hoge beschikbaarheid, fouttolerantie en betere prestaties te garanderen.
Er zijn verschillende typen load balancers:
IAM is een raamwerk dat regelt wie toegang heeft tot cloudresources en welke acties zij mogen uitvoeren. Het helpt het principe van least privilege af te dwingen en beveiligt cloudomgevingen.
In IAM definiëren users en roles identiteiten met specifieke rechten, policies verlenen of weigeren toegang via JSON-gebaseerde regels, en multi-factor authentication (MFA) voegt een extra beveiligingslaag toe voor kritieke handelingen.
Security groups en network ACL’s (access control lists) regelen inkomend en uitgaand verkeer naar cloudresources, maar werken op verschillende niveaus.
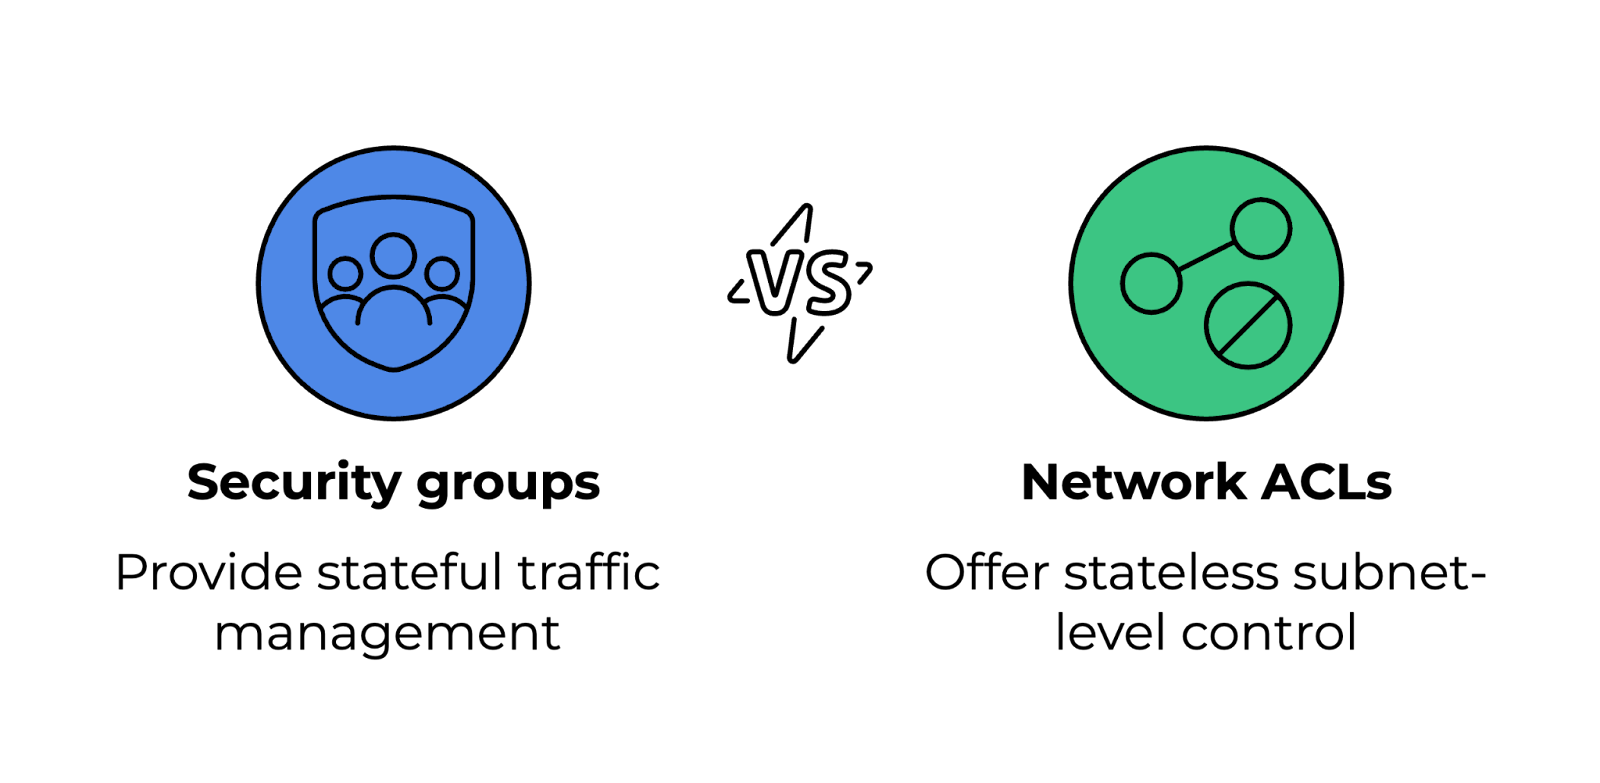
Vergelijking van security groups en network ACL’s. Afbeelding door de auteur.
Een bastion host is een beveiligde jumpserver voor toegang tot cloudresources in een privénetwerk. In plaats van alle servers aan het internet bloot te stellen, fungeert het als gateway voor externe verbindingen.
Om de beveiliging te verbeteren, moet deze strikte firewallregels hebben en alleen SSH- of RDP-toegang toestaan vanaf vertrouwde IP’s. Gebruik MFA en sleutelgebaseerde authenticatie voor veilige toegang en schakel logging en monitoring in om ongeautoriseerde inlogpogingen te volgen.
Autoscaling laat cloudomgevingen resources dynamisch aanpassen op basis van vraag, wat zorgt voor kostenefficiëntie en prestaties. Het werkt op twee manieren:
Cloudproviders bieden autoscaling-groepen die samenwerken met load balancers om verkeer effectief te verdelen.
Effectief kostenbeheer in de cloud vereist het monitoren van gebruik en het kiezen van de juiste prijsmodellen. Strategieën voor kostenoptimalisatie zijn onder andere:
Wil je AWS-beveiliging beheersen en cloudkosten optimaliseren? Bekijk de cursus AWS Security and Cost Management voor essentiële best practices.
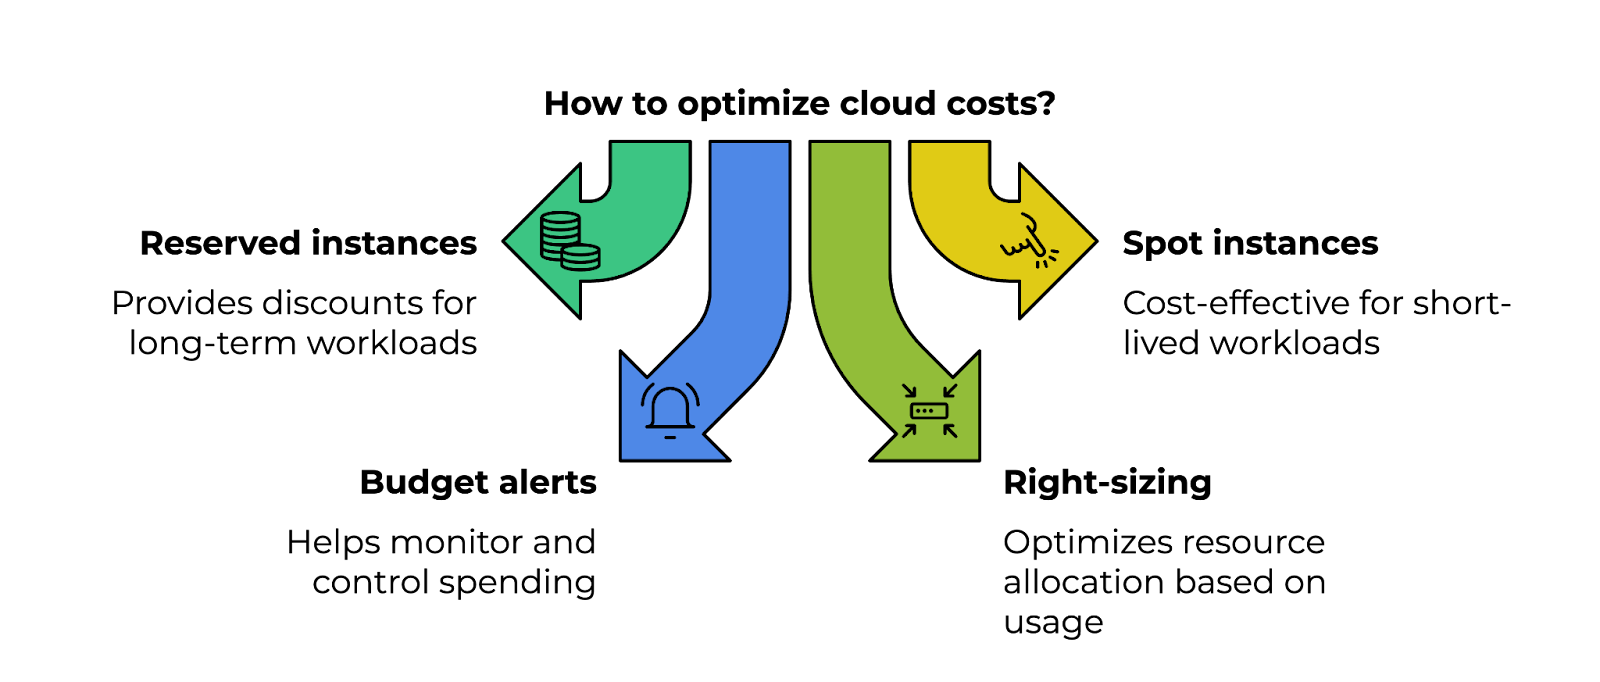
Vier pijlers voor het optimaliseren van cloudkosten. Afbeelding door de auteur.
Terraform en AWS CloudFormation zijn beide infrastructure-as-code (IaC)-tools, maar ze verschillen op enkele punten:
|
Functie |
Terraform |
AWS CloudFormation |
|
Cloudondersteuning |
Cloud-agnostisch, ondersteunt AWS, Azure, GCP en andere. |
AWS-specifiek, exclusief ontworpen voor AWS-resources. |
|
Configuratietaal |
Gebruikt HashiCorp Configuration Language (HCL). |
Gebruikt JSON/YAML-templates. |
|
Statebeheer |
Beheert een state-file om infrastructuurwijzigingen bij te houden. |
Gebruikt stacks om deployments te beheren en te volgen. |
Monitoringtools helpen prestatieknelpunten, beveiligingsdreigingen en resource-overgebruik op te sporen. Veelgebruikte monitoringoplossingen zijn onder andere:
Containers verpakken applicaties met dependencies, waardoor ze lichtgewicht, draagbaar en schaalbaar zijn. Vergeleken met virtuele machines gebruiken containers minder resources, omdat meerdere containers op één OS kunnen draaien.
Docker en Kubernetes maken snellere deployment en rollback mogelijk. Daarnaast schalen ze eenvoudig met orkestratietools zoals Kubernetes en Amazon ECS/EKS.
Wil je je containerisatievaardigheden aanscherpen? De track Containerization and Virtualization behandelt Docker, Kubernetes en meer om je te helpen schaalbare cloudapplicaties te bouwen.
Een service mesh is een infrastructuurlaag die service-naar-servicecommunicatie beheert in microservices-gebaseerde cloudapplicaties. Het biedt:
Populaire service-meshoplossingen zijn Istio, Linkerd en AWS App Mesh.
Een multicloudstrategie houdt in dat meerdere cloudproviders (AWS, Azure, GCP) worden gebruikt om vendor lock-in te vermijden en de veerkracht te verbeteren.
Bedrijven kiezen hiervoor wanneer ze geografische redundantie nodig hebben voor disaster recovery, unieke diensten van verschillende providers willen benutten (bijv. AWS voor compute, GCP voor AI) of moeten voldoen aan regionale regelgeving die de keuze voor cloudproviders beperkt.
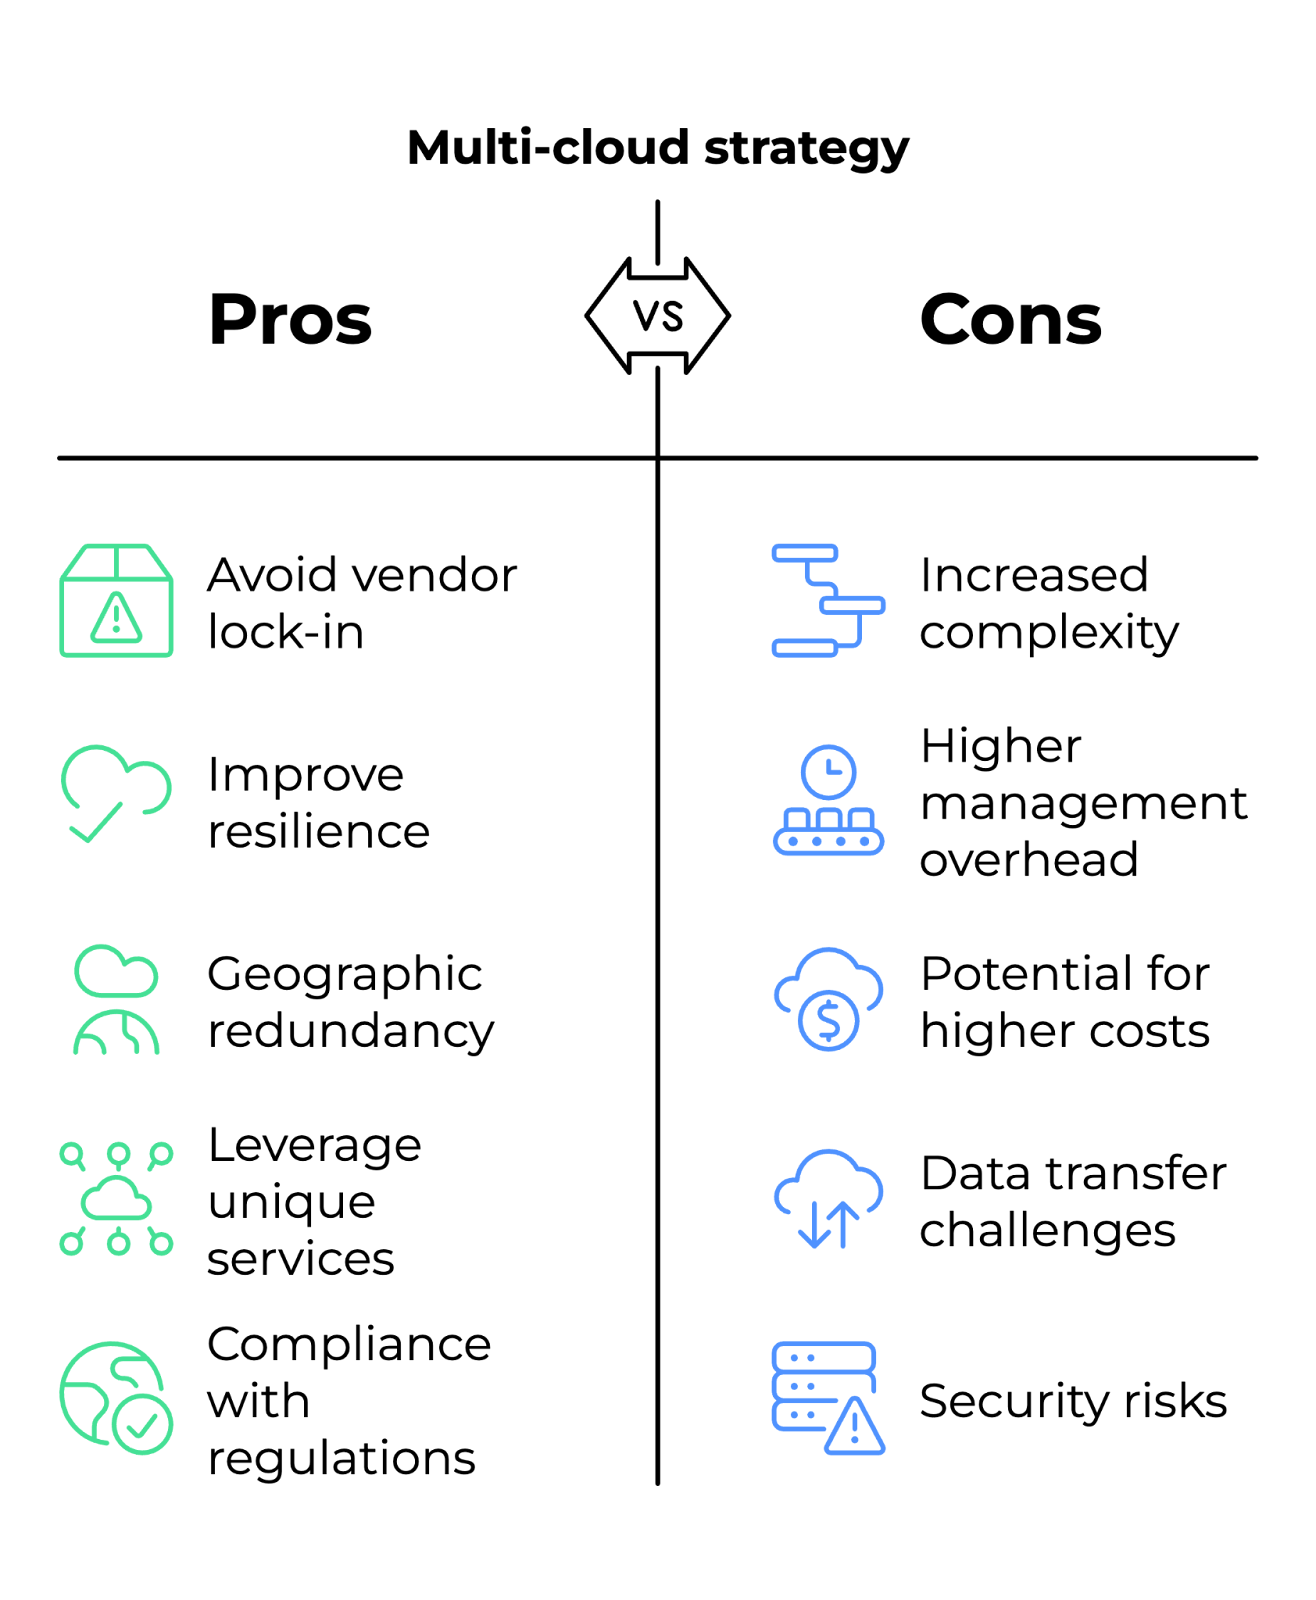
Voor- en nadelen van een multicloudstrategie. Afbeelding door de auteur.
Deze vragen toetsen je vermogen om schaalbare oplossingen te ontwerpen, complexe cloudinfrastructuren te beheren en kritieke scenario’s aan te pakken.
Een multiregio-architectuur zorgt voor minimale downtime en bedrijfscontinuïteit door resources over meerdere geografische locaties te verdelen.
Bij het ontwerpen van zo’n architectuur moet je verschillende factoren overwegen. Dit zijn er een paar:
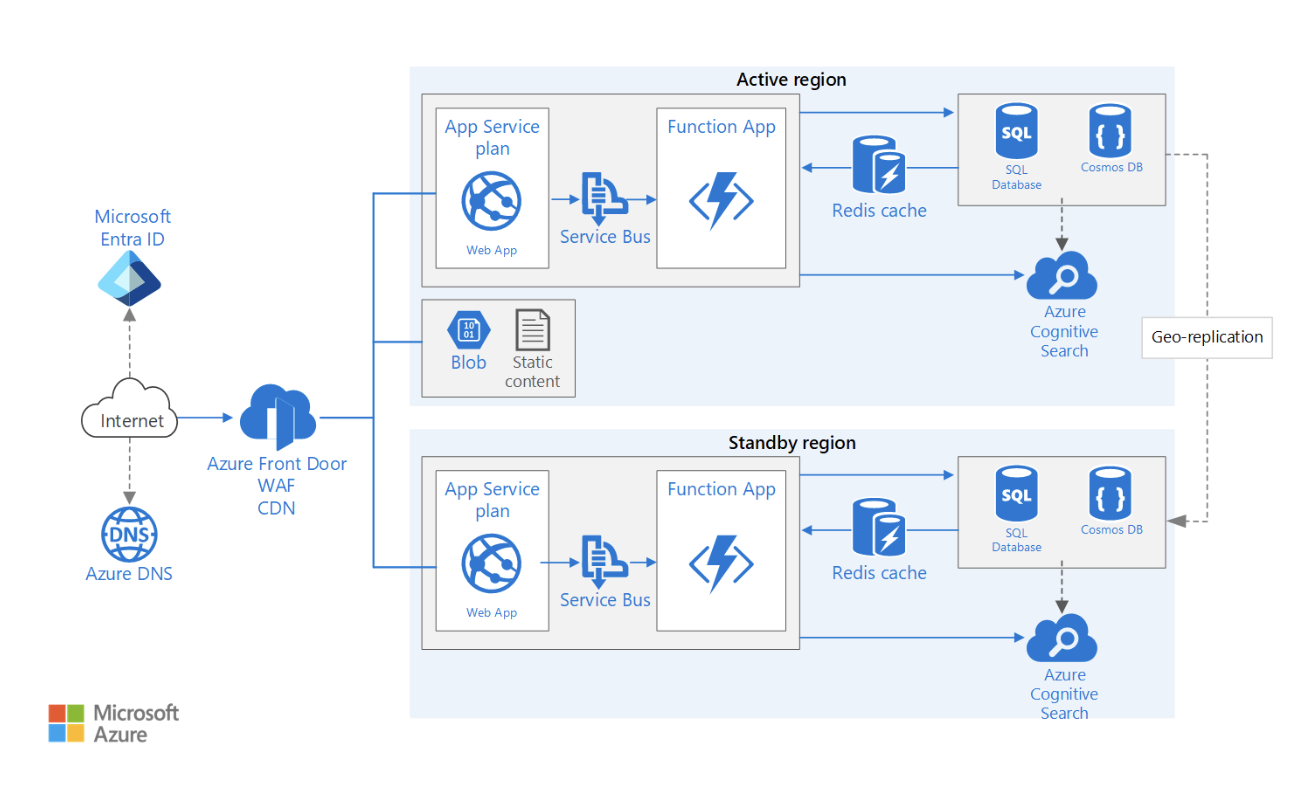
Voorbeeld van een multiregio webapplicatiearchitectuur met hoge beschikbaarheid. Bron afbeelding: Microsoft Learn
Het zero trust-model gaat ervan uit dat geen enkele entiteit, binnen of buiten het netwerk, standaard te vertrouwen is.
Zo implementeer je zero trust in cloudomgevingen:
Een succesvolle strategie begint met kostenallocatie en tagging, waarbij organisaties gestructureerde tags afdwingen (bijv. afdeling, project, eigenaar) om uitgaven per team te volgen en financiële transparantie te verbeteren.
Automatische budgetalerts moeten worden ingesteld met tools als AWS Budgets, Azure Cost Management of GCP Billing Alerts om onverwachte kosten te voorkomen. Deze oplossingen bieden realtime monitoring en meldingen wanneer het gebruik drempels benadert.
Een ander aspect is rightsizing en reserved instances. Door continu gebruiksstatistieken zoals CPU en geheugen te analyseren, kunnen teams bepalen of workloads moeten worden aangepast of verplaatst naar reserved of spot-instanties, die aanzienlijke besparingen opleveren.
Het implementeren van FinOps-best practices verhoogt de kostenefficiëntie verder. Tools voor automatische kostenanomaliedetectie zoals Kubecost (voor Kubernetes-omgevingen) en AWS Compute Optimizer helpen onderbenutte resources proactief te identificeren en te optimaliseren.
Tot slot spelen auto-shutdown policies een cruciale rol bij het verminderen van verspilling. Serverless-functies, zoals AWS Lambda of Azure Functions, kunnen onderbenutte resources buiten kantooruren automatisch uitschakelen om onnodige uitgaven te voorkomen.
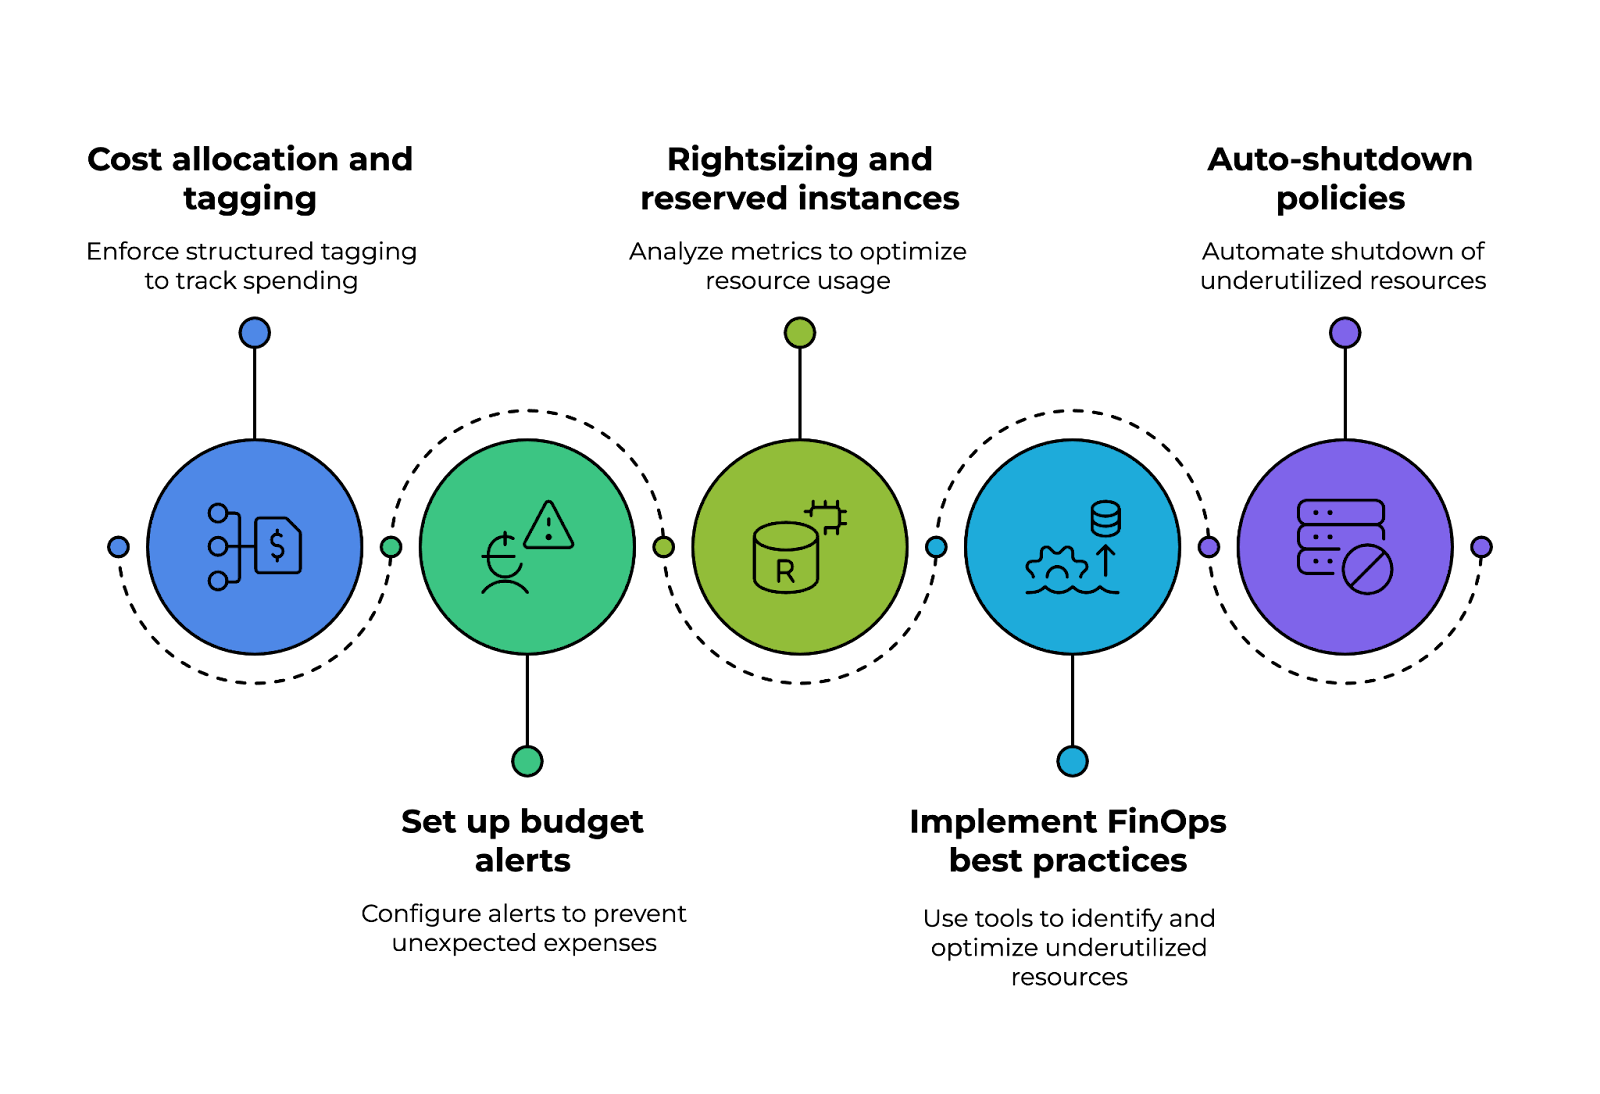
Pijlers voor de implementatie van een cloudkostengovernancestrategie. Afbeelding door de auteur.
Een data lake vereist efficiënte opslag, ophalen en verwerking van data op petabyteschaal. Enkele optimalisatiestrategieën zijn:
Een van de fundamentele aspecten van een CI/CD-pijplijn is codeversiebeheer en repositorymanagement, wat efficiënte samenwerking en wijzigingstracking mogelijk maakt. Tools zoals GitHub Actions, AWS CodeCommit of Azure Repos helpen broncode beheren, branchingstrategieën afdwingen en pull request-workflows stroomlijnen.
Build-automatisering en artifactmanagement spelen een cruciale rol bij consistentie en betrouwbaarheid van builds. Met Docker-gebaseerde builds, JFrog Artifactory of AWS CodeArtifact kunnen teams reproduceerbare builds maken, artifacts veilig opslaan en versiebeheer borgen over omgevingen heen.
Beveiliging is een andere belangrijke overweging. Het integreren van SAST-tools (static application security testing), zoals SonarQube of Snyk, maakt vroege detectie van kwetsbaarheden in de codebase mogelijk. Daarnaast zorgt het afdwingen van ondertekende containerimages ervoor dat alleen geverifieerde en vertrouwde artifacts worden gedeployed.
Een robuuste deploymentstrategie met meerdere fasen helpt risico’s bij releases te minimaliseren. Technieken zoals canary-, blue-green- of rolling deployments maken gefaseerde uitrol mogelijk, verminderen downtime en geven realtime inzicht in prestaties. Met feature flags kunnen teams bepalen welke gebruikers nieuwe features zien vóór een volledige release.
Tot slot is integratie van Infrastructure as Code (IaC) essentieel voor het automatiseren en standaardiseren van cloudomgevingen. Met Terraform, AWS CloudFormation of Pulumi kunnen teams infrastructuur als code definiëren, consistentie behouden over deployments en provisioning van cloudresources mogelijk maken.
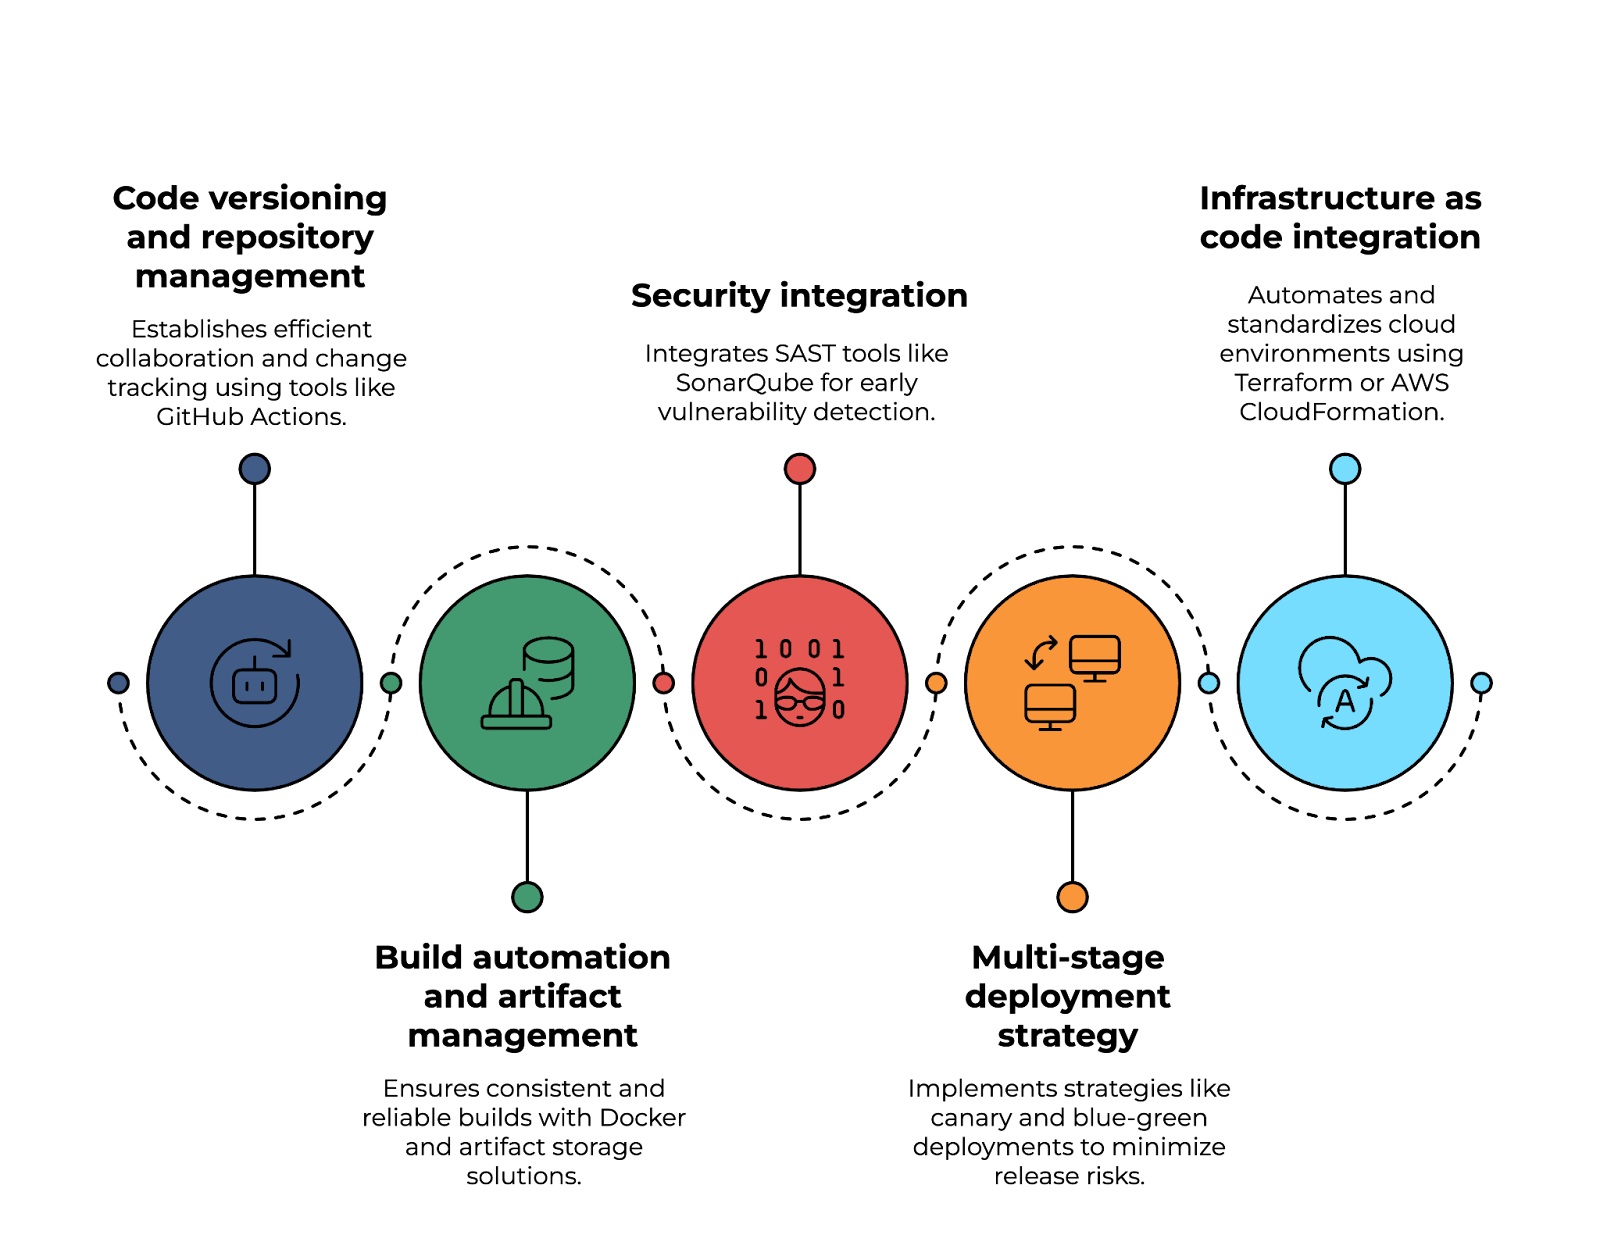
Implementatie van een cloud-native CI/CD-pijplijn. Afbeelding door de auteur.
Disaster recovery (DR) is essentieel om bedrijfscontinuïteit te waarborgen bij storingen, aanvallen of hardwarefouten. Een sterk DR-plan omvat het volgende:
Het beheren van grootschalige Kubernetes (K8s)-clusters brengt operationele en prestatie-uitdagingen met zich mee. Belangrijke aandachtspunten zijn:
Scenario-vragen beoordelen je vermogen om realistische clouduitdagingen te analyseren, problemen op te lossen en architecturale beslissingen te nemen onder verschillende beperkingen.
Je antwoorden moeten praktische ervaring, besluitvorming en trade-offs laten zien bij het oplossen van cloudproblemen. Omdat er geen goede of foute antwoorden zijn, heb ik enkele voorbeelden toegevoegd om je denkproces te sturen.
Voorbeeldantwoord:
Hoge latency in een cloudapplicatie kan door meerdere factoren worden veroorzaakt, waaronder netwerkcongestie, inefficiënte databasequeries, suboptimale plaatsing van instanties of misconfiguraties van load balancing.
Om het probleem te diagnosticeren zou ik beginnen met het isoleren van de bottleneck met cloudmonitoringtools. De eerste stap is het analyseren van applicatieresponstijden en netwerklatency door logs, request-responstijden en HTTP-statuscodes te controleren. Als het probleem netwerkgerelateerd is, zou ik traceroute of ping gebruiken om verhoogde round-trip-tijden tussen gebruikers en de applicatie te controleren. Als er een probleem is, kan het inschakelen van een CDN helpen om statische content dichter bij gebruikers te cachen en de latency te verlagen.
Als databasequeries vertraging veroorzaken, zou ik trage queries profileren en optimaliseren door de juiste indexen toe te voegen of tabellen te denormaliseren. Als de applicatie onder hoge belasting staat, kan horizontaal schalen met autoscaling-groepen of read replicas de druk op de primaire database verlagen.
Als de latency aanhoudt, zou ik de compute-resources van de applicatie controleren en zorgen dat deze in de juiste availability zone draait, zo dicht mogelijk bij eindgebruikers. Indien nodig zou ik workloads migreren naar een multiregio-opzet of edgecomputing inzetten om requests dichter bij de bron te verwerken.
Voorbeeldantwoord:
De eerste stap is een cloud readiness-assessment uitvoeren om te beoordelen of de applicatie as-is kan worden gemigreerd of aanpassingen vereist. Een aanpak is het gebruik van de “6 R’s van cloudmigratie”:
Een lift-and-shift-aanpak is ideaal als het doel een snelle migratie met minimale wijzigingen is. Als prestatieoptimalisatie en kostenefficiëntie prioriteit hebben, zou ik replatforming overwegen door de applicatie naar containers of serverless te verplaatsen voor betere schaalbaarheid. Voor monolithische applicaties kan refactoring naar microservices nodig zijn om prestaties en onderhoudbaarheid te verbeteren.
Ik zou me ook richten op datamigratie en ervoor zorgen dat databases met minimale downtime naar de cloud worden gerepliceerd.
Beveiliging en compliance zijn een andere grote zorg. Voor deployment zou ik ervoor zorgen dat de applicatie voldoet aan regelgeving (bijv. HIPAA, AVG) door encryptie, IAM-beleid en VPC-isolatie te implementeren.
Tot slot zou ik testen en valideren in een stagingomgeving voordat ik het productieverkeer overschakel.
Voorbeeldantwoord:
Op infrastructuurniveau zou ik de Kubernetescluster over meerdere availability zones (AZ’s) uitrollen. Dit zorgt ervoor dat verkeer naar een andere zone kan worden omgeleid als één AZ uitvalt. Voor on-prem of hybride omgevingen zou ik Kubernetes Federation gebruiken om multiclusterdeployments te beheren.
Binnen de cluster zou ik veerkracht op podniveau implementeren met ReplicaSets en horizontal pod autoscalers (HPA) om workloads dynamisch te schalen op basis van CPU/geheugengebruik. Daarnaast zorgen pod disruption budgets (PDB’s) ervoor dat een minimumaantal pods beschikbaar blijft tijdens updates of onderhoud.
Voor netwerken zou ik een service mesh gebruiken om communicatie tussen services te beheren en retries, circuit breaking en traffic shaping af te dwingen. Een globale load balancer zou extern verkeer efficiënt over meerdere regio’s verdelen.
Persistente opslag is ook cruciaal. Als microservices data persistentie vereisen, zou ik containernatieve opslagoplossingen gebruiken. Ik zou cross-region back-ups en geautomatiseerde snapshot policies configureren om dataverlies te voorkomen.
Tot slot zijn monitoring en logging essentieel om hoge beschikbaarheid te behouden. Ik zou Prometheus en Grafana integreren voor realtime performancemonitoring en de ELK-stack of AWS CloudWatch Logs gebruiken om de gezondheid van applicaties te volgen en storingen proactief te detecteren.
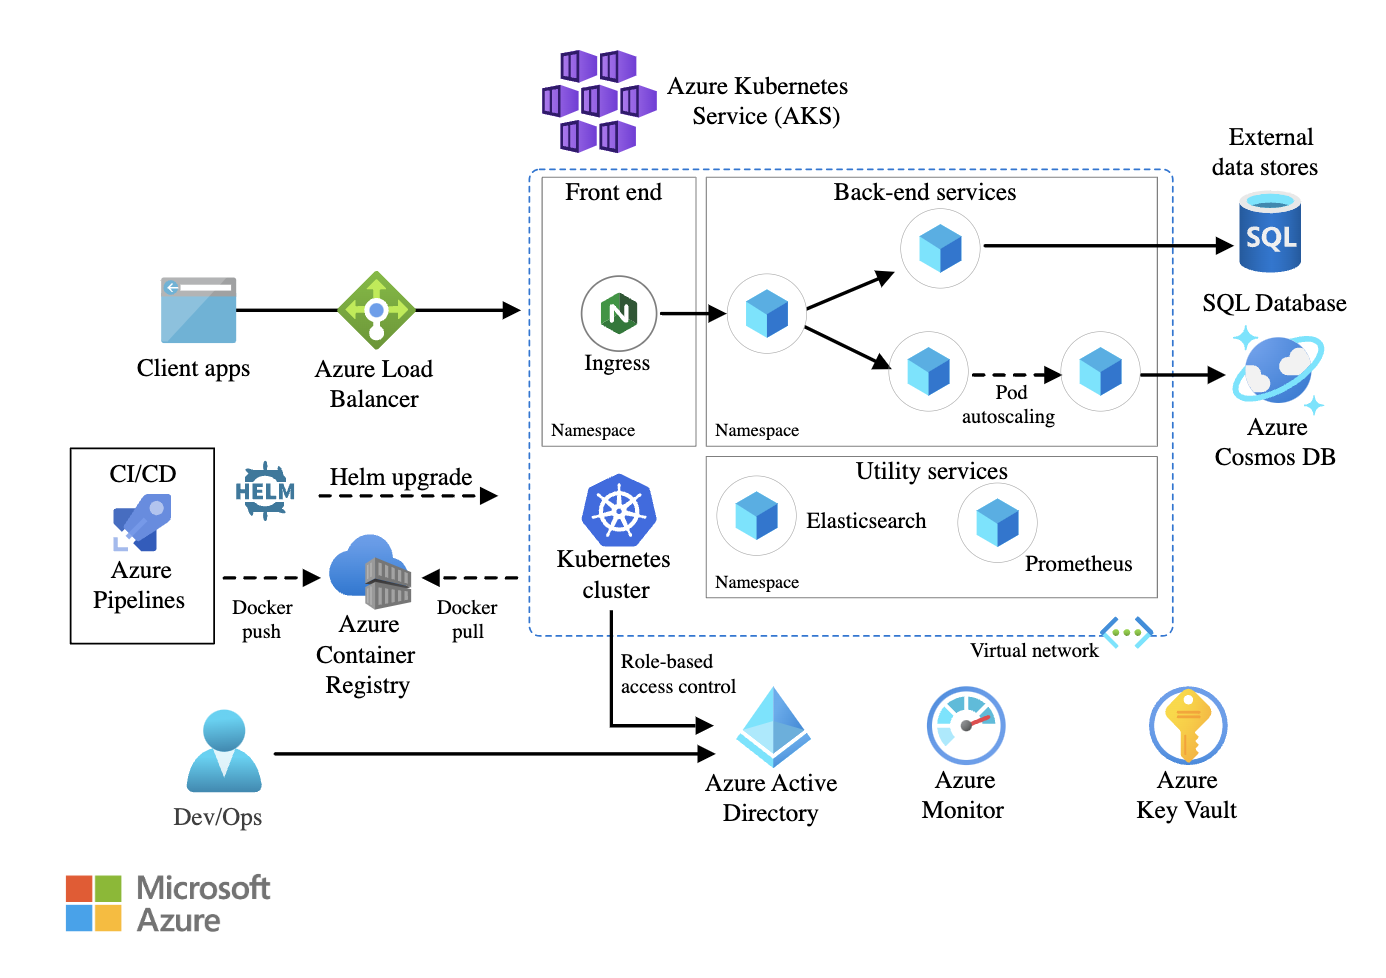
Voorbeeld van een microservicesarchitectuur met Azure Kubernetes Service (AKS). Bron afbeelding: Microsoft Learn
Voorbeeldantwoord:
Bij detectie van een beveiligingsincident zou mijn eerste reactie zijn om het incident in te perken, de aanvalsvector te identificeren en verdere uitbuiting te voorkomen. Eerst zou ik de getroffen systemen isoleren om de schade te beperken door gecompromitteerde IAM-referenties in te trekken, de toegang tot getroffen resources te beperken en security group-regels af te dwingen.
De volgende stap is loganalyse en onderzoek. Auditlogs onthullen verdachte activiteiten zoals ongeautoriseerde toegangsproberen, privilege-escalaties of onverwachte API-calls. Als een aanvaller een misgeconfigureerd beveiligingsbeleid heeft misbruikt, zou ik de kwetsbaarheid identificeren en patchen.
Om de impact te beperken, zou ik referenties roteren, gecompromitteerde API-sleutels intrekken en MFA afdwingen voor alle bevoorrechte accounts. Als er data-exfiltratie plaatsvond, zou ik logs analyseren om databeweging te traceren en relevante autoriteiten informeren als regelgeving dit vereist.
Zodra de inperking is bevestigd, zou ik een post-incidentreview uitvoeren om beveiligingsbeleid te versterken.
Voorbeeldantwoord:
Om een multicloudarchitectuur te ontwerpen, zou ik beginnen met een gemeenschappelijk identity and access management (IAM)-raamwerk, zoals Okta, AWS IAM Federation of Azure AD, om authenticatie over clouds heen te waarborgen. Dit voorkomt gesiloëerde toegangscontrole en beperkt identity sprawl.
Netwerken is een belangrijke uitdaging in multicloudomgevingen. Ik zou interconnect-diensten gebruiken zoals AWS Transit Gateway, Azure Virtual WAN of Google Cloud Interconnect voor veilige cross-cloudcommunicatie. Daarnaast zou ik een service mesh implementeren om verkeersbeheer en beveiligingsbeleid te standaardiseren.
Dataconsistentie over clouds heen is een andere kritieke factor. Ik zou cross-cloudreplicatie waarborgen met globale databases zoals Spanner, Cosmos DB of AWS Aurora Global Database. Als latencygevoelige applicaties datalocaliteit vereisen, zou ik edgecomputing inzetten om intercloud-datatransfers te verminderen.
Tot slot zijn kostenmonitoring en governance essentieel om cloudsprawl te voorkomen. Met FinOps-tools zoals CloudHealth, AWS Cost Explorer en Azure Cost Management zou ik uitgaven volgen, budgetlimieten afdwingen en resourceallocatie dynamisch optimaliseren.
Voorbereiden op een interview voor cloud engineer vraagt om een solide begrip van cloudbasis, architectuur, beveiliging en best practices. Blijf cloudservices verkennen, volg trends in de sector en, vooral, doe hands-on ervaring op met AWS, Azure of GCP.
De AWS Cloud Practitioner-track is een geweldige start als je meer over AWS wilt weten. Ben je nieuw bij Microsoft Azure, dan helpt de Azure Fundamentals (AZ-900)-track je een sterke basis op te bouwen. En wil je dieper duiken in Google Cloud Platform (GCP), dan is de Introduction to GCP-cursus het perfecte startpunt.
Succes met je interview!
Leer meer over cloudcomputing met deze cursussen!
Cursus
Cursus
Oefen en volg je voortgang.
Ga Verder Met Googleblog
Adel Nehme
15 min

