

Corso
Concetti di LLMOps
1 ore
20.3K
Pratica and corso your progress.
Continua Con Google
Immagine dell'autore
Siamo andati oltre il semplice miglioramento dei large language model (LLM) e ora ci concentriamo sull'utilizzarli per creare applicazioni AI utili alle aziende. Qui entrano in gioco gli strumenti di LLMOps (large language model operations), che semplificano la creazione di sistemi completamente automatizzati per costruire e distribuire soluzioni LLM in produzione.
In questo articolo, esamineremo diversi strumenti come API per LLM, framework di fine-tuning, strumenti di tracciamento degli esperimenti, ecosistemi di integrazione LLM, strumenti di ricerca vettoriale, framework di serving dei modelli, piattaforme di deployment e strumenti di osservabilità. Ogni strumento eccelle nel proprio ambito ed è progettato per risolvere problemi specifici legati agli LLM.
LLMOps è un campo emergente che si concentra sulla gestione operativa dei large language model in ambienti di produzione. In sostanza, è MLOps (machine learning operations) specializzato per i modelli linguistici e multimodali.
Segui il corso Master Large Language Models (LLMs) Concepts per imparare applicazioni degli LLM, metodologie di training, considerazioni etiche e le ricerche più recenti.
LLMOps copre l'intero ciclo di vita dei large language model, tra cui raccolta dei dati, training o fine-tuning del modello, test e validazione, integrazione, deployment, ottimizzazione, monitoraggio e manutenzione, e collaborazione. Strutturando i progetti e automatizzando i processi, l'LLMOps ti aiuta a ridurre gli errori e a scalare efficacemente le applicazioni AI, garantendo modelli robusti e in grado di soddisfare le esigenze del mondo reale.
In breve, gli strumenti di LLMOps ti aiutano a costruire un sistema automatizzato che raccoglie i dati, esegue il fine-tuning del modello, ne traccia le prestazioni, lo integra con dati esterni, crea l'app AI, la distribuisce nel cloud e osserva metriche e performance del modello in produzione.
Lo skill track Developing Large Language Models comprende 4 corsi che ti aiuteranno a costruire solide basi su come funzionano gli LLM e su come eseguire il fine-tuning di LLM pre-addestrati.
Ora esploriamo i migliori strumenti di LLMOps disponibili oggi.
Accedi a modelli linguistici e di embedding tramite chiamate API. Non devi distribuire il modello o mantenere il server: ti basta fornire una chiave API e iniziare a usare i modelli all'avanguardia.
OpenAI offre accesso via API a modelli LLM avanzati come GPT-4o e o1. Questi modelli possono essere utilizzati tramite un pacchetto Python o un comando CURL.
L'API è una soluzione ideale per startup senza un team tecnico dedicato al fine-tuning o al deployment in produzione. Fornisce accesso a modelli linguistici, modelli multimodali, function calling, output strutturati e opzioni di fine-tuning. Inoltre, puoi usare modelli di embedding per creare il tuo database vettoriale. In sintesi, offre un ecosistema AI completo e a basso costo.
Impara a usare la Python API di OpenAI per accedere agli LLM all'avanguardia seguendo il Tutorial API GPT-4o: Introduzione alle API di OpenAI.
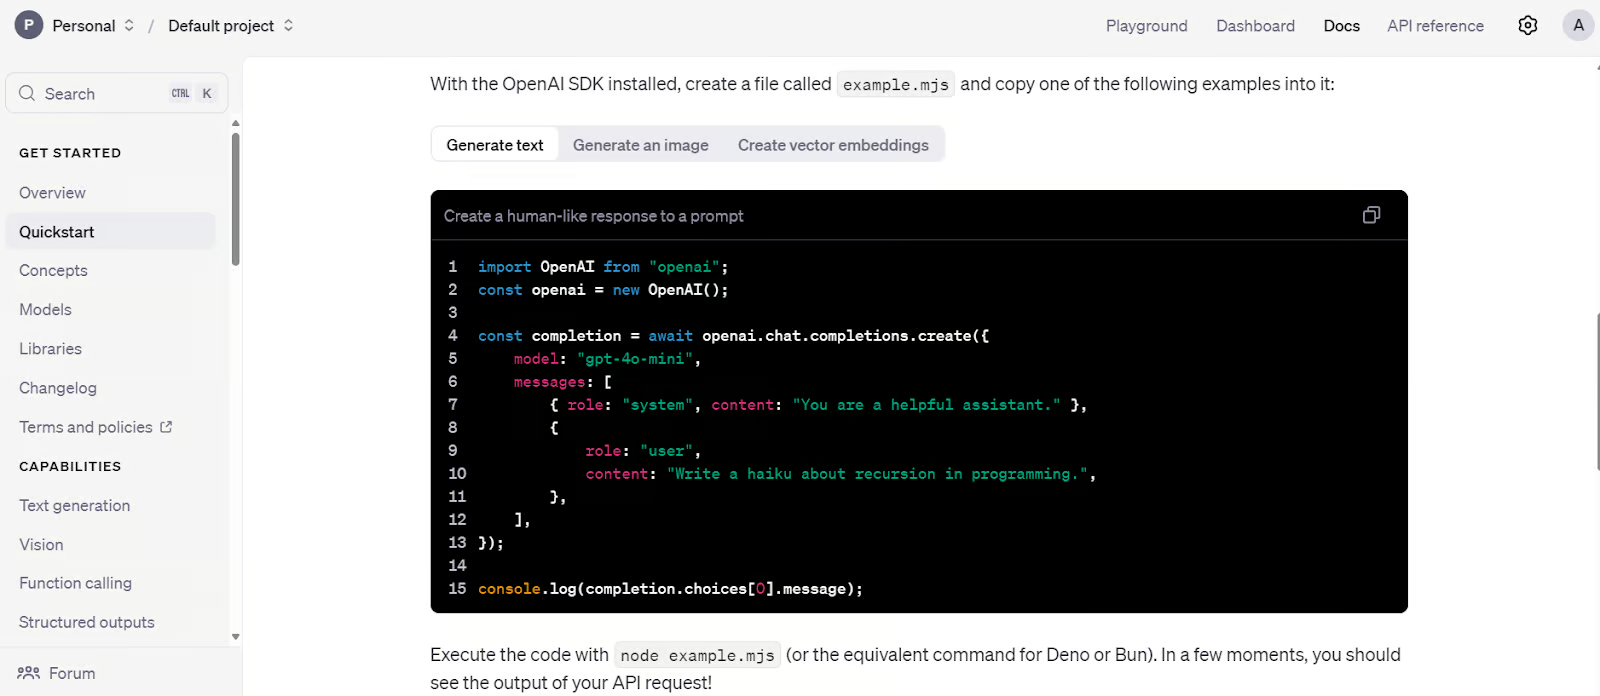
Codice quickstart OpenAI API. Fonte immagine: Quickstart tutorial - OpenAI API
L'API Anthropic è simile a quella di OpenAI e offre accesso a vari modelli linguistici e di embedding. Questi modelli possono essere usati per creare applicazioni RAG, integrare strumenti, recuperare pagine web, utilizzare modelli di visione e sviluppare agenti AI. Nel tempo, Anthropic punta a fornire tutti gli strumenti necessari per creare e distribuire applicazioni AI pienamente funzionali.
Come l'API di OpenAI, include meccanismi di sicurezza e strumenti di valutazione per monitorare le prestazioni del modello.
Impara a usare la Claude API per accedere a LLM di punta seguendo il Tutorial API Claude Sonnet 3.5: Introduzione alle API di Anthropic.
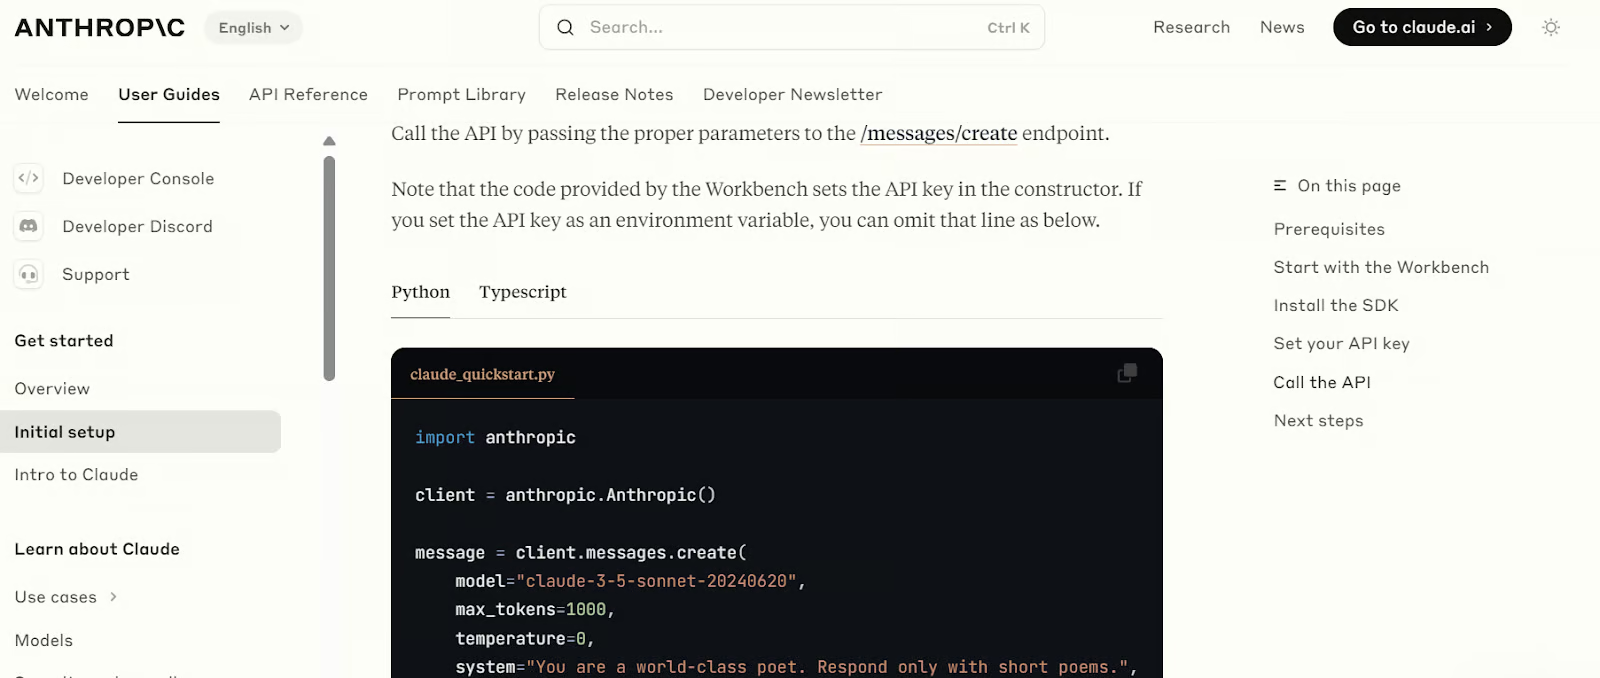
Codice quickstart Anthropic API. Fonte immagine: Initial setup - Anthropic
Con Python, esegui il fine-tuning dei large language model di base su un dataset personalizzato per adattare stile, compito e funzionalità del modello alle esigenze specifiche.
Transformers di Hugging Face è un framework ben noto nella comunità e nell'industria AI. È ampiamente usato per accedere ai modelli, fare fine-tuning degli LLM con risorse limitate e salvare i modelli. Offre un ecosistema completo che va dal caricamento dei dati alla valutazione degli LLM.
Con Transformers puoi caricare dataset e modelli, processare i dati, costruire modelli con argomenti personalizzati, addestrarli e pubblicarli nel cloud. In seguito, puoi distribuire questi modelli su un server con pochi clic.
Segui il corso Introduction to LLMs in Python per conoscere il panorama degli LLM, l'architettura Transformer, gli LLM pre-addestrati e come integrarli per risolvere problemi reali.
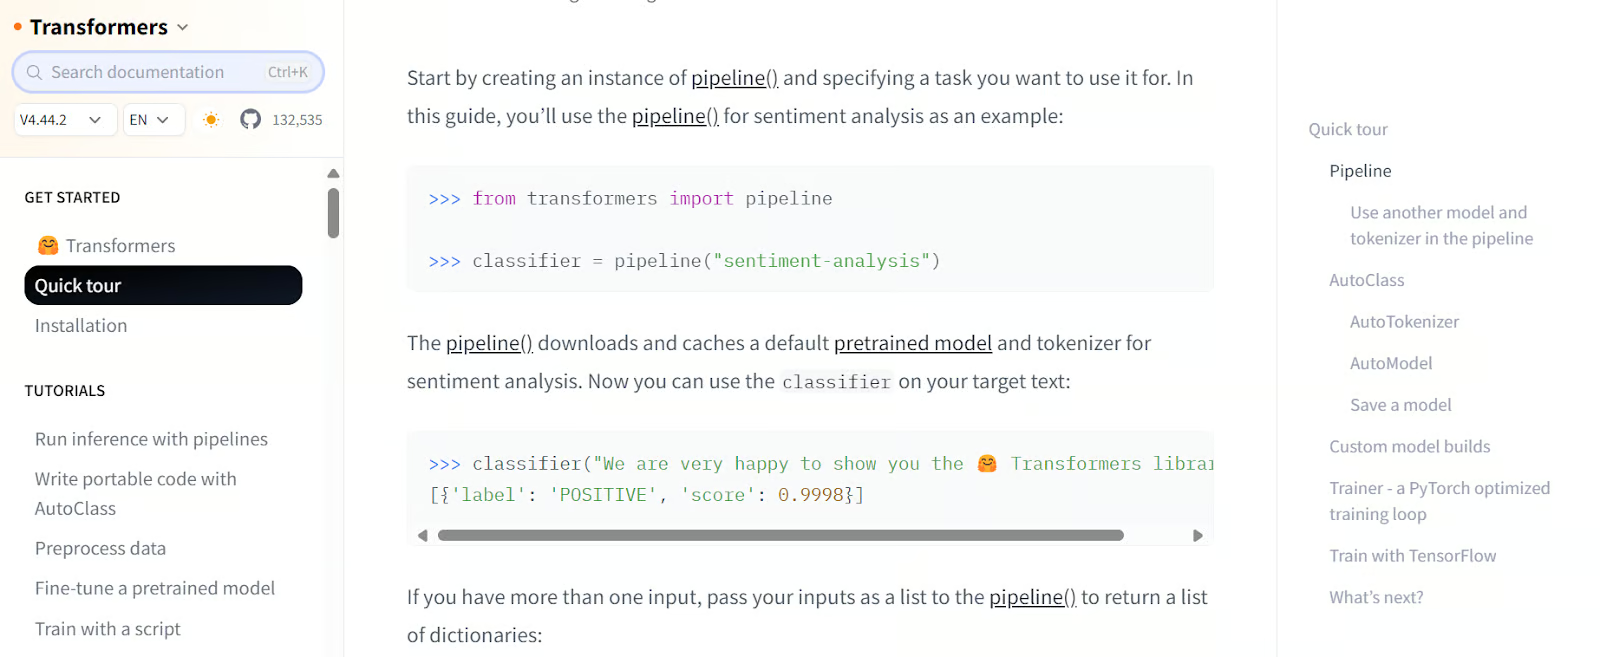
Codice quickstart di Transformers. Fonte immagine: Quick tour (huggingface.co)
Unsloth AI è un framework Python per il fine-tuning e l'accesso ai large language model. Offre una semplice API e prestazioni 2x più veloci rispetto a Transformers.
Costruito sopra la libreria Transformers, integra strumenti aggiuntivi per semplificare il fine-tuning dei large language model con risorse limitate. Una funzione di spicco di Unsloth è la possibilità di salvare i modelli in formato compatibile con vLLM e GGUF con una sola riga di codice, eliminando la necessità di installare e configurare librerie come llama.cpp, perché gestisce tutto in automatico.
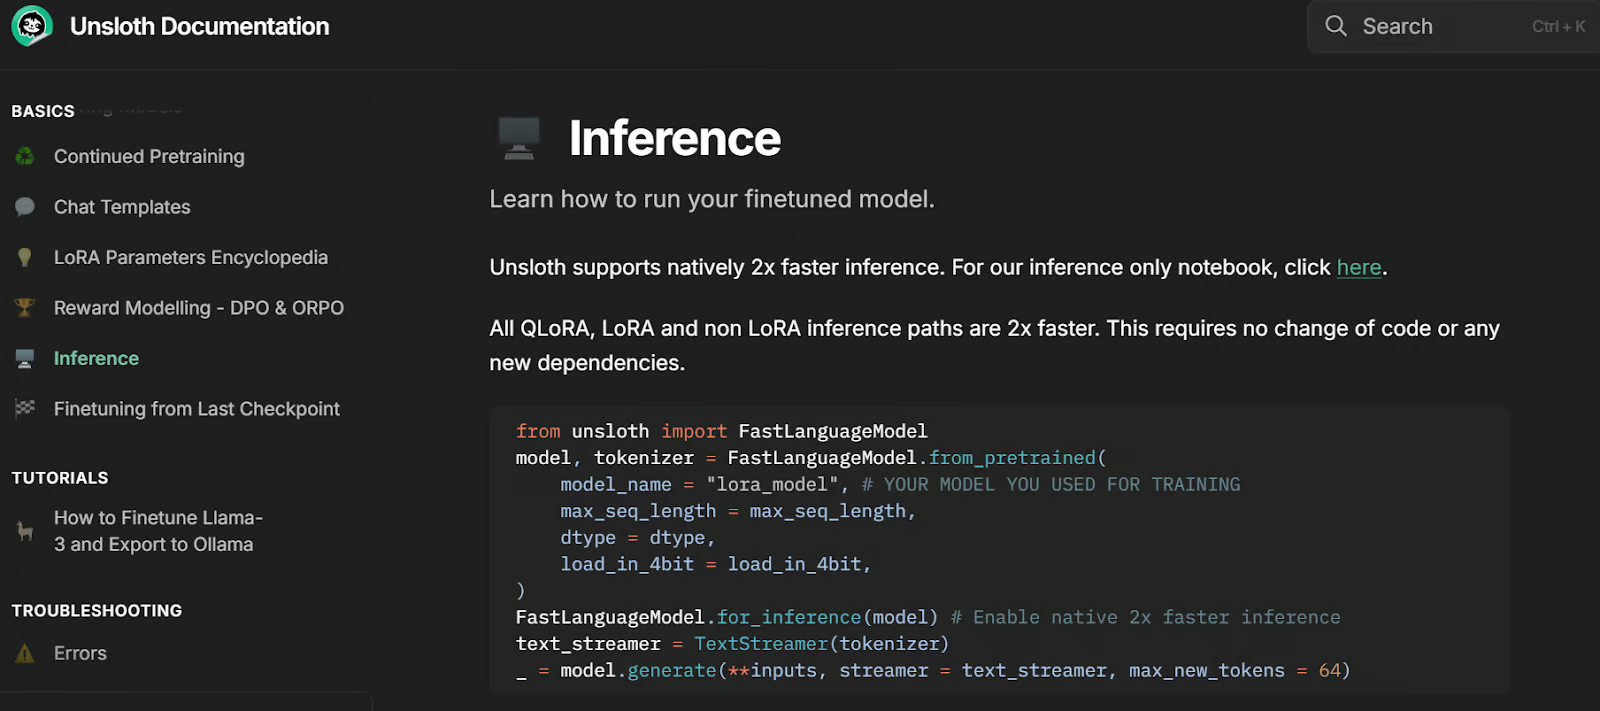
Codice di inferenza Unsloth. Fonte immagine: Inference | Unsloth Documentation
Traccia ed esamina le prestazioni del modello durante il training e confronta i risultati.
Weights & Biases ti consente di tracciare le prestazioni del modello durante e dopo il fine-tuning per valutarne l'efficacia. Supporta anche il tracciamento delle applicazioni RAG e il monitoraggio e il debug degli LLM.
La piattaforma si integra senza problemi con vari framework e strumenti, tra cui Transformers, LangChain, PyTorch e Keras. Un vantaggio chiave di Weights & Biases è la dashboard altamente personalizzabile, che ti permette di creare report di valutazione del modello e confrontare diverse versioni.
Impara a strutturare, registrare e analizzare i tuoi esperimenti di machine learning con Weights & Biases seguendo il tutorial Machine Learning Experimentation: An Introduction to Weights & Biases.
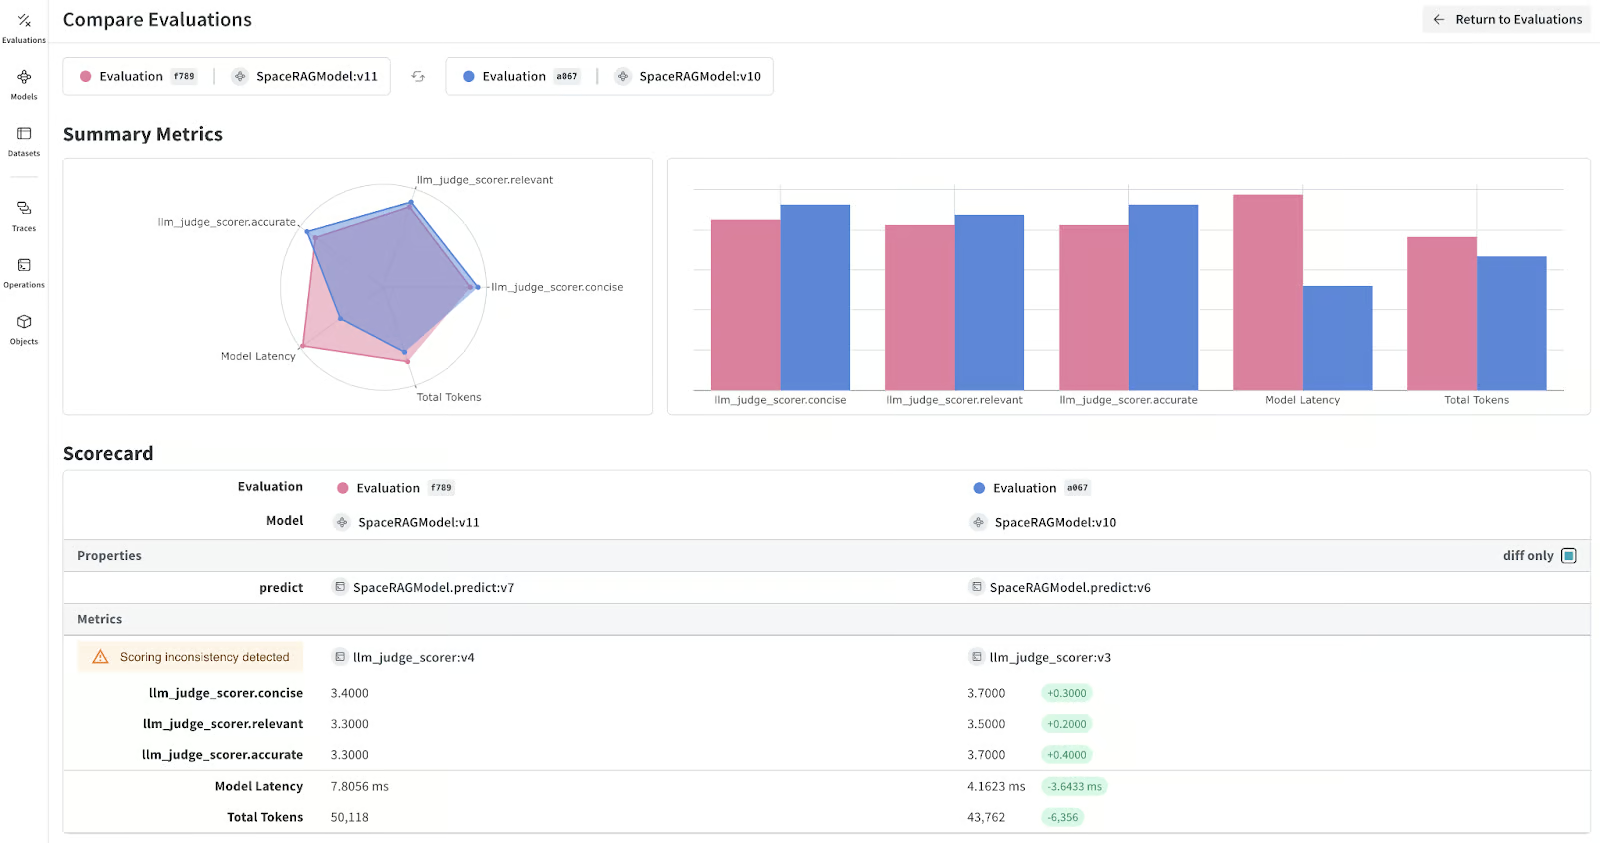
Metriche del modello LLM. Fonte immagine: wandb.ai
Integra gli LLM con database esterni, database privati e ricerca sul web. Con questi framework puoi persino creare e servire l'intera applicazione AI. In breve, questi strumenti sono fondamentali per costruire applicazioni complesse basate su LLM che puoi distribuire nel cloud.
LangChain è uno strumento popolare per creare applicazioni AI con gli LLM. Con poche righe di codice puoi sviluppare chatbot RAG sensibili al contesto direttamente nei notebook Jupyter.
LangChain ora offre un ecosistema LLM completo:
LangChain semplifica lo sviluppo di applicazioni basate su LLM fornendo strumenti, componenti e interfacce che snelliscono il processo.
Completa il corso Developing LLM Applications with LangChain per capire come costruire applicazioni AI usando LLM, prompt, catene e agent in LangChain.
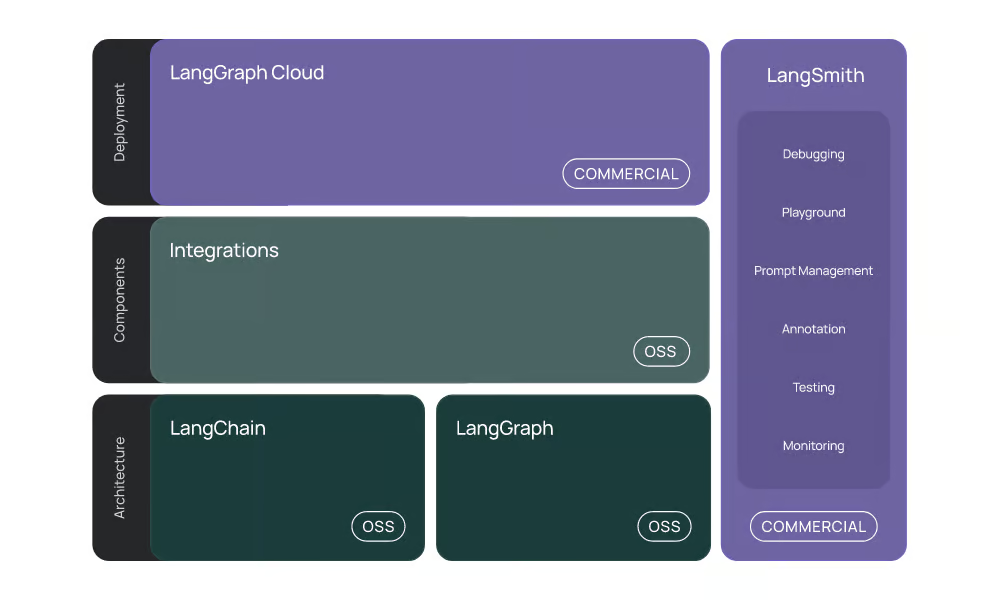
L'ecosistema LangChain. Fonte immagine: Introduction | 🦜️🔗 LangChain
LlamaIndex è simile a LangChain ma offre un approccio più semplice alla creazione di applicazioni RAG. Con poche righe di codice puoi creare applicazioni RAG con cronologia.
LlamaIndex fornisce integrazioni complete con API e vector store, consentendo lo sviluppo di applicazioni LLM complesse e all'avanguardia. Dispone anche di un servizio gestito chiamato LlamaCloud, che permette di ospitare facilmente applicazioni AI.
Impara a ingerire, gestire e recuperare dati privati e specifici di dominio usando il linguaggio naturale con il tutorial LlamaIndex: A Data Framework for the Large Language Models (LLMs) based applications.
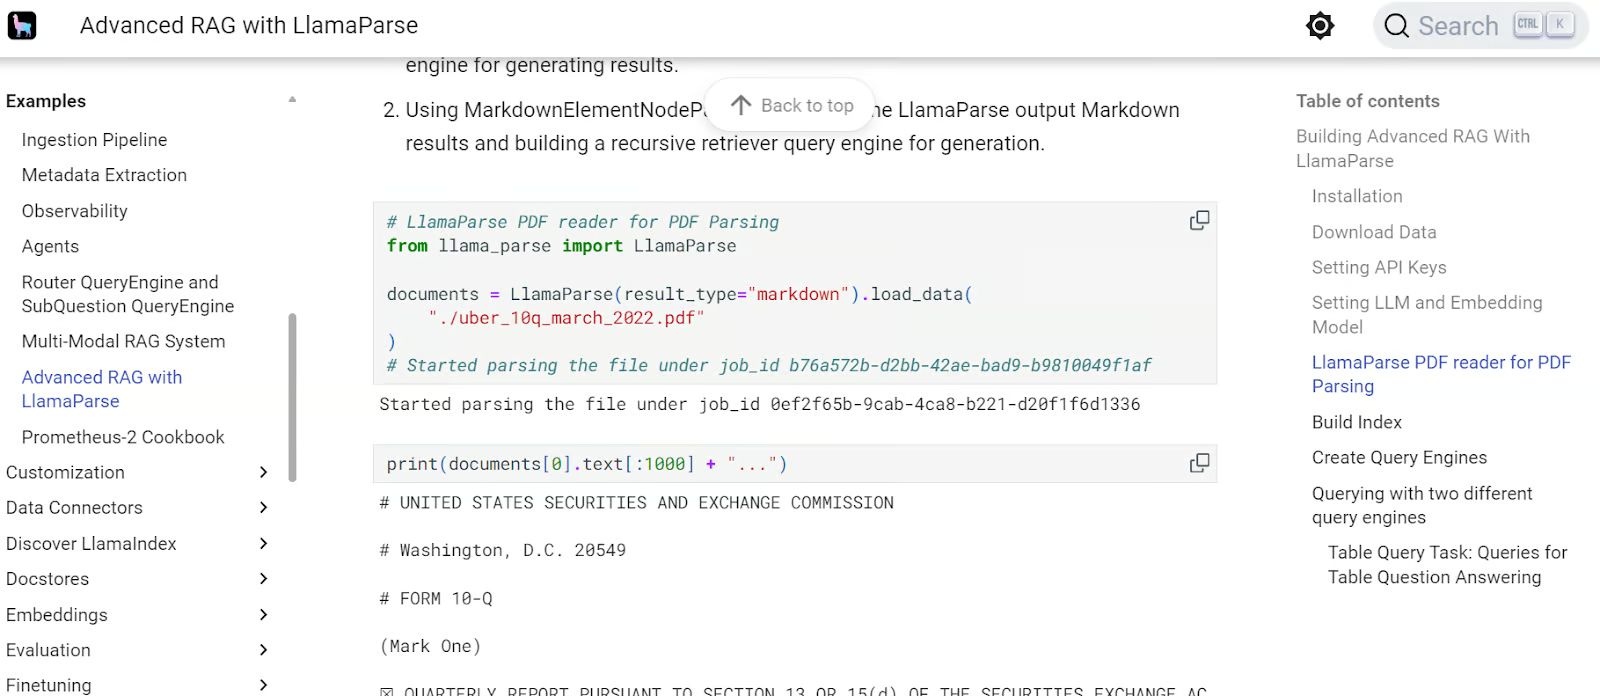
Guida RAG avanzata di LlamaIndex. Fonte immagine: Advanced RAG with LlamaParse - LlamaIndex
Gli strumenti di ricerca vettoriale offrono solide capacità di archiviazione e recupero, essenziali per costruire applicazioni di Retrieval-Augmented Generation (RAG). Questi strumenti consentono di convertire vari tipi di dati, come testo, immagini e audio, in embedding, che vengono poi archiviati in database vettoriali.
Chroma è un database vettoriale open-source nativo per l'AI. Rende semplice costruire app LLM permettendo di integrare facilmente conoscenze, fatti e competenze.
Se vuoi creare una semplice applicazione RAG che ti consenta di archiviare i documenti come embedding e poi recuperarli per combinarli con i prompt e dare più contesto al modello linguistico, non ti serve LangChain. Ti basta un Chroma DB per salvare e recuperare i documenti.
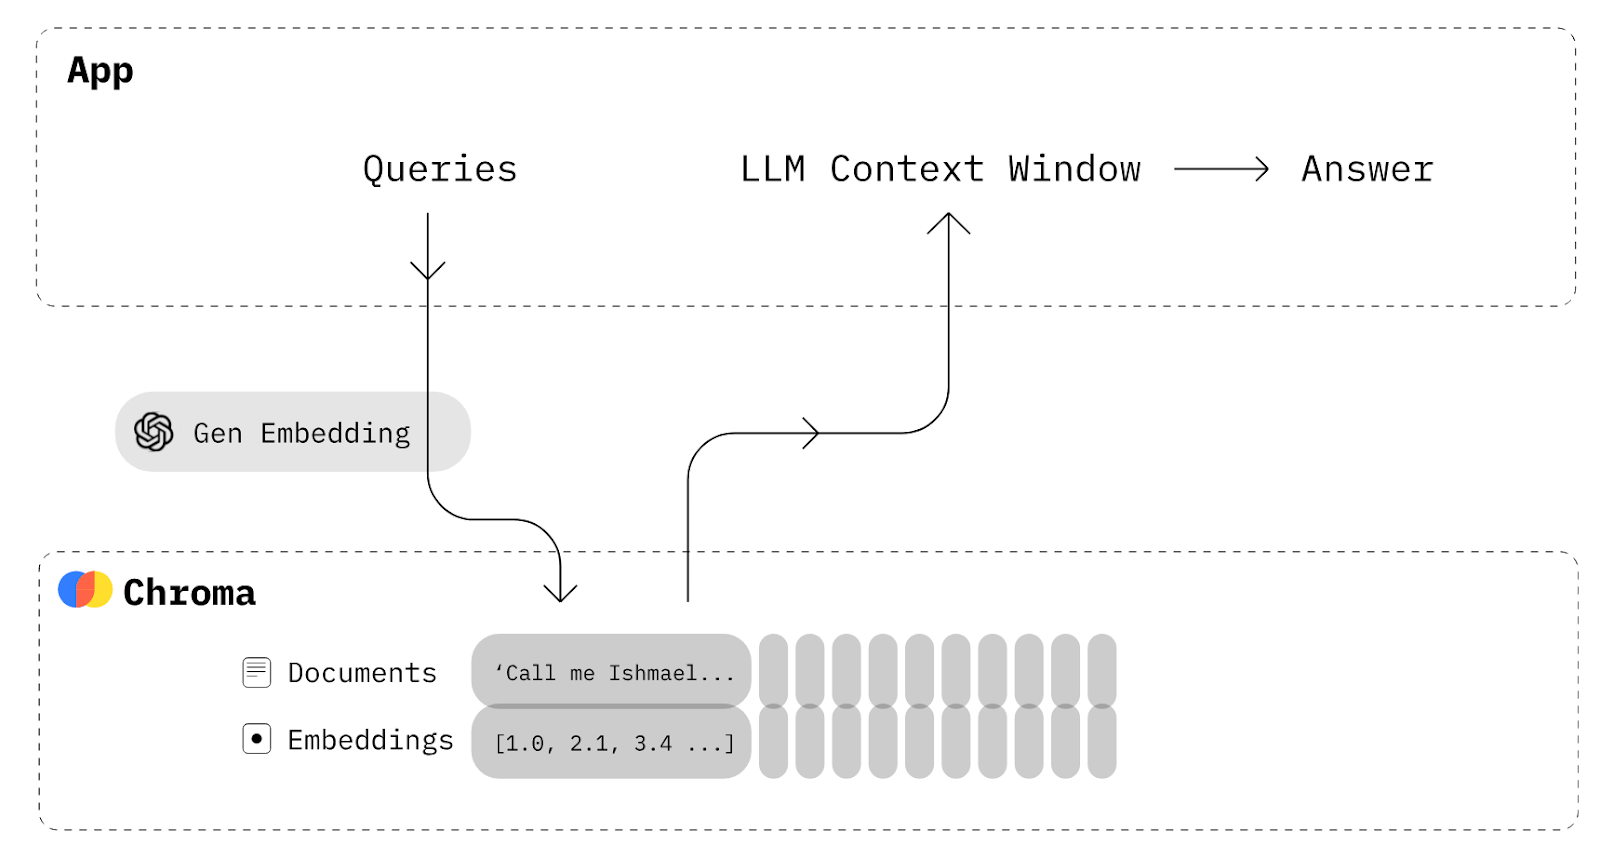
Diagramma Chroma DB. Fonte immagine: Chroma Docs (trychroma.com)
Qdrant è un popolare database vettoriale open-source e motore di ricerca per similarità che gestisce vettori ad alta dimensionalità. Offre soluzioni locali, cloud e ibride, risultando versatile per diverse esigenze di deployment.
Qdrant è particolarmente efficace in applicazioni come retrieval-augmented generation, rilevamento di anomalie, ricerca avanzata e sistemi di raccomandazione. La sua API robusta consente un'integrazione e una gestione agevole dei dati testuali, rendendolo uno strumento potente per gli sviluppatori che vogliono implementare funzionalità di ricerca basate su vettori.
Dai un'occhiata a The 5 Best Vector Databases per il tuo caso d'uso specifico. Offrono un'API semplice e prestazioni elevate.
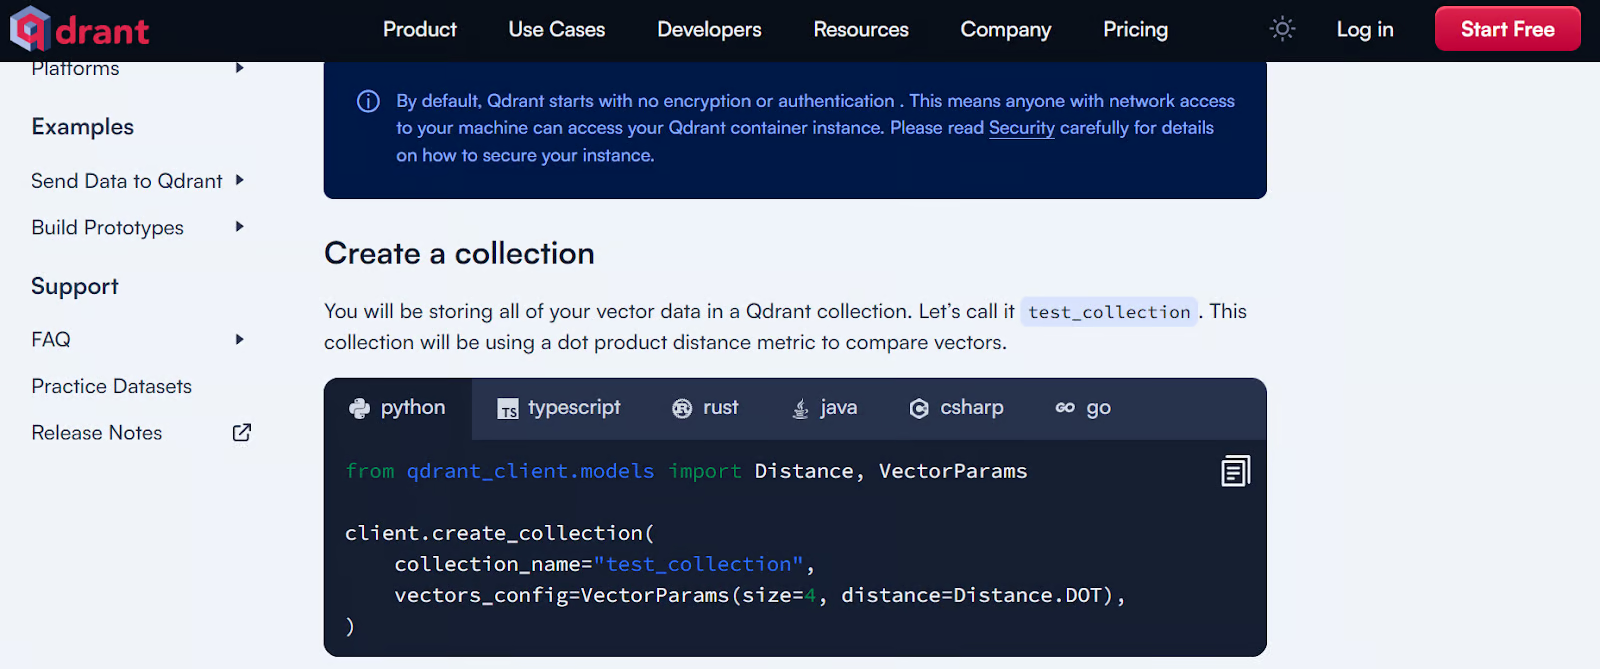
Esempio di avvio rapido Qdrant. Fonte immagine: Local Quickstart - Qdrant
Un componente essenziale per la tua applicazione è un motore di inferenza e serving ad alto throughput per LLM compatibile con un'ampia gamma di risorse di calcolo, tra cui GPU, TPU, XPU e altro. Questi strumenti sono anche compatibili con server compatibili con OpenAI, permettendoti di usare l'API di OpenAI per accedere al modello servito senza soluzione di continuità.
vLLM è una solida libreria open-source progettata per un'inferenza e un serving efficienti dei large language model. Affronta le sfide del deployment degli LLM, come l'elevato consumo di memoria e i costi computazionali, utilizzando tecniche innovative di gestione della memoria e strategie di batching dinamico.
Una delle migliori funzionalità di vLLM è l'algoritmo PagedAttention, che aumenta significativamente il throughput e riduce gli sprechi di memoria. Offre fino a 24 volte più throughput rispetto a soluzioni tradizionali come Hugging Face Transformers.
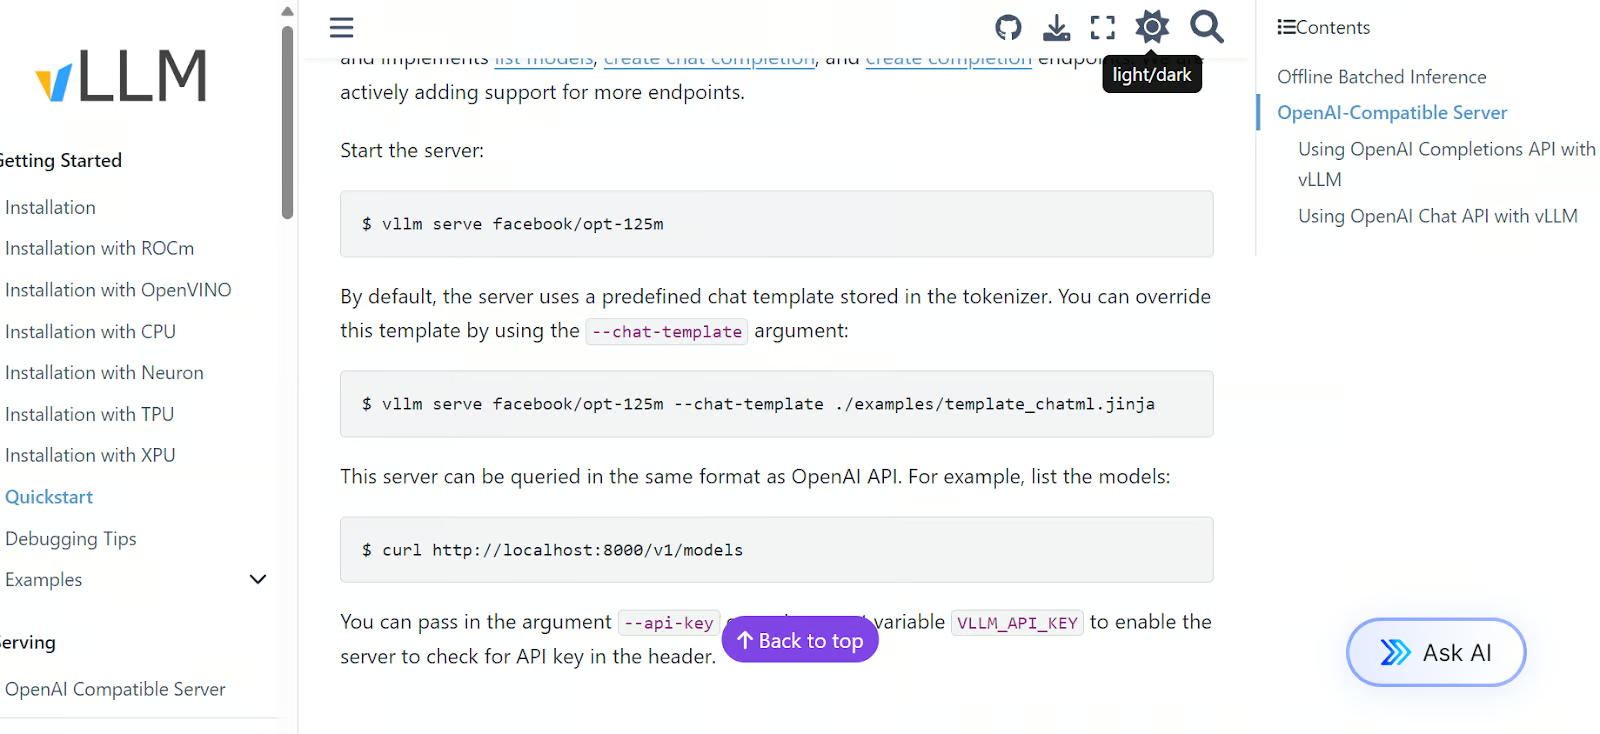
Esempio di quick start vLLM. Fonte immagine: Quickstart — vLLM
BentoML è una libreria Python per costruire e servire LLM, che offre più opzioni di personalizzazione per sviluppare applicazioni AI rispetto a vLLM. Include BentoCloud, un servizio gestito che permette di distribuire e monitorare facilmente i modelli nel cloud, con un livello gratuito per iniziare.
BentoML automatizza molti passaggi complessi del deployment dei modelli, riducendo significativamente il tempo necessario per passare dallo sviluppo alla produzione.
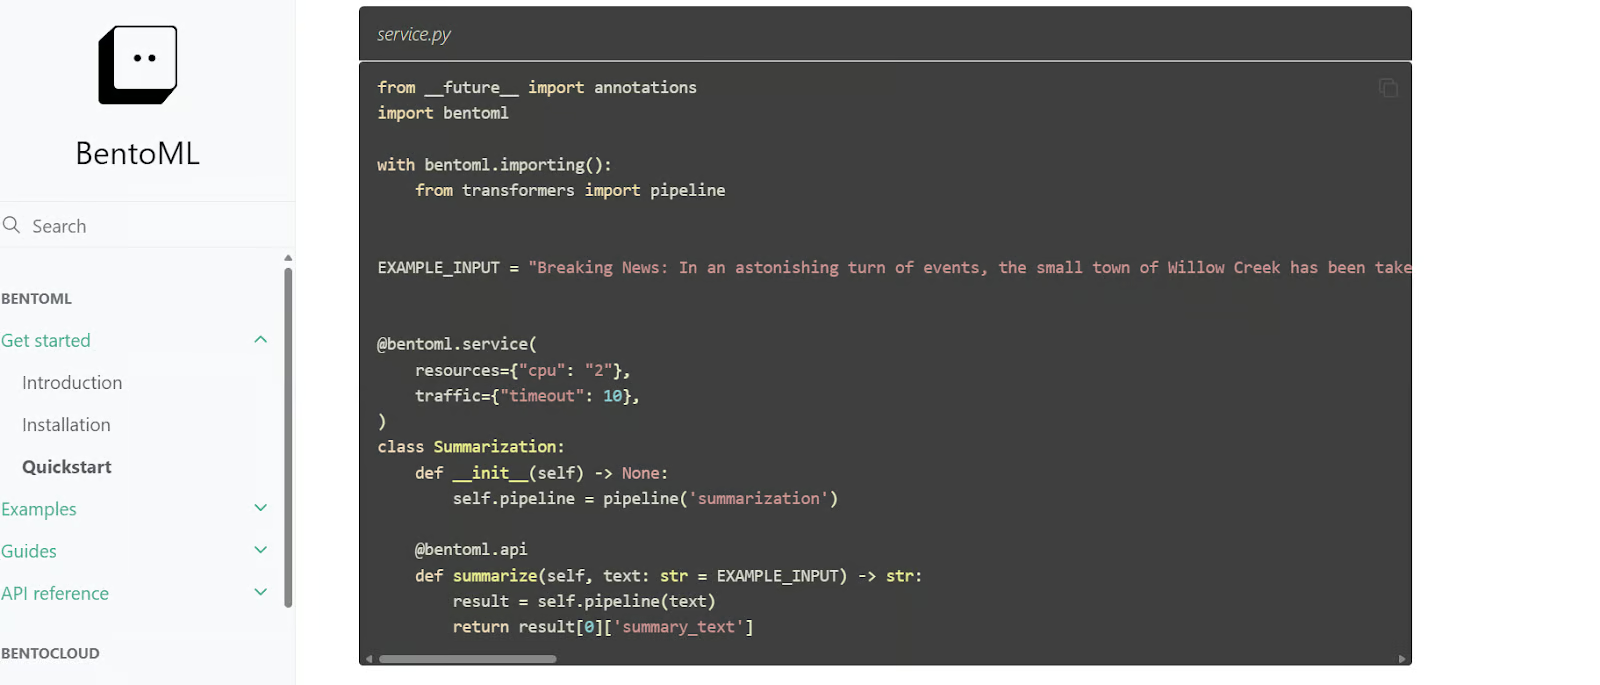
Codice quickstart BentoML. Fonte immagine: Quickstart - BentoML
Puoi distribuire il tuo LLM direttamente nel cloud oppure creare un'applicazione AI integrata e poi distribuirla. Per farlo, puoi scegliere qualsiasi grande fornitore di servizi cloud. Tuttavia, gli strumenti seguenti sono progettati appositamente per LLM e deployment AI, fornendo funzionalità di distribuzione più semplici ed efficienti.
Se ami l'ecosistema Hugging Face, adorerai gli Inference Endpoints di Hugging Face. Questo servizio di deployment ti permette di servire qualsiasi modello dall'hub di modelli di Hugging Face, inclusi i modelli privati, per l'uso in produzione. Ti basta selezionare il provider cloud e il tipo di macchina di calcolo, e in pochi minuti il tuo modello è pronto all'uso.
Inference Endpoints ha una dashboard dedicata che ti consente di creare endpoint e monitorare i modelli in produzione, fornendo una soluzione sicura ed efficiente per distribuire modelli di machine learning.
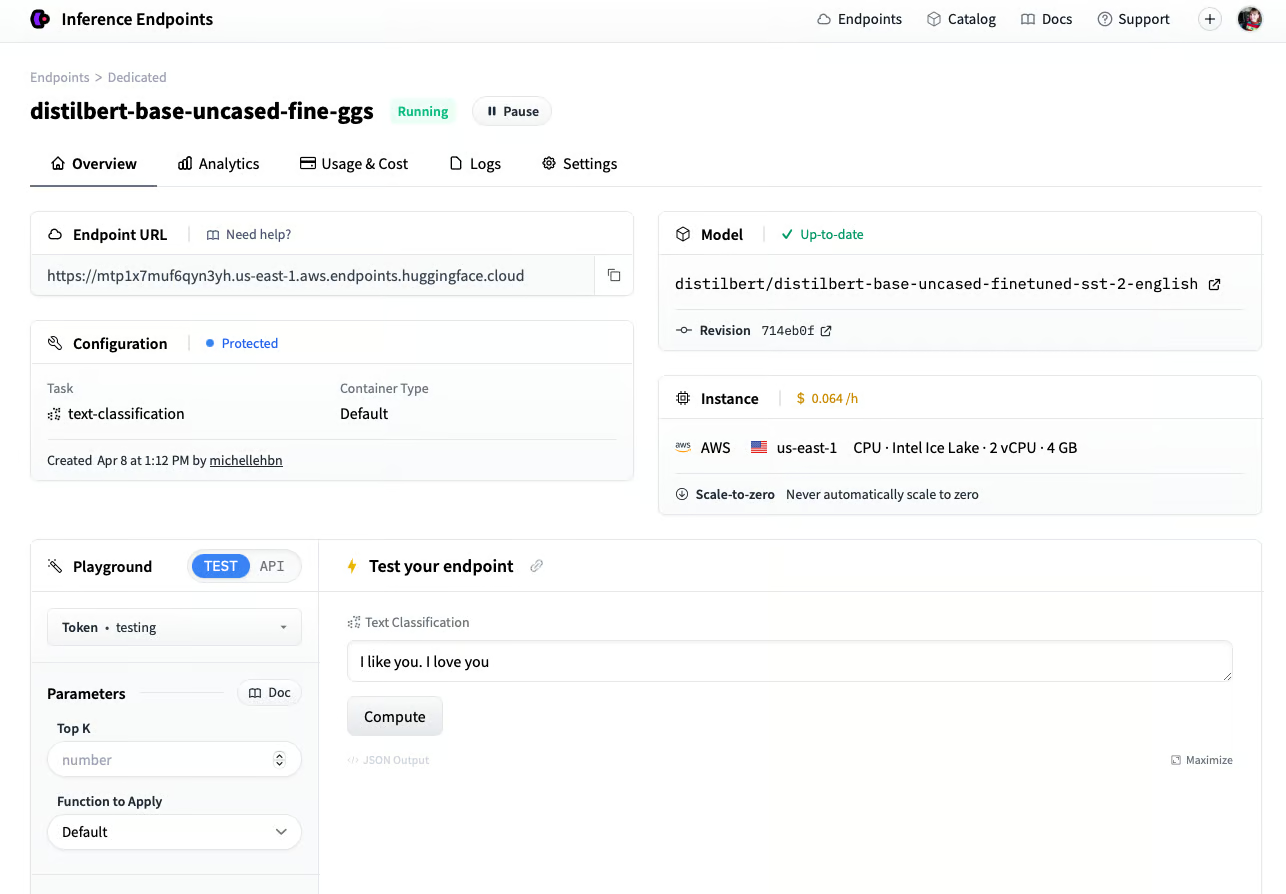
Distribuire un modello tramite l'Inference endpoint di Hugging Face. Fonte immagine: Create an Endpoint (huggingface.co)
Anyscale utilizza Ray Serve nel backend per offrire inferenza di modelli veloce e ad alto throughput. In quanto piattaforma di calcolo completamente gestita e scalabile, Anyscale ti consente di caricare dati, addestrare modelli, valutarli e servirli, gestire i servizi, monitorare i modelli e controllare gli accessi. È una piattaforma MLOps end-to-end costruita sull'ecosistema open-source Ray, che semplifica l'intero ciclo di vita delle applicazioni AI.
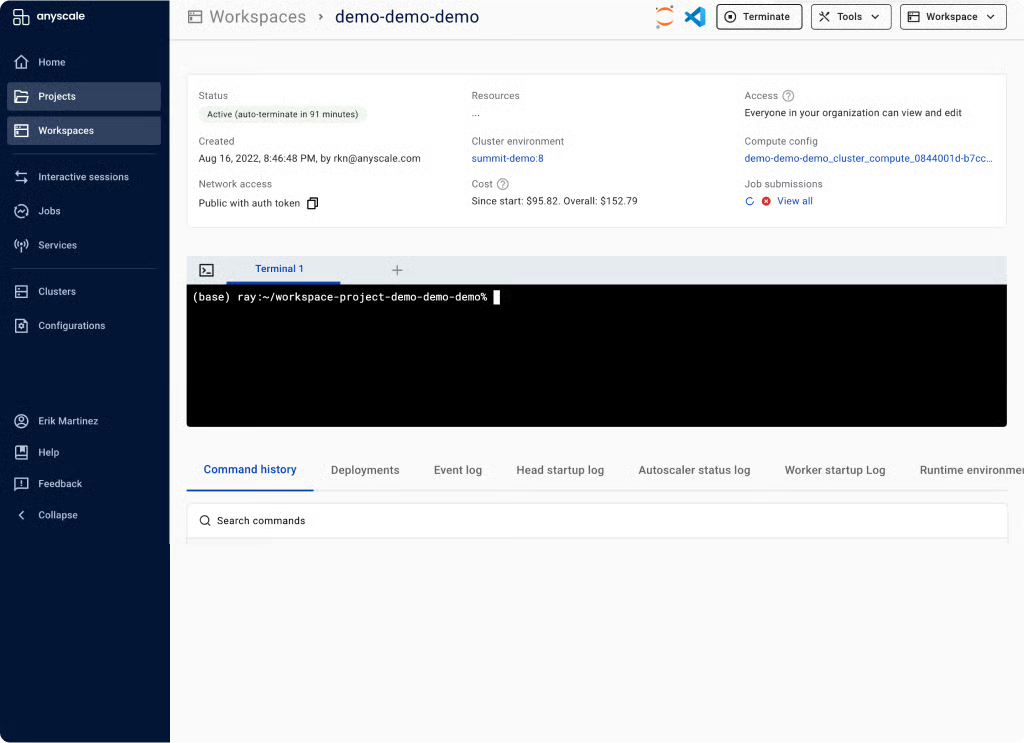
Workspace Anyscale. Fonte immagine: Unified Compute Platform for AI & Python Apps | Anyscale
Una volta distribuiti gli LLM, è fondamentale monitorarne le prestazioni in produzione. Gli strumenti di osservabilità tracciano automaticamente il tuo modello nel cloud e ti avvisano se le prestazioni diminuiscono in modo significativo.
Evidently è un framework open-source per l'osservabilità in ML e MLOps. Ti permette di valutare, testare e monitorare applicazioni ML e pipeline di dati. Supporta modelli predittivi generali e applicazioni di AI generativa.
Con oltre 100 metriche integrate, fornisce rilevamento del data drift e valutazione dei modelli ML. Può anche generare report di valutazione dei dati e dei modelli, suite di test automatizzate e dashboard di monitoraggio dei modelli.
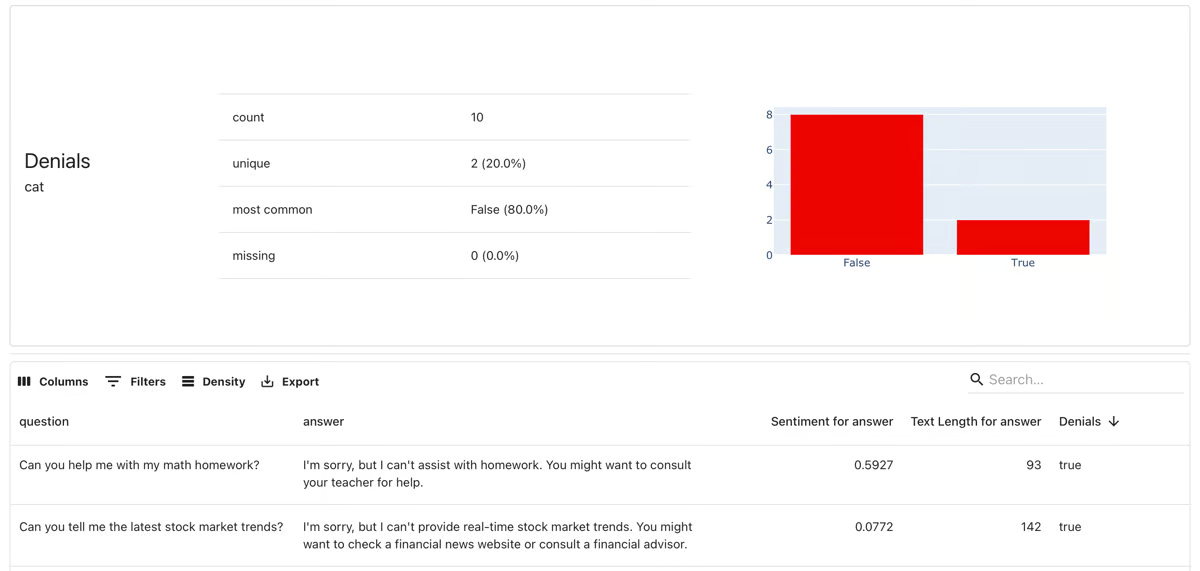
Monitoraggio dei modelli con Evidently. Fonte immagine: evidentlyai.com
Fiddler AI è una piattaforma di osservabilità dell'AI che monitora, spiega, analizza e migliora modelli LLM, modelli generativi di immagini e applicazioni AI generali. Rileva e risolve drift del modello, outlier e problemi di integrità dei dati tramite alert in tempo reale e debugging basato su explainable AI, aiutando i team a intercettare e correggere i problemi mentre si verificano.
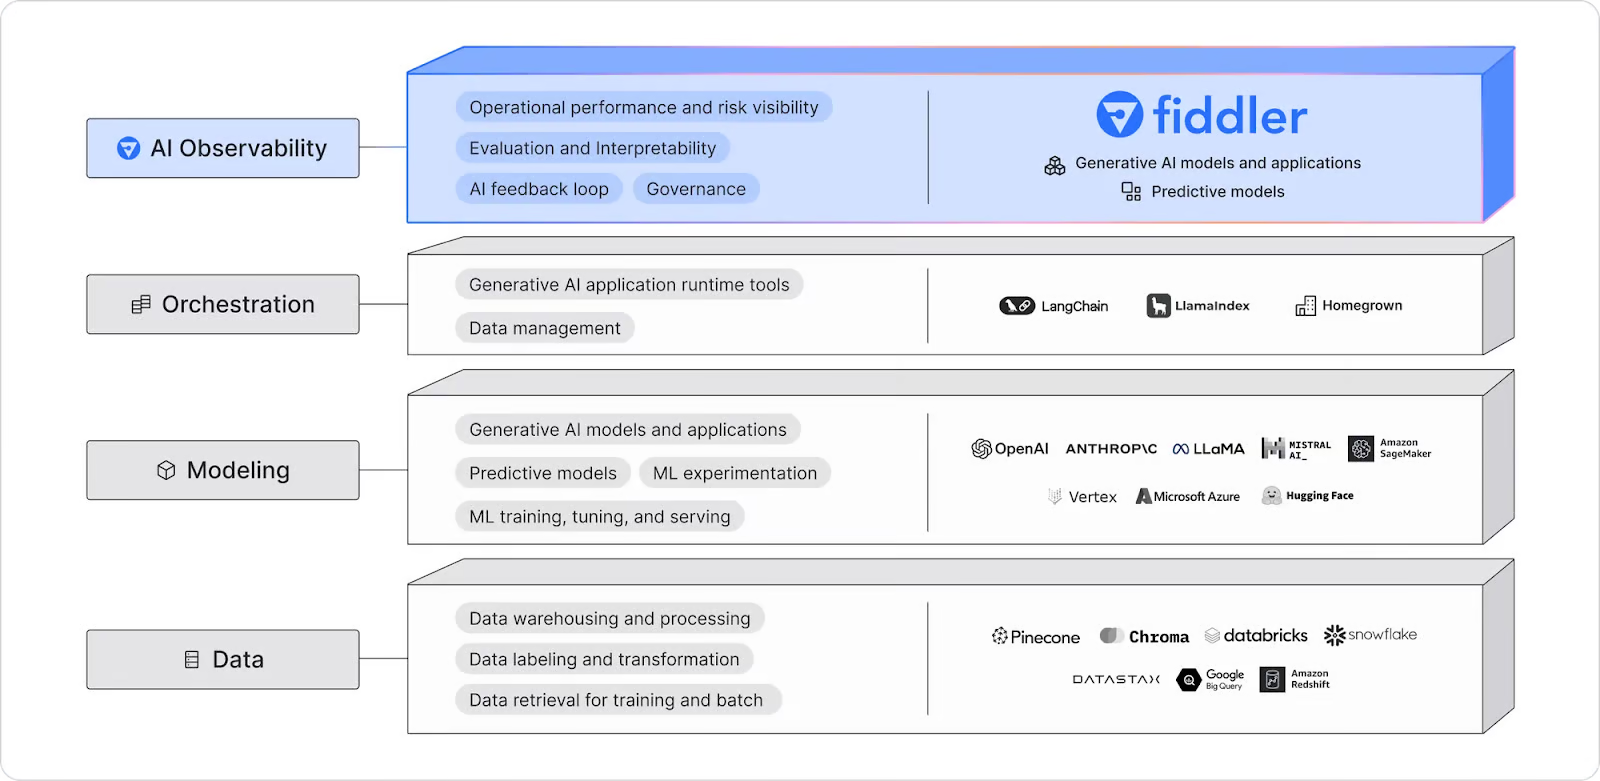
Diagramma di osservabilità Fiddler AI. Fonte immagine: LLM Observability | Fiddler AI
Ora che hai conosciuto vari strumenti di LLMOPs, è il momento di creare un progetto LLM tra quelli nella raccolta di post 12 LLM Projects For All Levels.
Il campo dell'LLMOps è ancora in evoluzione e c'è molto rumore nello spazio AI. In questo articolo, abbiamo esplorato i 15 migliori strumenti di LLMOps all'avanguardia.
Sebbene abbiamo trattato strumenti essenziali e popolari per creare, valutare e distribuire applicazioni AI nel cloud, molte categorie non sono state affrontate. Tra queste, strumenti di machine learning operations per CI/CD, orchestrazione dei workflow, versionamento di modelli e dati, Docker, Kubernetes e altro. Puoi approfondire queste categorie leggendo il post 25 Top MLOps Tools You Need to Know in 2026.
Se sei alle prime armi con l'LLMOps, è altamente consigliato iniziare con l'API di OpenAI e costruire un minimum viable product!
Approfondisci gli LLM con i seguenti corsi!
Corso
Corso
Pratica and corso your progress.
Continua Con Googleblog
Abid Ali Awan
15 min
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min



