
कोर्स
LLMOps Concepts
1 घंटा
19.5K
चित्र: लेखक द्वारा
हम बड़े भाषा मॉडल्स (LLMs) को बेहतर बनाने के चरण से आगे बढ़ चुके हैं और अब उनका उपयोग ऐसे एआई एप्लिकेशन बनाने में कर रहे हैं जो व्यवसायों की मदद करें। यहीं पर बड़े भाषा मॉडल ऑपरेशन्स (LLMOps) टूल्स काम आते हैं—ये LLM समाधानों को प्रोडक्शन में बनाने और तैनात करने के लिए पूरी तरह स्वचालित सिस्टम तैयार करने की प्रक्रिया को सरल बनाते हैं।
इस लेख में, हम विभिन्न टूल्स पर नज़र डालेंगे—जैसे LLM APIs, फाइन-ट्यूनिंग फ्रेमवर्क, एक्सपेरिमेंट ट्रैकिंग टूल्स, LLM इंटीग्रेशन इकोसिस्टम, वेक्टर सर्च टूल्स, मॉडल सर्विंग फ्रेमवर्क, डिप्लॉयमेंट प्लेटफ़ॉर्म, और ऑब्ज़र्वेबिलिटी टूल्स। हर टूल अपने काम में बेहतरीन है और LLMs से संबंधित विशिष्ट समस्याओं को सुलझाने के लिए बनाया गया है।
LLMOps एक उभरता हुआ क्षेत्र है जो प्रोडक्शन वातावरण में बड़े भाषा मॉडल्स के परिचालन प्रबंधन पर केंद्रित है। मूल रूप से यह MLOps (मशीन लर्निंग ऑपरेशन्स) ही है, जिसे भाषा और अन्य मल्टीमॉडल मॉडल्स के लिए विशेष रूप से अनुकूलित किया गया है।
Master Large Language Models (LLMs) Concepts कोर्स लें ताकि आप LLM एप्लिकेशन, प्रशिक्षण पद्धतियाँ, नैतिक पहलू, और नवीनतम शोध के बारे में सीख सकें।
LLMOps बड़े भाषा मॉडल्स के पूरे जीवनचक्र को समेटता है—डेटा संग्रहण, मॉडल प्रशिक्षण या फाइन-ट्यूनिंग, परीक्षण और वैलिडेशन, इंटीग्रेशन, डिप्लॉयमेंट, ऑप्टिमाइज़ेशन, मॉनिटरिंग और मेंटेनेंस, और सहयोग। परियोजनाओं को संरचित कर और प्रक्रियाओं का स्वचालन करके, LLMOps त्रुटियाँ कम करता है और एआई एप्लिकेशन को कुशलतापूर्वक स्केल करने में मदद करता है, जिससे मॉडल मज़बूत बनते हैं और वास्तविक दुनिया की मांगों को पूरा कर पाते हैं।
संक्षेप में, LLMOps टूल्स आपको एक स्वचालित सिस्टम बनाने में मदद करते हैं जो डेटा एकत्र करता है, उस पर मॉडल को फाइन-ट्यून करता है, मॉडल का प्रदर्शन ट्रैक करता है, उसे बाहरी डेटा से जोड़ता है, एआई ऐप बनाता है, उसे क्लाउड में तैनात करता है, और प्रोडक्शन में मॉडल के मेट्रिक्स व प्रदर्शन का निरीक्षण करता है।
Developing Large Language Models स्किल ट्रैक में 4 कोर्स शामिल हैं जो आपको LLM कैसे काम करते हैं और आप प्री-ट्रेंड LLMs को कैसे फाइन-ट्यून कर सकते हैं, इस पर मज़बूत आधार बनाने में मदद करेंगे।
अब, आज उपलब्ध शीर्ष LLMOps टूल्स पर नज़र डालते हैं।
API कॉल्स के ज़रिए भाषा और एम्बेडिंग मॉडल्स तक पहुँचें। आपको मॉडल तैनात करने या सर्वर बनाए रखने की ज़रूरत नहीं—सिर्फ API कुंजी प्रदान करें और अत्याधुनिक मॉडल्स का उपयोग शुरू करें।
OpenAI GPT-4o और o1 जैसे उन्नत LLM मॉडल्स तक API एक्सेस देता है। इन मॉडल्स का उपयोग Python पैकेज या CURL कमांड के माध्यम से किया जा सकता है।
यह API उन स्टार्टअप्स के लिए आदर्श है जिनके पास मॉडल्स को फाइन-ट्यून या प्रोडक्शन में तैनात करने के लिए तकनीकी टीम नहीं है। यह भाषा मॉडल्स, मल्टीमॉडल मॉडल्स, फंक्शन कॉलिंग, स्ट्रक्चर्ड आउटपुट्स, और फाइन-ट्यूनिंग विकल्पों तक पहुँच प्रदान करता है। इसके अलावा, आप एम्बेडिंग मॉडल्स का उपयोग करके अपना वेक्टर डेटाबेस बना सकते हैं। संक्षेप में, यह एक व्यापक और किफायती एआई इकोसिस्टम प्रदान करता है।
OpenAI Python API का उपयोग करके अत्याधुनिक LLMs तक पहुँच पाना सीखें: GPT-4o API Tutorial: Getting Started with OpenAI's API.
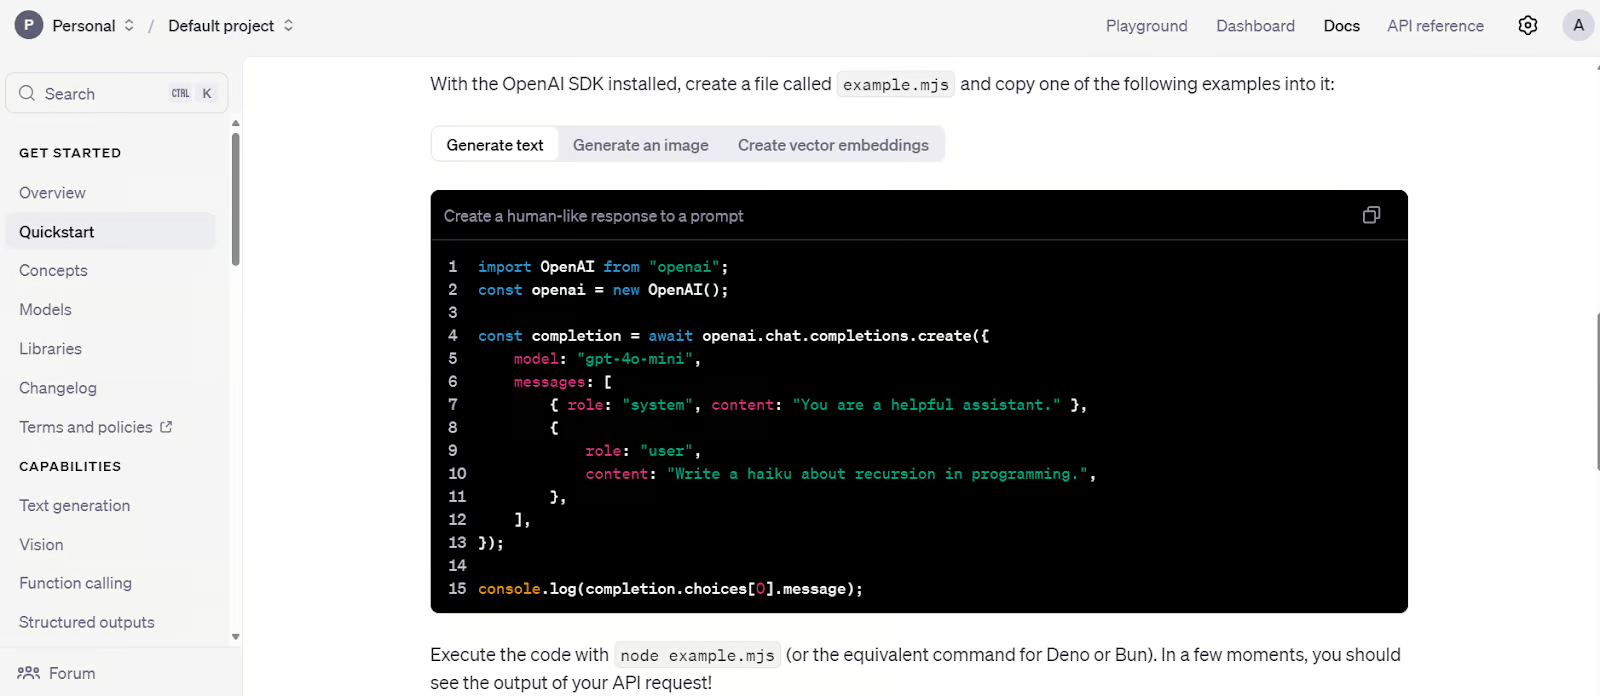
OpenAI API क्विकस्टार्ट कोड। चित्र स्रोत: Quickstart tutorial - OpenAI API
Anthropic API OpenAI API के समान है और विभिन्न भाषा तथा एम्बेडिंग मॉडल्स तक पहुँच देता है। इन मॉडल्स का उपयोग RAG एप्लिकेशन बनाने, टूल्स इंटीग्रेट करने, वेब पेज रिकॉल करने, विज़न मॉडल्स उपयोग करने, और एआई एजेंट विकसित करने में किया जा सकता है। समय के साथ, Anthropic का लक्ष्य पूरी तरह फ़ंक्शनल एआई एप्लिकेशन बनाने और तैनात करने के लिए आवश्यक सभी टूल्स उपलब्ध कराना है।
OpenAI API की तरह, इसमें सुरक्षा के लिए सेफगार्ड्स और मॉडल प्रदर्शन की निगरानी हेतु इवैल्यूएशन टूल्स शामिल हैं।
Claude API का उपयोग करके शीर्ष-प्रदर्शन वाले LLMs तक पहुँचना सीखें: Claude Sonnet 3.5 API Tutorial: Getting Started With Anthropic's API.
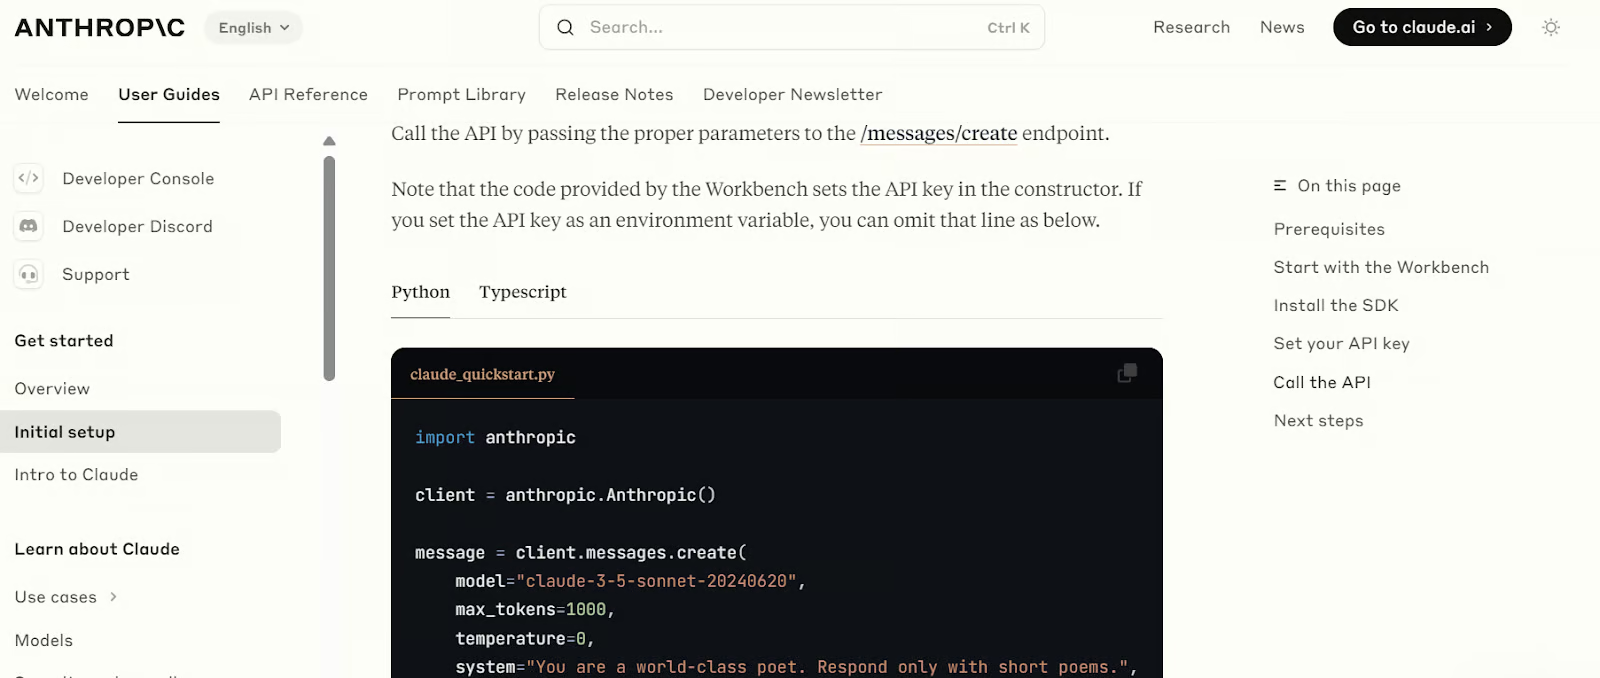
Anthropic API क्विकस्टार्ट कोड। चित्र स्रोत: Initial setup - Anthropic
Python का उपयोग करके कस्टम डेटासेट पर बेस बड़े भाषा मॉडल्स को फाइन-ट्यून करें, ताकि मॉडल की शैली, कार्य, और कार्यक्षमता विशिष्ट आवश्यकताओं के अनुरूप ढल सके।
Transformers (Hugging Face) एआई समुदाय और उद्योग में एक प्रसिद्ध फ्रेमवर्क है। यह मॉडल्स तक पहुँचने, सीमित संसाधनों में LLMs को फाइन-ट्यून करने, और मॉडल्स को सहेजने के लिए व्यापक रूप से उपयोग होता है। यह डेटा लोडिंग से लेकर LLMs के इवैल्यूएशन तक के लिए संपूर्ण इकोसिस्टम प्रदान करता है।
Transformers के साथ, आप डेटासेट और मॉडल्स लोड कर सकते हैं, डेटा प्रोसेस कर सकते हैं, कस्टम आर्गुमेंट्स के साथ मॉडल्स बना सकते हैं, मॉडल्स को प्रशिक्षित कर सकते हैं, और उन्हें क्लाउड पर पुश कर सकते हैं। बाद में, आप कुछ क्लिक में इन मॉडल्स को सर्वर पर तैनात कर सकते हैं।
Introduction to LLMs in Python कोर्स लें और LLM परिदृश्य, ट्रांसफ़ॉर्मर आर्किटेक्चर, प्री-ट्रेंड LLMs, और वास्तविक समस्याओं को हल करने हेतु LLMs इंटीग्रेट करने का तरीका सीखें।
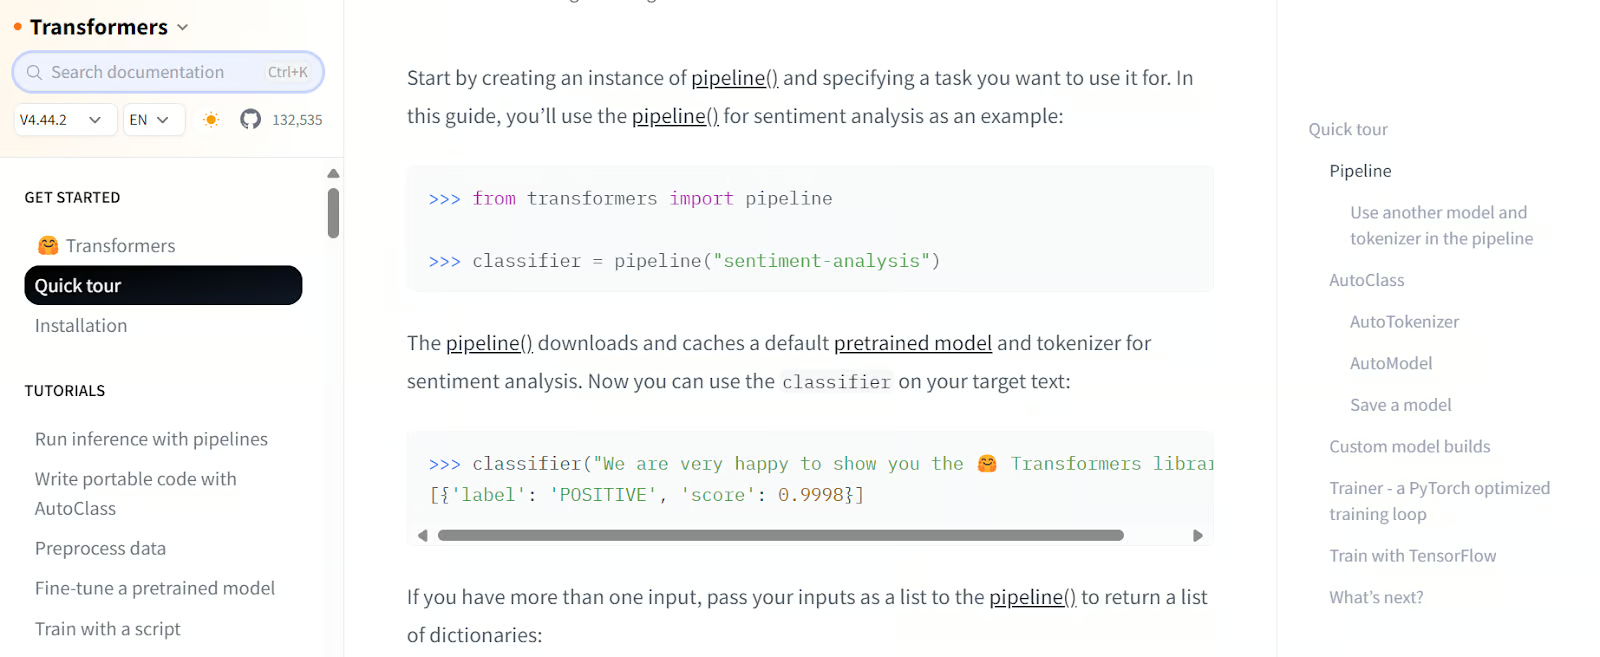
Transformers क्विकस्टार्ट कोड। चित्र स्रोत: Quick tour (huggingface.co)
Unsloth AI बड़े भाषा मॉडल्स को फाइन-ट्यून करने और एक्सेस करने के लिए एक Python फ्रेमवर्क है। यह सरल API और Transformers की तुलना में 2x तेज़ परफ़ॉर्मेंस प्रदान करता है।
Transformers लाइब्रेरी पर निर्मित, यह सीमित संसाधनों में बड़े भाषा मॉडल्स को फाइन-ट्यून करना सरल बनाने के लिए अतिरिक्त टूल्स इंटीग्रेट करता है। Unsloth की एक खासियत यह है कि आप सिर्फ एक पंक्ति कोड से मॉडल्स को vLLM और GGUF संगत फ़ॉर्मैट में सहेज सकते हैं—llama.cpp जैसी लाइब्रेरीज़ को इंस्टॉल और सेटअप करने की ज़रूरत नहीं, क्योंकि यह सब अपने आप संभालता है।
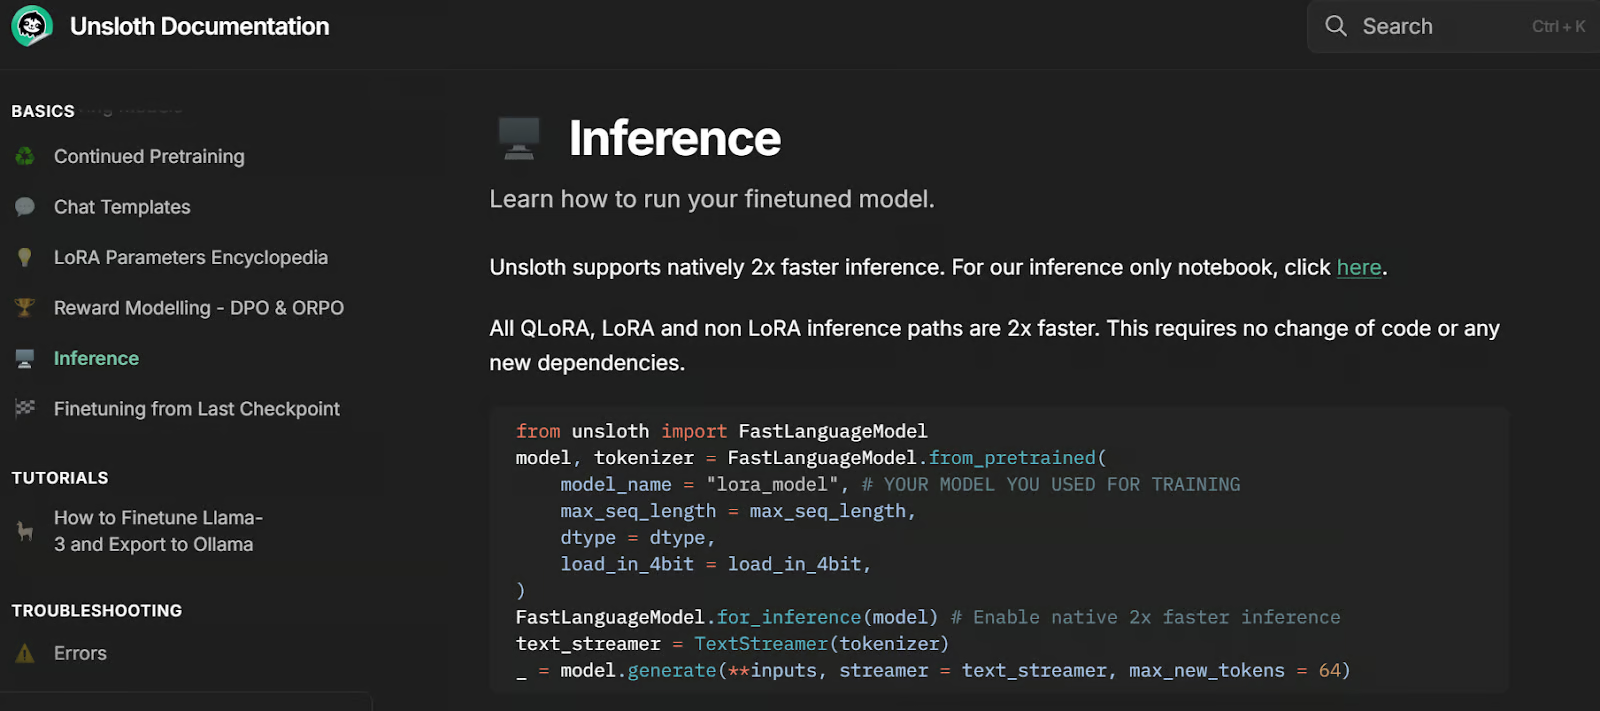
Unsloth इन्फ़रेंस कोड। चित्र स्रोत: Inference | Unsloth Documentation
ट्रेनिंग के दौरान मॉडल प्रदर्शन को ट्रैक और इवैल्यूएट करें, और परिणामों की तुलना करें।
Weights & Biases आपको फाइन-ट्यूनिंग के दौरान और बाद में मॉडल का प्रदर्शन ट्रैक करने देता है, ताकि प्रभावशीलता का आकलन हो सके। यह RAG एप्लिकेशन ट्रैकिंग, LLM मॉनिटरिंग और डीबगिंग का भी समर्थन करता है।
यह प्लेटफ़ॉर्म Transformers, LangChain, PyTorch, और Keras सहित विभिन्न फ्रेमवर्क्स और टूल्स के साथ सहजता से इंटीग्रेट होता है। Weights & Biases का एक बड़ा लाभ इसका अत्यधिक कस्टमाइज़ेबल डैशबोर्ड है, जिससे आप मॉडल इवैल्यूएशन रिपोर्ट बना सकते हैं और विभिन्न मॉडल वर्ज़न की तुलना कर सकते हैं।
Weights & Biases का उपयोग करके अपने मशीन लर्निंग एक्सपेरिमेंट्स को स्ट्रक्चर, लॉग और विश्लेषित करना सीखें: Machine Learning Experimentation: An Introduction to Weights & Biases।
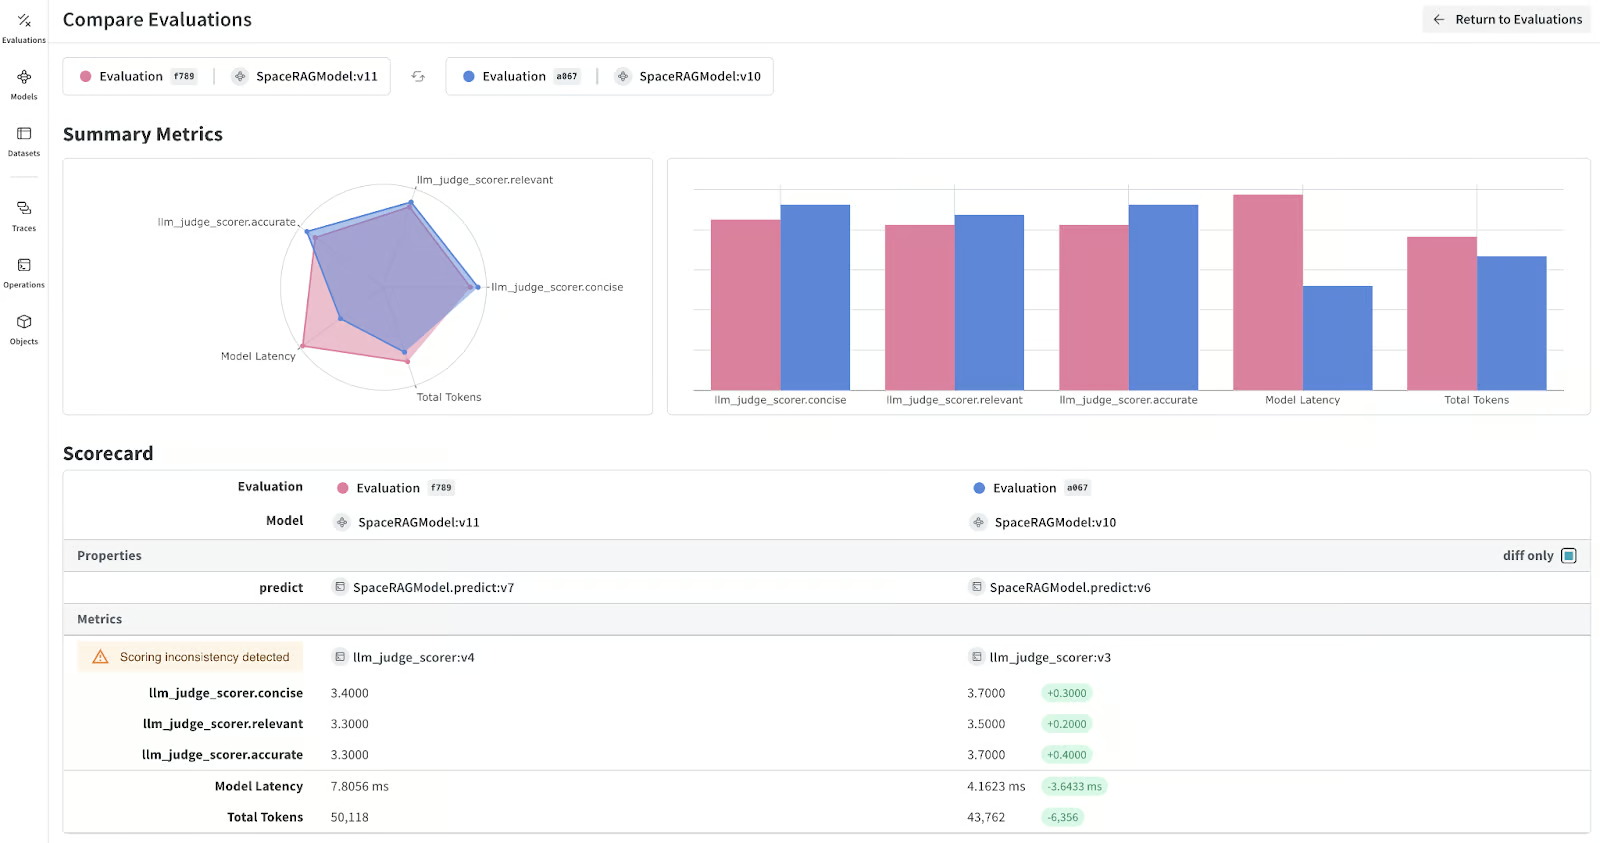
LLM मॉडल मेट्रिक्स। चित्र स्रोत: wandb.ai
LLM को बाहरी डेटाबेस, निजी डेटाबेस, और वेब सर्च के साथ इंटीग्रेट करें। आप इन्हीं फ्रेमवर्क्स से पूरा एआई एप्लिकेशन भी बना और सर्व कर सकते हैं। संक्षेप में, ये टूल्स जटिल LLM-आधारित एप्लिकेशन बनाने के लिए महत्वपूर्ण हैं जिन्हें आप क्लाउड पर तैनात कर सकें।
LangChain LLMs का उपयोग करके एआई एप्लिकेशन बनाने के लिए एक लोकप्रिय टूल है। कुछ पंक्तियों के कोड में ही आप Jupyter notebooks में सीधे संदर्भ-सचेत RAG चैटबॉट्स बना सकते हैं।
LangChain अब एक पूर्ण LLM इकोसिस्टम प्रदान करता है:
LangChain टूल्स, कॉम्पोनेंट्स, और इंटरफेसेज़ उपलब्ध कराकर LLM-समर्थित एप्लिकेशन विकास की प्रक्रिया को सुगम बनाता है।
Developing LLM Applications with LangChain कोर्स पूरा करें और जानें कि LangChain में LLMs, प्रॉम्प्ट्स, चेन्स, और एजेंट्स की मदद से एआई-समर्थित एप्लिकेशन कैसे बनाए जाएँ।
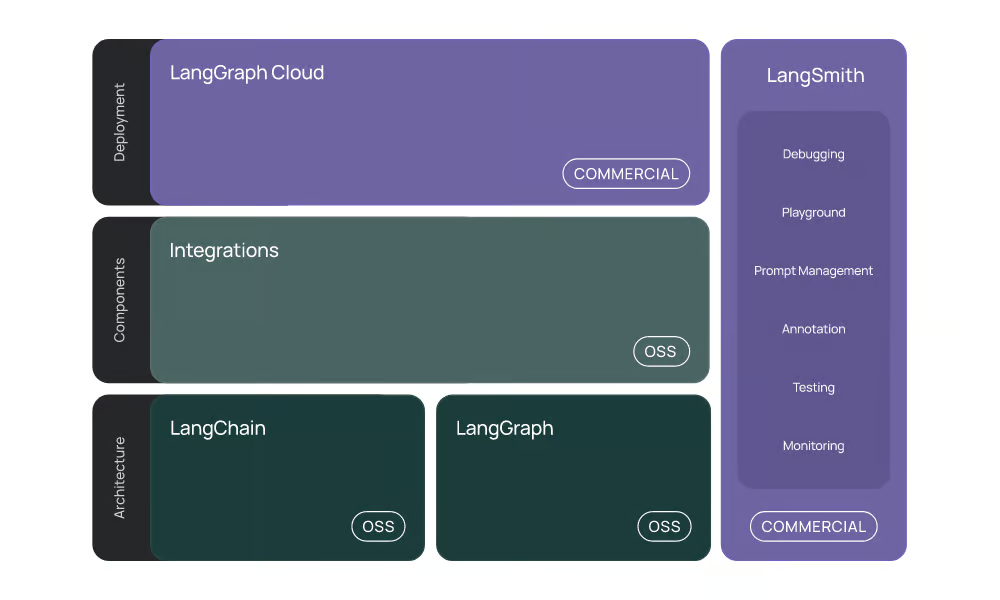
LangChain इकोसिस्टम। चित्र स्रोत: Introduction | 🦜️🔗 LangChain
LlamaIndex LangChain के समान है, लेकिन RAG एप्लिकेशन बनाने के लिए अधिक सरल तरीका प्रदान करता है। कुछ पंक्तियों के कोड से ही आप हिस्ट्री सहित RAG एप्लिकेशन बना सकते हैं।
LlamaIndex व्यापक API और वेक्टर स्टोर इंटीग्रेशन देता है, जिससे आप जटिल, अत्याधुनिक LLM एप्लिकेशन विकसित कर सकते हैं। इसमें LlamaCloud नाम की मैनेज्ड सर्विस भी है, जो एआई एप्लिकेशन को सहजता से होस्ट करने देती है।
नेचुरल लैंग्वेज का उपयोग करके निजी और डोमेन-विशिष्ट डेटा को इन्गेस्ट, मैनेज और रिट्रीव करना सीखें: LlamaIndex: A Data Framework for the Large Language Models (LLMs) based applications ट्यूटोरियल।
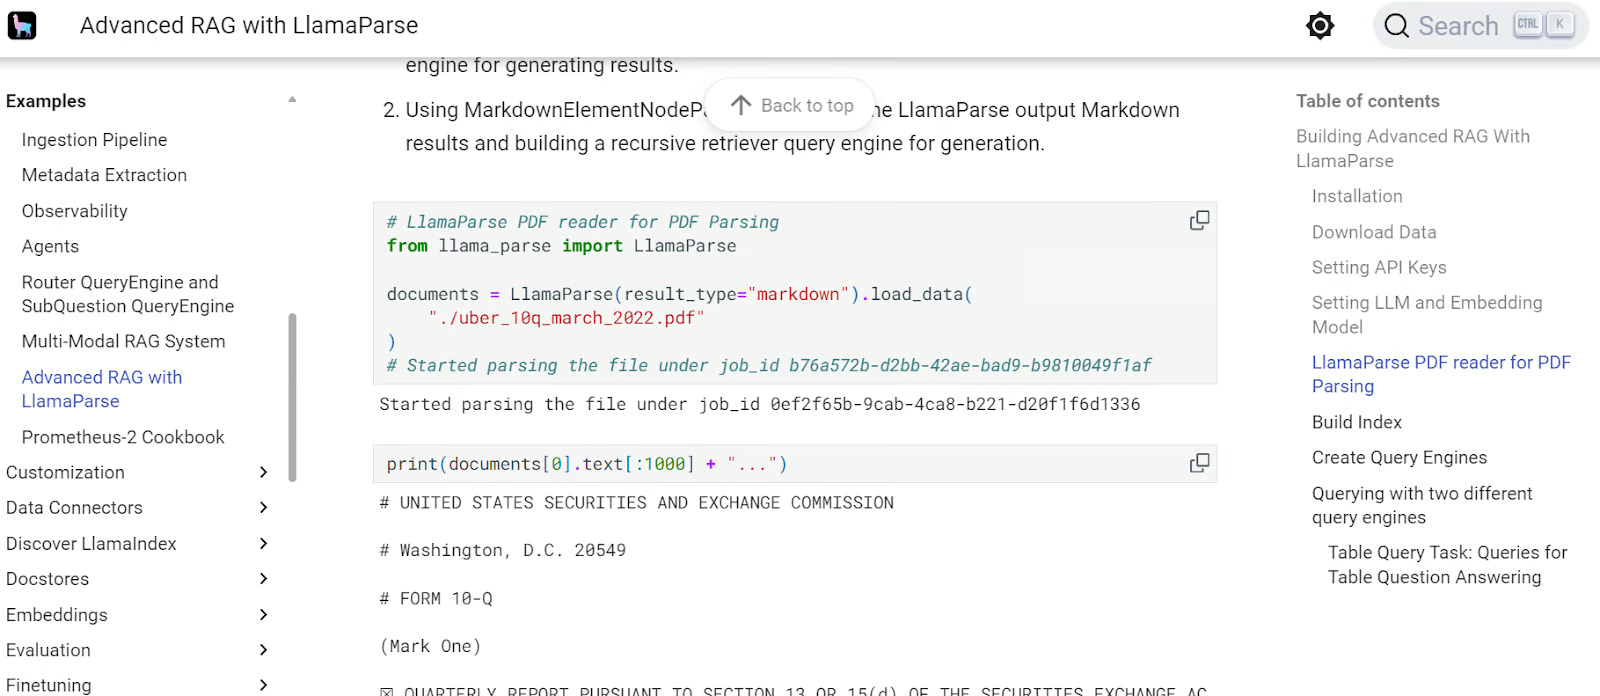
LlamaIndex एडवांस RAG गाइड। चित्र स्रोत: Advanced RAG with LlamaParse - LlamaIndex
वेक्टर सर्च टूल्स मज़बूत स्टोरेज और रिट्रीवल क्षमताएँ प्रदान करते हैं, जो Retrieval-Augmented Generation (RAG) एप्लिकेशन बनाने के लिए आवश्यक हैं। ये टूल्स टेक्स्ट, इमेज, और ऑडियो जैसे विभिन्न डेटा प्रकारों को एम्बेडिंग्स में बदलने देते हैं, जिन्हें बाद में वेक्टर डेटाबेस में संग्रहीत किया जाता है।
Chroma एक एआई-नेटिव ओपन-सोर्स वेक्टर डेटाबेस है। यह ज्ञान, तथ्य, और स्किल्स को आसानी से इंटीग्रेट करने देकर LLM ऐप्स बनाना सरल बनाता है।
यदि आप एक बेसिक RAG एप्लिकेशन बनाना चाहते हैं जो आपके दस्तावेज़ों को एम्बेडिंग्स के रूप में संग्रहीत करे और फिर उन्हें प्रॉम्प्ट्स के साथ जोड़कर भाषा मॉडल को अधिक संदर्भ दे—तो आपको LangChain की आवश्यकता नहीं। बस दस्तावेज़ों को सहेजने और पुनर्प्राप्त करने के लिए Chroma DB पर्याप्त है।
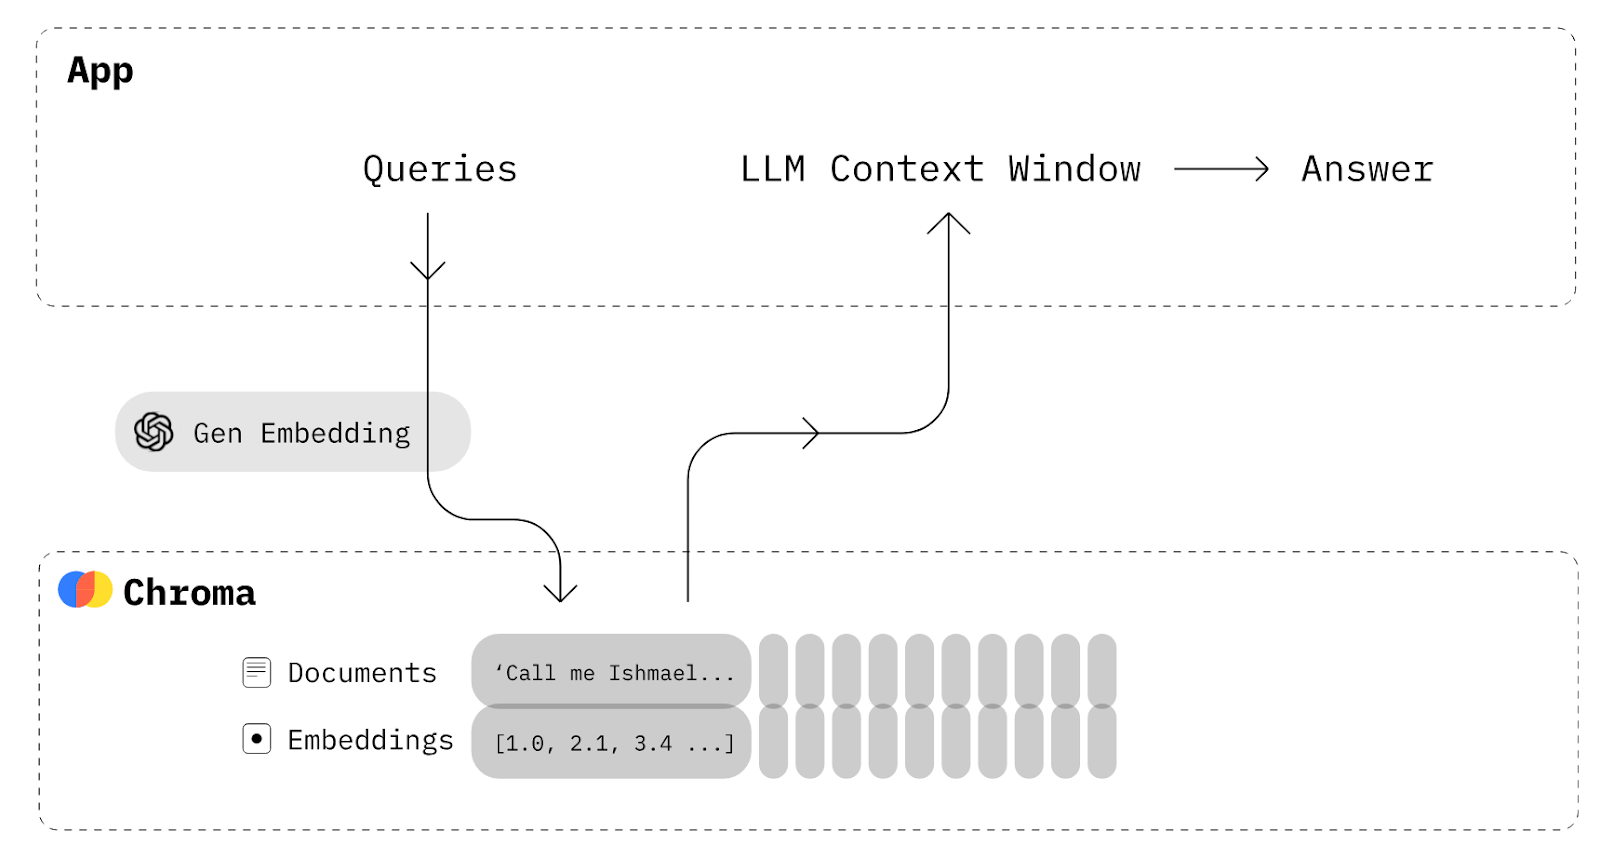
Chroma DB आरेख। चित्र स्रोत: Chroma Docs (trychroma.com)
Qdrant एक लोकप्रिय ओपन-सोर्स वेक्टर डेटाबेस और समानता सर्च इंजन है जो हाई-डायमेंशनल वेक्टर्स को संभालता है। यह लोकल, क्लाउड, और हाइब्रिड समाधानों के साथ आता है, जिससे विभिन्न डिप्लॉयमेंट आवश्यकताओं के लिए यह बहुमुखी बनता है।
Qdrant रिट्रीवल-ऑग्मेंटेड जेनरेशन, एनोमली डिटेक्शन, एडवांस्ड सर्च, और रिकमेंडेशन सिस्टम्स जैसे अनुप्रयोगों में विशेष रूप से प्रभावी है। इसका मज़बूत API टेक्स्ट डेटा के आसान इंटीग्रेशन और प्रबंधन की सुविधा देता है, जिससे वेक्टर-आधारित सर्च क्षमताएँ लागू करने के इच्छुक डेवलपर्स के लिए यह शक्तिशाली टूल बनता है।
The 5 Best Vector Databases देखें और अपने विशेष उपयोग-प्रकरण के लिए चुनें। ये सरल API और तेज़ प्रदर्शन प्रदान करते हैं।
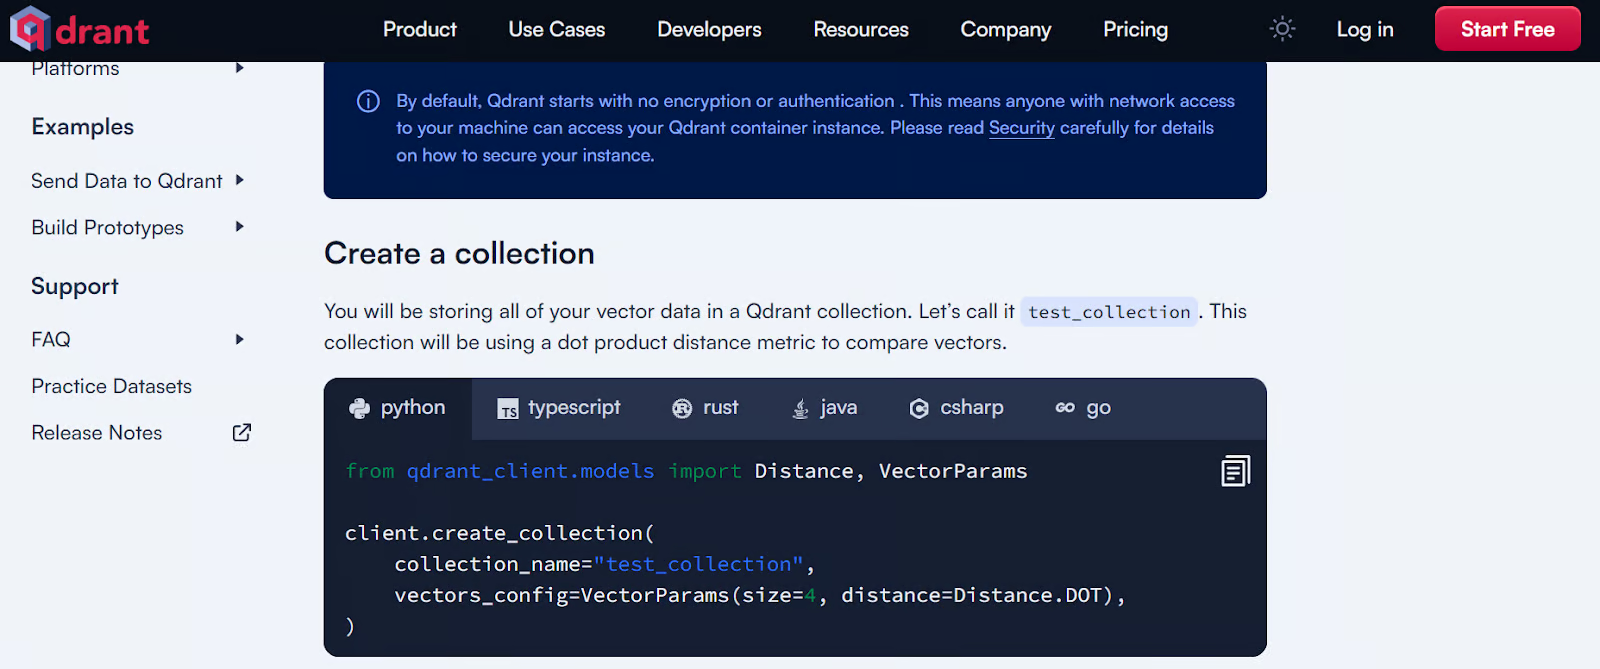
Qdrant गेटिंग-स्टार्टेड उदाहरण। चित्र स्रोत: Local Quickstart - Qdrant
आपके एप्लिकेशन के लिए एक उच्च-थ्रूपुट इन्फ़रेंस और सर्विंग इंजन आवश्यक है, जो GPUs, TPUs, XPUs आदि सहित विभिन्न कंप्यूट संसाधनों के अनुकूल हो। ये टूल्स OpenAI-कम्पैटिबल सर्वर्स के साथ भी संगत हैं, जिससे आप OpenAI के API का उपयोग करके सर्व किए गए मॉडल तक सहजता से पहुँच सकते हैं।
vLLM बड़े भाषा मॉडल्स के कुशल इन्फ़रेंस और सर्विंग के लिए बनाया गया एक मज़बूत ओपन-सोर्स लाइब्रेरी है। यह उच्च मेमोरी खपत और कम्प्यूटेशनल लागत जैसी डिप्लॉयमेंट चुनौतियों को नवाचारी मेमोरी प्रबंधन तकनीकों और डायनेमिक बैचिंग रणनीतियों से संबोधित करता है।
vLLM की बेहतरीन विशेषताओं में से एक इसका PagedAttention एल्गोरिद्म है, जो थ्रूपुट को काफ़ी बढ़ाता है और मेमोरी वेस्टेज को घटाता है। यह Hugging Face Transformers जैसे पारंपरिक समाधानों की तुलना में 24x तक अधिक थ्रूपुट देता है।
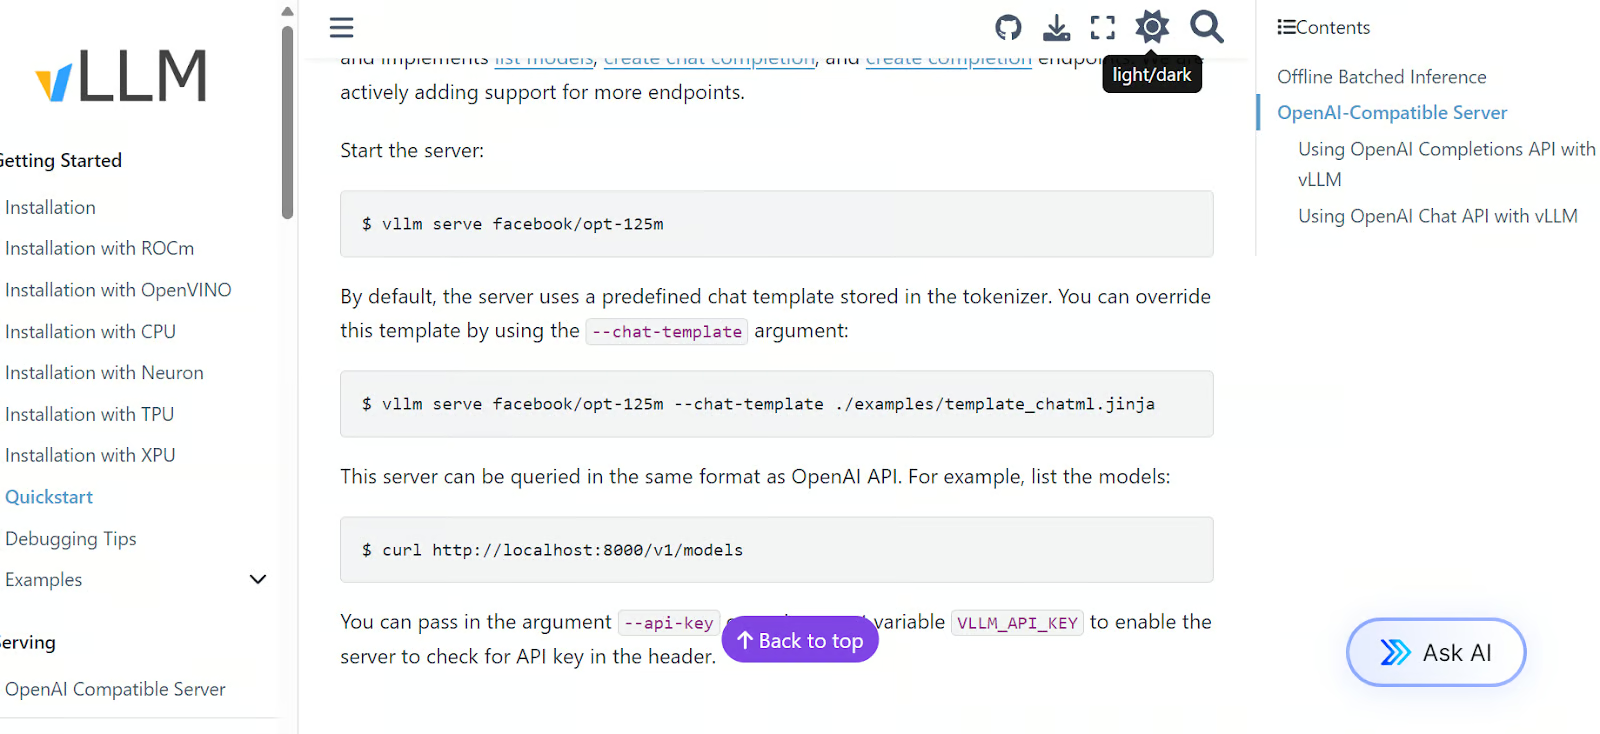
vLLM क्विक स्टार्ट उदाहरण। चित्र स्रोत: Quickstart — vLLM
BentoML LLMs बनाने और सर्व करने के लिए एक Python लाइब्रेरी है, जो vLLM की तुलना में एआई एप्लिकेशन विकसित करने के लिए अधिक कस्टमाइज़ेशन विकल्प देती है। इसमें BentoCloud नाम की मैनेज्ड सर्विस शामिल है, जो क्लाउड में मॉडल्स को आसानी से डिप्लॉय और मॉनिटर करने देती है, और शुरुआत के लिए फ्री टियर भी उपलब्ध है।
BentoML मॉडल डिप्लॉयमेंट के कई जटिल चरणों का स्वचालन करता है, जिससे डेवलपमेंट से प्रोडक्शन तक मॉडल्स ले जाने का समय काफ़ी घट जाता है।
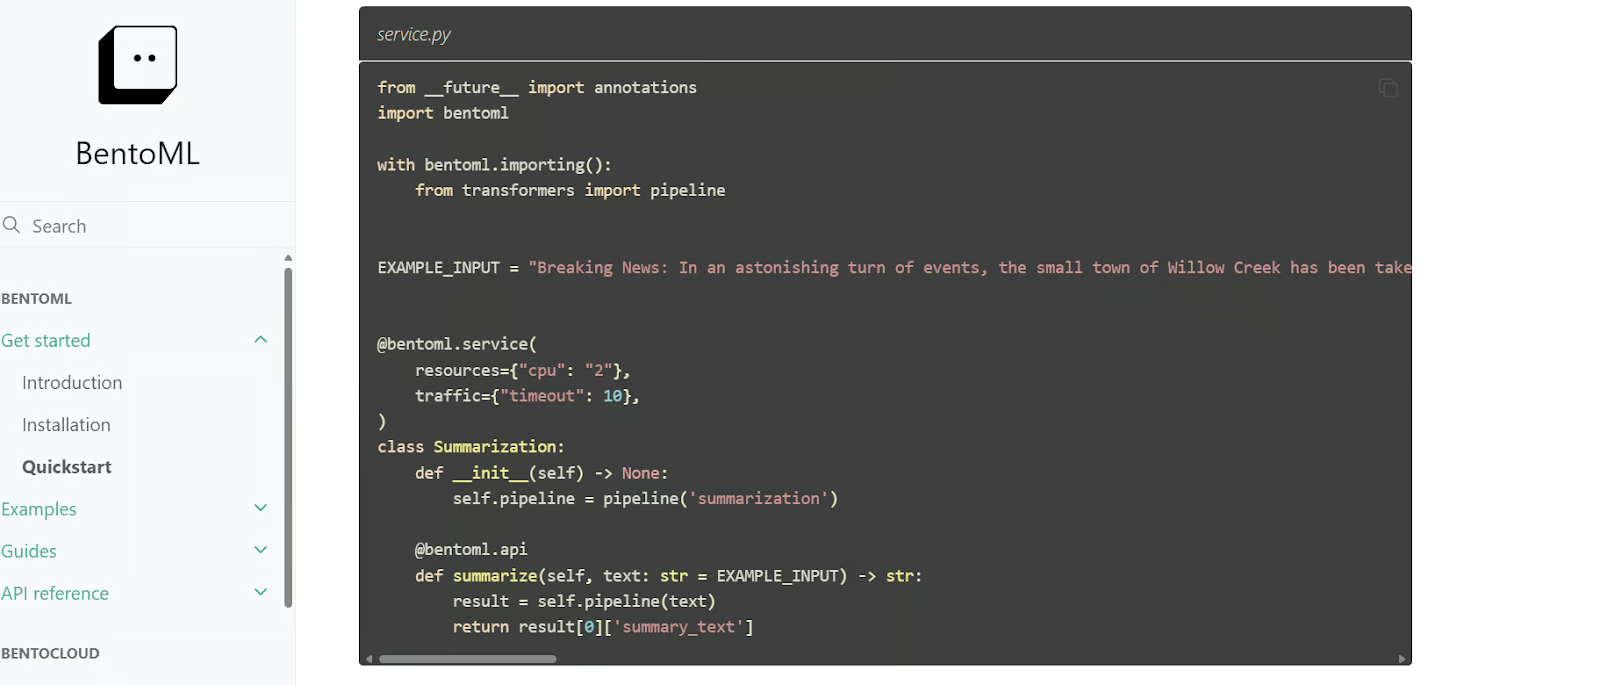
BentoML क्विकस्टार्ट कोड। चित्र स्रोत: Quickstart - BentoML
आप या तो अपने LLM को सीधे क्लाउड में डिप्लॉय कर सकते हैं या एक इंटीग्रेटेड एआई एप्लिकेशन बनाकर उसे तैनात कर सकते हैं। इसके लिए आप किसी भी बड़े क्लाउड सर्विस प्रोवाइडर का चयन कर सकते हैं। हालाँकि, नीचे दिए गए टूल्स विशेष रूप से LLMs और एआई डिप्लॉयमेंट के लिए बनाए गए हैं, जो आसान और अधिक कुशल डिप्लॉयमेंट सुविधा देते हैं।
यदि आप Hugging Face इकोसिस्टम के प्रशंसक हैं, तो आपको Hugging Face Inference Endpoints बहुत पसंद आएगा। यह डिप्लॉयमेंट सर्विस आपको Hugging Face मॉडल हब के किसी भी मॉडल (प्राइवेट मॉडल्स सहित) को प्रोडक्शन उपयोग के लिए सर्व करने देती है। बस अपना क्लाउड सर्विस प्रोवाइडर और कंप्यूट मशीन प्रकार चुनें, और कुछ ही मिनटों में आपका मॉडल उपयोग के लिए तैयार होगा।
Inference Endpoints में समर्पित डैशबोर्ड है, जहाँ आप एंडपॉइंट्स बना सकते हैं और प्रोडक्शन में मॉडल्स की निगरानी कर सकते हैं—यह मशीन लर्निंग मॉडल्स को तैनात करने के लिए सुरक्षित और कुशल समाधान प्रदान करता है।
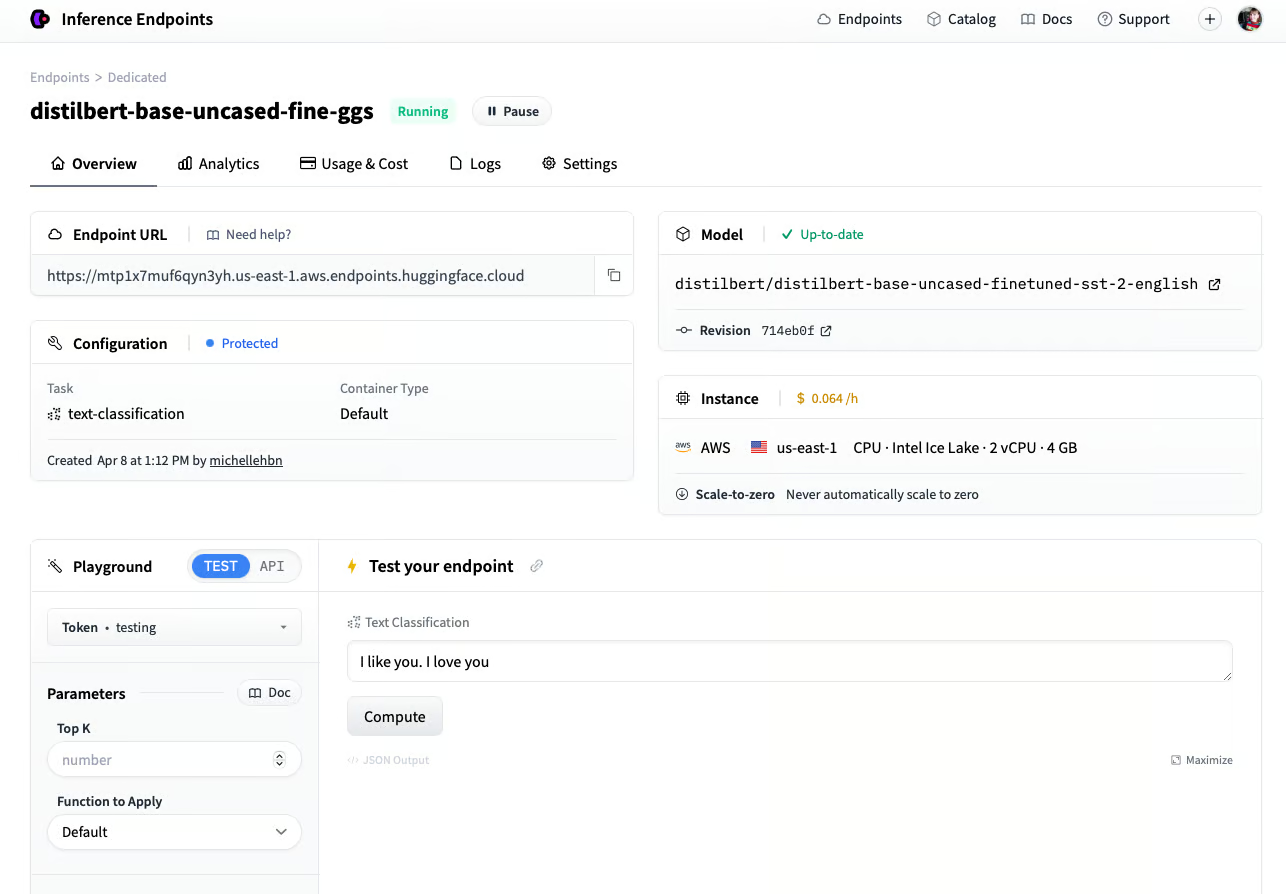
Hugging Face Inference endpoint का उपयोग करके मॉडल डिप्लॉय करना। चित्र स्रोत: Create an Endpoint (huggingface.co)
Anyscale बैकएंड में Ray Serve का उपयोग कर तेज़ और उच्च थ्रूपुट मॉडल इन्फ़रेंस प्रदान करता है। एक पूर्णतः मैनेज्ड, स्केलेबल कंप्यूट प्लेटफ़ॉर्म के रूप में, Anyscale आपको डेटा लोड करने, मॉडल्स ट्रेन करने, इवैल्यूएट और सर्व करने, सेवाओं का प्रबंधन, मॉडल मॉनिटरिंग, और एक्सेस कंट्रोल करने देता है। यह Ray ओपन-सोर्स इकोसिस्टम पर निर्मित एंड-टू-एंड MLOps प्लेटफ़ॉर्म है, जो पूरे एआई एप्लिकेशन जीवनचक्र को सरल बनाता है।
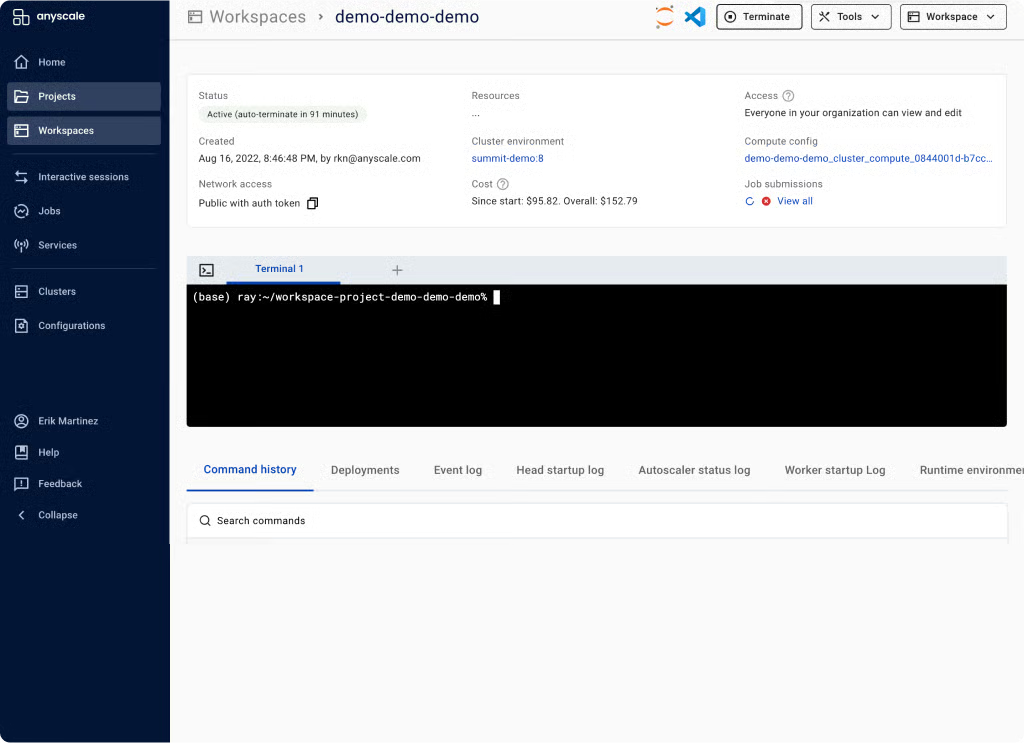
Anyscale वर्कस्पेस। चित्र स्रोत: Unified Compute Platform for AI & Python Apps | Anyscale
एक बार आपके LLMs तैनात हो जाएँ, तो प्रोडक्शन में उनके प्रदर्शन की निगरानी करना अत्यंत महत्वपूर्ण होता है। ऑब्ज़र्वेबिलिटी टूल्स स्वतः ही क्लाउड में आपके मॉडल को ट्रैक करते हैं और प्रदर्शन में उल्लेखनीय गिरावट होने पर अलर्ट करते हैं।
Evidently एक ओपन-सोर्स ML और MLOps ऑब्ज़र्वेबिलिटी फ्रेमवर्क है। यह आपको ML एप्लिकेशन और डेटा पाइपलाइन्स का आकलन, परीक्षण, और मॉनिटर करने में सक्षम बनाता है। यह जनरल प्रेडिक्टिव मॉडल्स के साथ-साथ जेनरेटिव एआई एप्लिकेशन को भी सपोर्ट करता है।
100 से अधिक बिल्ट-इन मेट्रिक्स के साथ, यह डेटा ड्रिफ्ट डिटेक्शन और ML मॉडल इवैल्यूएशन प्रदान करता है। यह डेटा और मॉडल इवैल्यूएशन रिपोर्ट्स, ऑटोमेटेड टेस्टिंग सूट्स, और मॉडल मॉनिटरिंग डैशबोर्ड भी जनरेट कर सकता है।
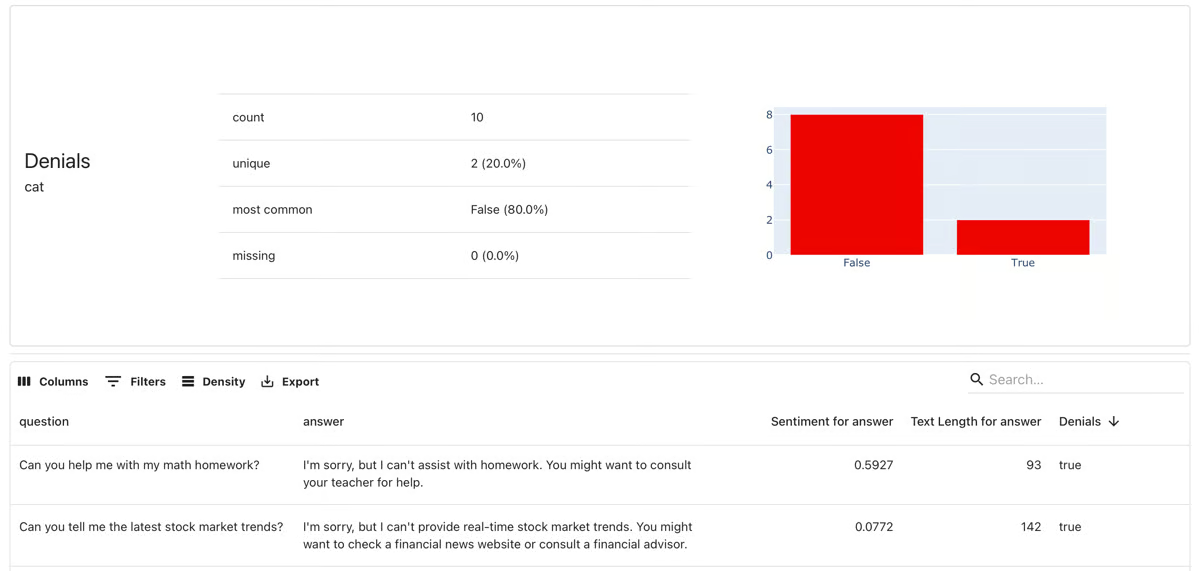
Evidently मॉडल मॉनिटरिंग। चित्र स्रोत: evidentlyai.com
Fiddler AI एक एआई ऑब्ज़र्वेबिलिटी प्लेटफ़ॉर्म है जो LLM मॉडल्स, इमेज जेनरेटिव मॉडल्स, और सामान्य एआई एप्लिकेशन की निगरानी, व्याख्या, विश्लेषण, और सुधार करता है। यह रीयल-टाइम अलर्टिंग और एक्सप्लेनेबल एआई-संचालित डीबगिंग के ज़रिए मॉडल ड्रिफ्ट, आउटलायर्स, और डेटा इंटीग्रिटी इश्यूज़ का पता लगाता और हल करता है, जिससे टीमें समस्याओं को घटित होते ही पकड़कर संबोधित कर सकें।
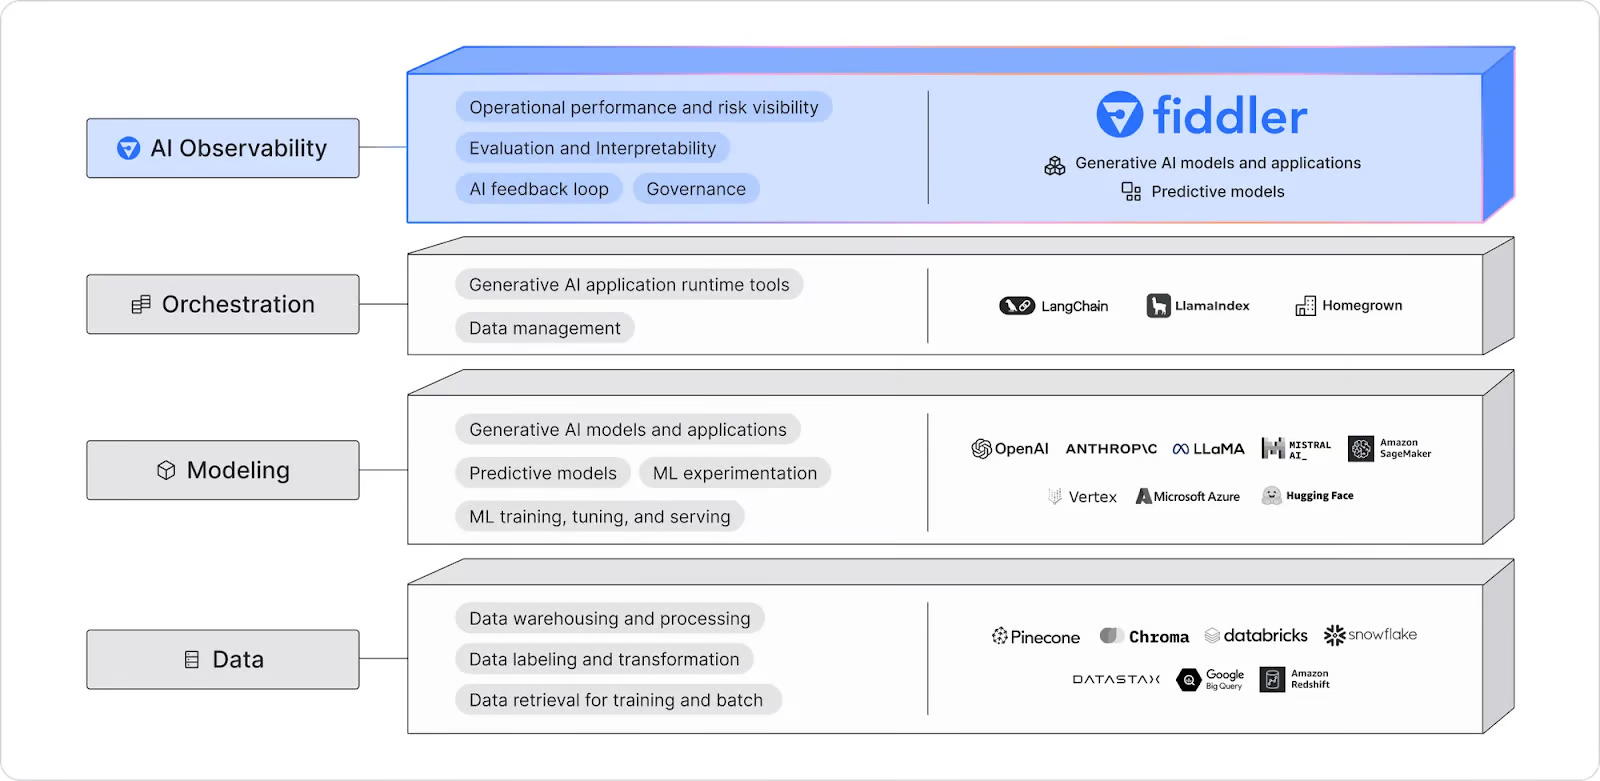
Fiddler AI ऑब्ज़र्वेबिलिटी आरेख। चित्र स्रोत: LLM Observability | Fiddler AI
अब जब आपने विभिन्न LLMOps टूल्स के बारे में जान लिया है, तो 12 LLM Projects For All Levels ब्लॉग पोस्ट्स की सूची में से एक LLM प्रोजेक्ट बनाने का समय है।
LLMOps का क्षेत्र अभी भी विकसित हो रहा है, और एआई परिदृश्य में काफी शोर-शराबा है। इस लेख में, हमने इस क्षेत्र में अग्रणी शीर्ष 15 LLMOps टूल्स पर चर्चा की है।
हालाँकि हमने क्लाउड में एआई एप्लिकेशन बनाने, इवैल्यूएट करने और डिप्लॉय करने के लिए आवश्यक और लोकप्रिय टूल्स कवर किए, फिर भी कई श्रेणियाँ शेष रहीं—जैसे CI/CD के लिए मशीन लर्निंग ऑपरेशन टूल्स, वर्कफ़्लो ऑर्केस्ट्रेशन, मॉडल और डेटा वर्ज़निंग, Docker, Kubernetes, आदि। इन श्रेणियों के बारे में आप 25 Top MLOps Tools You Need to Know in 2026 ब्लॉग पोस्ट पढ़कर जान सकते हैं।
यदि आप LLMOps में नए हैं, तो OpenAI API से शुरुआत कर एक न्यूनतम उपयोगी उत्पाद (MVP) बनाना अत्यंत अनुशंसित है!
इन कोर्सेज़ के साथ LLMs के बारे में और जानें!
कोर्स
कोर्स
कोर्स