
Cursus
LLMOps-concepten
1 uur
19.5K
Afbeelding door de auteur
We zijn voorbij het punt van alleen grote taalmodellen (LLM's) verbeteren en richten ons nu op het inzetten ervan om AI-toepassingen te bouwen die bedrijven vooruithelpen. Hier komen LLMOps-tools (large language model operations) om de hoek kijken: ze vereenvoudigen het bouwen van volledig geautomatiseerde systemen voor het ontwikkelen en uitrollen van LLM-oplossingen naar productie.
In dit artikel bekijken we verschillende tools zoals LLM-API's, fine-tuningframeworks, tools voor experimenttracking, LLM-integratie-ecosystemen, vectorzoektools, frameworks voor model serving, deploymentplatforms en observabilitytools. Elke tool blinkt uit in z'n eigen domein en is ontworpen om specifieke LLM-gerelateerde problemen op te lossen.
LLMOps is een opkomend vakgebied dat zich richt op het operationeel beheer van grote taalmodellen in productieomgevingen. Het is in essentie MLOps (machine learning operations) gespecialiseerd voor taal- en andere multimodale modellen.
Volg de cursus Master Large Language Models (LLMs) Concepts om te leren over LLM-toepassingen, trainingsmethodologieën, ethische overwegingen en het nieuwste onderzoek.
LLMOps omvat de volledige levenscyclus van grote taalmodellen, waaronder dataverzameling, modeltraining of fine-tuning, testen en validatie, integratie, deployment, optimalisatie, monitoring en onderhoud, en samenwerking. Door projecten te structureren en processen te automatiseren, helpt LLMOps je fouten te verminderen en AI-toepassingen efficiënt op te schalen, zodat modellen robuust zijn en voldoen aan de eisen van de praktijk.
Kortom, LLMOps-tools helpen je een geautomatiseerd systeem te bouwen dat data verzamelt, het model daarop fine-tunet, de prestaties bijhoudt, het integreert met externe data, de AI-app maakt, die uitrolt naar de cloud en de modelmetrics en -prestaties in productie observeert.
De skill track Developing Large Language Models bestaat uit 4 cursussen die je een stevige basis geven in hoe LLM's werken en hoe je voorgetrainde LLM's kunt fine-tunen.
Laten we nu de belangrijkste LLMOps-tools van vandaag verkennen.
Benader taal- en embeddingmodellen via API-calls. Je hoeft het model niet zelf te deployen of de server te onderhouden; met alleen een API-sleutel kun je state-of-the-art modellen gebruiken.
OpenAI biedt API-toegang tot geavanceerde LLM-modellen zoals GPT-4o en o1. Deze modellen zijn te gebruiken via een Python-pakket of CURL-commando.
De API is een ideale oplossing voor startups zonder technisch team om modellen te fine-tunen of in productie te deployen. Je krijgt toegang tot taalmodellen, multimodale modellen, function calling, gestructureerde output en fine-tuningopties. Daarnaast kun je embeddingmodellen gebruiken om je eigen vectordatabank te creëren. Kort gezegd: het biedt een compleet, voordelig AI-ecosysteem.
Leer hoe je de OpenAI Python API gebruikt om toegang te krijgen tot state-of-the-art LLM's met de tutorial GPT-4o API Tutorial: Aan de slag met OpenAI's API.
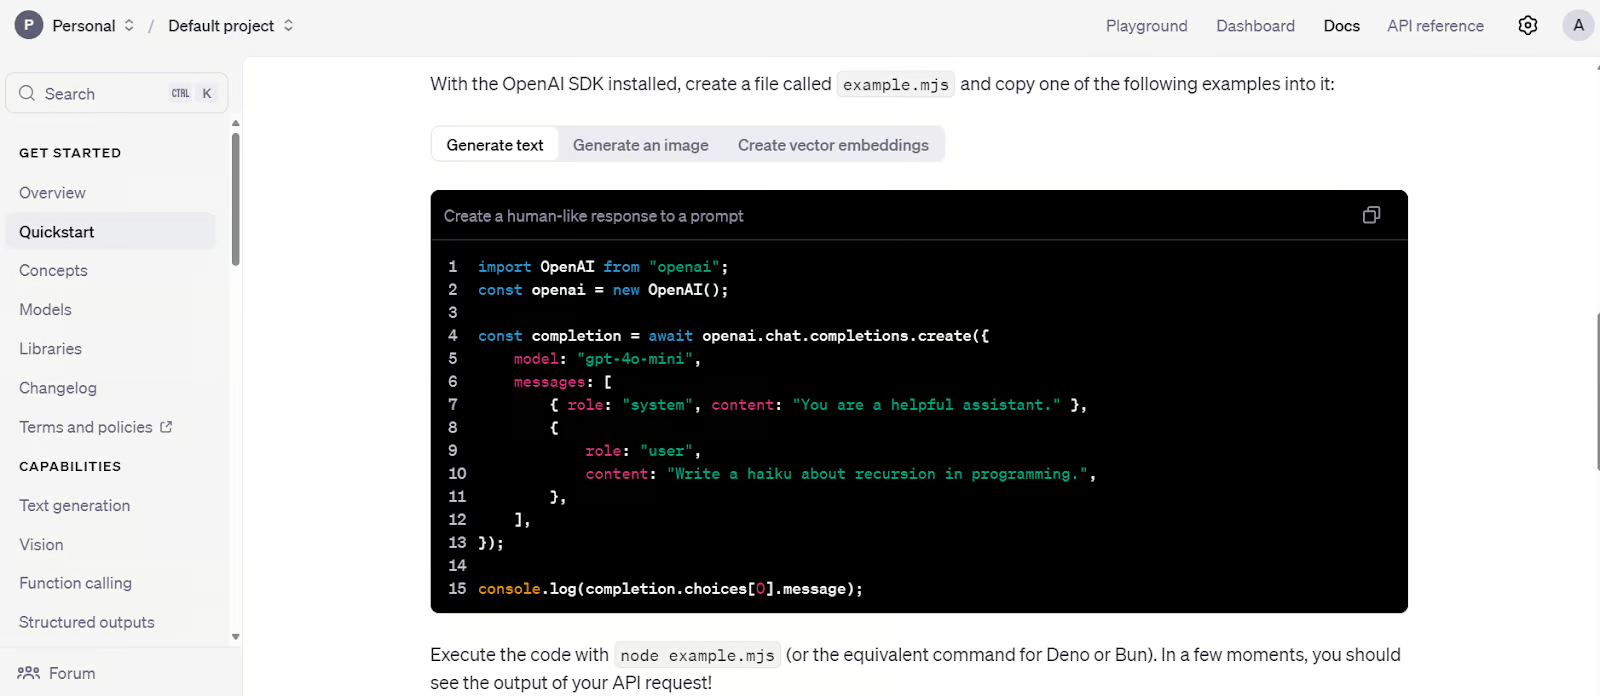
OpenAI API quickstart-code. Beeldbron: Quickstart-tutorial - OpenAI API
De Anthropic API lijkt op de OpenAI API en biedt toegang tot diverse taal- en embeddingmodellen. Met deze modellen kun je RAG-toepassingen maken, tools integreren, webpagina's ophalen, vision-modellen gebruiken en AI-agents ontwikkelen. Op termijn wil Anthropic alle tools bieden die nodig zijn om volledig functionele AI-toepassingen te bouwen en te deployen.
Net als de OpenAI API bevat het beveiligingen en evaluatietools om de modelprestaties te monitoren.
Leer hoe je de Claude API gebruikt om top-LLM's te benaderen met de tutorial Claude Sonnet 3.5 API Tutorial: Aan de slag met de API van Anthropic.
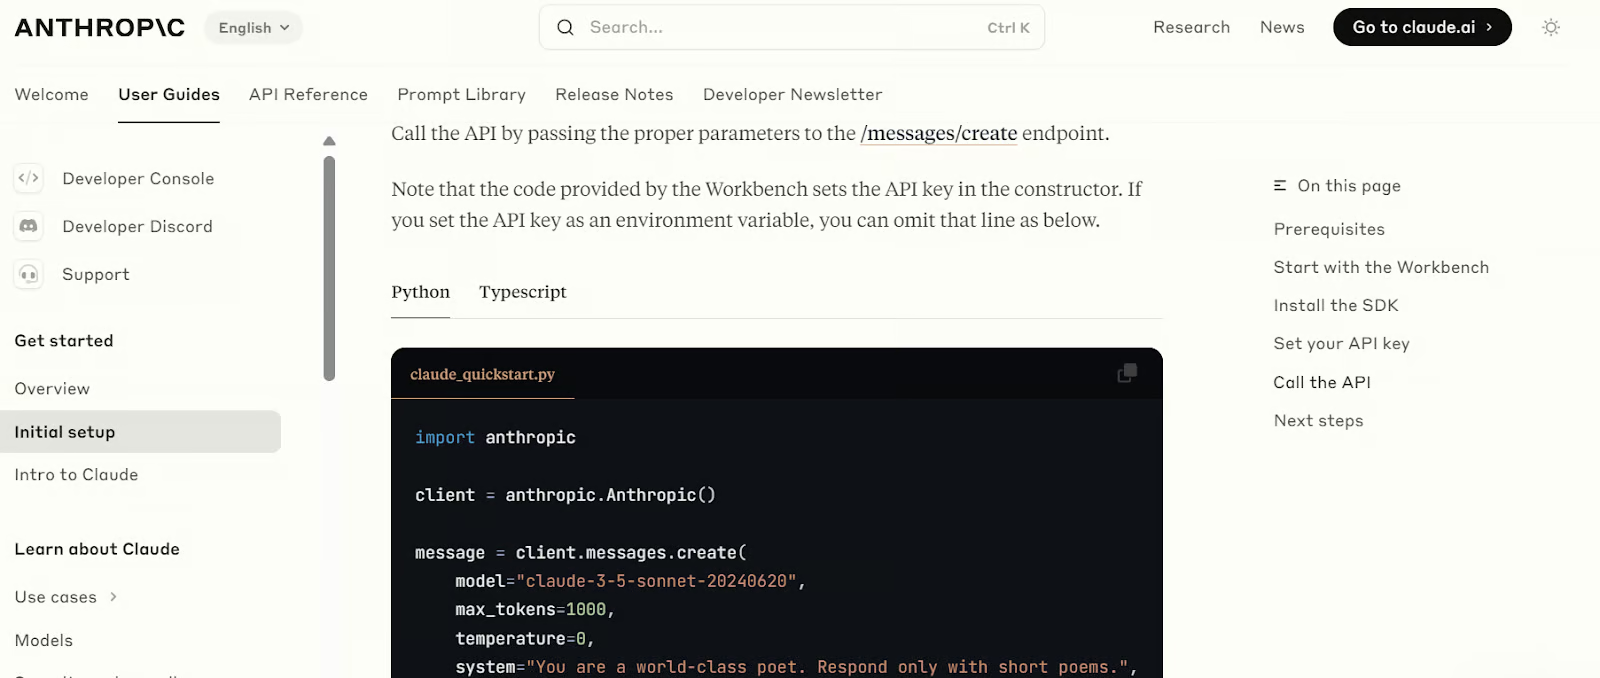
Anthropic API quickstart-code. Beeldbron: Initial setup - Anthropic
Gebruik Python om basis-LLM's te fine-tunen op een aangepaste dataset, zodat de stijl, taak en functionaliteit van het model aansluiten op specifieke eisen.
Transformers van Hugging Face is een bekend framework in de AI-community en -industrie. Het wordt veel gebruikt voor modeltoegang, het fine-tunen van LLM's met beperkte resources en het opslaan van modellen. Het biedt een volledig ecosysteem, van dataloading tot het evalueren van LLM's.
Met Transformers kun je datasets en modellen laden, data verwerken, modellen bouwen met aangepaste argumenten, modellen trainen en naar de cloud pushen. Later kun je deze modellen met slechts een paar kliks op een server deployen.
Volg de cursus Introduction to LLMs in Python om te leren over het LLM-landschap, de transformerarchitectuur, voorgetrainde LLM's en hoe je LLM's integreert om echte problemen op te lossen.
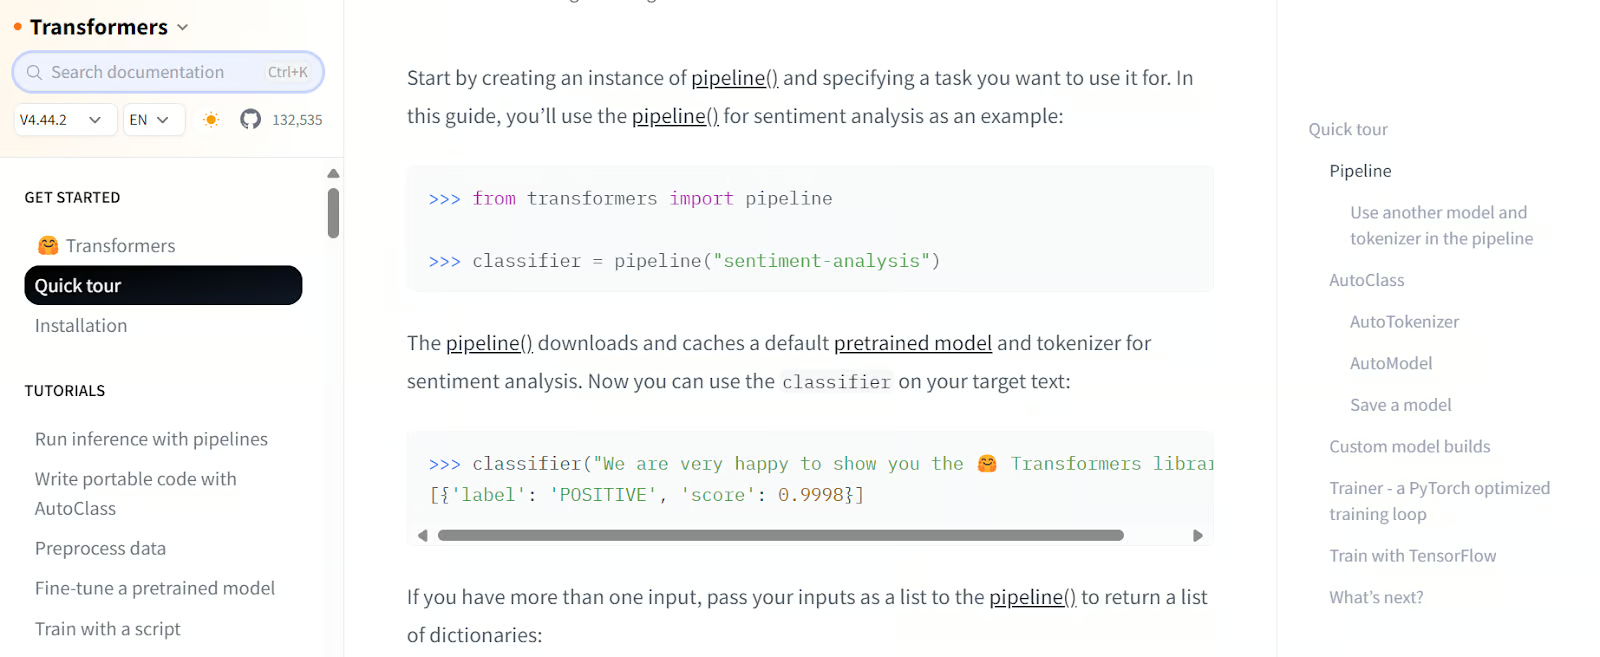
Transformers quickstart-code. Beeldbron: Quick tour (huggingface.co)
Unsloth AI is een Python-framework voor het fine-tunen en benaderen van grote taalmodellen. Het biedt een eenvoudige API en prestaties die 2x sneller zijn dan Transformers.
Bovenop de Transformers-bibliotheek integreert het extra tools om het fine-tunen van LLM's met beperkte resources te vereenvoudigen. Een opvallende feature van Unsloth is dat je met één regel code modellen kunt opslaan in vLLM- en GGUF-compatibel formaat, zodat je bibliotheken zoals llama.cpp niet hoeft te installeren en configureren: alles wordt automatisch afgehandeld.
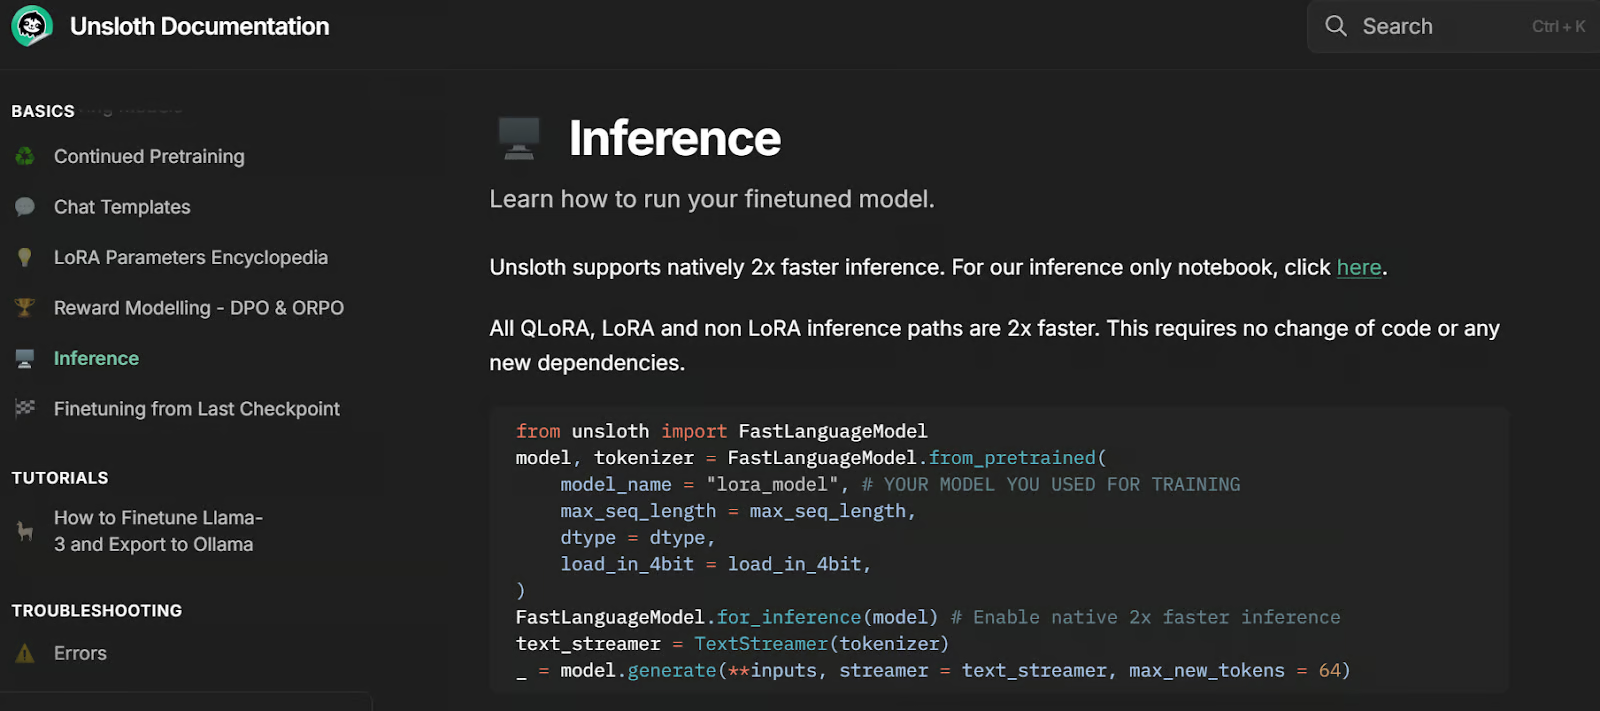
Unsloth inference-code. Beeldbron: Inference | Unsloth Documentation
Volg en evalueer de modelprestaties tijdens het trainen en vergelijk de resultaten.
Weights & Biases laat je modelprestaties tijdens en na het fine-tunen tracken om de effectiviteit te beoordelen. Het ondersteunt ook het tracken van RAG-toepassingen en het monitoren en debuggen van LLM's.
Het platform integreert naadloos met verschillende frameworks en tools, waaronder Transformers, LangChain, PyTorch en Keras. Een belangrijk voordeel van Weights & Biases is het sterk aanpasbare dashboard waarmee je modelevaluatierapporten kunt maken en verschillende modelversies kunt vergelijken.
Leer hoe je je machinelearning-experimenten structureert, logt en analyseert met Weights & Biases in de tutorial Machine Learning Experimentation: An Introduction to Weights & Biases.
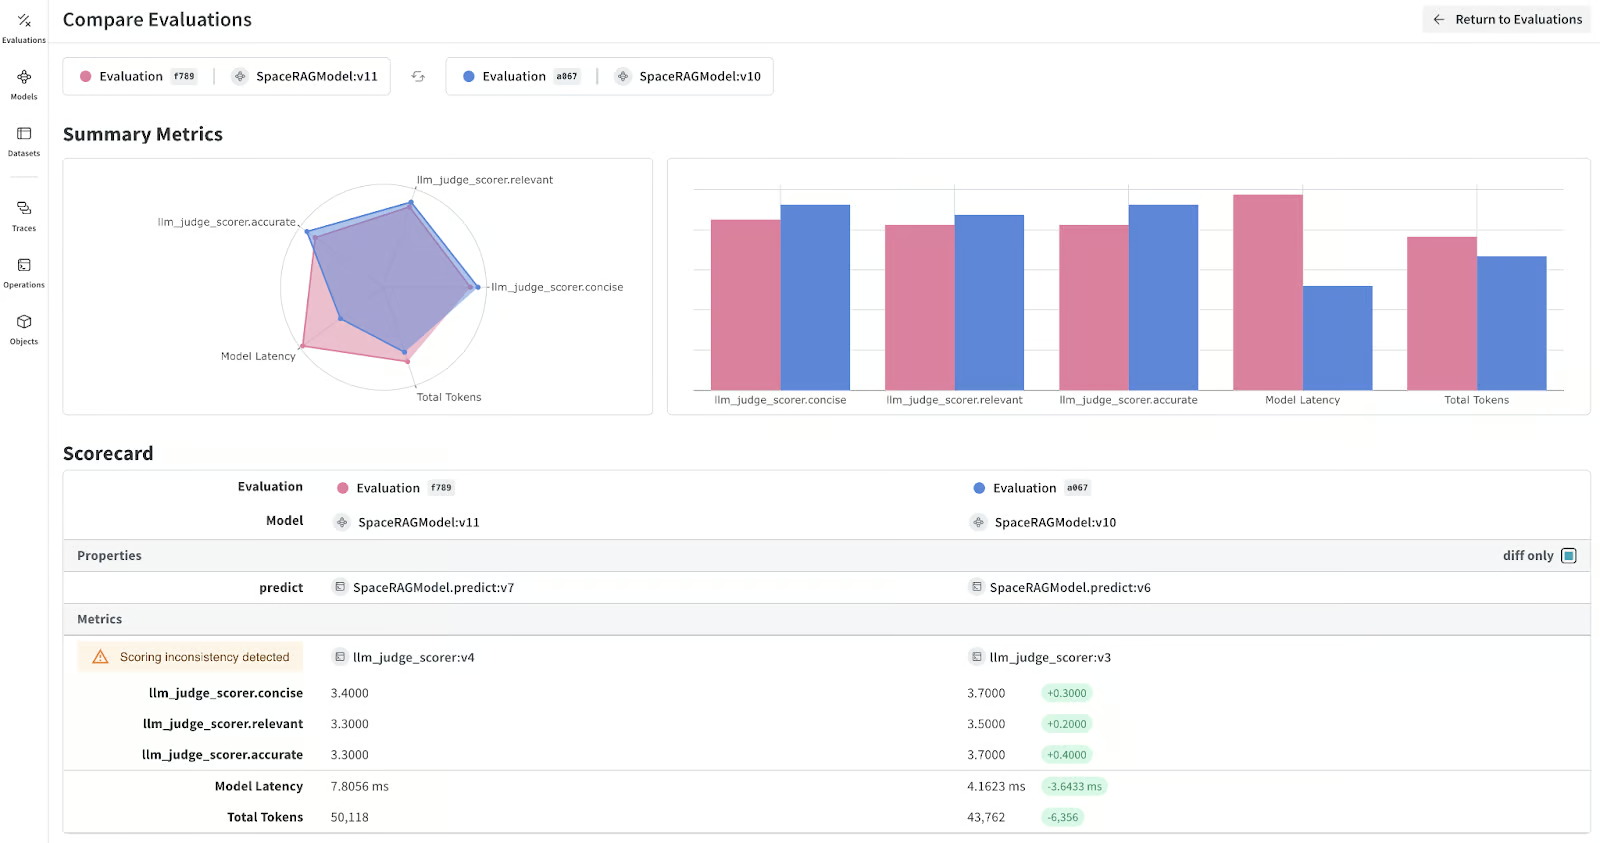
LLM-modelmetrics. Beeldbron: wandb.ai
Integreer LLM met een externe database, een private database en websearch. Je kunt met deze frameworks zelfs de volledige AI-toepassing bouwen en serven. Kortom, dit zijn sleuteltools voor het bouwen van complexe LLM-toepassingen die je in de cloud kunt deployen.
LangChain is een populaire tool voor het bouwen van AI-toepassingen met LLM's. Met slechts een paar regels code kun je contextbewuste RAG-chatbots ontwikkelen, direct in Jupyter-notebooks.
LangChain biedt inmiddels een compleet LLM-ecosysteem:
LangChain vereenvoudigt de ontwikkeling van LLM-gestuurde toepassingen met tools, componenten en interfaces die het proces stroomlijnen.
Rond de cursus Developing LLM Applications with LangChain af om te begrijpen hoe je AI-toepassingen bouwt met LLM's, prompts, chains en agents in LangChain.
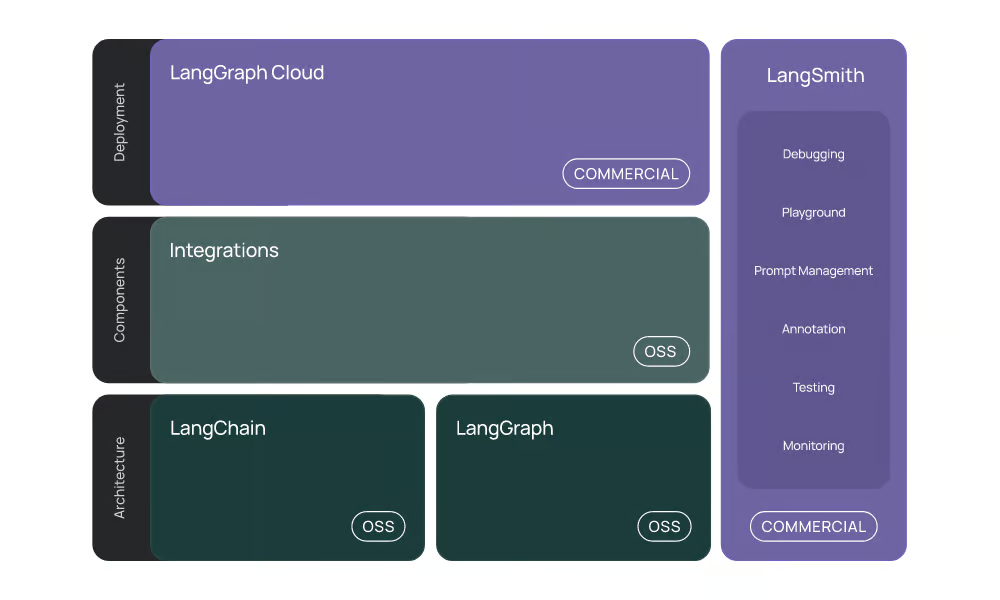
Het LangChain-ecosysteem. Beeldbron: Introduction | 🦜️🔗 LangChain
LlamaIndex lijkt op LangChain maar biedt een eenvoudigere aanpak voor het bouwen van RAG-toepassingen. Met enkele regels code kun je RAG-apps met geschiedenis maken.
LlamaIndex biedt uitgebreide API- en vectorstore-integraties, waarmee je complexe, state-of-the-art LLM-toepassingen kunt bouwen. Het heeft ook een managed service, LlamaCloud, voor het eenvoudig hosten van AI-toepassingen.
Leer hoe je private en domeinspecifieke data kunt inladen, beheren en ophalen via natuurlijke taal met de tutorial LlamaIndex: A Data Framework for the Large Language Models (LLMs) based applications.
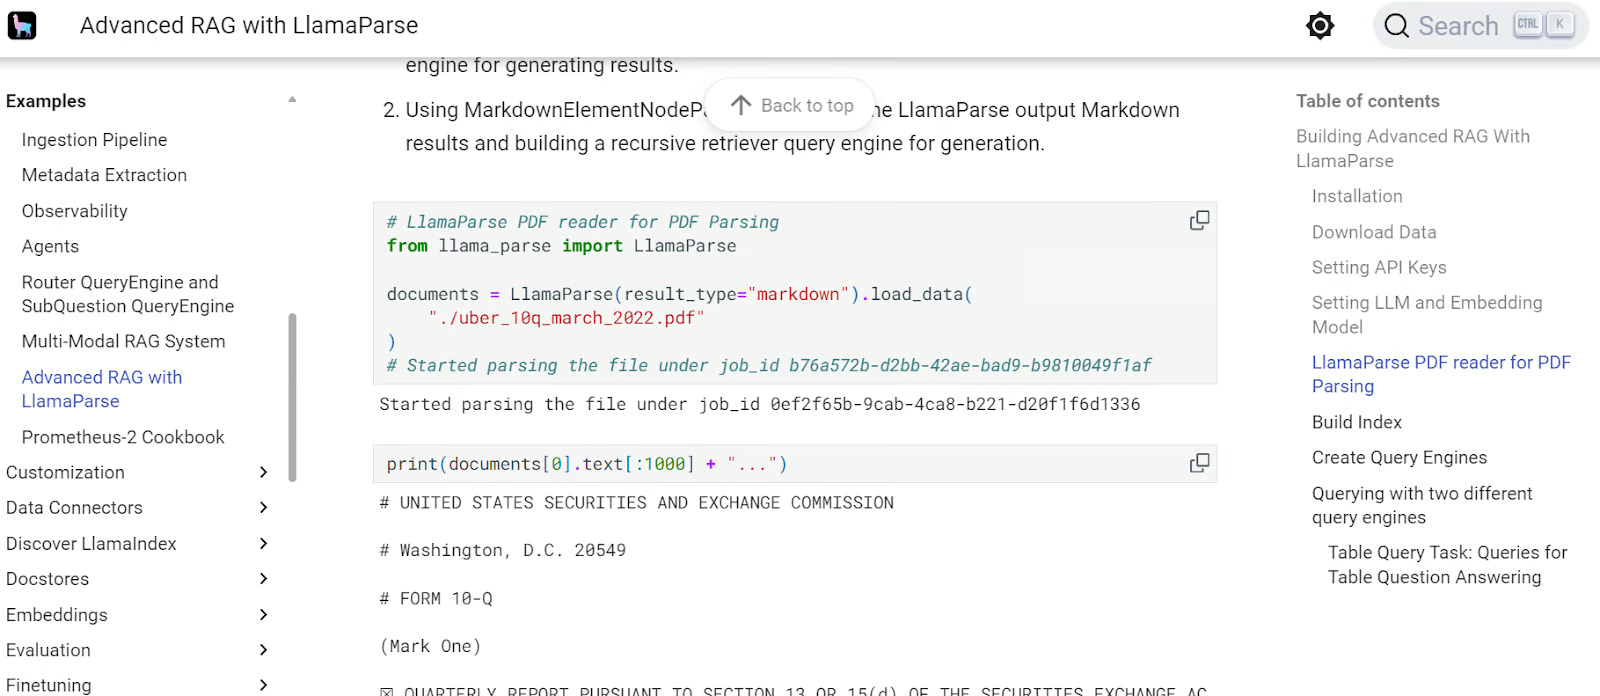
LlamaIndex advanced RAG-gids. Beeldbron: Advanced RAG with LlamaParse - LlamaIndex
Vectorzoektools bieden krachtige opslag- en ophaalmogelijkheden, cruciaal voor Retrieval-Augmented Generation (RAG)-toepassingen. Deze tools zetten verschillende datatypes, zoals tekst, afbeeldingen en audio, om in embeddings die vervolgens worden opgeslagen in vectordatabases.
Chroma is een AI-native open-source vectordatabank. Het maakt het eenvoudig om LLM-apps te bouwen door kennis, feiten en vaardigheden makkelijk te integreren.
Als je een eenvoudige RAG-toepassing wilt maken waarmee je documenten als embeddings opslaat en die vervolgens ophaalt om met prompts te combineren en zo meer context aan het taalmodel te geven, heb je geen LangChain nodig. Een Chroma DB volstaat om documenten op te slaan en op te halen.
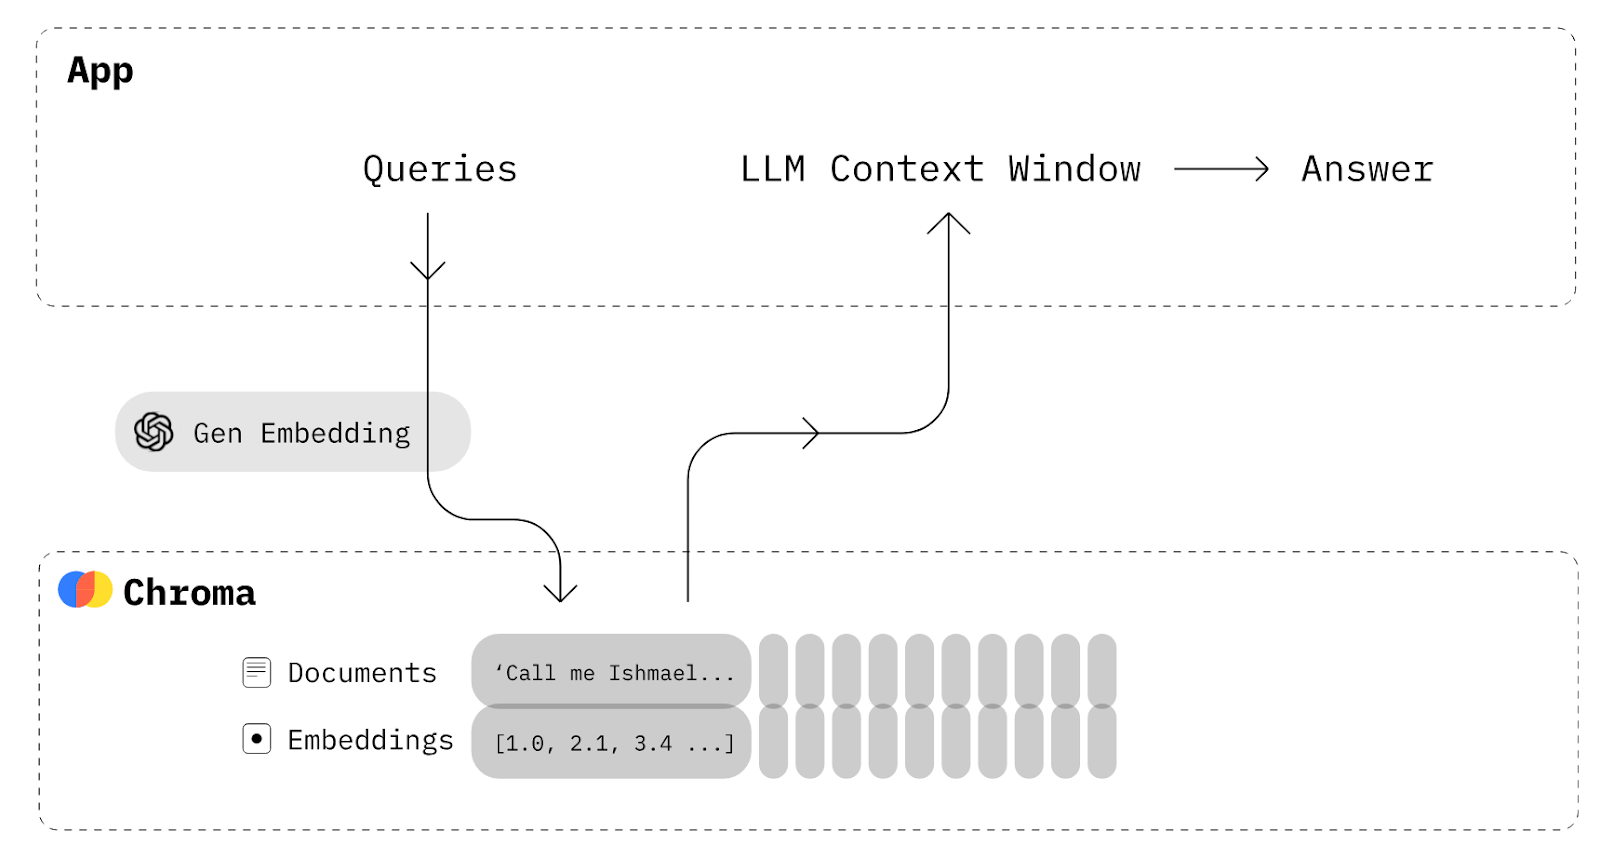
Chroma DB-diagram. Beeldbron: Chroma Docs (trychroma.com)
Qdrant is een populaire open-source vectordatabank en gelijkeniszoekmachine die hoge-dimensionale vectors aankan. Het biedt lokale, cloud- en hybride oplossingen en is daarmee veelzijdig voor uiteenlopende deploymentbehoeften.
Qdrant is bijzonder effectief voor toepassingen zoals retrieval-augmented generation, anomaliedetectie, geavanceerd zoeken en aanbevelingssystemen. De robuuste API maakt eenvoudige integratie en beheer van tekstdata mogelijk, waardoor het een krachtige tool is voor ontwikkelaars die vectorgebaseerd zoeken willen implementeren.
Bekijk The 5 Best Vector Databases voor jouw specifieke usecase. Ze bieden een eenvoudige API en snelle prestaties.
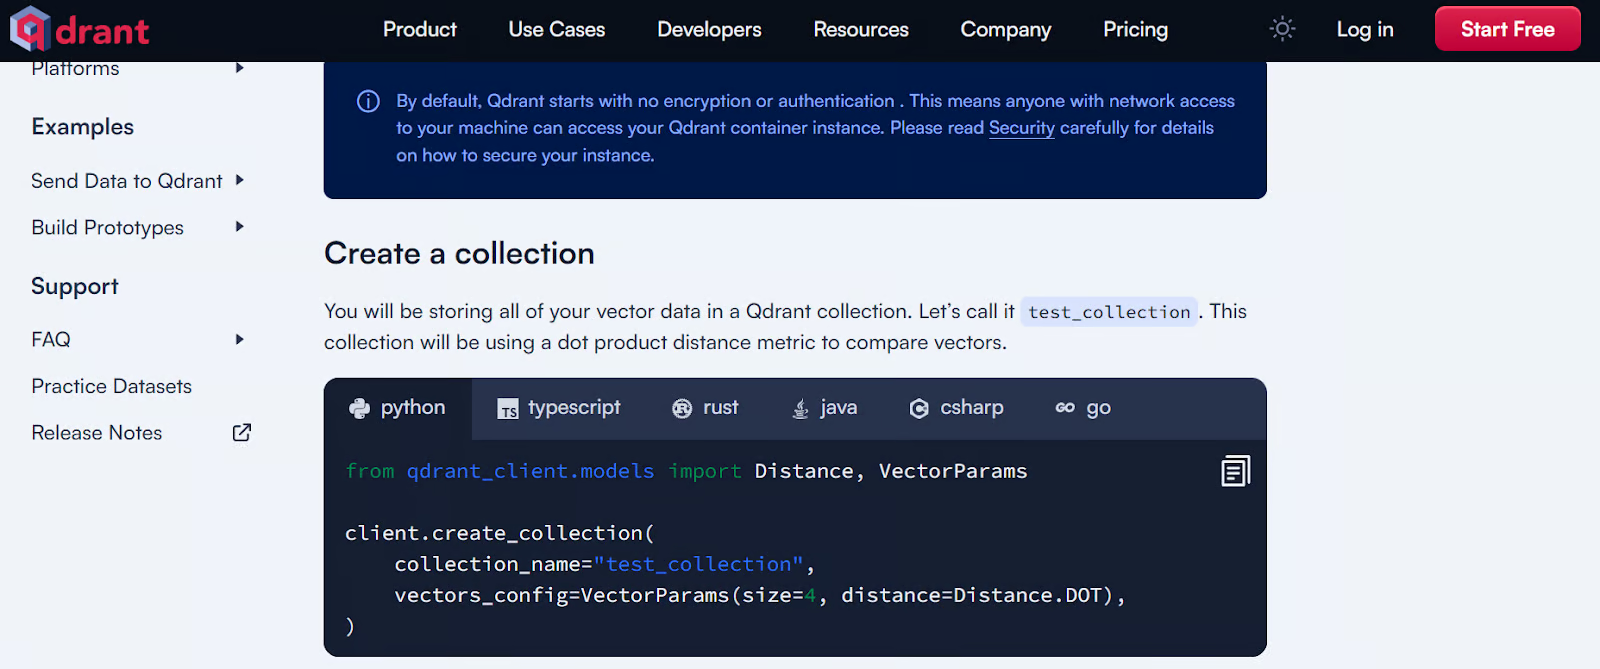
Qdrant-voorbeeld om te starten. Beeldbron: Local Quickstart - Qdrant
Een onmisbare component voor je toepassing is een inference- en servingengine met hoge doorvoer voor LLM's die compatibel is met uiteenlopende compute-resources, waaronder GPU's, TPU's, XPU's en meer. Deze tools zijn ook compatibel met OpenAI-compatibele servers, zodat je naadloos OpenAI's API kunt gebruiken om het geserveerde model aan te spreken.
vLLM is een robuuste open-source bibliotheek voor efficiënte inference en serving van grote taalmodellen. Het pakt uitdagingen bij het deployen van LLM's aan, zoals hoog geheugengebruik en rekenkosten, met innovatieve geheugentechnieken en dynamische batchingstrategieën.
Een van de beste features van vLLM is het PagedAttention-algoritme, dat de doorvoer aanzienlijk verhoogt en geheugenverspilling reduceert. Het levert tot 24x hogere doorvoer dan traditionele oplossingen zoals Hugging Face Transformers.
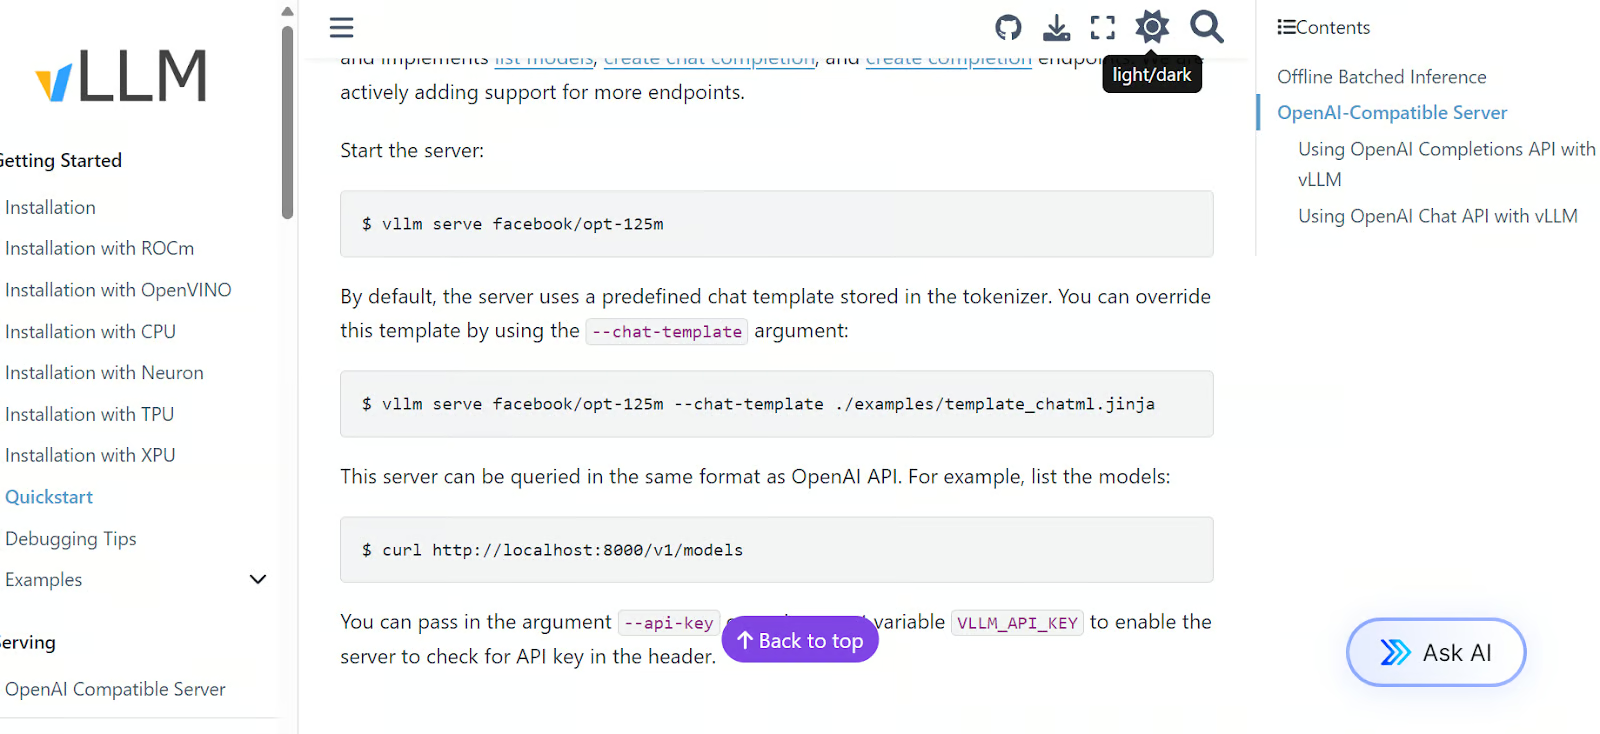
vLLM quickstart-voorbeeld. Beeldbron: Quickstart — vLLM
BentoML is een Python-bibliotheek voor het bouwen en serven van LLM's, met meer aanpassingsmogelijkheden voor het ontwikkelen van AI-toepassingen dan vLLM. Het bevat BentoCloud, een managed service waarmee je modellen eenvoudig in de cloud kunt deployen en monitoren, met een gratis laag om te starten.
BentoML automatiseert veel complexe stappen in modeldeployment en verkort zo de tijd om modellen van ontwikkeling naar productie te brengen aanzienlijk.
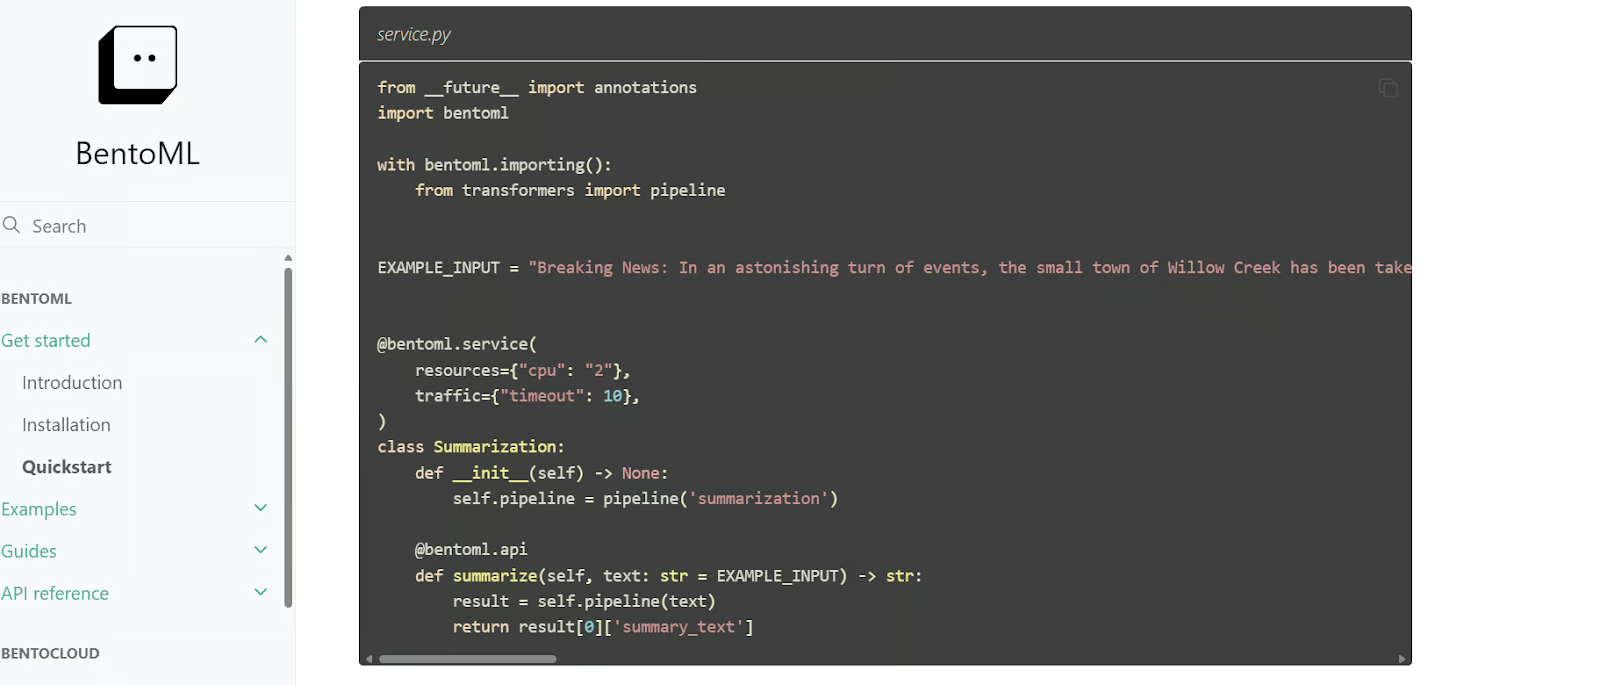
BentoML quickstart-code. Beeldbron: Quickstart - BentoML
Je kunt je LLM direct naar de cloud deployen of eerst een geïntegreerde AI-toepassing bouwen en die vervolgens deployen. Daarvoor kun je elke grote cloudprovider kiezen. De onderstaande tools zijn echter speciaal gebouwd voor LLM's en AI-deployment en bieden een eenvoudigere en efficiëntere deploymentervaring.
Als je fan bent van het Hugging Face-ecosysteem, zul je Hugging Face Inference Endpoints waarderen. Met deze deploymentservice kun je elk model van de Hugging Face model hub, inclusief private modellen, serven voor productiegebruik. Kies simpelweg je cloudprovider en het type rekenmachine, en binnen enkele minuten is je model klaar voor gebruik.
Inference Endpoints heeft een dedicated dashboard waarmee je endpoints kunt aanmaken en modellen in productie kunt monitoren, en biedt zo een veilige en efficiënte oplossing voor het deployen van machinelearningmodellen.
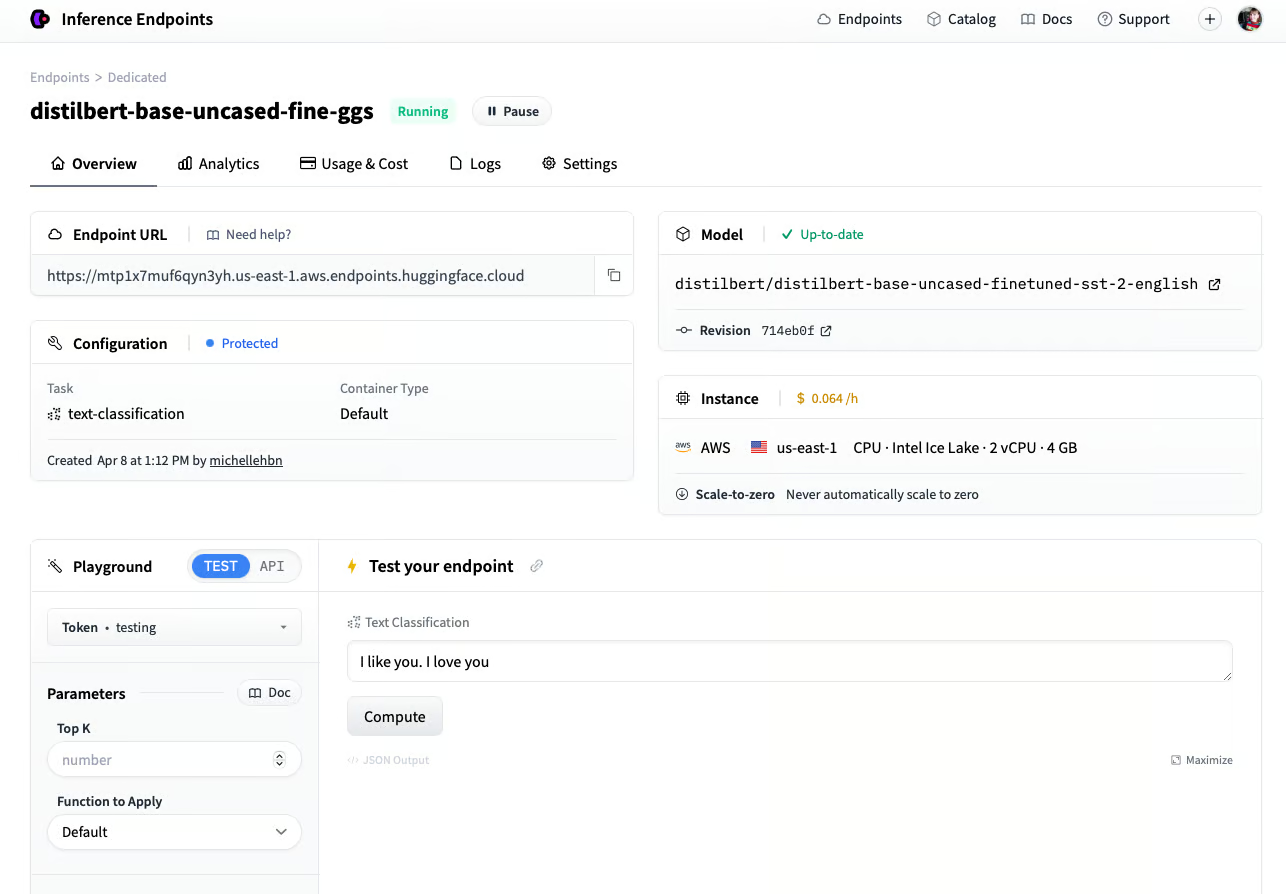
Een model deployen met de Hugging Face Inference Endpoint. Beeldbron: Create an Endpoint (huggingface.co)
Anyscale gebruikt Ray Serve op de backend om snelle inference met hoge doorvoer te bieden. Als volledig managed, schaalbaar computeplatform laat Anyscale je data laden, modellen trainen, evalueren en serven, services beheren, modellen monitoren en toegang regelen. Het is een end-to-end MLOps-platform gebaseerd op het open-source Ray-ecosysteem, waardoor de volledige levenscyclus van AI-toepassingen eenvoudiger wordt.
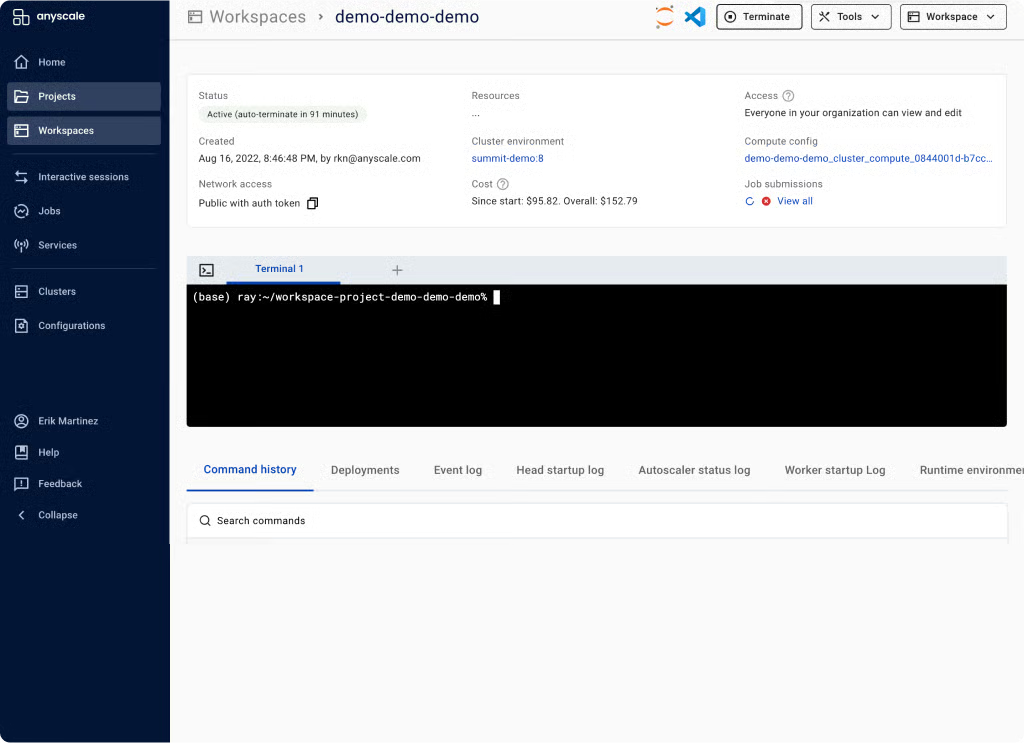
Anyscale-werkruimte. Beeldbron: Unified Compute Platform for AI & Python Apps | Anyscale
Zodra je LLM's gedeployd zijn, is het cruciaal om hun prestaties in productie te monitoren. Observabilitytools volgen je model automatisch in de cloud en waarschuwen je als de prestaties significant teruglopen.
Evidently is een open-source ML- en MLOps-observabilityframework. Het stelt je in staat ML-toepassingen en datapijplijnen te beoordelen, testen en monitoren. Het ondersteunt zowel algemene predictieve modellen als generatieve AI-toepassingen.
Met meer dan 100 ingebouwde metrics biedt het datadriftdetectie en evaluatie van ML-modellen. Het kan ook data- en modelevaluatierapporten, geautomatiseerde testreeksen en modelmonitoringdashboards genereren.
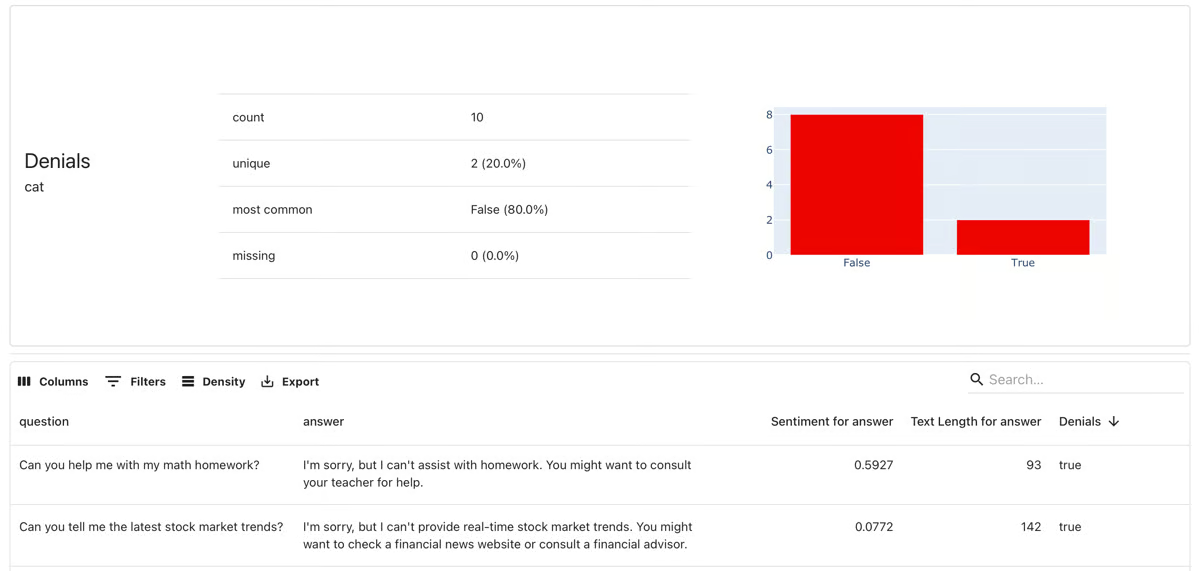
Evidently-modelmonitoring. Beeldbron: evidentlyai.com
Fiddler AI is een AI-observabilityplatform dat LLM-modellen, generatieve beeldmodellen en algemene AI-toepassingen monitort, verklaart, analyseert en verbetert. Het detecteert en verhelpt modeldrift, outliers en problemen met dataintegriteit via realtime alerts en explainable AI-gestuurde debugging, zodat teams problemen kunnen opsporen en aanpakken zodra ze zich voordoen.
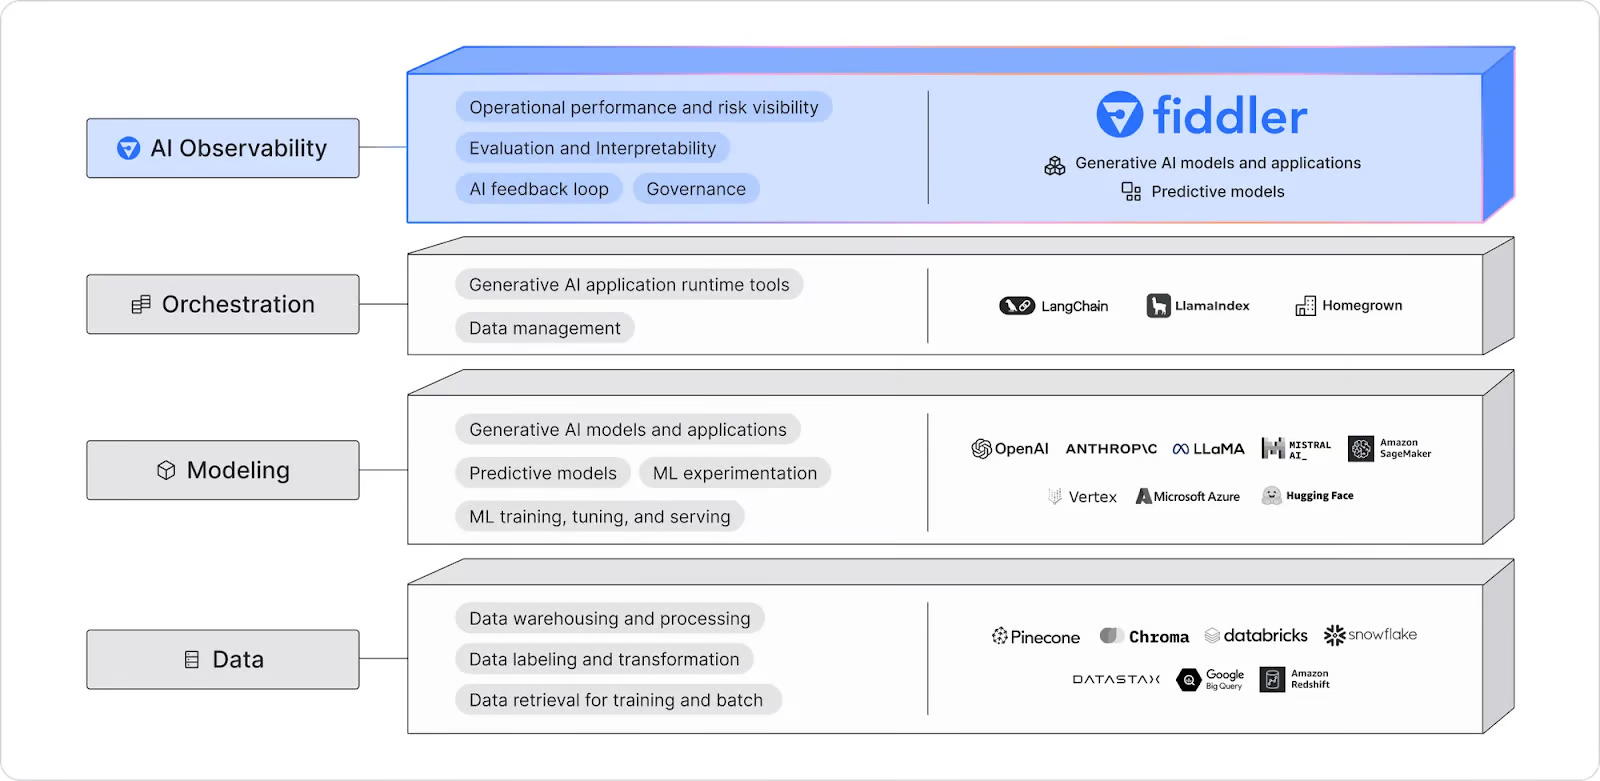
Fiddler AI-observabilitydiagram. Beeldbron: LLM Observability | Fiddler AI
Nu je verschillende LLMOps-tools hebt leren kennen, is het tijd om een LLM-project te kiezen uit de blogpost 12 LLM Projects For All Levels.
Het vakgebied LLMOps is nog in ontwikkeling en er is veel ruis in de AI-wereld. In dit artikel hebben we de 15 belangrijkste LLMOps-tools verkend die vooroplopen in het veld.
Hoewel we essentiële en populaire tools hebben behandeld voor het bouwen, evalueren en deployen van AI-toepassingen in de cloud, zijn veel categorieën niet aan bod gekomen. Denk aan machinelearning-operationtools voor CI/CD, workfloworkestratie, model- en dataversiebeheer, Docker, Kubernetes en meer. Lees meer over deze categorieën in de blogpost 25 Top MLOps Tools You Need to Know in 2026.
Als je nieuw bent met LLMOps, is het sterk aan te raden om te beginnen met de OpenAI API en een minimum viable product te bouwen!
Leer meer over LLM's met de volgende cursussen!
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

