Di recente ho concluso un contratto con un'azienda di IA. Tra le altre cose, aiutano i ricercatori nel post-training degli LLM. Come matematico con un dottorato, ho creato prompt matematici che mettevano in difficoltà i modelli di frontiera. I prompt trabocchetto non valevano; i prompt dovevano evidenziare errori di ragionamento.
Durante quel lavoro, ho sentito spesso parlare di "Humanity’s Last Exam". Ho scoperto che era un benchmark di IA progettato per testare il ragionamento in molti ambiti accademici. La mia curiosità mi ha spinto ad approfondire cos'è l'HLE e cosa ci dice sugli attuali limiti del ragionamento delle IA.
Se sei alle prime armi con l'IA e i benchmark, ti consiglio di seguire il percorso di competenze AI Fundamentals.
Che cos'è "Humanity’s Last Exam"?
Con l'avanzare degli LLM, i ricercatori si affidano a raccolte di domande di valutazione, note come benchmark, per confrontare le prestazioni e monitorare i progressi. Humanity's Last Exam (HLE) è un benchmark progettato per misurare le capacità di ragionamento di un LLM, non solo la sua abilità di riconoscere schemi. Mira a valutare quanto bene un modello gestisce problemi a livello esperto in molti domini accademici.
Perché abbiamo bisogno di un "Last Exam"?
Con i tanti benchmark già esistenti, perché aggiungerne un altro? Benchmark che una volta mettevano in difficoltà gli LLM, come MMLU, ora sono saturi, con modelli che spesso superano il 90 percento. A questo punto, questi benchmark smettono di misurare differenze significative tra i modelli.
HLE è un benchmark di nuova generazione che alza il livello di difficoltà riunendo domande create da esperti che richiedono ragionamenti a più passaggi, non una semplice rievocazione tramite pattern matching superficiale.
Come è stato sviluppato HLE?
Alla fine del 2024, il Centre for AI Safety, un'organizzazione non profit dedicata alla sicurezza dell'IA, ha collaborato con Scale AI, un'azienda di dati, per sviluppare un benchmark di IA più difficile. Il progetto è stato guidato da Dan Hendrycks.
Il team ha raccolto tramite crowdsourcing domande a livello di laurea magistrale da più discipline accademiche e ha offerto premi significativi: i migliori 50 contributori hanno vinto 5000 $, e i successivi 500 hanno ricevuto 500 $.
Il risultato è stato un ampio bacino di domande a livello esperto su molte materie, come matematica, informatica, letteratura, analisi musicale e storia.
Cosa include Humanity's Last Exam?
L'articolo su HLE descrive il benchmark come "...l'ultimo benchmark a risposte chiuse per abilità accademiche ampie." Le domande richiedono ragionamenti a più passaggi, il che impedisce ai modelli di indovinare o memorizzare le risposte.
HLE è composto da 2.500 domande pubbliche e circa 500 domande aggiuntive in un set privato di holdout.
Ogni domanda deve essere originale, avere un'unica risposta corretta e resistere a una semplice ricerca sul web o interrogazione di database. Circa il 76% delle domande usa il formato a corrispondenza esatta e il restante 24% è a scelta multipla. Circa il 14% delle domande è multimodale, con testo e immagini.
Il team HLE ha applicato un rigoroso processo di selezione delle domande.
- Per essere accettate, le domande dovevano mettere in scacco un LLM di frontiera. Circa settantamila domande hanno soddisfatto questo criterio.
- Revisori paritari esperti hanno raffinato e filtrato il totale fino a tredicimila domande.
- Organizzatori e revisori esperti hanno approvato manualmente seimila di queste domande.
- I ricercatori hanno suddiviso questo insieme in un set pubblico di 2.500 domande e un set holdout di circa 500 domande.
Critiche a Humanity’s Last Exam
I primi risultati hanno mostrato che i modelli di frontiera inizialmente ottenevano punteggi bassi alle domande, pur esprimendo alta confidenza. Questo divario indica allucinazioni.
Gruppi indipendenti hanno sollevato preoccupazioni. Future House, un laboratorio di ricerca non profit, ha pubblicato un post: "Circa il 30% delle risposte di chimica/biologia di Humanity’s Last Exam è probabilmente sbagliato."
La loro analisi si è concentrata sul protocollo di revisione. Gli autori delle domande sostenevano risposte corrette, ma ai revisori era stato chiesto di dedicare solo cinque minuti alla verifica della correttezza. Sostengono che questo processo lasci passare risposte eccessivamente complesse, artificiose o ambigue, che spesso confliggono con la letteratura scientifica.
I manutentori di HLE hanno risposto incaricando una revisione da parte di tre esperti del sottoinsieme contestato. Al 16 settembre 2025, prevedevano di annunciare un processo di revisione a rotazione per HLE.
Il panorama dei benchmark di IA
HLE si colloca all'interno di un ecosistema più ampio di benchmark che testano diversi aspetti delle capacità degli LLM.
Conoscenza e ragionamento
Questi benchmark valutano conoscenze accademiche e ragionamento.
- Massive Multitask Language Understanding (MMLU). MMLU testa le prestazioni zero-shot su cinquantasette materie diverse.
- MMLU-Pro/MMLU Pro+. Maggiore complessità delle domande e focus sul ragionamento di ordine superiore.
- Google Proof Q&A (GPQA) Un benchmark STEM a livello magistrale, a prova di Google, con 448 domande a scelta multipla.
- Humanity's Last Exam (HLE). HLE usa problemi curati a livello esperto che enfatizzano il ragionamento rispetto al ricordo.
Comprensione multimodale
Questi benchmark misurano il ragionamento che coinvolge sia testo sia immagini.
- Il Massive Multi-discipline Multimodal Understanding and Reasoning (MMMU). Circa 1.500 domande multimodali e multidisciplinari provenienti da esami, quiz e libri di testo.
- Il MMMU-Pro rimuove le domande risolvibili da modelli solo testo, aggiunge opzioni di risposta più robuste e introduce una modalità solo visiva in cui l'intero prompt è incorporato in un'immagine.
Ingegneria del software e uso di strumenti
Altri benchmark si concentrano specificamente sull'ingegneria del software e sull'uso di strumenti.
- SWE-bench. Costruito a partire da issue reali su GitHub da dodici repository Python. Il modello legge il codebase, interpreta la descrizione del problema e propone una patch.
- SWE-bench Verified. Una versione migliorata di SWE-bench che corregge test troppo specifici, chiarisce descrizioni vaghe dei problemi e stabilizza la configurazione degli ambienti.
- SWE-bench-Live. Una versione scalabile e continuamente aggiornata con 1319 task su 93 repo.
Framework olistici di valutazione multi-metrica
Il Center for Research on Foundation Models (CRFM) di Stanford ha sviluppato Holistic Evaluation of Language Models (HELM) per supportare una valutazione responsabile dell'IA.
HELM valuta i modelli su una batteria di scenari standardizzati, come question answering, sintesi, interrogazioni critiche per la sicurezza e contenuti sociali/etici. Questi scenari sono valutati su più dimensioni, non solo l'accuratezza, ma anche calibrazione, robustezza e tossicità.
HELM è cresciuto fino a diventare una famiglia di framework correlati.
- HELM Capabilities. Una classifica generalista per valutare i LM.
- Audio. Valutazioni per attività legate all'audio e al parlato.
- HELM Lite. Un sottoinsieme più piccolo e veloce per confronti rapidi.
- HELM Finance. HELM adattato a compiti finanziari.
- MedHELM. Valutazioni per il ragionamento e la sicurezza in ambito sanitario.
Valutazioni di sicurezza e di capacità pericolose
I framework di sicurezza misurano il rischio più che la competenza intellettuale.
- Model Evaluation & Threat Research (METR) è un'organizzazione di ricerca non profit che valuta capacità potenzialmente pericolose, come cyberattacchi, tentativi di evitare lo spegnimento o la capacità di automatizzare R&S in IA. La sua missione è rilevare precocemente i rischi catastrofici.
- Frontier Safety Framework di Google DeepMind. Definisce livelli di capacità critici (CCL), monitora se i modelli di frontiera si avvicinano ad essi e implementa piani di mitigazione quando accade.
Dove si collocano gli attuali modelli di IA sui benchmark?
Molte classifiche pubbliche monitorano le prestazioni degli LLM su varie metriche.
Classifiche
Ecco alcuni punteggi aggiornati al momento della stesura, dicembre 2025.
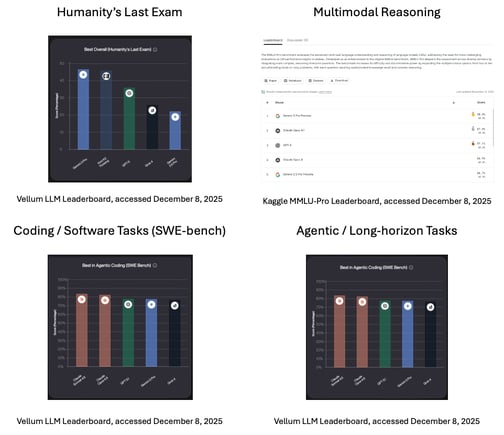
- Humanity's Last Exam. Secondo la classifica Vellum, l'attuale leader (al momento della stesura) è Gemini 3 Pro, il modello generativo multimodale di punta di Google.
- Ragionamento multimodale. Gemini 3 Pro, progettato per unificare le modalità in un unico sistema, è in testa nel ragionamento multimodale, secondo la classifica Kaggle MMLU-Pro.
- Coding / Attività software (SWE-bench). Claude Sonnet 4.5 di Anthropic, che dà priorità al ragionamento accurato, occupa il primo posto nel coding e nei compiti software reali, secondo la classifica Vellum.
- Attività agentiche / di lungo periodo. Anche Claude Sonnet 4.5 è in testa nelle attività agentiche e di lungo periodo, secondo la classifica Vellum.
Sicurezza/capacità pericolose
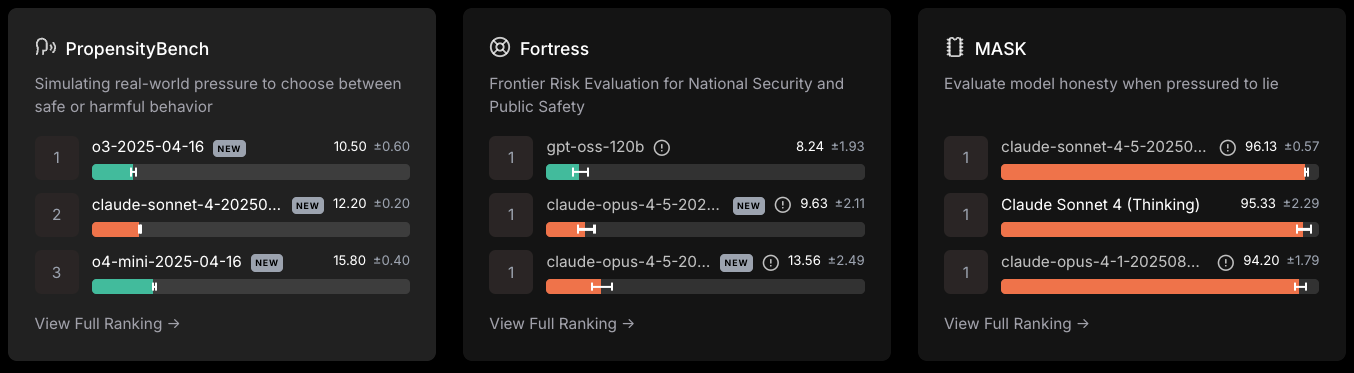
Scale LLM Safety Leaderboard, consultata l'8 dicembre 2025
- o3-2024-04-18 di OpenAI era in testa a PropensityBench, che misura la scelta tra comportamento sicuro o dannoso.
- GPT-oss-120b era in testa nella Frontier Risk Evaluation for National Security and Public Safety.
- Claude Sonnet-4.5 ha resistito maggiormente alla pressione di mentire.
Come viene usato Humanity’s Last Exam
Finora ho illustrato cos'è HLE e come è stato sviluppato. Vediamo ora come il test viene usato in pratica.
Per i team di ricerca
HLE fornisce un metodo di valutazione standardizzato tra domini. Mette in evidenza i punti di forza e di debolezza di un modello. Rivela il divario tra esso e le prestazioni di esperti umani. I team possono usare questi schemi per guidare lo sviluppo del modello e il post-training mirato.
Per i policymaker
HLE fornisce una metrica pubblica e globale dei progressi nel ragionamento dell'IA. Crea un punto di riferimento condiviso tra Paesi ed enti regolatori e può ancorare le discussioni su soglie, supervisione e governance alla realtà, non all'hype.
Conclusione
I benchmark di IA plasmano il modo in cui misuriamo i progressi dell'IA. Man mano che i benchmark precedenti si sono saturati, è emersa l'esigenza di un nuovo benchmark, focalizzato sul ragionamento, non solo sul ricordo o sul pattern matching.
Humanity's Last Exam cerca di colmare quel vuoto raccogliendo tramite crowdsourcing domande a livello magistrale da esperti di tutto il mondo per mettere in luce i limiti degli LLM. Non è l'ultima parola, ma chiarisce dove si colloca oggi l'IA rispetto al ragionamento degli esperti umani.
Per ulteriori informazioni sugli LLM e su come funzionano, ti consiglio le seguenti risorse:







Di recente ho concluso un contratto con un'azienda di IA. Tra le altre cose, aiutano i ricercatori nel post-training degli LLM. Come matematico con un dottorato, ho creato prompt matematici che mettevano in difficoltà i modelli di frontiera. I prompt trabocchetto non valevano; i prompt dovevano evidenziare errori di ragionamento.
Durante quel lavoro, ho sentito spesso parlare di "Humanity’s Last Exam". Ho scoperto che era un benchmark di IA progettato per testare il ragionamento in molti ambiti accademici. La mia curiosità mi ha spinto ad approfondire cos'è l'HLE e cosa ci dice sugli attuali limiti del ragionamento delle IA.
Se sei alle prime armi con l'IA e i benchmark, ti consiglio di seguire il percorso di competenze AI Fundamentals.
Che cos'è "Humanity’s Last Exam"?
Con l'avanzare degli LLM, i ricercatori si affidano a raccolte di domande di valutazione, note come benchmark, per confrontare le prestazioni e monitorare i progressi. Humanity's Last Exam (HLE) è un benchmark progettato per misurare le capacità di ragionamento di un LLM, non solo la sua abilità di riconoscere schemi. Mira a valutare quanto bene un modello gestisce problemi a livello esperto in molti domini accademici.
Perché abbiamo bisogno di un "Last Exam"?
Con i tanti benchmark già esistenti, perché aggiungerne un altro? Benchmark che una volta mettevano in difficoltà gli LLM, come MMLU, ora sono saturi, con modelli che spesso superano il 90 percento. A questo punto, questi benchmark smettono di misurare differenze significative tra i modelli.
HLE è un benchmark di nuova generazione che alza il livello di difficoltà riunendo domande create da esperti che richiedono ragionamenti a più passaggi, non una semplice rievocazione tramite pattern matching superficiale.
Come è stato sviluppato HLE?
Alla fine del 2024, il Centre for AI Safety, un'organizzazione non profit dedicata alla sicurezza dell'IA, ha collaborato con Scale AI, un'azienda di dati, per sviluppare un benchmark di IA più difficile. Il progetto è stato guidato da Dan Hendrycks.
Il team ha raccolto tramite crowdsourcing domande a livello di laurea magistrale da più discipline accademiche e ha offerto premi significativi: i migliori 50 contributori hanno vinto 5000 $, e i successivi 500 hanno ricevuto 500 $.
Il risultato è stato un ampio bacino di domande a livello esperto su molte materie, come matematica, informatica, letteratura, analisi musicale e storia.
Cosa include Humanity's Last Exam?
L'articolo su HLE descrive il benchmark come "...l'ultimo benchmark a risposte chiuse per abilità accademiche ampie." Le domande richiedono ragionamenti a più passaggi, il che impedisce ai modelli di indovinare o memorizzare le risposte.
HLE è composto da 2.500 domande pubbliche e circa 500 domande aggiuntive in un set privato di holdout.
Ogni domanda deve essere originale, avere un'unica risposta corretta e resistere a una semplice ricerca sul web o interrogazione di database. Circa il 76% delle domande usa il formato a corrispondenza esatta e il restante 24% è a scelta multipla. Circa il 14% delle domande è multimodale, con testo e immagini.
Il team HLE ha applicato un rigoroso processo di selezione delle domande.
Critiche a Humanity’s Last Exam
I primi risultati hanno mostrato che i modelli di frontiera inizialmente ottenevano punteggi bassi alle domande, pur esprimendo alta confidenza. Questo divario indica allucinazioni.
Gruppi indipendenti hanno sollevato preoccupazioni. Future House, un laboratorio di ricerca non profit, ha pubblicato un post: "Circa il 30% delle risposte di chimica/biologia di Humanity’s Last Exam è probabilmente sbagliato."
La loro analisi si è concentrata sul protocollo di revisione. Gli autori delle domande sostenevano risposte corrette, ma ai revisori era stato chiesto di dedicare solo cinque minuti alla verifica della correttezza. Sostengono che questo processo lasci passare risposte eccessivamente complesse, artificiose o ambigue, che spesso confliggono con la letteratura scientifica.
I manutentori di HLE hanno risposto incaricando una revisione da parte di tre esperti del sottoinsieme contestato. Al 16 settembre 2025, prevedevano di annunciare un processo di revisione a rotazione per HLE.
Il panorama dei benchmark di IA
HLE si colloca all'interno di un ecosistema più ampio di benchmark che testano diversi aspetti delle capacità degli LLM.
Conoscenza e ragionamento
Questi benchmark valutano conoscenze accademiche e ragionamento.
Comprensione multimodale
Questi benchmark misurano il ragionamento che coinvolge sia testo sia immagini.
Ingegneria del software e uso di strumenti
Altri benchmark si concentrano specificamente sull'ingegneria del software e sull'uso di strumenti.
Framework olistici di valutazione multi-metrica
Il Center for Research on Foundation Models (CRFM) di Stanford ha sviluppato Holistic Evaluation of Language Models (HELM) per supportare una valutazione responsabile dell'IA.
HELM valuta i modelli su una batteria di scenari standardizzati, come question answering, sintesi, interrogazioni critiche per la sicurezza e contenuti sociali/etici. Questi scenari sono valutati su più dimensioni, non solo l'accuratezza, ma anche calibrazione, robustezza e tossicità.
HELM è cresciuto fino a diventare una famiglia di framework correlati.
Valutazioni di sicurezza e di capacità pericolose
I framework di sicurezza misurano il rischio più che la competenza intellettuale.
Dove si collocano gli attuali modelli di IA sui benchmark?
Molte classifiche pubbliche monitorano le prestazioni degli LLM su varie metriche.
Classifiche
Ecco alcuni punteggi aggiornati al momento della stesura, dicembre 2025.
Sicurezza/capacità pericolose
Scale LLM Safety Leaderboard, consultata l'8 dicembre 2025
Come viene usato Humanity’s Last Exam
Finora ho illustrato cos'è HLE e come è stato sviluppato. Vediamo ora come il test viene usato in pratica.
Per i team di ricerca
HLE fornisce un metodo di valutazione standardizzato tra domini. Mette in evidenza i punti di forza e di debolezza di un modello. Rivela il divario tra esso e le prestazioni di esperti umani. I team possono usare questi schemi per guidare lo sviluppo del modello e il post-training mirato.
Per i policymaker
HLE fornisce una metrica pubblica e globale dei progressi nel ragionamento dell'IA. Crea un punto di riferimento condiviso tra Paesi ed enti regolatori e può ancorare le discussioni su soglie, supervisione e governance alla realtà, non all'hype.
Conclusione
I benchmark di IA plasmano il modo in cui misuriamo i progressi dell'IA. Man mano che i benchmark precedenti si sono saturati, è emersa l'esigenza di un nuovo benchmark, focalizzato sul ragionamento, non solo sul ricordo o sul pattern matching.
Humanity's Last Exam cerca di colmare quel vuoto raccogliendo tramite crowdsourcing domande a livello magistrale da esperti di tutto il mondo per mettere in luce i limiti degli LLM. Non è l'ultima parola, ma chiarisce dove si colloca oggi l'IA rispetto al ragionamento degli esperti umani.
Per ulteriori informazioni sugli LLM e su come funzionano, ti consiglio le seguenti risorse: