{count, plural, one {Programma} other {Programmi}}
L'intelligenza artificiale nell'ingegneria del software
{hours} ore
Anthropic ha rilasciato Claude Opus 4.7, l’ultima iterazione del suo modello di punta. Il miglioramento principale è l’autonomia: Anthropic lo presenta come il modello a cui puoi affidare i lavori di coding e agent più difficili e di lunga durata senza supervisione stretta.
In questo rilascio apprendiamo anche che esiste un soffitto sopra Opus 4.7. Il Mythos Preview interno di Anthropic ottiene punteggi più alti su diversi benchmark, ma viene trattenuto dal rilascio ampio mentre Anthropic testa le salvaguardie informatiche. Per chiunque non sia un ricercatore interno di Anthropic, Opus 4.7 è il soffitto attuale.
In questo articolo, passeremo in rassegna cosa c’è davvero di nuovo in Opus 4.7, analizzeremo i risultati dei benchmark e condivideremo test pratici che puoi eseguire da solo. Puoi anche consultare le nostre guide ai modelli concorrenti pubblicati di recente, come il Muse Spark di Meta, OpenAI GPT-5.5 e Gemini 3.1 di Google.
Aggiornamento: il 28 maggio 2026, Anthropic ha rilasciato il modello successore. Scopri tutto nella nostra guida a Claude Opus 4.8.
Claude Opus 4.7 è l’ultimo large language model di punta di Anthropic, in cima alla famiglia di modelli Claude sopra Sonnet e Haiku. Segue Claude Opus 4.6 ed è progettato per i compiti più impegnativi, come workflow agentici complessi e attività di ragionamento multi-step che richiedono prestazioni sostenute su sessioni lunghe.
Rispetto a Opus 4.6, la versione 4.7 si concentra su tre aree:
Il Mythos Preview interno di Anthropic, che abbiamo menzionato prima e di cui abbiamo anche una FAQ, guida diversi benchmark, ma non è ampiamente disponibile. Opus 4.7 è sostanzialmente un modello gemello addestrato con capacità di cybersecurity deliberatamente ridotte.
Anthropic ha riportato miglioramenti notevoli in diverse aree di capacità in Opus 4.7.
Opus 4.7 segue le istruzioni più fedelmente rispetto ai modelli precedenti. È ovviamente utile per qualunque workflow che dipenda dall’affidabilità, ma può anche avere conseguenze inattese: Anthropic invita a ri-tarare prompt e harness, perché istruzioni che i modelli precedenti saltavano o interpretavano in modo lasco ora verranno prese alla lettera.
La visione ad alta risoluzione è stata migliorata per supportare immagini fino a 3,75 megapixel, più di tre volte rispetto a quanto accettavano i modelli più vecchi. Gli agent per l’uso del computer e i workflow di estrazione dati potrebbero beneficiare molto di questa granularità di dettaglio aumentata, poiché dipendono da leggibilità e accuratezza, talvolta fino al livello del singolo pixel.
Opus 4.7 è migliore nella memoria basata su file system, ovvero un pattern in cui il modello scrive note su file mentre lavora e le rilegge nelle esecuzioni successive.
Claude Code è l’ambiente più ovvio: un file CLAUDE.md alla radice del progetto che Claude legge all’avvio della sessione, aggiorna mano a mano che prende decisioni e utilizza quando torni al lavoro.
“Meglio” qui significa giudizio più accurato su cosa valga la pena annotare e richiamo più affidabile nei turni successivi. Anthropic afferma che questo consente ai nuovi task di “richiedere meno contesto iniziale” — cosa che, se hai mai ri-spiegato per la quinta volta le convenzioni del tuo progetto a un modello, come è capitato a noi, apprezzerai.
Quindi, il punto: se usi Opus 4.7 per lavori multi-sessione, lascialo prendere appunti. Lo farà meglio di Opus 4.6, anche se già Opus 4.6 teneva note piuttosto buone.
Anthropic ci dice che Claude Opus 4.7 ha apportato miglioramenti significativi in queste aree.
Abbiamo creato alcuni test nostri per mettere alla prova queste affermazioni.
Per testare il rispetto delle istruzioni di Opus 4.7, abbiamo usato il seguente prompt dettagliato per stressarlo. Ha 12 vincoli distinti verificabili alla fine.
You are writing a short briefing document for a new employee at a mid-sized accounting firm. Follow every instruction below.
Write a briefing about the firm's approach to client onboarding. The briefing must meet all of the following requirements:

The briefing must be exactly 4 paragraphs long.
-The second paragraph must begin with the word "Historically".
-Each paragraph must contain between 3 and 5 sentences. No paragraph may have fewer than 3 or more than 5.
-Do not use the words "streamline", "leverage", "robust", or "synergy" anywhere in the document.
-Include exactly two direct quotes from fictional senior partners. Attribute each quote to a named partner. Do not include any other quoted material.
-One of the partners quoted must have a surname that starts with the letter M.
-End the document with a single-sentence closing line on its own, separated from the fourth paragraph by a blank line. This closing line does not count toward the 4-paragraph requirement.
-The closing line must be a question.
-Use British English spelling throughout (e.g., "organisation", "colour", "realise").
-Do not use any bullet points, numbered lists, or headings.
-Mention a specific fictional client name exactly once, and italicise it using markdown asterisks.
-The total word count of the briefing, including the closing line, must be between 280 and 320 words. Do not include any preamble, explanation, or commentary before or after the briefing. Output only the briefing itself.
Ed ecco il risultato:
Welcome to Harding & Whitcombe, where client onboarding is treated as the foundation of every successful long-term engagement. Our approach centres on understanding the organisation behind the numbers before any technical work begins, which means the first two weeks are devoted almost entirely to listening. New clients are assigned a dedicated onboarding lead who coordinates introductions across tax, audit, and advisory teams. This structure ensures that every colleague touching the account shares a consistent understanding of the client's priorities and sensitivities.

Historically, the firm operated a more transactional model, with onboarding handled piecemeal by whichever partner had signed the engagement letter. That changed in 2014, when senior leadership recognised that our competitors were winning work on relationships rather than fees alone. As Helena Marchbanks, our managing partner, often reminds new hires, "A client who feels understood in week one rarely questions the invoice in month six." The revised approach has measurably improved retention and referral rates across every service line.

In practical terms, you will be expected to attend the initial discovery meeting for any client you support, even in a purely observational capacity. You should familiarise yourself with the client's sector, recent filings, and any public commentary from their leadership before that first conversation. When we onboarded Thornbury Mills Ltd last spring, the junior associate who had read three years of their annual reports was the one who spotted the inventory anomaly that shaped our entire advisory brief. Preparation of that depth is the standard we expect, not the exception.

You will also notice that we emphasise candour from the outset, particularly around scope and realistic timelines. "We would rather lose a pitch than promise something we cannot deliver," says Rupert Castellane, head of our advisory practice, and that philosophy colours every onboarding conversation. Take the time to ask questions, observe the senior partners in action, and recognise that trust accumulates slowly but pays compounding dividends.

Are you ready to meet your first client?
Ora è il momento di valutarlo. Condivido il nostro rubric:
|
# |
Vincolo |
Come verificare |
|
1 |
Esattamente 4 paragrafi (più riga di chiusura) |
Conta le interruzioni di paragrafo |
|
2 |
Il paragrafo 2 inizia con "Historically" |
Guarda la prima parola |
|
3 |
Ogni paragrafo ha 3–5 frasi |
Conta le frasi per paragrafo |
|
4 |
Nessuna parola vietata |
Ctrl+F per ciascuna |
|
5 |
Esattamente 2 citazioni, entrambe attribuite, nessun altro materiale tra virgolette |
Conta le virgolette |
|
6 |
Il cognome di uno dei partner inizia con M |
Controlla le attribuzioni |
|
7 |
Riga di chiusura separata da una riga vuota |
Controllo visivo |
|
8 |
La riga di chiusura è una domanda |
Termina con "?" |
|
9 |
Ortografia britannica |
Ctrl+F per "organization", "color", "realize", ecc. |
|
10 |
Niente elenchi puntati, numerati o titoli |
Controllo visivo |
|
11 |
Cliente fittizio menzionato una sola volta e in corsivo |
Ctrl+F per gli asterischi |
|
12 |
Conteggio parole 280–320 |
Incolla in un contatore parole |
Ti risparmiamo la fatica di passarci. Il modello ha segnato 11/12.
Stava facendo un lavoro perfetto, ma alla fine ha superato di poco il limite di parole (325 parole, con limite 320).
Abbiamo applicato lo stesso test a Claude Sonnet 4.6, che ha ottenuto anch’esso 11/12 istruzioni corrette, fallendo nello stesso punto (conteggio parole). Consideriamo comunque Opus 4.7 un miglioramento perché Sonnet 4.6 è andato ben oltre il limite (400 parole).
Per il nostro secondo test, abbiamo dato in pasto a Opus 4.7 un’immagine difficile da leggere:
You are analysing a degraded image that may be blurry, low-resolution,
or otherwise difficult to read. Your job is to extract as much accurate
information as possible.

Complete all of the following tasks. Do not include any preamble,
explanation, or commentary. Output only the requested deliverable.

1. Describe what type of document or visualisation this appears to be
   (e.g. bar chart, dashboard, table, report page). State your confidence
   as High, Medium, or Low.

2. List every number you can make out, however partial. For each one,
   state what you believe it refers to and your confidence (High, Medium,
   or Low). If a number is ambiguous between two readings (e.g. could be
   138 or 188), state both possibilities.

3. List every piece of text you can make out — titles, labels, legends,
   footnotes — quoted as precisely as possible. Where a word or character
   is unclear, use [?] to mark the uncertain character, e.g. "Re[?]enue".

4. Describe the layout: how many distinct sections or panels are visible,
   and what does each appear to contain?

5. State what you believe the overall subject or story of the image is,
   in one sentence of no more than 25 words. Flag if your confidence is
   Low.

6. List anything you attempted to read but could not make out at all.
Insieme a queste istruzioni, abbiamo fornito a Opus 4.7 uno screenshot degradato del grafico sul commercio della Scozia del 1786 di Playfair, che abbiamo preso dal nostro articolo su Esempi di Data Visualization.
Sapevamo di poter validare l’output perché avevamo una versione a risoluzione più alta da Wikipedia. Ecco l’immagine che ha visto Opus 4.7:
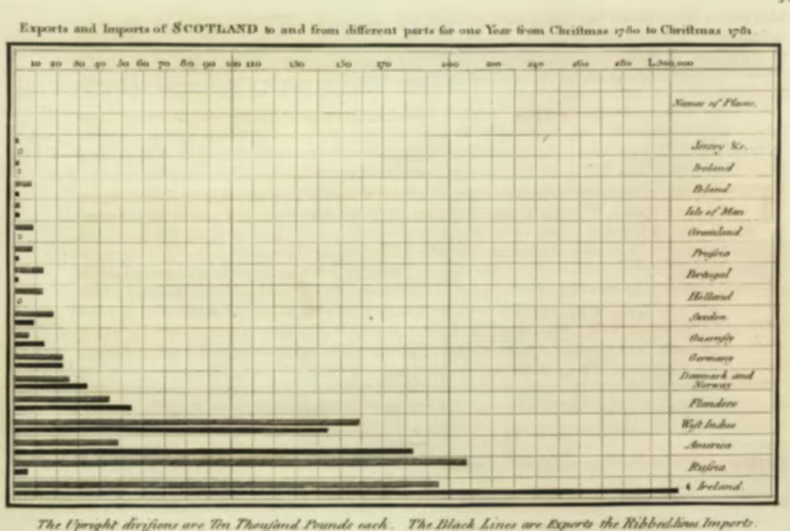
Ecco la lettura di Opus 4.7:
Type: Horizontal bar chart, antique engraving. Confidence: High.

Numbers: X-axis ticks: 10, 20, 30…110, 130, 150, 170, 200, 220, 240, 260, 280, L.300,000 (High, but 130/220 uncertain).

Years "1780" and "1781" in title (High). "Ten Thousand Pounds" per division (High).

Title: "Exports and Imports of SCOTLAND to and from different parts for one Year from Christmas 1780 to Christmas 1781"

Header: "Names of Places"

Places: Jersey &c., Ireland, [?]oland, Isle of Man, Gr[oe]nland, Prussia, Portugal, Holland, Sweden, Guernsey, Germany, Denmark and Norway, Flanders, West Indies, America, Russia, Ireland (duplicate?)

Footnote: "The Upright divisions are Ten Thousand Pounds each. The Black Lines are Exports the Ribbed lines Imports."

Layout: Single panel — title, plot area with ~16 paired bars, right-hand place-name column, footnote below.

Subject: A 1780–81 trade chart showing Scotland's exports and imports by partner. Confidence: High.

Couldn't read: Top-right corner mark; exact bar values; first letter of "[?]oland"; whether bottom "Ireland" is a duplicate.
Sapevamo che questo test potesse essere insidioso, dato che l’asse x del grafico di Playfair effettivamente cambia conteggio a metà (ogni 10 fino a 110, poi decine dispari 130/150/170, poi decine pari 200/220/240/260/280). Ma Opus 4.7 ha letto correttamente l’asse al primo tentativo nonostante la stranezza.
Una cosa che ci ha comunque fatto sorridere: capiamo che ci piaccia quando i modelli di IA esprimono incertezza, ma “[?]oland” avrebbe dovuto essere letto con fiducia come “Poland” e “Gr[oe]nland” come “Greenland”. Anche se non avevamo un rubric ufficiale per questo, possiamo assegnargli onestamente 9/10.
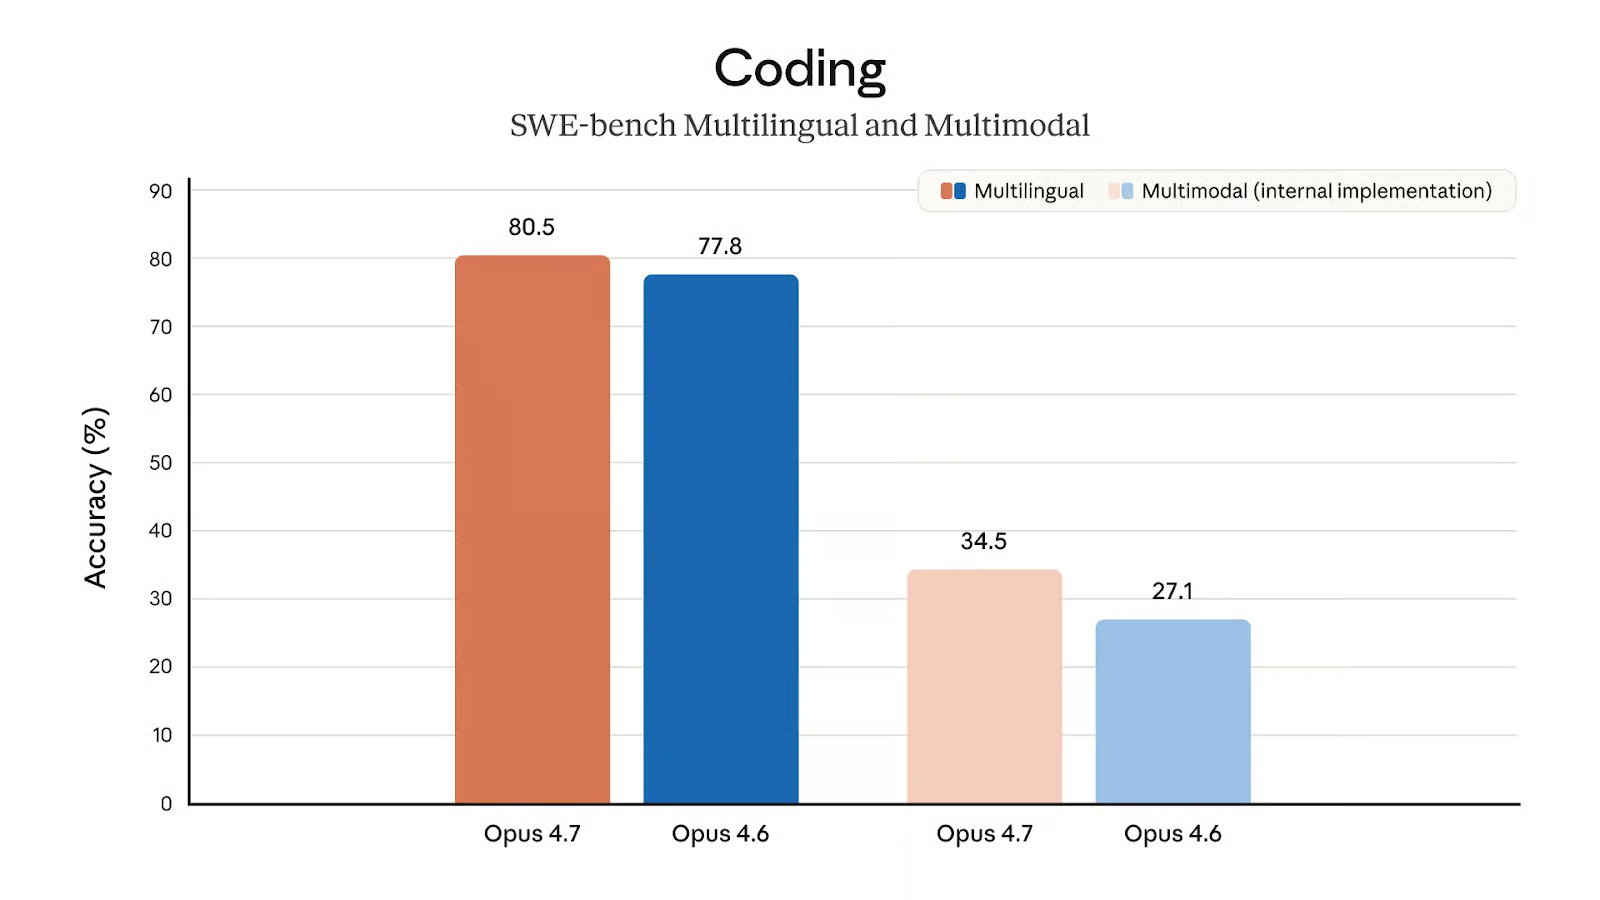
Opus 4.7 è stato valutato su 14 benchmark che coprono coding, ragionamento, uso di tool, uso del computer e ragionamento visivo. La tabella seguente mostra il confronto completo con Opus 4.6, GPT 5.4, Gemini 3.1 Pro e il non ancora pubblicato Mythos Preview.
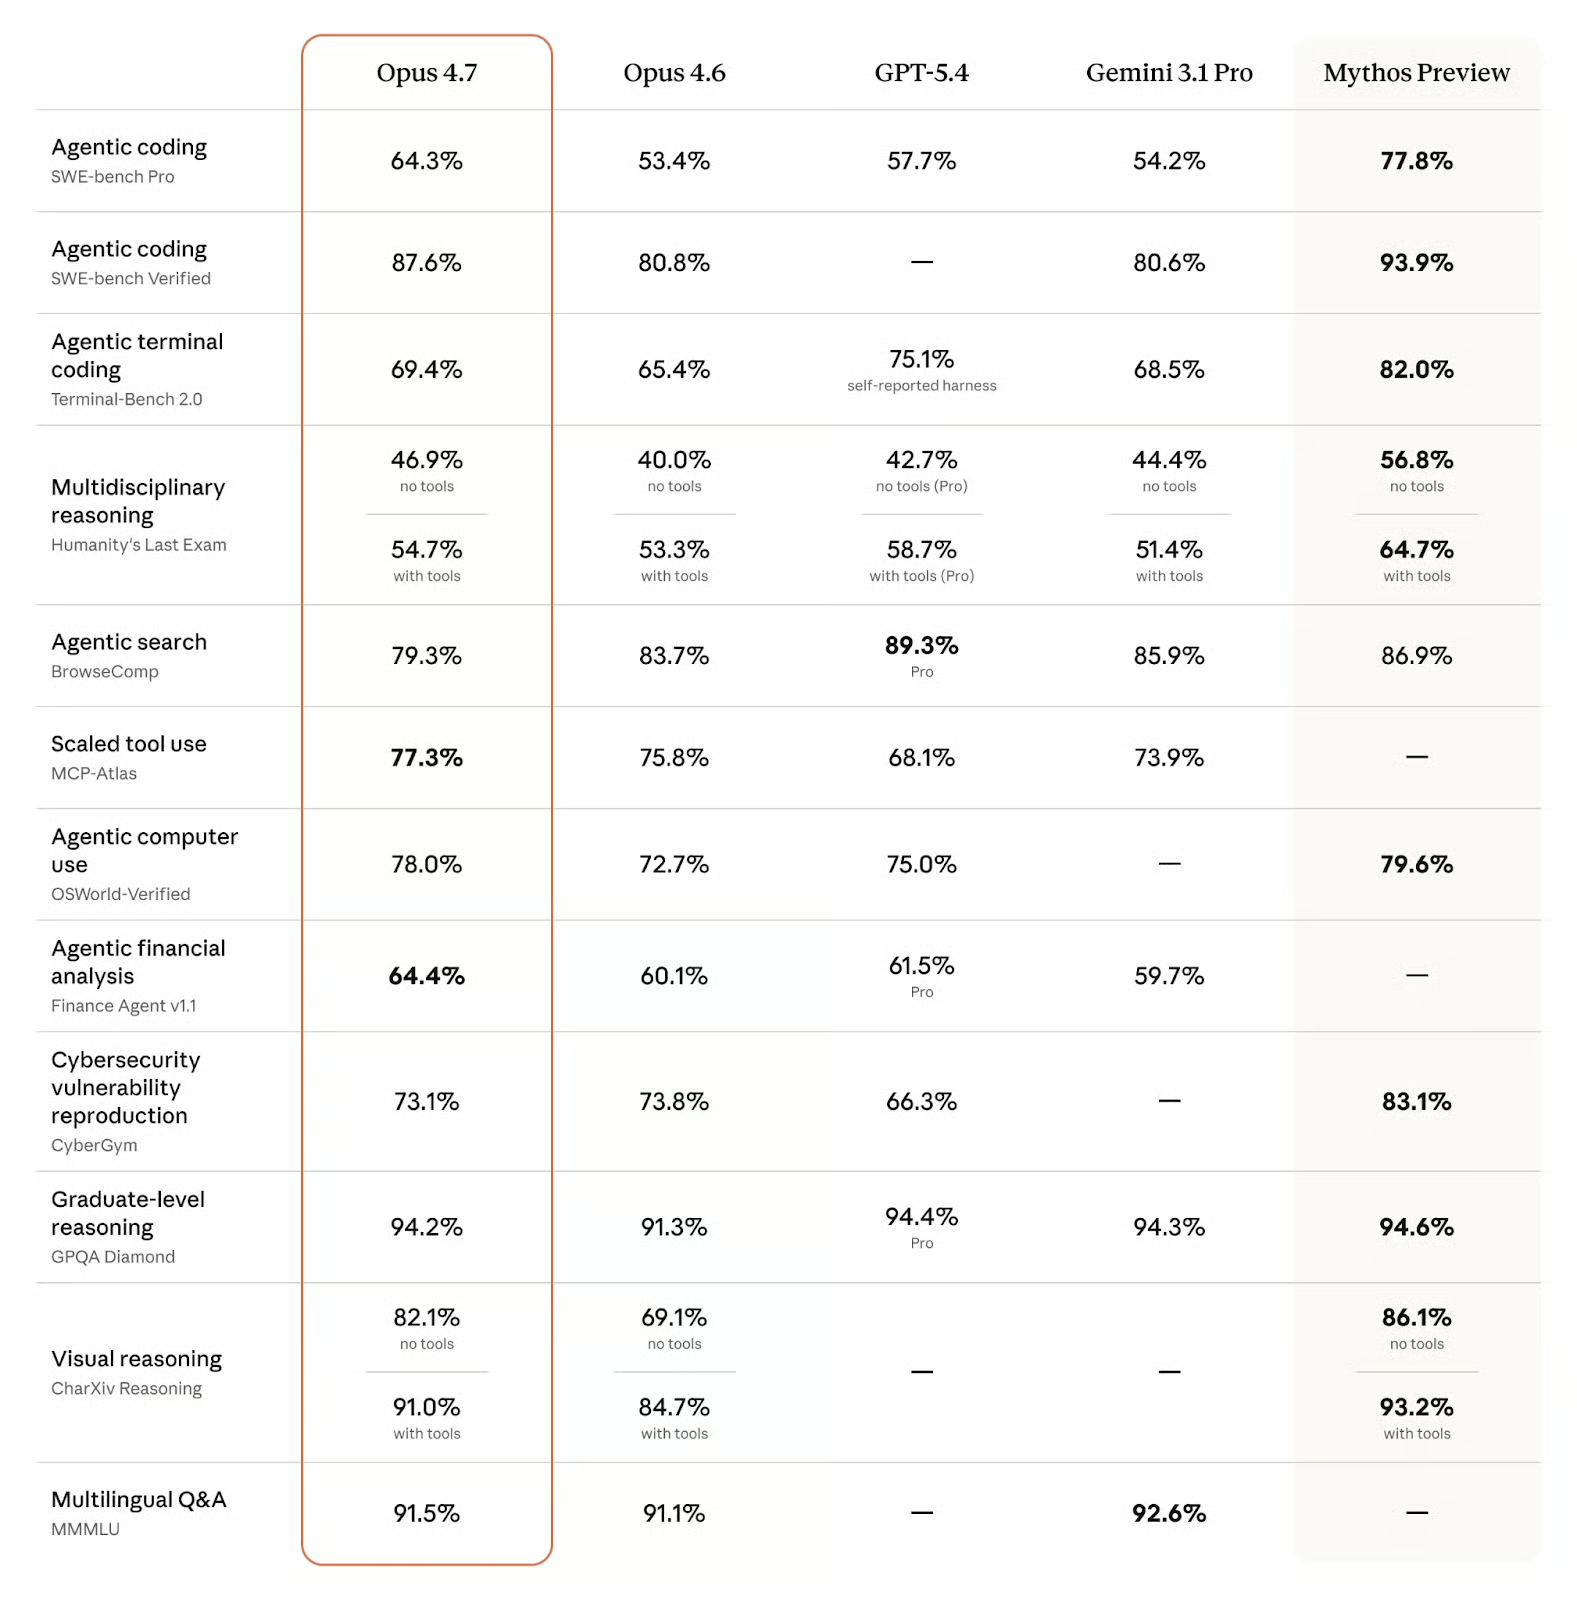
Su SWE-bench Pro, Opus 4.7 segna 64,3%, davanti a GPT-5.4 con 57,7%, Gemini 3.1 Pro con 54,2% e Opus 4.6 con 53,4%. Su SWE-bench Verified, Opus 4.7 arriva a 87,6% rispetto all’80,6% di Gemini 3.1 Pro e all’80,8% di Opus 4.6. GPT-5.4 non ha un punteggio pubblicato su SWE-bench Verified in questo confronto.
SWE-bench testa la capacità di un modello di risolvere issue reali di GitHub in repository Python open-source. La variante Pro è più difficile, con problemi più complessi. Il guadagno di 10,9 punti rispetto a Opus 4.6 su SWE-bench Pro è il maggior miglioramento di questo rilascio (in punti percentuali) e mette Opus 4.7 chiaramente davanti a entrambi i principali concorrenti su questo compito.
Solo il Mythos Preview interno di Anthropic segna 77,8% su SWE-bench Pro e 93,9% su SWE-bench Verified, a dimostrazione che c’è ancora margine sopra Opus 4.7. Tuttavia, Mythos non è ampiamente disponibile, quindi per l’uso in produzione Opus 4.7 è il soffitto attuale.
I risultati su Terminal-Bench 2.0, il benchmark di riferimento per il coding agentico nel terminale, sono piuttosto interessanti. Opus 4.7 migliora leggermente rispetto al predecessore (69,4% vs 65,4%) e supera Gemini 3.1 Pro, che segna 68,5%.
Detto ciò, non riesce a competere con GPT-5.4 (75,1%) sotto questo aspetto, anche se la nota di cautela auto-riportata sul punteggio di GPT-5.4 va tenuta presente nel confronto. Resta il fatto che potrebbe essere deludente per Anthropic che il suo nuovo modello di punta (rilasciato) non primeggi in un benchmark centrale per lo sviluppo software agentico.
Humanity's Last Exam è una raccolta di domande a livello graduate in scienze, matematica e discipline umanistiche, progettata per essere difficile per i modelli di frontiera attuali. Opus 4.7 guida la variante senza strumenti, che testa il ragionamento grezzo senza recupero esterno. Il divario con strumenti a favore di GPT-5.4 (58,7%) è l’area più chiara in cui Opus 4.7 (54,7%) non è in testa.
Il ragionamento a livello graduate si misura di solito con GPQA-Diamond, oggi piuttosto saturo: come tutti i modelli di frontiera attuali, i quattro modelli a confronto superano il 90% e sono sostanzialmente alla pari.
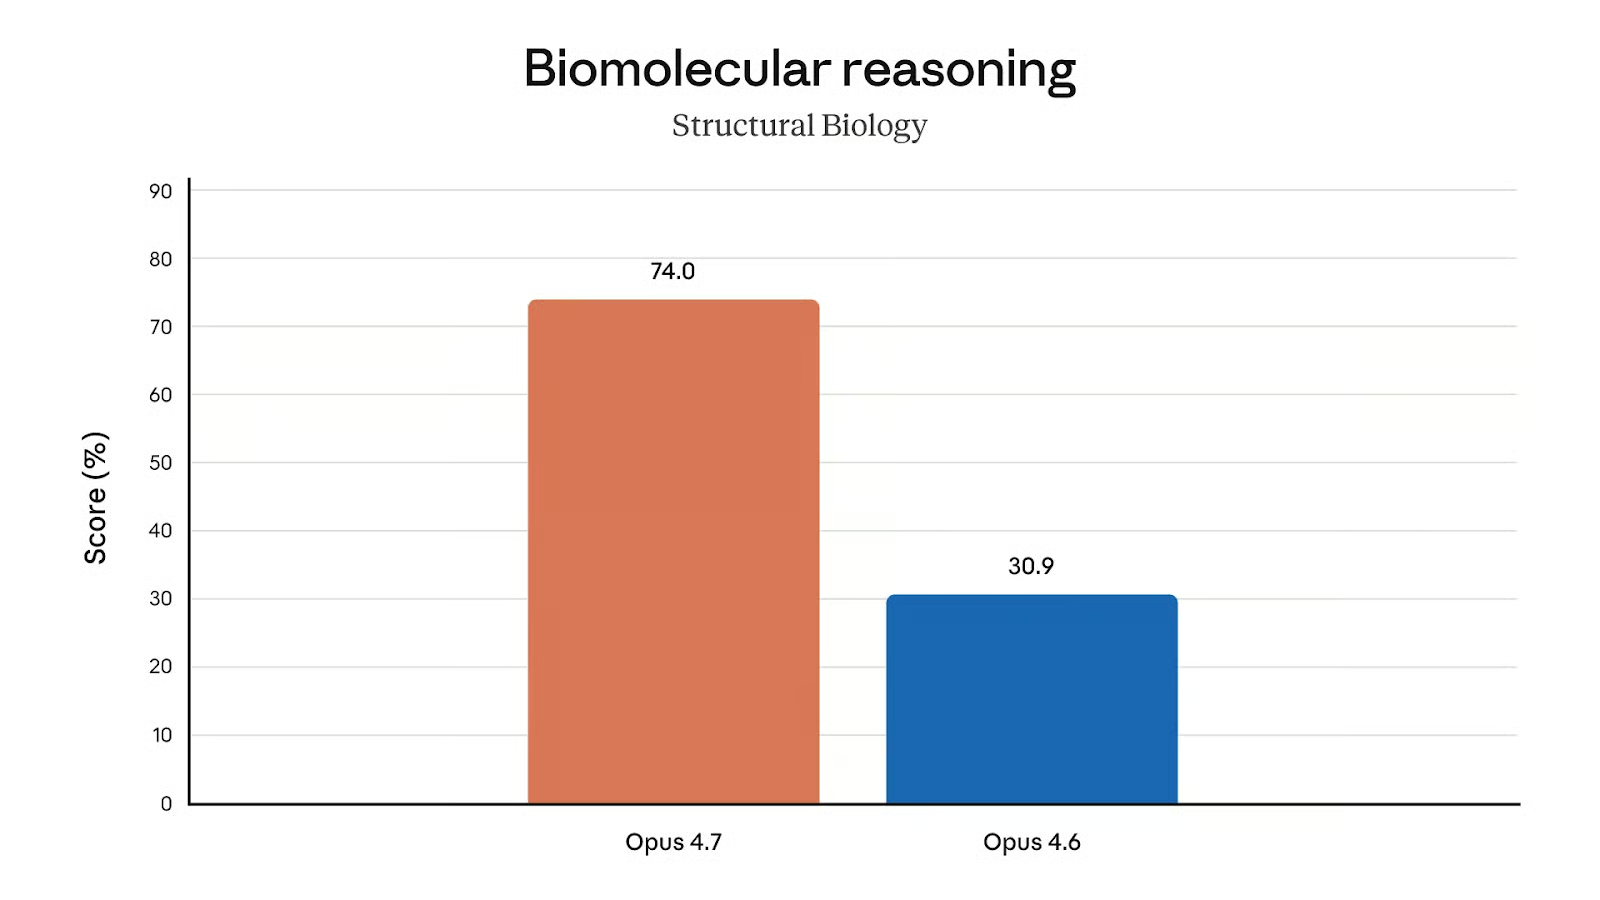
Un risultato di benchmark più interessante riguarda la biologia, uno dei campi testati anche in GPQA-Diamond. Pur non potendolo confrontare con i modelli concorrenti, il salto tra Opus 4.6 (30,9%) e Opus 4.7 (74,0%) merita sicuramente attenzione!
I risultati nel benchmark CharXiv, che misura il ragionamento visivo su grafici e figure scientifiche, riflettono che questa è stata una delle aree di maggiore focus nello sviluppo di Opus 4.7.
Il miglioramento di 13 punti senza strumenti è il guadagno relativo più grande di questo rilascio. Senza punteggi dei concorrenti per confrontare, è difficile dire dove si posizioni Opus 4.7 nel panorama più ampio su questo compito, ma il miglioramento rispetto a Opus 4.6 è sostanziale.
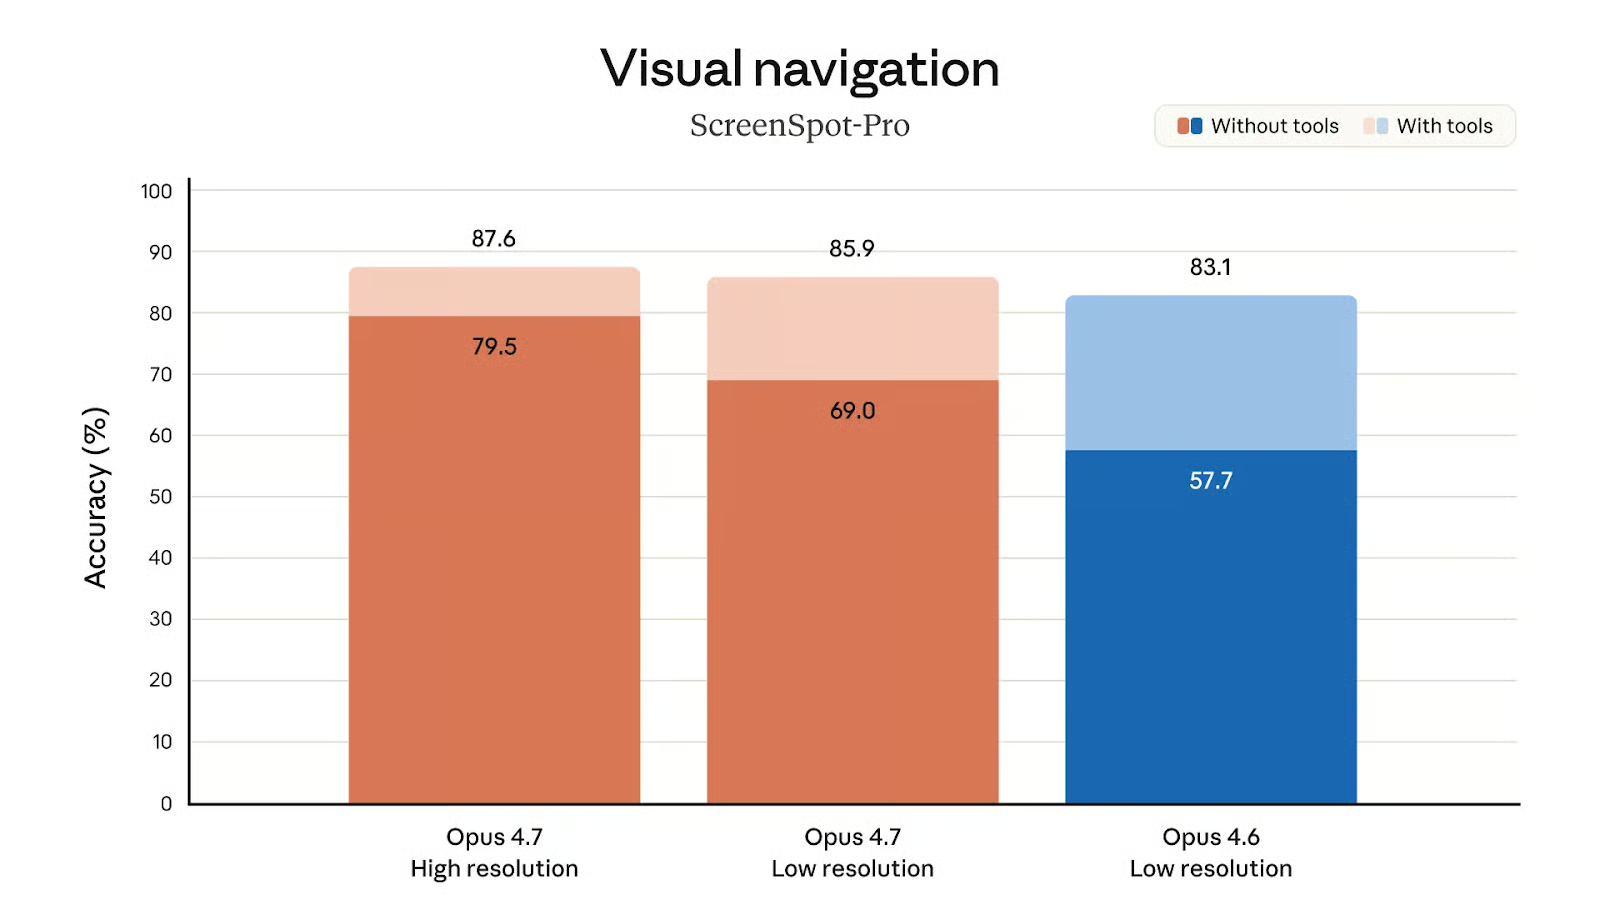
Il supporto per immagini a risoluzione più alta è probabilmente una delle ragioni del miglioramento nel ragionamento visivo. Il grafico dei punteggi Screenspot-Pro a diverse risoluzioni mostra l’enorme incremento di accuratezza che Opus 4.7 ottiene da una risoluzione più elevata, soprattutto senza uso di tool (79,5% vs 69,0%).
MCP-Atlas testa le prestazioni in workflow complessi multi-tool. Opus 4.7 segna 77,3%, il più alto tra tutti i modelli nel confronto. L’unico modello che supera di pochissimo il punteggio MCP-Atlas di Opus 4.7 è Muse Spark, riportato al 78,3%.
OSWorld testa la capacità di un modello di completare task controllando un’interfaccia computer, cliccando, digitando e navigando nelle applicazioni. Opus 4.7 segna 78,0%, in aumento rispetto al 72,7% di Opus 4.6. GPT-5.4 segna 75,0%, e Gemini 3.1 Pro non ha un punteggio pubblicato su questo benchmark. Mythos Preview segna 79,6%, appena sopra Opus 4.7.
Questa è sicuramente un’area in cui Opus 4.7 eccelle: guida sia MCP-Atlas sia OSWorld-Verified con un margine significativo rispetto ai flagship concorrenti di Google e OpenAI, un risultato forte per chi costruisce sistemi agent in produzione che si basano su orchestrazione di tool e agent per l’uso del computer.
Le capacità di analisi finanziaria del modello meritano una menzione d’onore: Opus 4.7 è in cima alla classifica di Finance Agent v1.1 (64,4%), significativamente avanti rispetto a GPT-5.4 (61,5%) e Gemini 3.1 Pro (59,7%).
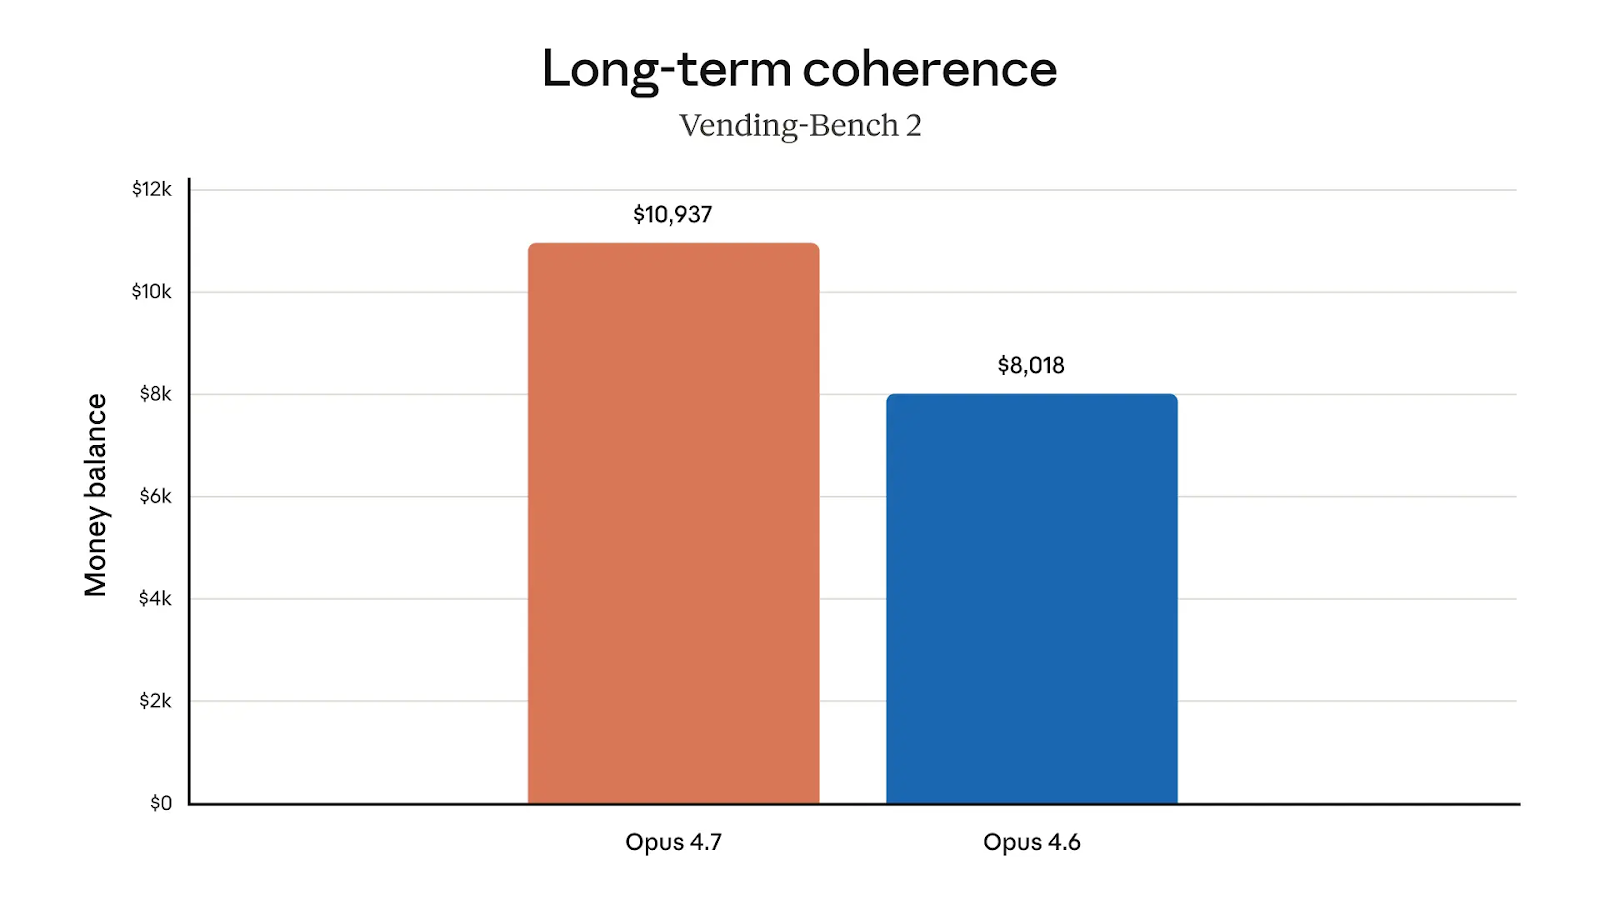
Nel più pratico Vending-Bench 2, vediamo che Opus 4.7 se la cava meglio anche con il denaro. In media, il modello è arrivato a un importo di 10.937 $, rispetto agli 8.018 $ di Opus 4.6.
Anthropic non ci fa aspettare. Opus 4.7 è ora disponibile
In tutti i prodotti Claude
Claude API (claude-opus-4-7)
Microsoft Foundry
Oggi più che mai si teme l’inflazione. Ma per fortuna, il prezzo è lo stesso di Opus 4.6. Sono 5 $ per milione di token in input e 25 $ per milione di token in output. (Non c’è stato aumento tra Opus 4.6 e Opus 4.7.)
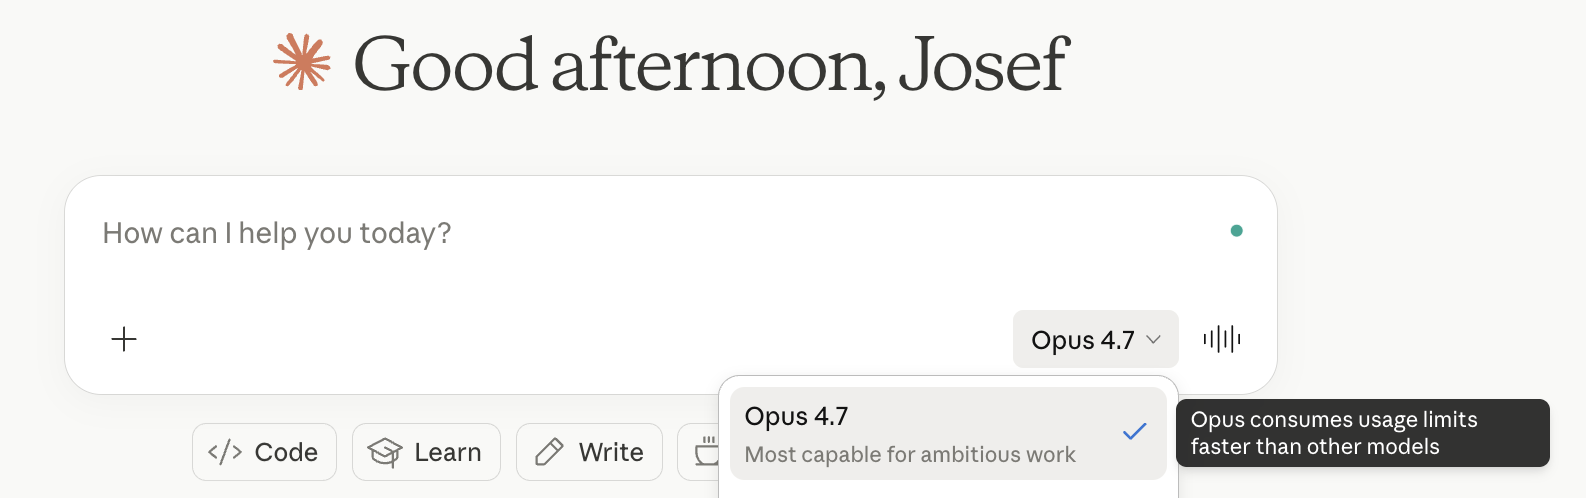
Promemoria generale, se usi Opus su Claude.ai: ogni messaggio che invii include l’intera conversazione fino a quel momento (la tua nuova domanda + tutti i botta e risposta precedenti) più la risposta del modello. Tutto ciò viene misurato in token. Il tuo piano, qualunque esso sia, ha un budget di token che si ricarica a finestra mobile.
Modelli diversi consumano quel budget a tariffe diverse. Opus è il più costoso perché è il più potente. Un rapporto pubblicato indicativo: Opus costa circa 5× rispetto a Sonnet per token.
Anthropic ha distribuito diversi aggiornamenti insieme al modello stesso che vale la pena conoscere, soprattutto se usi Claude Code o sviluppi sull’API.
Un nuovo livello di effort xhigh ("extra high") ora si colloca tra high e max. Ti offre un’altra opzione quando scegli tra profondità di ragionamento e latenza. In Claude Code, il livello di effort predefinito è stato portato a xhigh su tutti i piani, e Anthropic consiglia di iniziare con high o xhigh quando testi Opus 4.7 su task di coding e agentici.
Claude Code ha guadagnato un nuovo comando slash /ultrareview, che esegue un pass dedicato di revisione sulle tue modifiche e segnala bug o problemi di design che un revisore umano attento noterebbe. Gli utenti Pro e Max ottengono tre ultrareview gratuite per provarlo.
Gli utenti Max hanno ora accesso alla modalità auto, un’impostazione di permessi in cui Claude prende decisioni per tuo conto. È una via di mezzo tra approvare ogni passo e saltare del tutto i permessi.
I budget di task sono ora in beta pubblica sulla Claude API. Consentono agli sviluppatori di limitare la spesa in token di Claude su un’esecuzione, particolarmente utile per workflow agentici più lunghi in cui vuoi che il modello si regoli il passo invece di bruciare il budget.
Abbiamo osservato da vicino i risultati dei benchmark, che includevano al loro interno un confronto con altri modelli. A livello generale, confrontiamo direttamente Opus 4.7 con GPT-5.4.
La conclusione di base è che Opus 4.7 ottimizza per l’autonomia a lungo orizzonte. GPT-5.4 è un modello unificato general-purpose con supporto a tool più ampio e prezzi più bassi per contesti corti.
| Claude Opus 4.7 | GPT-5.4 | |
|---|---|---|
| Migliore in | Esecuzioni di coding lunghe, uso del computer desktop, visione densa |
Ricerca via browser, task a contesto breve, steering a metà risposta |
| SWE-bench Pro | 64,3% | 57,7% |
| BrowseComp | 79,3% | 89,3% |
| Prezzi | Tariffa fissa sull’intero contesto da 1M | Più economico sotto 272K, l’intera sessione viene riprezzata sopra |
| Finestra di contesto | ~1M token | ~1M token |
Per il confronto completo con il modello successore di OpenAI, GPT-5.5, vedi il nostro post, Claude Opus 4.7 vs. GPT-5.5.
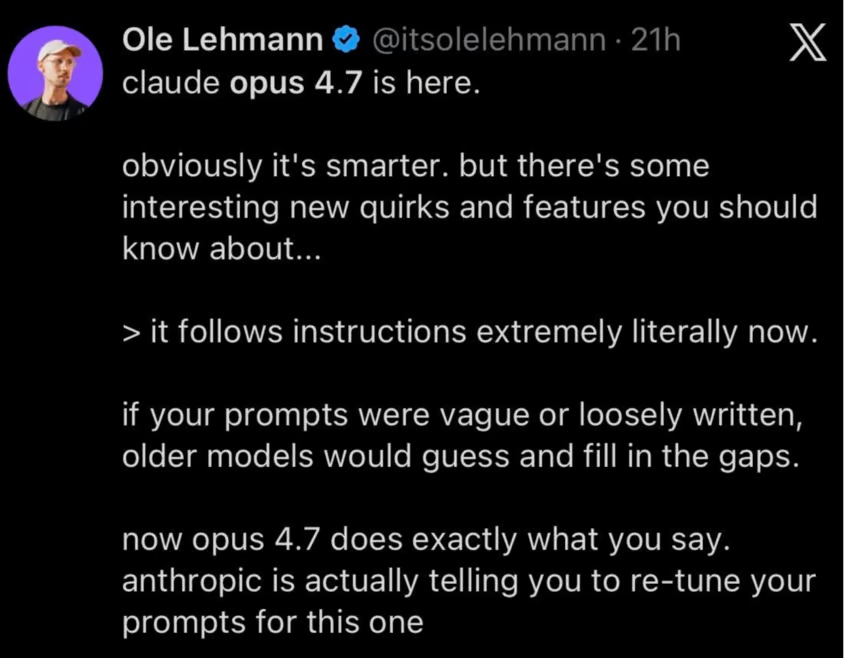
Alcuni utenti segnalano che le loro pipeline stanno dando problemi perché Opus 4.7 segue le istruzioni in modo più letterale di prima. Anthropic ha avvertito della necessità di ri-tarare i prompt.
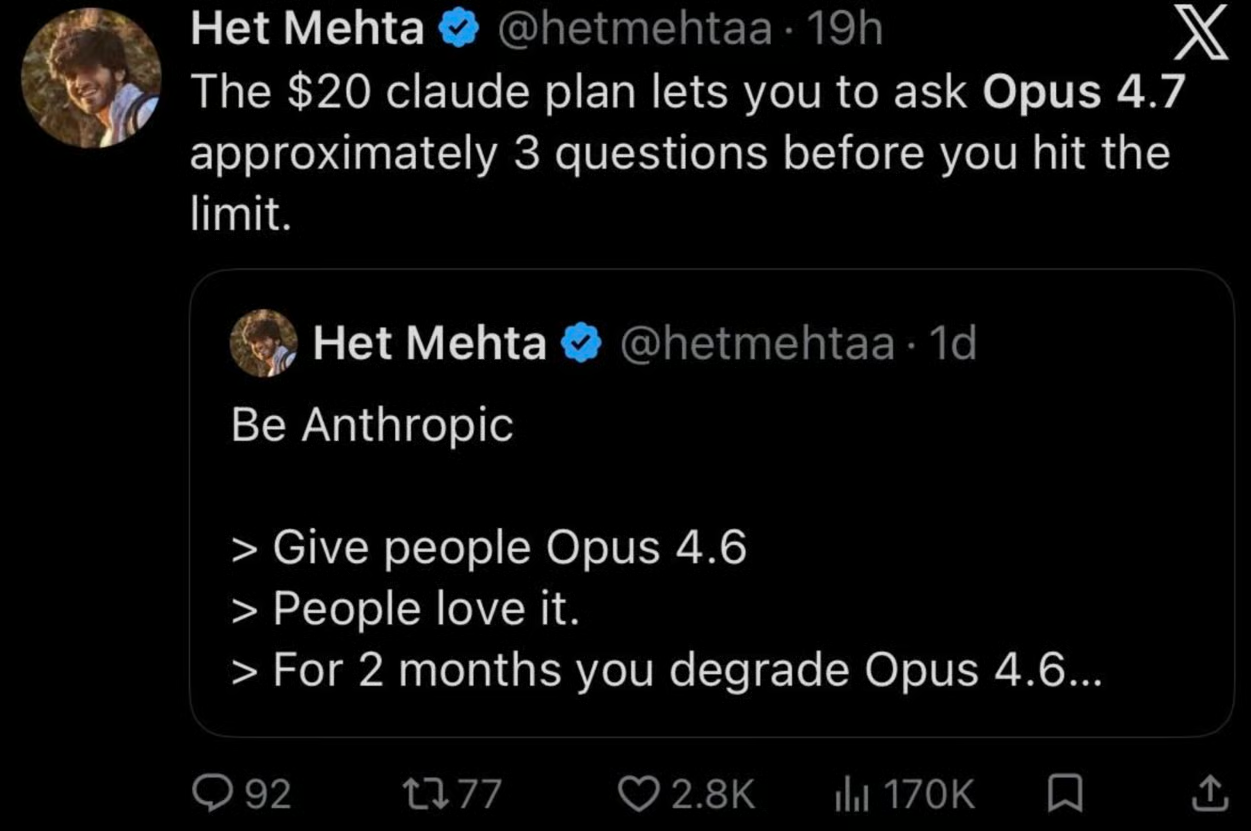
Altri utenti erano preoccupati per l’uso di token. Come parte del rilascio, Anthropic ha alzato i limiti di velocità per tutti gli utenti per tener conto di un uso di token più alto, ma non è del tutto chiaro se sia un vero compenso.
Claude Opus 4.7 è il modello più capace che la maggior parte delle persone può effettivamente usare oggi. I miglioramenti puntano tutti nella stessa direzione: lavori agentici più lunghi e meno supervisionati, con coding più forte, visione più nitida e memoria cross-session migliorata a sostegno.
Ciò che rende interessante questo rilascio è l’inquadramento Mythos. Opus 4.7 è un veicolo di test con vincoli cyber sulla strada verso un rilascio più ampio di classe Mythos, il che significa che ora esiste un soffitto chiaro sopra di esso a cui non puoi accedere — ma anche che le salvaguardie distribuite con la 4.7 sono un’anteprima di come Anthropic intende gestire i rilasci di frontiera in futuro.
Impara con DataCamp
{count, plural, one {Programma} other {Programmi}}
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {blog} other {blogs}}
Abid Ali Awan
15 min
{count, plural, one {blog} other {blogs}}
Abid Ali Awan
10 min
{count, plural, one {blog} other {blogs}}
Tim Lu
12 min