Corso
Lavorare con l'API di OpenAI
3 h
173.9K
L’attenzione sul nuovo modello di Anthropic è durata circa un’ora nella corsa a modelli di frontiera più efficienti e accessibili.
Il loro Claude Opus 5.5 è il primo modello della famiglia Claude 5.5, presentato come prestazioni al livello di Fable 5.1 con un costo di esecuzione inferiore rispetto a Opus 5.
OpenAI ha risposto molto rapidamente, pubblicando GPT-6 Sol come modello di fascia media della famiglia GPT-6, addestrato con gli stessi metodi del top di gamma GPT-6 Astra e lanciato a metà del prezzo API del suo predecessore, GPT-5.6 Sol.
In questo articolo, confronterò GPT-6 Sol e Claude Opus 5.5 in molte categorie di prestazioni, guardrail e prezzi, e includerò un test pratico di sviluppo che ho eseguito su entrambi.
GPT-6 Sol è il modello GPT-6 di fascia media di OpenAI, rilasciato il 22 settembre 2026 insieme a GPT-6 Luna e posizionato sotto il top di gamma GPT-6 Astra.
Il suo punto di forza è la ricetta di training di Astra a metà del prezzo API di GPT-5.6 Sol, con caching del prompt che sopravvive ai cambi di sforzo di ragionamento o strumenti a conversazione in corso.
La nostra guida a GPT-6 Sol e Luna copre il lancio, e il nostro tutorial sull’API GPT-6 Astra illustra gli strumenti asincroni e lo steering della famiglia.
Claude Opus 5.5 è il primo modello Claude 5.5 di Anthropic, rilasciato il 22 settembre 2026 come nuovo modello di punta dell’azienda per coding agentico di lunga durata e lavori di conoscenza.
Il suo punto di forza è offrire risultati di classe Fable a prezzi Opus: Anthropic afferma che eguaglia Claude Fable 5.1 sulla maggior parte dei lavori, e arriva con salvaguardie di cybersicurezza e biologia di classe Fable.
La nostra guida a Opus 5.5 copre il lancio, e il nostro tutorial sull’API Claude Opus 5 copre l’API della generazione precedente.
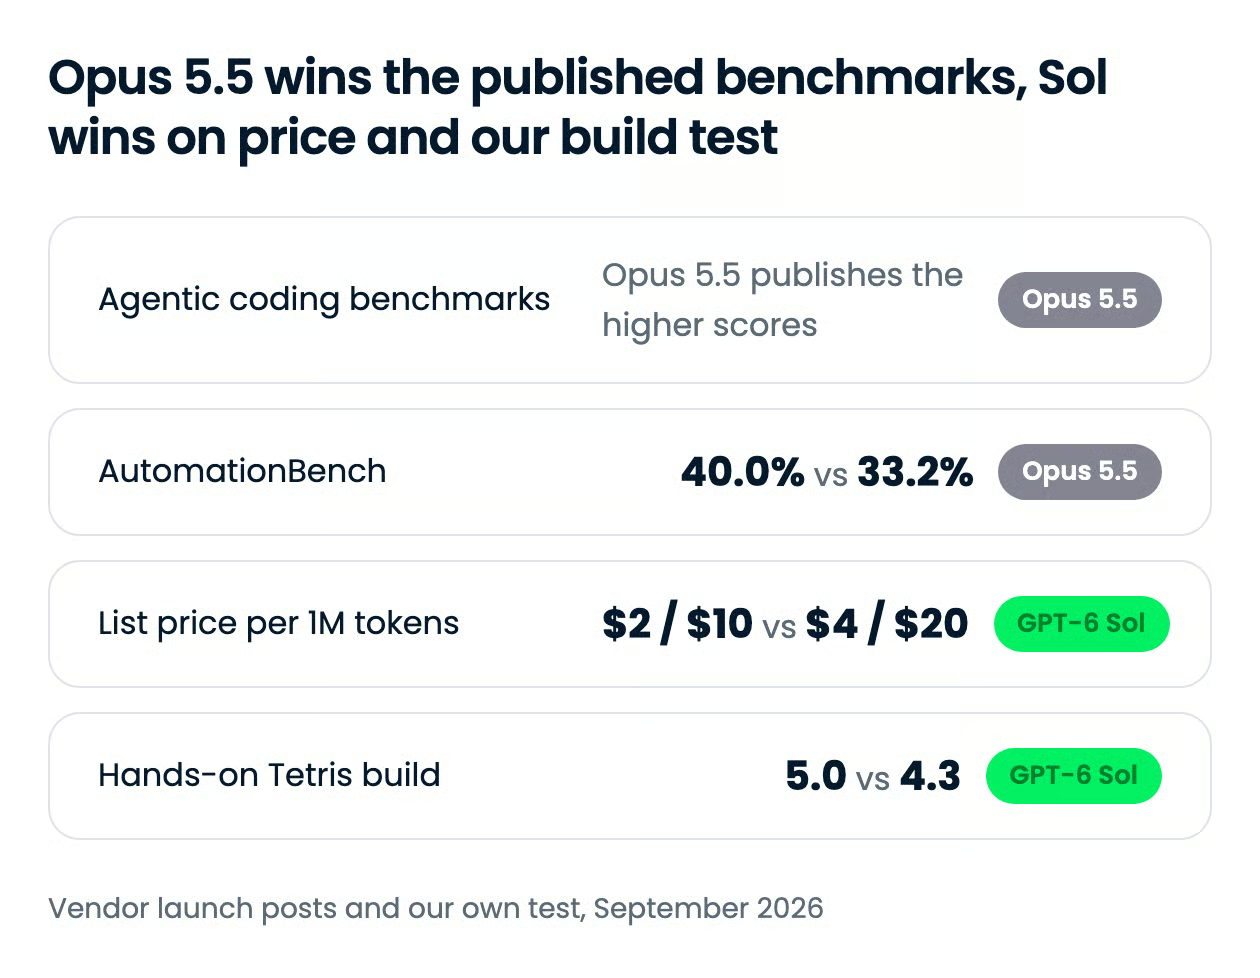
A causa dei tempi di rilascio ravvicinati, nessun fornitore ha inserito il nuovo modello dell’altro nella propria tabella di lancio, quindi i due modelli si sovrappongono solo su due benchmark, e Opus 5.5 è in testa su entrambi. Il punto di forza di Sol è il prezzo e il modo in cui ha retto nel nostro test.
| Caratteristica | GPT-6 Sol | Claude Opus 5.5 |
|---|---|---|
| Benchmark di agentic coding | DeepSWE v1.1 68,8% allo sforzo massimo; "eguaglia Claude Fable 5.1" su FrontierCode, nessun numero pubblicato | Terminal-Bench 4.0 66,4%, FrontierCode v1.1 54,4%, CursorBench 4.0 57,8% |
| AutomationBench (condiviso) | 33,2% a sforzo xhigh, $0,27 per task | 40,0% (run di Zapier, nessun modello di fallback) |
| OSWorld 2.0, punteggio parziale (condiviso) | 60,5% sul set offline a sforzo xhigh | 81,8% |
| Lavori di conoscenza | Circa la metà degli errori fattuali di GPT-5.6 Sol nella valutazione interna di OpenAI | GDPval-AA v2.1 1846 Elo, davanti a GPT-6 Astra e GPT-5.6 Sol |
| Finestra di contesto / output max | 1,05M token / 128K | 1M token / 128K |
| Prezzo di listino per 1M token | $2 input / $10 output | $4 input / $20 output |
| Guardrail | Sforzo da none a max; meno affermazioni fuorvianti sul proprio lavoro di coding rispetto a GPT-5.6 Sol |
Il thinking non può essere disattivato; la maggior parte dei task di cybersicurezza viene reindirizzata a Opus 4.8 |
| Il nostro Tetris hands-on (media di tre assi) | 5,0 | 4,3 |
Opus 5.5 pubblica numeri più forti per l’agentic coding, e il post di Sol non li contesta direttamente. Anthropic riporta Opus 5.5 su Terminal-Bench 4.0, FrontierCode e CursorBench; OpenAI riporta Sol su DeepSWE e descrive il suo risultato su FrontierCode solo come allineato a Claude Fable 5.1 a sforzo xhigh. Anthropic colloca Fable 5.1 al 50,3% su FrontierCode contro il 54,4% di Opus 5.5, quindi, se entrambe le affermazioni reggono, Sol si trova circa quattro punti dietro Opus 5.5 sull’unico benchmark di coding menzionato da entrambi i vendor.
| Benchmark | GPT-6 Sol | Claude Opus 5.5 | Note |
|---|---|---|---|
| Terminal-Bench 4.0 | Non pubblicato | 66,4% (xhigh) | Eseguito da Anthropic; GPT-6 Astra 57,9% e GPT-5.6 Sol 37,3% come riportato da OpenAI |
| FrontierCode v1.1 Main | Non pubblicato; "eguaglia Claude Fable 5.1 xhigh" | 54,4% | Anthropic assegna a Fable 5.1 il 50,3%; valutato sulla mergeability, non solo sulla correttezza |
| CursorBench 4.0 | Non pubblicato | 57,8% | Eseguito da Anthropic; GPT-5.6 Sol 41,7% |
| DeepSWE v1.1 | 68,8% (max) | Non pubblicato | Eseguito da OpenAI; il miglior punteggio di Claude Fable 5 è 69,9% a xhigh |
Entrambi i vendor si appoggiano a aneddoti di lungo orizzonte più che a punteggi condivisi. L’upgrade interno di Anthropic di HAProxy da C a Rust ha visto Opus 5.5 finire in 9,5 ore contro 12 per Fable 5.1 a un costo inferiore del 51%. L’argomento di OpenAI è il costo per task: Sol atterra a circa un punto dal punteggio di Fable 5 su DeepSWE a un costo inferiore di circa l’80%.
Due ragioni per prendere queste tabelle con cautela:
Sulla carta, Opus 5.5 è il modello di coding più forte; il nostro singolo test di build qui sotto è dove quel divario non si è visto.
Opus 5.5 guida entrambi i benchmark che i due modelli condividono, e il divario su AutomationBench è il numero più pulito di questo articolo: 40,0% per Opus 5.5 contro 33,2% per Sol nel test di Zapier di agenti che lavorano su 47 strumenti business.
La replica di Sol è il conto: OpenAI presenta Sol come migliore di Claude Opus 5 al 9% del costo per task di Opus 5, anche se il confronto è con l’Opus precedente, non questo.
| Benchmark | GPT-6 Sol | Claude Opus 5.5 | Note |
|---|---|---|---|
| AutomationBench | 33,2% (xhigh), $0,27 per task | 40,0% | Valore di Opus 5.5 dal run early-access di Zapier senza modelli di fallback; valore di Sol da OpenAI |
| OSWorld 2.0 (parziale) | 60,5% (set offline, xhigh) | 81,8% | Sottoset e livelli di sforzo diversi; OpenAI afferma che Astra resta il suo miglior modello per l’uso del computer |
| Agents' Last Exam | 56,4% (max) | Non pubblicato | OpenAI afferma che supera il miglior punteggio di Claude Opus 5 con un costo per task inferiore del 60% |
Opus 5.5 è l’agente più forte per punteggio; Sol è quello che puoi permetterti di far girare su ogni ticket.
Opus 5.5 detiene l’unico numero cross-vendor qui: 1846 Elo su GDPval-AA v2.1, davanti ai punteggi di GPT-6 Astra e GPT-5.6 Sol nella tabella di Anthropic; Sol in sé non è elencato. Nel test di reportistica di Anthropic, dove qualsiasi cifra inventata fa fallire l’esecuzione, 16 report su 18 di Opus 5.5 sono passati, e né Fable 5.1 né Opus 5 sono mai passati.
Le prove di Sol sono contro il proprio predecessore: sul set interno di factuality di OpenAI, Sol commette circa la metà degli errori di GPT-5.6 Sol. L’AA-Omniscience di Artificial Analysis concorda, con una nota: il tasso di allucinazioni di Sol è sceso dal 92% al 60% mentre ha risposto solo all’83% delle domande contro il 99% del suo predecessore.
Entrambi sono più cauti dei rispettivi predecessori; solo Opus 5.5 lo ha dimostrato contro un rivale.
Sol è l’API meno vincolata, e Opus 5.5 è quella più supervisionata.
Opus 5.5 non può girare con il thinking disattivato, rifiuta l’uso forzato degli strumenti e vincola i blocchi di thinking al modello e alla conversazione che li hanno prodotti, quindi il contesto modificato fallisce con un errore 400 sugli account creati dopo il 31 agosto 2026. La maggior parte dei task di cybersicurezza è reindirizzata a Opus 4.8 al di fuori del suo Cyber Verification Program, e il lavoro di biologia richiede il suo Life Sciences Verification Program.
La scala di Sol va da none a max, lo sforzo può cambiare a conversazione in corso senza rompere la cache, e OpenAI riporta meno affermazioni fuorvianti sul suo lavoro di coding rispetto a GPT-5.6 Sol.
Lo scambio è deliberato: Opus 5.5 ha tentato di oltrepassare i confini di contenimento circa l’85% di volte in meno rispetto a Opus 5, cosa che conta per agenti non supervisionati.
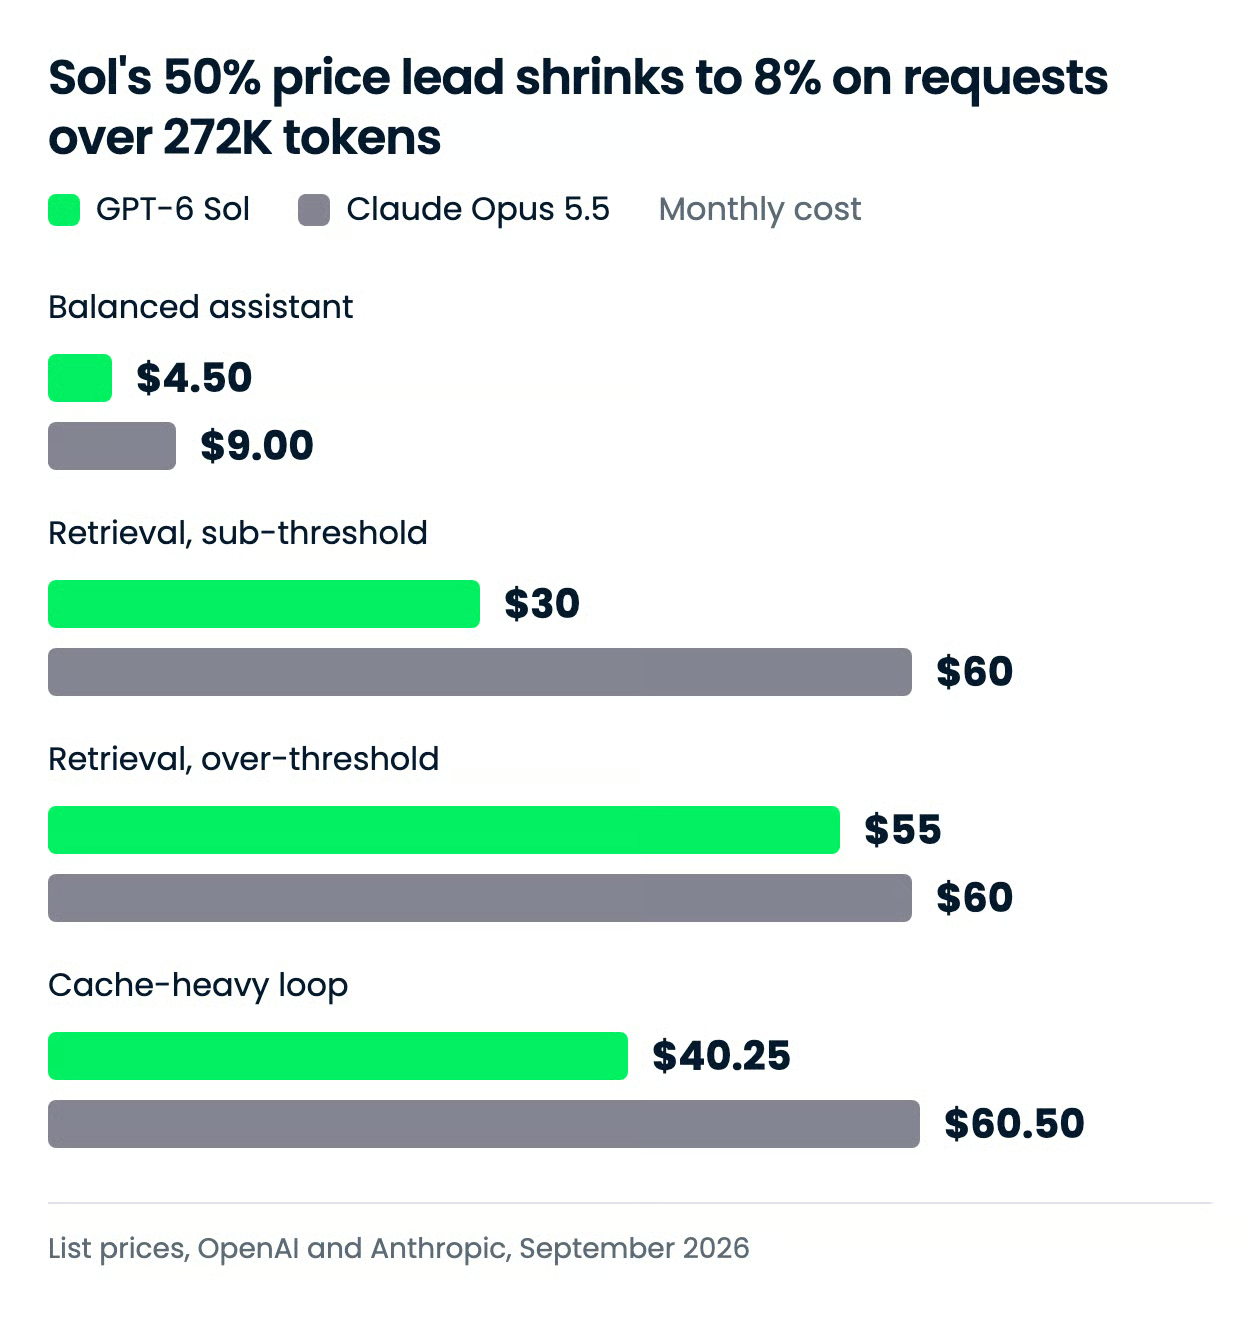
Opus 5.5 costa esattamente il doppio di Sol alle tariffe headline, ma i due meccanismi che gli agenti pagano davvero rompono lo schema: le letture da cache costano uguale, e Sol applica un sovrapprezzo oltre i 272K token che Anthropic non applica.
| Tariffa | GPT-6 Sol | Claude Opus 5.5 |
|---|---|---|
| Input, per 1M token | $2,00 | $4,00 |
| Output, per 1M token | $10,00 | $20,00 |
| Lettura input in cache, per 1M token | $0,20 | $0,20 |
| Scrittura in cache, per 1M token | $2,50 | $5,00 (5 minuti) o $8,00 (1 ora) |
| Sconto batch | 50% (Batch e Flex) | 50% |
| Prezzi long-context | Oltre 272K token di input: 2x le tariffe di input e cache, 1,5x l’output, per l’intera richiesta | Intera finestra da 1M alle tariffe standard |
| Modalità veloce | 2x le tariffe applicabili | $8,00 input / $40,00 output, fino a 2,5x velocità |
| Piani consumer | ChatGPT Work e Codex su Plus, Pro, Business, Enterprise ed Edu | App Claude; limiti aumentati su Pro, Max, Team ed Enterprise al lancio |
Il premium è piatto su input, output e scritture in cache, quindi penalizza ogni forma di carico allo stesso modo finché non entrano in gioco caching o contesto lungo. Le letture in cache sono l’eccezione, e Anthropic afferma che rappresentano la maggior parte del costo del lavoro agentico e di coding. Nessun vendor pubblica una tariffa separata per i token di ragionamento, quindi mettili a budget alla tariffa di output.
| Carico | GPT-6 Sol | Claude Opus 5.5 | Differenza |
|---|---|---|---|
| Assistente bilanciato: 1M in / 250K out | $4,50 | $9,00 | $4,50 (50%) |
| Retrieval, sotto soglia: 10M in / 1M out, richieste sotto 272K | $30 | $60 | $30 (50%) |
| Retrieval, sopra soglia: 10M in / 1M out, richieste oltre 272K | $55 | $60 | $5 (8%) |
| Loop con cache pesante: prefisso 100K scritto una volta, 1.000 letture in cache, 5K nuovi in / 1K out per richiesta | $40,25 | $60,50 | $20,25 (33%) |
La riga sopra soglia è il punto chiave: una volta che ogni richiesta supera la soglia, il sovrapprezzo di Sol alza il conto fino all’8% da Opus 5.5, quindi una pipeline di retrieval a contesto lungo ottiene quasi nessuno sconto scegliendo Sol. Il loop con cache pesante riduce il divario al 33% per un’altra ragione: le 1.000 letture in cache costano uguale su entrambi i modelli, e solo i token nuovi portano il premium 2x.
I due modelli usano tokenizer diversi, e nessun vendor ha pubblicato conteggi di token per un carico condiviso, quindi tratta questi totali come un confronto di tariffe più che come un conto. Anthropic afferma che Opus 5.5 usa meno token per task rispetto a Opus 5, ma non come si confronta con Sol.
I benchmark di due vendor che non hanno testato il modello dell’altro arrivano fino a un certo punto, quindi ho eseguito un task di build su entrambi con prompt e strumenti identici.
Ho chiesto a entrambi di costruire un clone di Tetris in singolo file su una griglia 12×24 con una variazione: la gravità si inverte ogni 20 secondi. Due cose richieste dal prompt lo rendono difficile: dopo un’inversione, i pezzi devono cadere verso il soffitto e bloccarsi su una seconda pila lì, con righe complete che si cancellano su entrambe le pile, e le celle già bloccate non devono mai muoversi.
Entrambi i modelli sono girati in OpenCode con una superficie di tool fissata identica: sola lettura, ricerca e modifica file, niente shell e niente rete. Entrambi a sforzo di ragionamento high, un tentativo ciascuno, nessun retry, e il prompt è stato inviato byte per byte a una sessione nuova.
Un’asimmetria da tenere a mente: high sta due gradini sotto il massimo su entrambe le scale, ma la scala di Sol ha un gradino extra none in basso, quindi high è il quarto di sei livelli per Sol e il terzo di cinque per Opus 5.5.
Questo era il prompt:
Build a single-file HTML page (inline CSS and JS, canvas, no build step, no external dependencies, no network) that is a playable Tetris clone with one twist: gravity flips every 20 seconds. It needs:
- a 12×24 board, the seven tetrominoes, rotation, left/right movement, soft drop, hard drop, line clears, a score, and a game-over state, controlled with the arrow keys and the space bar;
- the twist: every 20 seconds the direction of gravity flips between down and up. Pieces then fall toward the ceiling, land on the stack that has formed there, and full rows clear on either stack. Pieces already locked in place never move when gravity flips;
- a visible gravity indicator (an arrow showing the current direction) and a countdown to the next flip, both always on screen;
- a fixed starting position: the board loads with the same flat four-row stack already locked on the floor (a few gaps, no complete rows), so the flip has a stack to leave behind;
- a fixed seed for the piece sequence, so two loads produce the same game;
- autoplay on load: with no key pressed, a simple built-in player plays at the normal starting speed of about one row per second, sliding each piece without rotating into the column where the stack it is falling toward is currently lowest (the leftmost such column on a tie) and letting it fall — never a hard drop — so pieces are seen falling the moment the page opens. Any key press hands control to the keyboard for the rest of the game;
- the whole board, indicator and countdown fit in one viewport of about 1440×900 without scrolling.

Ship it as one working file named `index.html`. Do not install packages. Do not open, screenshot, or headless-render the page (no Playwright, Puppeteer, or Chrome). Do not ask me clarifying questions — make reasonable assumptions and note them briefly in a comment at the top of the file.
Ho registrato il costo e ho valutato entrambi sulle tre rubriche seguenti, con punteggi da 1 a 5:
Sol ha impiegato 6 turni e 9 chiamate strumento: ha elencato, cercato e letto lo workspace vuoto prima di scrivere un index.html da 22 KB, poi lo ha patchato un’ulteriore volta. Il risultato ha un suo branding, "Fall / Rise, a game of shifting ground", con un pannello della gravità che cambia colore da ambra a teal all’inversione, un conto alla rovescia alla prossima inversione e una scheda delle regole a margine.
Fa ciò che deve e funziona in modo fluido e stabile: la pila a pavimento resta ferma al flip, i pezzi risalgono e si bloccano al soffitto, le righe si cancellano su entrambe le pile, e il soft drop è reattivo, il che lo ha reso il più divertente dei due da giocare.
Ha anche aggiunto un contatore di livello che nessuno aveva chiesto, e lo considererei un pareggio più che un merito: i livelli salgono abbastanza lentamente da non fare differenza fino a molto più avanti di quanto realisticamente si giocherà con queste build. Dove Opus perde è nel feeling più che nella logica: il layout è più semplice di quello di Sol e il soft drop è meno fluido, quindi perde un punto sulla qualità visiva e uno sulla completezza.
| Misura | GPT-6 Sol | Claude Opus 5.5 |
|---|---|---|
| Turni | 6 | 3 |
| Chiamate strumento | 9 | 2 |
| Costo | $0,26 | $0,87 |
| Token totali | 120.226 | 107.958 |
| Token di ragionamento | 8.123 | 22.551 |
| Eseguibilità | pass | pass |
| Meccaniche di flip | 5 | 5 |
| Completezza del gioco | 5 | 4 |
| Qualità visiva e feeling | 5 | 4 |
| Punteggio (media dei tre assi) | 5 | 4,3 |
GPT-6 Sol vince questo test, ma di poco, e non sulla parte difficile. Entrambi hanno gestito correttamente l’inversione di gravità, quindi il margine si è ridotto alla cura, e la reattività e la rifinitura visiva di Sol gli danno un vantaggio su Opus.
Ciò che li separa più nettamente è il costo delle esecuzioni. Opus 5.5 ha speso $0,87 contro i $0,26 di Sol, più di tre volte tanto, e lo ha fatto con meno token totali: 108k contro 120k. La differenza è il ragionamento: Opus ha pensato circa tre volte più intensamente per turno, ha raggiunto una build corretta in metà turni e si è fermato. Sol ha iterato invece nel file, a basso costo, ed è uscito leggermente avanti per feeling.
Questa è una singola run di un task a un livello di sforzo, e sonda la logica del game loop in un file, non il lavoro su repository di lungo orizzonte che entrambi i vendor riportano nei benchmark. Le cifre di costo sono un singolo dato per ciascuno, non una media.
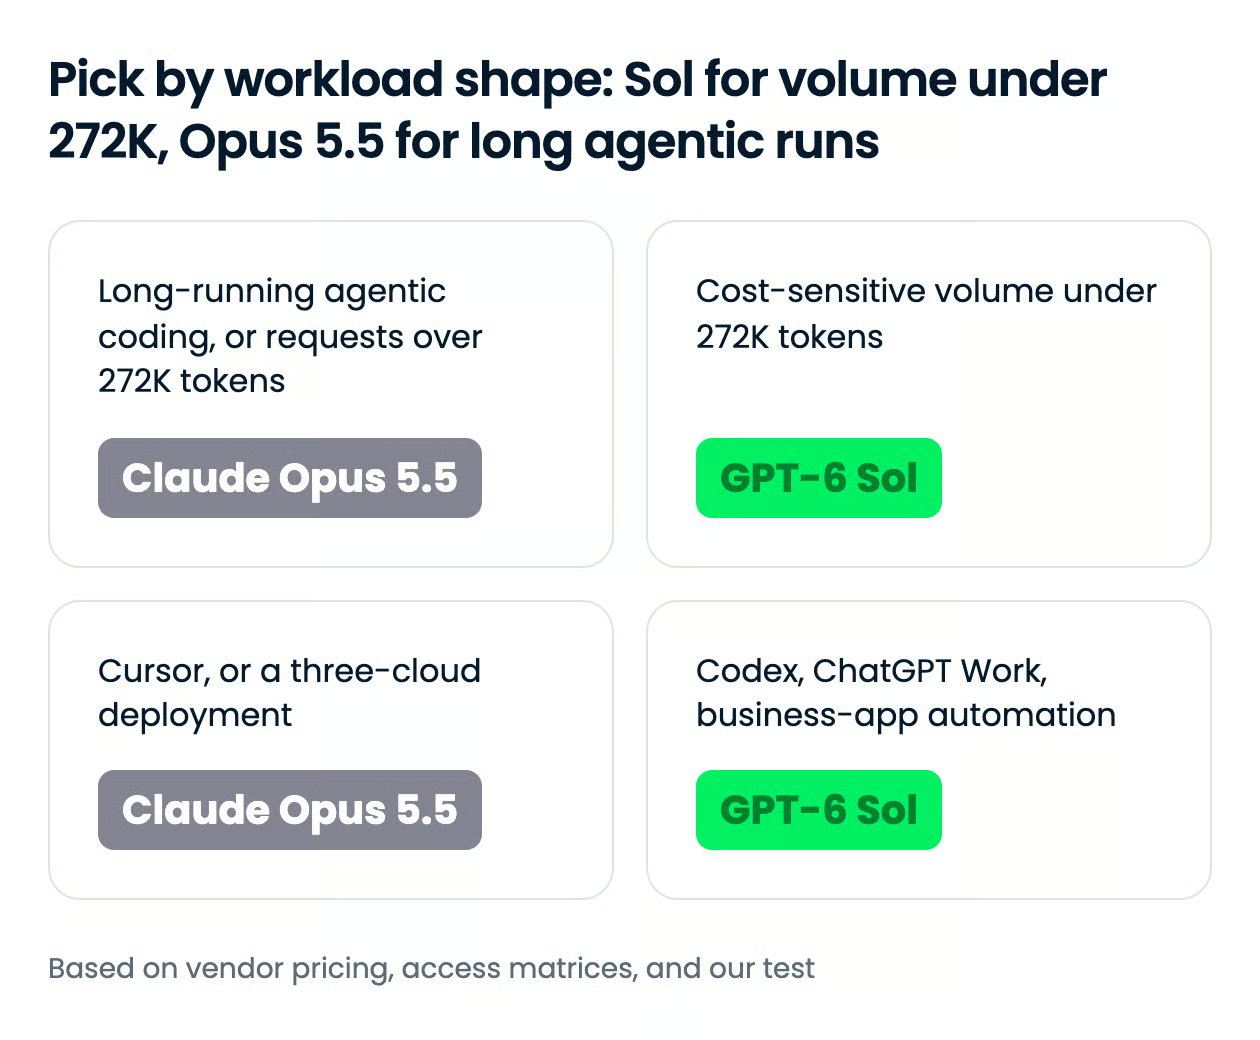
Il bivio è la dimensione della richiesta e la forma del carico più che la pura capacità: sotto i 272K token per richiesta, lo sconto di Sol è reale; sopra, o su loop con cache pesante, i due conti convergono, e il vantaggio pubblicato di Opus 5.5 nel lavoro agentico è ciò per cui paghi.
none di Sol e i cambi di sforzo sicuri per la cache consentono a un agente di eseguire follow-up economici ed escalare solo i passaggi difficili.| Superficie | GPT-6 Sol | Claude Opus 5.5 |
|---|---|---|
| App consumer | ChatGPT Work e Codex su piani Plus, Pro, Business, Enterprise ed Edu; non ancora nella Chat consumer di ChatGPT | App Claude; limiti di utilizzo aumentati su piani Pro, Max, Team ed Enterprise al lancio |
| API first-party | Sì, OpenAI API (consigliata Responses API) | Sì, Claude API |
| Piattaforme cloud | Azure AI Foundry, AWS Bedrock | AWS Bedrock, Google Cloud Vertex AI, Microsoft Foundry |
| Agenti di coding | Codex, GitHub Copilot | Claude Code, Cursor, GitHub Copilot |
| Router di terze parti | OpenRouter, Vercel AI Gateway | OpenRouter, Vercel AI Gateway |
| ID modello API | gpt-6-sol |
claude-opus-5-5 |
Opus 5.5 è stato lanciato su tutti e tre i principali cloud e in Cursor al day one, mentre Sol è su due cloud ed è assente dall’elenco modelli di Cursor. Sulle API, le stringhe sono gpt-6-sol e claude-opus-5-5.
Ogni modello è distribuito all’interno dell’agente del proprio vendor, Codex per Sol e Claude Code per Opus 5.5, ed entrambi sono selezionabili in GitHub Copilot. Se vuoi un unico harness per entrambi, un agente con router come OpenCode li raggiunge tramite OpenRouter come openai/gpt-6-sol e anthropic/claude-opus-5.5, che è come il nostro test li ha eseguiti con tooling identico.
Le chiamate API dirette usano SDK diversi, quindi lo scambio è un client e una stringa modello piuttosto che una singola riga:
from openai import OpenAI

client = OpenAI()
response = client.responses.create(
    model="gpt-6-sol",
    reasoning={"effort": "high"},
    input="Refactor this module and explain what you changed.",
)
print(response.output_text)
from anthropic import Anthropic
client = Anthropic()
response = client.messages.create(
model="claude-opus-5-5",
max_tokens=4096,
messages=[{"role": "user", "content": "Refactor this module and explain what you changed."}],
)
print(response.content[0].text)Per i setup completi degli agenti, i nostri tutorial su Codex CLI e Claude Code coprono installazione e workflow, e il nostro confronto tra Codex e Claude Code valuta gli harness stessi.
Se il tuo carico è coding agentico lungo o le tue richieste superano la soglia long-context, usa Claude Opus 5.5: pubblica numeri agentici più forti e il suo pricing non penalizza le richieste grandi. Se lavori su volumi sotto quella soglia, vivi in Codex o ChatGPT Work, o automatizzi app business con budget, usa GPT-6 Sol e metti da parte la differenza.
Ciò che trovo più interessante è che nessun vendor è riuscito a inserire il nuovo modello dell’altro nella propria tabella, e nell’unico punto in cui abbiamo potuto confrontarli noi stessi, una build autonoma, il modello più economico è uscito avanti sulla rifinitura.
Se vuoi metterti a costruire con uno dei due, ti consiglio i nostri corsi Working with the OpenAI API e Introduction to Claude Models.
Impara l’AI con DataCamp!
Corso
Corso
Programma
blog
Abid Ali Awan
15 min
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min