Vai al contenuto principale

Che cos'è Seedance 2.0? Guida con esempi

Scopri l’input quad‑modale e le funzionalità di riferimento del modello di generazione video Seedance 2.0. Come funziona, come accedervi e come si confronta con Sora 2.
Aggiornato 29 set 2026  · 15 min leggi

Scopri con l'IA

ChatGPTClaudePerplexity

È questo il “momento DeepSeek” per la generazione video? ByteDance ha appena rilasciato in sordina il suo modello di generazione video Seedance 2.0 e i primi video realizzati con esso stanno diventando virali.

In questa guida ti spiegherò cos’è Seedance, le sue caratteristiche principali e come funziona sotto il cofano. Ti mostrerò anche esempi del nuovo modello di generazione video in azione e confronterò punti di forza e debolezze con altri modelli di spicco. Può mettere in discussione Veo 3.1 di Google, Sora 2 di OpenAI e Kling 3.0 di Kuaishou?

Che cos'è Seedance 2.0? 

Seedance 2.0 è il più recente modello generativo di ByteDance per text-to-video e image-to-video, rilasciato il 10 febbraio 2026.

Fonte: Aleena Amir su X

Poiché ByteDance non ha pubblicato una nota di rilascio ufficiale in inglese per Seedance 2.0, la maggior parte delle specifiche pubbliche e delle affermazioni sulle funzionalità sono ricostruite da resoconti in cinese sul rollout di Jimeng. Molte “schede tecniche” su siti wrapper di terze parti sembrano riecheggiare le stesse fonti anziché documentazione ufficiale ByteDance.

Secondo test dei media cinesi e documentazione dei primi partner, Seedance 2.0 promette output video 2K di livello cinema con un’eccellente coerenza dei personaggi.

Come posso accedere a Seedance 2.0?

Ufficialmente, Seedance 2.0 è disponibile all’interno di Jimeng di ByteDance nella Cina continentale, dove è accessibile ai membri a pagamento (ad es., livelli ≥69 RMB riportati dai media cinesi). In pratica, l’accesso a Jimeng è centrato sulla Cina, e verifica dell’account e metodi di pagamento locali sono tipici punti di attrito.

La landing page di Seedance 2.0 è già visibile. Tuttavia, l’accesso effettivo è al momento limitato: la maggior parte degli utenti vedrà un messaggio "Coming Soon" fino al rollout completo, previsto dalle fonti del settore intorno al 24 febbraio 2026. 

Nel frattempo, il workaround più popolare tra gli utenti internazionali è ChatCut, un’app video AI di terze parti che ha integrato direttamente Seedance 2.0 e offre accesso globale anticipato senza richiedere un numero di telefono cinese. Al momento, c’è una lista d’attesa per iscriversi.

Come funziona Seedance?

Come Sora 2 e Veo 3.1, Seedance 2.0 è un modello di diffusione. Ciò significa che genera video partendo da fotogrammi di rumore statico e trasformandoli gradualmente in molti passaggi per rivelare una sequenza video coerente. 

Tuttavia, a differenza dei primi modelli text-to-video che trattavano il video come una clip silenziosa in un’unica inquadratura, Seedance 2.0 è progettato come un “regista multimodale” capace di gestire suono, struttura narrativa e riferimenti visivi complessi in un’unica passata.

Dirigere la scena con input quad‑modali

In passato, ottenere esattamente ciò che volevi da un’IA richiedeva “prompt engineering”, ovvero scrivere descrizioni testuali lunghe e complesse sperando che l’IA capisse. Seedance 2.0 sostituisce questi tentativi con un sistema di input quad‑modale per dirigere la scena.

“Quad‑modale” significa che Seedream può gestire input di testo, immagine, video e audio. L’encoder quad‑modale non è un unico imbuto, ma un insieme di encoder preaddestrati per ciascun tipo di dato:

  • Testo elaborato da un encoder basato su LLM per estrarre il significato semantico
  • Immagini codificate in token di caratteristiche visive (patch)
  • Video di riferimento codificati in token spaziotemporali (patch 3D)
  • Audio codificato in token di forma d’onda o spettrogramma

Di conseguenza, tutti e quattro gli input grezzi vengono convertiti in un linguaggio unificato di vettori latenti per rappresentare matematicamente gli input.

Pianificare le storie con logica multi‑shot

Un’altra grande frustrazione con i vecchi strumenti video IA era il limite del singolo shot. Se chiedevi una storia, l’IA cercava di comprimere tutto in una ripresa continua e non montata. Con durate di solito limitate a pochi secondi, spesso ne risultavano deformazioni strane o parti del prompt ignorate. 

Seedance 2.0 introduce un pianificatore narrativo per risolvere il problema con una logica multi‑shot. Prima di generare un singolo pixel, questo planner si comporta come uno storyboard artist. Legge il tuo prompt e lo scompone in una sequenza di inquadrature distinte. 

Per esempio, può iniziare con un campo lungo di una città, poi passare a un mezzo busto di una persona e infine a un primissimo piano del viso, il tutto senza necessità di istruzioni dettagliate. Quindi orchestra la generazione di queste inquadrature in sequenza.

Usa dati di coerenza condivisi per garantire che volto, abiti e illuminazione della persona restino identici in ogni stacco. Il risultato sembra una sequenza montata da film piuttosto che una clip video “allucinata”.

Combinare diffusione con due modelli transformer

La maggior parte dei modelli video IA funziona come una cinepresa muta: genera prima il video e devi aggiungere il suono dopo con uno strumento separato. Questo spesso porta a “deriva”, dove il rumore di passi o una porta che sbatte non corrispondono del tutto all’azione su schermo. 

Seedance 2.0 risolve con un transformer di diffusione a doppio ramo con un transformer dedicato al video e l’altro all’audio.

Pensalo come un cervello con due emisferi che lavorano in perfetta sincronia. Un emisfero si concentra interamente sui fotogrammi video, mentre l’altro genera la forma d’onda audio. Poiché comunicano costantemente durante la creazione, il modello fa sì che quando avviene un evento visivo (come un bicchiere che si rompe), il suono corrispondente venga generato esattamente allo stesso millisecondo.
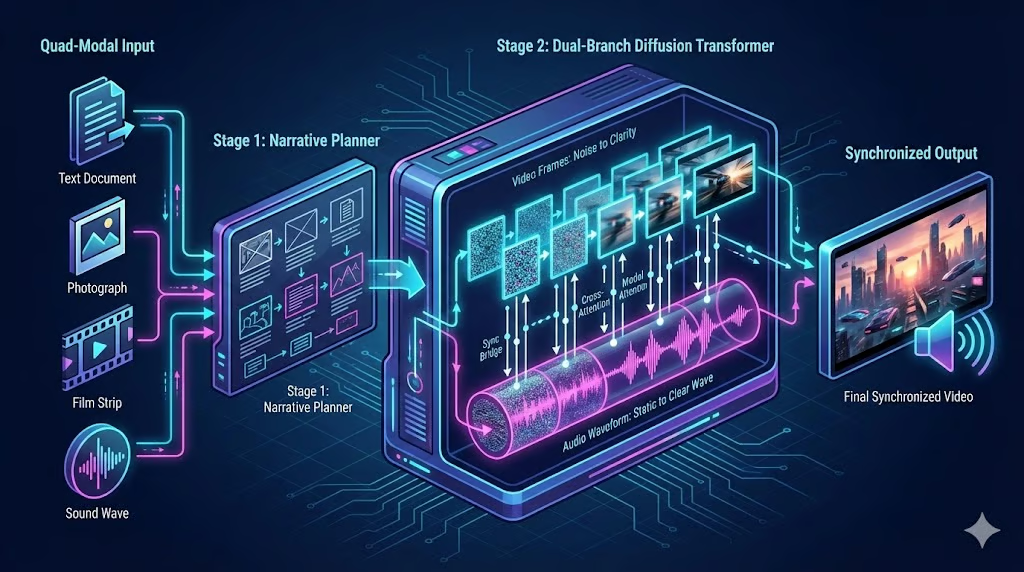
Architettura ad alto livello del Dual-Branch Diffusion Transformer di Seedance 2.0

Funzionalità principali di Seedance 2.0

Ora che sappiamo come funziona, vediamo cosa può fare Seedance 2.0. Due delle funzionalità più interessanti sono il sistema di riferimento quad‑modale a tutto tondo e lo storyboarding multi‑shot nativo.

Sistema di riferimento multimodale a tutto tondo

Seedream 2.0 ti consente di mostrare ciò che vuoi, invece di limitarti a dirlo. Puoi caricare fino a 12 file (9 immagini, 3 video e 3 clip audio) e assegnare loro ruoli specifici usando un sistema di riferimenti con @.

  • Ti serve un attore specifico? Carica la sua foto e taggala come riferimento del personaggio.
  • Vuoi un movimento di camera preciso? Carica un video di esempio e taggalo come riferimento del movimento.
  • Hai un beat specifico? Carica una canzone e taggala come riferimento del ritmo.

Il modello separa questi input e li combina, permettendoti di “dirigere” la scena usando asset concreti invece di affidarti alla fortuna.

Per chiarire meglio come si presenta in azione, ecco un esempio:

Prompt: “Sostituisci la modella nel video promozionale @Video1 con una modella occidentale, facendo riferimento all’aspetto in @Image2. Cambia tutto il parlato in inglese.” (Fonte: SD AI Animation Storyteller su X)

Il risultato è molto convincente. Seedance ha seguito le istruzioni completamente, ha catturato quasi perfettamente l’aspetto del modello di riferimento e ha regolato il lip sync durante la traduzione dell’audio in inglese. Nota speciale: il comportamento del riflesso sugli occhiali è completamente preservato.

Storyboarding multi‑shot

La funzione di storyboarding multi‑shot mette Seedance 2.0 nel ruolo di regista e montatore allo stesso tempo. Ecco come funziona:

  1. Il modello suddivide automaticamente una narrazione in più inquadrature collegate
  2. Per ogni inquadratura, seleziona il tipo di camera appropriato.
  3. Infine, compone le inquadrature e aggiunge le transizioni tra di esse.

Prompt: “Avenger's Endgame durante la grande scena di combattimento, ma Thanos ferma tutto e dice a tutti i supereroi che gli dispiace. Tutti i supereroi accettano subito e se ne vanno, ma poi Spiderman dice: "Oh hell no, he killed like a bajillion people!" E così tornano tutti indietro e lo prendono a calci mentre è a terra.” (Fonte: Christopher Fryant su X)

Questo è un buon esempio dello storyboarding in azione. Il campo lungo iniziale, lo zoom su Thanos, l’inclinazione verso Thor e il taglio netto su Spiderman: tutto appare molto coerente e in linea con l’atmosfera degli Avengers, senza bisogno di chiedere esplicitamente nessuno di questi movimenti di camera.

Generazione nativa di effetti sonori e clonazione vocale

Fino a non molto tempo fa, la generazione audio nativa sarebbe stata già una killer feature di per sé, ma oggi è più uno standard atteso. Detto ciò, Seedance 2.0 non solo genera insieme video e audio sincronizzati, ma include anche dialoghi multilingue, suoni ambientali ed effetti sonori legati all’azione.

Una funzione molto interessante abilitata dagli input audio è la clonazione vocale, presumibilmente multi‑speaker, così da poter avere fino a 3 voci personalizzate per scena (poiché questo è il limite di file audio). Consente di caricare voci reali per guidare accento, tono e persino conversazioni multi‑personaggio.

Abbiamo già visto in azione le capacità di lingua e lip‑sync negli esempi di traduzione; ora vediamo come Seedance crea da zero musica di sottofondo ed effetti sonori.

Prompt (usando file di riferimento): “La donna in @Image1 si avvicina allo specchio e guarda il suo riflesso. La posa deve fare riferimento a @Image2. Dopo un momento di contemplazione, all’improvviso crolla e inizia a urlare. L’azione di afferrare lo specchio, così come emozioni ed espressioni durante il crollo e l’urlo, devono fare pieno riferimento a @Video1.” (Fonte: Feyber su X)

L’esempio mostra che il modello può gestire diverse emozioni in conflitto all’interno della stessa scena, non solo visivamente ma anche acusticamente. 

La musica triste all’inizio della scena riflette bene l’espressione del personaggio e vira su una tonalità più horror quando urla con rabbia allo specchio. La musica di sottofondo non interferisce con l’urlo né con il suono dell’afferrare lo specchio, ma li completa bene.

Visuali cinematografiche ad alta risoluzione

Seedance supporta output fino a 2K, più formati di proporzione e frame rate 24–60 fps, a seconda della piattaforma. Enfatizza l’estetica cinematografica curando dettagli come:

  • Texture dettagliate
  • Illuminazione globale robusta
  • Color grading di tipo filmico

Un altro focus nello sviluppo di Seedance 2.0 è stato il rispetto della fisica. Queste due caratteristiche vanno di pari passo, come si vede dal prossimo esempio:

Prompt: “Sequenza d’azione cinematografica ad alta energia di notte in una città illuminata al neon, la camera segue un personaggio solitario che sprinta per strade bagnate dalla pioggia mentre droni della polizia e fari sfrecciano sfocati, tagli rapidi tra primi piani di occhi determinati, stivali che spruzzano nelle pozzanghere e campi larghi di traffico che lo manca per un soffio, whip‑pan della camera mentre supera barriere, scivola sui cofani delle auto e schiva esplosioni che scintillano dietro di lui, motion blur intenso e illuminazione dinamica, sensazione da camera a mano con push‑in aggressivi, contrasto drammatico, coreografia veloce, impatti netti e un ultimo beat al rallentatore mentre salta da un tetto nell’oscurità con le luci della città che strisciano sotto di lui.” (Fonte: Txori su X)

Questo risultato sembra una scena uscita direttamente da un film d’azione. Movimento di camera, illuminazione e persino la fisica dell’acqua che schizza da una pozzanghera sono perfetti. Ciò che non torna è che il personaggio salta da un tetto subito dopo aver corso per strada.

Una particolarità ovvia ma interessante è che, pur essendo descritto solo come “solitario”, il personaggio è risultato una copia carbone di Keanu Reeves. 

Considerando il prompt ricco d’azione e l’ambientazione distopica (“città illuminata al neon”, “bagnata dalla pioggia”, “droni della polizia”), si capisce bene da dove arrivi l’ispirazione. Resta solo da chiedersi se derivi da Matrix, John Wick, o Cyberpunk 2077 (o da una combinazione dei tre).

Quanto è valido Seedance 2.0?

Onestamente, i video visti durante l’introduzione delle funzionalità parlano da soli. In questa sezione voglio concentrarmi su due problemi della generazione video che i punti di forza di Seedance 2.0 mitigano.

Mettere fine alla dipendenza dai “magic prompt”

Uno dei principali punti dolenti della prima generazione di video IA era il prompt engineering a scatola nera: i creator dovevano scoprire “magic prompt” e formulazioni furbe per ottenere risultati usabili da modelli con scarso comprendonio semantico e controlli limitati.

Qui sia il sistema di riferimento a tutto tondo sia lo storyboarding multi‑shot tornano molto utili. La combinazione tra poter mappare asset a ruoli e un modello che eccelle nel capire il contesto tra le varie inquadrature di una scena dà risultati notevoli senza bisogno di “prompt‑maxxing”. Evita anche di sovraccaricare il prompt (e il modello).

Un buon esempio è l’uso di griglie di immagini 3x3. Dati 9 riferimenti che rappresentano diverse inquadrature di una scena, puoi ottenere buoni output anche senza alcuno sforzo sul prompt. Vediamo cosa ha restituito il modello dalla seguente griglia in input, abbinata a un prompt ridotto all’osso:
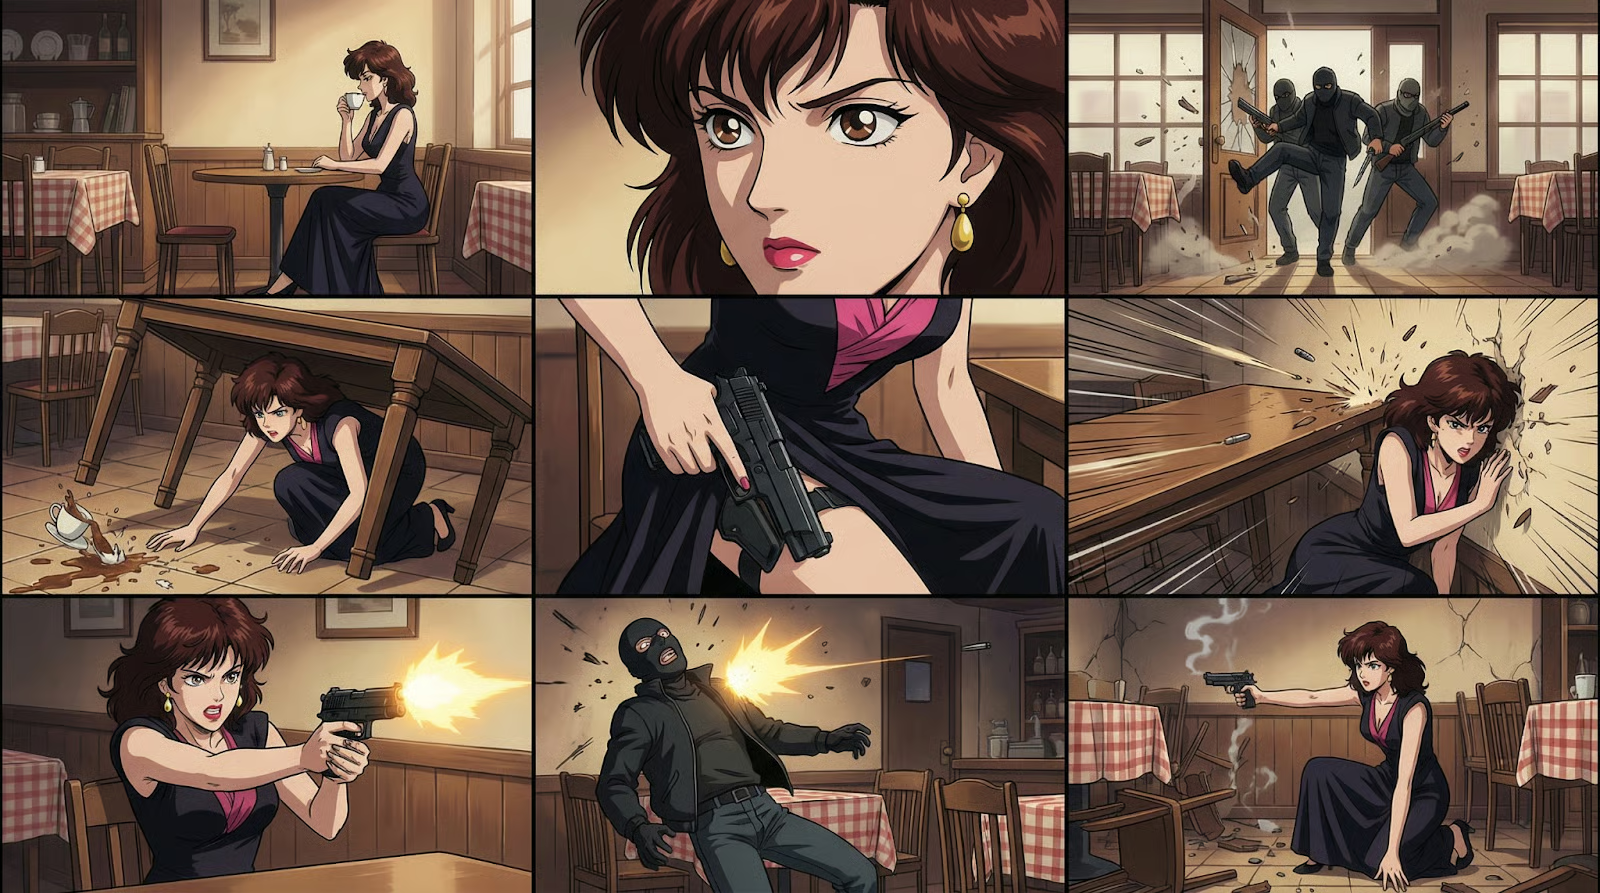
Griglia 3x3 che raffigura scena d’azione anime

Prompt: “Genera video dallo storyboard.” (Fonte: Mr.Iancu su X)

Di nuovo, un risultato molto convincente. Il modello comprende naturalmente il contesto della scena e colma i vuoti tra i singoli frame. Una cosa che non ha senso è che a metà video uno degli aggressori sembri stare per qualche frame nell’angolo dietro di lei.

Un altro piccolo errore che (pensavo) di aver notato era che il tavolo fosse in piedi, cosa che non darebbe copertura al personaggio; ma se guardi bene nell’angolo in basso a sinistra, vedi che l’errore era già nella griglia di immagini, che è stata generata da Nano Banana Pro.

Risolvere il problema delle clip “usa e getta”

Con i modelli precedenti, la generazione video spesso si trasformava in una lotteria per ottenere per caso la clip giusta, con molti tentativi (costosi) “usa e getta”. Lo storyboarding multi‑shot automatico affronta il problema e scompone molto bene i prompt narrativi in più inquadrature.

Seedance 2.0 offre una consistenza di identità e di scena significativamente migliorata rispetto ai modelli precedenti. Questo riduce drasticamente artefatti fastidiosi come drift del personaggio, cambi improvvisi di aspetto o sfarfallii che spesso rendevano inutilizzabili clip altrimenti promettenti.

Prompt: “Un documentario sulla natura su una lontra che pilota un aeroplano.” (Fonte: ChinaTechTrend su X)

Quali sono i limiti di Seedance 2.0?

Considerati tutti i punti di forza visti, vediamo alcune limitazioni del modello Seedance 2.0.

Scene complesse e stratificate con vetro

È stato riportato che Seedance 2.0 fatichi a gestire più livelli in movimento dietro un vetro, che, va detto, è un compito impegnativo per qualsiasi modello di generazione video (e peraltro un edge case non troppo comune). 

Tuttavia, l’unico esempio che ho trovato è discusso in questa recensione su YouTube. Mostra “una tipica scena esterna per una scena da diner, in stile Cyberpunk, vista attraverso il vetro, personaggio all’interno, auto in movimento all’esterno”. L’output in parte appariva molto naturale, con gocce di pioggia sul vetro e respirazione, ma l’intera scena si muoveva in modo innaturale (come se fosse “legata a un’auto”).

Sembrava che una scena con vetro su entrambi i lati del personaggio, con ulteriore sfondo dietro il secondo strato di vetro, fosse troppo per Seedream 2.0, che non riusciva più a distinguere tra sfondo statico e auto in movimento.

Nel nostro esempio precedente con la modella che mostra gli occhiali, trasparenza e riflessione degli occhiali erano perfette, ma va notato che a) era un esempio molto più semplice e b) usava un video di riferimento che fungeva da template per il modello.

Piccole incoerenze e testo sullo sfondo

Alcune incoerenze sono piuttosto la conseguenza di una misinterpretazione del contesto codificato che non di una cattiva generazione video in sé. Per fare un esempio, quando è stato chiesto di creare un crossover tra Game of Thrones e Friends, ha inserito per errore un personaggio di How I Met Your Mother:

Prompt: “Il cast di Friends è protagonista della sit‑com Game of Thrones. Chandler interpreta il re Joffrey. Joey è la Mano.” (Fonte: Gavin Purcell su X)

Come nell’esempio di Keanu Reeves, puoi intuire da dove venga: entrambi gli show sono sit‑com molto simili, quindi le loro rappresentazioni vettoriali saranno estremamente vicine.

Sebbene i testi sullo sfondo siano generalmente leggibili anche in scene con movimenti rapidi (pensa all’esempio di Keanu Reeves), in alcuni casi appaiono un po’ pixelati. Per esempio, guarda i cartelloni pubblicitari in questo video di basket, in cui una bambina segna contro Lebron James, diventato virale:

Prompt sconosciuto (Fonte: Serge Bulaev su X)

Anche qui, un risultato complessivamente molto convincente: i movimenti dei giocatori sono realistici, la camera mantiene il focus sulla ragazza che palleggia, e sia le ombre sia il rumore di fondo corrispondono a ciò che vediamo. Purtroppo il prompt usato in questo esempio non è stato condiviso.

Scenari di performance musicale

Difficile stabilirne la causa, ma ho riscontrato che le scene che coinvolgono esibizioni musicali, come concerti, hanno ancora un po’ di quella vecchia uncanny valley. Ecco un esempio di scena di un concerto K‑pop:

Prompt: “Epica scena di concerto K‑pop — Palco drammatico con luci, effetti ed energia, senza rappresentare persone reali.” (Fonte: Ankit Patel su X)

Ci sono alcune cose da notare. Innanzitutto, il suono include la canzone (con eco appropriata e rumore della folla). Tuttavia, a me suona un po’ legnoso. Anche il movimento dei membri della band appare leggermente strano, con la corista a sinistra che si fonde con il palco.

Seedance 2.0 vs concorrenti

Vediamo come Seedance 2.0 si confronta con i suoi tre principali competitori.

Categoria funzionale

Seedance 2.0

OpenAI Sora 2

Google Veo 3.1

Kuaishou Kling 3.0

Qualità cinematografica e risoluzione

2K commerciale: Ottimizzato per un’estetica digitale nitida; ideale per clip brevi e incisive.

Fedeltà da simulatore del mondo: Punta a coerenza di lungo periodo (20s) e simulazione ad alta fedeltà.

Scelta da direttore della fotografia: Superiore scienza del colore in stile filmico, HDR e profondità di campo professionale.

1080p di alta qualità: Ottima aderenza al prompt, sebbene a risoluzione inferiore rispetto a Seedance.

Realismo del movimento e fisica

Priori appresi: Movimento stabile dei personaggi derivato da riferimenti video.

Leader nella fisica: Il migliore per gravità, fluidi, collisioni e permanenza degli oggetti (anche off‑screen).

Maestria della camera: Eccelle in movimenti cinematografici realistici (pan, carrellate) e coerenza temporale (60s).

Maestro del movimento: Gestisce azioni umane complesse (mangiare, combattere) e interazioni fisiche (altalene).

Controllo da regista e input

Riferimento quad‑modale: Sistema a grafo unico per assegnare ruoli specifici a input Testo, Foto, Video e Audio.

Guidato dal testo: Principalmente prompt testuali con supporto immagini limitato; manca l’assegnazione multi‑file.

Editing mascherato: Offre controllo preciso tramite maschere e iterazione basata su testo.

Omni Mode e pennello: Include “Motion Brush” per i percorsi e collega più personaggi/elementi.

Capacità audio

Sync a doppio ramo: Genera audio/video simultaneamente per una sincronizzazione rigorosa al frame.

Post‑processo: Genera prima il video con audio aggiunto dopo; manca di sincronizzazione stretta.

Strumenti esterni: Si affida a tecnologia separata (es., AudioSet), con sincronizzazione meno precisa.

Audio nativo: Genera audio con toni di personaggio e lingue distinti.

Velocità di produzione e accesso

Alto throughput: <60s per clip da 5s. Disponibilità ufficiale limitata alla Cina.

Premium/lento: Computazionalmente pesante e più lento; posizionato come strumento premium/di ricerca.

Limitato: Generazione più lenta (minuti); accesso riservato a tester/partner fidati.

Accessibile: Piattaforma web veloce con migliore accesso globale, sebbene ~30% più lenta di Seedance.

Seedance 2.0 vs Sora 2

Uno dei principali punti di forza di Sora 2 è l’architettura come “simulatore di realtà” con profonda comprensione fisica, eccellendo nel modellare gravità, dinamica dei fluidi e permanenza degli oggetti. Pur non essendo un focus principale di Seedance 2.0, i primi risultati mostrano che non resta significativamente indietro rispetto a Sora 2 su questo fronte e può competere.

Il sistema di riferimento quad‑modale di Seedance, invece, è ciò che manca a Sora, che serve solo come modello text‑to‑video e image‑to‑video. Pertanto, clonare stili o personaggi specifici è piuttosto statico in Sora, rispetto alla possibilità di copiare il movimento di intere scene o clonare voci in Seedance.

Sebbene Sora 2 possa generare video di alta qualità, tratta l’audio come un processo separato e secondario. L’architettura a doppio ramo di Seedance 2.0 è fondamentalmente diversa, poiché genera video e audio simultaneamente in un’unica passata. Questo consente una sincronizzazione più stretta, accurata al frame (come i passi che colpiscono il suolo esattamente quando il piede atterra) rispetto a Veo.

Seedance 2.0 vs Google Veo 3.1

Veo 3.1 offre ai registi un controllo preciso con lo strumento Masked Editing, che consente di selezionare e modificare regioni specifiche di un video (ad es., cambiare i vestiti di un personaggio) lasciando intatto il resto. Fornisce anche comandi di camera specifici (pan, tilt, zoom) per imitare tecniche di filmmaking tradizionali. 

Seedance 2.0 adotta un approccio diverso al controllo con il sistema di riferimento Quad‑Modale. Invece di maschere di editing, gli utenti Seedance possono clonare stili o movimenti caricando video e immagini di riferimento. Se Veo è una suite di editing digitale, Seedance è un motore di “style transfer” potenziato, ancora più adatto a replicare una specifica atmosfera o un movimento di camera.

Come Sora 2, anche Veo 3.1 non può competere con Seedance 2.0 in termini di sincronizzazione tra output audio e video.

Seedance 2.0 vs Kling 3.0

Entrambi i modelli eccellono nel mantenere coerenti i personaggi, ma lo fanno in modo diverso. Kling 3.0 usa l’Omni Mode per “legare” personaggi specifici (volti, abiti) e riutilizzarli su più inquadrature o scene. In sostanza crea una libreria di asset richiamabili con un riferimento @. 

Rispetto al sistema di riferimento quad‑modale di Seedance 2.0, la differenza sta nel voler clonare qualcosa dall’esterno o mantenere intatti artefatti generati. Kling è migliore per costruire un cast riutilizzabile per una serie, mentre Seedance è migliore per “trasferire stile” di una specifica atmosfera o mossa di camera da una clip esistente su un nuovo soggetto.

Kling 3.0 offre un controllo preciso su tono ed emozione dei dialoghi generati (ad es., “sussurrato”, “eccitato”, “sarcastico”) e supporta nativamente il parlato multilingue, con risultati notevoli. Sebbene la sua sincronizzazione audio‑video superi Veo 3.1 e Sora 2, Seedance 2.0 ha ancora un leggero vantaggio qui.

Considerazioni finali 

I primi risultati del modello Seedance 2.0 di ByteDance sono molto promettenti e fanno presagire un salto in avanti nella generazione video con IA. In particolare, la combinazione tra input quad‑modale e storyboarding multi‑shot automatico ha il potenziale per cambiare le carte in tavola in casi d’uso che vanno dalla pubblicità e prototipazione a cinema e gaming.

Tuttavia, questo potere porta con sé attriti immediati. La capacità del modello di clonare voci da una singola foto e generare involontariamente figure coperte da copyright (come il sosia non richiesto di Keanu Reeves) ha già costretto ByteDance a sospendere urgentemente specifiche funzionalità di riferimento a “persone reali” e a rafforzare la verifica dell’identità.

Sarà interessante vedere come attori come Google e OpenAI reagiranno al rilascio di Seedance e se le restrizioni di accesso globale verranno infine allentate, liberando gli utenti dalla dipendenza da wrapper API di terze parti. Stiamo monitorando da vicino e forniremo una recensione pratica completa non appena avremo accesso diretto per testare personalmente le capacità del modello.

Se ti interessano i concetti che abilitano strumenti avanzati come Seedream 2.0, ti consiglio di iscriverti al percorso di competenze AI Fundamentals.

Seedance 2.0: FAQ

Seedance 2.0 è gratuito?

No. Attualmente, Seedance 2.0 è disponibile tramite la piattaforma "Jimeng" di ByteDance in Cina, che richiede un abbonamento a pagamento (i livelli riportati partono da circa 69 RMB). Gli utenti internazionali in genere vi accedono tramite aggregator o wrapper API di terze parti, che definiscono propri modelli di prezzo.

Come posso accedere a Seedance 2.0 fuori dalla Cina?

L’accesso diretto alla piattaforma Jimeng richiede spesso un numero di telefono cinese e un metodo di pagamento locale. La maggior parte degli utenti fuori dalla Cina al momento si affida a siti wrapper IA di terze parti o servizi API che integrano il modello Seedance, sebbene siano non ufficiali e possano avere limiti d’uso o costi diversi. L’accesso tramite la piattaforma Dreamina di CapCut è previsto per fine febbraio 2026.

Posso clonare una persona o uno stile specifici in Seedance 2.0?

Sì, ma con caveat. Puoi caricare immagini di riferimento per “clonare” l’aspetto di un personaggio o un video per copiare un movimento di camera specifico. Tuttavia, in seguito alla generazione accidentale di sosia di celebrità, ByteDance avrebbe inasprito le restrizioni sull’uso di riferimenti a persone reali per prevenire deepfake e violazioni di copyright.

Seedance 2.0 genera audio?

Sì. A differenza di molti concorrenti che generano prima il video e aggiungono il suono dopo, Seedance 2.0 usa un Dual‑Branch Diffusion Transformer per generare simultaneamente fotogrammi video e forme d’onda audio. Il risultato è una sincronizzazione più stretta, in cui effetti sonori (come passi o vetro che si rompe) sono accurati al frame rispetto all’azione visiva.

Cosa rende Seedance 2.0 diverso da Sora 2 di OpenAI?

Pur concentrandosi Sora 2 sulla simulazione della fisica del mondo reale e su video di lunga durata, Seedance 2.0 dà priorità a “velocità commerciale” e controllo da regista. La sua caratteristica di spicco è il sistema di riferimento quad‑modale, che consente di caricare fino a 12 immagini, video e file audio specifici per assegnare ruoli precisi (come riferimento personaggio o movimento di camera), offrendo un controllo più diretto rispetto al prompting principalmente testuale di Sora.


Tom Farnschläder's photo
Author
Tom Farnschläder
LinkedIn

Tom è un data scientist e formatore tecnico. Scrive e gestisce i tutorial e i post del blog di DataCamp su data science. In precedenza, Tom ha lavorato nella data science presso Deutsche Telekom.

Argomenti
AI generativa
Intelligenza artificiale

Corsi di intelligenza artificiale generativa

Corso

Concetti di IA generativa

2 ore
119.9K
Scopri come usare l'IA generativa in modo responsabile. Scopri come si sviluppano i modelli di IA generativa e quale impatto avranno sulla società in futuro.
Vedi i dettagliRight Arrow
Inizia Il Corso
Mostra altroRight Arrow
Correlato

blog

Tokenizzazione nel NLP: come funziona, sfide e casi d'uso

Guida al preprocessing NLP nel machine learning. Copriamo spaCy, i transformer di Hugging Face e come funziona la tokenizzazione in casi d'uso reali.
Abid Ali Awan's photo

Abid Ali Awan

10 min

blog

Che cos'è Snowflake? Guida per principianti alla piattaforma dati cloud

Esplora le basi di Snowflake, la piattaforma dati cloud. Scopri la sua architettura, le sue funzionalità e come integrarla nelle tue pipeline di dati.
Tim Lu's photo

Tim Lu

12 min

blog

I 15 migliori server MCP remoti che ogni AI builder dovrebbe conoscere nel 2026

Scopri i 15 migliori server MCP remoti che stanno trasformando lo sviluppo AI nel 2026. Scopri come migliorano automazione, ragionamento, sicurezza e velocità dei workflow.
Abid Ali Awan's photo

Abid Ali Awan

15 min

Mostra AltroMostra Altro

