Ga naar hoofdinhoud

Wat is Seedance 2.0? Een gids met voorbeelden

Ontdek de quad‑modale input- en referentiefuncties van het Seedance 2.0‑videogenereermodel. Zie hoe het werkt, hoe je toegang krijgt en hoe het zich verhoudt tot Sora 2.
Bijgewerkt 2 okt 2026  · 15 min lezen

Verken met AI

ChatGPTClaudePerplexity

Is dit het “DeepSeek‑moment” voor videogeneratie? ByteDance heeft stilletjes het Seedance 2.0‑videogenereermodel uitgebracht, en de eerste videovoorbeelden die ermee zijn gemaakt gaan viraal.

In deze gids neem ik je mee door wat Seedance is, de belangrijkste features en hoe het onder de motorkap werkt. Ik laat ook voorbeelden zien van het nieuwe videogenereermodel in actie en vergelijk de sterke en zwakke punten met andere prominente modellen. Kan het Google's Veo 3.1, OpenAI’s Sora 2 en Kuaishou's Kling 3.0 uitdagen?

Wat is Seedance 2.0? 

Seedance 2.0 is ByteDance’s nieuwste generatieve AI‑model voor tekst-naar‑video en afbeelding-naar‑video, uitgebracht op 10 februari 2026.

Bron: Aleena Amir op X

Omdat ByteDance geen canonieke Engelstalige releasenotes voor Seedance 2.0 heeft gepubliceerd, zijn de meeste publieke specificaties en featureclaims gereconstrueerd uit Chinese berichtgeving over Jimeng’s uitrol. Veel “spec sheets” op derde‑partij wrappersites lijken dezelfde bronnen te herhalen in plaats van officiële ByteDance‑documentatie.

Volgens tests door Chinese media en vroege partnerdocumentatie belooft Seedance 2.0 2K bioscoopkwaliteit met uitstekende karakterconsistentie.

Hoe krijg ik toegang tot Seedance 2.0?

Officieel is Seedance 2.0 live binnen ByteDance’s Jimeng in vasteland‑China, waar het beschikbaar is voor betalende leden (bijv. ≥69 RMB‑tiers volgens Chinese media). In de praktijk is Jimeng‑toegang China‑gecentreerd, en accountverificatie en lokale betaalrails zijn typische struikelblokken.

De Seedance 2.0‑landingspagina is al zichtbaar. Werkelijke toegang is echter voorlopig afgeschermd: de meeste gebruikers zien een "Coming Soon"‑melding tot de volledige uitrol, die volgens branchebronnen rond 24 februari 2026 wordt verwacht. 

Ondertussen is de populairste workaround onder internationale gebruikers ChatCut, een derde‑partij AI‑videoapp die Seedance 2.0 direct heeft geïntegreerd en vroege wereldwijde toegang biedt zonder Chinees telefoonnummer. Op dit moment is er een wachtlijst om je in te schrijven.

Hoe werkt Seedance?

Net als Sora 2 en Veo 3.1 is Seedance 2.0 een diffusiemodel. Dat wil zeggen: het genereert video door te beginnen met frames van statische ruis en die stap voor stap te transformeren tot een samenhangende videosequentie. 

Maar anders dan eerdere tekst‑naar‑video‑modellen die video zagen als een stille, single‑shot clip, is Seedance 2.0 opgezet als een “multimodale regisseur” die in één keer geluid, verhaallijn en complexe visuele referenties kan afhandelen.

De scène regisseren met quad‑modale inputs

Vroeger vergde precies krijgen wat je wilde van AI “prompt engineering”: lange, complexe tekstomschrijvingen typen en hopen dat de AI het begreep. Seedance 2.0 vervangt dat giswerk door de scène te regisseren met een quad‑modaal inputsysteem.

“Quad‑modaal” betekent dat Seedream tekst, afbeelding, video en audio als input aankan. De quad‑modale encoder is geen grote trechter, maar een set voorgetrainde encoders per datatype:

  • Tekst wordt verwerkt door een LLM‑gebaseerde encoder om semantische betekenis te extraheren
  • Afbeeldingen worden gecodeerd naar visuele featuretokens (patches)
  • Videoreferentieclips worden gecodeerd naar spatiotemporele tokens (3D‑patches)
  • Audio wordt gecodeerd naar golfvorm‑ of spectrogramtokens

Daardoor worden alle vier de ruwe inputs omgezet in een uniforme taal van latente vectoren om de inputs wiskundig te representeren.

Verhalen plannen met multi‑shot‑logica

Een van de grootste frustraties met oudere AI‑videotools was de beperking tot één shot. Als je om een verhaal vroeg, probeerde de AI alles in één ononderbroken take te proppen. Met videoduur vaak beperkt tot enkele seconden leidde dat vaak tot vreemde vervormingen of het negeren van delen van de prompt. 

Seedance 2.0 introduceert een verhalende planner om dit op te lossen met multi‑shot‑logica. Nog vóór er één pixel wordt gegenereerd, werkt deze planner als een storyboard‑artist. Hij leest je prompt en breekt die op in een reeks afzonderlijke camerashots. 

Zo kan hij beginnen met een wide shot van een stad, dan snijden naar een medium shot van een persoon, en eindigen met een close‑up van diens gezicht, allemaal zonder gedetailleerde instructies. Vervolgens orkestreert hij de generatie van deze shots in volgorde.

Hij gebruikt gedeelde consistentiedata om ervoor te zorgen dat het gezicht, de kleding en de belichting van de persoon in elke knip exact hetzelfde blijven. Het resultaat voelt meer als een gemonteerde filmscène dan als een ruwe, gehallucineerde videoclip.

Diffusie combineren met twee transformermodellen

De meeste AI‑videomodellen werken als een stomme filmcamera: ze genereren eerst de video en je moet later geluid toevoegen met een aparte tool. Dat leidt vaak tot “drift”, waarbij het geluid van voetstappen of een dichtslaande deur net niet past bij de actie in beeld. 

Seedance 2.0 lost dit op met een dual‑branch diffusion transformer, met één transformer toegewijd aan video en de andere aan audio.

Zie het als een brein met twee hersenhelften die perfect synchroon werken. De ene helft richt zich volledig op het genereren van videoframes, terwijl de andere de audiogolfvorm genereert. Omdat ze tijdens het creatieproces voortdurend communiceren, zorgt het model ervoor dat wanneer een visuele gebeurtenis plaatsvindt (zoals glas dat breekt), het bijbehorende geluid exact op dezelfde milliseconde wordt gegenereerd.
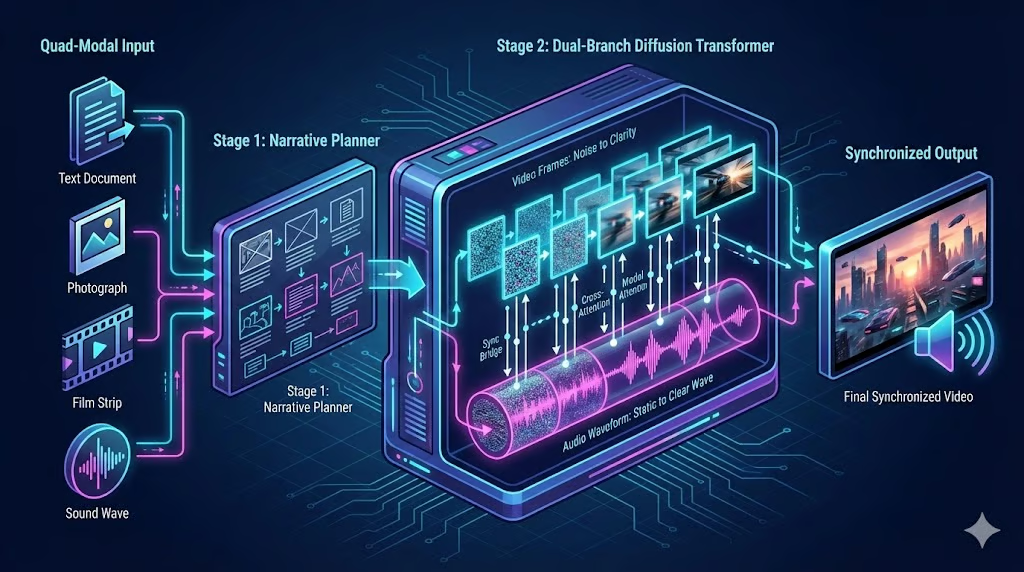
High-level architecture of the Seedance 2.0 Dual-Branch Diffusion Transformer

Belangrijkste features van Seedance 2.0

Nu we weten hoe het werkt, kijken we wat Seedance 2.0 kan. Twee van de meest opvallende features zijn het quad‑modale all‑round referentiesysteem en de native multi‑shot storyboarding.

Multimodaal all‑round referentiesysteem

Seedream 2.0 laat je het zien in plaats van het alleen te vertellen. Je kunt tot 12 bestanden uploaden (9 afbeeldingen, 3 video’s en 3 audioclips) en ze specifieke rollen geven met een @‑referentiesysteem.

  • Specifieke acteur nodig? Upload z’n foto en tag die als karakterreferentie.
  • Een bepaalde camerabeweging nodig? Upload een voorbeeldvideo en tag die als bewegingsreferentie.
  • Een specifieke beat? Upload een nummer en tag dat als ritmereferentie.

Het model scheidt deze inputs en combineert ze, zodat je de scène kunt “regisseren” met concrete assets in plaats van op geluk te vertrouwen.

Om een duidelijker beeld te geven van hoe dit er in de praktijk uitziet, volgt hier een voorbeeld:

Prompt: “Vervang het model in de promovideo @Video1 door een westers model, met referentie naar het uiterlijk in @Image2. Verander alle gesproken taal naar Engels.” (Bron: SD AI Animation Storyteller op X)

Het resultaat is erg indrukwekkend. Seedance volgde de instructies volledig, benaderde het uiterlijk van het referentiemodel bijna perfect en paste de lipsynchronisatie aan bij het vertalen van de audio naar het Engels. Opvallend detail: het reflectiegedrag in de brillenglazen is volledig behouden.

Multi‑shot storyboarding

De multi‑shot storyboarding‑feature zet Seedance 2.0 tegelijk in de rol van regisseur en editor. Zo werkt het:

  1. Het model breekt automatisch één verhaal op in meerdere verbonden shots
  2. Voor elk shot kiest het het juiste camertype.
  3. Tot slot componeert het de shots en voegt overgangen toe.

Prompt: “Avenger's Endgame tijdens de grote gevechtsscène, maar Thanos stopt alles en vertelt alle superhelden dat het hem spijt. Alle superhelden accepteren dit onmiddellijk en lopen weg, maar dan zegt Spiderman: "Oh hell no, hij heeft echt belachelijk veel mensen vermoord!" En dus rennen ze allemaal terug en trappen hem terwijl hij op de grond ligt.” (Bron: Christopher Fryant op X)

Dit is een goed voorbeeld van de storyboarding in actie. De wide shot in het begin, de zoom‑in op Thanos, de tilt richting Thor en de harde knip naar Spiderman—het oogt allemaal heel coherent en in lijn met de Avengers‑sfeer, zonder dat je expliciet om die camerabewegingen hoeft te vragen.

Native geluidseffecten en stemklonen

Tot voor kort zou native audiogeneratie op zich al een killerfeature zijn geweest, maar tegenwoordig is het eerder een verwachte standaard. Toch genereert Seedance 2.0 niet alleen synchroon video en audio samen, maar omvat het ook meertalige dialogen, omgevingsgeluiden en aan acties gekoppelde geluidseffecten.

Een erg coole feature mogelijk gemaakt door de audio‑input is stemklonen, naar verluidt multi‑speaker, zodat je tot 3 aangepaste stemmen per scène kunt hebben (want dat is de limiet voor audiobestanden). Gebruikers kunnen echte stemmen uploaden om accent, toon en zelfs meerpersoonsgesprekken te sturen.

We hebben de taal- en lipsync‑skills al gezien in de vertaalvoorbeelden; laten we nu kijken hoe Seedance achtergrondmuziek en geluidseffecten from scratch creëert.

Prompt (met referentiebestanden): “De vrouw in @Image1 loopt naar de spiegel en kijkt naar haar reflectie. Haar pose moet refereren aan @Image2. Na een moment van contemplatie stort ze ineens in en begint te schreeuwen. De actie van het grijpen van de spiegel, evenals de emoties en gezichtsuitdrukkingen tijdens de instorting en schreeuw, moeten volledig refereren aan @Video1.” (Bron: Feyber op X)

Het voorbeeld laat zien dat het model meerdere, conflicterende emoties binnen dezelfde scène aankan—niet alleen visueel, maar ook akoestisch. 

De droevige achtergrondmuziek aan het begin van de scène weerspiegelt de gezichtsuitdrukking van het personage goed, en verandert in een meer horrorachtige toon wanneer ze boos in de spiegel schreeuwt. De achtergrondmuziek verstoort haar schreeuw of het geluid van het grijpen van de spiegel niet, maar vult het mooi aan.

Hoogwaardige, filmische visuals

Seedance ondersteunt tot 2K‑outputs, meerdere beeldverhoudingen en framerates van 24–60 fps, afhankelijk van het platform. Het legt de nadruk op filmische esthetiek door te letten op details zoals:

  • Gedetailleerde texturen
  • Robuuste globale belichting
  • Filmachtige color grading

Een andere focus in de ontwikkeling van Seedance 2.0 was het respecteren van natuurkunde. Deze twee features gaan hand in hand, zoals we zien in het volgende voorbeeld:

Prompt: “Een hoogenergetische, filmische actiesequentie ’s nachts in een neonverlichte stad, de camera volgt een eenzaam personage dat door doorregende straten sprint terwijl politiedrones en koplampen voorbij vegen, snelle cuts tussen close‑ups van vastberaden ogen, laarzen die in plassen spatten, en wide shots van verkeer dat hem op het nippertje mist, de camera whip‑pannt terwijl hij over barrières springt, over autokappen glijdt en explosies ontwijkt die achter hem opvlammen, intense motion blur en dynamische belichting, handheld‑gevoel met agressieve push‑ins, dramatisch contrast, snelle choreografie, harde impacts en een laatste slow‑motion beat wanneer hij van een rooftop in de duisternis springt terwijl stadslichten onder hem strepen.” (Bron: Txori op X)

Dit resultaat oogt als een scène rechtstreeks uit een actiefilm. Camerabeweging, belichting en zelfs de fysica van opspattend water uit een plas kloppen. Wat niet klopt, is dat het personage van een dak springt direct nadat hij door een straat rent.

Een opvallende maar interessante eigenaardigheid is dat, hoewel het personage alleen als “eenzaam” werd beschreven, hij uitpakte als een exacte kopie van Keanu Reeves. 

Gezien de actievolle prompt met een dystopische setting (“neonverlichte stad”, “doorregend”, “politiedrones”) zie je waar dat vandaan komt. De enige vraag is of de inspiratie komt van The Matrix, John Wick, of Cyberpunk 2077 (of een combinatie daarvan).

Hoe goed is Seedance 2.0?

Eerlijk gezegd spreken de video’s die we bij de feature‑introductie zagen voor zich. In dit deel wil ik focussen op twee problemen met videogeneratie die de sterke punten van Seedance 2.0 mitigeren.

Einde aan de afhankelijkheid van “magische prompts”

Een groot pijnpunt van de eerste generatie AI‑video was black‑box prompt engineering: makers moesten “magische prompts” en hacky formuleringen ontdekken om bruikbare resultaten te krijgen van modellen met zwakke semantische begrip en beperkte controls.

Hier komen zowel het all‑round referentiesysteem als de multi‑shot storyboarding goed van pas. De combinatie van assets aan rollen kunnen toewijzen en een model dat uitblinkt in contextbegrip over verschillende shots binnen een scène levert indrukwekkende resultaten op zonder “prompt‑maxxing”. Het voorkomt ook dat je de prompt overlaadt (en het model overbelast).

Een goed voorbeeld is het gebruik van 3x3‑afbeeldingsrasters. Met 9 referentieafbeeldingen die verschillende shots binnen een scène weergeven, kun je al degelijke outputs krijgen, zelfs als je nul moeite in de prompt steekt. Laten we zien wat het model teruggeeft op basis van het volgende raster als input, gecombineerd met een zo eenvoudig mogelijke prompt:
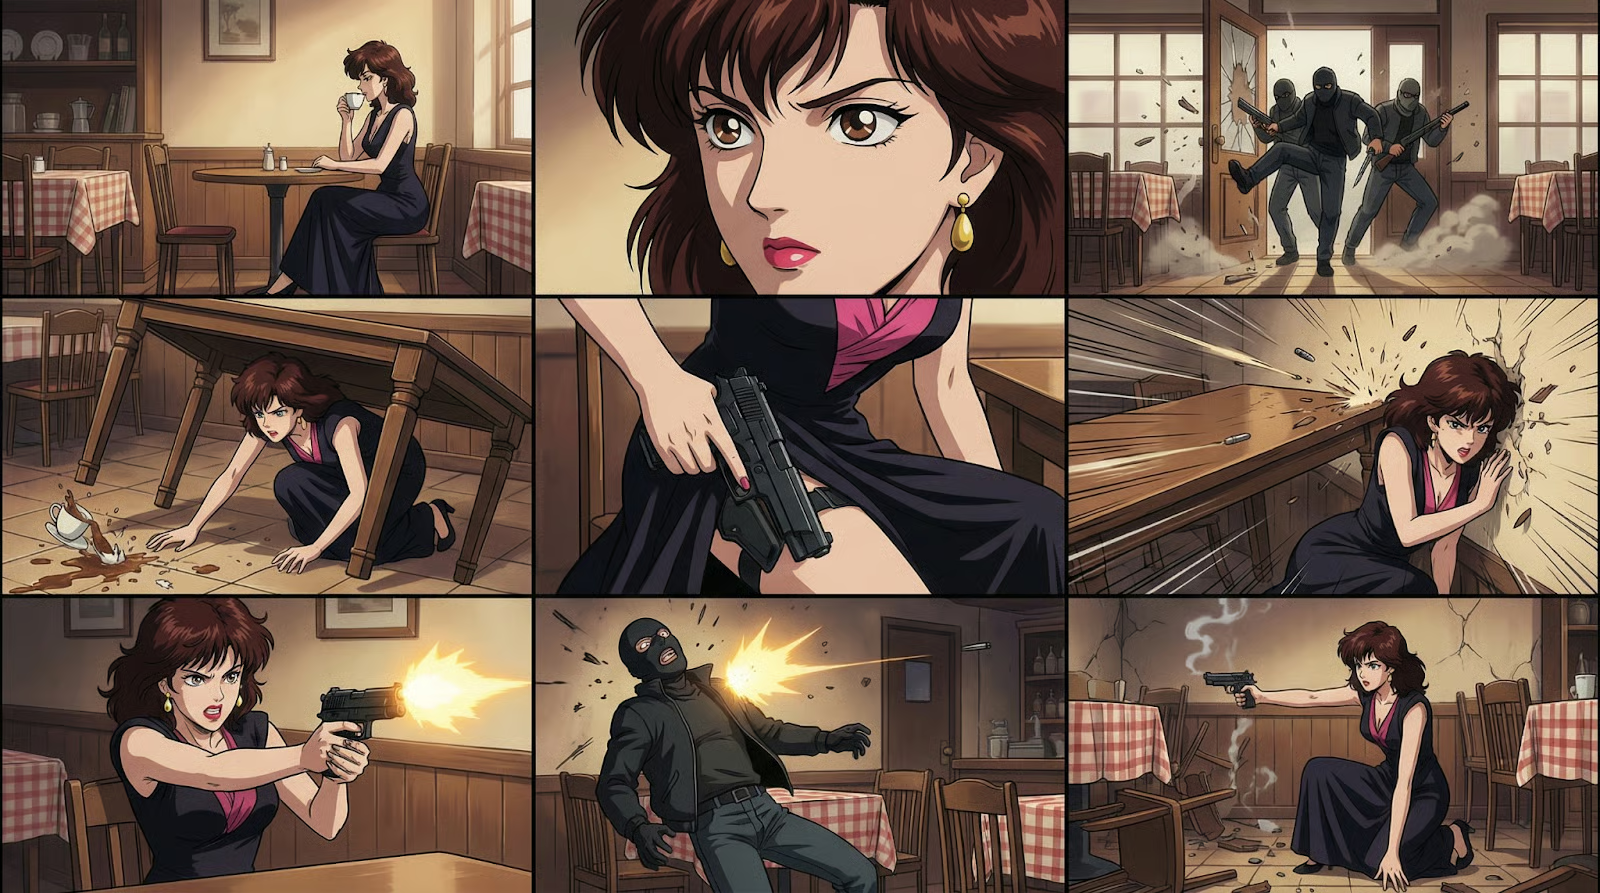
3x3 grid depicting anime action scene

Prompt: “Genereer video vanaf storyboard.” (Bron: Mr.Iancu op X)

Opnieuw een zeer indrukwekkend resultaat. Het model begrijpt de context van de scène vanzelf en vult de gaten tussen afzonderlijke frames. Eén ding dat niet klopt, is dat halverwege de video een van de aanvallers voor een paar frames in de hoek achter haar lijkt te staan.

Een andere kleine fout die (dacht ik) me opviel, was dat de tafel rechtop stond, wat het personage geen dekking zou geven—maar als je goed kijkt in de linkerbenedenhoek, zie je dat de fout al in het afbeeldingsraster zat, dat werd genereerd door Nano Banana Pro.

Het “wegwerpclip”‑probleem oplossen

Met eerdere modellen werd videogeneratie vaak een loterij om toevallig de juiste clip te krijgen, met veel (dure) “wegwerp”‑pogingen onderweg. De automatische multi‑shot storyboarding pakt dit aan en doet uitstekend werk in het ontleden van verhalende prompts in meerdere shots.

Seedance 2.0 levert aanzienlijk verbeterde identiteit- en scèneconsistentie vergeleken met eerdere modellen. Dit vermindert drastisch vervelende visuele artefacten zoals karakterdrift, plotselinge uiterlijkveranderingen of flikkeren, die veelbelovende clips vaak onbruikbaar maakten.

Prompt: “Een natuurdocumentaire over een otter die een vliegtuig bestuurt.” (Bron: ChinaTechTrend op X)

Wat zijn de beperkingen van Seedance 2.0?

Met alle sterktes in gedachten kijken we nu naar een paar beperkingen van het Seedance 2.0‑model.

Complexe, gelaagde scènes met glas

Er is gemeld dat Seedance 2.0 moeite heeft met meerdere bewegende lagen achter glas, wat toegegeven een uitdagende taak is voor elk videogeneratiemodel (en bovendien een niet‑al‑te‑veelvoorkomend randgeval). 

Het enige voorbeeld dat ik kon vinden, wordt besproken in deze YouTube‑review. Het toont “een typische exterieurshot voor een dinerscène, cyberpunkachtig, door het glas kijkend, personage binnen, buiten rijdende auto’s.” De output oogde deels heel natuurlijk, met regendruppels op het raam en ademhalingsanimatie, maar de hele scène bewoog onnatuurlijk (alsof hij “aan een auto vastzat”).

Het leek alsof een scène met glas aan beide kanten van het personage, met extra achtergrondscenery achter de tweede glaslaag, te veel was voor Seedream 2.0, waardoor het niet meer kon onderscheiden tussen de statische achtergrond en rijdende auto’s.

In ons eerdere voorbeeld met het model met haar bril waren zowel de transparantie als de reflectie van de glazen on point, maar daarbij moet worden opgemerkt dat a) het een veel eenvoudiger voorbeeld was en b) een referentievideo werd gebruikt als sjabloon voor het model.

Kleine inconsistenties en achtergrondtekst

Sommige inconsistenties zijn eerder het gevolg van een misinterpretatie van de gecodeerde context dan van slechte videogeneratie op zich. Zo werd in een opdracht om een Game of Thrones en Friends‑crossover te maken per ongeluk een personage uit How I Met Your Mother toegevoegd:

Prompt: “De cast van Friends speelt in de Game of Thrones‑sitcom. Chandler speelt King Joffrey. Joey is de Hand.” (Bron: Gavin Purcell op X)

Net als bij het Keanu Reeves‑voorbeeld kun je raden waar het vandaan komt: beide shows zijn erg vergelijkbare sitcoms, dus hun vectorrepresentaties zullen extreem dicht bij elkaar liggen.

Hoewel achtergrondteksten over het algemeen leesbaar zijn, zelfs in scènes met snelle bewegingen (denk aan het Keanu Reeves‑voorbeeld), zijn ze in sommige gevallen wat gepixeld. Kijk bijvoorbeeld naar de reclameborden in deze basketbalvideo van een kind dat scoort tegen Lebron James en viraal ging:

Prompt onbekend (Bron: Serge Bulaev op X)

Opnieuw is dit al met al een zeer indrukwekkend resultaat: de bewegingen van de spelers zijn erg realistisch, de camera houdt de focus op het dribbelende meisje, en zowel de schaduwen als het achtergrondgeluid komen overeen met wat we zien. Helaas is de in dit voorbeeld gebruikte prompt niet gedeeld.

Muziekperformancescenario’s

De reden is lastig te duiden, maar scènes met muziekoptredens, zoals concerten, hebben nog steeds een beetje die ouderwetse uncanny‑valley‑vibe. Hier is een voorbeeld van een K‑popconcertscène:

Prompt: “Epische K‑popconcertscène — Dramatisch podium met lichten, effecten en energie, zonder echte personen te tonen.” (Bron: Ankit Patel op X)

Er zijn hier een paar dingen om op te merken. Allereerst bevat het geluid het lied (met correcte echo en publieksgeluid). Toch klinkt het voor mij wat houterig. De beweging van de bandleden oogt ook licht vreemd, met de achtergrondzanger links die in het podium lijkt te morphen.

Seedance 2.0 vs. concurrenten

Laten we kijken hoe Seedance 2.0 zich verhoudt tot de drie belangrijkste concurrenten.

Featurecategorie

Seedance 2.0

OpenAI Sora 2

Google Veo 3.1

Kuaishou Kling 3.0

Filmische kwaliteit & resolutie

Commercieel 2K: Geoptimaliseerd voor een scherpe, digitale esthetiek; het best voor korte, krachtige clips.

World Sim‑fideliteit: Richt zich op langetermijncoherentie (20s) en hoge‑fideliteit simulatie.

Keuze van de cameraman: Superieure filmachtige kleurscience, HDR en professionele scherptediepte.

Hoogwaardige 1080p: Uitstekende prompt‑nauwkeurigheid, maar lagere resolutie dan Seedance.

Bewegingsrealisme & natuurkunde

Geleerde priors: Stabiele karaktermotoriek afgeleid van videoreferenties.

Fysicalijder: Beste in zwaartekracht, vloeistoffen, botsingen en objectpermanentie (ook off‑screen).

Camerabeheersing: Excelleert in realistische filmische bewegingen (pans, dollies) en temporele consistentie (60s).

Bewegingsmeester: Kan complexe menselijke acties (eten, vechten) en fysieke interacties (wipwippen) aan.

Regisseurscontrole & inputs

Quad‑modale referentie: Uniek graafsysteem om specifieke rollen toe te wijzen aan tekst-, foto-, video- en audio‑inputs.

Tekstgestuurd: Voornamelijk tekstprompts met beperkte afbeeldingondersteuning; mist multi‑file‑toewijzing.

Masked Editing: Biedt precieze controle via masking en tekstgebaseerde iteratie.

Omni Mode & Brush: Beschikt over “Motion Brush” voor paden en bindt meerdere personages/elementen.

Audiomogelijkheden

Dual‑Branch Sync: Genereert audio/video gelijktijdig voor strakke, frame‑accurate synchronisatie.

Nabewerking: Genereert eerst video en voegt later audio toe; mist strakke sync.

Externe tools: Vertrouwt op aparte tech (bijv. AudioSet), wat leidt tot minder precieze synchronisatie.

Native audio: Genereert audio met onderscheidende stemtonen en talen.

Productiesnelheid & toegang

Hoge throughput: <60s voor 5s‑clips. Officiële beschikbaarheid beperkt tot China.

Premium/langzaam: Rekenintensief en trager; gepositioneerd als research/premium tool.

Beperkt: Langzamere generatie (minuten); toegang beperkt tot trusted testers/partners.

Toegankelijk: Snel webplatform met betere wereldwijde toegang, maar ~30% trager dan Seedance.

Seedance 2.0 vs Sora 2

Een van de belangrijkste verkooppunten van Sora 2 is dat het is opgezet als een “realiteitssimulator” met diep fysisch begrip en uitblinkt in het modelleren van zwaartekracht, vloeistofdynamica en objectpermanentie. Hoewel dit niet de hoofdprioriteit is van Seedance 2.0, laten de eerste resultaten zien dat het hierin niet significant achterloopt op Sora 2 en kan concurreren.

Seedance’s quad‑modale referentiesysteem ontbreekt juist in Sora, dat alleen dient als tekst‑naar‑video en afbeelding‑naar‑video. Daarom is het klonen van specifieke stijlen of personages in Sora tamelijk statisch, vergeleken met het kunnen kopiëren van de beweging van hele scènes of het klonen van stemmen in Seedance.

Hoewel Sora 2 hoogwaardige video kan genereren, behandelt het audio als een apart, secundair proces. Seedance 2.0’s dual‑branch transformerarchitectuur is fundamenteel anders, omdat het video en audio gelijktijdig in één pass genereert. Dit maakt strakkere, frame‑nauwkeurige synchronisatie mogelijk (zoals voetstappen precies op het moment van landen) dan in Veo.

Seedance 2.0 vs Google Veo 3.1

Veo 3.1 geeft regisseurs precieze controle via de Masked Editing‑tool, waarmee je specifieke regio’s van een video kunt selecteren en aanpassen (bijv. kleding van een personage veranderen) terwijl de rest onaangeroerd blijft. Het biedt ook specifieke cameracommands (pan, tilt, zoom) om traditionele filmtechnieken na te bootsen. 

Seedance 2.0 kiest een andere benadering van controle met het Quad‑Modale Referentiesysteem. In plaats van edit‑maskers kunnen Seedance‑gebruikers stijlen of bewegingen klonen door referentievideo’s en afbeeldingen te uploaden. Als Veo een digitale editingsuite is, dan is Seedance een “style‑transfer”‑motor op steroïden, wat het nog geschikter maakt om een specifieke vibe of camerabeweging te repliceren.

Net als Sora 2 kan Veo 3.1 niet concurreren met Seedance 2.0 wat betreft de synchronisatie van audio- en video‑output.

Seedance 2.0 vs Kling 3.0

Beide modellen blinken uit in het consistent houden van personages, maar bereiken dat anders. Kling 3.0 gebruikt Omni Mode om specifieke personages (gezichten, kleding) te “binden” en opnieuw te gebruiken over meerdere shots of scènes. Het creëert in wezen een bibliotheek van assets die je met een @‑referentie kunt aanroepen. 

Vergeleken met het quad‑modale referentiesysteem van Seedance 2.0 zit het verschil in of je iets van buitenaf wilt klonen of gegenereerde artefacten intact wilt houden. Kling is beter om een herbruikbare cast voor een serie op te bouwen, terwijl Seedance beter is voor het “style‑transferen” van een specifieke vibe of camerabeweging van een bestaande clip naar een nieuw onderwerp.

Kling 3.0 biedt precieze controle over de toon en emotie van gegenereerde dialogen (bijv. “fluisterend”, “enthousiast”, “sarcastisch”) en ondersteunt native meertalige spraak, wat indrukwekkende resultaten oplevert. Hoewel de audio‑video‑synchronisatie beter is dan bij Veo 3.1 en Sora 2, heeft Seedance 2.0 hier nog steeds een kleine voorsprong.

Tot slot 

De eerste resultaten van ByteDance’s Seedance 2.0‑model zijn zeer indrukwekkend en beloven een sprong voorwaarts in AI‑videogeneratie. Vooral de combinatie van de quad‑modale input en de automatische multi‑shot storyboarding heeft het potentieel om een echte gamechanger te zijn in toepassingen van reclame en prototyping tot film en gaming.

Die kracht zorgt echter direct voor frictie. Het vermogen van het model om stemmen te klonen vanaf één foto en onbedoeld auteursrechtelijk beschermde figuren te genereren (zoals de ongevraagde Keanu Reeves‑lookalike) heeft ByteDance al gedwongen om specifieke “echte‑persoon”‑referentiefuncties dringend te schorsen en de identiteitsverificatie aan te scherpen.

Het wordt interessant om te zien hoe grote spelers als Google en OpenAI reageren op de release van Seedance en of wereldwijde toegangsbeperkingen uiteindelijk worden opgeheven, zodat gebruikers niet meer afhankelijk zijn van derde‑partij API‑wrappers. We volgen de situatie op de voet en leveren een volledige hands‑on review zodra we directe toegang hebben om de capaciteiten van het model zelf te testen.

Als je geïnteresseerd bent in de concepten achter geavanceerde tools zoals Seedream 2.0, raad ik aan je in te schrijven voor onze AI Fundamentals‑skilltrack.

Seedance 2.0 FAQ's

Is Seedance 2.0 gratis te gebruiken?

Nee. Seedance 2.0 is momenteel beschikbaar via ByteDance’s “Jimeng”‑platform in China, waarvoor een betaald abonnement nodig is (gerapporteerde tiers beginnen rond 69 RMB). Internationale gebruikers krijgen doorgaans toegang via derde‑partij API‑aggregators of wrappers, die hun eigen prijsmodellen hanteren.

Hoe kan ik buiten China toegang krijgen tot Seedance 2.0?

Directe toegang tot het Jimeng‑platform vereist vaak een Chinees telefoonnummer en betaalmethode. De meeste gebruikers buiten China vertrouwen momenteel op derde‑partij AI‑wrappersites of API‑diensten die het Seedance‑model integreren, al zijn die niet officieel en kunnen ze andere gebruikslimieten of kosten hebben. Toegang via CapCut’s Dreamina‑platform wordt verwacht voor eind februari 2026.

Kan ik een specifieke persoon of stijl klonen in Seedance 2.0?

Ja, met kanttekeningen. Je kunt referentieafbeeldingen uploaden om het uiterlijk van een personage te “klonen” of een video om een specifieke camerabeweging te kopiëren. Naar aanleiding van de onbedoelde generatie van celebrity‑lookalikes heeft ByteDance echter naar verluidt de beperkingen op het gebruik van echte‑persoon‑referenties aangescherpt om deepfakes en copyrightschending te voorkomen.

Genereert Seedance 2.0 geluid?

Ja. In tegenstelling tot veel concurrenten die eerst video genereren en later geluid toevoegen, gebruikt Seedance 2.0 een Dual‑Branch Diffusion Transformer om videoframes en audiogolfvormen gelijktijdig te genereren. Dit resulteert in strakkere synchronisatie, waarbij geluidseffecten (zoals voetstappen of brekend glas) frame‑nauwkeurig aansluiten op de visuele actie.

Wat maakt Seedance 2.0 anders dan Sora 2 van OpenAI?

Hoewel Sora 2 focust op het simuleren van real‑world natuurkunde en langdurige video, geeft Seedance 2.0 prioriteit aan “commerciële snelheid” en regisseurscontrole. De opvallendste feature is het quad‑modale referentiesysteem, waarmee gebruikers tot 12 specifieke afbeeldingen, video’s en audiobestanden kunnen uploaden en precieze rollen kunnen toewijzen (zoals karakterreferentie of camerabeweging), wat directere controle biedt dan Sora’s vooral tekstgebaseerde prompting.


Tom Farnschläder's photo
Author
Tom Farnschläder
LinkedIn

Tom is data scientist en technisch docent. Hij schrijft en beheert de data science-tutorials en blogposts van DataCamp. Eerder werkte Tom in data science bij Deutsche Telekom.

Onderwerpen
Generative AI
Kunstmatige intelligentie

Cursussen over Generatieve AI

Cursus

Generatieve AI-concepten

2 uur
120.4K
Ontdek hoe je generatieve AI verantwoord kunt inzetten. Leer hoe generatieve AI-modellen worden ontwikkeld en welke impact ze op de samenleving zullen hebben.
Bekijk detailsRight Arrow
Start Cursus
Meer bekijkenRight Arrow
Gerelateerd

blog

AI vanaf nul leren in 2026: een complete gids van de experts

Ontdek alles wat je moet weten om in 2026 AI te leren, van tips om te beginnen tot handige resources en inzichten van industrie-experts.
Adel Nehme's photo

Adel Nehme

15 min

Meer BekijkenMeer Bekijken

