Ir al contenido principal

¿Qué es Seedance 2.0? Guía con ejemplos

Descubre las entradas y referencias cuatrimodales del modelo de generación de vídeo Seedance 2.0. Cómo funciona, cómo acceder y cómo se compara con Sora 2.
Actualizado 17 sept 2026  · 15 min leer

Explora con IA

ChatGPTClaudePerplexity

¿Es este el "momento DeepSeek" para la generación de vídeo? ByteDance acaba de lanzar sin hacer ruido su modelo de generación de vídeo Seedance 2.0, y los primeros ejemplos creados con él se están volviendo virales.

En esta guía, te cuento qué es Seedance, sus funciones clave y cómo funciona por dentro. También verás ejemplos del nuevo modelo de generación de vídeo en acción y compararemos sus puntos fuertes y débiles con otros modelos destacados. ¿Puede plantarle cara a Veo 3.1 de Google, Sora 2 de OpenAI y Kling 3.0 de Kuaishou?

¿Qué es Seedance 2.0? 

Seedance 2.0 es el nuevo modelo generativo de IA de ByteDance para texto a vídeo e imagen a vídeo, lanzado el 10 de febrero de 2026.

Fuente: Aleena Amir en X

Como ByteDance no ha publicado una nota de lanzamiento canónica en inglés para Seedance 2.0, la mayor parte de las especificaciones públicas y afirmaciones sobre funciones se han reconstruido a partir de la cobertura en chino del despliegue de Jimeng. Muchas "fichas técnicas" en sitios de terceros parecen repetir las mismas fuentes en lugar de documentación oficial de ByteDance.

Según pruebas de medios chinos y documentación temprana de partners, Seedance 2.0 promete salida de vídeo en 2K con calidad de cine y una gran consistencia de personajes.

¿Cómo puedo acceder a Seedance 2.0?

Oficialmente, Seedance 2.0 está disponible dentro de Jimeng de ByteDance en China continental, donde se ofrece a miembros de pago (p. ej., niveles ≥69 RMB según medios chinos). En la práctica, el acceso a Jimeng está centrado en China, y la verificación de cuenta y los métodos de pago locales suelen ser puntos de fricción.

La página de producto de Seedance 2.0 ya es visible. Sin embargo, el acceso real está limitado por el momento: la mayoría de usuarios verán un mensaje de "Próximamente" hasta el despliegue completo, que fuentes del sector esperan alrededor del 24 de febrero de 2026. 

Mientras tanto, la vía más popular entre usuarios internacionales es ChatCut, una app de vídeo con IA de terceros que ha integrado Seedance 2.0 directamente y ofrece acceso global anticipado sin exigir número de teléfono chino. De momento hay una lista de espera para registrarse.

¿Cómo funciona Seedance?

Al igual que Sora 2 y Veo 3.1, Seedance 2.0 es un modelo de difusión. Es decir, genera vídeo empezando por fotogramas de ruido estático y transformándolos gradualmente en muchos pasos hasta revelar una secuencia coherente.

Sin embargo, a diferencia de los primeros modelos de texto a vídeo que trataban el vídeo como un clip silencioso de una sola toma, Seedance 2.0 está diseñado como un "director multimodal" capaz de gestionar sonido, estructura narrativa y referencias visuales complejas en una sola pasada.

Dirigir la escena con entradas cuatrimodales

Antes, conseguir que una IA creara exactamente lo que querías exigía "ingeniería de prompts": escribir descripciones de texto largas y complejas y cruzar los dedos para que la IA las entendiera. Seedance 2.0 elimina ese tanteo dirigiendo la escena con un sistema de entrada cuatrimodal.

"Cuatrimodal" significa que Seedream puede manejar texto, imagen, vídeo y audio como entrada. El codificador cuatrimodal no es un único embudo, sino un conjunto de codificadores preentrenados para cada tipo de dato:

  • Texto procesado por un codificador basado en LLM para extraer el significado semántico
  • Imágenes codificadas en tokens de rasgos visuales (parches)
  • Vídeo de referencia codificado en tokens espaciotemporales (parches 3D)
  • Audio codificado en tokens de forma de onda o espectrograma

Como resultado, las cuatro entradas brutas se convierten en un lenguaje unificado de vectores latentes para representarlas matemáticamente.

Planificación narrativa con lógica multitiro

Otra de las grandes frustraciones con las herramientas antiguas de vídeo con IA era el límite de una sola toma. Si pedías una historia, la IA intentaba meterlo todo en un único plano secuencia sin editar. Con duraciones de vídeo limitadas a unos pocos segundos, a menudo terminaba en deformaciones raras o ignorando parte del prompt. 

Seedance 2.0 incorpora un planificador narrativo con lógica multitiro para solucionarlo. Antes de generar un solo píxel, este planificador actúa como un artista de storyboard. Lee tu prompt y lo descompone en una secuencia de planos de cámara distintos. 

Por ejemplo, puede empezar con un plano general de una ciudad, cortar después a un plano medio de una persona y terminar con un primer plano de su cara, sin necesidad de dar instrucciones detalladas. Luego orquesta la generación de estos planos en secuencia.

Utiliza datos de consistencia compartidos para asegurar que la cara, la ropa y la iluminación de la persona se mantengan exactamente iguales en cada corte. El resultado se siente como una secuencia montada de pelicula, no como un vídeo en bruto alucinado.

Combinando difusión con dos transformadores

La mayoría de modelos de vídeo con IA funcionan como un cine mudo: generan primero el vídeo y luego tienes que añadir el sonido con otra herramienta. Esto provoca a menudo "deriva", donde el sonido de unos pasos o una puerta que se cierra no encaja del todo con la acción en pantalla. 

Seedance 2.0 lo resuelve con un transformador de difusión de doble rama, con un transformer dedicado al vídeo y otro al audio.

Piénsalo como un cerebro con dos hemisferios trabajando en perfecta sincronía. Un hemisferio se centra totalmente en generar los fotogramas de vídeo, mientras que el otro genera la forma de onda de audio. Como se comunican constantemente durante la creación, el modelo asegura que cuando sucede un evento visual (como romperse un vaso), el sonido correspondiente se genere en el mismo milisegundo.
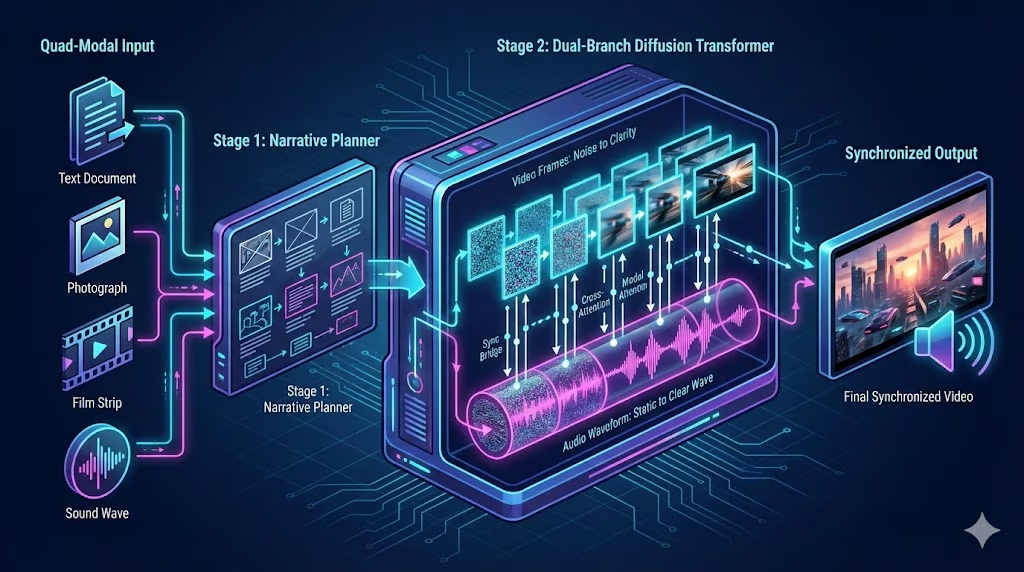
Arquitectura de alto nivel del transformador de difusión de doble rama de Seedance 2.0

Funciones clave de Seedance 2.0

Ahora que sabemos cómo funciona, veamos qué puede hacer Seedance 2.0. Dos de las funciones más interesantes son su sistema de referencia cuatrimodal y su storyboard nativo multitiro.

Sistema de referencia multimodal integral

Seedream 2.0 te permite mostrarle lo que quieres, no solo contárselo. Puedes subir hasta 12 archivos (9 imágenes, 3 vídeos y 3 clips de audio) y asignarles roles concretos usando un sistema de referencias con @.

  • ¿Necesitas un actor concreto? Sube su foto y etiquétala como referencia de personaje.
  • ¿Quieres un movimiento de cámara específico? Sube un vídeo de ejemplo y etiquétalo como referencia de movimiento.
  • ¿Tienes un ritmo concreto? Sube una canción y etiquétala como referencia de ritmo.

El modelo separa estas entradas y las combina, permitiéndote "dirigir" la escena con recursos concretos en lugar de fiarte de la suerte.

Para que te hagas una idea más clara de cómo se ve en acción, aquí tienes un ejemplo:

Prompt: "Sustituye al modelo del vídeo promocional @Video1 por una modelo occidental, tomando como referencia la apariencia de @Image2. Cambia todo el idioma hablado a inglés". (Fuente: SD AI Animation Storyteller en X)

El resultado es muy llamativo. Seedance siguió las instrucciones por completo, captó casi a la perfección el look del modelo de referencia y ajustó el lip sync al traducir el audio al inglés. Como detalle, el comportamiento del reflejo en las gafas se conserva tal cual.

Storyboard multitiro

La función de storyboard multitiro pone a Seedance 2.0 en el papel de director y editor a la vez. Así funciona:

  1. El modelo divide automáticamente una narrativa en varios planos conectados.
  2. Para cada plano, selecciona el tipo de cámara adecuado.
  3. Por último, compone los planos y añade transiciones entre ellos.

Prompt: "Avenger's Endgame durante la gran escena de la batalla, pero Thanos detiene todo y les dice a los superhéroes que lo siente. Todos los superhéroes lo aceptan de inmediato y empiezan a irse, pero entonces Spiderman dice: \"Ni de broma, ¡mató a un mogollón de gente!\" Y todos vuelven corriendo y le patean cuando ya está en el suelo". (Fuente: Christopher Fryant en X)

Este es un buen ejemplo del storyboard en acción. El plano general del principio, el zoom a Thanos, el paneo hacia Thor y el corte brusco a Spiderman: todo resulta coherente y muy en la línea del universo Avengers, sin necesidad de pedir explícitamente ninguno de esos movimientos de cámara.

Generación nativa de efectos de sonido y clonación de voz

Hasta hace poco, la generación nativa de audio ya habría sido por sí sola una función rompedora, pero hoy en día es un estándar esperado. Aun así, Seedance 2.0 no solo genera vídeo y audio sincronizados, sino que también incluye diálogos multilingües, sonidos ambiente y efectos sonoros vinculados a la acción.

Una función muy potente habilitada por la entrada de audio es la clonación de voz, supuestamente multilocutor, de modo que puedes tener hasta 3 voces de personaje personalizadas por escena (ya que ese es el límite de archivos de audio). Permite subir voces reales para guiar acento, tono e incluso conversaciones entre varios personajes.

Aunque ya hemos visto en acción las capacidades de idioma y sincronización labial en los ejemplos de traducción, veamos cómo crea Seedance música de fondo y efectos de sonido desde cero.

Prompt (usando archivos de referencia): "La mujer de @Image1 se acerca al espejo y mira su reflejo. Su pose debe tomar como referencia @Image2. Tras un momento de contemplación, de repente se derrumba y empieza a gritar. La acción de agarrar el espejo, así como las emociones y expresiones faciales durante el derrumbe y el grito, deben referenciar por completo @Video1". (Fuente: Feyber en X)

El ejemplo muestra que el modelo puede manejar varias emociones contrapuestas dentro de la misma escena, no solo a nivel visual, sino también acústico. 

La música triste del principio refleja bien la expresión de la protagonista y vira hacia un tono más de terror cuando grita enfadada al espejo. La música de fondo no interfiere con su grito ni con el sonido de agarrar el espejo, sino que lo complementa.

Visuales cinematográficos en alta resolución

Seedance admite salidas de hasta 2K, múltiples relaciones de aspecto y frecuencias de 24–60 fps, según la plataforma. Potencia la estética cinematográfica cuidando detalles como:

  • Texturas detalladas
  • Iluminación global robusta
  • Corrección de color tipo cine

Otro foco del desarrollo de Seedance 2.0 ha sido respetar la física. Estas dos facetas van de la mano, como vemos en el siguiente ejemplo:

Prompt: "Una secuencia de acción cinematográfica de alta energía por la noche en una ciudad con neones; la cámara sigue a un personaje solitario que corre por calles mojadas por la lluvia mientras drones policiales y faros pasan borrosos; cortes rápidos entre primeros planos de ojos decididos, botas salpicando charcos y planos generales con coches que casi lo atropellan; la cámara hace whip-pan mientras salta vallas, se desliza sobre capós y esquiva explosiones que estallan detrás de él; motion blur intenso e iluminación dinámica; sensación de cámara al hombro con push-ins agresivos; contraste dramático, coreografías rápidas, impactos secos y un remate a cámara lenta al saltar desde una azotea a la oscuridad mientras las luces de la ciudad se estiran debajo". (Fuente: Txori en X)

El resultado parece sacado de una película de acción. El movimiento de cámara, la iluminación e incluso la física del agua salpicando de un charco están muy logrados. Lo que chirría es que el personaje salta desde una azotea justo después de correr por una calle.

Una rareza obvia e interesante es que, aunque el personaje solo se describía como "solitario", resulta ser una copia calcada de Keanu Reeves. 

Si piensas en el prompt cargado de acción y el ambiente distópico ("ciudad con neones", "calles empapadas", "drones policiales"), se entiende de dónde viene. La única duda es si la inspiración procede de The Matrix, John Wick o Cyberpunk 2077 (o una mezcla de los tres).

¿Qué tan bueno es Seedance 2.0?

Sinceramente, los vídeos que vimos al presentar funciones hablan por sí solos. En esta sección quiero centrarme en dos problemas de la generación de vídeo que los puntos fuertes de Seedance 2.0 ayudan a mitigar.

Adiós a la dependencia de los "prompts mágicos"

Un gran punto de dolor de la primera generación de vídeo con IA fue la ingeniería de prompts en caja negra: los creadores tenían que descubrir "prompts mágicos" y fórmulas rebuscadas para obtener resultados usables de modelos con comprensión semántica débil y controles limitados.

Aquí es donde el sistema de referencias integral y el storyboard multitiro son muy útiles. La combinación de poder mapear recursos a roles y un modelo que entiende el contexto a través de distintos planos de una escena ofrece resultados impactantes sin necesidad de "exprimir el prompt". Además evita sobrecargar el prompt (y al propio modelo).

Un buen ejemplo es el uso de rejillas de 3x3 imágenes. Con 9 imágenes de referencia que representan distintos planos de una escena, puedes obtener salidas decentes incluso sin trabajar nada el prompt. Veamos qué devolvió el modelo a partir de la siguiente rejilla como entrada, combinada con un prompt tan simple como se puede:
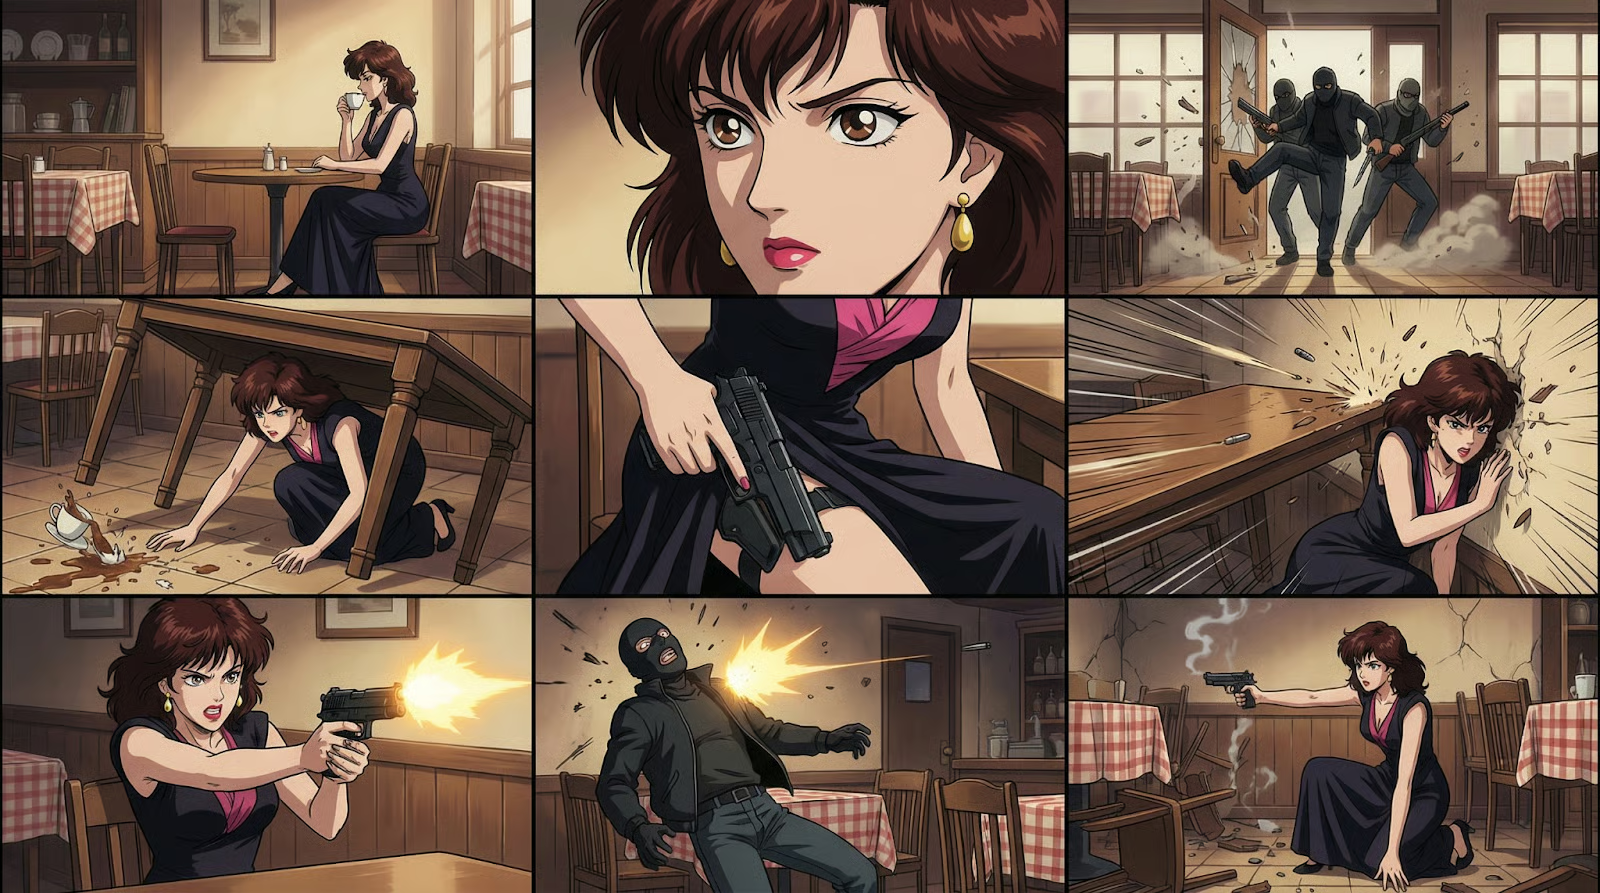
Rejilla 3x3 que muestra una escena de acción anime

Prompt: "Generar vídeo a partir del storyboard". (Fuente: Mr.Iancu en X)

De nuevo, un resultado muy sólido. El modelo entiende de forma natural el contexto de la escena y rellena los huecos entre fotogramas. Algo que no tiene mucho sentido es que, a mitad del vídeo, uno de los atacantes parece estar de pie en la esquina detrás de ella durante unos fotogramas.

Otro fallo menor que (creí) ver fue que la mesa estaba de pie, lo que no daría cobertura al personaje; pero si miras bien la esquina inferior izquierda, verás que el error ya estaba en la rejilla de imágenes, que fue generada por Nano Banana Pro.

Solucionar el problema de los "clips desechables"

Con modelos anteriores, la generación de vídeo a menudo era una lotería para dar con el clip correcto por casualidad, con muchos intentos (caros) "desechables" por el camino. El storyboard multitiro automático ataja esto y descompone muy bien los prompts narrativos en múltiples planos.

Seedance 2.0 ofrece una consistencia de identidad y de escena muy superior a la de modelos anteriores. Esto reduce drásticamente artefactos molestos como deriva de personajes, cambios repentinos de apariencia o parpadeos que a menudo hacían inservibles clips prometedores.

Prompt: "Un documental de naturaleza sobre una nutria pilotando un avión". (Fuente: ChinaTechTrend en X)

¿Cuáles son las limitaciones de Seedance 2.0?

Con todos los puntos fuertes sobre la mesa, veamos algunas limitaciones del modelo Seedance 2.0.

Escenas complejas con capas y cristal

Se ha informado de que a Seedance 2.0 le cuesta manejar múltiples capas en movimiento detrás de un cristal, lo cual, admitámoslo, es un reto complejo para cualquier modelo de generación de vídeo (y además un caso poco frecuente). 

Sin embargo, el único ejemplo que he encontrado se comenta en esta review en YouTube. Muestra "una escena típica de exterior para una escena de cafetería, con aire Cyberpunk, mirando a través del cristal; personaje dentro, coches moviéndose fuera". La salida parecía en parte muy natural, con gotas de lluvia en la ventana y animación de respiración, pero el conjunto de la escena se movía de forma antinatural (como si estuviera "atada a un coche").

Parecía que una escena con cristal a ambos lados del personaje, con un fondo adicional detrás de la segunda capa de cristal, era demasiado para Seedream 2.0, y dejó de distinguir entre el fondo estático y los coches en movimiento.

En el ejemplo anterior de la modelo con gafas, la transparencia y el reflejo estaban muy bien resueltos, pero cabe señalar que a) era un ejemplo mucho más simple y b) usaba un vídeo de referencia que servía de plantilla para el modelo.

Pequeñas incoherencias y texto de fondo

Algunas incoherencias se deben más a una mala interpretación del contexto codificado que a una mala generación de vídeo per se. Por ejemplo, al pedir una escena crossover de Game of Thrones y Friends, insertó por accidente a un personaje de How I Met Your Mother:

Prompt: "El elenco de Friends protagoniza la sitcom de Game of Thrones. Chandler interpreta al rey Joffrey. Joey es la Mano". (Fuente: Gavin Purcell en X)

Como en el ejemplo de Keanu Reeves, se intuye de dónde proviene: ambas series son sitcoms muy similares, por lo que sus representaciones vectoriales estarán muy próximas.

Aunque los textos de fondo suelen ser legibles incluso en escenas con mucho movimiento (piensa en el ejemplo de Keanu Reeves), en algunos casos aparecen algo pixelados. Por ejemplo, fíjate en las vallas publicitarias de este vídeo de baloncesto de una niña anotando contra Lebron James que se hizo viral:

Prompt desconocido (Fuente: Serge Bulaev en X)

De nuevo, un resultado muy logrado en conjunto: los movimientos de los jugadores son realistas, la cámara mantiene el foco en la niña que bota el balón y tanto las sombras como el ruido de fondo se corresponden con lo que vemos. Por desgracia, no se compartió el prompt usado en este ejemplo.

Escenarios de actuaciones musicales

Es difícil precisar la razón, pero he visto que escenas con actuaciones musicales, como conciertos, siguen teniendo un poco de ese viejo valle inquietante. Aquí va un ejemplo de escena de concierto K-pop:

Prompt: "Escena épica de concierto K-pop: escenario dramático con luces, efectos y energía, sin mostrar personas reales". (Fuente: Ankit Patel en X)

Hay varias cosas a destacar. Para empezar, el sonido incluye la canción (con eco adecuado y ruido del público). Sin embargo, me suena algo acartonado. El movimiento de los miembros de la banda también se ve un pelín raro, con la corista de la izquierda fundiéndose con el escenario.

Seedance 2.0 frente a sus competidores

Veamos cómo se compara Seedance 2.0 con sus tres principales competidores.

Categoría

Seedance 2.0

OpenAI Sora 2

Google Veo 3.1

Kuaishou Kling 3.0

Calidad cinematográfica y resolución

2K comercial: optimizado para una estética digital nítida; ideal para clips cortos e impactantes.

Fidelidad de simulación del mundo: prioriza la coherencia a largo plazo (20 s) y la simulación de alta fidelidad.

Elección del director de foto: colorimetría tipo cine superior, HDR y profundidad de campo profesional.

1080p de alta calidad: excelente adherencia al prompt, aunque con menor resolución que Seedance.

Realismo del movimiento y física

Priori aprendidos: movimiento estable de personajes derivado de vídeos de referencia.

Líder en física: mejor en gravedad, fluidos, colisiones y permanencia de objetos (incluso fuera de plano).

Maestría de cámara: destaca en movimientos cinematográficos realistas (paneos, travellings) y consistencia temporal (60 s).

Maestro del movimiento: maneja acciones humanas complejas (comer, pelear) e interacciones físicas (balancines).

Control del director y entradas

Referencia cuatrimodal: sistema único para asignar roles específicos a entradas de texto, foto, vídeo y audio.

Impulsado por texto: principalmente prompts de texto con soporte limitado de imagen; sin asignación multiarchivo.

Edición con máscara: control preciso mediante enmascarado e iteración por texto.

Omni Mode y Brush: incluye "Motion Brush" para trayectorias y vincula múltiples personajes/elementos.

Capacidades de audio

Sincronía de doble rama: genera audio y vídeo simultáneamente con sincronización precisa a nivel de fotograma.

Posprocesado: genera primero el vídeo y añade el audio después; sincronía menos ajustada.

Herramientas externas: depende de tecnología separada (p. ej., AudioSet), con sincronización menos precisa.

Audio nativo: genera audio con tonos de personaje y lenguas diferenciadas.

Velocidad de producción y acceso

Alto rendimiento: <60 s para clips de 5 s. Disponibilidad oficial limitada a China.

Premium/lento: computacionalmente pesado y más lento; orientado a investigación/premium.

Restringido: generación más lenta (minutos); acceso limitado a testers/partners de confianza.

Accesible: plataforma web rápida con mejor acceso global, aunque ~30% más lenta que Seedance.

Seedance 2.0 vs Sora 2

Uno de los principales reclamos de Sora 2 es que está diseñado como un "simulador de realidad" con una comprensión física profunda, destacando en modelado de gravedad, dinámica de fluidos y permanencia de objetos. Aunque no es un foco principal de Seedance 2.0, los primeros resultados muestran que no se queda significativamente atrás respecto a Sora 2 en este aspecto y puede competir.

El sistema de referencias cuatrimodal de Seedance, por su parte, es algo que falta en Sora, que solo funciona como modelo de texto a vídeo e imagen a vídeo. Por tanto, clonar estilos o personajes concretos es bastante estático en Sora, frente a la capacidad de copiar el movimiento de escenas completas o clonar voces en Seedance.

Aunque Sora 2 puede generar vídeo de alta calidad, trata el audio como un proceso separado y secundario. La arquitectura de transformador de doble rama de Seedance 2.0 es fundamentalmente distinta, ya que genera vídeo y audio simultáneamente en una sola pasada. Esto permite una sincronización más ajustada y precisa a nivel de fotograma (como que los pasos suenen exactamente cuando el pie toca el suelo) que en Veo.

Seedance 2.0 vs Google Veo 3.1

Veo 3.1 ofrece a los directores un control preciso mediante su herramienta de edición con máscara, que permite seleccionar y modificar regiones específicas de un vídeo (p. ej., cambiar la ropa de un personaje) dejando el resto intacto. También admite comandos de cámara concretos (pan, tilt, zoom) para emular técnicas tradicionales de rodaje. 

Seedance 2.0 adopta un enfoque distinto al control con su sistema de referencias cuatrimodal. En lugar de máscaras de edición, los usuarios de Seedance pueden clonar estilos o movimientos subiendo vídeos e imágenes de referencia. Si Veo es una suite de edición digital, Seedance es un motor de "transferencia de estilo" llevado al extremo, lo que lo hace aún mejor para replicar un ambiente o movimiento concretos.

Al igual que Sora 2, Veo 3.1 no puede competir con Seedance 2.0 en sincronización entre audio y vídeo.

Seedance 2.0 vs Kling 3.0

Ambos modelos destacan en mantener consistentes a los personajes, pero lo logran de manera diferente. Kling 3.0 utiliza Omni Mode para "vincular" personajes específicos (caras, ropa) y reutilizarlos en múltiples planos o escenas. En esencia, crea una biblioteca de recursos a la que puedes llamar con una referencia @. 

Comparado con el sistema de referencias cuatrimodal de Seedance 2.0, la diferencia está en si quieres clonar algo externo o mantener intactos artefactos generados. Kling es mejor para construir un reparto reutilizable para una serie, mientras que Seedance es mejor para "transferir estilo" de un ambiente o movimiento de cámara concreto desde un clip existente a un nuevo sujeto.

Kling 3.0 ofrece control preciso sobre el tono y la emoción del diálogo generado (p. ej., "susurrando", "entusiasmado", "sarcástico") y admite voz multilingüe de forma nativa, con resultados notables. Aunque su sincronización audio-vídeo supera a Veo 3.1 y Sora 2, Seedance 2.0 aún mantiene una ligera ventaja.

Reflexiones finales 

Los primeros resultados del modelo Seedance 2.0 de ByteDance son muy prometedores y apuntan a un salto en la generación de vídeo con IA. Especialmente la combinación de sus entradas cuatrimodales y el storyboard automático multitiro tiene potencial para cambiar las reglas del juego en casos de uso que van de la publicidad y el prototipado al cine y los videojuegos.

Ahora bien, este poder trae fricciones inmediatas. La capacidad del modelo de clonar voces a partir de una sola foto y de generar involuntariamente figuras con copyright (como el doble de Keanu Reeves sin pedirlo) ya ha obligado a ByteDance a suspender urgentemente ciertas funciones de referencia de "personas reales" y endurecer la verificación de identidad.

Será interesante ver cómo reaccionan actores como Google y OpenAI al lanzamiento de Seedance y si las restricciones de acceso global se relajarán, liberando a los usuarios de depender de wrappers de API de terceros. Estamos siguiendo de cerca la situación y publicaremos un análisis práctico completo en cuanto consigamos acceso directo para poner a prueba el modelo por nosotros mismos.

Si te interesan los conceptos que hacen posibles herramientas avanzadas como Seedream 2.0, te recomiendo inscribirte en nuestro itinerario de habilidades AI Fundamentals.

Seedance 2.0: preguntas frecuentes

¿Seedance 2.0 es gratuito?

No. Actualmente, Seedance 2.0 está disponible a través de la plataforma "Jimeng" de ByteDance en China, que requiere suscripción de pago (según se informa, los planes parten de unos 69 RMB). Los usuarios internacionales suelen acceder mediante agregadores o wrappers de API de terceros, que establecen sus propios precios.

¿Cómo puedo acceder a Seedance 2.0 fuera de China?

El acceso directo a la plataforma Jimeng suele requerir número de teléfono y método de pago chinos. La mayoría de usuarios fuera de China dependen por ahora de sitios wrapper de IA o servicios de API que integran el modelo Seedance, aunque son no oficiales y pueden tener límites de uso o costes distintos. Se espera acceso a través de la plataforma Dreamina de CapCut (Dreamina) a finales de febrero de 2026.

¿Puedo clonar a una persona o un estilo concretos en Seedance 2.0?

Sí, pero con matices. Puedes subir imágenes de referencia para "clonar" la apariencia de un personaje o un vídeo para copiar un movimiento de cámara concreto. Sin embargo, tras la generación accidental de parecidos razonables de celebridades, ByteDance habría reforzado las restricciones sobre referencias de personas reales para prevenir deepfakes e infracciones de copyright.

¿Seedance 2.0 genera sonido?

Sí. A diferencia de muchos competidores que generan primero el vídeo y añaden el sonido después, Seedance 2.0 usa un transformador de difusión de doble rama para generar simultáneamente fotogramas de vídeo y formas de onda de audio. El resultado es una sincronización más ajustada, donde los efectos (como pasos o cristales rompiéndose) encajan al fotograma con la acción visual.

¿Qué diferencia a Seedance 2.0 de Sora 2 de OpenAI?

Mientras Sora 2 se centra en simular la física del mundo real y en vídeos de larga duración, Seedance 2.0 prioriza la "velocidad comercial" y el control del director. Su función estrella es el sistema de referencias cuatrimodal, que permite subir hasta 12 imágenes, vídeos y archivos de audio para asignar roles precisos (como referencia de personaje o de movimiento de cámara), ofreciendo un control más directo que el prompting principalmente textual de Sora.


Tom Farnschläder's photo
Author
Tom Farnschläder
LinkedIn

Editor de ciencia de datos en DataCamp | Me encanta hacer previsiones y crear con API.

Temas
IA Generativa
Inteligencia Artificial

Cursos de IA generativa

Curso

Conceptos de la IA generativa

2 h
119K
Aprovecha la IA generativa con responsabilidad, aprende cómo se desarrollan estos modelos de IA y cómo afectarán a la sociedad en el futuro.
Ver detallesRight Arrow
Empezar Curso
Ver másRight Arrow
Relacionado

blog

Los 7 mejores generadores de vídeo con IA para 2026 con vídeos de ejemplo

Descubre los mejores generadores de vídeo con IA disponibles en la actualidad, entre los que se incluyen RunwayML, Synthesia, Colossyan, Pictory, DeepBrain AI, Invideo y los muy esperados Sora y Veo de DeepMind.
Dr Ana Rojo-Echeburúa's photo

Dr Ana Rojo-Echeburúa

9 min

blog

¿Qué es Sora de OpenAI? Cómo funciona, Ejemplos, Características

Descubre Sora de OpenAI a través de vídeos de ejemplo y explora sus funciones, como Remix, Re-cut, Loop, Storyboard, Blend y Style Preset.
Richie Cotton's photo

Richie Cotton

8 min

blog

SAM 2: Primeros pasos con el modelo 2 de Segmentar cualquier cosa de Meta

El SAM 2 (Segment Anything Model 2) de Meta AI es el primer modelo unificado capaz de segmentar cualquier objeto tanto en imágenes como en vídeos en tiempo real.
An AI juggles tasks

blog

Cinco proyectos que puedes crear con modelos de IA generativa (con ejemplos)

Aprende a utilizar modelos de IA generativa para crear un editor de imágenes, un chatbot similar a ChatGPT con pocos recursos y una aplicación clasificadora de aprobación de préstamos y a automatizar interacciones PDF y un asistente de voz con GPT.
Abid Ali Awan's photo

Abid Ali Awan

10 min

blog

¿Qué es un modelo generativo?

Los modelos generativos utilizan el machine learning para descubrir patrones en los datos y generar datos nuevos. Conoce su importancia y sus aplicaciones en la IA.
Abid Ali Awan's photo

Abid Ali Awan

11 min

Tutorial

Tutorial de DeepSeek-Coder-V2: Ejemplos, instalación, puntos de referencia

DeepSeek-Coder-V2 es un modelo de lenguaje de código de código abierto que rivaliza con el rendimiento de GPT-4, Gemini 1.5 Pro, Claude 3 Opus, Llama 3 70B o Codestral.
Dimitri Didmanidze's photo

Dimitri Didmanidze

8 min

Ver MásVer Más