Last chance! 50% off DataCamp Premium
Sale ends in
क्या यह वीडियो जेनरेशन के लिए “DeepSeek मोमेंट” है? ByteDance ने चुपचाप अपना Seedance 2.0 वीडियो जेनरेशन मॉडल जारी किया है, और इससे बने शुरुआती वीडियो उदाहरण वायरल हो रहे हैं।
इस गाइड में, मैं आपको बताऊंगा कि Seedance क्या है, इसकी प्रमुख विशेषताएं क्या हैं, और यह अंदर से कैसे काम करता है। मैं आपको नए वीडियो जेनरेशन मॉडल के एक्शन में उदाहरण भी दिखाऊंगा और इसकी ताकतों व कमजोरियों की तुलना अन्य प्रमुख मॉडलों से करूंगा। क्या यह Google के को Veo 3.1, OpenAI के Sora 2, और Kuaishou के Kling 3.0 को चुनौती दे सकता है?
Seedance 2.0 ByteDance का नवीनतम टेक्स्ट-टू-वीडियो और इमेज-टू-वीडियो जनरेटिव AI मॉडल है, जिसे 10 फरवरी, 2026 को जारी किया गया था।
स्रोत: Aleena Amir on X
क्योंकि ByteDance ने Seedance 2.0 के लिए कोई विधिवत अंग्रेजी रिलीज़ नोट प्रकाशित नहीं किया है, इसलिए अधिकतर सार्वजनिक स्पेक्स और फीचर दावे Jimeng के रोलआउट पर चीनी रिपोर्टिंग से पुनर्निर्मित हैं। कई तृतीय‑पक्ष रैपर साइटों पर “स्पेक शीट्स” आधिकारिक ByteDance डॉक्यूमेंटेशन के बजाय उन्हीं स्रोतों को दोहराती प्रतीत होती हैं।
चीनी मीडिया के परीक्षण और शुरुआती पार्टनर डॉक्यूमेंटेशन के अनुसार, Seedance 2.0 उत्कृष्ट कैरेक्टर कंसिस्टेंसी के साथ 2K सिनेमा-ग्रेड वीडियो आउटपुट का वादा करता है।
आधिकारिक रूप से, Seedance 2.0 मुख्यभूमि चीन में ByteDance के Jimeng के भीतर लाइव है, जहाँ यह भुगतान करने वाले सदस्यों के लिए उपलब्ध है (उदा., चीनी मीडिया द्वारा रिपोर्ट किए गए ≥69 RMB टीयर)। व्यवहार में, Jimeng एक्सेस चीन‑केंद्रित है, और अकाउंट वेरिफिकेशन व स्थानीय भुगतान ढाँचा सामान्य घर्षण बिंदु हैं।
Seedance 2.0 का लैंडिंग पेज पहले से दिखाई दे रहा है। हालाँकि, वास्तविक एक्सेस फिलहाल नियंत्रित है: अधिकांश उपयोगकर्ताओं को पूर्ण रोलआउट तक “Coming Soon” संदेश दिखेगा, जिसकी उद्योग सूत्रों के अनुसार उम्मीद 24 फरवरी, 2026 के आसपास है।
इस बीच, अंतरराष्ट्रीय उपयोगकर्ताओं के बीच सबसे लोकप्रिय वर्कअराउंड ChatCut है, एक तृतीय‑पक्ष AI वीडियो ऐप जिसने Seedance 2.0 को सीधे इंटीग्रेट किया है और बिना चीनी फोन नंबर के शुरुआती वैश्विक एक्सेस देता है। फिलहाल, यहाँ वेटलिस्ट है जिसपर साइन अप करना होगा।
जैसे Sora 2 और Veo 3.1, Seedance 2.0 एक डिफ्यूजन मॉडल है। यानी यह स्थिर शोर वाले फ्रेमों से शुरू करके, कई चरणों में उन्हें बदलते हुए एक सुसंगत वीडियो अनुक्रम प्रकट करता है।
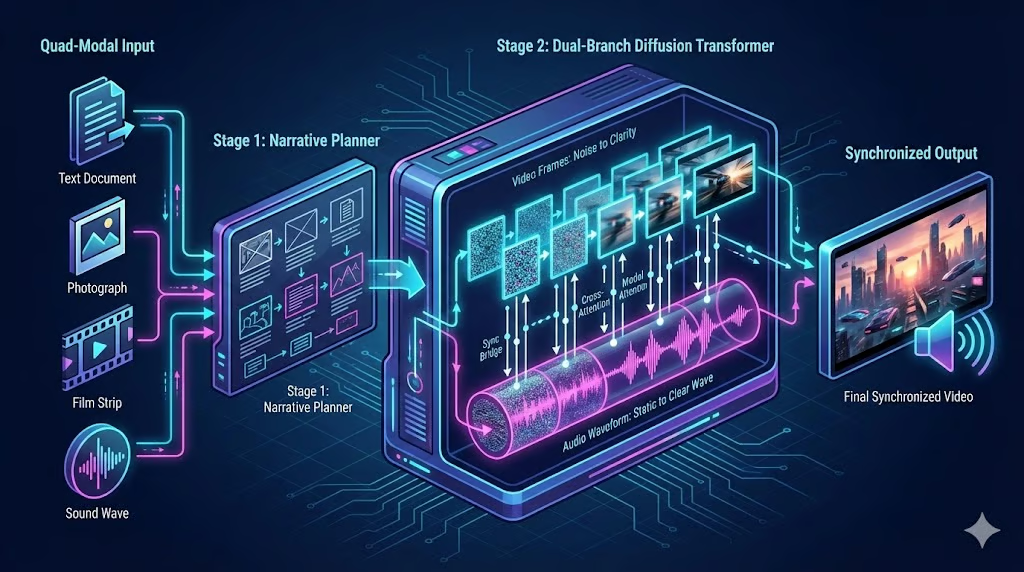
हालाँकि, पहले के टेक्स्ट-टू-वीडियो मॉडलों के विपरीत जो वीडियो को एक मूक, सिंगल‑शॉट क्लिप मानते थे, Seedance 2.0 को एक “मल्टीमोडल डायरेक्टर” के रूप में आर्किटेक्ट किया गया है, जो एक ही पास में साउंड, कहानी संरचना और जटिल विजुअल रेफरेंस संभाल सकता है।
पहले, AI से बिल्कुल वैसा बनवाने के लिए “प्रॉम्प्ट इंजीनियरिंग” करनी पड़ती थी—लंबे, जटिल टेक्स्ट विवरण टाइप करना और उम्मीद करना कि AI समझ ले। Seedance 2.0 इसे क्वाड‑मोडल इनपुट सिस्टम से सीन डायरेक्ट करके बदल देता है।
“क्वाड‑मोडल” का मतलब है कि Seedream टेक्स्ट, इमेज, वीडियो और ऑडियो इनपुट संभाल सकता है। क्वाड‑मोडल एन्कोडर एक बड़ा फ़नल नहीं है, बल्कि प्रत्येक डेटा प्रकार के लिए प्री‑ट्रेंड एन्कोडर्स का सेट है:
नतीजतन, चारों रॉ इनपुट्स को छिपी हुई वेक्टर भाषा में बदला जाता है ताकि इनपुट का गणितीय रूप से निरूपण हो सके।
पुराने AI वीडियो टूल्स की सबसे बड़ी झुंझलाहट सिंगल‑शॉट लिमिट थी। अगर आप कहानी मांगते, तो AI सब कुछ एक सतत, बिना एडिट किए हुए टेक में ठूँसने की कोशिश करता। चूँकि वीडियो की अवधि आमतौर पर कुछ सेकंड तक सीमित रहती थी, इसका परिणाम अक्सर अजीब वॉर्पिंग या प्रॉम्प्ट के हिस्सों की अनदेखी के रूप में निकलता था।
Seedance 2.0 मल्टी‑शॉट लॉजिक के साथ एक नैरेटिव प्लानर पेश करता है। एक पिक्सेल जनरेट करने से पहले, यह प्लानर एक स्टोरीबोर्ड आर्टिस्ट की तरह काम करता है। यह आपके प्रॉम्प्ट को पढ़कर उसे अलग‑अलग कैमरा शॉट्स के अनुक्रम में तोड़ देता है।
उदाहरण के लिए, यह शहर का वाइड शॉट से शुरू कर सकता है, फिर किसी व्यक्ति का मीडियम शॉट, और अंत में उनके चेहरे का क्लोज‑अप—वह भी बिना विस्तृत निर्देशों के। इसके बाद यह इन शॉट्स की जेनरेशन को क्रम में ऑर्केस्ट्रेट करता है।
यह साझा कंसिस्टेंसी डेटा का उपयोग करता है ताकि हर कट में व्यक्ति का चेहरा, कपड़े और लाइटिंग बिल्कुल एक जैसी बनी रहे। नतीजा एक एडिटेड मूवी सीक्वेंस जैसा लगता है, न कि कच्चा, हेलुसिनेटेड विडियो क्लिप।
अधिकांश AI वीडियो मॉडल मूक फिल्म कैमरे की तरह काम करते हैं: वे पहले वीडियो बनाते हैं, और आपको बाद में अलग टूल से साउंड जोड़ना पड़ता है। इससे अक्सर “ड्रिफ्ट” होता है, जहाँ कदमों की आवाज़ या दरवाज़ा पटकने की ध्वनि स्क्रीन पर दिख रही क्रिया से ठीक मेल नहीं खाती।
Seedance 2.0 इसे डुअल‑ब्रांच डिफ्यूजन ट्रांसफॉर्मर से हल करता है, जिसमें एक ट्रांसफॉर्मर वीडियो के लिए समर्पित है और दूसरा ऑडियो के लिए।
इसे ऐसे समझें जैसे दो गोलार्द्धों वाला दिमाग जो पूर्ण सामंजस्य में काम करता है। एक गोलार्द्ध पूरी तरह वीडियो फ्रेम जनरेट करने पर केंद्रित रहता है, जबकि दूसरा ऑडियो वेवफॉर्म जनरेट करता है। क्योंकि वे निर्माण प्रक्रिया के दौरान लगातार संवाद करते हैं, मॉडल सुनिश्चित करता है कि जब कोई विजुअल इवेंट होता है (जैसे काँच टूटना), तो संबंधित ध्वनि उसी मिलीसेकंड पर उत्पन्न हो।
अब जब हमें पता है कि यह कैसे काम करता है, तो देखते हैं Seedance 2.0 क्या कर सकता है। इसकी दो सबसे रोमांचक विशेषताएँ हैं—क्वाड‑मोडल ऑल‑अराउंड रेफरेंस सिस्टम और नैटिव मल्टी‑शॉट स्टोरीबोर्डिंग।
Seedream 2.0 आपको केवल बताने के बजाय इसे दिखाने देता है कि आप क्या चाहते हैं। आप अधिकतम 12 फाइलें (9 इमेज, 3 वीडियो, और 3 ऑडियो क्लिप) अपलोड कर सकते हैं और उन्हें @ रेफरेंस सिस्टम का उपयोग करके विशिष्ट भूमिकाएँ असाइन कर सकते हैं।
मॉडल इन इनपुट्स को अलग‑अलग करता है और मिलाकर उपयोग करता है, जिससे आप किस्मत पर निर्भर होने के बजाय ठोस असेट्स से सीन को “डायरेक्ट” कर सकते हैं।
यह आपको और स्पष्ट तस्वीर देने के लिए कि एक्शन में यह कैसा दिख सकता है, यहाँ एक उदाहरण है:
प्रॉम्प्ट: “प्रमोशनल वीडियो @Video1 में मॉडल को @Image2 में संदर्भित लुक के साथ एक वेस्टर्न मॉडल से बदलें। बोली जाने वाली भाषा को पूरी तरह अंग्रेजी में बदल दें।” (स्रोत: SD AI Animation Storyteller on X)
नतीजा बहुत प्रभावशाली है। Seedance ने निर्देशों का पूरी तरह पालन किया, रेफरेंस्ड मॉडल का लुक लगभग पूरी तरह कैप्चर किया, और ऑडियो को अंग्रेजी में अनुवाद करते समय लिप‑सिंक भी समायोजित कर दिया। खास तौर पर ध्यान देने वाली बात है कि चश्मे की रिफ्लेक्शन का व्यवहार पूरी तरह सुरक्षित रहा।
मल्टी‑शॉट स्टोरीबोर्डिंग फीचर Seedance 2.0 को एक साथ निर्देशक और संपादक, दोनों की भूमिका में रखता है। यह ऐसे काम करता है:
प्रॉम्प्ट: “Avenger's Endgame के बड़े फाइट सीन के दौरान, लेकिन Thanos सब कुछ रोक देता है और सभी सुपरहीरोज़ से कहता है कि उसे खेद है। सभी सुपरहीरोज़ तुरंत इसे स्वीकार कर लेते हैं और चले जाते हैं, लेकिन फिर Spiderman कहता है, \"ओह नहीं, उसने तो करोड़ों लोगों को मार डाला!\" और फिर वे सभी वापस भागते हैं और उसे नीचे गिरा कर लात मारते हैं।” (स्रोत: Christopher Fryant on X)
यह स्टोरीबोर्डिंग के एक्शन में होने का अच्छा उदाहरण है। शुरुआत का वाइड शॉट, Thanos पर ज़ूम‑इन, Thor की ओर टिल्ट, और Spiderman पर हार्ड कट—ये सब बिना किसी कैमरा मूवमेंट को स्पष्ट रूप से माँगे हुए भी बहुत सुसंगत लगते हैं और Avengers की फील से मेल खाते हैं।
कुछ समय पहले तक, नैटिव ऑडियो जेनरेशन अपने आप में एक किलर फीचर होता, लेकिन आजकल यह अपेक्षित मानक बन चुका है। फिर भी, Seedance 2.0 केवल सिंक्रोनाइज़्ड वीडियो और ऑडियो साथ‑साथ नहीं बनाता, बल्कि बहुभाषी संवाद, एंबियंट साउंड्स और एक्शन‑लिंक्ड साउंड इफेक्ट्स भी शामिल करता है।
ऑडियो इनपुट क्षमताओं से सक्षम एक बहुत बढ़िया फीचर वॉइस क्लोनिंग है, जो कथित तौर पर मल्टी‑स्पीकर है, यानी आप प्रति सीन अधिकतम 3 कस्टम कैरेक्टर वॉइस रख सकते हैं (क्योंकि यही ऑडियो फाइल लिमिट है)। यह उपयोगकर्ताओं को वास्तविक आवाज़ें अपलोड करके ऐक्सेंट, टोन, और यहाँ तक कि बहु‑चरित्र वार्तालाप को गाइड करने देता है।
जहाँ हमने अनुवाद उदाहरणों में भाषा और लिप‑सिंकिंग कौशल देख लिए हैं, वहीं अब देखते हैं कि Seedance बैकग्राउंड म्यूजिक और साउंड इफेक्ट्स खरोंच से कैसे बनाता है।
प्रॉम्प्ट (रेफरेंस फाइलों का उपयोग): “@Image1 में दिख रही महिला दर्पण तक चलकर जाती है और अपनी परछाईं देखती है। उसकी पोज़ @Image2 को संदर्भित करनी चाहिए। एक पल के विचार के बाद, वह अचानक टूट जाती है और चीखना शुरू कर देती है। दर्पण को पकड़ने की क्रिया, साथ ही टूटने और चीखने के दौरान की भावनाएँ और चेहरे के हावभाव, पूरी तरह से @Video1 को संदर्भित करने चाहिए।” (स्रोत: Feyber on X)
उदाहरण दिखाता है कि मॉडल एक ही सीन में कई परस्पर विरोधी भावनाओं को न केवल दृश्य रूप से, बल्कि ध्वनिक रूप से भी संभाल सकता है।
सीन की शुरुआत में उदास बैकग्राउंड म्यूजिक कैरेक्टर के चेहरे के हाव‑भाव को अच्छी तरह दर्शाता है, और जैसे ही वह गुस्से में दर्पण में चीखती है, वह अधिक हॉरर‑जैसी धुन में बदल जाता है। बैकग्राउंड म्यूजिक उसकी चीख या दर्पण पकड़ने की आवाज़ में दखल नहीं देता, बल्कि उसे अच्छे से कॉम्प्लिमेंट करता है।
Seedance अधिकतम 2K आउटपुट, कई आस्पेक्ट रेशियो, और 24–60 fps तक के फ्रेम रेट (प्लेटफॉर्म पर निर्भर) को सपोर्ट करता है। यह निम्नलिखित विवरणों पर ध्यान देकर सिनेमैटिक एस्थेटिक्स पर ज़ोर देता है:
Seedance 2.0 के विकास में एक और फोकस फिजिक्स का सम्मान करना था। ये दोनों विशेषताएँ हाथ‑में‑हाथ चलती हैं, जैसा कि हम अपने अगले उदाहरण से देख सकते हैं:
प्रॉम्प्ट: “रात में नीयन‑लाइट शहर में हाई‑एनर्जी सिनेमैटिक एक्शन सीक्वेंस, कैमरा बारिश‑भीगी सड़कों पर दौड़ते एक अकेले किरदार को ट्रैक करता है जबकि पुलिस ड्रोन और हेडलाइट्स धुंधला होकर गुज़रती हैं, कट्स जल्दी‑जल्दी होते हैं—दृढ़ नज़र का क्लोज़‑अप, पानी के गड्ढों में छपाक मारते जूते, और ट्रैफिक के वाइड शॉट्स जो उसे बाल‑बाल बचाते हैं; कैमरा व्हिप‑पैन करता है जब वह बैरियर्स के ऊपर से कूदता है, कार की हुड्स पर स्लाइड करता है, और पीछे भड़कती धमाकों से बचता है; तीव्र मोशन ब्लर और डायनेमिक लाइटिंग, हैंडहेल्ड कैमरा फील के साथ आक्रामक पुश‑इन्स, नाटकीय कंट्रास्ट, तेज कोरियोग्राफी, तीखे इम्पैक्ट्स, और अंत में स्लो‑मोशन जब वह एक रूफटॉप से अँधेरे में छलाँग लगाता है जबकि नीचे शहर की रोशनी धारियों जैसी दिखती हैं।” (स्रोत: Txori on X)
यह परिणाम किसी एक्शन मूवी के सीन जैसा लगता है। कैमरा मूवमेंट, लाइटिंग, और यहाँ तक कि पानी के गड्ढे से उछलते पानी की फिजिक्स भी सटीक हैं। जो बात मेल नहीं खाती, वह है कि किरदार सड़क पर दौड़ने के तुरंत बाद इमारत की छत से कूद जाता है।
एक स्पष्ट पर रोचक बात यह है कि किरदार सिर्फ “अकेला” बताया गया था, फिर भी वह हूबहू Keanu Reeves जैसा बन गया।
अगर आप डिस्टोपियन सीनरी वाला एक्शन‑हैवी प्रॉम्प्ट देखें (“नीयन‑लाइट शहर”, “बारिश‑भीगा”, “पुलिस ड्रोन”), तो आप समझ सकते हैं कि यह कहाँ से आया। बस सवाल यह है कि प्रेरणा The Matrix, John Wick, या Cyberpunk 2077 से आती है (या तीनों का संयोजन है)।
ईमानदारी से कहें तो, फीचर इंट्रोडक्शन के दौरान देखे गए वीडियो अपने आप में बहुत कुछ कह देते हैं। इस सेक्शन में, मैं वीडियो जेनरेशन की दो समस्याओं पर ध्यान देना चाहता हूँ जिन्हें Seedance 2.0 की खूबियाँ कम करती हैं।
पहली पीढ़ी के AI वीडियो के लिए एक बड़ा दर्द‑बिंदु था ब्लैक‑बॉक्स प्रॉम्प्ट इंजीनियरिंग: क्रिएटर्स को “मैजिक प्रॉम्प्ट्स” और जुगाड़ू वाक्यांश खोजने पड़ते थे ताकि कमजोर सैमांटिक समझ और सीमित कंट्रोल्स वाले मॉडलों से उपयोगी परिणाम मिल सकें।
यहीं ऑल‑राउंड रेफरेंस सिस्टम और मल्टी‑शॉट स्टोरीबोर्डिंग दोनों बहुत काम आते हैं। असेट्स को रोल्स पर मैप करने की क्षमता और ऐसे मॉडल का संयोजन जो सीन के अलग‑अलग शॉट्स में कॉन्टेक्स्ट समझने में माहिर है, बिना “प्रॉम्प्ट‑मैक्सिंग” के प्रभावशाली परिणाम देता है। यह प्रॉम्प्ट को ओवरलोड करने (और मॉडल पर बोझ) से भी बचाता है।
एक अच्छा उदाहरण 3x3 इमेज ग्रिड्स का उपयोग है। एक सीन के अलग‑अलग शॉट्स का प्रतिनिधित्व करने वाली 9 रेफरेंस इमेज देने पर, आप बिना किसी प्रयास के भी ठीक‑ठाक आउटपुट पा सकते हैं। देखते हैं कि निम्नलिखित ग्रिड को इनपुट के रूप में, यथासंभव सरल प्रॉम्प्ट के साथ मिलाकर मॉडल ने क्या लौटाया:
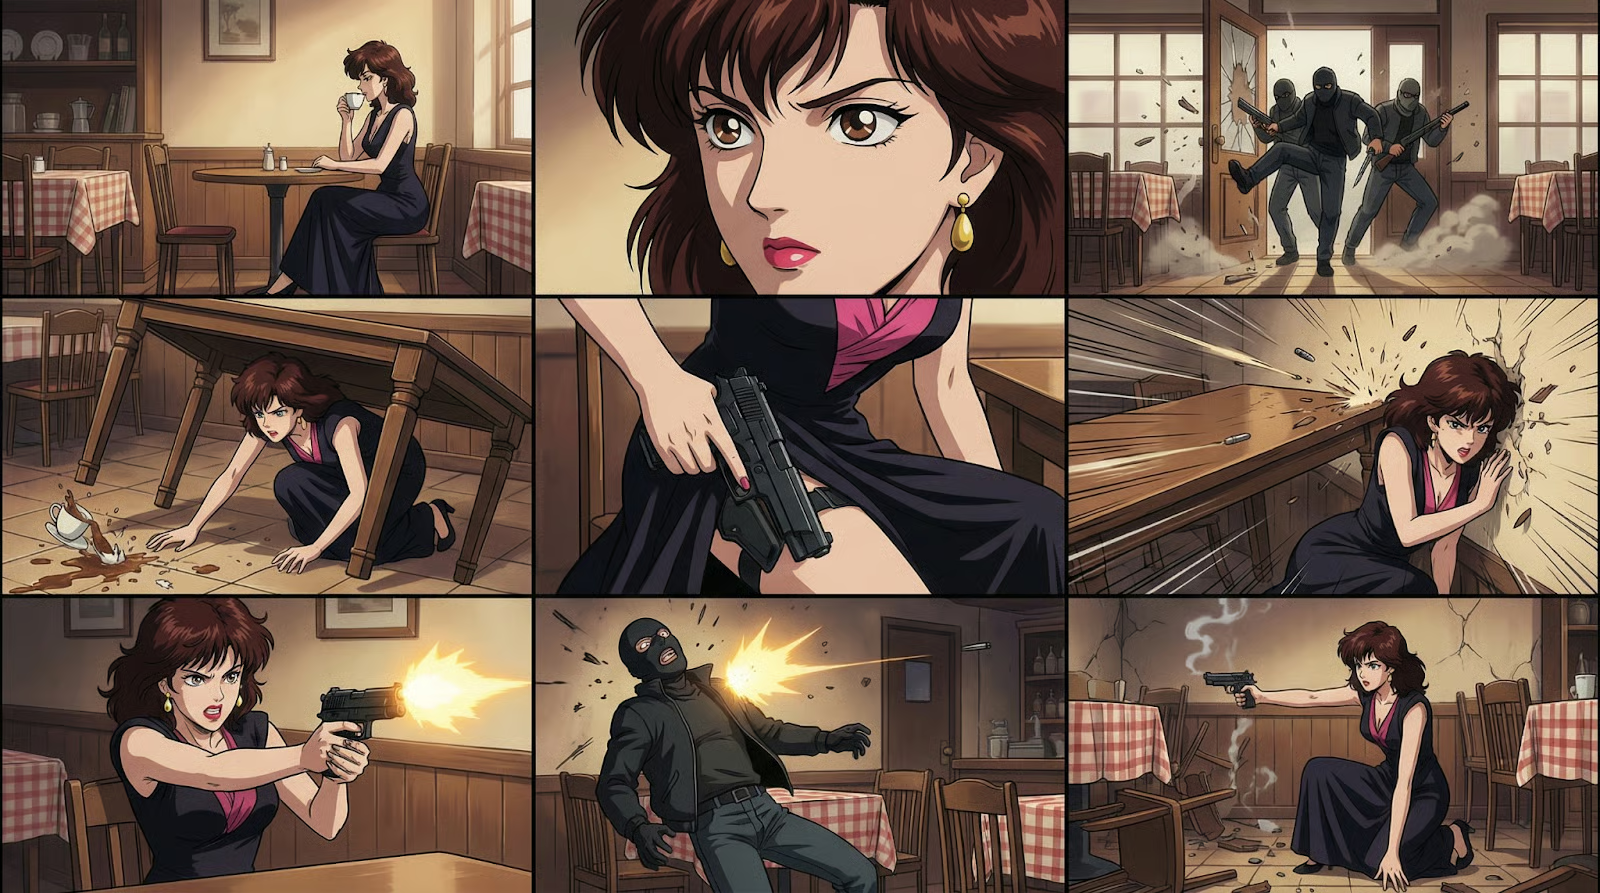
प्रॉम्प्ट: “स्टोरीबोर्ड से वीडियो जनरेट करें।” (स्रोत: Mr.Iancu on X)
फिर से, बहुत प्रभावशाली परिणाम। मॉडल स्वाभाविक रूप से सीन के संदर्भ को समझता है और व्यक्तिगत फ्रेमों के बीच की कड़ी भर देता है। एक बात जो समझ में नहीं आती, वह है कि वीडियो के बीच में, हमलावरों में से एक कुछ फ्रेमों के लिए उसके पीछे कोने में खड़ा दिखता है।
एक और छोटा सा दोष जो (मेरे ख्याल से) मैंने देखा, वह यह था कि टेबल सीधा खड़ा था, जो किरदार को कोई कवर नहीं देता—लेकिन यदि आप निचले‑बाएँ कोने में ध्यान से देखें, तो पता चलता है कि यह गलती पहले से ही इमेज ग्रिड का हिस्सा थी, जिसे ने Nano Banana Pro जेनरेट किया था।
पहले के मॉडलों में, वीडियो जेनरेशन अक्सर किस्मत के भरोसे सही क्लिप पा लेने की लॉटरी बन जाता था, जिसके दौरान बहुत से (महँगे) “थ्रोअवे” ट्राइज़ लगते थे। ऑटोमैटिक मल्टी‑शॉट स्टोरीबोर्डिंग इसे संबोधित करती है और नैरेटिव प्रॉम्प्ट्स को कई शॉट्स में तोड़ने का बढ़िया काम करती है।
Seedance 2.0 पहले के मॉडलों की तुलना में पहचान और सीन कंसिस्टेंसी को उल्लेखनीय रूप से बढ़ाता है। इससे कैरेक्टर ड्रिफ्ट, अचानक लुक बदलना, या फ्लिकरिंग जैसे परेशान करने वाले विजुअल आर्टिफैक्ट्स में भारी कमी आती है, जो अन्यथा अच्छे लगने वाले क्लिप्स को अनुपयोगी बना देते थे।
प्रॉम्प्ट: “एक ऊदबिलाव द्वारा विमान उड़ाने पर एक प्रकृति डॉक्युमेंट्री।” (स्रोत: ChinaTechTrend on X)
हमने जिन सभी खूबियों पर बात की, उन्हें ध्यान में रखते हुए, अब Seedance 2.0 मॉडल की कुछ सीमाएँ देखते हैं।
रिपोर्ट किया गया है कि Seedance 2.0 को काँच के पीछे कई गतिशील परतों से निपटने में कठिनाई होती है, जो मानना पड़ेगा कि किसी भी वीडियो जेनरेशन मॉडल के लिए चुनौतीपूर्ण कार्य है (और वैसे भी, बहुत आम एज केस नहीं है)।
हालाँकि, मुझे जो एकमात्र उदाहरण मिला, उस पर चर्चा की गई है इस YouTube समीक्षा में। इसमें दिखाया गया है “डाइनर सीन के लिए एक सामान्य बाहरी दृश्य, साइबरपंक‑जैसा, काँच के पार देखते हुए, अंदर किरदार, बाहर चलती कारें।” आउटपुट आंशिक रूप से बहुत प्राकृतिक दिखा, खिड़की पर बारिश की बूंदों और श्वसन ऐनिमेशन के साथ, लेकिन पूरा सीन अप्राकृतिक रूप से हिलता रहा (जैसे “कार से बँधा” हो)।
ऐसा लगा मानो किरदार के दोनों ओर काँच वाले सीन, और दूसरे काँच की परत के पीछे अतिरिक्त बैकग्राउंड सीनरी, Seedream 2.0 के लिए बहुत ज़्यादा हो गई, और वह स्थिर बैकग्राउंड और चलती कारों में फर्क नहीं कर पाया।
हमारे पहले वाले उदाहरण में जहाँ मॉडल अपने चश्मे दिखा रही थी, वहाँ पारदर्शिता और रिफ्लेक्शन दोनों सटीक थे, लेकिन ध्यान देना होगा कि a) वह काफ़ी सरल उदाहरण था, और b) उसमें रेफरेंस वीडियो का उपयोग हुआ था जो मॉडल के लिए टेम्पलेट का काम कर रहा था।
कुछ असंगतियाँ खराब वीडियो जेनरेशन से ज़्यादा एन्कोडेड संदर्भ की गलत व्याख्या का परिणाम लगती हैं। उदाहरण के लिए, जब Game of Thrones और Friends का क्रॉसओवर सीन बनाने को कहा गया, तो इसने गलती से How I Met Your Mother के एक किरदार को डाल दिया:
प्रॉम्प्ट: “Friends की कास्ट Game of Thrones सिटकॉम में स्टार करती है। Chandler किंग Joffrey की भूमिका में। Joey Hand है।” (स्रोत: Gavin Purcell on X)
Keanu Reeves वाले उदाहरण की तरह, आप अंदाज़ा लगा सकते हैं कि यह कहाँ से आता है: दोनों शो बहुत मिलते‑जुलते सिटकॉम हैं, इसलिए उनके वेक्टर रिप्रेजेंटेशन्स एक‑दूसरे के बेहद करीब होंगे।
जहाँ बैकग्राउंड टेक्स्ट आम तौर पर तेज़ मूवमेंट वाले दृश्यों में भी पढ़ने योग्य रहते हैं (Keanu Reeves वाले उदाहरण को सोचें), वहीं कुछ मामलों में वे थोड़ा पिक्सेलेटेड दिखते हैं। उदाहरण के लिए, इस वायरल हुए बास्केटबॉल वीडियो में, जहाँ एक बच्चे ने Lebron James के खिलाफ स्कोर किया, विज्ञापन बोर्ड्स को देखें:
प्रॉम्प्ट अज्ञात (स्रोत: Serge Bulaev on X)
फिर से, यह कुल मिलाकर बहुत प्रभावशाली परिणाम है: खिलाड़ियों की मूवमेंट्स बहुत वास्तविक हैं, कैमरा ड्रिब्लिंग करती लड़की पर फोकस बनाए रखता है, और छायाएँ व बैकग्राउंड शोर दोनों दृश्य के अनुरूप हैं। दुर्भाग्य से, इस उदाहरण में उपयोग किया गया प्रॉम्प्ट साझा नहीं किया गया था।
कारण तय करना कठिन है, लेकिन मैंने पाया कि संगीत प्रदर्शन वाले दृश्य, जैसे कॉन्सर्ट्स, अब भी थोड़े‑बहुत पुराने “अजीब‑सा” अहसास देते हैं। यहाँ K‑pop कॉन्सर्ट सीन का एक उदाहरण है:
प्रॉम्प्ट: “एपिक K‑pop कॉन्सर्ट सीन—ड्रामैटिक स्टेज लाइट्स, इफेक्ट्स और ऊर्जा के साथ, वास्तविक व्यक्तियों को दर्शाए बिना।” (स्रोत: Ankit Patel on X)
यहाँ कुछ बातें नोट करने लायक हैं। सबसे पहले, साउंड में गाना शामिल है (उचित इको और भीड़ के शोर सहित)। हालाँकि, यह मुझे थोड़ा खोखला सा लगता है। बैंड सदस्यों की मूवमेंट भी कुछ अटपटी लगती है, बाएँ वाले बैकग्राउंड सिंगर के स्टेज में घुलते‑मिलते हुए।
देखते हैं कि Seedance 2.0 अपने तीन मुख्य प्रतिद्वंद्वियों की तुलना में कैसा ठहरता है।
|
फ़ीचर श्रेणी |
Seedance 2.0 |
OpenAI Sora 2 |
Google Veo 3.1 |
Kuaishou Kling 3.0 |
|
सिनेमैटिक गुणवत्ता और रिज़ॉल्यूशन |
कमर्शियल 2K: शार्प, डिजिटल एस्थेटिक के लिए ऑप्टिमाइज़्ड; छोटे, प्रभावशाली क्लिप्स के लिए सर्वश्रेष्ठ। |
वर्ल्ड सिम फिडेलिटी: दीर्घकालिक सुसंगति (20s) और हाई‑फिडेलिटी सिमुलेशन पर केंद्रित। |
सिनेमैटोग्राफर की पसंद: श्रेष्ठ फिल्म‑जैसी कलर साइंस, HDR, और प्रोफेशनल डेप्थ‑ऑफ‑फील्ड। |
हाई‑क्वालिटी 1080p: उत्कृष्ट प्रॉम्प्ट अनुपालन, हालाँकि Seedance से कम रिज़ॉल्यूशन। |
|
मोशन रियलिज़्म और फिजिक्स |
लर्न्ड प्रायर्स: वीडियो रेफरेंसेज़ से व्युत्पन्न स्थिर कैरेक्टर मोशन। |
फिजिक्स लीडर: ग्रैविटी, फ्लूइड्स, कोलिज़न, और ऑब्जेक्ट परमानेंस (ऑफ‑स्क्रीन भी) में सर्वश्रेष्ठ। |
कैमरा मास्टरी: यथार्थपरक सिनेमैटिक मूवमेंट्स (पैन, डॉली) और टेम्पोरल कंसिस्टेंसी (60s) में उत्कृष्ट। |
मोशन मास्टर: जटिल मानवीय क्रियाएँ (खाना, लड़ना) और फिजिकल इंटरैक्शन्स (सी‑सा) संभालता है। |
|
डायरेक्टर कंट्रोल और इनपुट्स |
क्वाड‑मोडल रेफरेंस: टेक्स्ट, फोटो, वीडियो और ऑडियो इनपुट्स को विशिष्ट भूमिकाएँ देने के लिए अद्वितीय ग्राफ सिस्टम। |
टेक्स्ट‑ड्रिवन: मुख्यतः टेक्स्ट‑आधारित प्रॉम्प्ट्स, सीमित इमेज सपोर्ट; मल्टी‑फाइल असाइनमेंट का अभाव। |
मास्क्ड एडिटिंग: मास्किंग और टेक्स्ट‑आधारित इटरेशन के माध्यम से सटीक नियंत्रण देता है। |
ओम्नी मोड और ब्रश: “Motion Brush” पाथिंग के लिए; कई कैरेक्टर्स/एलीमेंट्स को बाँधता है। |
|
ऑडियो क्षमताएँ |
डुअल‑ब्रांच सिंक: कड़े, फ्रेम‑एक्यूरेट सिंक्रो के लिए ऑडियो/वीडियो एक साथ जनरेट करता है। |
पोस्ट‑प्रोसेस: पहले वीडियो, बाद में ऑडियो; टाइट सिंक का अभाव। |
बाहरी टूल्स: अलग तकनीक (जैसे, AudioSet) पर निर्भर, कम सटीक सिंक्रो। |
नैटिव ऑडियो: अलग‑अलग कैरेक्टर टोन और भाषाओं के साथ ऑडियो जनरेट करता है। |
|
प्रोडक्शन स्पीड और एक्सेस |
हाई थ्रूपुट: 5s क्लिप के लिए <60s। आधिकारिक उपलब्धता चीन तक सीमित। |
प्रीमियम/धीमा: कम्प्यूटेशनली भारी और धीमा; रिसर्च/प्रीमियम टूल के रूप में स्थित। |
प्रतिबंधित: धीमी जेनरेशन (मिनट्स); एक्सेस भरोसेमंद टेस्टर्स/पार्टनर्स तक सीमित। |
सुलभ: तेज़ वेब प्लेटफ़ॉर्म और बेहतर वैश्विक एक्सेस, हालाँकि Seedance से ~30% धीमा। |
Sora 2 की मुख्य विशेषताओं में से एक यह है कि इसे गहरी भौतिक समझ वाले “रियलिटी सिम्युलेटर” के रूप में आर्किटेक्ट किया गया है, जो ग्रैविटी, फ्लूड डायनेमिक्स और ऑब्जेक्ट परमानेंस का बेहतरीन मॉडलिंग करता है। हालाँकि यह Seedance 2.0 का प्राथमिक फोकस नहीं है, शुरुआती परिणाम दिखाते हैं कि इस मामले में यह Sora 2 से उल्लेखनीय रूप से पीछे नहीं है और प्रतिस्पर्धा कर सकता है।
दूसरी ओर, Seedance का क्वाड‑मोडल रेफरेंस सिस्टम Sora में नहीं है, जो केवल टेक्स्ट‑टू‑वीडियो और इमेज‑टू‑वीडियो मॉडल के रूप में काम करता है। इसलिए, Seedance में पूरी सीन की मूवमेंट कॉपी करने या वॉइस क्लोनिंग जैसी क्षमताओं की तुलना में Sora में विशिष्ट स्टाइल्स या कैरेक्टर्स को क्लोन करना काफी स्थिर है।
जहाँ Sora 2 उच्च‑गुणवत्ता का वीडियो बना सकता है, वहीं वह ऑडियो को अलग, द्वितीयक प्रक्रिया मानता है। Seedance 2.0 की डुअल‑ब्रांच ट्रांसफॉर्मर आर्किटेक्चर मौलिक रूप से अलग है, क्योंकि यह एक ही पास में वीडियो और ऑडियो साथ‑साथ जनरेट करता है। इससे Veo की तुलना में और भी कसा हुआ, फ्रेम‑एक्यूरेट सिंक्रो मिल पाता है (जैसे पाँव ज़मीन पर लगते ही कदमों की आवाज़)।
Veo 3.1 निर्देशक को अपने Masked Editing टूल के माध्यम से सटीक नियंत्रण देता है, जो उपयोगकर्ताओं को वीडियो के विशिष्ट हिस्सों का चयन और संशोधन करने देता है (उदा., किसी कैरेक्टर के कपड़े बदलना), जबकि बाकी हिस्सा यथावत रहता है। यह पारंपरिक फिल्म निर्माण तकनीकों की नकल करने के लिए विशिष्ट कैमरा कमांड्स (पैन, टिल्ट, ज़ूम) भी देता है।
Seedance 2.0 अपने क्वाड‑मोडल रेफरेंस सिस्टम के साथ नियंत्रण के प्रति अलग दृष्टिकोण अपनाता है। एडिटिंग मास्क्स की बजाय, Seedance उपयोगकर्ता रेफरेंस वीडियो और इमेजेस अपलोड करके स्टाइल्स या मोशन्स को क्लोन कर सकते हैं। यदि Veo एक डिजिटल एडिटिंग सूट है, तो Seedance “स्टाइल ट्रांसफर” इंजन का स्टेरॉयड‑संस्करण है, जो किसी विशिष्ट वाइब या मूवमेंट को दोहराने के लिए और भी उपयुक्त बनाता है।
Sora 2 की तरह, Veo 3.1 भी ऑडियो और वीडियो आउटपुट के सिंक्रोनाइज़ेशन में Seedance 2.0 से प्रतिस्पर्धा नहीं कर सकता।
दोनों मॉडल कैरेक्टर्स को सुसंगत रखने में उत्कृष्ट हैं, लेकिन वे इसे अलग तरह से हासिल करते हैं। Kling 3.0 Omni Mode का उपयोग करके विशिष्ट कैरेक्टर्स (चेहरे, कपड़े) को “बाइंड” करता है और उन्हें कई शॉट्स या सीन्स में पुन: उपयोग करता है। यह मूलतः एक असेट लाइब्रेरी बनाता है जिसे आप @ रेफरेंस से बुला सकते हैं।
यदि आप इसे Seedance 2.0 के क्वाड‑मोडल रेफरेंस सिस्टम से तुलना करें, तो अंतर इस बात में है कि आप बाहर से कुछ क्लोन करना चाहते हैं या जनरेटेड आर्टिफैक्ट्स को जस‑का‑तस रखना चाहते हैं। सीरीज़ के लिए पुन: प्रयोज्य कास्ट बनाने में Kling बेहतर है, जबकि किसी मौजूदा वीडियो क्लिप से किसी विशिष्ट वाइब या कैमरा मूव को नए सब्जेक्ट पर “स्टाइल ट्रांसफर” करने में Seedance बेहतर है।
Kling 3.0 जेनरेटेड संवाद के टोन और भावना (उदा., “फुसफुसाना,” “उत्साहित,” “व्यंग्यात्मक”) पर सटीक नियंत्रण देता है और नैटिव रूप से बहुभाषी वाणी सपोर्ट करता है, जो प्रभावशाली परिणाम देता है। जबकि इसका ऑडियो‑वीडियो सिंक्रोनाइज़ेशन Veo 3.1 और Sora 2 से बेहतर है, यहाँ भी Seedance 2.0 को हल्की बढ़त है।
ByteDance के Seedance 2.0 मॉडल के शुरुआती परिणाम बेहद प्रभावशाली हैं और AI वीडियो जेनरेशन में छलाँग का संकेत देते हैं। खासकर इसका क्वाड‑मोडल इनपुट और ऑटोमैटिक मल्टी‑शॉट स्टोरीबोर्डिंग का संयोजन विज्ञापन और प्रोटोटाइपिंग से लेकर फ़िल्म और गेमिंग तक के उपयोग मामलों में सच्चा गेम‑चेंजर बनने की क्षमता रखता है।
हालाँकि, यह शक्ति तत्काल घर्षण के साथ आती है। एक ही फोटो से आवाज़ क्लोन करने और अनजाने में कॉपीराइटेड व्यक्तियों (जैसे बिना माँगे Keanu Reeves जैसे दिखने वाले) को जेनरेट करने की मॉडल की क्षमता ने ByteDance को कुछ “रियल‑पर्सन” रेफरेंस फीचर्स को तत्काल निलंबित करने और पहचान सत्यापन कड़ा करने पर मजबूर किया है।
देखना दिलचस्प होगा कि Google और OpenAI जैसे बड़े खिलाड़ी Seedance की रिलीज़ पर कैसे प्रतिक्रिया देते हैं और क्या वैश्विक एक्सेस प्रतिबंध अंततः हटेंगे, जिससे उपयोगकर्ता तृतीय‑पक्ष API रैपर्स पर निर्भरता से मुक्त हो सकें। हम स्थिति पर कड़ी नज़र रख रहे हैं और जैसे ही हमें मॉडल की क्षमताओं का स्वयं परीक्षण करने के लिए प्रत्यक्ष एक्सेस मिलेगा, हम एक पूर्ण हैंड्स‑ऑन समीक्षा प्रदान करेंगे।
यदि आप उन अवधारणाओं में रुचि रखते हैं जो Seedream 2.0 जैसे उन्नत टूल्स को सक्षम बनाती हैं, तो मैं हमारे AI Fundamentals स्किल ट्रैक में नामांकन की सिफारिश करता/करती हूँ।
नहीं। वर्तमान में, Seedance 2.0 चीन में ByteDance के "Jimeng" प्लेटफ़ॉर्म के माध्यम से उपलब्ध है, जिसके लिए पेड सब्सक्रिप्शन चाहिए (रिपोर्ट किए गए टीयर लगभग 69 RMB से शुरू होते हैं)। अंतरराष्ट्रीय उपयोगकर्ता आमतौर पर तृतीय‑पक्ष API एग्रीगेटर्स या रैपर्स के माध्यम से एक्सेस करते हैं, जो अपनी स्वयं की कीमतें तय करते हैं।
Jimeng प्लेटफ़ॉर्म तक डायरेक्ट एक्सेस के लिए अक्सर चीनी फ़ोन नंबर और भुगतान विधि की आवश्यकता होती है। चीन के बाहर अधिकांश उपयोगकर्ता फिलहाल तृतीय‑पक्ष AI रैपर साइट्स या API सेवाओं पर निर्भर हैं जो Seedance मॉडल को इंटीग्रेट करती हैं, हालाँकि ये अनौपचारिक हैं और इनके उपयोग सीमा या लागत अलग हो सकती है। CapCut के Dreamina प्लेटफ़ॉर्म के माध्यम से एक्सेस की उम्मीद फरवरी 2026 के अंत तक है।
हाँ, लेकिन सीमाओं के साथ। आप किसी कैरेक्टर की उपस्थिति को “क्लोन” करने के लिए रेफरेंस इमेज अपलोड कर सकते हैं या किसी विशिष्ट कैमरा मूवमेंट को कॉपी करने के लिए वीडियो। हालाँकि, सेलिब्रिटी लुकअलाइक्स की अनैच्छिक जेनरेशन के बाद, ByteDance ने कथित तौर पर वास्तविक‑व्यक्ति रेफरेंसेज़ के उपयोग पर प्रतिबंध कड़े किए हैं, ताकि डीपफेक्स और कॉपीराइट उल्लंघन रोके जा सकें।
हाँ। कई प्रतिस्पर्धियों के विपरीत जो पहले वीडियो बनाते हैं और बाद में साउंड जोड़ते हैं, Seedance 2.0 डुअल‑ब्रांच डिफ्यूजन ट्रांसफॉर्मर का उपयोग करता है जो वीडियो फ्रेम्स और ऑडियो वेवफॉर्म्स को एक साथ जनरेट करता है। इससे कसा हुआ सिंक्रो मिलता है, जहाँ साउंड इफेक्ट्स (जैसे कदमों की आहट या काँच टूटना) विजुअल एक्शन के सापेक्ष फ्रेम‑एक्यूरेट होते हैं।
जहाँ Sora 2 वास्तविक‑विश्व भौतिकी और लंबे‑अवधि वीडियो के सिमुलेशन पर केंद्रित है, वहीं Seedance 2.0 “कमर्शियल स्पीड” और डायरेक्टर कंट्रोल को प्राथमिकता देता है। इसका सबसे अलग फीचर क्वाड‑मोडल रेफरेंस सिस्टम है, जो उपयोगकर्ताओं को अधिकतम 12 विशिष्ट इमेज, वीडियो और ऑडियो फाइलें अपलोड करके सटीक भूमिकाएँ असाइन करने देता है (जैसे कैरेक्टर रेफरेंस या कैमरा मोशन), जो Sora के मुख्यतः टेक्स्ट‑आधारित प्रॉम्प्टिंग की तुलना में अधिक डायरेक्ट कंट्रोल देता है।
टॉम एक डेटा साइंटिस्ट और तकनीकी शिक्षक हैं। वे DataCamp के डेटा साइंस ट्यूटोरियल्स और ब्लॉग पोस्ट लिखते और प्रबंधित करते हैं। इससे पहले, टॉम ने Deutsche Telekom में डेटा साइंस में काम किया था।
जनरेटिव AI पाठ्यक्रम
कोर्स
कोर्स
कोर्स