Corso
Introduzione a Python
4 ore
7.1M
Nel text mining, un gruppo importante di metriche riguarda la frequenza delle parole (o di qualsiasi token) in un certo corpus di documenti testuali. Tuttavia, puoi usare anche un insieme aggiuntivo di metriche nei casi in cui ogni documento abbia un valore numerico associato che descrive un certo attributo del documento.
Alcuni esempi:
In questo tutorial,
defaultdict del modulo collections per il grosso del lavoro, oltre ai DataFrame di pandas per gestire l’output finale.Supponiamo che tu abbia due tweet e che il loro contenuto e il numero di impression (visualizzazioni) siano i seguenti:
| Testo del tweet | Visualizzazioni |
|---|---|
| spain | 800 |
| france | 200 |
È semplice fare l’analisi di base e scoprire che le parole sono divise 50:50 tra "france" e "spain". In molti casi questo è tutto ciò che hai, e puoi solo misurare la frequenza assoluta delle parole e cercare di inferire certe relazioni. In questo caso, però, hai anche dei dati su ciascuno dei documenti.
La frequenza ponderata qui è chiaramente diversa, e la divisione è 80:20. In altre parole, sebbene "spain" e "france" compaiano una volta ciascuna nei tuoi tweet, dalla prospettiva dei lettori la prima è apparsa 800 volte, mentre la seconda 200 volte. C’è una grande differenza!
defaultdictOra considera questo esempio leggermente più articolato per un set simile di documenti:
| Documento | Visualizzazioni |
|---|---|
| france | 200 |
| spain | 180 |
| spain beaches | 170 |
| france beaches | 160 |
| spain best beaches | 160 |
Ora cicli sui documenti, li dividi in parole e conti le occorrenze di ciascuna parola:
 from collections import defaultdict

import pandas as pd

text_list = ['france', 'spain', 'spain beaches', 'france beaches', 'spain best beaches']

word_freq = defaultdict(int)

for text in text_list:
    for word in text.split():
        word_freq[word] += 1

pd.DataFrame.from_dict(word_freq, orient='index') \
.sort_values(0, ascending=False) \
.rename(columns={0: 'abs_freq'})| abs_freq | |
|---|---|
| spain | 3 |
| beaches | 3 |
| france | 2 |
| best | 1 |
Nel ciclo sopra, la prima riga itera su text_list uno alla volta. La seconda riga (all’interno di ciascun documento) itera sulle parole di ogni elemento, divise per lo spazio (che avrebbe potuto essere anche un altro carattere ("-", ",", "_", ecc.)).
Quando provi ad assegnare un valore a word_freq[word] ci sono due possibili scenari:
word esiste: in tal caso l’assegnazione avviene (aggiungendo uno)word non è in word_freq: in questo caso defaultdict chiama la funzione di default a cui è stato assegnato quando è stato definito, che in questo caso è int.Quando int viene chiamato restituisce zero. Ora la chiave esiste, il suo valore è zero, ed è pronta a ricevere un +1.
Anche se nella prima tabella la parola in cima era "france", dopo aver contato tutte le parole all’interno di ciascun documento vediamo che "spain" e "beaches" sono a pari merito al primo posto. Questo è importante per far emergere tendenze nascoste, soprattutto quando l’elenco di documenti con cui stai lavorando è dell’ordine delle decine o centinaia di migliaia.
Ora che hai contato le occorrenze di ciascuna parola nel corpus di documenti, vuoi vedere la frequenza ponderata. Cioè, vuoi vedere quante volte le parole sono apparse ai tuoi lettori, rispetto a quante volte le hai usate.
Nella prima tabella, la frequenza assoluta delle parole era divisa equamente tra "spain" e "france", ma "spain" aveva chiaramente molto più peso, perché il suo valore era 800, contro i 200 di "france".
Ma qual è la frequenza ponderata delle parole per la seconda tabella, leggermente più complessa?
Scopriamolo!
Puoi riutilizzare parte del codice di sopra, con alcune aggiunte:
 # default value is now a list with two ints
word_freq = defaultdict(lambda: [0, 0])

# the `views` column you had in the first DataFrame
num_list = [200, 180, 170, 160, 160]

# looping is now over both the text and the numbers
for text, num in zip(text_list, num_list):
    for word in text.split():
        # same as before
        word_freq[word][0] += 1
        # new line, incrementing the numeric value for each word
        word_freq[word][1] += num

columns = {0: 'abs_freq', 1: 'wtd_freq'}

abs_wtd_df = pd.DataFrame.from_dict(word_freq, orient='index') \
             .rename(columns=columns) \
             .sort_values('wtd_freq', ascending=False) \
             .assign(rel_value=lambda df: df['wtd_freq'] / df['abs_freq']) \
            .round()

abs_wtd_df.style.background_gradient(low=0, high=.7, subset=['rel_value'])| abs_freq | wtd_freq | rel_value | |
|---|---|---|---|
| spain | 3 | 510 | 170 |
| beaches | 3 | 490 | 163 |
| france | 2 | 360 | 180 |
| best | 1 | 160 | 160 |
Alcune osservazioni:
rel_value è una semplice divisione per ottenere il valore per occorrenza di ciascuna parola.rel_value, vedi anche che, pur essendo "france" piuttosto bassa nella metrica wtd_freq, sembra avere potenziale, perché il valore per occorrenza è alto. Questo potrebbe suggerire, per esempio, di aumentare la copertura di contenuti su "france".Potresti anche voler aggiungere altre metriche che mostrino le percentuali e le percentuali cumulative di ciascun tipo di frequenza, così da avere una prospettiva migliore su quante parole costituiscono la maggior parte del totale, se ce ne sono:
 abs_wtd_df.insert(1, 'abs_perc', value=abs_wtd_df['abs_freq'] / abs_wtd_df['abs_freq'].sum())
abs_wtd_df.insert(2, 'abs_perc_cum', abs_wtd_df['abs_perc'].cumsum())
abs_wtd_df.insert(4, 'wtd_freq_perc', abs_wtd_df['wtd_freq'] / abs_wtd_df['wtd_freq'].sum())
abs_wtd_df.insert(5, 'wtd_freq_perc_cum', abs_wtd_df['wtd_freq_perc'].cumsum())
abs_wtd_df.style.background_gradient(low=0, high=0.8)| abs_freq | abs_perc | abs_perc_cum | wtd_freq | wtd_freq_perc | wtd_freq_perc_cum | rel_value | |
|---|---|---|---|---|---|---|---|
| spain | 3 | 0.333333 | 0.333333 | 510 | 0.335526 | 0.335526 | 170 |
| beaches | 3 | 0.333333 | 0.666667 | 490 | 0.322368 | 0.657895 | 163 |
| france | 2 | 0.222222 | 0.888889 | 360 | 0.236842 | 0.894737 | 180 |
| best | 1 | 160 | 160 |
Altro si può analizzare, e con più dati in genere arrivano più sorprese.
Come potrebbe apparire tutto questo in un contesto reale con dati reali?
Esaminerai i titoli dei film, vedrai quali parole sono più usate nei titoli — cioè la frequenza assoluta — e quali parole sono associate al maggior incasso, ovvero la frequenza ponderata.
Boxoffice Mojo ha un elenco di oltre 15.000 film, insieme al relativo incasso lordo e posizioni in classifica. Inizia facendo scraping dei dati usando requests e BeautifulSoup — Puoi già esplorare Boxoffice Mojo qui se ti va:
import requests
from bs4 import BeautifulSoup
final_list = []
for i in range(1, 156):
if not i%10:
print(i)
page = 'http://www.boxofficemojo.com/alltime/domestic.htm?page=' + str(i) + '&p=.htm'
resp = requests.get(page)
soup = BeautifulSoup(resp.text, 'lxml')
# trial and error to get the exact positions
table_data = [x.text for x in soup.select('tr td')[11:511]]
# put every 5 values in a row
temp_list = [table_data[i:i+5] for i in range(0, len(table_data[:-4]), 5)]
for temp in temp_list:
final_list.append(temp)10
20
30
40
50
60
70
80
90
100
110
120
130
140
150
boxoffice_df = pd.DataFrame.from_records(final_list)

boxoffice_df.head(10)
| 0 | 1 | 2 | 3 | 4 | |
|---|---|---|---|---|---|
| 0 | 1 | Star Wars: The Force Awakens | BV | $936,662,225 | 2015 |
| 1 | 2 | Avatar | Fox | $760,507,625 | 2009^ |
| 2 | 3 | Black Panther | BV | $681,084,109 | 2018 |
| 3 | 4 | Titanic | Par. | $659,363,944 | 1997^ |
| 4 | 5 | Jurassic World | Uni. | $652,270,625 | 2015 |
| 5 | 6 | Marvel's The Avengers | BV | $623,357,910 | 2012 |
| 6 | 7 | Star Wars: The Last Jedi | BV | $620,181,382 | 2017 |
| 7 | 8 | The Dark Knight | WB | $534,858,444 | 2008^ |
| 8 | 9 | Rogue One: A Star Wars Story | BV | $532,177,324 | 2016 |
| 9 | 10 | Beauty and the Beast (2017) | BV | $504,014,165 | 2017 |
boxoffice_df.tail(15)
| 0 | 1 | 2 | 3 | 4 | |
|---|---|---|---|---|---|
| 15485 | 15486 | The Dark Hours | N/A | $423 | 2005 |
| 15486 | 15487 | 2:22 | Magn. | $422 | 2017 |
| 15487 | 15488 | State Park | Atl | $421 | 1988 |
| 15488 | 15489 | The Magician (2010) | Reg. | $406 | 2010 |
| 15489 | 15490 | Skinless | PPF | $400 | 2014 |
| 15490 | 15491 | Cinemanovels | Mont. | $398 | 2014 |
| 15491 | 15492 | Hannah: Buddhism's Untold Journey | KL | $396 | 2016 |
| 15492 | 15493 | Apartment 143 | Magn. | $383 | 2012 |
| 15493 | 15494 | The Marsh | All. | $336 | 2007 |
| 15494 | 15495 | The Chambermaid | FM | $315 | 2015 |
| 15495 | 15496 | News From Planet Mars | KL | $310 | 2016 |
| 15496 | 15497 | Trojan War | WB | $309 | 1997 |
| 15497 | 15498 | Lou! Journal infime | Distrib. | $287 | 2015 |
| 15498 | 15499 | Intervention | All. | $279 | 2007 |
| 15499 | 15500 | Playback | Magn. | $264 | 2012 |
Vedrai che alcuni valori numerici hanno caratteri speciali ($, , e ^), e alcuni valori sono in realtà N/A. Quindi devi sistemarli:
na_year_idx =  [i for i, x in enumerate(final_list) if x[4] == 'n/a'] # get the indexes of the 'n/a' values
new_years = [1998, 1999, 1960, 1973]  # got them by checking online

print(*[(i, x) for i, x in enumerate(final_list) if i in na_year_idx], sep='\n')
print('new year values:', new_years)
(8003, ['8004', 'Warner Bros. 75th Anniversary Film Festival', 'WB', '$741,855', 'n/a'])
(8148, ['8149', 'Hum Aapke Dil Mein Rahte Hain', 'Eros', '$668,678', 'n/a'])
(8197, ['8198', 'Purple Moon (Re-issue)', 'Mira.', '$640,945', 'n/a'])
(10469, ['10470', 'Amarcord', 'Jan.', '$125,493', 'n/a'])
new year values: [1998, 1999, 1960, 1973]
for na_year, new_year in zip(na_year_idx, new_years):
    final_list[na_year][4] = new_year
    print(final_list[na_year], new_year)
['8004', 'Warner Bros. 75th Anniversary Film Festival', 'WB', '$741,855', 1998] 1998
['8149', 'Hum Aapke Dil Mein Rahte Hain', 'Eros', '$668,678', 1999] 1999
['8198', 'Purple Moon (Re-issue)', 'Mira.', '$640,945', 1960] 1960
['10470', 'Amarcord', 'Jan.', '$125,493', 1973] 1973
Ora trasformi l’elenco in un DataFrame di pandas assegnando alle colonne i nomi appropriati e convertendo ai tipi di dato desiderati.
 import re
regex = '|'.join(['\$', ',', '\^'])

columns = ['rank', 'title', 'studio', 'lifetime_gross', 'year']

boxoffice_df = pd.DataFrame({
    'rank': [int(x[0]) for x in final_list],  # convert ranks to integers
    'title': [x[1] for x in final_list],  # get titles as is
    'studio': [x[2] for x in final_list],  # get studio names as is
    'lifetime_gross': [int(re.sub(regex, '', x[3])) for x in final_list],  # remove special characters and convert to integer
    'year': [int(re.sub(regex, '', str(x[4]))) for x in final_list],  # remove special characters and convert to integer
})
print('rows:', boxoffice_df.shape[0])
print('columns:', boxoffice_df.shape[1])
print('\ndata types:')
print(boxoffice_df.dtypes)
boxoffice_df.head(15)
rows: 15500
columns: 5
data types:
lifetime_gross int64
rank int64
studio object
title object
year int64
dtype: object
| lifetime_gross | rank | studio | title | year | |
|---|---|---|---|---|---|
| 0 | 936662225 | 1 | BV | Star Wars: The Force Awakens | 2015 |
| 1 | 760507625 | 2 | Fox | Avatar | 2009 |
| 2 | 681084109 | 3 | BV | Black Panther | 2018 |
| 3 | 659363944 | 4 | Par. | Titanic | 1997 |
| 4 | 652270625 | 5 | Uni. | Jurassic World | 2015 |
| 5 | 623357910 | 6 | BV | Marvel's The Avengers | 2012 |
| 6 | 620181382 | 7 | BV | Star Wars: The Last Jedi | 2017 |
| 7 | 534858444 | 8 | WB | The Dark Knight | 2008 |
| 8 | 532177324 | 9 | BV | Rogue One: A Star Wars Story | 2016 |
| 9 | 504014165 | 10 | BV | Beauty and the Beast (2017) | 2017 |
| 10 | 486295561 | 11 | BV | Finding Dory | 2016 |
| 11 | 474544677 | 12 | Fox | Star Wars: Episode I - The Phantom Menace | 1999 |
| 12 | 460998007 | 13 | Fox | Star Wars | 1977 |
| 13 | 459005868 | 14 | BV | Avengers: Age of Ultron | 2015 |
| 14 | 448139099 | 15 | WB | The Dark Knight Rises | 2012 |
La parola "star" è tra le prime, poiché compare in cinque dei primi quindici film, e sai anche che la saga di Star Wars ha ancora più film, diversi dei quali in alto in classifica.
Ora utilizziamo il codice sviluppato e vediamo come funziona su questo set di dati. Non c’è nulla di nuovo nel codice seguente, semplicemente lo racchiudi tutto in una funzione:
 def word_frequency(text_list, num_list, sep=None):
    word_freq = defaultdict(lambda: [0, 0])

    for text, num in zip(text_list, num_list):
        for word in text.split(sep=sep):
            word_freq[word][0] += 1
            word_freq[word][1] += num

    columns = {0: 'abs_freq', 1: 'wtd_freq'}

    abs_wtd_df = (pd.DataFrame.from_dict(word_freq, orient='index')
                 .rename(columns=columns )
                 .sort_values('wtd_freq', ascending=False)
                 .assign(rel_value=lambda df: df['wtd_freq'] / df['abs_freq']).round())

    abs_wtd_df.insert(1, 'abs_perc', value=abs_wtd_df['abs_freq'] / abs_wtd_df['abs_freq'].sum())
    abs_wtd_df.insert(2, 'abs_perc_cum', abs_wtd_df['abs_perc'].cumsum())
    abs_wtd_df.insert(4, 'wtd_freq_perc', abs_wtd_df['wtd_freq'] / abs_wtd_df['wtd_freq'].sum())
    abs_wtd_df.insert(5, 'wtd_freq_perc_cum', abs_wtd_df['wtd_freq_perc'].cumsum())

    return abs_wtd_df
word_frequency(boxoffice_df['title'], boxoffice_df['lifetime_gross']).head()| abs_freq | abs_perc | abs_perc_cum | wtd_freq | wtd_freq_perc | wtd_freq_perc_cum | rel_value | |
|---|---|---|---|---|---|---|---|
| The | 3055 | 0.068747 | 0.068747 | 67518342498 | 0.081167 | 0.081167 | 22100930.0 |
| the | 1310 | 0.029479 | 0.098227 | 32973100860 | 0.039639 | 0.120806 | 25170306.0 |
| of | 1399 | 0.031482 | 0.129709 | 30180592467 | 0.036282 | 0.157087 | 21572975.0 |
| and | 545 | 0.012264 | 0.141973 | 12188113847 | 0.014652 | 0.171739 | 22363512.0 |
| 2 | 158 | 0.003556 | 0.145529 | 9032673058 | 0.010859 | 0.182598 | 57168817.0 |
Non sorprende che le "stop word" siano in cima, cosa piuttosto comune per la maggior parte delle raccolte di documenti. Inoltre sono duplicate, dove alcune sono in maiuscolo e altre no. Quindi hai due cose chiare da gestire:
Ecco un semplice aggiornamento della funzione (nuovo parametro rm_words, e anche le righe 6, 7 e 8):
# words will be expanded
def word_frequency(text_list, num_list, sep=None, rm_words=('the', 'and', 'a')):
    word_freq = defaultdict(lambda: [0, 0])

    for text, num in zip(text_list, num_list):
        for word in text.split(sep=sep):
            # This should take care of ignoring the word if it's in the stop words
            if word.lower() in rm_words:
                continue
            # .lower() makes sure we are not duplicating words
            word_freq[word.lower()][0] += 1
            word_freq[word.lower()][1] += num

    columns = {0: 'abs_freq', 1: 'wtd_freq'}

    abs_wtd_df = (pd.DataFrame.from_dict(word_freq, orient='index')
                 .rename(columns=columns )
                 .sort_values('wtd_freq', ascending=False)
                 .assign(rel_value=lambda df: df['wtd_freq'] / df['abs_freq']).round())

    abs_wtd_df.insert(1, 'abs_perc', value=abs_wtd_df['abs_freq'] / abs_wtd_df['abs_freq'].sum())
    abs_wtd_df.insert(2, 'abs_perc_cum', abs_wtd_df['abs_perc'].cumsum())
    abs_wtd_df.insert(4, 'wtd_freq_perc', abs_wtd_df['wtd_freq'] / abs_wtd_df['wtd_freq'].sum())
    abs_wtd_df.insert(5, 'wtd_freq_perc_cum', abs_wtd_df['wtd_freq_perc'].cumsum())

    abs_wtd_df = abs_wtd_df.reset_index().rename(columns={'index': 'word'})

    return abs_wtd_df
from collections import defaultdict
word_freq_df = word_frequency(boxoffice_df['title'],
boxoffice_df['lifetime_gross'],
rm_words=['of','in', 'to', 'and', 'a', 'the',
'for', 'on', '&', 'is', 'at', 'it',
'from', 'with'])
word_freq_df.head(15).style.bar(['abs_freq', 'wtd_freq', 'rel_value'],
color='#60DDFF') # E6E9EB| word | abs_freq | abs_perc | abs_perc_cum | wtd_freq | wtd_freq_perc | wtd_freq_perc_cum | rel_value | |
|---|---|---|---|---|---|---|---|---|
| 0 | 2 | 158 | 0.00443945 | 0.00443945 | 9032673058 | 0.0137634 | 0.0137634 | 5.71688e+07 |
| 1 | star | 45 | 0.0012644 | 0.00570385 | 5374658819 | 0.00818953 | 0.0219529 | 1.19437e+08 |
| 2 | man | 195 | 0.00547907 | 0.0111829 | 3967037854 | 0.0060447 | 0.0279976 | 2.03438e+07 |
| 3 | part | 41 | 0.00115201 | 0.0123349 | 3262579777 | 0.00497129 | 0.0329689 | 7.95751e+07 |
| 4 | movie | 117 | 0.00328744 | 0.0156224 | 3216050557 | 0.00490039 | 0.0378693 | 2.74876e+07 |
Diamo un’occhiata allo stesso DataFrame ordinato in base a abs_freq:
(word_freq_df.sort_values('abs_freq', ascending=False)
 .head(15)
    .style.bar(['abs_freq', 'wtd_freq', 'rel_value'],
               color='#60DDFF'))
| word | abs_freq | abs_perc | abs_perc_cum | wtd_freq | wtd_freq_perc | wtd_freq_perc_cum | rel_value | |
|---|---|---|---|---|---|---|---|---|
| 26 | love | 211 | 0.00592863 | 0.069542 | 1604206885 | 0.00244438 | 0.111399 | 7.60288e+06 |
Ora visualizziamo per confrontare entrambe e vedere le tendenze nascoste:
 import matplotlib.pyplot as plt
plt.figure(figsize=(20,8))
plt.subplot(1, 2, 1)

word_freq_df_abs = word_freq_df.sort_values('abs_freq', ascending=False).reset_index()

plt.barh(range(20),
         list(reversed(word_freq_df_abs['abs_freq'][:20])), color='#288FB7')
for i, word in enumerate(word_freq_df_abs['word'][:20]):
    plt.text(word_freq_df_abs['abs_freq'][i], 20-i-1,
             s=str(i+1) + '. ' + word + ': '  + str(word_freq_df_abs['abs_freq'][i]),
             ha='right', va='center', fontsize=14, color='white', fontweight='bold')
plt.text(0.4, -1.1, s='Number of times the word was used in a movie title; out of 15500 movies.', fontsize=14)
plt.text(0.4, -1.8, s='Data: boxofficemojo.com Apr. 2018.   Feedback: @eliasdabbas', fontsize=14)


plt.vlines(range(0, 210, 10), -1, 20, colors='gray', alpha=0.1)
plt.hlines(range(0, 20, 2), 0, 210, colors='gray', alpha=0.1)
plt.yticks([])
plt.xticks([])
plt.title('Words Most Used in Movie Titles', fontsize=22, fontweight='bold')

# =============
plt.subplot(1, 2, 2)
# plt.axis('off')
plt.barh(range(20),
         list(reversed(word_freq_df['wtd_freq'][:20])), color='#288FB7')
for i, word in enumerate(word_freq_df['word'][:20]):
    plt.text(word_freq_df['wtd_freq'][i], 20-i-1,
             s=str(i+1) + '. ' + word + ': ' + '$' + str(round(word_freq_df['wtd_freq'][i] / 1000_000_000, 2)) + 'b',
             ha='right', va='center', fontsize=14, color='white', fontweight='bold')
plt.text(0.4, -1.1, s='Alltime boxoffice revenue of all movies whos title contained the word. (Top word is "2") ', fontsize=14)
plt.text(0.4, -1.8, s='Data collection & methodology: http://bit.ly/word_freq', fontsize=14)

plt.vlines(range(0, 9_500_000_000, 500_000_000), -1, 20, colors='gray', alpha=0.1)
plt.hlines(range(0, 20, 2), 0, 10_000_000_000, colors='gray', alpha=0.1)
plt.xlim((-70_000_000, 9_500_000_000))
plt.yticks([])
plt.xticks([])
plt.title('Words Most Associated With Boxoffice Revenue', fontsize=22, fontweight='bold')
plt.tight_layout(pad=0.01)
plt.show()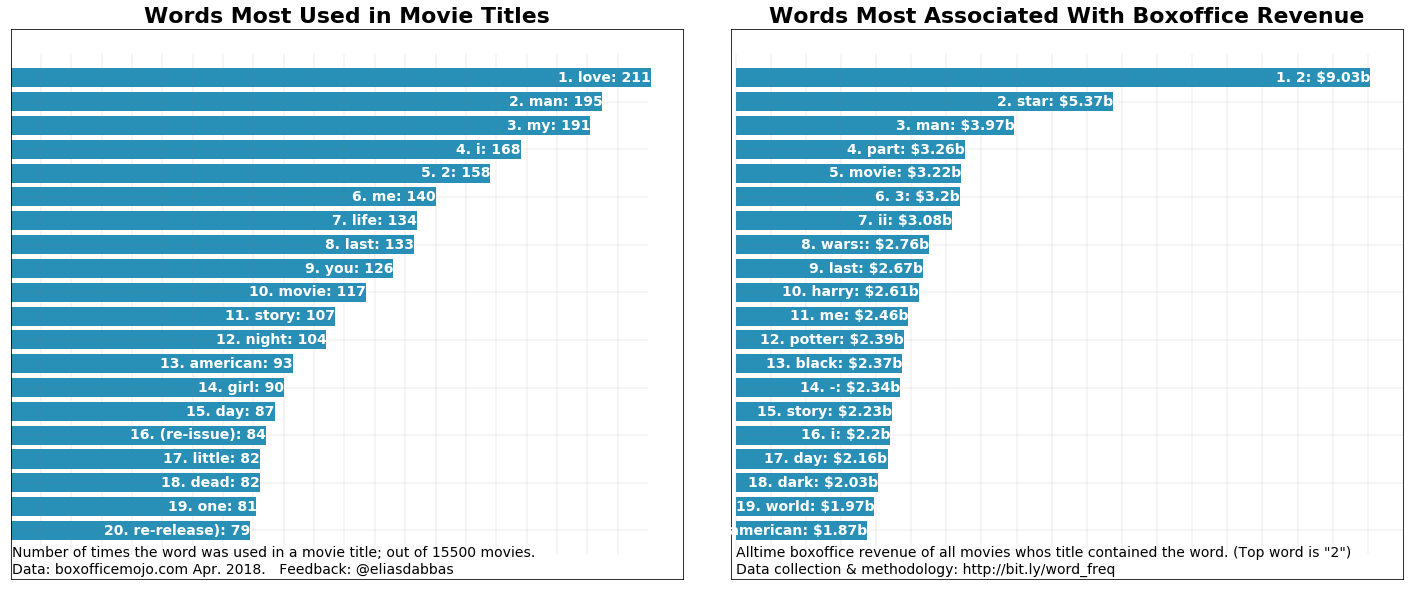
Sembra che, almeno nella mente di produttori e sceneggiatori, l’amore conquisti tutto! È la parola più usata in tutti i titoli dei film. Non è però così in alto quando si passa alla frequenza ponderata (incasso al botteghino).
In altre parole, se guardi tutti i titoli dei film, la parola "love" sarebbe quella che incontreresti più spesso. Ma stimando quale parola sia apparsa di più agli occhi degli spettatori (usando l’incasso lordo come metrica), allora "2", "star" e "man" sarebbero le più viste, o comunque associate al maggior incasso.
Per essere chiari: questi sono calcoli molto semplici. Quando dici che la frequenza ponderata della parola "love" è 1.604.106.767, significa semplicemente che la somma degli incassi lordi a vita di tutti i film il cui titolo includeva la parola "love" è stata quella cifra.
È anche interessante che "2" sia la parola in cima. Ovviamente non è una parola, ma indica che i secondi capitoli delle serie cinematografiche ammontano a una somma molto grande. Lo stesso vale per "3", che è in quinta posizione. Nota che anche "part" e "ii" sono nella top ten, a conferma dello stesso fatto.
"American" e "movie" hanno un alto valore relativo.
Una nota rapida sulle stop word usate in questa funzione
Di solito forniresti un elenco più completo di stop word rispetto a quello qui usato, soprattutto se stai lavorando con articoli o post sui social. Ad esempio il pacchetto nltk fornisce elenchi di stop word in diverse lingue, che puoi scaricare e utilizzare.
Le parole qui sono state scelte dopo alcune verifiche sui film principali. Molte di queste sono solitamente considerate stop word, ma nel caso dei titoli di film, aveva senso mantenerne alcune perché potrebbero dare qualche indizio. Per esempio, le parole "I", "me", "you" potrebbero suggerire certe dinamiche sociali. Un altro motivo è che i titoli di film sono frasi molto brevi, e stiamo cercando di ricavarne il maggior significato possibile.
Puoi sicuramente provare con il tuo set di parole e ottenere risultati leggermente diversi.
Guardando alla lista originale dei titoli dei film, vediamo che alcune delle parole principali non compaiono nemmeno nella top ten, ed è proprio questo il tipo di insight che cerchiamo di far emergere con questo approccio.
boxoffice_df.head(10)
| lifetime_gross | rank | studio | title | year | |
|---|---|---|---|---|---|
| 0 | 936662225 | 1 | BV | Star Wars: The Force Awakens | 2015 |
| 1 | 760507625 | 2 | Fox | Avatar | 2009 |
| 2 | 681084109 | 3 | BV | Black Panther | 2018 |
| 3 | 659363944 | 4 | Par. | Titanic | 1997 |
| 4 | 652270625 | 5 | Uni. | Jurassic World | 2015 |
| 5 | 623357910 | 6 | BV | Marvel's The Avengers | 2012 |
| 6 | 620181382 | 7 | BV | Star Wars: The Last Jedi | 2017 |
| 7 | 534858444 | 8 | WB | The Dark Knight | 2008 |
| 8 | 532177324 | 9 | BV | Rogue One: A Star Wars Story | 2016 |
| 9 | 504014165 | 10 | BV | Beauty and the Beast (2017) | 2017 |
Successivamente, ha senso esplorare meglio le parole principali più interessanti. Filtriamo i film che contengono "2" e vediamo:
(boxoffice_df[boxoffice_df['title']
              .str
              .contains('2 | 2', case=False)] # spaces used to exclude words like '2010'
              .head(10))
| lifetime_gross | rank | studio | title | year | |
|---|---|---|---|---|---|
| 15 | 441226247 | 16 | DW | Shrek 2 | 2004 |
| 30 | 389813101 | 31 | BV | Guardians of the Galaxy Vol. 2 | 2017 |
| 31 | 381011219 | 32 | WB | Harry Potter and the Deathly Hallows Part 2 | 2011 |
| 35 | 373585825 | 36 | Sony | Spider-Man 2 | 2004 |
| 38 | 368061265 | 39 | Uni. | Despicable Me 2 | 2013 |
| 64 | 312433331 | 65 | Par. | Iron Man 2 | 2010 |
| 79 | 292324737 | 80 | LG/S | The Twilight Saga: Breaking Dawn Part 2 | 2012 |
| 87 | 281723902 | 88 | LGF | The Hunger Games: Mockingjay - Part 2 | 2015 |
| 117 | 245852179 | 118 | BV | Toy Story 2 | 1999 |
| 146 | 226164286 | 147 | NL | Rush Hour 2 | 2001 |
Diamo anche un’occhiata ai principali film con "star":
boxoffice_df[boxoffice_df['title'].str.contains('star | star', case=False)].head(10)
| lifetime_gross | rank | studio | title | year | |
|---|---|---|---|---|---|
| 0 | 936662225 | 1 | BV | Star Wars: The Force Awakens | 2015 |
| 6 | 620181382 | 7 | BV | Star Wars: The Last Jedi | 2017 |
| 8 | 532177324 | 9 | BV | Rogue One: A Star Wars Story | 2016 |
| 11 | 474544677 | 12 | Fox | Star Wars: Episode I - The Phantom Menace | 1999 |
| 12 | 460998007 | 13 | Fox | Star Wars | 1977 |
| 33 | 380270577 | 34 | Fox | Star Wars: Episode III - Revenge of the Sith | 2005 |
| 65 | 310676740 | 66 | Fox | Star Wars: Episode II - Attack of the Clones | 2002 |
| 105 | 257730019 | 106 | Par. | Star Trek | 2009 |
| 140 | 228778661 | 141 | Par. | Star Trek Into Darkness | 2013 |
| 301 | 158848340 | 302 | Par. | Star Trek Beyond | 2016 |
E, infine, i principali film con "man":
boxoffice_df[boxoffice_df['title'].str.contains('man | man', case=False)].head(10)
| lifetime_gross | rank | studio | title | year | |
|---|---|---|---|---|---|
| 18 | 423315812 | 19 | BV | Pirates of the Caribbean: Dead Man's Chest | 2006 |
| 22 | 409013994 | 23 | BV | Iron Man 3 | 2013 |
| 35 | 373585825 | 36 | Sony | Spider-Man 2 | 2004 |
| 48 | 336530303 | 49 | Sony | Spider-Man 3 | 2007 |
| 53 | 330360194 | 54 | WB | Batman v Superman: Dawn of Justice | 2016 |
| 59 | 318412101 | 60 | Par. | Iron Man | 2008 |
| 64 | 312433331 | 65 | Par. | Iron Man 2 | 2010 |
| 82 | 291045518 | 83 | WB | Man of Steel | 2013 |
| 176 | 206852432 | 177 | WB | Batman Begins | 2005 |
| 182 | 202853933 | 183 | Sony | The Amazing Spider-Man 2 | 2014 |
Come primo passo, potresti cercare di ottenere più parole: i titoli dei film sono estremamente brevi e spesso non veicolano il significato letterale delle parole. Per esempio, un padrino dovrebbe essere una persona che assiste al battesimo di un bambino e promette di prendersene cura (o magari un mafioso che uccide per piacere?!).
Un ulteriore esercizio potrebbe essere quello di ottenere descrizioni più dettagliate, oltre al titolo del film. Per esempio:
"A computer hacker learns from mysterious rebels about the true nature of his reality and his role in the war against its controllers."
ci dice molto di più del film rispetto a "The Matrix".
In alternativa, potresti anche prendere una delle seguenti strade per arricchire la tua analisi:
Potresti essere interessato a esplorare direttamente questi dati e altri ancora:
Ok, ora hai esplorato il conteggio delle parole nei titoli dei film e visto la differenza tra frequenze assolute e ponderate, e come trascurarne una possa far perdere una parte importante del quadro. Hai anche visto i limiti di questo approccio e alcune proposte per migliorare la tua analisi.
Hai creato una funzione dedicata che puoi eseguire facilmente per analizzare qualsiasi set di dati testuali simili con numeri, e sai come questo può migliorare la comprensione di questo tipo di dati.
Provala analizzando le prestazioni dei tuoi tweet, gli URL del tuo sito, i tuoi post su Facebook o qualsiasi altro set di dati simile che potresti incontrare.
Potrebbe essere più semplice clonare il repository con il codice e provare tu stesso.
La funzione word_frequency fa parte del pacchetto advertools, che puoi scaricare e provare nel tuo lavoro/ricerca.
Dai un’occhiata e fammi sapere! @eliasdabbas
Dai un’occhiata al Tutorial sui dizionari in Python di DataCamp per imparare a creare la frequenza delle parole, e al tutorial Web Scraping & NLP in Python per imparare a tracciare le distribuzioni di frequenza delle parole.
Scopri di più su Python
Corso
Corso
Corso
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min
blog
Abid Ali Awan
15 min



