Corso
Introduzione al Deep Learning in Python
4 ore
264.8K
All'inizio di questa settimana ho tenuto una sessione Facebook Live di Code along. Insieme abbiamo usato alcune tecniche base di elaborazione del linguaggio naturale per tracciare le parole che ricorrono più spesso nel romanzo Moby Dick. Nel farlo, abbiamo anche visto quanto sia efficace ragionare in termini della seguente pipeline di Data Science, con costante attenzione al processo:
In questo post imparerai a costruire una pipeline di data science per tracciare le distribuzioni di frequenza delle parole in Moby Dick, e in molti altri romanzi.
Suggerimento: se vuoi riguardare il Facebook Live, dai un'occhiata al video seguente; puoi saltare direttamente al 12° minuto, quando entra Hugo e la sessione inizia davvero.
Non ti forniremo i romanzi: imparerai a estrarli dal sito Project Gutenberg (che contiene essenzialmente un ampio corpus di libri) usando il pacchetto Python requests e come recuperare i romanzi da questi dati web usando BeautifulSoup. Poi passerai all'analisi dei romanzi usando il Natural Language ToolKit (nltk). Nel processo, imparerai aspetti importanti dell'elaborazione del linguaggio naturale (NLP) come la tokenizzazione e le stopword.
Alla fine sarai in grado di visualizzare le distribuzioni di frequenza delle parole di qualsiasi romanzo tu possa trovare su Project Gutenberg. Le competenze NLP che svilupperai, tuttavia, saranno applicabili a gran parte dei dati che i data scientist incontrano, dato che una quota enorme dei dati mondiali è non strutturata e include una grande quantità di testo.
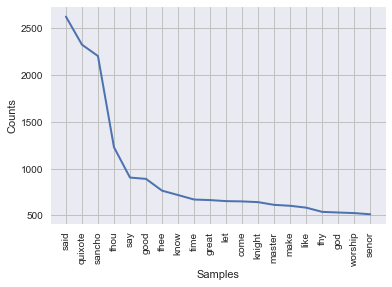
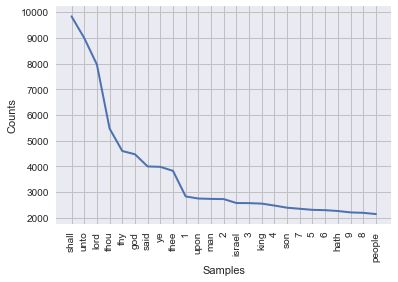
Ad esempio, da cosa potrebbe provenire la seguente distribuzione di frequenza delle parole?
Questo post è stato generato da un Jupyter Notebook; puoi trovarlo in questa repository. Se hai pensieri, risposte e/o riflessioni, scrivimi pure su Twitter: @hugobowne.
Segui le istruzioni nel README.md per configurare il tuo sistema e metterti in moto.
Quali sono le parole più frequenti nel romanzo Moby Dick e con quale frequenza compaiono?
I tuoi dati grezzi sono il testo del romanzo di Melville, Moby Dick. Come faresti a portare in Python il testo di questo libro di ~800 parole?
Be', ci sono diversi modi per farlo, ma prima renditi conto che il testo è liberamente disponibile online su Project Gutenberg. Andiamoci, proviamo a trovare Moby Dick e poi memorizziamo l'URL rilevante nello spazio dei nomi di Python:
# Store url
url = 'https://www.gutenberg.org/files/2701/2701-h/2701-h.htm'
Ora che hai l'URL, devi recuperare l'HTML del sito.
Nota che HTML sta per Hypertext Markup Language ed è il linguaggio di markup standard per il web.
Userai requests per farlo, uno dei pacchetti Python più popolari e utili in circolazione. Puoi saperne di più nel corso di DataCamp Importing Data in Python (Part 2).
Secondo il sito del pacchetto requests:
Requests ti permette di inviare richieste HTTP/1.1 organiche, allevate al pascolo, senza bisogno di manodopera.
e le seguenti organizzazioni dichiarano di usare internamente requests:
Il Governo di Sua Maestà, Amazon, Google, Twilio, NPR, Obama for America, Twitter, Sony e istituzioni federali statunitensi che preferiscono rimanere senza nome.
Inoltre,
Requests è uno dei pacchetti Python più scaricati di sempre, con oltre 13.000.000 di download ogni mese. Lo usano tutti i ragazzi cool!
Farai una richiesta GET al sito, il che significa che stai ottenendo dati da esso. È quello che fai con un browser quando visiti una pagina web. Esistono altri tipi di richieste, come le richieste POST, ma qui non ce ne occuperemo.
requests rende tutto questo semplice con la sua funzione get. Esegui qui la richiesta e controlla il tipo di oggetto restituito.
# Import `requests`
import requests

# Make the request and check object type
r = requests.get(url)
type(r)
requests.models.Response
Questo è un oggetto Response. Nella guida rapida di requests puoi vedere che un oggetto Response ha un attributo text che ti permette di ottenerne l'HTML! Facciamolo e stampiamo l'HTML per dare un'occhiata:
# Extract HTML from Response object and print
html = r.text
#print(html)
OK! Questo HTML non è esattamente quello che vuoi. Tuttavia, contiene ciò che vuoi: il testo di Moby Dick. Ora devi manipolare questo HTML per estrarre il romanzo.
Qui userai il pacchetto BeautifulSoup. Il sito del pacchetto dice:
Sembra promettente!
Prima, una parola sul nome del pacchetto: Beautiful Soup? Nello sviluppo web, il termine "tag soup" indica HTML strutturalmente o sintatticamente scorretto scritto per una pagina web. Ciò che Beautiful Soup sa fare meglio è rendere di nuovo bello il "tag soup" ed estrarne informazioni con facilità! Infatti, l'oggetto principale creato e interrogato quando si usa questo pacchetto si chiama BeautifulSoup. Dopo aver creato la zuppa, possiamo usare il suo metodo .get_text() per estrarre il testo.
# Import BeautifulSoup from bs4
from bs4 import BeautifulSoup


# Create a BeautifulSoup object from the HTML
soup = BeautifulSoup(html, "html5lib")
type(soup)
bs4.BeautifulSoup
Da questi oggetti soup puoi estrarre tutti i tipi di informazioni interessanti sul sito che stai estraendo, come il titolo:
# Get soup title
soup.title
<title>
      Moby Dick; Or the Whale, by Herman Melville
    </title>
Oppure il titolo come stringa:
# Get soup title as string
soup.title.string
'\n Moby Dick; Or the Whale, by Herman Melville\n '
Oppure tutti gli URL trovati all'interno dei tag < a > di una pagina (collegamenti ipertestuali):
# Get hyperlinks from soup and check out first several
soup.findAll('a')[:8]
[<a href="#link2H_4_0002"> ETYMOLOGY. </a>,
 <a href="#link2H_4_0003"> EXTRACTS (Supplied by a Sub-Sub-Librarian).
         </a>,
 <a href="#link2HCH0001"> CHAPTER 1. Loomings. </a>,
 <a href="#link2HCH0002"> CHAPTER 2. The Carpet-Bag. </a>,
 <a href="#link2HCH0003"> CHAPTER 3. The Spouter-Inn. </a>,
 <a href="#link2HCH0004"> CHAPTER 4. The Counterpane. </a>,
 <a href="#link2HCH0005"> CHAPTER 5. Breakfast. </a>,
 <a href="#link2HCH0006"> CHAPTER 6. The Street. </a>]
Quello che vuoi fare è estrarre il testo dalla soup e c'è un metodo molto utile, .get_text(), proprio per questo.
Ottieni il testo, stampalo e dagli un'occhiata. È quello che vuoi?
# Get the text out of the soup and print it
text = soup.get_text()
#print(text)
Nota che ora è quasi quello che vuoi.
È il testo del romanzo con qualche elemento indesiderato all'inizio e alla fine. Potresti rimuoverlo se volessi. Tuttavia, questa parte è così piccola rispetto al testo di Moby Dick che, in prima approssimazione, va bene lasciarla e questo sarà l'approccio qui. Per risultati più robusti, suggerirei di rimuoverla.
Ora che hai il testo di interesse, è il momento di contare quante volte compare ciascuna parola e di tracciare l'istogramma di frequenza che ti interessa: viene in aiuto l'elaborazione del linguaggio naturale!
Ora userai nltk, il Natural Language Toolkit, per
Vuoi tokenizzare il tuo testo, cioè dividerlo in un elenco di parole. In sostanza, vuoi separare le parti di testo che sono separate da spazi bianchi.
Per farlo userai uno strumento potente chiamato espressioni regolari. Un'espressione regolare, o regex in breve, è una sequenza di caratteri che definisce un pattern di ricerca. Sono notoriamente ostiche e si spiegano al meglio con un esempio.
L'espressione regolare che corrisponde a tutte le parole che iniziano con "p" è "p\w+". Vediamo cosa significa:
Mettendo tutto insieme, l'espressione regolare "p\w+" corrisponderà a tutte le sottostringhe che iniziano con "p" e sono seguite da caratteri alfanumerici e underscore. Nella maggior parte dei testi in inglese che hanno senso, questo corrisponderà a parole che iniziano con "p".
Ora userai il pacchetto Python integrato re per estrarre tutte le parole che iniziano con "p" dalla frase "peter piper picked a peck of pickled peppers" come riscaldamento.
# Import regex package
import re

# Define sentence
sentence = 'peter piper pick a peck of pickled peppers'

# Define regex
ps = 'p\w+'


# Find all words in sentence that match the regex and print them
re.findall(ps, sentence)
['peter', 'piper', 'pick', 'peck', 'pickled', 'peppers']
Sembra piuttosto buono. Ora, se "p\w+" è il regex che corrisponde alle parole che iniziano con "p", qual è il regex che corrisponde a tutte le parole?
Tocca a te farlo ora per la nostra frase-giocattolo di Peter Piper qui sopra.
# Find all words and print them
re.findall('\w+', sentence)
['peter', 'piper', 'pick', 'a', 'peck', 'of', 'pickled', 'peppers']
Ora puoi fare lo stesso con text, la stringa che contiene Moby Dick:
# Find all words in Moby Dick and print several
tokens = re.findall('\w+', text)
tokens[:8]
['Moby', 'Dick', 'Or', 'the', 'Whale', 'by', 'Herman', 'Melville']
Nota che c'è anche un modo per farlo con nltk, il Natural Language Toolkit:
# Import RegexpTokenizer from nltk.tokenize
from nltk.tokenize import RegexpTokenizer

# Create tokenizer
tokenizer = RegexpTokenizer('\w+')


# Create tokens
tokens = tokenizer.tokenize(text)
tokens[:8]
['Moby', 'Dick', 'Or', 'the', 'Whale', 'by', 'Herman', 'Melville']
OK! Ci sei quasi. Nota, però, che sopra "Or" ha una "O" maiuscola e altrove potrebbe non averla, ma sia "Or" che "or" vorrai contarle come la stessa parola. Per questo motivo, dovrai costruire un elenco di tutte le parole in Moby Dick in cui tutte le lettere maiuscole sono state rese minuscole. Ti tornerà utile il metodo di stringa .lower():
# Initialize new list
words = []


# Loop through list tokens and make lower case
for word in tokens:
    words.append(word.lower())


# Print several items from list as sanity check
words[:8]
['moby', 'dick', 'or', 'the', 'whale', 'by', 'herman', 'melville']
È pratica comune rimuovere parole molto frequenti nella lingua inglese come "the", "of" e "a" (note come stopword) perché non sono così interessanti. Per approfondire tutte queste tecniche, dai un'occhiata al nostro corso Natural Language Processing Fundamentals in Python.
Il pacchetto nltk ha un elenco di stopword in inglese che ora memorizzerai come sw e di cui stamperai i primi elementi.
Se qui ottieni un errore, esegui il comando nltk.download('stopwords') per installare le stopword sul tuo sistema.
# Import nltk
import nltk

# Get English stopwords and print some of them
sw = nltk.corpus.stopwords.words('english')
sw[:5]
['i', 'me', 'my', 'myself', 'we']
Vuoi l'elenco di tutte le parole in words che non sono in sw. Un modo per ottenere questo elenco è scorrere tutti gli elementi di words e aggiungerli a un nuovo elenco se non sono in sw:
# Initialize new list
words_ns = []

# Add to words_ns all words that are in words but not in sw
for word in words:
    if word not in sw:
        words_ns.append(word)

# Print several list items as sanity check
words_ns[:5]
['moby', 'dick', 'whale', 'herman', 'melville']
La nostra domanda era: "Quali sono le parole più frequenti nel romanzo Moby Dick e con quale frequenza compaiono?"
Ora puoi tracciare un istogramma di frequenza delle parole in Moby Dick con due righe di codice usando nltk. Per farlo,
nltk.FreqDist();plot() dell'oggetto risultante.#Import datavis libraries
import matplotlib.pyplot as plt
import seaborn as sns
# Figures inline and set visualization style
%matplotlib inline
sns.set()
# Create freq dist and plot
freqdist1 = nltk.FreqDist(words_ns)
freqdist1.plot(25)
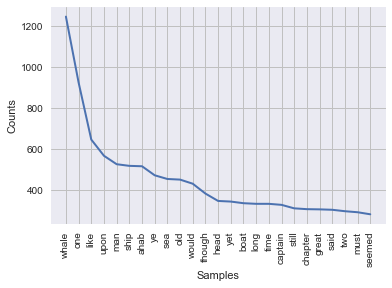
La cosa bella è che, usando nltk per rispondere alla nostra domanda, in realtà abbiamo già presentato la soluzione in un modo comunicabile agli altri: un grafico della distribuzione di frequenza! Puoi leggere le parole più comuni, insieme alla loro frequenza. Ad esempio, "whale" è la parola più comune nel romanzo (chi l'avrebbe detto), escludendo le stopword, e compare per oltre 1200 volte!
Visto che su Project Gutenberg ci sono tanti romanzi per cui possiamo creare questi istogrammi di frequenza delle parole, ha senso scrivere una funzione che faccia tutto questo:
 def plot_word_freq(url):
    """Takes a url (from Project Gutenberg) and plots a word frequency
    distribution"""
    # Make the request and check object type
    r = requests.get(url)
    # Extract HTML from Response object and print
    html = r.text
    # Create a BeautifulSoup object from the HTML
    soup = BeautifulSoup(html, "html5lib")
    # Get the text out of the soup and print it
    text = soup.get_text()
    # Create tokenizer
    tokenizer = RegexpTokenizer('\w+')
    # Create tokens
    tokens = tokenizer.tokenize(text)
    # Initialize new list
    words = []
    # Loop through list tokens and make lower case
    for word in tokens:
        words.append(word.lower())
    # Get English stopwords and print some of them
    sw = nltk.corpus.stopwords.words('english')
    # Initialize new list
    words_ns = []
    # Add to words_ns all words that are in words but not in sw
    for word in words:
        if word not in sw:
            words_ns.append(word)
    # Create freq dist and plot
    freqdist1 = nltk.FreqDist(words_ns)
    freqdist1.plot(25)
Ora usa la funzione per tracciare le distribuzioni di frequenza delle parole da altri testi su Project Gutenberg:
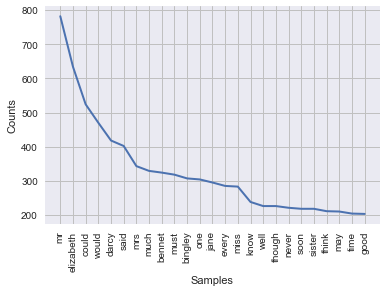
plot_word_freq('https://www.gutenberg.org/files/42671/42671-h/42671-h.htm')
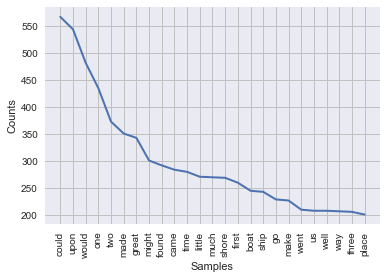
plot_word_freq('https://www.gutenberg.org/files/521/521-h/521-h.htm')
plot_word_freq('https://www.gutenberg.org/files/10/10-h/10-h.htm')
In questo post hai imparato a costruire una pipeline di Data Science per tracciare le distribuzioni di frequenza delle parole in Moby Dick, tra molti altri romanzi. Hai imparato a estrarli dal sito Project Gutenberg (ampio corpus di libri) usando il pacchetto Python requests e come recuperare i romanzi da questi dati web usando BeautifulSoup. Poi sei passato ad analizzare i romanzi usando il Natural Language ToolKit (nltk). Nel processo hai imparato aspetti importanti dell'elaborazione del linguaggio naturale (NLP) come la tokenizzazione e le stopword. Ora sei in grado di visualizzare le distribuzioni di frequenza delle parole di qualsiasi romanzo tu possa trovare su Project Gutenberg. Le competenze NLP che hai sviluppato sono applicabili anche a gran parte dei dati che i Data Scientist incontrano, dato che una vasta proporzione dei dati mondiali è non strutturata e include una grande quantità di testo.
Questo post è stato generato da un Jupyter Notebook; puoi trovarlo in questa repository. Se hai pensieri, risposte e/o riflessioni, scrivimi pure su twitter: @hugobowne. Fammi sapere quali progetti interessanti costruisci.
Dai un'occhiata ai tutorial di DataCamp Web Scraping using Python (and Beautiful Soup) e How to Use Python to Scrape Amazon.
Approfondisci Python
Corso
Corso
Corso
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min
blog
Tim Lu
12 min



