
Last chance! 50% off DataCamp Premium
Sale ends in
टेक्स्ट माइनिंग में एक महत्वपूर्ण मीट्रिक-समूह, किसी कॉर्पस (दस्तावेज़-संग्रह) में शब्दों (या किसी भी टोकन) की आवृत्ति से संबंधित होता है। हालांकि, ऐसे मामलों में जहाँ हर दस्तावेज़ के साथ उसके किसी गुण का संख्यात्मक मान जुड़ा होता है, आप अतिरिक्त मीट्रिक-समूह का भी उपयोग कर सकते हैं।
कुछ उदाहरण:
इस ट्यूटोरियल में,
collections मॉड्यूल की defaultdict डेटा संरचना, और अंतिम आउटपुट के प्रबंधन के लिए pandas के DataFrame का उपयोग करेंगे।मान लीजिए आपके पास दो ट्वीट हैं और उनका कंटेंट तथा इम्प्रेशन्स (व्यूज़) की संख्या इस प्रकार है:
| ट्वीट टेक्स्ट | व्यूज़ |
|---|---|
| spain | 800 |
| france | 200 |
मूल विश्लेषण करना आसान है और आप पाएंगे कि आपके शब्द 'france' और 'spain' के बीच 50:50 बंटे हैं। कई मामलों में, आपके पास बस यही होता है और आप केवल शब्दों की परिमाणात्मक आवृत्ति माप सकते हैं और कुछ संबंधों का अनुमान लगा सकते हैं। इस मामले में, आपके पास प्रत्येक दस्तावेज़ के बारे में कुछ डेटा भी है।
यहाँ वेटेड आवृत्ति स्पष्ट रूप से अलग है, और बंटवारा 80:20 है। यानी, भले ही 'spain' और 'france' आपके ट्वीट्स में एक-एक बार आए हों, आपके पाठकों के दृष्टिकोण से पहला 800 बार जबकि दूसरा 200 बार प्रकट हुआ। यह बड़ा फर्क है!
defaultdict का उपयोग करके सरल शब्द-आवृत्तिअब इसी तरह के दस्तावेज़-समूह के लिए थोड़ा अधिक विस्तार वाला उदाहरण देखें:
| दस्तावेज़ | व्यूज़ |
|---|---|
| france | 200 |
| spain | 180 |
| spain beaches | 170 |
| france beaches | 160 |
| spain best beaches | 160 |
अब आप दस्तावेज़ों पर लूप लगाते हैं, उन्हें शब्दों में विभाजित करते हैं, और प्रत्येक शब्द की आवृत्ति गिनते हैं:
 from collections import defaultdict

import pandas as pd

text_list = ['france', 'spain', 'spain beaches', 'france beaches', 'spain best beaches']

word_freq = defaultdict(int)

for text in text_list:
    for word in text.split():
        word_freq[word] += 1

pd.DataFrame.from_dict(word_freq, orient='index') \
.sort_values(0, ascending=False) \
.rename(columns={0: 'abs_freq'})| abs_freq | |
|---|---|
| spain | 3 |
| beaches | 3 |
| france | 2 |
| best | 1 |
ऊपर के लूप में, पहली पंक्ति text_list पर एक-एक करके लूप लगाती है। दूसरी पंक्ति (हर दस्तावेज़ के भीतर) प्रत्येक आइटम के शब्दों पर लूप लगाती है, जिन्हें स्पेस कैरेक्टर से विभाजित किया गया है (जो किसी और कैरेक्टर ('-', ',', '_', आदि) से भी हो सकता था)।
जब आप word_freq[word] को कोई मान असाइन करने की कोशिश करते हैं, तो दो संभावनाएँ होती हैं:
word मौजूद है: ऐसे में असाइनमेंट हो जाता है (एक जोड़ते हुए)word word_freq में नहीं है, इस स्थिति में defaultdict वह डिफ़ॉल्ट फ़ंक्शन बुलाता है जो परिभाषा के समय दिया गया था, जो यहाँ int है।int कॉल होने पर शून्य लौटाता है। अब कुंजी मौजूद है, उसका मान शून्य है, और वह अपने मान में 1 जोड़ने के लिए तैयार है।
हालाँकि पहले तालिका में शीर्ष शब्द 'france' था, लेकिन प्रत्येक दस्तावेज़ के भीतर सभी शब्दों की गिनती करने के बाद हम देखते हैं कि 'spain' और 'beaches' पहले स्थान पर बराबरी पर हैं। यह छिपे रुझानों का पता लगाने में महत्वपूर्ण है, खासकर जब जिन दस्तावेज़ों से आप निपट रहे हैं उनकी संख्या दसियों, सैकड़ों या हजारों में हो।
अब जब आप दस्तावेज़-समूह में प्रत्येक शब्द की आवृत्ति गिन चुके हैं, तो आप वेटेड आवृत्ति देखना चाहते हैं। यानी, आप देखना चाहते हैं कि आपके पाठकों को वे शब्द कितनी बार दिखाई दिए, इसकी तुलना में कि आपने उन्हें कितनी बार इस्तेमाल किया।
पहली तालिका में, शब्दों की परिमाणात्मक आवृत्ति 'spain' और 'france' के बीच बराबर थी, लेकिन 'spain' का वजन स्पष्ट रूप से बहुत अधिक था, क्योंकि उसका मान 800 था, जबकि 'france' का 200।
लेकिन दूसरी, थोड़ी अधिक जटिल, तालिका के लिए वेटेड शब्द-आवृत्ति क्या होगी?
आइए पता लगाएँ!
आप ऊपर उपयोग किए गए कुछ कोड का पुन: उपयोग कर सकते हैं, लेकिन कुछ जोड़ के साथ:
 # default value is now a list with two ints
word_freq = defaultdict(lambda: [0, 0])

# the `views` column you had in the first DataFrame
num_list = [200, 180, 170, 160, 160]

# looping is now over both the text and the numbers
for text, num in zip(text_list, num_list):
    for word in text.split():
        # same as before
        word_freq[word][0] += 1
        # new line, incrementing the numeric value for each word
        word_freq[word][1] += num

columns = {0: 'abs_freq', 1: 'wtd_freq'}

abs_wtd_df = pd.DataFrame.from_dict(word_freq, orient='index') \
             .rename(columns=columns) \
             .sort_values('wtd_freq', ascending=False) \
             .assign(rel_value=lambda df: df['wtd_freq'] / df['abs_freq']) \
            .round()

abs_wtd_df.style.background_gradient(low=0, high=.7, subset=['rel_value'])| abs_freq | wtd_freq | rel_value | |
|---|---|---|---|
| spain | 3 | 510 | 170 |
| beaches | 3 | 490 | 163 |
| france | 2 | 360 | 180 |
| best | 1 | 160 | 160 |
कुछ टिप्पणियाँ:
rel_value एक साधारण भागफल है, जो प्रत्येक शब्द की प्रति उपस्थिति मान देता है।rel_value को देखते हुए आप यह भी देखते हैं कि भले ही 'france' wtd_freq मीट्रिक पर काफी नीचे है, फिर भी इसमें संभावनाएँ दिखती हैं, क्योंकि प्रति उपस्थिति मान अधिक है। यह उदाहरण के लिए 'france' पर आपकी कंटेंट कवरेज बढ़ाने का संकेत दे सकता है।आप ऐसे अन्य मीट्रिक्स भी जोड़ना चाहेंगे जो प्रत्येक प्रकार की आवृत्ति का प्रतिशत और संचयी प्रतिशत दिखाएँ, ताकि आपको बेहतर परिप्रेक्ष्य मिल सके कि कुल का bulk कितने शब्द बनाते हैं, यदि कोई हो:
 abs_wtd_df.insert(1, 'abs_perc', value=abs_wtd_df['abs_freq'] / abs_wtd_df['abs_freq'].sum())
abs_wtd_df.insert(2, 'abs_perc_cum', abs_wtd_df['abs_perc'].cumsum())
abs_wtd_df.insert(4, 'wtd_freq_perc', abs_wtd_df['wtd_freq'] / abs_wtd_df['wtd_freq'].sum())
abs_wtd_df.insert(5, 'wtd_freq_perc_cum', abs_wtd_df['wtd_freq_perc'].cumsum())
abs_wtd_df.style.background_gradient(low=0, high=0.8)| abs_freq | abs_perc | abs_perc_cum | wtd_freq | wtd_freq_perc | wtd_freq_perc_cum | rel_value | |
|---|---|---|---|---|---|---|---|
| spain | 3 | 0.333333 | 0.333333 | 510 | 0.335526 | 0.335526 | 170 |
| beaches | 3 | 0.333333 | 0.666667 | 490 | 0.322368 | 0.657895 | 163 |
| france | 2 | 0.222222 | 0.888889 | 360 | 0.236842 | 0.894737 | 180 |
| best | 1 | 0.111111 | 1 | 160 | 0.105263 | 1 | 160 |
और भी बहुत कुछ विश्लेषित किया जा सकता है, और अधिक डेटा के साथ आपको आमतौर पर और ज्यादा चौंकाने वाली बातें मिलेंगी।
तो वास्तविक दुनिया में, वास्तविक डेटा के साथ यह कैसा दिख सकता है?
आप फ़िल्मों के शीर्षक देखेंगे, किन शब्दों का शीर्षकों में सबसे अधिक उपयोग हुआ है — जो परिमाणात्मक आवृत्ति है — और कौन से शब्द सबसे अधिक राजस्व से जुड़े हैं, यानी वेटेड आवृत्ति।
Boxoffice Mojo पर 15,000 से अधिक फ़िल्मों की सूची है, उनके संबंधित ग्रॉस रेवेन्यू और रैंक के साथ। requests और BeautifulSoup का उपयोग कर डेटा स्क्रैप करना शुरू करें — यदि आप चाहें तो यहाँ Boxoffice Mojo को अभी एक्सप्लोर कर सकते हैं:
import requests
from bs4 import BeautifulSoup
final_list = []
for i in range(1, 156):
if not i%10:
print(i)
page = 'http://www.boxofficemojo.com/alltime/domestic.htm?page=' + str(i) + '&p=.htm'
resp = requests.get(page)
soup = BeautifulSoup(resp.text, 'lxml')
# trial and error to get the exact positions
table_data = [x.text for x in soup.select('tr td')[11:511]]
# put every 5 values in a row
temp_list = [table_data[i:i+5] for i in range(0, len(table_data[:-4]), 5)]
for temp in temp_list:
final_list.append(temp)10
20
30
40
50
60
70
80
90
100
110
120
130
140
150
boxoffice_df = pd.DataFrame.from_records(final_list)

boxoffice_df.head(10)
| 0 | 1 | 2 | 3 | 4 | |
|---|---|---|---|---|---|
| 0 | 1 | Star Wars: The Force Awakens | BV | $936,662,225 | 2015 |
| 1 | 2 | Avatar | Fox | $760,507,625 | 2009^ |
| 2 | 3 | Black Panther | BV | $681,084,109 | 2018 |
| 3 | 4 | Titanic | Par. | $659,363,944 | 1997^ |
| 4 | 5 | Jurassic World | Uni. | $652,270,625 | 2015 |
| 5 | 6 | Marvel's The Avengers | BV | $623,357,910 | 2012 |
| 6 | 7 | Star Wars: The Last Jedi | BV | $620,181,382 | 2017 |
| 7 | 8 | The Dark Knight | WB | $534,858,444 | 2008^ |
| 8 | 9 | Rogue One: A Star Wars Story | BV | $532,177,324 | 2016 |
| 9 | 10 | Beauty and the Beast (2017) | BV | $504,014,165 | 2017 |
boxoffice_df.tail(15)
| 0 | 1 | 2 | 3 | 4 | |
|---|---|---|---|---|---|
| 15485 | 15486 | The Dark Hours | N/A | $423 | 2005 |
| 15486 | 15487 | 2:22 | Magn. | $422 | 2017 |
| 15487 | 15488 | State Park | Atl | $421 | 1988 |
| 15488 | 15489 | The Magician (2010) | Reg. | $406 | 2010 |
| 15489 | 15490 | Skinless | PPF | $400 | 2014 |
| 15490 | 15491 | Cinemanovels | Mont. | $398 | 2014 |
| 15491 | 15492 | Hannah: Buddhism's Untold Journey | KL | $396 | 2016 |
| 15492 | 15493 | Apartment 143 | Magn. | $383 | 2012 |
| 15493 | 15494 | The Marsh | All. | $336 | 2007 |
| 15494 | 15495 | The Chambermaid | FM | $315 | 2015 |
| 15495 | 15496 | News From Planet Mars | KL | $310 | 2016 |
| 15496 | 15497 | Trojan War | WB | $309 | 1997 |
| 15497 | 15498 | Lou! Journal infime | Distrib. | $287 | 2015 |
| 15498 | 15499 | Intervention | All. | $279 | 2007 |
| 15499 | 15500 | Playback | Magn. | $264 | 2012 |
आप देखेंगे कि कुछ संख्यात्मक मानों में विशेष वर्ण हैं ($, , और ^), और कुछ मान वास्तव में N/A हैं। इसलिए आपको उन्हें बदलना होगा:
na_year_idx =  [i for i, x in enumerate(final_list) if x[4] == 'n/a'] # get the indexes of the 'n/a' values
new_years = [1998, 1999, 1960, 1973]  # got them by checking online

print(*[(i, x) for i, x in enumerate(final_list) if i in na_year_idx], sep='\n')
print('new year values:', new_years)
(8003, ['8004', 'Warner Bros. 75th Anniversary Film Festival', 'WB', '$741,855', 'n/a'])
(8148, ['8149', 'Hum Aapke Dil Mein Rahte Hain', 'Eros', '$668,678', 'n/a'])
(8197, ['8198', 'Purple Moon (Re-issue)', 'Mira.', '$640,945', 'n/a'])
(10469, ['10470', 'Amarcord', 'Jan.', '$125,493', 'n/a'])
new year values: [1998, 1999, 1960, 1973]
for na_year, new_year in zip(na_year_idx, new_years):
    final_list[na_year][4] = new_year
    print(final_list[na_year], new_year)
['8004', 'Warner Bros. 75th Anniversary Film Festival', 'WB', '$741,855', 1998] 1998
['8149', 'Hum Aapke Dil Mein Rahte Hain', 'Eros', '$668,678', 1999] 1999
['8198', 'Purple Moon (Re-issue)', 'Mira.', '$640,945', 1960] 1960
['10470', 'Amarcord', 'Jan.', '$125,493', 1973] 1973
अब आप सूची को pandas के DataFrame में बदलते हैं, कॉलम के उचित नाम देकर, और मनचाहे डेटा प्रकारों में कन्वर्ट करके।
 import re
regex = '|'.join(['\$', ',', '\^'])

columns = ['rank', 'title', 'studio', 'lifetime_gross', 'year']

boxoffice_df = pd.DataFrame({
    'rank': [int(x[0]) for x in final_list],  # convert ranks to integers
    'title': [x[1] for x in final_list],  # get titles as is
    'studio': [x[2] for x in final_list],  # get studio names as is
    'lifetime_gross': [int(re.sub(regex, '', x[3])) for x in final_list],  # remove special characters and convert to integer
    'year': [int(re.sub(regex, '', str(x[4]))) for x in final_list],  # remove special characters and convert to integer
})
print('rows:', boxoffice_df.shape[0])
print('columns:', boxoffice_df.shape[1])
print('\ndata types:')
print(boxoffice_df.dtypes)
boxoffice_df.head(15)
rows: 15500
columns: 5
data types:
lifetime_gross int64
rank int64
studio object
title object
year int64
dtype: object
| lifetime_gross | rank | studio | title | year | |
|---|---|---|---|---|---|
| 0 | 936662225 | 1 | BV | Star Wars: The Force Awakens | 2015 |
| 1 | 760507625 | 2 | Fox | Avatar | 2009 |
| 2 | 681084109 | 3 | BV | Black Panther | 2018 |
| 3 | 659363944 | 4 | Par. | Titanic | 1997 |
| 4 | 652270625 | 5 | Uni. | Jurassic World | 2015 |
| 5 | 623357910 | 6 | BV | Marvel's The Avengers | 2012 |
| 6 | 620181382 | 7 | BV | Star Wars: The Last Jedi | 2017 |
| 7 | 534858444 | 8 | WB | The Dark Knight | 2008 |
| 8 | 532177324 | 9 | BV | Rogue One: A Star Wars Story | 2016 |
| 9 | 504014165 | 10 | BV | Beauty and the Beast (2017) | 2017 |
| 10 | 486295561 | 11 | BV | Finding Dory | 2016 |
| 11 | 474544677 | 12 | Fox | Star Wars: Episode I - The Phantom Menace | 1999 |
| 12 | 460998007 | 13 | Fox | Star Wars | 1977 |
| 13 | 459005868 | 14 | BV | Avengers: Age of Ultron | 2015 |
| 14 | 448139099 | 15 | WB | The Dark Knight Rises | 2012 |
'star' शब्द शीर्ष में से एक है, क्योंकि यह शीर्ष पंद्रह फ़िल्मों में से पाँच में आता है, और आप यह भी जानते हैं कि Star Wars श्रृंखला में और भी फ़िल्में हैं, जिनमें से कई शीर्ष पर हैं।
अब आपने जो कोड विकसित किया है उसका उपयोग करें और देखें कि यह इस डेटा सेट पर कैसे काम करता है। नीचे दिए गए कोड में नया कुछ नहीं है, आप बस सब कुछ एक फ़ंक्शन में रख रहे हैं:
 def word_frequency(text_list, num_list, sep=None):
    word_freq = defaultdict(lambda: [0, 0])

    for text, num in zip(text_list, num_list):
        for word in text.split(sep=sep):
            word_freq[word][0] += 1
            word_freq[word][1] += num

    columns = {0: 'abs_freq', 1: 'wtd_freq'}

    abs_wtd_df = (pd.DataFrame.from_dict(word_freq, orient='index')
                 .rename(columns=columns )
                 .sort_values('wtd_freq', ascending=False)
                 .assign(rel_value=lambda df: df['wtd_freq'] / df['abs_freq']).round())

    abs_wtd_df.insert(1, 'abs_perc', value=abs_wtd_df['abs_freq'] / abs_wtd_df['abs_freq'].sum())
    abs_wtd_df.insert(2, 'abs_perc_cum', abs_wtd_df['abs_perc'].cumsum())
    abs_wtd_df.insert(4, 'wtd_freq_perc', abs_wtd_df['wtd_freq'] / abs_wtd_df['wtd_freq'].sum())
    abs_wtd_df.insert(5, 'wtd_freq_perc_cum', abs_wtd_df['wtd_freq_perc'].cumsum())

    return abs_wtd_df
word_frequency(boxoffice_df['title'], boxoffice_df['lifetime_gross']).head()| abs_freq | abs_perc | abs_perc_cum | wtd_freq | wtd_freq_perc | wtd_freq_perc_cum | rel_value | |
|---|---|---|---|---|---|---|---|
| The | 3055 | 0.068747 | 0.068747 | 67518342498 | 0.081167 | 0.081167 | 22100930.0 |
| the | 1310 | 0.029479 | 0.098227 | 32973100860 | 0.039639 | 0.120806 | 25170306.0 |
| of | 1399 | 0.031482 | 0.129709 | 30180592467 | 0.036282 | 0.157087 | 21572975.0 |
| and | 545 | 0.012264 | 0.141973 | 12188113847 | 0.014652 | 0.171739 | 22363512.0 |
| 2 | 158 | 0.003556 | 0.145529 | 9032673058 | 0.010859 | 0.182598 | 57168817.0 |
आश्चर्य नहीं कि 'स्टॉप वर्ड्स' सबसे ऊपर हैं, जो अधिकांश दस्तावेज़-संग्रहों के लिए लगभग समान होता है। आपके पास ये डुप्लीकेट में भी हैं, जहाँ कुछ कैपिटलाइज़्ड हैं और कुछ नहीं। इसलिए आपके पास दो स्पष्ट काम हैं:
यहाँ फ़ंक्शन का एक सरल अपडेट है (नया rm_words पैरामीटर, साथ ही पंक्तियाँ 6, 7 और 8):
# words will be expanded
def word_frequency(text_list, num_list, sep=None, rm_words=('the', 'and', 'a')):
    word_freq = defaultdict(lambda: [0, 0])

    for text, num in zip(text_list, num_list):
        for word in text.split(sep=sep):
            # This should take care of ignoring the word if it's in the stop words
            if word.lower() in rm_words:
                continue
            # .lower() makes sure we are not duplicating words
            word_freq[word.lower()][0] += 1
            word_freq[word.lower()][1] += num

    columns = {0: 'abs_freq', 1: 'wtd_freq'}

    abs_wtd_df = (pd.DataFrame.from_dict(word_freq, orient='index')
                 .rename(columns=columns )
                 .sort_values('wtd_freq', ascending=False)
                 .assign(rel_value=lambda df: df['wtd_freq'] / df['abs_freq']).round())

    abs_wtd_df.insert(1, 'abs_perc', value=abs_wtd_df['abs_freq'] / abs_wtd_df['abs_freq'].sum())
    abs_wtd_df.insert(2, 'abs_perc_cum', abs_wtd_df['abs_perc'].cumsum())
    abs_wtd_df.insert(4, 'wtd_freq_perc', abs_wtd_df['wtd_freq'] / abs_wtd_df['wtd_freq'].sum())
    abs_wtd_df.insert(5, 'wtd_freq_perc_cum', abs_wtd_df['wtd_freq_perc'].cumsum())

    abs_wtd_df = abs_wtd_df.reset_index().rename(columns={'index': 'word'})

    return abs_wtd_df
from collections import defaultdict
word_freq_df = word_frequency(boxoffice_df['title'],
boxoffice_df['lifetime_gross'],
rm_words=['of','in', 'to', 'and', 'a', 'the',
'for', 'on', '&', 'is', 'at', 'it',
'from', 'with'])
word_freq_df.head(15).style.bar(['abs_freq', 'wtd_freq', 'rel_value'],
color='#60DDFF') # E6E9EB| शब्द | abs_freq | abs_perc | abs_perc_cum | wtd_freq | wtd_freq_perc | wtd_freq_perc_cum | rel_value | |
|---|---|---|---|---|---|---|---|---|
| 0 | 2 | 158 | 0.00443945 | 0.00443945 | 9032673058 | 0.0137634 | 0.0137634 | 5.71688e+07 |
| 1 | star | 45 | 0.0012644 | 0.00570385 | 5374658819 | 0.00818953 | 0.0219529 | 1.19437e+08 |
| 2 | man | 195 | 0.00547907 | 0.0111829 | 3967037854 | 0.0060447 | 0.0279976 | 2.03438e+07 |
| 3 | part | 41 | 0.00115201 | 0.0123349 | 3262579777 | 0.00497129 | 0.0329689 | 7.95751e+07 |
| 4 | movie | 117 | 0.00328744 | 0.0156224 | 3216050557 | 0.00490039 | 0.0378693 | 2.74876e+07 |
| 5 | 3 | 63 | 0.00177016 | 0.0173925 | 3197591193 | 0.00487227 | 0.0427415 | 5.07554e+07 |
| 6 | ii | 67 | 0.00188255 | 0.0192751 | 3077712883 | 0.0046896 | 0.0474311 | 4.5936e+07 |
| 7 | wars: | 6 | 0.000168587 | 0.0194437 | 2757497155 | 0.00420168 | 0.0516328 | 4.59583e+08 |
| 8 | last | 133 | 0.003737 | 0.0231807 | 2670229651 | 0.00406871 | 0.0557015 | 2.00769e+07 |
| 9 | harry | 27 | 0.00075864 | 0.0239393 | 2611329714 | 0.00397896 | 0.0596805 | 9.67159e+07 |
| 10 | me | 140 | 0.00393369 | 0.027873 | 2459330128 | 0.00374736 | 0.0634279 | 1.75666e+07 |
| 11 | potter | 10 | 0.000280978 | 0.028154 | 2394811427 | 0.00364905 | 0.0670769 | 2.39481e+08 |
| 12 | black | 71 | 0.00199494 | 0.0301489 | 2372306467 | 0.00361476 | 0.0706917 | 3.34128e+07 |
| 13 | - | 49 | 0.00137679 | 0.0315257 | 2339484878 | 0.00356474 | 0.0742564 | 4.77446e+07 |
| 14 | story | 107 | 0.00300646 | 0.0345322 | 2231437526 | 0.00340011 | 0.0776565 | 2.08546e+07 |
आइए उसी DataFrame को देखें जिसे abs_freq के आधार पर सॉर्ट किया गया है:
(word_freq_df.sort_values('abs_freq', ascending=False)
 .head(15)
    .style.bar(['abs_freq', 'wtd_freq', 'rel_value'],
               color='#60DDFF'))
| शब्द | abs_freq | abs_perc | abs_perc_cum | wtd_freq | wtd_freq_perc | wtd_freq_perc_cum | rel_value | |
|---|---|---|---|---|---|---|---|---|
| 26 | love | 211 | 0.00592863 | 0.069542 | 1604206885 | 0.00244438 | 0.111399 | 7.60288e+06 |
| 2 | man | 195 | 0.00547907 | 0.0111829 | 3967037854 | 0.0060447 | 0.0279976 | 2.03438e+07 |
| 24 | my | 191 | 0.00536668 | 0.0618994 | 1629540498 | 0.00248298 | 0.106478 | 8.53163e+06 |
| 15 | i | 168 | 0.00472043 | 0.0392526 | 2203439786 | 0.00335745 | 0.081014 | 1.31157e+07 |
| 0 | 2 | 158 | 0.00443945 | 0.00443945 | 9032673058 | 0.0137634 | 0.0137634 | 5.71688e+07 |
| 10 | me | 140 | 0.00393369 | 0.027873 | 2459330128 | 0.00374736 | 0.0634279 | 1.75666e+07 |
| 31 | life | 134 | 0.0037651 | 0.0764822 | 1534647732 | 0.00233839 | 0.123297 | 1.14526e+07 |
| 8 | last | 133 | 0.003737 | 0.0231807 | 2670229651 | 0.00406871 | 0.0557015 | 2.00769e+07 |
| 23 | you | 126 | 0.00354032 | 0.0565327 | 1713758853 | 0.00261131 | 0.103995 | 1.36013e+07 |
| 4 | movie | 117 | 0.00328744 | 0.0156224 | 3216050557 | 0.00490039 | 0.0378693 | 2.74876e+07 |
| 14 | story | 107 | 0.00300646 | 0.0345322 | 2231437526 | 0.00340011 | 0.0776565 | 2.08546e+07 |
| 33 | night | 104 | 0.00292217 | 0.0814555 | 1523917360 | 0.00232204 | 0.127946 | 1.46531e+07 |
| 19 | american | 93 | 0.00261309 | 0.0478505 | 1868854192 | 0.00284763 | 0.0932591 | 2.00952e+07 |
| 117 | girl | 90 | 0.0025288 | 0.151644 | 842771661 | 0.00128416 | 0.26663 | 9.36413e+06 |
| 16 | day | 87 | 0.00244451 | 0.0416971 | 2164198760 | 0.00329766 | 0.0843116 | 2.48758e+07 |
अब दोनों की तुलना के लिए विज़ुअलाइज़ करें और छिपे हुए रुझान देखें:
 import matplotlib.pyplot as plt
plt.figure(figsize=(20,8))
plt.subplot(1, 2, 1)

word_freq_df_abs = word_freq_df.sort_values('abs_freq', ascending=False).reset_index()

plt.barh(range(20),
         list(reversed(word_freq_df_abs['abs_freq'][:20])), color='#288FB7')
for i, word in enumerate(word_freq_df_abs['word'][:20]):
    plt.text(word_freq_df_abs['abs_freq'][i], 20-i-1,
             s=str(i+1) + '. ' + word + ': '  + str(word_freq_df_abs['abs_freq'][i]),
             ha='right', va='center', fontsize=14, color='white', fontweight='bold')
plt.text(0.4, -1.1, s='Number of times the word was used in a movie title; out of 15500 movies.', fontsize=14)
plt.text(0.4, -1.8, s='Data: boxofficemojo.com Apr. 2018.   Feedback: @eliasdabbas', fontsize=14)


plt.vlines(range(0, 210, 10), -1, 20, colors='gray', alpha=0.1)
plt.hlines(range(0, 20, 2), 0, 210, colors='gray', alpha=0.1)
plt.yticks([])
plt.xticks([])
plt.title('Words Most Used in Movie Titles', fontsize=22, fontweight='bold')

# =============
plt.subplot(1, 2, 2)
# plt.axis('off')
plt.barh(range(20),
         list(reversed(word_freq_df['wtd_freq'][:20])), color='#288FB7')
for i, word in enumerate(word_freq_df['word'][:20]):
    plt.text(word_freq_df['wtd_freq'][i], 20-i-1,
             s=str(i+1) + '. ' + word + ': ' + '$' + str(round(word_freq_df['wtd_freq'][i] / 1000_000_000, 2)) + 'b',
             ha='right', va='center', fontsize=14, color='white', fontweight='bold')
plt.text(0.4, -1.1, s='Alltime boxoffice revenue of all movies whos title contained the word. (Top word is "2") ', fontsize=14)
plt.text(0.4, -1.8, s='Data collection & methodology: http://bit.ly/word_freq', fontsize=14)

plt.vlines(range(0, 9_500_000_000, 500_000_000), -1, 20, colors='gray', alpha=0.1)
plt.hlines(range(0, 20, 2), 0, 10_000_000_000, colors='gray', alpha=0.1)
plt.xlim((-70_000_000, 9_500_000_000))
plt.yticks([])
plt.xticks([])
plt.title('Words Most Associated With Boxoffice Revenue', fontsize=22, fontweight='bold')
plt.tight_layout(pad=0.01)
plt.show()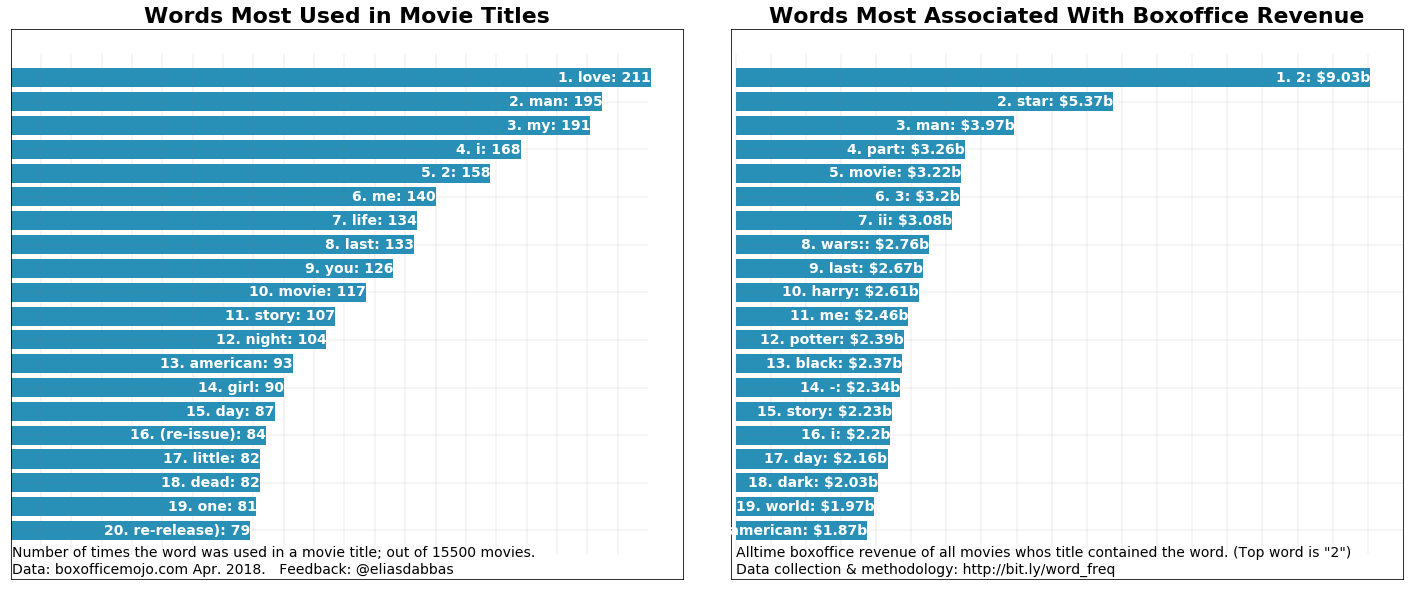
ऐसा लगता है कि कम से कम निर्माताओं और लेखकों के दिमाग में तो प्यार सब पर भारी पड़ता है! यह सभी फिल्म शीर्षकों में सबसे अधिक इस्तेमाल किया गया शब्द है। हालांकि, भारित आवृत्ति (बॉक्स-ऑफिस राजस्व) के मामले में यह उतना ऊपर नहीं है।
दूसरे शब्दों में, यदि आप सभी फिल्म शीर्षकों को देखें, तो 'love' वह शब्द होगा जो आपको सबसे अधिक मिलेगा। लेकिन दर्शकों की नजर में कौन-सा शब्द सबसे ज्यादा आया—इसे कुल कमाई को मीट्रिक मानकर आँका जाए—तो '2', 'star' और 'man' सबसे अधिक देखे गए होंगे, या सबसे अधिक राजस्व से जुड़े होंगे।
साफ़ करने के लिए: ये बहुत साधारण गणनाएँ हैं। जब आप कहते हैं कि 'love' शब्द की भारित आवृत्ति 1,604,106,767 है, तो इसका सरल मतलब यह है कि जिन सभी फिल्मों के शीर्षक में 'love' शामिल था, उनकी आजीवन कमाई का योग इतना था।
यह भी दिलचस्प है कि '2' शीर्ष पर है। जाहिर है यह शब्द नहीं है, लेकिन यह संकेत देता है कि फिल्म श्रृंखलाओं के दूसरे भाग बहुत बड़ी रकम जोड़ते हैं। '3' भी वैसा ही है, जो पाँचवें स्थान पर है। ध्यान दें कि 'part' और 'ii' भी शीर्ष दस में हैं, जो इसी बात की पुष्टि करते हैं।
'American' और 'movie' का सापेक्ष मान अधिक है।
इस फ़ंक्शन में प्रयुक्त स्टॉप वर्ड्स पर एक त्वरित टिप्पणी
आम तौर पर, आप यहाँ दी गई सूची से अधिक व्यापक स्टॉप वर्ड्स की सूची देंगे, खासकर यदि आप लेखों या सोशल मीडिया पोस्ट से निपट रहे हैं। उदाहरण के लिए nltk पैकेज कई भाषाओं में स्टॉप वर्ड्स की सूचियाँ देता है, जिन्हें डाउनलोड कर इस्तेमाल किया जा सकता है।
यहाँ के शब्द कुछ शीर्ष फिल्मों पर कुछ जाँचों के बाद चुने गए थे। इन में से कई आमतौर पर स्टॉप वर्ड्स माने जाते हैं, लेकिन फिल्म शीर्षकों के मामले में, उनमें से कुछ को रखना समझदारी लगी क्योंकि वे कुछ संकेत दे सकते हैं। उदाहरण के लिए, 'I', 'me', 'you' जैसे शब्द कुछ सामाजिक गतिशीलता की ओर इशारा कर सकते हैं। एक और कारण यह है कि फिल्म शीर्षक बहुत छोटे वाक्यांश होते हैं, और हम उनसे अधिक से अधिक अर्थ निकालने की कोशिश कर रहे हैं।
आप निश्चित रूप से अपने शब्दों के सेट के साथ इसे आज़मा सकते हैं, और थोड़े अलग परिणाम देख सकते हैं।
मूल फिल्मों की सूची पर नज़र डालें, तो दिखता है कि कुछ शीर्ष शब्द शीर्ष दस में भी नहीं आते, और यही वह तरह की अंतर्दृष्टि है जिसे हम इस तरीके से उजागर करने की कोशिश कर रहे हैं।
boxoffice_df.head(10)
| lifetime_gross | rank | studio | title | year | |
|---|---|---|---|---|---|
| 0 | 936662225 | 1 | BV | Star Wars: The Force Awakens | 2015 |
| 1 | 760507625 | 2 | Fox | Avatar | 2009 |
| 2 | 681084109 | 3 | BV | Black Panther | 2018 |
| 3 | 659363944 | 4 | Par. | Titanic | 1997 |
| 4 | 652270625 | 5 | Uni. | Jurassic World | 2015 |
| 5 | 623357910 | 6 | BV | Marvel's The Avengers | 2012 |
| 6 | 620181382 | 7 | BV | Star Wars: The Last Jedi | 2017 |
| 7 | 534858444 | 8 | WB | The Dark Knight | 2008 |
| 8 | 532177324 | 9 | BV | Rogue One: A Star Wars Story | 2016 |
| 9 | 504014165 | 10 | BV | Beauty and the Beast (2017) | 2017 |
अगला, मेरा मानना है कि जिन शीर्ष शब्दों में दिलचस्पी है, उन्हें और गहराई से देखना समझदारी होगी। आइए उन फिल्मों को फ़िल्टर करें जिनमें '2' हो और देखें:
(boxoffice_df[boxoffice_df['title']
              .str
              .contains('2 | 2', case=False)] # spaces used to exclude words like '2010'
              .head(10))
| lifetime_gross | rank | studio | title | year | |
|---|---|---|---|---|---|
| 15 | 441226247 | 16 | DW | Shrek 2 | 2004 |
| 30 | 389813101 | 31 | BV | Guardians of the Galaxy Vol. 2 | 2017 |
| 31 | 381011219 | 32 | WB | Harry Potter and the Deathly Hallows Part 2 | 2011 |
| 35 | 373585825 | 36 | Sony | Spider-Man 2 | 2004 |
| 38 | 368061265 | 39 | Uni. | Despicable Me 2 | 2013 |
| 64 | 312433331 | 65 | Par. | Iron Man 2 | 2010 |
| 79 | 292324737 | 80 | LG/S | The Twilight Saga: Breaking Dawn Part 2 | 2012 |
| 87 | 281723902 | 88 | LGF | The Hunger Games: Mockingjay - Part 2 | 2015 |
| 117 | 245852179 | 118 | BV | Toy Story 2 | 1999 |
| 146 | 226164286 | 147 | NL | Rush Hour 2 | 2001 |
आइए शीर्ष 'star' फिल्मों पर भी एक नज़र डालें:
boxoffice_df[boxoffice_df['title'].str.contains('star | star', case=False)].head(10)
| lifetime_gross | rank | studio | title | year | |
|---|---|---|---|---|---|
| 0 | 936662225 | 1 | BV | Star Wars: The Force Awakens | 2015 |
| 6 | 620181382 | 7 | BV | Star Wars: The Last Jedi | 2017 |
| 8 | 532177324 | 9 | BV | Rogue One: A Star Wars Story | 2016 |
| 11 | 474544677 | 12 | Fox | Star Wars: Episode I - The Phantom Menace | 1999 |
| 12 | 460998007 | 13 | Fox | Star Wars | 1977 |
| 33 | 380270577 | 34 | Fox | Star Wars: Episode III - Revenge of the Sith | 2005 |
| 65 | 310676740 | 66 | Fox | Star Wars: Episode II - Attack of the Clones | 2002 |
| 105 | 257730019 | 106 | Par. | Star Trek | 2009 |
| 140 | 228778661 | 141 | Par. | Star Trek Into Darkness | 2013 |
| 301 | 158848340 | 302 | Par. | Star Trek Beyond | 2016 |
और, अंत में, शीर्ष 'man' फिल्में:
boxoffice_df[boxoffice_df['title'].str.contains('man | man', case=False)].head(10)
| lifetime_gross | rank | studio | title | year | |
|---|---|---|---|---|---|
| 18 | 423315812 | 19 | BV | Pirates of the Caribbean: Dead Man's Chest | 2006 |
| 22 | 409013994 | 23 | BV | Iron Man 3 | 2013 |
| 35 | 373585825 | 36 | Sony | Spider-Man 2 | 2004 |
| 48 | 336530303 | 49 | Sony | Spider-Man 3 | 2007 |
| 53 | 330360194 | 54 | WB | Batman v Superman: Dawn of Justice | 2016 |
| 59 | 318412101 | 60 | Par. | Iron Man | 2008 |
| 64 | 312433331 | 65 | Par. | Iron Man 2 | 2010 |
| 82 | 291045518 | 83 | WB | Man of Steel | 2013 |
| 176 | 206852432 | 177 | WB | Batman Begins | 2005 |
| 182 | 202853933 | 183 | Sony | The Amazing Spider-Man 2 | 2014 |
पहले कदम के रूप में, आप और अधिक शब्द जुटाने की कोशिश कर सकते हैं: फ़िल्मी शीर्षक अत्यंत छोटे होते हैं और कई बार शब्दों के शाब्दिक अर्थ नहीं बताते। उदाहरण के लिए, godfather वास्तव में वह व्यक्ति होता है जो किसी बच्चे के बपतिस्मा का साक्षी बनता है और उसकी देखभाल का वचन देता है (या फिर कोई माफ़िया जो शौक के लिए हत्या करता है?!).
एक और अभ्यास के रूप में, फ़िल्म शीर्षक के अलावा अधिक विस्तृत वर्णन जुटाने की कोशिश करें। उदाहरण के लिए:
"एक कंप्यूटर हैकर को रहस्यमयी बाग़ियों से अपनी वास्तविकता की असली प्रकृति और नियंत्रकों के खिलाफ़ युद्ध में अपनी भूमिका के बारे में पता चलता है।"
यह हमें 'The Matrix' की तुलना में फ़िल्म के बारे में कहीं अधिक बताता है।
वैकल्पिक रूप से, आप अपना विश्लेषण समृद्ध करने के लिए नीचे दिए गए रास्तों में से किसी एक को भी अपना सकते हैं:
आप स्वयं इस डेटा के साथ-साथ अन्य डेटा का भी अन्वेषण करना चाहेंगे:
ठीक है, अब आपने फ़िल्म शीर्षकों में शब्दों की गणनाओं का अन्वेषण कर लिया है, और निरपेक्ष तथा वेटेड आवृत्तियों के बीच का अंतर देखा है, और यह भी कि इनमें से किसी एक को छोड़ देने से तस्वीर का बड़ा हिस्सा छूट सकता है। आपने इस पद्धति की सीमाएँ भी देखी हैं, और अपने विश्लेषण को बेहतर करने के कुछ सुझाव भी पाए हैं।
आपने एक विशेष फ़ंक्शन बनाने की प्रक्रिया पूरी कर ली है, जिसे आप आसानी से किसी भी ऐसे समान पाठ्य डेटा सेट (जिसमें संख्याएँ हों) पर चला सकते हैं, और समझ लिया है कि यह ऐसे डेटा सेट की आपकी समझ को कैसे बेहतर कर सकता है।
इसे आज़माएँ—अपने ट्वीट्स के प्रदर्शन, अपनी वेबसाइट के URLs, अपने Facebook पोस्ट्स, या किसी भी अन्य समान डेटा सेट का विश्लेषण करके देखें।
शायद आपके लिए कोड सहित रिपॉज़िटरी क्लोन करना और खुद प्रयास करना आसान होगा।
word_frequency फ़ंक्शन advertools पैकेज का हिस्सा है, जिसे आप डाउनलोड कर अपने कार्य/अनुसंधान में उपयोग करके देख सकते हैं।
देखें और बताइए! @eliasdabbas
DataCamp के Python Dictionaries Tutorial पर नज़र डालें ताकि आप शब्द आवृत्ति बनाना सीख सकें, और Web Scraping & NLP in Python ट्यूटोरियल देखें ताकि आप शब्द आवृत्ति वितरण को प्लॉट करना सीख सकें।
Python के बारे में और जानें
कोर्स
कोर्स
कोर्स