Cours
Introduction à Python
4 h
7M
Un jeu de métriques essentiel en fouille de texte concerne la fréquence des mots (ou de tout jeton) dans un corpus de documents textuels. Mais vous pouvez aussi recourir à un autre ensemble de métriques lorsque chaque document est associé à une valeur numérique qui décrit un attribut du document.
Quelques exemples :
Dans ce tutoriel,
defaultdict du module collections pour le gros du travail, ainsi que des DataFrames pandas pour produire le résultat final.Supposons que vous ayez deux tweets, avec leur contenu et le nombre d’impressions (vues) suivants :
| Texte du tweet | Vues |
|---|---|
| spain | 800 |
| france | 200 |
Une analyse basique montre facilement que vos mots se répartissent à 50 %/50 % entre « france » et « spain ». Dans bien des cas, vous n’avez que cela et vous ne pouvez mesurer que la fréquence absolue des mots pour tenter d’inférer certaines relations. Ici, vous disposez d’une donnée supplémentaire sur chacun des documents.
La fréquence pondérée, elle, est clairement différente : la répartition est de 80 %/20 %. Autrement dit, bien que « spain » et « france » apparaissent chacun une fois dans vos tweets, du point de vue des lecteurs, le premier est apparu 800 fois et le second 200 fois. Cela change tout !
defaultdictConsidérons maintenant un exemple un peu plus élaboré pour un ensemble de documents similaire :
| Document | Vues |
|---|---|
| france | 200 |
| spain | 180 |
| spain beaches | 170 |
| france beaches | 160 |
| spain best beaches | 160 |
Parcourez les documents, découpez-les en mots et comptez les occurrences de chaque mot :
 from collections import defaultdict

import pandas as pd

text_list = ['france', 'spain', 'spain beaches', 'france beaches', 'spain best beaches']

word_freq = defaultdict(int)

for text in text_list:
    for word in text.split():
        word_freq[word] += 1

pd.DataFrame.from_dict(word_freq, orient='index') \
.sort_values(0, ascending=False) \
.rename(columns={0: 'abs_freq'})| abs_freq | |
|---|---|
| spain | 3 |
| beaches | 3 |
| france | 2 |
| best | 1 |
Dans la boucle ci-dessus, la première ligne parcourt text_list élément par élément. La deuxième ligne (pour chaque document) parcourt les mots de chaque élément, découpés sur l’espace (ce pourrait être un autre séparateur : « - », « , », « _ », etc.).
Quand vous essayez d’affecter une valeur à word_freq[word], deux cas sont possibles :
word existe : on effectue alors l’affectation (on ajoute 1).word n’existe pas dans word_freq : defaultdict appelle la fonction par défaut fournie lors de sa définition, ici int.Quand int est appelée, elle renvoie zéro. La clé existe désormais, sa valeur vaut zéro, et elle est prête à recevoir une incrémentation de 1.
Bien que le mot le plus haut placé ait été « france » dans le premier tableau, après avoir compté tous les mots de chaque document, on voit que « spain » et « beaches » arrivent ex æquo en tête. C’est essentiel pour mettre au jour des tendances cachées, surtout lorsque la liste de documents compte des dizaines, voire des centaines de milliers d’entrées.
Maintenant que vous avez compté les occurrences de chaque mot dans le corpus, vous souhaitez voir la fréquence pondérée. Autrement dit, vous voulez savoir combien de fois les mots sont apparus aux yeux des lecteurs, comparé au nombre de fois où vous les avez utilisés.
Dans le premier tableau, la fréquence absolue était équilibrée entre « spain » et « france », mais « spain » pesait bien plus lourd, car sa valeur était de 800 contre 200 pour « france ».
Quelle serait la fréquence pondérée pour le deuxième tableau, un peu plus complexe ?
Voyons cela !
Vous pouvez réutiliser une partie du code précédent, avec quelques ajouts :
 # default value is now a list with two ints
word_freq = defaultdict(lambda: [0, 0])

# the `views` column you had in the first DataFrame
num_list = [200, 180, 170, 160, 160]

# looping is now over both the text and the numbers
for text, num in zip(text_list, num_list):
    for word in text.split():
        # same as before
        word_freq[word][0] += 1
        # new line, incrementing the numeric value for each word
        word_freq[word][1] += num

columns = {0: 'abs_freq', 1: 'wtd_freq'}

abs_wtd_df = pd.DataFrame.from_dict(word_freq, orient='index') \
             .rename(columns=columns) \
             .sort_values('wtd_freq', ascending=False) \
             .assign(rel_value=lambda df: df['wtd_freq'] / df['abs_freq']) \
            .round()

abs_wtd_df.style.background_gradient(low=0, high=.7, subset=['rel_value'])| abs_freq | wtd_freq | rel_value | |
|---|---|---|---|
| spain | 3 | 510 | 170 |
| beaches | 3 | 490 | 163 |
| france | 2 | 360 | 180 |
| best | 1 | 160 | 160 |
Quelques observations :
rel_value correspond simplement à la valeur par occurrence de chaque mot (division).rel_value, on voit aussi que, même si « france » est plutôt bas selon wtd_freq, son potentiel existe : la valeur par occurrence est élevée. Cela peut suggérer d’augmenter, par exemple, votre couverture de contenu autour de « france ».Vous pouvez ajouter d’autres métriques indiquant les pourcentages et pourcentages cumulés de chaque type de fréquence, afin de mieux cerner combien de mots constituent l’essentiel du total, le cas échéant :
 abs_wtd_df.insert(1, 'abs_perc', value=abs_wtd_df['abs_freq'] / abs_wtd_df['abs_freq'].sum())
abs_wtd_df.insert(2, 'abs_perc_cum', abs_wtd_df['abs_perc'].cumsum())
abs_wtd_df.insert(4, 'wtd_freq_perc', abs_wtd_df['wtd_freq'] / abs_wtd_df['wtd_freq'].sum())
abs_wtd_df.insert(5, 'wtd_freq_perc_cum', abs_wtd_df['wtd_freq_perc'].cumsum())
abs_wtd_df.style.background_gradient(low=0, high=0.8)| abs_freq | abs_perc | abs_perc_cum | wtd_freq | wtd_freq_perc | wtd_freq_perc_cum | rel_value | |
|---|---|---|---|---|---|---|---|
| spain | 3 | 0.333333 | 0.333333 | 510 | 0.335526 | 0.335526 | 170 |
| beaches | 3 | 0.333333 | 0.666667 | 490 | 0.322368 | 0.657895 | 163 |
| france | 2 | 0.222222 | 0.888889 | 360 | 0.236842 | 0.894737 | 180 |
| best | 1 | 0.111111 | 1 | 160 | 0.105263 | 1 | 160 |
Vous pourriez analyser bien davantage, et avec plus de données, attendez-vous à d’autres surprises.
À quoi cela ressemble-t-il dans un cas réel avec des données concrètes ?
Nous allons étudier des titres de films, repérer les mots les plus utilisés dans les titres — c’est la fréquence absolue —, et ceux associés aux plus fortes recettes — la fréquence pondérée.
Boxoffice Mojo propose une liste de plus de 15 000 films avec leurs recettes brutes et leur classement. Commencez par aspirer les données avec requests et BeautifulSoup – vous pouvez déjà explorer Boxoffice Mojo ici si vous le souhaitez :
import requests
from bs4 import BeautifulSoup
final_list = []
for i in range(1, 156):
if not i%10:
print(i)
page = 'http://www.boxofficemojo.com/alltime/domestic.htm?page=' + str(i) + '&p=.htm'
resp = requests.get(page)
soup = BeautifulSoup(resp.text, 'lxml')
# trial and error to get the exact positions
table_data = [x.text for x in soup.select('tr td')[11:511]]
# put every 5 values in a row
temp_list = [table_data[i:i+5] for i in range(0, len(table_data[:-4]), 5)]
for temp in temp_list:
final_list.append(temp)10
20
30
40
50
60
70
80
90
100
110
120
130
140
150
boxoffice_df = pd.DataFrame.from_records(final_list)

boxoffice_df.head(10)
| 0 | 1 | 2 | 3 | 4 | |
|---|---|---|---|---|---|
| 0 | 1 | Star Wars: The Force Awakens | BV | $936,662,225 | 2015 |
| 1 | 2 | Avatar | Fox | $760,507,625 | 2009^ |
| 2 | 3 | Black Panther | BV | $681,084,109 | 2018 |
| 3 | 4 | Titanic | Par. | $659,363,944 | 1997^ |
| 4 | 5 | Jurassic World | Uni. | $652,270,625 | 2015 |
| 5 | 6 | Marvel's The Avengers | BV | $623,357,910 | 2012 |
| 6 | 7 | Star Wars: The Last Jedi | BV | $620,181,382 | 2017 |
| 7 | 8 | WB | The Dark Knight | $534,858,444 | 2008^ |
| 8 | 9 | BV | Rogue One: A Star Wars Story | $532,177,324 | 2016 |
| 9 | 10 | Beauty and the Beast (2017) | BV | $504,014,165 | 2017 |
boxoffice_df.tail(15)
| 0 | 1 | 2 | 3 | 4 | |
|---|---|---|---|---|---|
| 15485 | 15486 | The Dark Hours | N/A | $423 | 2005 |
| 15486 | 15487 | 2:22 | Magn. | $422 | 2017 |
| 15487 | 15488 | State Park | Atl | $421 | 1988 |
| 15488 | 15489 | The Magician (2010) | Reg. | $406 | 2010 |
| 15489 | 15490 | Skinless | PPF | $400 | 2014 |
| 15490 | 15491 | Cinemanovels | Mont. | $398 | 2014 |
| 15491 | 15492 | Hannah: Buddhism's Untold Journey | KL | $396 | 2016 |
| 15492 | 15493 | Apartment 143 | Magn. | $383 | 2012 |
| 15493 | 15494 | The Marsh | All. | $336 | 2007 |
| 15494 | 15495 | The Chambermaid | FM | $315 | 2015 |
| 15495 | 15496 | News From Planet Mars | KL | $310 | 2016 |
| 15496 | 15497 | Trojan War | WB | $309 | 1997 |
| 15497 | 15498 | Lou! Journal infime | Distrib. | $287 | 2015 |
| 15498 | 15499 | Intervention | All. | $279 | 2007 |
| 15499 | 15500 | Playback | Magn. | $264 | 2012 |
Vous verrez que certaines valeurs numériques contiennent des caractères spéciaux ($, , et ^), et que certaines valeurs sont N/A. Il faut donc les corriger :
na_year_idx =  [i for i, x in enumerate(final_list) if x[4] == 'n/a'] # get the indexes of the 'n/a' values
new_years = [1998, 1999, 1960, 1973]  # got them by checking online

print(*[(i, x) for i, x in enumerate(final_list) if i in na_year_idx], sep='\n')
print('new year values:', new_years)
(8003, ['8004', 'Warner Bros. 75th Anniversary Film Festival', 'WB', '$741,855', 'n/a'])
(8148, ['8149', 'Hum Aapke Dil Mein Rahte Hain', 'Eros', '$668,678', 'n/a'])
(8197, ['8198', 'Purple Moon (Re-issue)', 'Mira.', '$640,945', 'n/a'])
(10469, ['10470', 'Amarcord', 'Jan.', '$125,493', 'n/a'])
new year values: [1998, 1999, 1960, 1973]
for na_year, new_year in zip(na_year_idx, new_years):
    final_list[na_year][4] = new_year
    print(final_list[na_year], new_year)
['8004', 'Warner Bros. 75th Anniversary Film Festival', 'WB', '$741,855', 1998] 1998
['8149', 'Hum Aapke Dil Mein Rahte Hain', 'Eros', '$668,678', 1999] 1999
['8198', 'Purple Moon (Re-issue)', 'Mira.', '$640,945', 1960] 1960
['10470', 'Amarcord', 'Jan.', '$125,493', 1973] 1973
Transformez maintenant la liste en DataFrame pandas en nommant correctement les colonnes et en convertissant les types voulus.
 import re
regex = '|'.join(['\$', ',', '\^'])

columns = ['rank', 'title', 'studio', 'lifetime_gross', 'year']

boxoffice_df = pd.DataFrame({
    'rank': [int(x[0]) for x in final_list],  # convert ranks to integers
    'title': [x[1] for x in final_list],  # get titles as is
    'studio': [x[2] for x in final_list],  # get studio names as is
    'lifetime_gross': [int(re.sub(regex, '', x[3])) for x in final_list],  # remove special characters and convert to integer
    'year': [int(re.sub(regex, '', str(x[4]))) for x in final_list],  # remove special characters and convert to integer
})
print('rows:', boxoffice_df.shape[0])
print('columns:', boxoffice_df.shape[1])
print('\ndata types:')
print(boxoffice_df.dtypes)
boxoffice_df.head(15)
rows: 15500
columns: 5
data types:
lifetime_gross int64
rank int64
studio object
title object
year int64
dtype: object
| lifetime_gross | rank | studio | title | year | |
|---|---|---|---|---|---|
| 0 | 936662225 | 1 | BV | Star Wars: The Force Awakens | 2015 |
| 1 | 760507625 | 2 | Fox | Avatar | 2009 |
| 2 | 681084109 | 3 | BV | Black Panther | 2018 |
| 3 | 659363944 | 4 | Par. | Titanic | 1997 |
| 4 | 652270625 | 5 | Uni. | Jurassic World | 2015 |
| 5 | 623357910 | 6 | BV | Marvel's The Avengers | 2012 |
| 6 | 620181382 | 7 | BV | Star Wars: The Last Jedi | 2017 |
| 7 | 534858444 | 8 | WB | The Dark Knight | 2008 |
| 8 | 532177324 | 9 | BV | Rogue One: A Star Wars Story | 2016 |
| 9 | 504014165 | 10 | BV | Beauty and the Beast (2017) | 2017 |
| 10 | 486295561 | 11 | BV | Finding Dory | 2016 |
| 11 | 474544677 | 12 | Fox | Star Wars: Episode I - The Phantom Menace | 1999 |
| 12 | 460998007 | 13 | Fox | Star Wars | 1977 |
| 13 | 459005868 | 14 | BV | Avengers: Age of Ultron | 2015 |
| 14 | 448139099 | 15 | WB | The Dark Knight Rises | 2012 |
Le mot « star » ressort parmi les premiers, puisqu’il apparaît dans cinq des quinze meilleurs films, et la saga Star Wars compte bien d’autres titres, dont plusieurs dans le haut du classement.
Appliquons maintenant le code développé et voyons ce qu’il donne sur ce jeu de données. Rien de nouveau ci-dessous : tout est regroupé dans une seule fonction :
 def word_frequency(text_list, num_list, sep=None):
    word_freq = defaultdict(lambda: [0, 0])

    for text, num in zip(text_list, num_list):
        for word in text.split(sep=sep):
            word_freq[word][0] += 1
            word_freq[word][1] += num

    columns = {0: 'abs_freq', 1: 'wtd_freq'}

    abs_wtd_df = (pd.DataFrame.from_dict(word_freq, orient='index')
                 .rename(columns=columns )
                 .sort_values('wtd_freq', ascending=False)
                 .assign(rel_value=lambda df: df['wtd_freq'] / df['abs_freq']).round())

    abs_wtd_df.insert(1, 'abs_perc', value=abs_wtd_df['abs_freq'] / abs_wtd_df['abs_freq'].sum())
    abs_wtd_df.insert(2, 'abs_perc_cum', abs_wtd_df['abs_perc'].cumsum())
    abs_wtd_df.insert(4, 'wtd_freq_perc', abs_wtd_df['wtd_freq'] / abs_wtd_df['wtd_freq'].sum())
    abs_wtd_df.insert(5, 'wtd_freq_perc_cum', abs_wtd_df['wtd_freq_perc'].cumsum())

    return abs_wtd_df
word_frequency(boxoffice_df['title'], boxoffice_df['lifetime_gross']).head()| abs_freq | abs_perc | abs_perc_cum | wtd_freq | wtd_freq_perc | wtd_freq_perc_cum | rel_value | |
|---|---|---|---|---|---|---|---|
| The | 3055 | 0.068747 | 0.068747 | 67518342498 | 0.081167 | 0.081167 | 22100930.0 |
| the | 1310 | 0.029479 | 0.098227 | 32973100860 | 0.039639 | 0.120806 | 25170306.0 |
| of | 1399 | 0.031482 | 0.129709 | 30180592467 | 0.036282 | 0.157087 | 21572975.0 |
| and | 545 | 0.012264 | 0.141973 | 12188113847 | 0.014652 | 0.171739 | 22363512.0 |
| 2 | 158 | 0.003556 | 0.145529 | 9032673058 | 0.010859 | 0.182598 | 57168817.0 |
Sans surprise, les « stop words » dominent, comme dans la plupart des collections de documents. Ils apparaissent en double, certains capitalisés, d’autres non. Deux points à traiter :
Voici une mise à jour simple de la fonction (nouveau paramètre rm_words, et modifications aux lignes 6, 7 et 8) :
# words will be expanded
def word_frequency(text_list, num_list, sep=None, rm_words=('the', 'and', 'a')):
    word_freq = defaultdict(lambda: [0, 0])

    for text, num in zip(text_list, num_list):
        for word in text.split(sep=sep):
            # This should take care of ignoring the word if it's in the stop words
            if word.lower() in rm_words:
                continue
            # .lower() makes sure we are not duplicating words
            word_freq[word.lower()][0] += 1
            word_freq[word.lower()][1] += num

    columns = {0: 'abs_freq', 1: 'wtd_freq'}

    abs_wtd_df = (pd.DataFrame.from_dict(word_freq, orient='index')
                 .rename(columns=columns )
                 .sort_values('wtd_freq', ascending=False)
                 .assign(rel_value=lambda df: df['wtd_freq'] / df['abs_freq']).round())

    abs_wtd_df.insert(1, 'abs_perc', value=abs_wtd_df['abs_freq'] / abs_wtd_df['abs_freq'].sum())
    abs_wtd_df.insert(2, 'abs_perc_cum', abs_wtd_df['abs_perc'].cumsum())
    abs_wtd_df.insert(4, 'wtd_freq_perc', abs_wtd_df['wtd_freq'] / abs_wtd_df['wtd_freq'].sum())
    abs_wtd_df.insert(5, 'wtd_freq_perc_cum', abs_wtd_df['wtd_freq_perc'].cumsum())

    abs_wtd_df = abs_wtd_df.reset_index().rename(columns={'index': 'word'})

    return abs_wtd_df
from collections import defaultdict
word_freq_df = word_frequency(boxoffice_df['title'],
boxoffice_df['lifetime_gross'],
rm_words=['of','in', 'to', 'and', 'a', 'the',
'for', 'on', '&', 'is', 'at', 'it',
'from', 'with'])
word_freq_df.head(15).style.bar(['abs_freq', 'wtd_freq', 'rel_value'],
color='#60DDFF') # E6E9EB| word | abs_freq | abs_perc | abs_perc_cum | wtd_freq | wtd_freq_perc | wtd_freq_perc_cum | rel_value | |
|---|---|---|---|---|---|---|---|---|
| 0 | 2 | 158 | 0.00443945 | 0.00443945 | 9032673058 | 0.0137634 | 0.0137634 | 5.71688e+07 |
| 1 | star | 45 | 0.0012644 | 0.00570385 | 5374658819 | 0.00818953 | 0.0219529 | 1.19437e+08 |
| 2 | man | 195 | 0.00547907 | 0.0111829 | 3967037854 | 0.0060447 | 0.0279976 | 2.03438e+07 |
| 3 | part | 41 | 0.00115201 | 0.0123349 | 3262579777 | 0.00497129 | 0.0329689 | 7.95751e+07 |
| 4 | movie | 117 | 0.00328744 | 0.0156224 | 3216050557 | 0.00490039 | 0.0378693 | 2.74876e+07 |
Observons le même DataFrame trié par abs_freq :
(word_freq_df.sort_values('abs_freq', ascending=False)
 .head(15)
    .style.bar(['abs_freq', 'wtd_freq', 'rel_value'],
               color='#60DDFF'))
| word | abs_freq | abs_perc | abs_perc_cum | wtd_freq | wtd_freq_perc | wtd_freq_perc_cum | rel_value | |
|---|---|---|---|---|---|---|---|---|
| 26 | love | 211 | 0.00592863 | 0.069542 | 1604206885 | 0.00244438 | 0.111399 | 7.60288e+06 |
| 2 | man | 195 | 0.00547907 | 0.0111829 | 3967037854 | 0.0060447 | 0.0279976 | 2.03438e+07 |
| 24 | my | 191 | 0.00536668 | 0.0618994 | 1629540498 | 0.00248298 | 0.106478 | 8.53163e+06 |
| 15 | i | 168 | 0.00472043 | 0.0392526 | 2203439786 | 0.00335745 | 0.081014 | 1.31157e+07 |
| 0 | 2 | 158 | 0.00443945 | 0.00443945 | 9032673058 | 0.0137634 | 0.0137634 | 5.71688e+07 |
Visualisons maintenant pour comparer les deux et faire apparaître les tendances cachées :
 import matplotlib.pyplot as plt
plt.figure(figsize=(20,8))
plt.subplot(1, 2, 1)

word_freq_df_abs = word_freq_df.sort_values('abs_freq', ascending=False).reset_index()

plt.barh(range(20),
         list(reversed(word_freq_df_abs['abs_freq'][:20])), color='#288FB7')
for i, word in enumerate(word_freq_df_abs['word'][:20]):
    plt.text(word_freq_df_abs['abs_freq'][i], 20-i-1,
             s=str(i+1) + '. ' + word + ': '  + str(word_freq_df_abs['abs_freq'][i]),
             ha='right', va='center', fontsize=14, color='white', fontweight='bold')
plt.text(0.4, -1.1, s='Number of times the word was used in a movie title; out of 15500 movies.', fontsize=14)
plt.text(0.4, -1.8, s='Data: boxofficemojo.com Apr. 2018.   Feedback: @eliasdabbas', fontsize=14)


plt.vlines(range(0, 210, 10), -1, 20, colors='gray', alpha=0.1)
plt.hlines(range(0, 20, 2), 0, 210, colors='gray', alpha=0.1)
plt.yticks([])
plt.xticks([])
plt.title('Words Most Used in Movie Titles', fontsize=22, fontweight='bold')

# =============
plt.subplot(1, 2, 2)
# plt.axis('off')
plt.barh(range(20),
         list(reversed(word_freq_df['wtd_freq'][:20])), color='#288FB7')
for i, word in enumerate(word_freq_df['word'][:20]):
    plt.text(word_freq_df['wtd_freq'][i], 20-i-1,
             s=str(i+1) + '. ' + word + ': ' + '$' + str(round(word_freq_df['wtd_freq'][i] / 1000_000_000, 2)) + 'b',
             ha='right', va='center', fontsize=14, color='white', fontweight='bold')
plt.text(0.4, -1.1, s='Alltime boxoffice revenue of all movies whos title contained the word. (Top word is "2") ', fontsize=14)
plt.text(0.4, -1.8, s='Data collection & methodology: http://bit.ly/word_freq', fontsize=14)

plt.vlines(range(0, 9_500_000_000, 500_000_000), -1, 20, colors='gray', alpha=0.1)
plt.hlines(range(0, 20, 2), 0, 10_000_000_000, colors='gray', alpha=0.1)
plt.xlim((-70_000_000, 9_500_000_000))
plt.yticks([])
plt.xticks([])
plt.title('Words Most Associated With Boxoffice Revenue', fontsize=22, fontweight='bold')
plt.tight_layout(pad=0.01)
plt.show()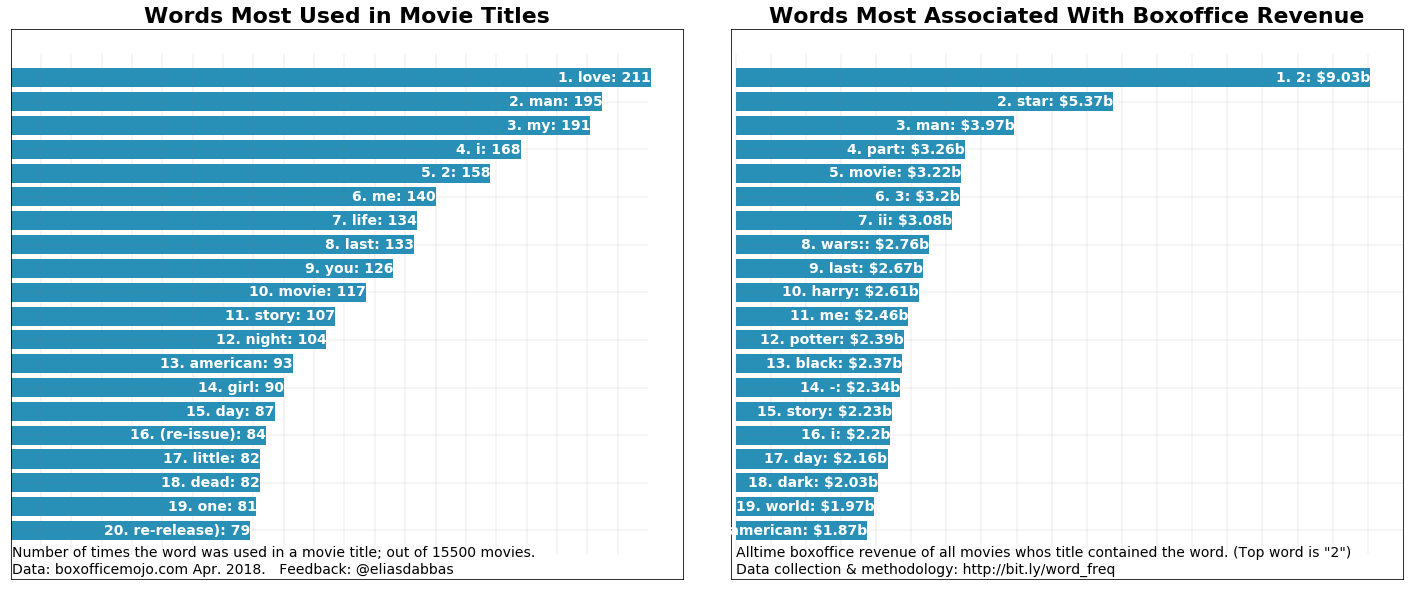
On dirait bien, du moins dans l’esprit des producteurs et scénaristes, que l’amour triomphe de tout ! C’est le mot le plus utilisé dans tous les titres de films. En fréquence pondérée (recettes au box-office), il est toutefois moins bien classé.
En d’autres termes, si vous regardez l’ensemble des titres, « love » est celui que vous verrez le plus souvent. Mais si vous estimez le mot le plus vu par le public (en prenant les recettes brutes comme proxy), alors « 2 », « star » et « man » dominent, car associés aux plus fortes recettes.
Pour être clair : ce sont des calculs très simples. Dire que la fréquence pondérée du mot « love » est 1 604 106 767 signifie simplement que la somme des recettes brutes à vie de tous les films dont le titre contenait « love » atteint ce montant.
Autre point intéressant : « 2 » arrive en tête. Évidemment, ce n’est pas un mot, mais cela indique que les deuxièmes opus de séries pèsent très lourd. Même constat pour « 3 », cinquième. Notez que « part » et « ii » figurent aussi dans le top 10, confirmant le phénomène.
« American » et « movie » présentent une valeur relative élevée.
Un mot sur les stop words utilisés
En général, vous fournirez une liste de stop words bien plus complète, surtout si vous traitez des articles ou des posts sur les réseaux sociaux. Par exemple, le paquet nltk propose des listes dans plusieurs langues, téléchargeables et réutilisables.
Ici, les mots ont été choisis après quelques vérifications sur les meilleurs films. Beaucoup sont souvent considérés comme des stop words, mais dans le cas des titres de films, il peut être pertinent d’en conserver certains, car ils apportent des indices. Par exemple, « I », « me », « you » peuvent suggérer des dynamiques sociales. Autre raison : les titres sont des expressions très courtes, et nous cherchons à en extraire un maximum de sens.
N’hésitez pas à tester avec votre propre liste : vous obtiendrez des résultats légèrement différents.
En revenant à la liste initiale des titres, on constate que certains des mots les plus utilisés n’apparaissent même pas dans le top 10 des recettes : c’est précisément le type d’insight que cette approche permet de révéler.
boxoffice_df.head(10)
| lifetime_gross | rank | studio | title | year | |
|---|---|---|---|---|---|
| 0 | 936662225 | 1 | BV | Star Wars: The Force Awakens | 2015 |
| 1 | 760507625 | 2 | Fox | Avatar | 2009 |
| 2 | 681084109 | 3 | BV | Black Panther | 2018 |
| 3 | 659363944 | 4 | Par. | Titanic | 1997 |
| 4 | 652270625 | 5 | Uni. | Jurassic World | 2015 |
| 5 | 623357910 | 6 | BV | Marvel's The Avengers | 2012 |
| 6 | 620181382 | 7 | BV | Star Wars: The Last Jedi | 2017 |
| 7 | 534858444 | 8 | WB | The Dark Knight | 2008 |
| 8 | 532177324 | 9 | BV | Rogue One: A Star Wars Story | 2016 |
| 9 | 504014165 | 10 | BV | Beauty and the Beast (2017) | 2017 |
Ensuite, il serait pertinent d’explorer davantage les mots les plus intéressants. Filtrons les films contenant « 2 » :
(boxoffice_df[boxoffice_df['title']
              .str
              .contains('2 | 2', case=False)] # spaces used to exclude words like '2010'
              .head(10))
| lifetime_gross | rank | studio | title | year | |
|---|---|---|---|---|---|
| 15 | 441226247 | 16 | DW | Shrek 2 | 2004 |
| 30 | 389813101 | 31 | BV | Guardians of the Galaxy Vol. 2 | 2017 |
| 31 | 381011219 | 32 | WB | Harry Potter and the Deathly Hallows Part 2 | 2011 |
| 35 | 373585825 | 36 | Sony | Spider-Man 2 | 2004 |
| 38 | 368061265 | 39 | Uni. | Despicable Me 2 | 2013 |
| 64 | 312433331 | 65 | Par. | Iron Man 2 | 2010 |
| 79 | 292324737 | 80 | LG/S | The Twilight Saga: Breaking Dawn Part 2 | 2012 |
| 87 | 281723902 | 88 | LGF | The Hunger Games: Mockingjay - Part 2 | 2015 |
| 117 | 245852179 | 118 | BV | Toy Story 2 | 1999 |
| 146 | 226164286 | 147 | NL | Rush Hour 2 | 2001 |
Jetons aussi un coup d’œil aux principaux films « star » :
boxoffice_df[boxoffice_df['title'].str.contains('star | star', case=False)].head(10)
| lifetime_gross | rank | studio | title | year | |
|---|---|---|---|---|---|
| 0 | 936662225 | 1 | BV | Star Wars: The Force Awakens | 2015 |
| 6 | 620181382 | 7 | BV | Star Wars: The Last Jedi | 2017 |
| 8 | 532177324 | 9 | BV | Rogue One: A Star Wars Story | 2016 |
| 11 | 474544677 | 12 | Fox | Star Wars: Episode I - The Phantom Menace | 1999 |
| 12 | 460998007 | 13 | Fox | Star Wars | 1977 |
| 33 | 380270577 | 34 | Fox | Star Wars: Episode III - Revenge of the Sith | 2005 |
| 65 | 310676740 | 66 | Fox | Star Wars: Episode II - Attack of the Clones | 2002 |
| 105 | 257730019 | 106 | Par. | Star Trek | 2009 |
| 140 | 228778661 | 141 | Par. | Star Trek Into Darkness | 2013 |
| 301 | 158848340 | 302 | Par. | Star Trek Beyond | 2016 |
Et, pour finir, les principaux films « man » :
boxoffice_df[boxoffice_df['title'].str.contains('man | man', case=False)].head(10)
| lifetime_gross | rank | studio | title | year | |
|---|---|---|---|---|---|
| 18 | 423315812 | 19 | BV | Pirates of the Caribbean: Dead Man's Chest | 2006 |
| 22 | 409013994 | 23 | BV | Iron Man 3 | 2013 |
| 35 | 373585825 | 36 | Sony | Spider-Man 2 | 2004 |
| 48 | 336530303 | 49 | Sony | Spider-Man 3 | 2007 |
| 53 | 330360194 | 54 | WB | Batman v Superman: Dawn of Justice | 2016 |
| 59 | 318412101 | 60 | Par. | Iron Man | 2008 |
| 64 | 312433331 | 65 | Par. | Iron Man 2 | 2010 |
| 82 | 291045518 | 83 | WB | Man of Steel | 2013 |
| 176 | 206852432 | 177 | WB | Batman Begins | 2005 |
| 182 | 202853933 | 183 | Sony | The Amazing Spider-Man 2 | 2014 |
Pour commencer, vous pourriez chercher à inclure davantage de mots : les titres de films sont très courts et ne reflètent pas toujours le sens littéral. Par exemple, un « godfather » est censé être la personne qui assiste au baptême d’un enfant et promet d’en prendre soin (ou bien un mafieux qui tue par plaisir ?!).
Un exercice complémentaire consisterait à récupérer des descriptions plus détaillées, en plus du titre. Par exemple :
"A computer hacker learns from mysterious rebels about the true nature of his reality and his role in the war against its controllers."
apporte bien plus d’informations sur le film que « The Matrix ».
Vous pouvez aussi suivre l’une des pistes suivantes pour enrichir votre analyse :
Vous pouvez explorer ces données — et d’autres — par vous-même :
Vous avez désormais exploré le comptage des mots dans les titres de films, constaté la différence entre fréquences absolue et pondérée, et vu qu’ignorer l’une d’elles peut occulter une grande partie de l’histoire. Vous avez aussi identifié les limites de cette approche et des pistes pour l’améliorer.
Vous avez construit une fonction dédiée, facile à réexécuter pour analyser tout jeu de données textuelles assorties de nombres, et compris en quoi cela éclaire mieux ce type de données.
Testez-la sur la performance de vos tweets, les URLs de votre site, vos publications Facebook, ou tout autre jeu de données similaire.
Le plus simple est peut-être de cloner le dépôt et d’essayer par vous-même.
La fonction word_frequency fait partie du package advertools, que vous pouvez télécharger et utiliser dans vos travaux/recherches.
Essayez et dites-moi ce que vous en pensez ! @eliasdabbas
Consultez le tutoriel sur les dictionnaires Python de DataCamp pour apprendre à créer une fréquence de mots, et le tutoriel Web scraping et NLP en Python pour apprendre à tracer des distributions de fréquences de mots.
En savoir plus sur Python
Cours
Cours
Cours