Kurs
Einführung in Python
4 Std.
7M
Ein zentrales Set an Kennzahlen im Text Mining bezieht sich auf die Häufigkeit von Wörtern (oder beliebigen Tokens) in einem bestimmten Korpus von Textdokumenten. In manchen Fällen hat allerdings jedes Dokument zusätzlich einen numerischen Wert, der ein Attribut des Dokuments beschreibt – dann lässt sich eine weitere Klasse von Metriken nutzen.
Einige Beispiele:
In diesem Tutorial
defaultdict aus dem collections-Modul und nutzt pandas-DataFrames für die Aufbereitung der Ergebnisse.Nehmen wir an, du hast zwei Tweets; ihr Inhalt und ihre Impressionen (Views) sind wie folgt:
| Tweet-Text | Views |
|---|---|
| spain | 800 |
| france | 200 |
Die Basisauswertung ist einfach: Deine Wörter verteilen sich 50:50 auf „france“ und „spain“. In vielen Fällen sind das alle Daten, die du hast – du misst die absolute Worthäufigkeit und leitest Beziehungen daraus ab. Hier liegen dir allerdings zusätzliche Informationen zu den Dokumenten vor.
Die gewichtete Häufigkeit unterscheidet sich klar: Die Verteilung ist 80:20. Obwohl „spain“ und „france“ jeweils einmal in deinen Tweets vorkommen, erschien aus Sicht der Leser Ersteres 800-mal und Letzteres 200-mal. Das ist ein deutlicher Unterschied!
defaultdictBetrachte nun ein etwas umfangreicheres Beispiel mit einem ähnlichen Dokumentenset:
| Dokument | Views |
|---|---|
| france | 200 |
| spain | 180 |
| spain beaches | 170 |
| france beaches | 160 |
| spain best beaches | 160 |
Du iterierst jetzt über die Dokumente, zerlegst sie in Wörter und zählst die Vorkommen jedes einzelnen Wortes:
 from collections import defaultdict

import pandas as pd

text_list = ['france', 'spain', 'spain beaches', 'france beaches', 'spain best beaches']

word_freq = defaultdict(int)

for text in text_list:
    for word in text.split():
        word_freq[word] += 1

pd.DataFrame.from_dict(word_freq, orient='index') \
.sort_values(0, ascending=False) \
.rename(columns={0: 'abs_freq'})| abs_freq | |
|---|---|
| spain | 3 |
| beaches | 3 |
| france | 2 |
| best | 1 |
In der obigen Schleife gehst du in der ersten Zeile die text_list nacheinander durch. Die zweite Zeile (innerhalb jedes Dokuments) iteriert über die Wörter jedes Elements, getrennt am Leerzeichen (das auch ein anderes Trennzeichen sein könnte, z. B. '-', ',', '_', etc.).
Beim Zuweisen eines Werts zu word_freq[word] gibt es zwei Fälle:
word existiert: Dann wird der Wert um eins erhöht.word existiert nicht: defaultdict ruft die beim Anlegen hinterlegte Default-Funktion auf – hier int.int gibt in diesem Fall 0 zurück. Jetzt existiert der Schlüssel, der Wert ist 0 und kann um 1 erhöht werden.
Obwohl im ersten Beispiel 'france' oben stand, siehst du nach dem Zählen über alle Wörter pro Dokument, dass 'spain' und 'beaches' gleichauf an erster Stelle liegen. Solche Analysen sind wichtig, um verborgene Trends zu erkennen – insbesondere, wenn deine Dokumentliste in die Zehn- oder Hunderttausende geht.
Nachdem du die Vorkommen jedes Wortes im Korpus gezählt hast, willst du die gewichtete Häufigkeit betrachten. Das heißt: Wie oft sind die Wörter aus Sicht deiner Leser erschienen – verglichen mit der Anzahl deiner Verwendungen?
Im ersten Beispiel war die absolute Häufigkeit 50:50 zwischen 'spain' und 'france', aber 'spain' hatte deutlich mehr Gewicht, weil sein Wert 800 betrug, gegenüber 200 für 'france'.
Wie sieht nun die gewichtete Worthäufigkeit für die zweite, etwas komplexere Tabelle aus?
Finden wir es heraus!
Du kannst Teile des obigen Codes wiederverwenden – mit ein paar Ergänzungen:
 # default value is now a list with two ints
word_freq = defaultdict(lambda: [0, 0])

# the `views` column you had in the first DataFrame
num_list = [200, 180, 170, 160, 160]

# looping is now over both the text and the numbers
for text, num in zip(text_list, num_list):
    for word in text.split():
        # same as before
        word_freq[word][0] += 1
        # new line, incrementing the numeric value for each word
        word_freq[word][1] += num

columns = {0: 'abs_freq', 1: 'wtd_freq'}

abs_wtd_df = pd.DataFrame.from_dict(word_freq, orient='index') \
             .rename(columns=columns) \
             .sort_values('wtd_freq', ascending=False) \
             .assign(rel_value=lambda df: df['wtd_freq'] / df['abs_freq']) \
            .round()

abs_wtd_df.style.background_gradient(low=0, high=.7, subset=['rel_value'])| abs_freq | wtd_freq | rel_value | |
|---|---|---|---|
| spain | 3 | 510 | 170 |
| beaches | 3 | 490 | 163 |
| france | 2 | 360 | 180 |
| best | 1 | 160 | 160 |
Einige Beobachtungen:
rel_value ist schlicht der Wert pro Vorkommen, also wtd_freq geteilt durch abs_freq.rel_value siehst du auch: Obwohl 'france' bei wtd_freq relativ weit unten liegt, steckt Potenzial drin – der Wert pro Vorkommen ist hoch. Das könnte ein Hinweis sein, deine Inhalte zu 'france' auszubauen.Praktisch ist auch, Prozentwerte und kumulierte Prozente für beide Häufigkeiten zu ergänzen. So bekommst du ein Gefühl, wie viele Wörter den Großteil der Summe ausmachen:
 abs_wtd_df.insert(1, 'abs_perc', value=abs_wtd_df['abs_freq'] / abs_wtd_df['abs_freq'].sum())
abs_wtd_df.insert(2, 'abs_perc_cum', abs_wtd_df['abs_perc'].cumsum())
abs_wtd_df.insert(4, 'wtd_freq_perc', abs_wtd_df['wtd_freq'] / abs_wtd_df['wtd_freq'].sum())
abs_wtd_df.insert(5, 'wtd_freq_perc_cum', abs_wtd_df['wtd_freq_perc'].cumsum())
abs_wtd_df.style.background_gradient(low=0, high=0.8)| abs_freq | abs_perc | abs_perc_cum | wtd_freq | wtd_freq_perc | wtd_freq_perc_cum | rel_value | |
|---|---|---|---|---|---|---|---|
| spain | 3 | 0.333333 | 0.333333 | 510 | 0.335526 | 0.335526 | 170 |
| beaches | 3 | 0.333333 | 0.666667 | 490 | 0.322368 | 0.657895 | 163 |
| france | 2 | 0.222222 | 0.888889 | 360 | 0.236842 | 0.894737 | 180 |
| best | 1 | 0.111111 | 1 | 160 | 0.105263 | 1 | 160 |
Mit mehr Daten lassen sich weitere Muster erkennen – und oft gibt es Überraschungen.
Wie sieht das nun in der Praxis mit echten Daten aus?
Du schaust dir Filmtitel an: Welche Wörter kommen in den Titeln am häufigsten vor (absolute Häufigkeit)? Und welche Wörter sind mit dem meisten Umsatz verknüpft (gewichtete Häufigkeit)?
Boxoffice Mojo führt eine Liste mit über 15.000 Filmen inklusive Einspielergebnis und Rang. Starte mit dem Scrapen der Daten via requests und BeautifulSoup – hier kannst du Boxoffice Mojo bereits erkunden:
import requests
from bs4 import BeautifulSoup
final_list = []
for i in range(1, 156):
if not i%10:
print(i)
page = 'http://www.boxofficemojo.com/alltime/domestic.htm?page=' + str(i) + '&p=.htm'
resp = requests.get(page)
soup = BeautifulSoup(resp.text, 'lxml')
# trial and error to get the exact positions
table_data = [x.text for x in soup.select('tr td')[11:511]]
# put every 5 values in a row
temp_list = [table_data[i:i+5] for i in range(0, len(table_data[:-4]), 5)]
for temp in temp_list:
final_list.append(temp)10
20
30
40
50
60
70
80
90
100
110
120
130
140
150
boxoffice_df = pd.DataFrame.from_records(final_list)

boxoffice_df.head(10)
| 0 | 1 | 2 | 3 | 4 | |
|---|---|---|---|---|---|
| 0 | 1 | Star Wars: The Force Awakens | BV | $936,662,225 | 2015 |
| 1 | 2 | Avatar | Fox | $760,507,625 | 2009^ |
| 2 | 3 | Black Panther | BV | $681,084,109 | 2018 |
| 3 | 4 | Titanic | Par. | $659,363,944 | 1997^ |
| 4 | 5 | Jurassic World | Uni. | $652,270,625 | 2015 |
| 5 | 6 | Marvel's The Avengers | BV | $623,357,910 | 2012 |
| 6 | 7 | BV | $620,181,382 | 2017 | |
| 7 | 8 | WB | $534,858,444 | 2008^ | |
| 8 | 9 | BV | $532,177,324 | 2016 | |
| 9 | 10 | BV | $504,014,165 | 2017 |
boxoffice_df.tail(15)
| 0 | 1 | 2 | 3 | 4 | |
|---|---|---|---|---|---|
| 15485 | 15486 | The Dark Hours | N/A | $423 | 2005 |
| 15486 | 15487 | 2:22 | Magn. | $422 | 2017 |
| 15487 | 15488 | State Park | Atl | $421 | 1988 |
| 15488 | 15489 | The Magician (2010) | Reg. | $406 | 2010 |
| 15489 | 15490 | Skinless | PPF | $400 | 2014 |
| 15490 | 15491 | Cinemanovels | Mont. | $398 | 2014 |
| 15491 | 15492 | Hannah: Buddhism's Untold Journey | KL | $396 | 2016 |
| 15492 | 15493 | Apartment 143 | Magn. | $383 | 2012 |
| 15493 | 15494 | The Marsh | All. | $336 | 2007 |
| 15494 | 15495 | The Chambermaid | FM | $315 | 2015 |
| 15495 | 15496 | News From Planet Mars | KL | $310 | 2016 |
| 15496 | 15497 | Trojan War | WB | $309 | 1997 |
| 15497 | 15498 | Lou! Journal infime | Distrib. | $287 | 2015 |
| 15498 | 15499 | Intervention | All. | $279 | 2007 |
| 15499 | 15500 | Playback | Magn. | $264 | 2012 |
Du siehst: Manche numerischen Werte enthalten Sonderzeichen ($, , und ^), und einige Werte sind N/A. Das musst du bereinigen:
na_year_idx =  [i for i, x in enumerate(final_list) if x[4] == 'n/a'] # get the indexes of the 'n/a' values
new_years = [1998, 1999, 1960, 1973]  # got them by checking online

print(*[(i, x) for i, x in enumerate(final_list) if i in na_year_idx], sep='\n')
print('new year values:', new_years)
(8003, ['8004', 'Warner Bros. 75th Anniversary Film Festival', 'WB', '$741,855', 'n/a'])
(8148, ['8149', 'Hum Aapke Dil Mein Rahte Hain', 'Eros', '$668,678', 'n/a'])
(8197, ['8198', 'Purple Moon (Re-issue)', 'Mira.', '$640,945', 'n/a'])
(10469, ['10470', 'Amarcord', 'Jan.', '$125,493', 'n/a'])
new year values: [1998, 1999, 1960, 1973]
for na_year, new_year in zip(na_year_idx, new_years):
    final_list[na_year][4] = new_year
    print(final_list[na_year], new_year)
['8004', 'Warner Bros. 75th Anniversary Film Festival', 'WB', '$741,855', 1998] 1998
['8149', 'Hum Aapke Dil Mein Rahte Hain', 'Eros', '$668,678', 1999] 1999
['8198', 'Purple Moon (Re-issue)', 'Mira.', '$640,945', 1960] 1960
['10470', 'Amarcord', 'Jan.', '$125,493', 1973] 1973
Jetzt wandelst du die Liste in ein pandas-DataFrame um, vergibst passende Spaltennamen und konvertierst in die gewünschten Datentypen.
 import re
regex = '|'.join(['\$', ',', '\^'])

columns = ['rank', 'title', 'studio', 'lifetime_gross', 'year']

boxoffice_df = pd.DataFrame({
    'rank': [int(x[0]) for x in final_list],  # convert ranks to integers
    'title': [x[1] for x in final_list],  # get titles as is
    'studio': [x[2] for x in final_list],  # get studio names as is
    'lifetime_gross': [int(re.sub(regex, '', x[3])) for x in final_list],  # remove special characters and convert to integer
    'year': [int(re.sub(regex, '', str(x[4]))) for x in final_list],  # remove special characters and convert to integer
})
print('rows:', boxoffice_df.shape[0])
print('columns:', boxoffice_df.shape[1])
print('\ndata types:')
print(boxoffice_df.dtypes)
boxoffice_df.head(15)
rows: 15500
columns: 5
data types:
lifetime_gross int64
rank int64
studio object
title object
year int64
dtype: object
| lifetime_gross | rank | studio | title | year | |
|---|---|---|---|---|---|
| 0 | 936662225 | 1 | BV | Star Wars: The Force Awakens | 2015 |
| 1 | 760507625 | 2 | Fox | Avatar | 2009 |
| 2 | 681084109 | 3 | BV | Black Panther | 2018 |
| 3 | 659363944 | 4 | Par. | Titanic | 1997 |
| 4 | 652270625 | 5 | Uni. | Jurassic World | 2015 |
| 5 | 623357910 | 6 | BV | Marvel's The Avengers | 2012 |
| 6 | 620181382 | 7 | BV | Star Wars: The Last Jedi | 2017 |
| 7 | 534858444 | 8 | WB | The Dark Knight | 2008 |
| 8 | 532177324 | 9 | BV | Rogue One: A Star Wars Story | 2016 |
| 9 | 504014165 | 10 | BV | Beauty and the Beast (2017) | 2017 |
| 10 | 486295561 | 11 | BV | Finding Dory | 2016 |
| 11 | 474544677 | 12 | Fox | Star Wars: Episode I - The Phantom Menace | 1999 |
| 12 | 460998007 | 13 | Fox | Star Wars | 1977 |
| 13 | 459005868 | 14 | BV | Avengers: Age of Ultron | 2015 |
| 14 | 448139099 | 15 | WB | The Dark Knight Rises | 2012 |
Das Wort „star“ ist eines der häufigsten: Es taucht in fünf der Top-15-Filme auf – und die Star-Wars-Reihe umfasst noch mehr Titel, mehrere davon ebenfalls unter den Top-Plätzen.
Lass uns jetzt den entwickelten Code auf diesen Datensatz anwenden. Neu ist unten nichts – wir packen alles in eine Funktion:
 def word_frequency(text_list, num_list, sep=None):
    word_freq = defaultdict(lambda: [0, 0])

    for text, num in zip(text_list, num_list):
        for word in text.split(sep=sep):
            word_freq[word][0] += 1
            word_freq[word][1] += num

    columns = {0: 'abs_freq', 1: 'wtd_freq'}

    abs_wtd_df = (pd.DataFrame.from_dict(word_freq, orient='index')
                 .rename(columns=columns )
                 .sort_values('wtd_freq', ascending=False)
                 .assign(rel_value=lambda df: df['wtd_freq'] / df['abs_freq']).round())

    abs_wtd_df.insert(1, 'abs_perc', value=abs_wtd_df['abs_freq'] / abs_wtd_df['abs_freq'].sum())
    abs_wtd_df.insert(2, 'abs_perc_cum', abs_wtd_df['abs_perc'].cumsum())
    abs_wtd_df.insert(4, 'wtd_freq_perc', abs_wtd_df['wtd_freq'] / abs_wtd_df['wtd_freq'].sum())
    abs_wtd_df.insert(5, 'wtd_freq_perc_cum', abs_wtd_df['wtd_freq_perc'].cumsum())

    return abs_wtd_df
word_frequency(boxoffice_df['title'], boxoffice_df['lifetime_gross']).head()| abs_freq | abs_perc | abs_perc_cum | wtd_freq | wtd_freq_perc | wtd_freq_perc_cum | rel_value | |
|---|---|---|---|---|---|---|---|
| The | 3055 | 0.068747 | 0.068747 | 67518342498 | 0.081167 | 0.081167 | 22100930.0 |
| the | 1310 | 0.029479 | 0.098227 | 32973100860 | 0.039639 | 0.120806 | 25170306.0 |
| of | 1399 | 0.031482 | 0.129709 | 30180592467 | 0.036282 | 0.157087 | 21572975.0 |
| and | 545 | 0.012264 | 0.141973 | 12188113847 | 0.014652 | 0.171739 | 22363512.0 |
| 2 | 158 | 0.003556 | 0.145529 | 9032673058 | 0.010859 | 0.182598 | 57168817.0 |
Wenig überraschend führen sogenannte „Stopwörter“ die Liste an – und einige tauchen doppelt auf, groß- und kleingeschrieben. Also gibt es zwei To-dos:
Hier ist ein einfaches Update (neuer Parameter rm_words sowie Zeilen 6, 7 und 8):
# words will be expanded
def word_frequency(text_list, num_list, sep=None, rm_words=('the', 'and', 'a')):
    word_freq = defaultdict(lambda: [0, 0])

    for text, num in zip(text_list, num_list):
        for word in text.split(sep=sep):
            # This should take care of ignoring the word if it's in the stop words
            if word.lower() in rm_words:
                continue
            # .lower() makes sure we are not duplicating words
            word_freq[word.lower()][0] += 1
            word_freq[word.lower()][1] += num

    columns = {0: 'abs_freq', 1: 'wtd_freq'}

    abs_wtd_df = (pd.DataFrame.from_dict(word_freq, orient='index')
                 .rename(columns=columns )
                 .sort_values('wtd_freq', ascending=False)
                 .assign(rel_value=lambda df: df['wtd_freq'] / df['abs_freq']).round())

    abs_wtd_df.insert(1, 'abs_perc', value=abs_wtd_df['abs_freq'] / abs_wtd_df['abs_freq'].sum())
    abs_wtd_df.insert(2, 'abs_perc_cum', abs_wtd_df['abs_perc'].cumsum())
    abs_wtd_df.insert(4, 'wtd_freq_perc', abs_wtd_df['wtd_freq'] / abs_wtd_df['wtd_freq'].sum())
    abs_wtd_df.insert(5, 'wtd_freq_perc_cum', abs_wtd_df['wtd_freq_perc'].cumsum())

    abs_wtd_df = abs_wtd_df.reset_index().rename(columns={'index': 'word'})

    return abs_wtd_df
from collections import defaultdict
word_freq_df = word_frequency(boxoffice_df['title'],
boxoffice_df['lifetime_gross'],
rm_words=['of','in', 'to', 'and', 'a', 'the',
'for', 'on', '&', 'is', 'at', 'it',
'from', 'with'])
word_freq_df.head(15).style.bar(['abs_freq', 'wtd_freq', 'rel_value'],
color='#60DDFF') # E6E9EB| word | abs_freq | abs_perc | abs_perc_cum | wtd_freq | wtd_freq_perc | wtd_freq_perc_cum | rel_value | |
|---|---|---|---|---|---|---|---|---|
| 0 | 2 | 158 | 0.00443945 | 0.00443945 | 9032673058 | 0.0137634 | 0.0137634 | 5.71688e+07 |
| 1 | star | 45 | 0.0012644 | 0.00570385 | 5374658819 | 0.00818953 | 0.0219529 | 1.19437e+08 |
| 2 | man | 195 | 0.00547907 | 0.0279976 | 3967037854 | 0.0060447 | 0.0279976 | 2.03438e+07 |
| 3 | part | 41 | 0.00115201 | 0.0329689 | 3262579777 | 0.00497129 | 0.0329689 | 7.95751e+07 |
| 4 | movie | 117 | 0.00328744 | 0.0378693 | 3216050557 | 0.00490039 | 0.0378693 | 2.74876e+07 |
Schauen wir auf dasselbe DataFrame, sortiert nach abs_freq:
(word_freq_df.sort_values('abs_freq', ascending=False)
 .head(15)
    .style.bar(['abs_freq', 'wtd_freq', 'rel_value'],
               color='#60DDFF'))
| word | abs_freq | abs_perc | abs_perc_cum | wtd_freq | wtd_freq_perc | wtd_freq_perc_cum | rel_value | |
|---|---|---|---|---|---|---|---|---|
| 26 | love | 211 | 0.00592863 | 0.111399 | 1604206885 | 0.00244438 | 0.111399 | 7.60288e+06 |
| 2 | man | 195 | 0.00547907 | 0.0279976 | 3967037854 | 0.0060447 | 0.0279976 | 2.03438e+07 |
Visualisieren wir das Ganze, um beide Perspektiven zu vergleichen und verborgene Trends zu sehen:
 import matplotlib.pyplot as plt
plt.figure(figsize=(20,8))
plt.subplot(1, 2, 1)

word_freq_df_abs = word_freq_df.sort_values('abs_freq', ascending=False).reset_index()

plt.barh(range(20),
         list(reversed(word_freq_df_abs['abs_freq'][:20])), color='#288FB7')
for i, word in enumerate(word_freq_df_abs['word'][:20]):
    plt.text(word_freq_df_abs['abs_freq'][i], 20-i-1,
             s=str(i+1) + '. ' + word + ': '  + str(word_freq_df_abs['abs_freq'][i]),
             ha='right', va='center', fontsize=14, color='white', fontweight='bold')
plt.text(0.4, -1.1, s='Number of times the word was used in a movie title; out of 15500 movies.', fontsize=14)
plt.text(0.4, -1.8, s='Data: boxofficemojo.com Apr. 2018.   Feedback: @eliasdabbas', fontsize=14)


plt.vlines(range(0, 210, 10), -1, 20, colors='gray', alpha=0.1)
plt.hlines(range(0, 20, 2), 0, 210, colors='gray', alpha=0.1)
plt.yticks([])
plt.xticks([])
plt.title('Words Most Used in Movie Titles', fontsize=22, fontweight='bold')

# =============
plt.subplot(1, 2, 2)
# plt.axis('off')
plt.barh(range(20),
         list(reversed(word_freq_df['wtd_freq'][:20])), color='#288FB7')
for i, word in enumerate(word_freq_df['word'][:20]):
    plt.text(word_freq_df['wtd_freq'][i], 20-i-1,
             s=str(i+1) + '. ' + word + ': ' + '$' + str(round(word_freq_df['wtd_freq'][i] / 1000_000_000, 2)) + 'b',
             ha='right', va='center', fontsize=14, color='white', fontweight='bold')
plt.text(0.4, -1.1, s='Alltime boxoffice revenue of all movies whos title contained the word. (Top word is "2") ', fontsize=14)
plt.text(0.4, -1.8, s='Data collection & methodology: http://bit.ly/word_freq', fontsize=14)

plt.vlines(range(0, 9_500_000_000, 500_000_000), -1, 20, colors='gray', alpha=0.1)
plt.hlines(range(0, 20, 2), 0, 10_000_000_000, colors='gray', alpha=0.1)
plt.xlim((-70_000_000, 9_500_000_000))
plt.yticks([])
plt.xticks([])
plt.title('Words Most Associated With Boxoffice Revenue', fontsize=22, fontweight='bold')
plt.tight_layout(pad=0.01)
plt.show()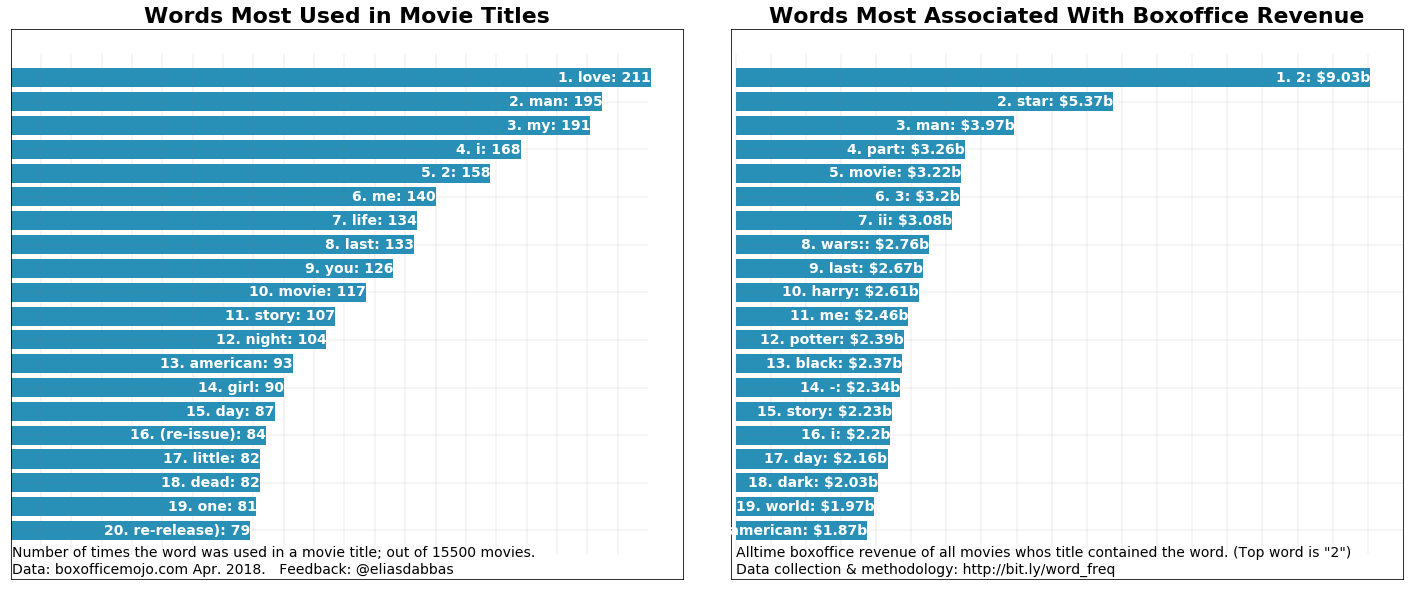
Zumindest in den Köpfen von Produzenten und Autorinnen scheint Liebe zu siegen: „love“ ist das meistgenutzte Wort in allen Filmtiteln. Beim Kriterium gewichtete Häufigkeit (Box-Office-Einnahmen) liegt es allerdings nicht ganz vorne.
Heißt: In allen Filmtiteln würdest du „love“ am häufigsten finden. Betrachtet man hingegen, welches Wort aus Sicht der Zuschauer am meisten „erschien“ (Einspielergebnis als Proxy), führen „2“, „star“ und „man“ – sie sind mit den höchsten Einnahmen verknüpft.
Zur Klarstellung: Das sind sehr einfache Berechnungen. Wenn die gewichtete Häufigkeit von „love“ 1.604.106.767 beträgt, heißt das lediglich, dass die Summe der gesamten Einspielergebnisse aller Filme, deren Titel das Wort „love“ enthält, genau diesen Betrag ausmacht.
Spannend ist auch, dass „2“ an der Spitze steht. Natürlich ist das kein Wort, sondern ein Hinweis darauf, dass zweite Teile von Filmreihen enorm viel Umsatz generieren. Ähnlich „3“ auf Position fünf. Auch „part“ und „ii“ finden sich in den Top Ten und stützen diese Beobachtung.
„American“ und „movie“ haben einen hohen relativen Wert.
Kurz zu den verwendeten Stopwörtern
Normalerweise würdest du eine umfassendere Stopwortliste verwenden – besonders bei Artikeln oder Social Posts. Das Paket nltk stellt z. B. Stopwortlisten für mehrere Sprachen bereit.
Die hier genutzten Wörter wurden nach einigen Stichproben unter den Top-Filmen gewählt. Viele davon sind zwar klassisch Stopwörter, bei Filmtiteln kann es aber sinnvoll sein, einige zu behalten – sie liefern Kontext. Beispielsweise können „I“, „me“, „you“ etwas über soziale Dynamiken andeuten. Außerdem sind Filmtitel sehr kurze Phrasen, aus denen wir möglichst viel Bedeutung ziehen wollen.
Probier es gern mit deiner eigenen Wortliste – du wirst leicht abweichende Ergebnisse sehen.
Im Vergleich zur ursprünglichen Titelliste fällt auf: Einige der Top-Wörter tauchen nicht einmal in den Top Ten der Titel auf. Genau diese Art von Insight wollen wir mit diesem Ansatz sichtbar machen.
boxoffice_df.head(10)
| lifetime_gross | rank | studio | title | year | |
|---|---|---|---|---|---|
| 0 | 936662225 | 1 | BV | Star Wars: The Force Awakens | 2015 |
| 1 | 760507625 | 2 | Fox | Avatar | 2009 |
| 2 | 681084109 | 3 | BV | Black Panther | 2018 |
| 3 | 659363944 | 4 | Par. | Titanic | 1997 |
| 4 | 652270625 | 5 | Uni. | Jurassic World | 2015 |
| 5 | 623357910 | 6 | BV | Marvel's The Avengers | 2012 |
| 6 | 620181382 | 7 | BV | Star Wars: The Last Jedi | 2017 |
| 7 | 534858444 | 8 | WB | The Dark Knight | 2008 |
| 8 | 532177324 | 9 | BV | Rogue One: A Star Wars Story | 2016 |
| 9 | 504014165 | 10 | BV | Beauty and the Beast (2017) | 2017 |
Als Nächstes lohnt sich ein Blick auf spannende Top-Wörter. Filtern wir nach Filmen mit „2“:
(boxoffice_df[boxoffice_df['title']
              .str
              .contains('2 | 2', case=False)] # spaces used to exclude words like '2010'
              .head(10))
| lifetime_gross | rank | studio | title | year | |
|---|---|---|---|---|---|
| 15 | 441226247 | 16 | DW | Shrek 2 | 2004 |
| 30 | 389813101 | 31 | BV | Guardians of the Galaxy Vol. 2 | 2017 |
| 31 | 381011219 | 32 | WB | Harry Potter and the Deathly Hallows Part 2 | 2011 |
| 35 | 373585825 | 36 | Sony | Spider-Man 2 | 2004 |
| 38 | 368061265 | 39 | Uni. | Despicable Me 2 | 2013 |
| 64 | 312433331 | 65 | Par. | Iron Man 2 | 2010 |
| 79 | 292324737 | 80 | LG/S | The Twilight Saga: Breaking Dawn Part 2 | 2012 |
| 87 | 281723902 | 88 | LGF | The Hunger Games: Mockingjay - Part 2 | 2015 |
| 117 | 245852179 | 118 | BV | Toy Story 2 | 1999 |
| 146 | 226164286 | 147 | NL | Rush Hour 2 | 2001 |
Werfen wir auch einen Blick auf die Top-„star“-Filme:
boxoffice_df[boxoffice_df['title'].str.contains('star | star', case=False)].head(10)
| lifetime_gross | rank | studio | title | year | |
|---|---|---|---|---|---|
| 0 | 936662225 | 1 | BV | Star Wars: The Force Awakens | 2015 |
| 6 | 620181382 | 7 | BV | Star Wars: The Last Jedi | 2017 |
| 8 | 532177324 | 9 | BV | Rogue One: A Star Wars Story | 2016 |
| 11 | 474544677 | 12 | Fox | Star Wars: Episode I - The Phantom Menace | 1999 |
| 12 | 460998007 | 13 | Fox | Star Wars | 1977 |
| 33 | 380270577 | 34 | Fox | Star Wars: Episode III - Revenge of the Sith | 2005 |
| 65 | 310676740 | 66 | Fox | Star Wars: Episode II - Attack of the Clones | 2002 |
| 105 | 257730019 | 106 | Par. | Star Trek | 2009 |
| 140 | 228778661 | 141 | Par. | Star Trek Into Darkness | 2013 |
| 301 | 158848340 | 302 | Par. | Star Trek Beyond | 2016 |
Und zuletzt die Top-„man“-Filme:
boxoffice_df[boxoffice_df['title'].str.contains('man | man', case=False)].head(10)
| lifetime_gross | rank | studio | title | year | |
|---|---|---|---|---|---|
| 18 | 423315812 | 19 | BV | Pirates of the Caribbean: Dead Man's Chest | 2006 |
| 22 | 409013994 | 23 | BV | Iron Man 3 | 2013 |
| 35 | 373585825 | 36 | Sony | Spider-Man 2 | 2004 |
| 48 | 336530303 | 49 | Sony | Spider-Man 3 | 2007 |
| 53 | 330360194 | 54 | WB | Batman v Superman: Dawn of Justice | 2016 |
| 59 | 318412101 | 60 | Par. | Iron Man | 2008 |
| 64 | 312433331 | 65 | Par. | Iron Man 2 | 2010 |
| 82 | 291045518 | 83 | WB | Man of Steel | 2013 |
| 176 | 206852432 | 177 | WB | Batman Begins | 2005 |
| 182 | 202853933 | 183 | Sony | The Amazing Spider-Man 2 | 2014 |
Als ersten Schritt könntest du mehr Wörter einbeziehen: Filmtitel sind extrem kurz und transportieren oft nicht die wörtliche Bedeutung. Beispiel: Ein „Godfather“ ist eigentlich ein Taufpate, der die Fürsorge für ein Kind zusichert (oder ein Mafioso, der zum Vergnügen tötet?!).
Als weitere Übung könntest du zu den Titeln detailliertere Beschreibungen ergänzen. Zum Beispiel:
"A computer hacker learns from mysterious rebels about the true nature of his reality and his role in the war against its controllers."
Dieser Satz verrät deutlich mehr über den Film als „The Matrix“.
Alternativ kannst du deine Analyse entlang folgender Pfade vertiefen:
Vielleicht möchtest du die Daten selbst weiter erkunden – sowie weitere Datensätze:
Du hast nun die Worthäufigkeit in Filmtiteln untersucht und den Unterschied zwischen absoluter und gewichteter Häufigkeit gesehen – und warum das Weglassen einer Sichtweise ein unvollständiges Bild ergibt. Außerdem kennst du die Grenzen des Ansatzes und Ansatzpunkte zur Verbesserung.
Du hast eine Funktion erstellt, die du schnell auf beliebige ähnliche Text-Datensätze mit Zahlen anwenden kannst – und weißt, wie sie dein Verständnis solcher Daten verbessert.
Probiere es aus: Analysiere deine Tweets, die URLs deiner Website, deine Facebook-Posts oder jeden anderen vergleichbaren Datensatz.
Am einfachsten ist es vielleicht, das Repository zu klonen und selbst loszulegen.
Die Funktion word_frequency ist Teil des Pakets advertools, das du herunterladen und in deiner Arbeit/Forschung einsetzen kannst.
Schau es dir an und gib Bescheid! @eliasdabbas
Sieh dir auch DataCamps Python Dictionaries Tutorial an, um Worthäufigkeiten zu erstellen, und das Tutorial Web Scraping & NLP in Python, um Worthäufigkeitsverteilungen zu visualisieren.
Mehr über Python lernen
Kurs
Kurs
Kurs