Curso
Introducción a Python
4 h
7M
Un conjunto importante de métricas en la minería de texto tiene que ver con la frecuencia de las palabras (o de cualquier token) en un determinado corpus de documentos. No obstante, también puedes usar un conjunto adicional de métricas cuando cada documento tiene asociado un valor numérico que describe algún atributo del propio documento.
Algunos ejemplos:
En este tutorial,
defaultdict del módulo collections para el trabajo pesado, además de DataFrames de pandas para gestionar el resultado final.Supón que tienes dos tuits y que su contenido y número de impresiones (vistas) son los siguientes:
| Texto del tuit | Vistas |
|---|---|
| spain | 800 |
| france | 200 |
Es fácil hacer el análisis básico y ver que tus palabras se reparten 50:50 entre “france” y “spain”. En muchos casos, esto es todo lo que tienes: puedes medir solo la frecuencia absoluta de las palabras e intentar inferir ciertas relaciones. En este caso, además, dispones de un dato numérico para cada documento.
La frecuencia ponderada aquí es claramente distinta: el reparto es 80:20. En otras palabras, aunque “spain” y “france” aparecen una vez cada una en tus tuits, desde la perspectiva de tus lectores la primera apareció 800 veces y la segunda 200. ¡Hay una gran diferencia!
defaultdictAhora considera este ejemplo un poco más elaborado para un conjunto similar de documentos:
| Documento | Vistas |
|---|---|
| france | 200 |
| spain | 180 |
| spain beaches | 170 |
| france beaches | 160 |
| spain best beaches | 160 |
Ahora iteras por los documentos, los separas en palabras y cuentas las apariciones de cada una:
 from collections import defaultdict

import pandas as pd

text_list = ['france', 'spain', 'spain beaches', 'france beaches', 'spain best beaches']

word_freq = defaultdict(int)

for text in text_list:
    for word in text.split():
        word_freq[word] += 1

pd.DataFrame.from_dict(word_freq, orient='index') \
.sort_values(0, ascending=False) \
.rename(columns={0: 'abs_freq'})| abs_freq | |
|---|---|
| spain | 3 |
| beaches | 3 |
| france | 2 |
| best | 1 |
En el bucle anterior, la primera línea recorre uno a uno los elementos de text_list. La segunda línea (dentro de cada documento) recorre las palabras de cada elemento, separadas por el espacio (podría ser cualquier otro carácter: “-”, “,”, “_”, etc.).
Al intentar asignar un valor a word_freq[word] hay dos escenarios posibles:
word existe: se realiza la asignación (sumando uno).word no está en word_freq: en ese caso defaultdict llama a la función por defecto con la que se definió, que aquí es int.Cuando se llama a int, devuelve cero. Ahora la clave existe, su valor es cero y ya puede incrementarse en 1.
Aunque en la primera tabla la palabra destacada era “france”, tras contar todas las palabras dentro de cada documento vemos que “spain” y “beaches” empatan en la primera posición. Esto es clave para destapar tendencias ocultas, sobre todo cuando trabajas con listas de documentos de decenas o cientos de miles.
Ahora que ya has contado las apariciones de cada palabra en el corpus, quieres ver la frecuencia ponderada. Es decir, quieres saber cuántas veces vieron tus lectores esas palabras en comparación con cuántas veces las usaste.
En la primera tabla, la frecuencia absoluta se repartía equitativamente entre “spain” y “france”, pero “spain” tenía claramente más peso, porque su valor era 800, frente a 200 de “france”.
Pero ¿cuál sería la frecuencia ponderada para la segunda tabla, un poco más compleja?
¡Vamos a verlo!
Puedes reutilizar parte del código anterior, con algunas adiciones:
 # el valor por defecto ahora es una lista con dos enteros
word_freq = defaultdict(lambda: [0, 0])

# la columna `views` que tenías en el primer DataFrame
num_list = [200, 180, 170, 160, 160]

# ahora iteramos por texto y números a la vez
for text, num in zip(text_list, num_list):
    for word in text.split():
        # igual que antes
        word_freq[word][0] += 1
        # línea nueva: incrementa el valor numérico para cada palabra
        word_freq[word][1] += num

columns = {0: 'abs_freq', 1: 'wtd_freq'}

abs_wtd_df = pd.DataFrame.from_dict(word_freq, orient='index') \
             .rename(columns=columns) \
             .sort_values('wtd_freq', ascending=False) \
             .assign(rel_value=lambda df: df['wtd_freq'] / df['abs_freq']) \
            .round()

abs_wtd_df.style.background_gradient(low=0, high=.7, subset=['rel_value'])| abs_freq | wtd_freq | rel_value | |
|---|---|---|---|
| spain | 3 | 510 | 170 |
| beaches | 3 | 490 | 163 |
| france | 2 | 360 | 180 |
| best | 1 | 160 | 160 |
Algunas observaciones:
rel_value es una simple división para obtener el valor por aparición de cada palabra.rel_value, también notas que, aunque “france” es bastante baja en wtd_freq, tiene potencial porque el valor por aparición es alto. Esto podría sugerir, por ejemplo, ampliar la cobertura de contenido sobre “france”.También puedes añadir otras métricas que muestren los porcentajes y los porcentajes acumulados de cada tipo de frecuencia para tener una mejor perspectiva de cuántas palabras concentran la mayor parte del total, si es el caso:
 abs_wtd_df.insert(1, 'abs_perc', value=abs_wtd_df['abs_freq'] / abs_wtd_df['abs_freq'].sum())
abs_wtd_df.insert(2, 'abs_perc_cum', abs_wtd_df['abs_perc'].cumsum())
abs_wtd_df.insert(4, 'wtd_freq_perc', abs_wtd_df['wtd_freq'] / abs_wtd_df['wtd_freq'].sum())
abs_wtd_df.insert(5, 'wtd_freq_perc_cum', abs_wtd_df['wtd_freq_perc'].cumsum())
abs_wtd_df.style.background_gradient(low=0, high=0.8)| abs_freq | abs_perc | abs_perc_cum | wtd_freq | wtd_freq_perc | wtd_freq_perc_cum | rel_value | |
|---|---|---|---|---|---|---|---|
| spain | 3 | 0.333333 | 0.333333 | 510 | 0.335526 | 0.335526 | 170 |
| beaches | 3 | 0.333333 | 0.666667 | 490 | 0.322368 | 0.657895 | 163 |
| france | 2 | 0.222222 | 0.888889 | 360 | 0.236842 | 0.894737 | 180 |
| best | 1 | 0.111111 | 1 | 160 | 0.105263 | 1 | 160 |
Con más datos, hay mucho más que analizar y suelen aparecer sorpresas.
¿Cómo se ve esto en un caso real con datos reales?
Vamos a examinar títulos de películas, ver qué palabras se usan más en los títulos —frecuencia absoluta— y cuáles se asocian con mayor recaudación —frecuencia ponderada—.
Boxoffice Mojo tiene una lista con más de 15.000 películas junto con su recaudación bruta y su ranking. Empieza extrayendo los datos con requests y BeautifulSoup. Puedes explorar Boxoffice Mojo aquí si quieres:
import requests
from bs4 import BeautifulSoup
final_list = []
for i in range(1, 156):
if not i%10:
print(i)
page = 'http://www.boxofficemojo.com/alltime/domestic.htm?page=' + str(i) + '&p=.htm'
resp = requests.get(page)
soup = BeautifulSoup(resp.text, 'lxml')
# prueba y error para dar con las posiciones exactas
table_data = [x.text for x in soup.select('tr td')[11:511]]
# agrupa cada 5 valores en una fila
temp_list = [table_data[i:i+5] for i in range(0, len(table_data[:-4]), 5)]
for temp in temp_list:
final_list.append(temp)10
20
30
40
50
60
70
80
90
100
110
120
130
140
150
boxoffice_df = pd.DataFrame.from_records(final_list)

boxoffice_df.head(10)
| 0 | 1 | 2 | 3 | 4 | |
|---|---|---|---|---|---|
| 0 | 1 | Star Wars: The Force Awakens | BV | $936,662,225 | 2015 |
| 1 | 2 | Avatar | Fox | $760,507,625 | 2009^ |
| 2 | 3 | Black Panther | BV | $681,084,109 | 2018 |
| 3 | 4 | Titanic | Par. | $659,363,944 | 1997^ |
| 4 | 5 | Jurassic World | Uni. | $652,270,625 | 2015 |
| 5 | 6 | Marvel's The Avengers | BV | $623,357,910 | 2012 |
| 6 | 7 | BV | $620,181,382 | 2017 | |
| 7 | 8 | WB | $534,858,444 | 2008^ | |
| 8 | 9 | BV | $532,177,324 | 2016 | |
| 9 | 10 | BV | $504,014,165 | 2017 |
boxoffice_df.tail(15)
| 0 | 1 | 2 | 3 | 4 | |
|---|---|---|---|---|---|
| 15485 | 15486 | The Dark Hours | N/A | $423 | 2005 |
| 15486 | 15487 | 2:22 | Magn. | $422 | 2017 |
| 15487 | 15488 | State Park | Atl | $421 | 1988 |
| 15488 | 15489 | The Magician (2010) | Reg. | $406 | 2010 |
| 15489 | 15490 | Skinless | PPF | $400 | 2014 |
| 15490 | 15491 | Cinemanovels | Mont. | $398 | 2014 |
| 15491 | 15492 | Hannah: Buddhism's Untold Journey | KL | $396 | 2016 |
| 15492 | 15493 | Apartment 143 | Magn. | $383 | 2012 |
| 15493 | 15494 | The Marsh | All. | $336 | 2007 |
| 15494 | 15495 | The Chambermaid | FM | $315 | 2015 |
| 15495 | 15496 | News From Planet Mars | KL | $310 | 2016 |
| 15496 | 15497 | Trojan War | WB | $309 | 1997 |
| 15497 | 15498 | Lou! Journal infime | Distrib. | $287 | 2015 |
| 15498 | 15499 | Intervention | All. | $279 | 2007 |
| 15499 | 15500 | Playback | Magn. | $264 | 2012 |
Verás que algunos valores numéricos incluyen caracteres especiales ($, , y ^), y algunos valores son N/A. Hay que limpiarlos:
na_year_idx =  [i for i, x in enumerate(final_list) if x[4] == 'n/a'] # índices de los valores 'n/a'
new_years = [1998, 1999, 1960, 1973]  # obtenidos comprobando online

print(*[(i, x) for i, x in enumerate(final_list) if i in na_year_idx], sep='\n')
print('new year values:', new_years)
(8003, ['8004', 'Warner Bros. 75th Anniversary Film Festival', 'WB', '$741,855', 'n/a'])
(8148, ['8149', 'Hum Aapke Dil Mein Rahte Hain', 'Eros', '$668,678', 'n/a'])
(8197, ['8198', 'Purple Moon (Re-issue)', 'Mira.', '$640,945', 'n/a'])
(10469, ['10470', 'Amarcord', 'Jan.', '$125,493', 'n/a'])
new year values: [1998, 1999, 1960, 1973]
for na_year, new_year in zip(na_year_idx, new_years):
    final_list[na_year][4] = new_year
    print(final_list[na_year], new_year)
['8004', 'Warner Bros. 75th Anniversary Film Festival', 'WB', '$741,855', 1998] 1998
['8149', 'Hum Aapke Dil Mein Rahte Hain', 'Eros', '$668,678', 1999] 1999
['8198', 'Purple Moon (Re-issue)', 'Mira.', '$640,945', 1960] 1960
['10470', 'Amarcord', 'Jan.', '$125,493', 1973] 1973
Ahora convierte la lista en un DataFrame de pandas, nombrando las columnas adecuadamente y convirtiendo a los tipos de datos deseados.
 import re
regex = '|'.join(['\$', ',', '\^'])

columns = ['rank', 'title', 'studio', 'lifetime_gross', 'year']

boxoffice_df = pd.DataFrame({
    'rank': [int(x[0]) for x in final_list],  # convierte los rangos a enteros
    'title': [x[1] for x in final_list],  # títulos tal cual
    'studio': [x[2] for x in final_list],  # estudios tal cual
    'lifetime_gross': [int(re.sub(regex, '', x[3])) for x in final_list],  # elimina caracteres especiales y convierte a entero
    'year': [int(re.sub(regex, '', str(x[4]))) for x in final_list],  # elimina caracteres especiales y convierte a entero
})
print('rows:', boxoffice_df.shape[0])
print('columns:', boxoffice_df.shape[1])
print('\ndata types:')
print(boxoffice_df.dtypes)
boxoffice_df.head(15)
rows: 15500
columns: 5
data types:
lifetime_gross int64
rank int64
studio object
title object
year int64
dtype: object
| lifetime_gross | rank | studio | title | year | |
|---|---|---|---|---|---|
| 0 | 936662225 | 1 | BV | Star Wars: The Force Awakens | 2015 |
| 1 | 760507625 | 2 | Fox | Avatar | 2009 |
| 2 | 681084109 | 3 | BV | Black Panther | 2018 |
| 3 | 659363944 | 4 | Par. | Titanic | 1997 |
| 4 | 652270625 | 5 | Uni. | Jurassic World | 2015 |
| 5 | 623357910 | 6 | BV | Marvel's The Avengers | 2012 |
| 6 | 620181382 | 7 | BV | Star Wars: The Last Jedi | 2017 |
| 7 | 534858444 | 8 | WB | The Dark Knight | 2008 |
| 8 | 532177324 | 9 | BV | Rogue One: A Star Wars Story | 2016 |
| 9 | 504014165 | 10 | BV | Beauty and the Beast (2017) | 2017 |
| 10 | 486295561 | 11 | BV | Finding Dory | 2016 |
| 11 | 474544677 | 12 | Fox | Star Wars: Episode I - The Phantom Menace | 1999 |
| 12 | 460998007 | 13 | Fox | Star Wars | 1977 |
| 13 | 459005868 | 14 | BV | Avengers: Age of Ultron | 2015 |
| 14 | 448139099 | 15 | WB | The Dark Knight Rises | 2012 |
La palabra “star” está entre las más frecuentes: aparece en cinco de las quince primeras películas, y la saga Star Wars incluye más títulos, varios de ellos también en el top.
Ahora vamos a usar el código que has desarrollado para ver cómo funciona con este conjunto de datos. No hay nada nuevo en el código siguiente: solo lo empaquetamos en una función:
 def word_frequency(text_list, num_list, sep=None):
    word_freq = defaultdict(lambda: [0, 0])

    for text, num in zip(text_list, num_list):
        for word in text.split(sep=sep):
            word_freq[word][0] += 1
            word_freq[word][1] += num

    columns = {0: 'abs_freq', 1: 'wtd_freq'}

    abs_wtd_df = (pd.DataFrame.from_dict(word_freq, orient='index')
                 .rename(columns=columns )
                 .sort_values('wtd_freq', ascending=False)
                 .assign(rel_value=lambda df: df['wtd_freq'] / df['abs_freq']).round())

    abs_wtd_df.insert(1, 'abs_perc', value=abs_wtd_df['abs_freq'] / abs_wtd_df['abs_freq'].sum())
    abs_wtd_df.insert(2, 'abs_perc_cum', abs_wtd_df['abs_perc'].cumsum())
    abs_wtd_df.insert(4, 'wtd_freq_perc', abs_wtd_df['wtd_freq'] / abs_wtd_df['wtd_freq'].sum())
    abs_wtd_df.insert(5, 'wtd_freq_perc_cum', abs_wtd_df['wtd_freq_perc'].cumsum())

    return abs_wtd_df
word_frequency(boxoffice_df['title'], boxoffice_df['lifetime_gross']).head()| abs_freq | abs_perc | abs_perc_cum | wtd_freq | wtd_freq_perc | wtd_freq_perc_cum | rel_value | |
|---|---|---|---|---|---|---|---|
| The | 3055 | 0.068747 | 0.068747 | 67518342498 | 0.081167 | 0.081167 | 22100930.0 |
| the | 1310 | 0.029479 | 0.098227 | 32973100860 | 0.039639 | 0.120806 | 25170306.0 |
| of | 1399 | 0.031482 | 0.129709 | 30180592467 | 0.036282 | 0.157087 | 21572975.0 |
| and | 545 | 0.012264 | 0.141973 | 12188113847 | 0.014652 | 0.171739 | 22363512.0 |
| 2 | 158 | 0.003556 | 0.145529 | 9032673058 | 0.010859 | 0.182598 | 57168817.0 |
Como era de esperar, las “stop words” dominan el ranking, algo común en la mayoría de colecciones de documentos. Además, aparecen duplicadas por mayúsculas y minúsculas. Hay dos cosas claras que resolver:
Aquí tienes una actualización simple de la función (nuevo parámetro rm_words, y líneas 6, 7 y 8):
# la lista de palabras se ampliará
def word_frequency(text_list, num_list, sep=None, rm_words=('the', 'and', 'a')):
    word_freq = defaultdict(lambda: [0, 0])

    for text, num in zip(text_list, num_list):
        for word in text.split(sep=sep):
            # Ignora la palabra si está en la lista de stop words
            if word.lower() in rm_words:
                continue
            # .lower() evita duplicar palabras
            word_freq[word.lower()][0] += 1
            word_freq[word.lower()][1] += num

    columns = {0: 'abs_freq', 1: 'wtd_freq'}

    abs_wtd_df = (pd.DataFrame.from_dict(word_freq, orient='index')
                 .rename(columns=columns )
                 .sort_values('wtd_freq', ascending=False)
                 .assign(rel_value=lambda df: df['wtd_freq'] / df['abs_freq']).round())

    abs_wtd_df.insert(1, 'abs_perc', value=abs_wtd_df['abs_freq'] / abs_wtd_df['abs_freq'].sum())
    abs_wtd_df.insert(2, 'abs_perc_cum', abs_wtd_df['abs_perc'].cumsum())
    abs_wtd_df.insert(4, 'wtd_freq_perc', abs_wtd_df['wtd_freq'] / abs_wtd_df['wtd_freq'].sum())
    abs_wtd_df.insert(5, 'wtd_freq_perc_cum', abs_wtd_df['wtd_freq_perc'].cumsum())

    abs_wtd_df = abs_wtd_df.reset_index().rename(columns={'index': 'word'})

    return abs_wtd_df
from collections import defaultdict
word_freq_df = word_frequency(boxoffice_df['title'],
boxoffice_df['lifetime_gross'],
rm_words=['of','in', 'to', 'and', 'a', 'the',
'for', 'on', '&', 'is', 'at', 'it',
'from', 'with'])
word_freq_df.head(15).style.bar(['abs_freq', 'wtd_freq', 'rel_value'],
color='#60DDFF') # E6E9EB| word | abs_freq | abs_perc | abs_perc_cum | wtd_freq | wtd_freq_perc | wtd_freq_perc_cum | rel_value | |
|---|---|---|---|---|---|---|---|---|
| 0 | 2 | 158 | 0.00443945 | 0.00443945 | 9032673058 | 0.0137634 | 0.0137634 | 5.71688e+07 |
| 1 | star | 45 | 0.0012644 | 0.00570385 | 5374658819 | 0.00818953 | 0.0219529 | 1.19437e+08 |
| 2 | man | 195 | 0.00547907 | 0.0111829 | 3967037854 | 0.0060447 | 0.0279976 | 2.03438e+07 |
| 3 | part | 41 | 0.00115201 | 0.0123349 | 3262579777 | 0.00497129 | 0.0329689 | 7.95751e+07 |
| 4 | movie | 117 | 0.00328744 | 0.0156224 | 3216050557 | 0.00490039 | 0.0378693 | 2.74876e+07 |
Veamos el mismo DataFrame ordenado por abs_freq:
(word_freq_df.sort_values('abs_freq', ascending=False)
 .head(15)
    .style.bar(['abs_freq', 'wtd_freq', 'rel_value'],
               color='#60DDFF'))
| word | abs_freq | abs_perc | abs_perc_cum | wtd_freq | wtd_freq_perc | wtd_freq_perc_cum | rel_value | |
|---|---|---|---|---|---|---|---|---|
| 26 | love | 211 | 0.00592863 | 0.069542 | 1604206885 | 0.00244438 | 0.111399 | 7.60288e+06 |
| 2 | man | 195 | 0.00547907 | 0.0111829 | 3967037854 | 0.0060447 | 0.0279976 | 2.03438e+07 |
| 24 | my | 191 | 0.00536668 | 0.0618994 | 1629540498 | 0.00248298 | 0.106478 | 8.53163e+06 |
Ahora vamos a visualizar para comparar ambas vistas y descubrir tendencias ocultas:
 import matplotlib.pyplot as plt
plt.figure(figsize=(20,8))
plt.subplot(1, 2, 1)

word_freq_df_abs = word_freq_df.sort_values('abs_freq', ascending=False).reset_index()

plt.barh(range(20),
         list(reversed(word_freq_df_abs['abs_freq'][:20])), color='#288FB7')
for i, word in enumerate(word_freq_df_abs['word'][:20]):
    plt.text(word_freq_df_abs['abs_freq'][i], 20-i-1,
             s=str(i+1) + '. ' + word + ': '  + str(word_freq_df_abs['abs_freq'][i]),
             ha='right', va='center', fontsize=14, color='white', fontweight='bold')
plt.text(0.4, -1.1, s='Número de veces que la palabra aparece en un título de película; de un total de 15500 películas.', fontsize=14)
plt.text(0.4, -1.8, s='Datos: boxofficemojo.com Abr. 2018.   Feedback: @eliasdabbas', fontsize=14)


plt.vlines(range(0, 210, 10), -1, 20, colors='gray', alpha=0.1)
plt.hlines(range(0, 20, 2), 0, 210, colors='gray', alpha=0.1)
plt.yticks([])
plt.xticks([])
plt.title('Palabras más usadas en títulos de películas', fontsize=22, fontweight='bold')

# =============
plt.subplot(1, 2, 2)
# plt.axis('off')
plt.barh(range(20),
         list(reversed(word_freq_df['wtd_freq'][:20])), color='#288FB7')
for i, word in enumerate(word_freq_df['word'][:20]):
    plt.text(word_freq_df['wtd_freq'][i], 20-i-1,
             s=str(i+1) + '. ' + word + ': ' + '$' + str(round(word_freq_df['wtd_freq'][i] / 1000_000_000, 2)) + 'b',
             ha='right', va='center', fontsize=14, color='white', fontweight='bold')
plt.text(0.4, -1.1, s='Recaudación histórica total de todas las películas cuyo título contiene la palabra. (La palabra superior es "2") ', fontsize=14)
plt.text(0.4, -1.8, s='Recogida de datos y metodología: http://bit.ly/word_freq', fontsize=14)

plt.vlines(range(0, 9_500_000_000, 500_000_000), -1, 20, colors='gray', alpha=0.1)
plt.hlines(range(0, 20, 2), 0, 10_000_000_000, colors='gray', alpha=0.1)
plt.xlim((-70_000_000, 9_500_000_000))
plt.yticks([])
plt.xticks([])
plt.title('Palabras más asociadas a la recaudación de taquilla', fontsize=22, fontweight='bold')
plt.tight_layout(pad=0.01)
plt.show()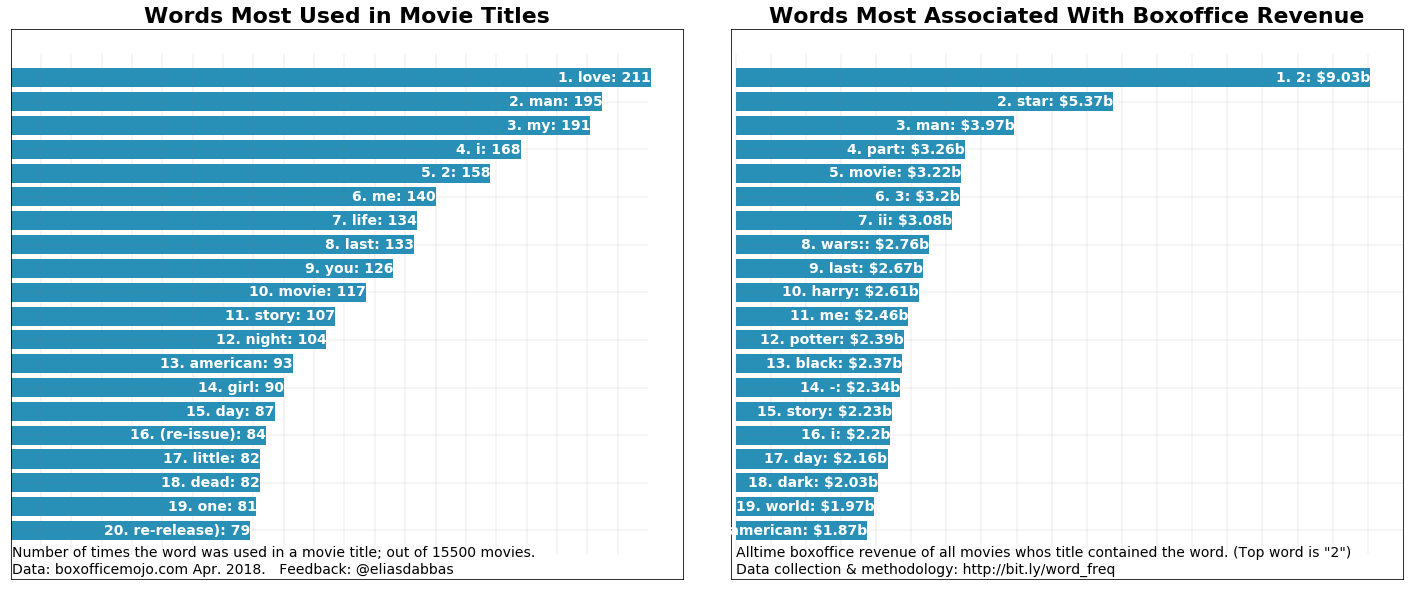
Parece que, al menos en la mente de productores y guionistas, ¡el amor todo lo puede! Es la palabra más utilizada en los títulos. Sin embargo, no está tan arriba si hablamos de frecuencia ponderada (recaudación).
En otras palabras, si miras todos los títulos, “love” es la palabra que más te encontrarás. Pero si estimas qué palabra “vieron” más los espectadores (usando la recaudación bruta como métrica), entonces “2”, “star” y “man” serían las más vistas, o las asociadas a mayor recaudación.
Para aclararlo: son cálculos muy simples. Que la frecuencia ponderada de “love” sea 1.604.106.767 significa simplemente que la suma de la recaudación histórica de todas las películas cuyo título incluye “love” es esa cantidad.
También es curioso que “2” lidere. Obviamente no es una palabra, pero indica que las segundas partes de las sagas suman muchísimo. Lo mismo con “3”, en quinta posición. Observa que “part” e “ii” también están en el top ten, reforzando la misma idea.
“American” y “movie” tienen un valor relativo alto.
Una nota rápida sobre las stop words usadas en esta función
Normalmente usarías una lista más completa de stop words que la de aquí, especialmente si trabajas con artículos o publicaciones en redes sociales. Por ejemplo, el paquete nltk ofrece listas de stop words en varios idiomas que puedes descargar y usar.
Las palabras aquí se eligieron tras revisar algunas de las películas top. Muchas suelen considerarse stop words, pero en títulos de películas tiene sentido mantener algunas porque pueden aportar información. Por ejemplo, “I”, “me”, “you” pueden sugerir dinámicas sociales. Además, los títulos son frases muy cortas e intentamos extraer el máximo sentido posible.
Prueba con tu propio conjunto de palabras y verás resultados algo distintos.
Si vuelves a la lista original de títulos, verás que algunas palabras destacadas ni siquiera aparecen en el top diez, y eso es justo el tipo de insight que buscamos con este enfoque.
boxoffice_df.head(10)
| lifetime_gross | rank | studio | title | year | |
|---|---|---|---|---|---|
| 0 | 936662225 | 1 | BV | Star Wars: The Force Awakens | 2015 |
| 1 | 760507625 | 2 | Fox | Avatar | 2009 |
| 2 | 681084109 | 3 | BV | Black Panther | 2018 |
| 3 | 659363944 | 4 | Par. | Titanic | 1997 |
| 4 | 652270625 | 5 | Uni. | Jurassic World | 2015 |
| 5 | 623357910 | 6 | BV | Marvel's The Avengers | 2012 |
| 6 | 620181382 | 7 | BV | Star Wars: The Last Jedi | 2017 |
| 7 | 534858444 | 8 | WB | The Dark Knight | 2008 |
| 8 | 532177324 | 9 | BV | Rogue One: A Star Wars Story | 2016 |
| 9 | 504014165 | 10 | BV | Beauty and the Beast (2017) | 2017 |
Después, tiene sentido explorar con más detalle las palabras más interesantes. Filtramos las películas que contienen “2”:
(boxoffice_df[boxoffice_df['title']
              .str
              .contains('2 | 2', case=False)] # espacios para excluir términos como '2010'
              .head(10))
| lifetime_gross | rank | studio | title | year | |
|---|---|---|---|---|---|
| 15 | 441226247 | 16 | DW | Shrek 2 | 2004 |
| 30 | 389813101 | 31 | BV | Guardians of the Galaxy Vol. 2 | 2017 |
| 31 | 381011219 | 32 | WB | Harry Potter and the Deathly Hallows Part 2 | 2011 |
| 35 | 373585825 | 36 | Sony | Spider-Man 2 | 2004 |
| 38 | 368061265 | 39 | Uni. | Despicable Me 2 | 2013 |
| 64 | 312433331 | 65 | Par. | Iron Man 2 | 2010 |
| 79 | 292324737 | 80 | LG/S | The Twilight Saga: Breaking Dawn Part 2 | 2012 |
| 87 | 281723902 | 88 | LGF | The Hunger Games: Mockingjay - Part 2 | 2015 |
| 117 | 245852179 | 118 | BV | Toy Story 2 | 1999 |
| 146 | 226164286 | 147 | NL | Rush Hour 2 | 2001 |
Echemos también un vistazo a las películas con “star”:
boxoffice_df[boxoffice_df['title'].str.contains('star | star', case=False)].head(10)
| lifetime_gross | rank | studio | title | year | |
|---|---|---|---|---|---|
| 0 | 936662225 | 1 | BV | Star Wars: The Force Awakens | 2015 |
| 6 | 620181382 | 7 | BV | Star Wars: The Last Jedi | 2017 |
| 8 | 532177324 | 9 | BV | Rogue One: A Star Wars Story | 2016 |
| 11 | 474544677 | 12 | Fox | Star Wars: Episode I - The Phantom Menace | 1999 |
| 12 | 460998007 | 13 | Fox | Star Wars | 1977 |
| 33 | 380270577 | 34 | Fox | Star Wars: Episode III - Revenge of the Sith | 2005 |
| 65 | 310676740 | 66 | Fox | Star Wars: Episode II - Attack of the Clones | 2002 |
| 105 | 257730019 | 106 | Par. | Star Trek | 2009 |
| 140 | 228778661 | 141 | Par. | Star Trek Into Darkness | 2013 |
| 301 | 158848340 | 302 | Par. | Star Trek Beyond | 2016 |
Y, por último, las películas con “man”:
boxoffice_df[boxoffice_df['title'].str.contains('man | man', case=False)].head(10)
| lifetime_gross | rank | studio | title | year | |
|---|---|---|---|---|---|
| 18 | 423315812 | 19 | BV | Pirates of the Caribbean: Dead Man's Chest | 2006 |
| 22 | 409013994 | 23 | BV | Iron Man 3 | 2013 |
| 35 | 373585825 | 36 | Sony | Spider-Man 2 | 2004 |
| 48 | 336530303 | 49 | Sony | Spider-Man 3 | 2007 |
| 53 | 330360194 | 54 | WB | Batman v Superman: Dawn of Justice | 2016 |
| 59 | 318412101 | 60 | Par. | Iron Man | 2008 |
| 64 | 312433331 | 65 | Par. | Iron Man 2 | 2010 |
| 82 | 291045518 | 83 | WB | Man of Steel | 2013 |
| 176 | 206852432 | 177 | WB | Batman Begins | 2005 |
| 182 | 202853933 | 183 | Sony | The Amazing Spider-Man 2 | 2014 |
Como primer paso, podrías intentar obtener más palabras: los títulos de películas son muy cortos y a menudo no transmiten el significado literal. Por ejemplo, un “padrino” debería ser quien presencia el bautizo de un niño y promete cuidarlo (¿o quizá un mafioso que mata por placer?).
Un ejercicio adicional sería obtener descripciones más detalladas, además del título. Por ejemplo:
"A computer hacker learns from mysterious rebels about the true nature of his reality and his role in the war against its controllers."
nos cuenta mucho más de la película que “The Matrix”.
Alternativamente, también puedes seguir alguno de estos caminos para enriquecer el análisis:
Quizá te interese explorar tú mismo estos datos y otros:
Ya has explorado los conteos de palabras en títulos de películas y visto la diferencia entre frecuencias absoluta y ponderada, y cómo omitir una puede dejar fuera parte importante de la foto. También has visto las limitaciones de este enfoque y algunas ideas para mejorar el análisis.
Has creado una función específica que puedes ejecutar fácilmente para analizar cualquier conjunto de datos de texto con números y entender mejor este tipo de datos.
Pruébalo con el rendimiento de tus tuits, las URLs de tu web, tus publicaciones en Facebook o cualquier conjunto de datos similar que encuentres.
Quizá te resulte más cómodo clonar el repositorio con el código y probarlo tú mismo.
La función word_frequency forma parte del paquete advertools, que puedes descargar y usar en tu trabajo o investigación.
Échale un vistazo y cuéntame qué tal: @eliasdabbas
Echa un ojo al tutorial de diccionarios en Python de DataCamp para aprender a crear frecuencias de palabras, y al tutorial de web scraping y PLN en Python para aprender a representar distribuciones de frecuencias.
Aprende más sobre Python
Curso
Curso
Curso
Tutorial
Duong Vu
11 min
Tutorial
Moez Ali
14 min
Tutorial
Kurtis Pykes
11 min
Tutorial
Kurtis Pykes
12 min
Tutorial
Kurtis Pykes
8 min
Tutorial
Karlijn Willems
15 min



