
Programma
Ingegnere dei dati in Python
40 ore
I binary search tree (BST) sono un tipo di albero binario struttura dati che organizza i dati seguendo un ordinamento specifico. Ogni nodo contiene un valore e ha collegamenti fino a due altri nodi: i figli sinistro e destro. In un BST, la regola è che il valore del figlio sinistro deve essere minore del valore del nodo genitore e il valore del figlio destro deve essere maggiore.
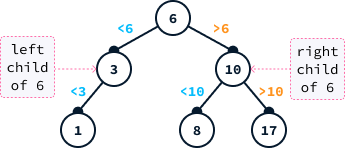
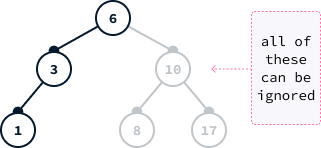
I BST possono essere molto efficienti nel trovare valori specifici perché permettono di eliminare grandi porzioni dell'albero durante la ricerca. Per esempio, se stiamo cercando il valore uno nell'albero sopra, possiamo ignorare tutti i nodi alla destra di sei. Questo perché la proprietà d'ordine garantisce che tutti quei valori siano maggiori di sei.
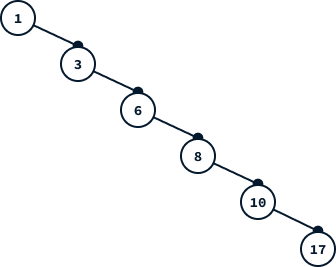
Idealmente, ogni nodo dovrebbe dividere i dati a metà, così da eliminare metà dei valori a ogni passo verso il basso nell'albero. Questo porta a ricerche estremamente rapide. Tuttavia, a seconda dell'ordine di inserimento, si può ottenere un albero sbilanciato che non divide efficacemente i dati. Ad esempio, inserire valori dal più piccolo al più grande produce un albero lineare, che non è migliore di una lista.
Un albero AVL è un albero binario di ricerca con la seguente proprietà aggiuntiva:
Per ogni nodo, l'altezza dei sottoalberi sinistro e destro differisce al massimo di uno.
Scomponendo questa definizione, il sottoalbero sinistro di un nodo include tutti i nodi alla sua sinistra, mentre il sottoalbero destro comprende tutti i nodi alla sua destra. L'altezza di un albero è definita come la lunghezza del percorso più lungo dal nodo radice (il nodo più in alto) a una qualsiasi delle sue foglie discendenti (nodi senza figli).
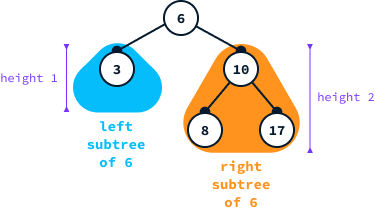
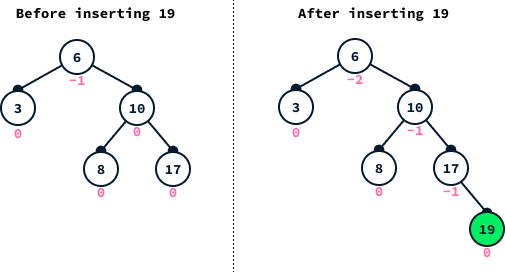
Il fattore di bilanciamento di un nodo si calcola come la differenza di altezza tra il suo sottoalbero sinistro e quello destro:
balance(N) = height(sottoalbero sinistro di N) - height(sottoalbero destro di N)
Per esempio, balance(6) = 1 - 3 = -2.
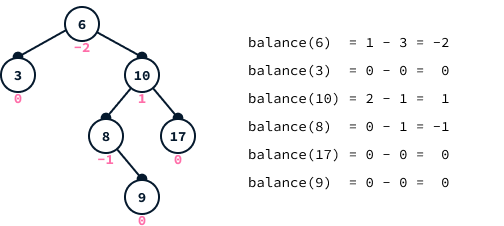
Nel diagramma, il nodo 6 presenta un fattore di bilanciamento pari a -2, indicando che l'albero non soddisfa i criteri di un albero AVL. Perché un albero sia classificato come AVL, il fattore di bilanciamento di ogni nodo deve essere -1, 0 o 1.
L'efficienza delle query in un albero binario di ricerca dipende dall'altezza dell'albero. Nel caso peggiore, il numero di nodi da esaminare è pari all'altezza dell'albero. Un problema chiave dei BST è che l'altezza può eguagliare il numero di nodi, il che significa che una query potrebbe richiedere l'ispezione di ogni singolo nodo.
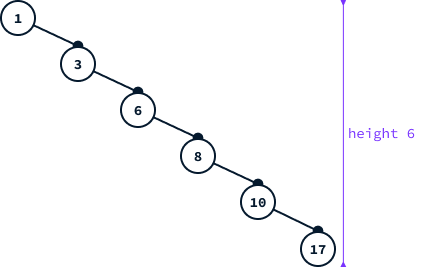
Sia M(h) il numero minimo di nodi da aggiungere a un albero binario di ricerca per raggiungere un'altezza h. Per i BST semplici, si osserva che M(h) = h, ossia si può ottenere un'altezza h con soli h nodi. Questo implica che l'altezza di un BST può crescere linearmente con il numero di nodi, portando a un tempo di query proporzionale alla dimensione del dataset.
Consideriamo il numero minimo di nodi, M(h), richiesto per creare un albero AVL con altezza h. Poiché si tratta di un albero AVL, è importante notare che il fattore di bilanciamento di ogni nodo può essere solo -1, 0 o 1.
Tuttavia, dato che stiamo assumendo che l'albero abbia il minor numero possibile di nodi per raggiungere un'altezza h, la radice non può avere un bilanciamento pari a 0. Se lo avesse, potremmo rimuovere un nodo dal lato sinistro o destro per ottenere un bilanciamento di -1 o 1, ottenendo comunque un albero AVL valido.
Supponiamo che il bilanciamento della radice sia 1 (il ragionamento sarebbe lo stesso se fosse -1). Ciò implica che l'albero sia strutturato come segue:
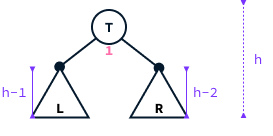
D'altra parte, sia il sottoalbero sinistro che quello destro devono essere a loro volta alberi AVL, ciascuno con il numero minimo di nodi richiesto per le rispettive altezze (altrimenti sarebbe possibile rimuovere ulteriori nodi). Il numero totale di nodi nell'albero è pari a 1 (per la radice) più il numero di nodi nel sottoalbero sinistro più quelli nel sottoalbero destro.
M(h) = 1 + (nodi in L) + (nodi in R) = 1 + M(h - 1) + M(h - 2)
All'aumentare dell'altezza, servono più nodi per raggiungerla. Quindi:
M(h - 1) > M(h - 2)
Combinando le due cose, possiamo dire che:
M(h) = 1 + M(h - 1) + M(h - 2) > 1 + 2 × M(h - 2) > 2 × M(h - 2)
Possiamo applicarlo h/2 volte finché non arriviamo a M(1) = 1 o M(2) = 2:
M(h) > 2 × M(h - 2) > 2 × 2 × M(h - 4) > 2 × 2 × 2 × M(h - 6) > … > 2(h/2)
Per chiarezza, l'immagine seguente mostra esempi specifici per h = 7 e h = 6:
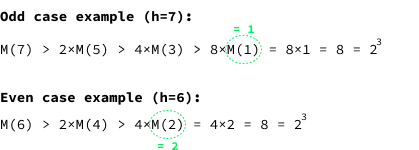
Concludiamo che il numero minimo di nodi in un albero AVL di altezza h è almeno 2(h/2):
M(h) > 2(h/2)
Applicando il logaritmo in base due a entrambi i lati, otteniamo:
log2(M(h)) > log2(2(h/2)) = h/2
Di conseguenza, moltiplicando entrambi i lati per due, deduciamo che l'altezza è al massimo il doppio del logaritmo in base 2 del numero di nodi:
2 × log2(M(h)) > h
Abbiamo dimostrato che:
L'altezza di un albero AVL contenente N nodi è al massimo 2 × log2(N).
Questo indica che le query in un albero AVL richiedono di esaminare solo una piccola porzione del dataset. Per esempio, dato un miliardo di voci, il logaritmo è circa 30, il che significa che, anche con un miliardo di punti dati, è necessario ispezionare solo circa 60 punti per trovare una voce specifica. Si tratta di un miglioramento significativo rispetto ai BST che, nel caso peggiore, richiederebbero l'ispezione di tutte le voci.
Per approfondire la complessità temporale degli algoritmi e la differenza tra complessità lineare e logaritmica, consulta questo articolo su notazione Big-O e complessità temporale.
Gli alberi AVL garantiscono query veloci imponendo che il bilanciamento di ogni nodo sia -1, 0 o 1. Per assicurare che il bilanciamento di ciascun nodo venga mantenuto, è necessario riequilibrare l'albero dopo l'inserimento di un nuovo valore.
L'inserimento nei binary search tree avviene seguendo il percorso dalla radice verso il basso. Si va a sinistra quando il valore da inserire è più piccolo, altrimenti a destra.
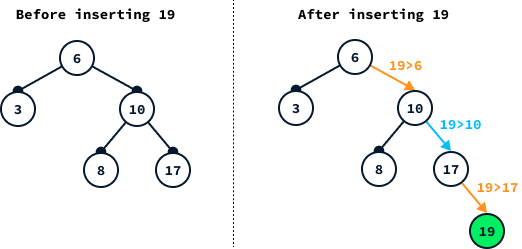
Un inserimento aumenta l'altezza al massimo di uno. Quindi, se dopo l'inserimento la proprietà di bilanciamento non è rispettata, significa che c'era un nodo con bilanciamento -1 che ora è -2, oppure un nodo con bilanciamento 1 che ora è 2. Il primo caso è ciò che avviene nell'esempio sopra.
Per ripristinare l'equilibrio, ci affidiamo alle rotazioni dell'albero. Una rotazione a sinistra sul nodo A ristruttura l'albero ruotando A verso sinistra, come mostrato di seguito:
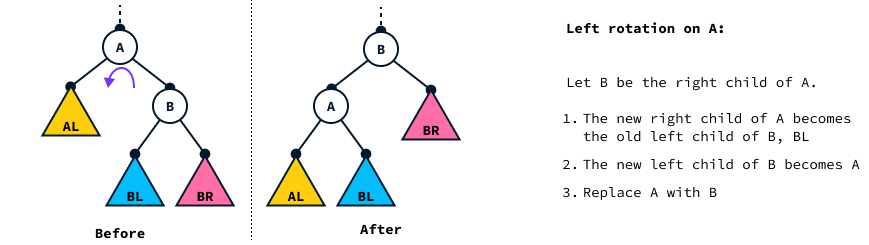
Nel diagramma:
BL rappresenta il sottoalbero sinistro di BBR è il sottoalbero destroAL è il sottoalbero sinistro di ANota che dopo la rotazione, l'ordinamento dei nodi resta valido:
A è minore di B perché B era il suo figlio destro.BL sono maggiori di A perché erano alla destra di A.AL sono minori di B perché sono minori di A.Una rotazione a destra funziona in modo simmetrico ruotando A verso destra.
Vediamo un esempio concreto correggendo lo sbilanciamento dell'albero dopo aver inserito 19 con una rotazione a sinistra sul nodo 6.
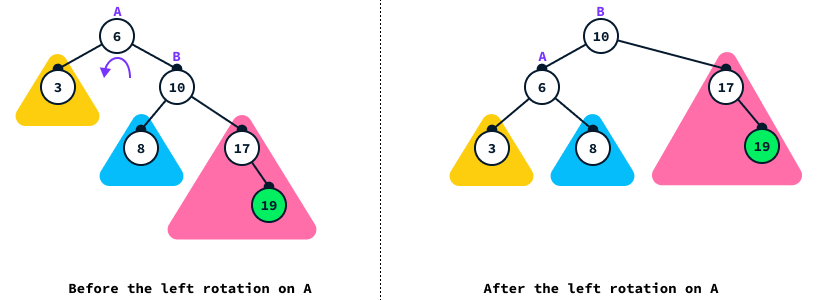
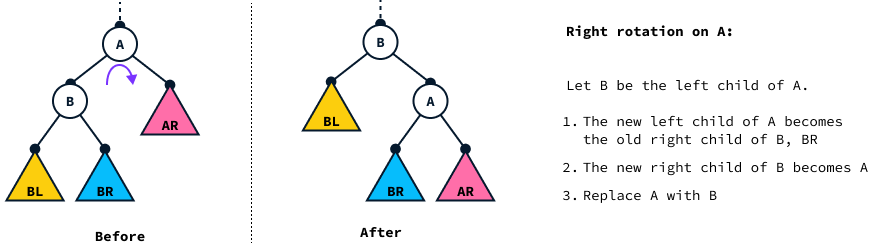
Dopo l'inserimento, correggiamo lo sbilanciamento ruotando un nodo con bilanciamento -2 o 2. In questo caso, il fattore di bilanciamento del nodo 6 era -2, il che significa che l'albero pendeva a destra, quindi abbiamo applicato una rotazione a sinistra (nella direzione opposta allo sbilanciamento). Se invece il bilanciamento è pari a 2, si usa una rotazione a destra.
Nel caso precedente, l'albero pendeva completamente a destra, quindi è bastata una singola rotazione a sinistra per ripristinare l'equilibrio. In alcuni casi, però, abbiamo uno sbilanciamento a zig-zag in cui l'albero pende da un lato, ma il sottoalbero pende dal lato opposto. Per vederlo, torniamo all'albero originale prima di inserire 19 e inseriamo invece 7:
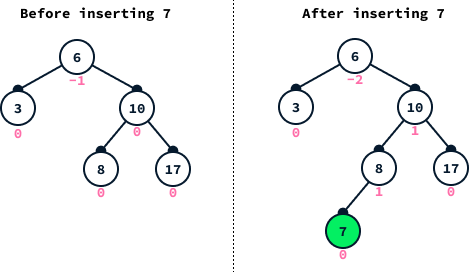
In questo caso, l'albero pende ancora a destra, ma il sottoalbero con radice in 10 pende a sinistra. Qui dobbiamo prima ruotare il nodo 10 a destra:
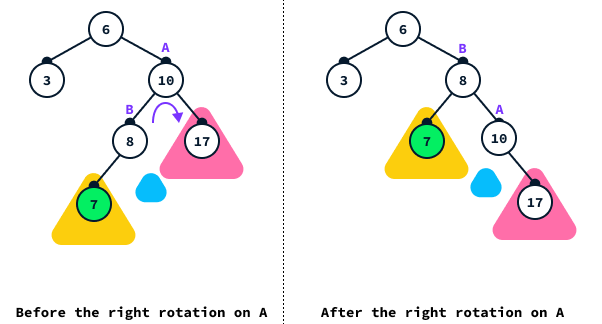
Nota che il nodo B non ha il figlio destro. Lo mostriamo comunque in blu nel diagramma per facilitare la visualizzazione.
Dopo aver eseguito la rotazione a destra, torniamo al caso precedente in cui una rotazione a sinistra su 6 ripristina l'equilibrio:
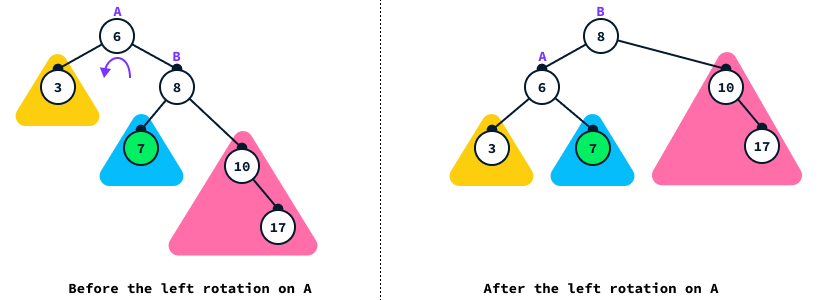
Iniziamo dall'implementazione del nodo.
Ogni nodo dell'albero ha cinque attributi:
self.value)self.parent)self.left)self.right)self.height)class Node:
def __init__(self, value, parent = None):
self.value = value
self.parent = parent
self.left = None
self.right = None
self.height = 1Usiamo il valore None per rappresentare i nodi mancanti. L'height di default è impostata a 1 perché un albero composto da un solo nodo ha altezza 1.
Per facilitare l'implementazione dell'albero, aggiungiamo alcuni metodi alla classe Node.
# Inside the Node class
  def left_height(self):
    # Get the heigth of the left subtree
    return 0 if self.left is None else self.left.height

  def right_height(self):
    # Get the height of the right subtree
    return 0 if self.right is None else self.right.height
  def balance_factor(self):
    # Get the balance factor
    return self.left_height() - self.right_height()
  def update_heigth(self):
    # Update the heigth of this node
    self.height = 1 + max(self.left_height(),self.right_height())

  def set_left(self, node):
    # Set the left child
    self.left = node
    if node is not None:
      node.parent = self
    self.update_heigth()

  def set_right(self, node):
    # Set the right child
    self.right = node
    if node is not None:
      node.parent = self
    self.update_heigth()
  def is_left_child(self):
    # Check whether this node is a left child
    return self.parent is not None and self.parent.left == self

  def is_right_child(self):
    # Check whether this node is a right child
    return self.parent is not None and self.parent.right == self
Nota che utilizziamo i metodi .set_left() e .set_right() per assegnare rispettivamente i figli sinistro e destro. La ragione per usare questi metodi, anziché modificare direttamente gli attributi self.left e self.right, è che quando si cambia un figlio, è necessario aggiornare anche il genitore del nuovo figlio e l'altezza del nodo.
L'albero AVL mantiene un parametro, la radice dell'albero, che è il nodo più in alto.
class AVLTree:
  def __init__(self):
    self.root = None
Per mantenere il bilanciamento dell'albero, dobbiamo implementare le rotazioni a sinistra e a destra. Rivediamo come una rotazione a sinistra è rappresentata nel diagramma:
# Inside the AVLTree class

  def rotate_left(self, a):
    b = a.right
    # 1. The new right child of A becomes the left child of B
    a.set_right(b.left)
    # 2. The new left child of B becomes A
    b.set_left(a)
    return b # 3. Return B to replace A with it
Le rotazioni a destra sono implementate in modo simmetrico:
# Inside the AVLTree class

  def rotate_right(self, a):
    b = a.left
    a.set_left(b.right)
    b.set_right(a)
    return b
Usando le rotazioni, possiamo riequilibrare l'albero. Un nodo richiede riequilibrio quando il suo fattore di bilanciamento raggiunge 2 (indicando che l'albero pende a sinistra) o -2 (indicando che l'albero pende a destra). In generale, ci sono quattro scenari da considerare:
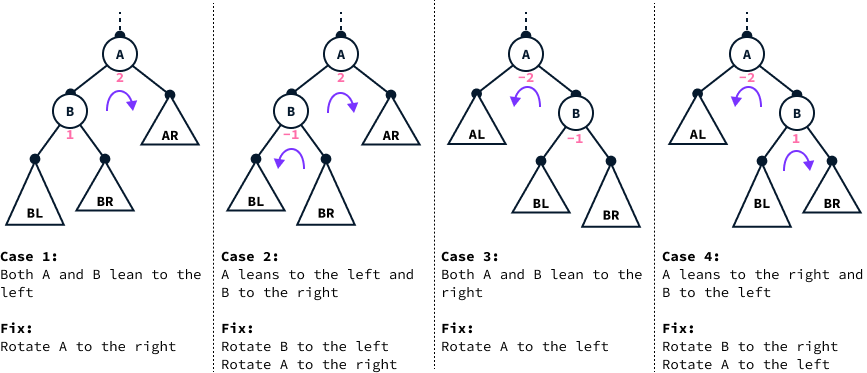
Implementiamo questi quattro casi nel metodo .rebalance().
# Inside the AVLTree class

  def rebalance(self, node):
    if node is None:
      # Empty tree, no rebalancing needed
      return None
    balance = node.balance_factor()
    if abs(balance) <= 1:
      # The node is already balanced, no rebalancing needed
      return node
    if balance == 2:
      # Cases 1 and 2, the tree is leaning to the left
      if node.left.balance_factor() == -1:
        # Case 2, we first do a left rotation
        node.set_left(self.rotate_left(node.left))
      return self.rotate_right(node)
    # Balance must be -2
    # Cases 3 and 4, the tree is leaning to the left
    if node.right.balance_factor() == 1:
      # Case 4, we first do a right rotation
      node.set_right(self.rotate_right(node.right))
    return self.rotate_left(node)
Nota che in ogni caso il metodo restituisce la radice del sottoalbero appena bilanciato. Questa nuova radice del sottoalbero verrà usata successivamente per aggiornare i figli durante il processo di riequilibrio.
Aggiungere un nodo a un albero AVL è simile al processo in un BST normale, con l'aggiunta del ripristino dell'equilibrio dopo l'inserimento. Per aggiungere un nodo in un BST, si parte dalla radice e si scende nell'albero. A ogni passo confrontiamo il valore da aggiungere con il valore del nodo corrente. Se il valore è più piccolo, andiamo a sinistra; altrimenti, a destra. Durante la discesa teniamo traccia del nodo genitore per poter inserire il nuovo nodo come suo figlio.
Quando raggiungiamo un nodo vuoto, ci sono due casi:
# Inside the AVLTree class
  def add(self, value):
    self.size += 1
    parent = None
    current = self.root
    while current is not None:
      parent = current
      if value < current.value:
        # Value to insert is smaller than node value, go left
        current = current.left
      else:
        # Value to insert is larger than node value, go right
        current = current.right
    # We found the parent, create the new node
    new_node = Node(value, parent)
    # Case 1: The parent is None so the new node is the root
    if parent is None:
      self.root = new_node
    else:
      # Case 2: Set the new node as a child of the parent
      if value < parent.value:
        parent.left = new_node
      else:
        parent.right = new_node
    # After a new node is added, we need to restore balance
    self.restore_balance(new_node)
L'unica differenza tra il metodo .add() di un BST e quello di un albero AVL sta nel passaggio finale. Questo consiste nel risalire l'albero e riequilibrare i nodi, a partire dal nodo appena aggiunto fino alla radice, riequilibrando ciascun nodo tramite il metodo .rebalance().
# Inside the AVLTree class
  def restore_balance(self, node):
    current = node
    # Go up the tree and rebalance left and right children
    while current is not None:
      current.set_left(self.rebalance(current.left))
      current.set_right(self.rebalance(current.right))
      current.update_heigth()
      current = current.parent
    self.root = self.rebalance(self.root)
    self.root.parent = None
Nota che il metodo .rebalance() non fa nulla quando il nodo è già bilanciato: restituisce semplicemente lo stesso nodo. Per questo, mentre risaliamo l'albero, possiamo chiamarlo su entrambi i lati, anche se solo uno dei due può essere sbilanciato. L'altra chiamata lascia l'albero invariato.
Ricorda che abbiamo implementato il metodo .rebalance() in modo che restituisca la (potenziale) nuova radice del sottoalbero. Il motivo è poter aggiornare i figli sinistro e destro dei nodi correnti mentre risaliamo ripristinando l'equilibrio.
Il diagramma seguente mostra i passaggi di .restore_balance() mentre si risale l'albero.
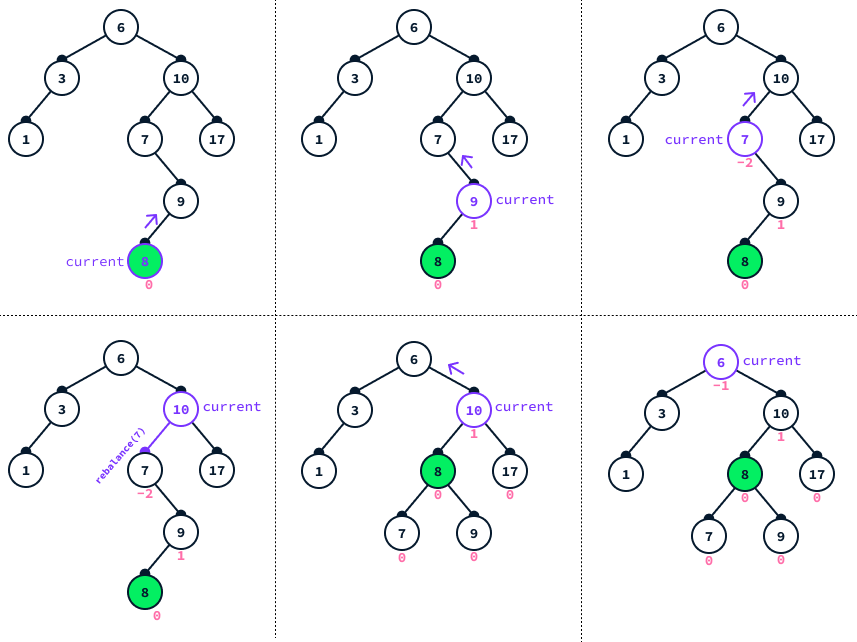
Nell'esempio dato, prima aggiungiamo il nodo 8. Poi il processo di ripristino dell'equilibrio inizia da questo nodo e risale l'albero, controllando e riequilibrando i figli sinistro e destro di ogni nodo incontrato. Questo continua fino a raggiungere il nodo 10. Fino a questo punto, nessuna delle invocazioni del metodo .rebalance() ha effetto, poiché i nodi restano bilanciati.
Tuttavia, raggiunto il nodo 10, si osserva che il suo figlio sinistro, il nodo 7, ha un fattore di bilanciamento pari a -2, indicando la necessità di un riequilibrio. Di conseguenza, viene chiamato .rebalance(7), che porta alla sostituzione del figlio sinistro di 10 con la nuova radice del sottoalbero sinistro, il nodo 8, ripristinando di fatto l'equilibrio dell'albero.
Oltre ad aggiungere e eliminare elementi mantenendo il bilanciamento, gli alberi AVL supportano diverse altre operazioni essenziali.
Grazie alla natura ordinata dei BST, il valore minimo si trova nel nodo più a sinistra dell'albero, mentre il valore massimo si trova nel nodo più a destra.
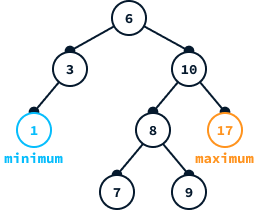
Abbiamo implementato due funzioni di supporto che individuano i nodi più a sinistra e più a destra a partire da un dato nodo. Queste funzioni sono utili per facilitare l'implementazione dell'eliminazione dei nodi.
# Inside the AVLTree class

  def leftmost(self, starting_node):
    # Find the leftmost node from a given starting node
    previous = None
    current = starting_node
    while current is not None:
      previous = current
      current = current.left
    return previous
  def minimum(self):
    # Return the minimum value in the tree
    if self.root is None:
      raise Exception("Empty tree")
    return self.leftmost(self.root).value
# Inside the AVLTree class
def rightmost(self, starting_node):
# Find the rightmost node from a given starting node
previous = None
current = starting_node
while current is not None:
previous = current
current = current.right
return previous
def maximum(self):
# Fidn the maximum value in the tree
if self.root is None:
raise Exception("Empty tree")
return self.rightmost(self.root).valuePer stabilire se un albero contiene un valore specifico, sfruttiamo la proprietà d'ordine dell'albero per guidare la ricerca. Partendo dalla radice, ci spostiamo a sinistra se il valore cercato è minore del nodo corrente e a destra se è maggiore. Se arriviamo alla fine dell'albero senza trovare il valore, significa che non è presente.
Per facilitare questo processo, implementiamo un metodo di supporto chiamato .locate_node(). Questo metodo è particolarmente utile non solo per la ricerca, ma anche per operazioni come l'eliminazione di valori dall'albero. Inoltre, usiamo il metodo .__contains__(), che ci consente di utilizzare l'operatore in per semplificare il controllo della presenza di un valore nell'albero.
# Inside the AVLTree class

  def locate_node(self, value):

    # Returns the node containing a given value or None if no

    # such node exists

    current = self.root

    while current is not None:

      if value == current.value:

        return current

      if value < current.value:

        current = current.left

      else:

        current = current.right

    return None

  def __contains__(self, value):

    node = self.locate_node(value)

return node is not NoneEliminare un nodo in un albero AVL può essere particolarmente impegnativo quando il nodo si trova nel mezzo dell'albero. Se il nodo è una foglia, cioè non ha figli, possiamo eliminarlo facilmente impostando a None il puntatore al figlio sinistro o destro del suo genitore in base a se il nodo è un figlio sinistro o destro.
Un caso speciale si presenta quando il nodo da eliminare è la radice dell'albero. In questo scenario, possiamo rimuovere il nodo impostando la radice a None.
# Inside the AVLTree class

  def delete_leaf(self, node):

    if node.parent is None:

      self.root = None

    elif node.is_left_child():

      node.parent.left = None

      node.parent = None

    else:

      node.parent.right = None

      node.parent = None
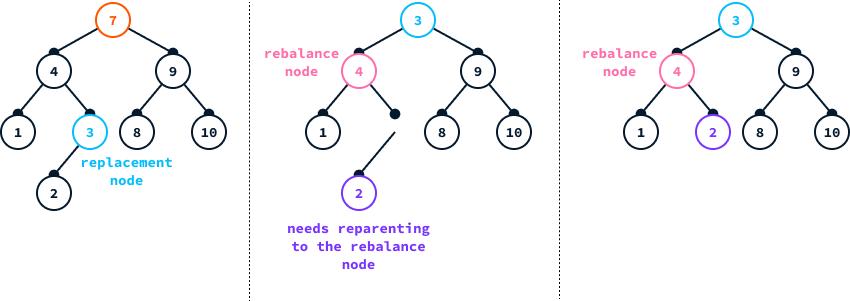
Per eliminare un valore da un albero AVL, dobbiamo prima individuare il nodo che lo contiene usando il metodo .locate_node(). Una volta localizzato il nodo, possiamo rimuoverlo con il metodo .delete_leaf() se è un nodo foglia. Se non è una foglia, la rimozione diretta comprometterebbe la struttura dell'albero. Per ovviare, troviamo un nodo sostitutivo. Se il nodo da eliminare ha un figlio sinistro, selezioniamo il nodo più a destra nel suo sottoalbero sinistro. Questo approccio mantiene la struttura ordinata dell'albero.
Il diagramma seguente esemplifica la rimozione del nodo 10 da un albero. Poiché ha un figlio sinistro, lo sostituiamo con il nodo più a destra del sottoalbero sinistro. Dopo la sostituzione, è fondamentale riequilibrare l'albero, a partire dal genitore del nodo appena sostituito.
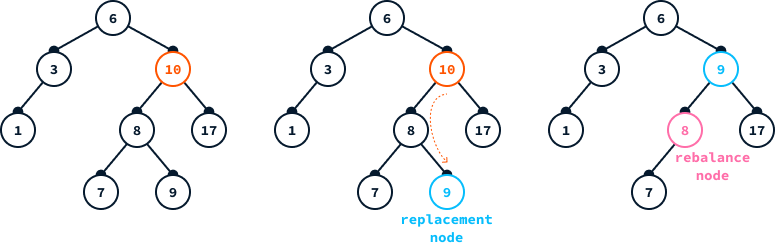
In questo esempio, il nodo sostitutivo è un nodo foglia. Tuttavia, se il nodo sostitutivo ha dei figli, è necessario riassegnarli al genitore del nodo sostitutivo. Poiché il nodo sostitutivo è un nodo estremo (il più a sinistra o il più a destra), può avere al massimo un figlio. Pertanto, questa riassegnazione è sempre fattibile.
# Inside the AVLTree class

  def delete(self, value):

    # Delete a value from the tree

    node = self.locate_node(value)

    if node is None:

      raise Exception("Value not stored in tree")

    replacement = None

    rebalance_node = node.parent

    if node.left is not None:

      # There's a left child so we replace with rightmost node

      replacement = self.rightmost(node.left)

      # Check if reparenting is needed

      if replacement.is_left_child():

        replacement.parent.set_left(replacement.left)

      else:

        replacement.parent.set_right(replacement.left)

    elif node.right is not None:

      # There's a right child so we replace with the leftmost node

      replacement = self.leftmost(node.right)

      # Check if reparenting is needed

      if replacement.is_left_child():

        replacement.parent.set_left(replacement.right)

      else:

        replacement.parent.set_right(replacement.right)

    if replacement:

      # We found a replacement so replace the value

      node.value = replacement.value

      rebalance_node = replacement.parent

    else:

      # No replacement so it means the node to delete is a leaf

      self.delete_leaf(node)

    if rebalance_node is not None:

self.restore_balance(rebalance_node)Le range query consistono nell'individuare tutti i valori compresi tra due valori specificati. Grazie alla natura ordinata degli alberi AVL, possiamo trovare questi valori in modo efficiente.
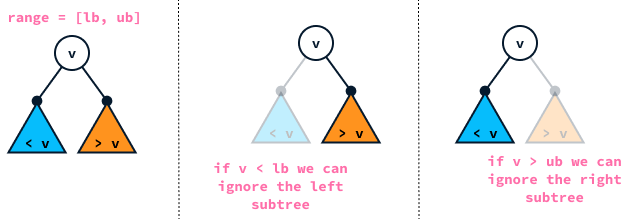
Per trovare tutti i valori compresi tra il limite inferiore lb e il limite superiore ub, usiamo un approccio ricorsivo per esplorare l'albero. Per ogni nodo incontrato, se il suo valore rientra nell'intervallo, lo includiamo nei risultati. Successivamente, esploriamo sia il sottoalbero sinistro sia quello destro per proseguire la ricerca.
Ignoriamo il sottoalbero sinistro se il valore del nodo è minore del limite inferiore, perché tutti i valori nel sottoalbero sinistro sono inferiori al valore del nodo. Analogamente, ignoriamo il sottoalbero destro se il valore del nodo è maggiore del limite superiore, poiché tutti i valori nel sottoalbero destro saranno maggiori del valore del nodo.
  def search(self, node, lb, ub, results):

    # Search for values between lower bound and upper bound

    if node is None:

      return

    if lb <= node.value and node.value <= ub:

      results.append(node.value)

    if node.value >= lb:

      self.search(node.left, lb, ub, results)

    if node.value <= ub:

      self.search(node.right, lb, ub, results)

  def range_query(self, lb, ub):

    # Search for values between lower bound and upper bound

    results = []

    self.search(self.root, lb, ub, results)

return resultsAbbiamo implementato un albero AVL in grado di eseguire le seguenti operazioni:
Il pacchetto avltree package offre un'implementazione in Python che riflette queste funzionalità.
Altri alberi binari di ricerca auto-bilancianti, come gli alberi rosso-neri, gli alberi splay e i B-tree, offrono funzionalità simili. In generale, le loro prestazioni sono paragonabili nella maggior parte delle applicazioni, poiché tutti mantengono un'altezza garantita logaritmica. Tuttavia, gli alberi AVL sono più finemente bilanciati, ottimizzando le operazioni di ricerca a costo di inserimenti potenzialmente più lenti a causa di requisiti di riequilibrio più rigorosi.
Gli alberi splay sono particolarmente efficaci in scenari in cui gli elementi recentemente accessi vengono riutilizzati frequentemente, rendendoli un'ottima scelta per implementazioni di cache.
I B-tree sono progettati in modo specifico per operare in modo efficiente su disco piuttosto che in memoria, risultando preziosi nella gestione di grandi insiemi di dati che superano la capacità della memoria, come nella creazione di indici di database.
Ci sono diversi modi in cui la nostra implementazione può essere migliorata. Ecco alcuni suggerimenti per esercizi per approfondire la comprensione degli alberi AVL:
I BST sono un tipo di struttura dati ad albero binario che organizza i dati seguendo un ordine specifico. Questa organizzazione permette di evitare di ispezionare l'intero dataset quando si cercano valori specifici. Tuttavia, i BST possono diventare sbilanciati, con un deterioramento delle prestazioni che, in alcuni scenari, può richiedere l'ispezione dell'intero dataset.
Gli alberi AVL risolvono questo problema imponendo proprietà di bilanciamento aggiuntive tramite rotazioni. Queste proprietà assicurano che l'altezza dell'albero rimanga logaritmica rispetto alla dimensione del dataset, offrendo un miglioramento significativo.
La complessità temporale logaritmica è un notevole passo avanti rispetto a quella lineare, rendendo gli alberi AVL estremamente efficienti per la risoluzione delle query. Anche con dataset di miliardi di voci, gli alberi AVL richiedono l'ispezione di pochi punti dati per trovare un elemento, risultando notevolmente più efficienti.
Impara data engineering con questi corsi!
Programma
Programma
Corso
blog
Tim Lu
12 min
blog
Abid Ali Awan
15 min
blog
Abid Ali Awan
10 min



