
लर्निंग पाथ
डेटा इंजीनियर में Python
40 घंटा
बाइनरी सर्च ट्री (BST) एक प्रकार का बाइनरी ट्री डेटा स्ट्रक्चर हैं जो एक विशिष्ट क्रम का उपयोग करके डेटा व्यवस्थित करते हैं। प्रत्येक नोड में एक मान होता है और अधिकतम दो अन्य नोड्स से जुड़ा होता है: बायाँ और दायाँ बच्चों से। BST में नियम यह है कि बाएँ बच्चे का मान उसके पैरेंट के मान से छोटा और दाएँ बच्चे का मान बड़ा होना चाहिए।
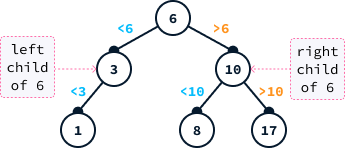
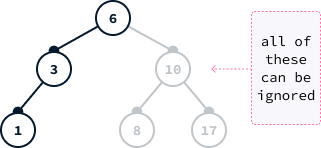
BST विशिष्ट मान ढूँढ़ने में बेहद कुशल हो सकते हैं क्योंकि यह खोज के दौरान ट्री के बड़े हिस्सों को हटाने की अनुमति देते हैं। उदाहरण के लिए, यदि हम ऊपर दिए ट्री में मान एक खोज रहे हैं, तो हम छह के दाएँ वाले सभी नोड्स को नज़रअंदाज़ कर सकते हैं। इसका कारण यह है कि क्रम गुण यह सुनिश्चित करता है कि वे सभी मान छह से बड़े हैं।
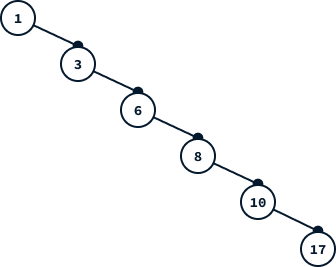
आदर्श रूप से, प्रत्येक नोड डेटा को आधा-आधा विभाजित करे, ताकि ट्री में हर कदम पर आधे मान हट जाएँ। इससे लुकअप्स अत्यधिक तेज़ होते हैं। लेकिन, इन्सर्शन के क्रम पर निर्भर करते हुए, ट्री असंतुलित हो सकता है और डेटा प्रभावी ढंग से विभाजित नहीं होता। उदाहरण के लिए, सबसे छोटे से सबसे बड़े मान डालने पर एक रैखिक (लीनियर) ट्री बनता है, जो सूची से बेहतर प्रदर्शन नहीं करता।
AVL ट्री एक बाइनरी सर्च ट्री है, जिसमें यह अतिरिक्त गुण होता है:
हर नोड के लिए, बाएँ और दाएँ उप-वृक्षों की ऊँचाई में अधिकतम एक का अंतर हो।
इस परिभाषा को तोड़कर देखें तो किसी नोड का बायाँ उप-वृक्ष उसके बाएँ के सभी नोड्स को शामिल करता है, जबकि दायाँ उप-वृक्ष उसके दाएँ के सभी नोड्स को। ट्री की ऊँचाई को जड़ (सबसे ऊपर का नोड) से लेकर उसके किसी भी पत्ते (जिसके बच्चे नहीं) तक की सबसे लंबी पथ की लंबाई के रूप में परिभाषित किया जाता है।
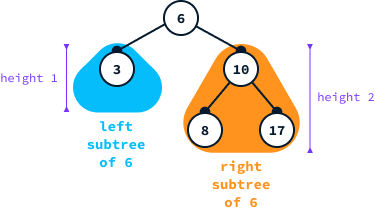
किसी नोड का बैलेंस फैक्टर उसके बाएँ और दाएँ उप-वृक्षों की ऊँचाई के अंतर के रूप में निकाला जाता है:
balance(N) = height(N के बाएँ उप-वृक्ष) - height(N के दाएँ उप-वृक्ष)
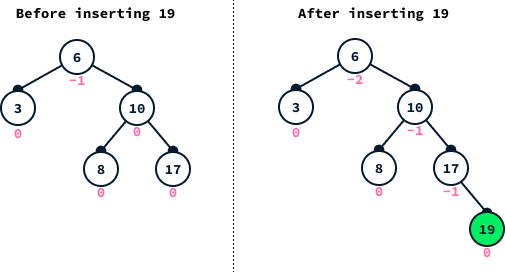
उदाहरण के लिए, balance(6) = 1 - 3 = -2.
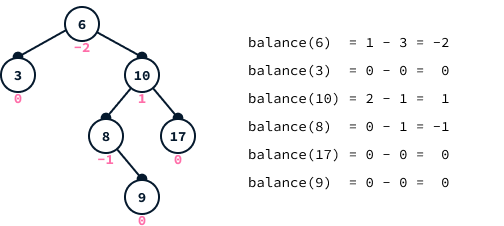
डायग्राम में, नोड 6 का बैलेंस फैक्टर -2 है, जो दर्शाता है कि ट्री AVL मानदंडों का पालन नहीं करता। किसी ट्री को AVL के रूप में वर्गीकृत होने के लिए, प्रत्येक नोड का बैलेंस फैक्टर -1, 0, या 1 होना चाहिए।
बाइनरी सर्च ट्री में क्वेरी की दक्षता ट्री की ऊँचाई पर निर्भर करती है। सबसे खराब स्थिति में, जाँचने वाले नोड्स की संख्या ट्री की ऊँचाई के बराबर होती है। BST का एक प्रमुख मुद्दा यह है कि ट्री की ऊँचाई नोड्स की संख्या जितनी हो सकती है, यानी क्वेरी में हर एक नोड की जाँच करनी पड़ सकती है।
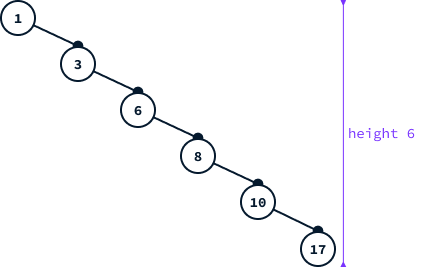
मान लें M(h) वह न्यूनतम नोड्स की संख्या दर्शाता है जिन्हें ऊँचाई h प्राप्त करने के लिए बाइनरी सर्च ट्री में जोड़ना आवश्यक है। साधारण BST के लिए हमने देखा कि M(h) = h, यानी केवल h नोड्स से ऊँचाई h पाई जा सकती है। इसका अर्थ यह है कि BST की ऊँचाई नोड्स की संख्या के साथ रैखिक रूप से बढ़ सकती है, जिससे क्वेरी समय डाटासेट के आकार के समानुपाती हो जाता है।
आइए M(h) को उस न्यूनतम नोड्स की संख्या मानें जो ऊँचाई h वाला AVL ट्री बनाने के लिए चाहिए। चूँकि यह AVL ट्री है, ध्यान दें कि प्रत्येक नोड का बैलेंस फैक्टर केवल -1, 0, या 1 हो सकता है।
लेकिन, हमारे इस मान के अनुसार कि ट्री की ऊँचाई h पाने के लिए संभव न्यूनतम नोड्स हैं, जड़ का बैलेंस 0 नहीं हो सकता। यदि होता, तो हम बाएँ या दाएँ से एक नोड हटा कर बैलेंस -1 या 1 कर सकते थे, और फिर भी एक वैध AVL ट्री रहता।
मान लें जड़ का बैलेंस 1 है (यदि -1 हो तो तर्क समान रहेगा)। इसका मतलब ट्री की संरचना इस प्रकार होगी:
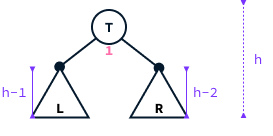
दूसरी ओर, बाएँ और दाएँ दोनों उप-वृक्ष भी अपने-अपने ऊँचाइयों के लिए न्यूनतम नोड्स वाले AVL ट्री होने चाहिए (अन्यथा और नोड्स हटाना संभव होता)। ट्री के कुल नोड्स = 1 (जड़) + बाएँ उप-वृक्ष के नोड्स + दाएँ उप-वृक्ष के नोड्स।
M(h) = 1 + (L के नोड्स) + (R के नोड्स) = 1 + M(h - 1) + M(h - 2)
जैसे-जैसे ऊँचाई बढ़ती है, उस ऊँचाई तक पहुँचने के लिए अधिक नोड्स जोड़ने पड़ते हैं। अतः:
M(h - 1) > M(h - 2)
दोनों को मिलाकर, हम कह सकते हैं:
M(h) = 1 + M(h - 1) + M(h - 2) > 1 + 2 × M(h - 2) > 2 × M(h - 2)
हम इसे h/2 बार लागू कर सकते हैं जब तक कि हम M(1) = 1 या M(2) = 2 तक न पहुँच जाएँ:
M(h) > 2 × M(h - 2) > 2 × 2 × M(h - 4) > 2 × 2 × 2 × M(h - 6) > … > 2(h/2)
स्पष्टता के लिए, नीचे दी गई छवि h = 7 और h = 6 के उदाहरण दिखाती है:
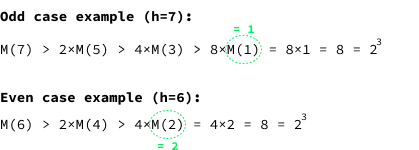
हम निष्कर्ष निकालते हैं कि ऊँचाई h वाले AVL ट्री में न्यूनतम नोड्स की संख्या कम-से-कम 2(h/2) है:
M(h) > 2(h/2)
दोनों पक्षों पर आधार दो का लघुगणक लगाने पर हमें मिलता है:
log2(M(h)) > log2(2(h/2)) = h/2
फलस्वरूप, दोनों पक्षों को दो से गुणा करने पर हम निष्कर्ष निकालते हैं कि ऊँचाई अधिक-से-अधिक नोड्स की संख्या के आधार-2 लघुगणक का दोगुना है:
2 × log2(M(h)) > h
हमने यह प्रदर्शित कर दिया है कि:
N नोड्स वाले AVL ट्री की ऊँचाई अधिक-से-अधिक 2 × log2(N) होती है।
यह दर्शाता है कि AVL ट्री में क्वेरी के लिए डाटासेट के बहुत छोटे हिस्से की ही जाँच करनी पड़ती है। उदाहरण के लिए, एक अरब प्रविष्टियों पर, लघुगणक लगभग 30 होता है, यानी एक अरब डेटा पॉइंट्स होने पर भी किसी विशेष प्रविष्टि को खोजने के लिए लगभग 60 डेटा पॉइंट्स ही देखने पड़ेंगे। यह BST की तुलना में बहुत बड़ा सुधार है, जहाँ सबसे खराब स्थिति में पूरे एक अरब डेटा पॉइंट्स की जाँच करनी पड़ सकती है।
एल्गोरिदमिक समय-जटिलता तथा रैखिक और लघुगणकीय जटिलता के अंतर को गहराई से समझने के लिए यह ब्लॉग पोस्ट देखें: Big-O नोटेशन और समय-जटिलता।
AVL ट्री प्रत्येक नोड का बैलेंस -1, 0, या 1 सुनिश्चित करके तेज़ क्वेरी की गारंटी देते हैं। प्रत्येक नोड का बैलेंस बना रहे, इसके लिए हमें नया मान डालने के बाद ट्री को पुनः संतुलित करना पड़ता है।
बाइनरी सर्च ट्री में इन्सर्शन जड़ से नीचे की ओर पथ का अनुसरण करके होता है। जिस मान को डालना है वह छोटा हो तो बाएँ जाएँ, अन्यथा दाएँ।
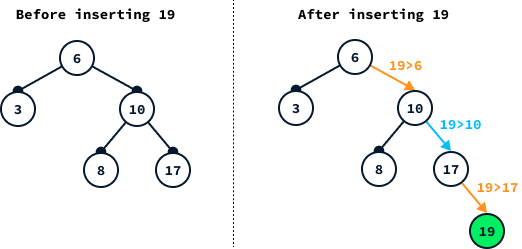
इन्सर्शन से ऊँचाई अधिक-से-अधिक एक बढ़ती है। इसलिए, यदि इन्सर्शन के बाद बैलेंस गुण पूरा नहीं होता, तो इसका अर्थ है कि या तो कोई नोड जिसका बैलेंस -1 था अब -2 हो गया, या जिसका बैलेंस 1 था अब 2 हो गया। ऊपर वाले उदाहरण में पहली स्थिति हुई है।
संतुलन बहाल करने के लिए, हम ट्री रोटेशंस पर निर्भर करते हैं। लेफ़्ट रोटेशन नोड A पर ट्री को इस प्रकार पुनर्संरचित करता है कि A को बाएँ घुमाया जाता है, जैसा नीचे दिखाया गया है:
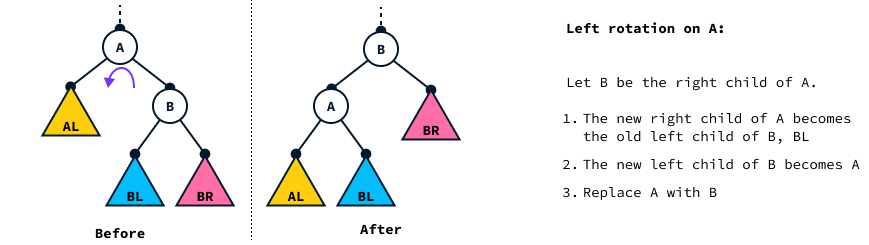
डायग्राम पर:
BL B का बायाँ उप-वृक्ष दर्शाता हैBR उसका दायाँ उप-वृक्ष हैAL A का बायाँ उप-वृक्ष हैध्यान दें कि रोटेशन के बाद भी नोड का क्रम मान्य रहता है:
A B से छोटा है क्योंकि B उसका दायाँ बच्चा था।BL के नोड्स A से बड़े हैं क्योंकि वे A के दाएँ थे।AL के नोड्स B से छोटे हैं क्योंकि वे A से छोटे हैं।राइट रोटेशन भी इसी तरह सममित रूप से A को दाएँ घुमा कर होता है।
आइए एक ठोस उदाहरण देखें: 19 डालने के बाद उत्पन्न असंतुलन को नोड 6 पर लेफ़्ट रोटेशन से ठीक करते हैं।
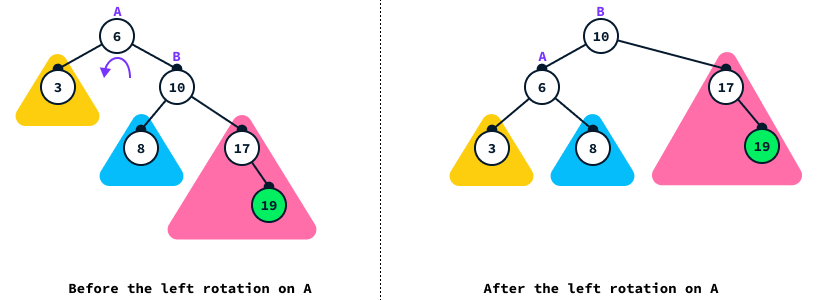
इन्सर्शन के बाद, हम -2 या 2 बैलेंस वाले नोड को घुमा कर असंतुलन ठीक करते हैं। इस मामले में, नोड 6 का बैलेंस -2 था, यानी ट्री दाएँ की ओर झुका हुआ था, इसलिए हमने लेफ़्ट रोटेशन किया (असंतुलन की विपरीत दिशा में)। यदि बैलेंस 2 होता, तो राइट रोटेशन किया जाता।
पिछले उदाहरण में ट्री पूरी तरह दाएँ झुका था, इसलिए एक सिंगल लेफ़्ट रोटेशन पर्याप्त था। लेकिन कभी-कभी ज़िग-ज़ैग प्रकार का असंतुलन होता है जहाँ ट्री एक ओर झुका है, पर उप-वृक्ष विपरीत ओर झुका है। इसे देखने के लिए, 19 डालने से पहले के मूल ट्री पर लौटते हैं और इसके बजाय 7 डालते हैं:
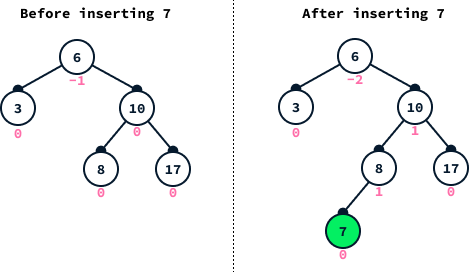
इस स्थिति में, ट्री अब भी दाएँ झुका है, लेकिन 10 पर जड़ा उप-वृक्ष बाएँ झुका है। ऐसे में, पहले नोड 10 को दाएँ घुमाना होगा:
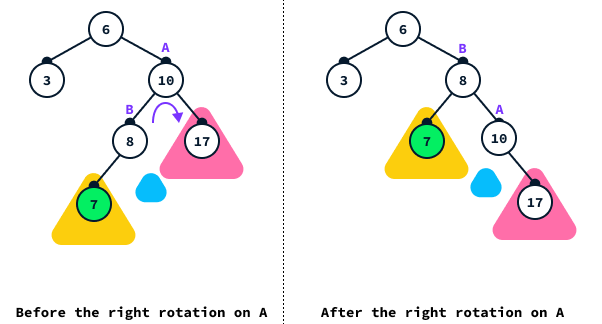
ध्यान दें कि नोड B का दायाँ बच्चा नहीं है। विज़ुअलाइज़ेशन आसान बनाने के लिए हम इसे डायग्राम में नीले रंग में फिर भी दिखा रहे हैं।
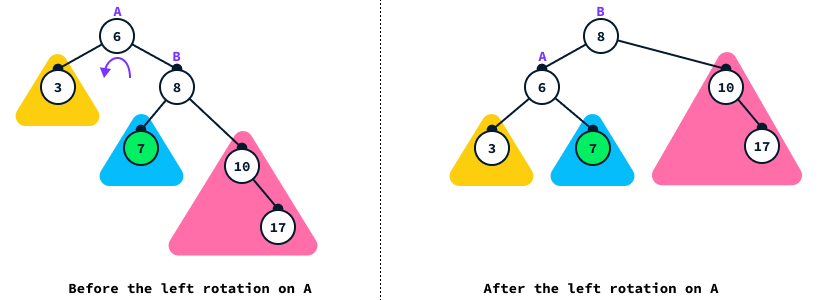
राइट रोटेशन करने के बाद, हम फिर पिछले मामले में आ जाते हैं जहाँ 6 पर लेफ़्ट रोटेशन संतुलन बहाल कर देगा:
आइए नोड इम्प्लीमेंटेशन से शुरू करें।
ट्री का प्रत्येक नोड पाँच गुण रखता है:
self.value)self.parent)self.left)self.right)self.height)class Node:
def __init__(self, value, parent = None):
self.value = value
self.parent = parent
self.left = None
self.right = None
self.height = 1हम मिसिंग नोड्स दर्शाने के लिए None का उपयोग करते हैं। डिफ़ॉल्ट height 1 रखी गई है क्योंकि एकल नोड वाला ट्री ऊँचाई 1 का होता है।
ट्री इम्प्लीमेंटेशन को सुगम बनाने के लिए, हम Node क्लास में कुछ मेथड्स जोड़ते हैं।
# Inside the Node class
  def left_height(self):
    # Get the heigth of the left subtree
    return 0 if self.left is None else self.left.height

  def right_height(self):
    # Get the height of the right subtree
    return 0 if self.right is None else self.right.height
  def balance_factor(self):
    # Get the balance factor
    return self.left_height() - self.right_height()
  def update_heigth(self):
    # Update the heigth of this node
    self.height = 1 + max(self.left_height(),self.right_height())

  def set_left(self, node):
    # Set the left child
    self.left = node
    if node is not None:
      node.parent = self
    self.update_heigth()

  def set_right(self, node):
    # Set the right child
    self.right = node
    if node is not None:
      node.parent = self
    self.update_heigth()
  def is_left_child(self):
    # Check whether this node is a left child
    return self.parent is not None and self.parent.left == self

  def is_right_child(self):
    # Check whether this node is a right child
    return self.parent is not None and self.parent.right == self
ध्यान दें कि हम बाएँ और दाएँ बच्चों को असाइन करने के लिए .set_left() और .set_right() का उपयोग करते हैं। सीधे self.left और self.right बदलने के बजाय इन मेथड्स का उपयोग करने का कारण यह है कि जब भी कोई बच्चा बदला जाता है, नए बच्चे के पैरेंट को अपडेट करना और नोड की ऊँचाई को भी अपडेट करना आवश्यक होता है।
AVL ट्री एक पैरामीटर बनाए रखता है—ट्री की जड़, यानी सबसे ऊपर का नोड।
class AVLTree:
  def __init__(self):
    self.root = None
ट्री का संतुलन बनाए रखने के लिए हमें लेफ़्ट और राइट रोटेशन इम्प्लीमेंट करने होंगे। आइए देखें डायग्राम में लेफ़्ट रोटेशन कैसे दर्शाया है:
# Inside the AVLTree class

  def rotate_left(self, a):
    b = a.right
    # 1. The new right child of A becomes the left child of B
    a.set_right(b.left)
    # 2. The new left child of B becomes A
    b.set_left(a)
    return b # 3. Return B to replace A with it
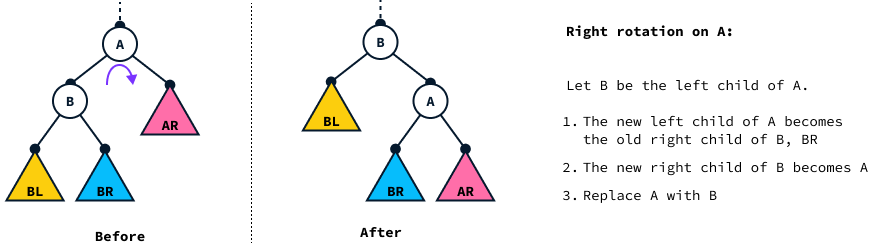
राइट रोटेशन सममित रूप से इम्प्लीमेंट होते हैं:
# Inside the AVLTree class

  def rotate_right(self, a):
    b = a.left
    a.set_left(b.right)
    b.set_right(a)
    return b
रोटेशंस का उपयोग कर हम ट्री को पुनः संतुलित कर सकते हैं। किसी नोड को तब रिबैलेंसिंग चाहिए जब उसका बैलेंस फैक्टर 2 (ट्री बाएँ झुका) या -2 (ट्री दाएँ झुका) हो। कुल चार परिदृश्य होते हैं जिन्हें हमें देखना होता है:
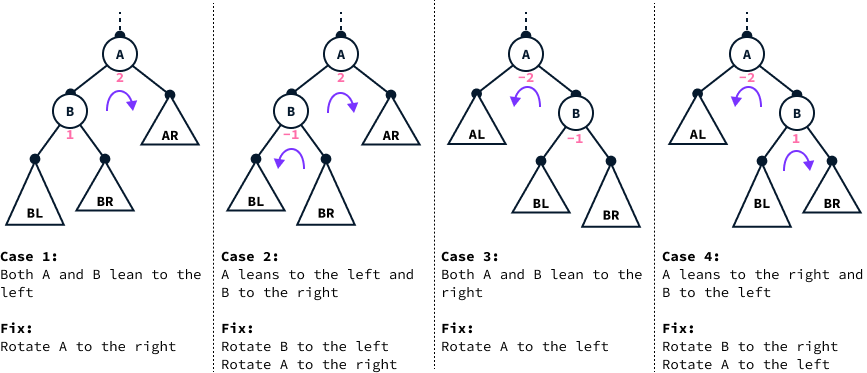
हम इन चारों मामलों को .rebalance() मेथड में इम्प्लीमेंट करते हैं।
# Inside the AVLTree class

  def rebalance(self, node):
    if node is None:
      # Empty tree, no rebalancing needed
      return None
    balance = node.balance_factor()
    if abs(balance) <= 1:
      # The node is already balanced, no rebalancing needed
      return node
    if balance == 2:
      # Cases 1 and 2, the tree is leaning to the left
      if node.left.balance_factor() == -1:
        # Case 2, we first do a left rotation
        node.set_left(self.rotate_left(node.left))
      return self.rotate_right(node)
    # Balance must be -2
    # Cases 3 and 4, the tree is leaning to the left
    if node.right.balance_factor() == 1:
      # Case 4, we first do a right rotation
      node.set_right(self.rotate_right(node.right))
    return self.rotate_left(node)
ध्यान दें कि हर मामले में यह मेथड अभी-अभी संतुलित हुए उप-वृक्ष की जड़ लौटाता है। पुनर्संतुलन के दौरान बच्चों को अपडेट करने में बाद में इसी नई उप-वृक्ष जड़ का उपयोग होगा।
AVL ट्री में नोड जोड़ना सामान्य BST जैसा ही है, बस इन्सर्शन के बाद संतुलन बहाल करने का चरण अतिरिक्त है। BST में नोड जोड़ते समय हम जड़ से नीचे जाते हैं और हर कदम पर जोड़ा जाने वाला मान वर्तमान नोड के मान से छोटा हो तो बाएँ, वरना दाएँ चलते हैं। नीचे जाते समय हम पैरेंट नोड ट्रैक करते हैं ताकि नए नोड को उसके बच्चे के रूप में जोड़ सकें।
खाली नोड मिलने पर दो स्थितियाँ होती हैं:
# Inside the AVLTree class
  def add(self, value):
    self.size += 1
    parent = None
    current = self.root
    while current is not None:
      parent = current
      if value < current.value:
        # Value to insert is smaller than node value, go left
        current = current.left
      else:
        # Value to insert is larger than node value, go right
        current = current.right
    # We found the parent, create the new node
    new_node = Node(value, parent)
    # Case 1: The parent is None so the new node is the root
    if parent is None:
      self.root = new_node
    else:
      # Case 2: Set the new node as a child of the parent
      if value < parent.value:
        parent.left = new_node
      else:
        parent.right = new_node
    # After a new node is added, we need to restore balance
    self.restore_balance(new_node)
BST के .add() मेथड और AVL ट्री के .add() में केवल अंतिम चरण का अंतर है। इसमें नए जोड़े नोड से जड़ तक ऊपर लौटते हुए .rebalance() मेथड का उपयोग करके प्रत्येक नोड को पुनः संतुलित करना शामिल है।
# Inside the AVLTree class
  def restore_balance(self, node):
    current = node
    # Go up the tree and rebalance left and right children
    while current is not None:
      current.set_left(self.rebalance(current.left))
      current.set_right(self.rebalance(current.right))
      current.update_heigth()
      current = current.parent
    self.root = self.rebalance(self.root)
    self.root.parent = None
ध्यान दें कि जब नोड पहले से संतुलित होता है तो .rebalance() कुछ नहीं करता—वही नोड लौटा देता है। यही कारण है कि ऊपर जाते हुए हम इसे दोनों ओर कॉल कर सकते हैं, भले ही केवल एक ओर असंतुलित हो। दूसरी कॉल ट्री को अपरिवर्तित छोड़ देती है।
याद करें कि हमने .rebalance() इस प्रकार इम्प्लीमेंट किया है कि वह उप-वृक्ष की (संभावित) नई जड़ लौटाए। ऐसा इसलिए ताकि ऊपर जाते हुए हम वर्तमान नोड्स के बाएँ और दाएँ बच्चों को अपडेट कर सकें।
नीचे दिया डायग्राम दिखाता है कि .restore_balance() ट्री में ऊपर जाते हुए किन चरणों से गुजरता है।
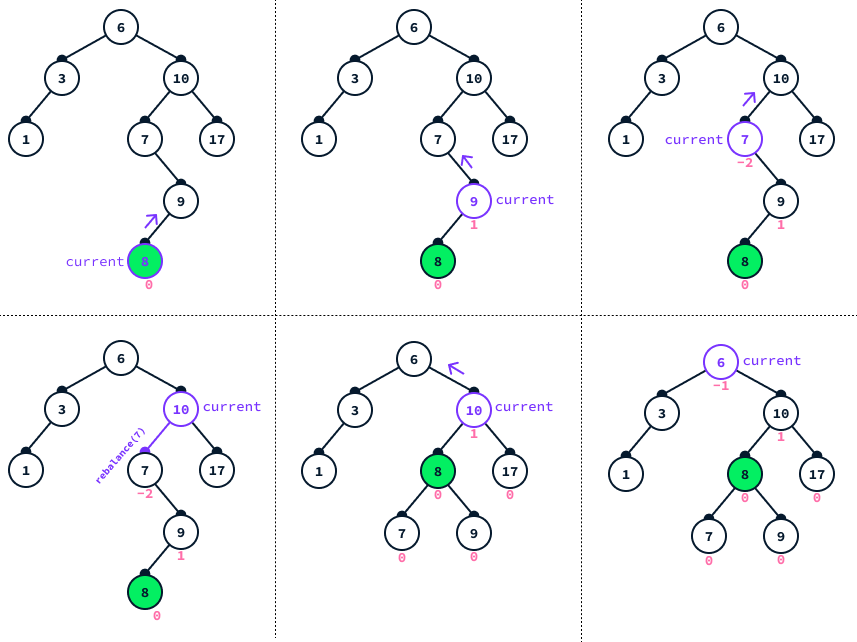
दिए गए उदाहरण में, हम पहले नोड 8 जोड़ते हैं। फिर, संतुलन बहाली की प्रक्रिया इसी नोड से शुरू होकर ट्री में ऊपर बढ़ती है, और हर नोड पर बाएँ और दाएँ बच्चों की जाँच और रिबैलेंसिंग करती है। यह क्रम तब तक जारी रहता है जब तक नोड 10 तक न पहुँचे। यहाँ तक .rebalance() की किसी भी कॉल का प्रभाव नहीं पड़ता क्योंकि नोड्स संतुलित रहते हैं।
हालाँकि, नोड 10 पर पहुँचने पर पता चलता है कि उसका बायाँ बच्चा, नोड 7, का बैलेंस फैक्टर -2 है, जो रिबैलेंसिंग की आवश्यकता दर्शाता है। फलस्वरूप, .rebalance(7) कॉल की जाती है, जिसके परिणामस्वरूप नोड 10 के बाएँ बच्चे को बाएँ उप-वृक्ष की नई जड़, नोड 8, से प्रतिस्थापित कर दिया जाता है, और ट्री का संतुलन बहाल हो जाता है।
ट्री का संतुलन बनाए रखते हुए जोड़ने और हटाने के अलावा, AVL ट्री कई अन्य आवश्यक ऑपरेशंस का समर्थन करता है।
BST के क्रमबद्ध स्वभाव के कारण, न्यूनतम मान ट्री के सबसे बाएँ नोड पर और अधिकतम मान सबसे दाएँ नोड पर मिलता है।
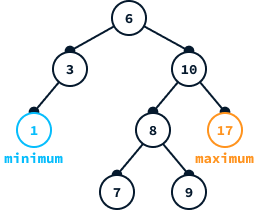
हमने दो सहायक फ़ंक्शंस इम्प्लीमेंट किए हैं जो दिए गए नोड से शुरू होकर क्रमशः सबसे बाएँ और सबसे दाएँ नोड्स का पता लगाते हैं। ये फ़ंक्शंस नोड डिलीशन के इम्प्लीमेंटेशन को सुगम बनाने में उपयोगी हैं।
# Inside the AVLTree class

  def leftmost(self, starting_node):
    # Find the leftmost node from a given starting node
    previous = None
    current = starting_node
    while current is not None:
      previous = current
      current = current.left
    return previous
  def minimum(self):
    # Return the minimum value in the tree
    if self.root is None:
      raise Exception("Empty tree")
    return self.leftmost(self.root).value
# Inside the AVLTree class
def rightmost(self, starting_node):
# Find the rightmost node from a given starting node
previous = None
current = starting_node
while current is not None:
previous = current
current = current.right
return previous
def maximum(self):
# Fidn the maximum value in the tree
if self.root is None:
raise Exception("Empty tree")
return self.rightmost(self.root).valueयह जाँचने के लिए कि किसी ट्री में कोई विशिष्ट मान मौजूद है या नहीं, हम ट्री के क्रम गुण का उपयोग करके खोज को निर्देशित करते हैं। जड़ से शुरू करके, यदि वांछित मान वर्तमान नोड से छोटा है तो बाएँ, और बड़ा है तो दाएँ जाते हैं। यदि ट्री के अंत तक पहुँचकर भी वांछित मान न मिले, तो इसका अर्थ है कि वह मान ट्री में नहीं है।
इस प्रक्रिया को सुगम बनाने के लिए, हम .locate_node() नामक एक सहायक मेथड इम्प्लीमेंट करते हैं। यह मेथड न केवल खोज के लिए बल्कि ट्री से मान हटाने जैसे ऑपरेशंस में भी उपयोगी है। साथ ही, हम .__contains__() मेथड का उपयोग करते हैं, जो in ऑपरेटर के माध्यम से ट्री में किसी मान की उपस्थिति की जाँच को सरल बनाता है।
# Inside the AVLTree class

  def locate_node(self, value):

    # Returns the node containing a given value or None if no

    # such node exists

    current = self.root

    while current is not None:

      if value == current.value:

        return current

      if value < current.value:

        current = current.left

      else:

        current = current.right

    return None

  def __contains__(self, value):

    node = self.locate_node(value)

return node is not Noneजब हटाया जाने वाला नोड ट्री के बीच में हो, तो AVL ट्री में नोड हटाना विशेष रूप से चुनौतीपूर्ण हो सकता है। यदि नोड एक पत्ता है, यानी उसके कोई बच्चे नहीं हैं, तो हम उसके पैरेंट के बाएँ या दाएँ बच्चे के पॉइंटर को, यह देखते हुए कि नोड बायाँ है या दायाँ, None सेट करके उसे आसानी से हटा सकते हैं।
एक विशेष स्थिति तब आती है जब हटाने के लिए लक्षित नोड ट्री की जड़ हो। इस स्थिति में, हम जड़ को None सेट करके नोड को हटा सकते हैं।
# Inside the AVLTree class

  def delete_leaf(self, node):

    if node.parent is None:

      self.root = None

    elif node.is_left_child():

      node.parent.left = None

      node.parent = None

    else:

      node.parent.right = None

      node.parent = None
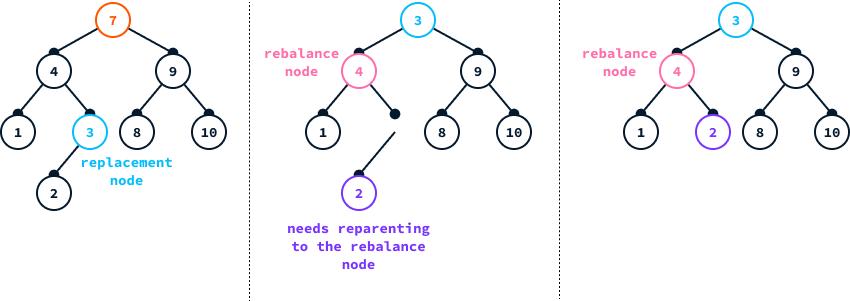
AVL ट्री से कोई मान हटाने के लिए, हमें पहले .locate_node() मेथड की मदद से उस मान वाला नोड खोजना होगा। नोड मिल जाने पर, यदि वह पत्ता है तो .delete_leaf() से हटा सकते हैं। यदि वह पत्ता नहीं है, तो सीधे हटाने से ट्री की संरचना बिगड़ जाएगी। इसे संबोधित करने के लिए, हम एक उपयुक्त प्रतिस्थापन नोड ढूँढ़ते हैं। यदि हटाए जाने वाले नोड का बायाँ बच्चा है, तो हम उसके बाएँ उप-वृक्ष में सबसे दायाँ नोड चुनते हैं। यह तरीका ट्री की क्रमबद्ध संरचना बनाए रखता है।
नीचे दिए डायग्राम में ट्री से नोड 10 हटाने का उदाहरण है। चूँकि इसका बायाँ बच्चा है, हम इसे बाएँ उप-वृक्ष के सबसे दाएँ नोड से बदलते हैं। प्रतिस्थापन के बाद, नए प्रतिस्थापित नोड के पैरेंट से शुरू करते हुए ट्री को पुनः संतुलित करना महत्वपूर्ण है।
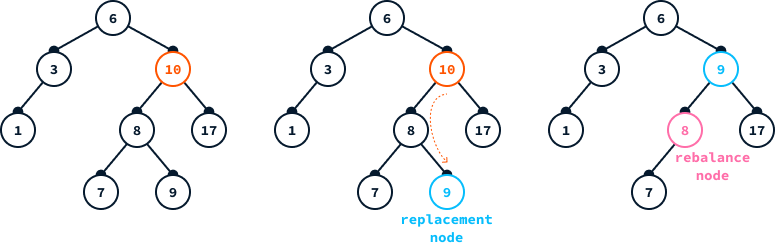
इस उदाहरण में, प्रतिस्थापन नोड एक पत्ता है। हालाँकि, यदि प्रतिस्थापन नोड के बच्चे हैं, तो उन्हें प्रतिस्थापन नोड के पैरेंट को पुनः असाइन करना आवश्यक है। चूँकि प्रतिस्थापन नोड अतिशय (एक्सट्रीम) नोड होता है (या तो सबसे बायाँ या सबसे दायाँ), उसके अधिकतम एक ही बच्चा हो सकता है। इसलिए यह पुनः-असाइनमेंट हमेशा संभव रहता है।
# Inside the AVLTree class

  def delete(self, value):

    # Delete a value from the tree

    node = self.locate_node(value)

    if node is None:

      raise Exception("Value not stored in tree")

    replacement = None

    rebalance_node = node.parent

    if node.left is not None:

      # There's a left child so we replace with rightmost node

      replacement = self.rightmost(node.left)

      # Check if reparenting is needed

      if replacement.is_left_child():

        replacement.parent.set_left(replacement.left)

      else:

        replacement.parent.set_right(replacement.left)

    elif node.right is not None:

      # There's a right child so we replace with the leftmost node

      replacement = self.leftmost(node.right)

      # Check if reparenting is needed

      if replacement.is_left_child():

        replacement.parent.set_left(replacement.right)

      else:

        replacement.parent.set_right(replacement.right)

    if replacement:

      # We found a replacement so replace the value

      node.value = replacement.value

      rebalance_node = replacement.parent

    else:

      # No replacement so it means the node to delete is a leaf

      self.delete_leaf(node)

    if rebalance_node is not None:

      self.restore_balance(rebalance_node)
रेंज क्वेरी में दो निर्दिष्ट मानों के बीच आने वाले सभी मानों की पहचान करना शामिल है। AVL ट्री के क्रमबद्ध स्वभाव के कारण, हम इन मानों को कुशलता से ढूँढ़ सकते हैं।
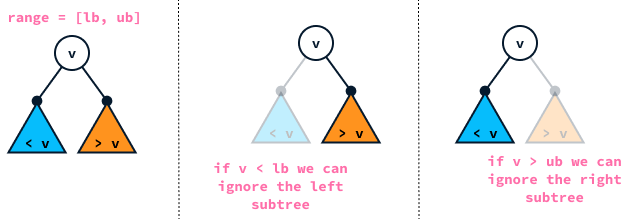
निम्न सीमा lb और उच्च सीमा ub द्वारा परिभाषित रेंज में आने वाले सभी मानों का पता लगाने के लिए, हम ट्री में रिकर्सिव खोज का उपयोग करते हैं। जिस-जिस नोड से गुजरते हैं, यदि उसका मान इस रेंज में आता है, तो हम उसे परिणामों में जोड़ते हैं। फिर हम खोज जारी रखने के लिए बाएँ और दाएँ दोनों उप-वृक्षों को देखते हैं।
यदि नोड का मान निम्न सीमा से कम है तो हम बाएँ उप-वृक्ष को नज़रअंदाज़ करते हैं क्योंकि बाएँ उप-वृक्ष के सभी मान नोड के मान से छोटे होंगे। इसी प्रकार, यदि नोड का मान उच्च सीमा से अधिक है तो हम दाएँ उप-वृक्ष को नज़रअंदाज़ करते हैं, क्योंकि दाएँ उप-वृक्ष के सभी मान नोड के मान से बड़े होंगे।
  def search(self, node, lb, ub, results):

    # Search for values between lower bound and upper bound

    if node is None:

      return

    if lb <= node.value and node.value <= ub:

      results.append(node.value)

    if node.value >= lb:

      self.search(node.left, lb, ub, results)

    if node.value <= ub:

      self.search(node.right, lb, ub, results)

  def range_query(self, lb, ub):

    # Search for values between lower bound and upper bound

    results = []

    self.search(self.root, lb, ub, results)

return resultsहमने एक AVL ट्री इम्प्लीमेंट किया है जो निम्नलिखित ऑपरेशंस कर सकता है:
avltree पैकेज इन क्षमताओं का प्रतिबिंबित करती हुई एक Python इम्प्लीमेंटेशन प्रदान करता है।
अन्य self-balancing बाइनरी सर्च ट्री, जैसे red-black ट्री, splay ट्री, और B-ट्री, भी समान कार्यक्षमताएँ देते हैं। सामान्यतः, अधिकांश अनुप्रयोगों में उनका प्रदर्शन तुलनीय रहता है क्योंकि सभी लघुगणकीय ऊँचाई की गारंटी रखते हैं। हालाँकि, AVL ट्री अधिक सूक्ष्मता से संतुलित होते हैं, जिससे खोज ऑपरेशंस अनुकूलित होते हैं, पर कड़े रिबैलेंसिंग के कारण इन्सर्शन अपेक्षाकृत धीमे हो सकते हैं।
Splay ट्री उन परिदृश्यों में विशेष रूप से प्रभावी हैं जहाँ हाल ही में एक्सेस किए गए एलीमेंट्स बार-बार उपयोग होते हैं, जिससे वे कैश इम्प्लीमेंटेशन के लिए उत्कृष्ट विकल्प बनते हैं।
B-ट्री विशेष रूप से डिस्क पर कुशलतापूर्वक काम करने के लिए डिज़ाइन किए गए हैं, न कि मेमोरी में—इसीलिए वे बड़े डाटासेट्स के प्रबंधन में अमूल्य हैं जो मेमोरी क्षमता से अधिक होते हैं, जैसे डेटाबेस इंडेक्स तैयार करना।
हमारे इम्प्लीमेंटेशन को बेहतर बनाने के कई तरीके हैं। AVL ट्री की अपनी समझ को गहरा करने के लिए अभ्यास स्वरूप कुछ सुझाव यहाँ दिए गए हैं:
BST एक प्रकार का बाइनरी ट्री डेटा स्ट्रक्चर है जो एक विशिष्ट क्रम का पालन करते हुए डेटा व्यवस्थित करता है। यह संगठन विशिष्ट मानों की खोज करते समय पूरे डाटासेट की जाँच से बचने देता है। परंतु, BST असंतुलित हो सकते हैं, जिससे प्रदर्शन बिगड़ता है और कुछ स्थितियों में पूरे डाटासेट की जाँच करनी पड़ सकती है।
AVL ट्री इस समस्या का समाधान रोटेशंस के माध्यम से अतिरिक्त संतुलन गुण थोपकर करते हैं। ये गुण सुनिश्चित करते हैं कि ट्री की ऊँचाई डाटासेट के आकार के सापेक्ष लघुगणकीय बनी रहे, जो एक महत्वपूर्ण सुधार है।
लघुगणकीय समय-जटिलता रैखिक समय-जटिलता पर एक बड़ा उन्नयन है, जिससे AVL ट्री क्वेरी हल करने में अत्यंत कुशल हो जाते हैं। अरबों प्रविष्टियों वाले डाटासेट्स में भी, किसी तत्व को ढूँढ़ने के लिए केवल कुछ ही डेटा पॉइंट्स की जाँच करनी पड़ती है, जो उन्हें कहीं अधिक प्रभावी बनाता है।
इन पाठ्यक्रमों के साथ डेटा इंजीनियरिंग सीखें!
लर्निंग पाथ
लर्निंग पाथ
कोर्स