{count, plural, one {Corso} other {Corsi}}
Principi di Ingegneria del Software in Python
{hours} ore
70.6K
Ti è mai capitato che ti chiedessero quanto durerà un progetto software e di renderti conto che la tua risposta migliore era, in pratica, un'ipotesi?
Negli anni '70 è così che la maggior parte dei team affrontava la stima dei costi nell'ingegneria del software. I progetti sforavano regolarmente budget e scadenze, e i metodi usati, perlopiù giudizio esperto e analogie grossolane, non reggevano quando i sistemi crescevano in dimensioni e complessità.
COCOMO è stato creato per risolvere il problema. Sta per COnstructive COst MOdel. Barry W. Boehm lo ha introdotto nel suo libro del 1981 Software Engineering Economics, basando le formule su dati reali di progetto anziché sull'intuizione. È diventato uno dei modelli di stima algoritmica più insegnati nel settore. Boehm, scomparso nell'agosto 2022, ha trascorso decenni a perfezionarne i principi.
In questo tutorial ti mostrerò come funziona il modello, cosa significano i diversi tipi e livelli, e farò un esempio numerico completo per dare senso ai numeri nella pratica.
COCOMO è un modello parametrico di stima dei costi software. Prende un input principale, ossia la dimensione stimata di un progetto software misurata in migliaia di linee di codice (KLOC), e lo usa per prevedere tre cose: l'impegno totale in persone-mese (PM), il tempo di sviluppo in mesi e il numero di persone necessarie.
Il modello presume che la dimensione del progetto sia il principale predittore dell'impegno. Boehm ha costruito le costanti del modello eseguendo analisi di regressione su dati storici reali di progetto.
Detto questo, COCOMO non stima direttamente il costo monetario. Stima l'impegno. Per convertire persone-mese in denaro, moltiplichi per il costo medio del lavoro per persona-mese nella tua organizzazione. Il modello ti fornisce l'impegno; tu fornisci la tariffa.
Boehm lavorava come Director of Software Research and Technology alla TRW Aerospace, e la frustrazione era immediata e concreta. Secondo un tributo poi pubblicato dalla National Academy of Engineering, un vicepresidente di TRW disse a Boehm, dopo aver esaminato un'offerta software di un concorrente: "Non voglio più dover approvare un'offerta software basandomi solo sulla fiducia. Vai e inventa un modo credibile per stimare il costo di sviluppo di un prodotto software."
Quella richiesta divenne COCOMO. Boehm studiò 63 progetti completati in TRW, coprendo software da 2.000 a 100.000 linee di codice, scritti in linguaggi dall'assembly al PL/I, tutti sviluppati secondo il modello a cascata. L'analisi di regressione su quel dataset produsse le costanti usate in COCOMO I, e il modello fu reso pubblico nel 1981.
La matematica alla base di Basic COCOMO I è semplice una volta capito cosa rappresenta ciascun termine.
La formula dell'impegno è:
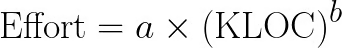
Qui l'impegno è misurato in persone-mese, KLOC è la dimensione stimata del software in migliaia di linee di codice e a e b sono costanti che dipendono dal tipo di progetto su cui stai lavorando.
La formula del tempo di sviluppo discende dalla stima dell'impegno:
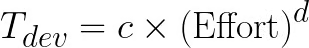
La costante d varia in base alla modalità, mentre c è fissa a 2,5 in tutte e tre. Molti tutorial sbagliano implicando che tutte e quattro le costanti cambino. Una volta che hai sia Effort che , puoi stimare il numero medio di persone richieste:
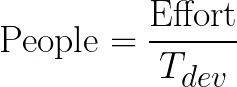
La tabella seguente mostra le costanti verificate per il Basic COCOMO I:
|
Modalità di progetto |
a |
b |
c |
d |
|
Organic |
2.4 |
1.05 |
2.5 |
0.38 |
|
Semi-Detached |
3.0 |
1.12 |
2.5 |
0.35 |
|
Embedded |
3.6 |
1.20 |
2.5 |
0.32 |
La variabile chiave qui è b. Per i progetti Organic, b = 1,05, il che significa che l'impegno cresce quasi linearmente con la dimensione del progetto. Per i progetti Embedded, b = 1,20, il che crea una significativa diseconomia di scala: raddoppiare la dimensione di un progetto embedded più che raddoppia l'impegno richiesto.
COCOMO I classifica i progetti software in tre modalità di sviluppo. Ogni modalità riflette una diversa combinazione di esperienza del team, complessità del progetto e vincoli operativi. La modalità che scegli determina quali costanti inserire nelle formule.
Vale la pena sottolinearlo subito: queste tre modalità si applicano solo a COCOMO I. COCOMO II, l'aggiornamento del 2000, le ha sostituite con un approccio diverso.
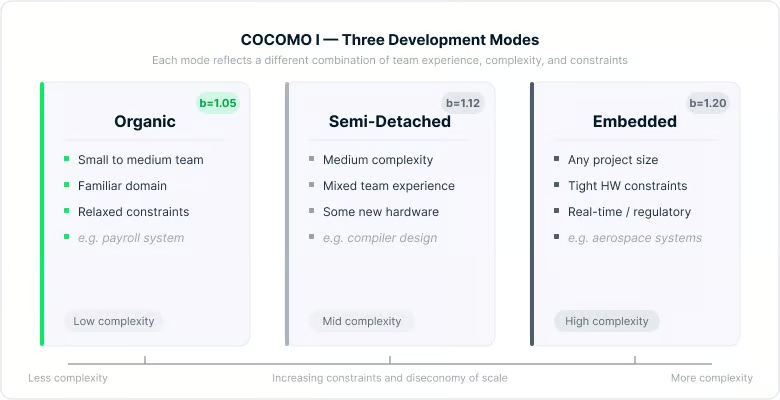
Le tre modalità di COCOMO I a confronto visivo. Immagine dell'autore.
Le tre modalità si collocano su una scala di complessità e vincoli crescenti. Il tipo di progetto e il contesto del team di solito rendono chiaro quale si applica.
La modalità Organic copre progetti piccoli e medi in cui il team ha una solida esperienza nel dominio applicativo, i requisiti sono relativamente ben compresi e non ci sono pressioni esterne significative da vincoli hardware o requisiti normativi. Un sistema paghe, un'applicazione di elaborazione dati o uno strumento di gestione dell'inventario rientrerebbero tipicamente qui.
Poiché il team è esperto e il dominio è familiare, l'overhead di comunicazione rimane basso anche quando il progetto cresce. Ecco perché l'esponente b è il più piccolo delle tre modalità.
La modalità Semi-detached sta nel mezzo. I team in questa categoria hanno esperienza mista: alcuni membri conoscono bene il dominio, altri no. Il progetto ha complessità moderata e potrebbe esserci qualche interazione con nuovo hardware o sistemi esterni.
Sviluppo di compilatori, sistemi di elaborazione transazioni e applicazioni business di fascia media sono esempi comuni. La diseconomia di scala è più evidente qui, con b = 1,12.
La modalità Embedded si applica a progetti con vincoli operativi stringenti: requisiti hardware rigorosi, esigenze di elaborazione real-time, standard normativi o requisiti aerospaziali e della difesa. Il team può essere numeroso e tecnicamente preparato, ma la complessità di integrazione, test e validazione fa crescere l'impegno rapidamente all'aumentare della dimensione del progetto.
Con b = 1,20, i progetti embedded hanno la diseconomia di scala più marcata tra le tre modalità. La modalità Embedded non riguarda nemmeno la dimensione del progetto: anche un sistema embedded relativamente piccolo rientra in questa categoria se opera sotto vincoli severi.
Oltre alle tre modalità di progetto, COCOMO I ha tre livelli di dettaglio della stima. Le modalità ti dicono quali costanti usare; i livelli ti dicono quanto in profondità modellare il progetto. Ogni livello costruisce sul precedente aggiungendo più fattori al calcolo, aumentando l'accuratezza al costo di più dati in input.
Pensalo come uno spettro: Basic COCOMO ti dà una stima rapida di massima, mentre Detailed COCOMO ti consente una pianificazione precisa a livello di fase.
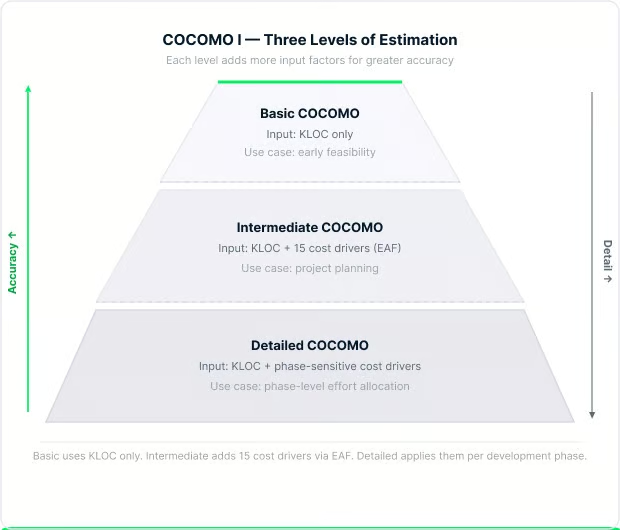
Livelli di COCOMO I per profondità del dettaglio di stima. Immagine dell'autore.
Scendendo lungo la piramide si aggiungono più fattori al calcolo, il che aumenta l'accuratezza ma richiede anche più dati in input per iniziare.
Basic COCOMO usa solo la dimensione del progetto in KLOC e la modalità di progetto. Inserisci i KLOC, applichi le costanti per la modalità scelta e ottieni una stima dell'impegno. È utile per valutazioni preliminari di fattibilità quando non hai ancora informazioni dettagliate sul team o sull'ambiente di sviluppo.
Intermediate COCOMO introduce un Effort Adjustment Factor, solitamente scritto come EAF. L'elenco completo dei moltiplicatori dei driver di costo è documentato nel COCOMO II Model Definition Manual. La formula dell'impegno diventa:
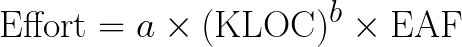
L'EAF è il prodotto di 15 driver di costo, ciascuno valutato su una scala da Very Low a Extra High. I driver ricadono in quattro categorie: attributi del prodotto (affidabilità, complessità, dimensione del database), attributi hardware (vincoli di tempo di esecuzione e storage), attributi del personale (esperienza e capacità del team) e attributi di progetto (strumenti, pressione sulla pianificazione e pratiche di sviluppo).
Una cosa da sapere su Intermediate COCOMO: la costante a cambia rispetto ai valori di Basic. Per la modalità Organic, a diventa 3,2 (non 2,4). Per la modalità semi-detached rimane 3,0. Per la modalità Embedded scende a 2,8. Gli esponenti b, c e d rimangono gli stessi sia a livello Basic che Intermediate.
I driver di costo relativi al personale sono invertiti: maggiore capacità significa un moltiplicatore più piccolo, che riduce la stima dell'impegno. Un team di programmatori esperti semplicemente non ha bisogno di tante persone-mese quanto un team di principianti per finire un progetto.
Detailed COCOMO, talvolta chiamato Advanced COCOMO, applica i moltiplicatori di impegno a livello di singola fase anziché all'intero progetto. Ciò significa che i driver di costo per analisi dei requisiti, progettazione dettagliata, codifica e integrazione e test sono valutati separatamente.
È il livello più accurato, e anche il più dispendioso in termini di tempo. Ha senso per progetti grandi in cui team diversi gestiscono fasi diverse e dove la distribuzione dell'impegno tra le fasi è rilevante per la pianificazione.
A metà degli anni '90, COCOMO I mostrava i suoi limiti. Lo sviluppo software era passato da progetti a cascata su mainframe a programmazione orientata agli oggetti, librerie di componenti riutilizzabili, prototipazione rapida e sistemi desktop distribuiti. Applicare dati di progetto degli anni '70 ad ambienti software degli anni '90 produceva stime inaffidabili.
Boehm e i suoi colleghi del USC Center for Software Engineering trascorsero diversi anni a ricostruire il modello da zero. Il risultato fu COCOMO II, pubblicato nel 2000 nel libro Software Cost Estimation with COCOMO II, calibrato su un dataset di 161 progetti, più del doppio dei 63 del modello originale.
Le motivazioni alla base di COCOMO II furono lo sviluppo orientato agli oggetti e basato su componenti, il riuso del software e l'integrazione di componenti commerciali off-the-shelf, i modelli iterativi e a spirale, e gli strumenti moderni. Una concezione errata comune da chiarire: COCOMO II non è stato costruito per l'Agile. L'Agile come lo intendiamo oggi esisteva a malapena mentre il modello veniva sviluppato tra il 1995 e il 2000.
COCOMO II offre tre sottomodelli, ciascuno adatto a una fase diversa della vita di un progetto.
L'Application Composition Model è progettato per la prototipazione iniziale, in particolare quando i team usano builder di GUI e librerie di componenti. Invece dei KLOC, usa gli Object Point: schermate, report e componenti di linguaggi di terza generazione ponderati per complessità e corretti per il riuso atteso. È un modello lineare senza fattori di scala o aggiustamenti esponenziali.
L'Early Design Model si usa prima che l'architettura sia stata definita. Prende in input gli Unadjusted Function Point, li converte in linee di codice sorgente equivalenti usando tabelle specifiche per linguaggio e applica sette driver di costo. Fornisce una stima ragionevole quando sai cosa dovrebbe fare il sistema ma non ancora come sarà costruito.
Il Post-Architecture Model è il più rigoroso dei tre. Si applica dopo che l'architettura software è definita, usando migliaia di linee di codice sorgente (KSLOC) o function point come input, 17 driver di costo e cinque fattori di scala. La formula dell'impegno è:
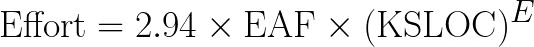
Dove E è un esponente dinamico calcolato come:
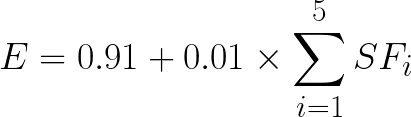
E la formula della pianificazione è:
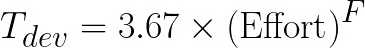
Dove:
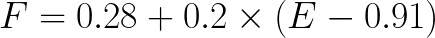
Le costanti 2,94, 0,91, 3,67 e 0,28 derivano dalla calibrazione COCOMO II.2000. Alcune fonti più vecchie citano 2,5 invece di 2,94; è un valore di calibrazione pre-2000 e non dovrebbe essere usato con il modello attuale. Il USC COCOMO II Web Tool su softwarecost.org è un'implementazione gratuita e live del modello Post-Architecture se vuoi eseguire stime senza fare i calcoli manualmente.
Due meccanismi fanno sì che COCOMO II funzioni diversamente da COCOMO I: fattori di scala e driver di costo. Ecco cosa fa ciascuno.
In COCOMO I, l'esponente b è fissato dalla modalità: scegli Organic, semi-detached o Embedded e ottieni un numero predefinito. COCOMO II lo sostituisce con cinque fattori di scala valutati in modo continuo che calcolano l'esponente in base a come li valuti.
I cinque fattori di scala in COCOMO II sono precedentedness (PREC), development flexibility (FLEX), architecture and risk resolution (RESL), team cohesion (TEAM) e process maturity (PMAT). Ciascuno è valutato su una scala da Very Low a Extra High e la loro somma combinata determina E nella formula dell'impegno. Una somma più alta indica un progetto meno maturo, meno familiare e più rischioso, quindi un esponente più alto e più impegno.
I fattori di scala influenzano la forma della curva dell'impegno. I driver di costo, invece, sono aggiustamenti moltiplicativi applicati all'impegno di base. COCOMO II ha 17 driver di costo nel modello Post-Architecture, rispetto ai 15 dell'Intermediate COCOMO I. Le aggiunte in COCOMO II includono fattori per riusabilità richiesta (RUSE), requisiti di documentazione (DOCU), volatilità della piattaforma (PVOL), continuità del personale (PCON), esperienza applicativa (APEX), esperienza sulla piattaforma (PLEX), esperienza con linguaggi e strumenti (LTEX) e sviluppo multisito (SITE).
Un driver di costo da evidenziare è SCED, che copre la pianificazione di sviluppo richiesta. Se comprimi significativamente una pianificazione, il moltiplicatore dell'impegno sale sopra 1,0, il che significa che ti servono effettivamente più persone-mese per finire prima. Questo rispecchia qualcosa che la maggior parte degli ingegneri già sa per esperienza: forzare un team a correre porta a overhead di coordinamento, errori e rework che spesso costano più del tempo risparmiato.
Il principale punto di forza del modello è la trasparenza. A differenza degli strumenti proprietari di stima, COCOMO pubblica tutte le sue equazioni, costanti e metodologie di calibrazione. Chiunque può verificare gli input e controllare gli output. Questo lo rende utile in ambito governativo, difesa e aerospaziale, dove l'audibilità matematica è spesso un requisito legale o contrattuale.
Il modello può anche essere ricalibrato. Le organizzazioni che raccolgono i propri dati storici di progetto possono adattare le costanti per riflettere il loro specifico ambiente, la composizione del team e lo stack tecnologico. È importante perché le costanti predefinite provengono da dataset che ormai hanno decenni.
La struttura a tre livelli (Basic → Intermediate → Detailed) è un altro vantaggio pratico. All'inizio di un progetto, quando si sa poco, si usa Basic per una stima approssimativa. Man mano che il progetto matura e si capisce di più su team e ambiente, si passa a Intermediate o Detailed per una pianificazione più raffinata.
La limitazione più grande è la dipendenza di COCOMO dai KLOC. Per usare COCOMO, devi stimare la dimensione di un progetto in linee di codice prima di scrivere qualsiasi codice. Nelle fasi iniziali di un progetto, proprio quando la stima conta di più, farlo accuratamente è notoriamente difficile.
Anche quando i KLOC possono essere stimati, le costanti in COCOMO I provengono da 63 progetti sviluppati con il modello a cascata tra il 1968 e il 1979. Le costanti in COCOMO II provengono da 161 progetti degli anni '90. Nessuno dei due dataset include sistemi cloud-native, applicazioni mobile, architetture a microservizi o pipeline DevOps moderne. Applicare direttamente queste costanti a un progetto moderno senza calibrazione locale produce stime inaffidabili.
Uno studio del 2025 ha quantificato la questione. Un Basic COCOMO non calibrato applicato a un dataset di progetti NASA ha prodotto un errore relativo medio di circa il 100%, senza previsioni entro il 25% dell'impegno reale. Non è un piccolo margine d'errore; riflette un modello usato fuori dalle condizioni per cui è stato costruito.
Il modello inoltre non gestisce bene lo sviluppo iterativo. COCOMO presume un ciclo di vita ragionevolmente sequenziale. I team Agile che lavorano in sprint brevi con backlog in evoluzione non si adattano alle assunzioni a cascata incorporate nella struttura di COCOMO.
C'è anche un problema più profondo. Un articolo pubblicato su Frontiers in Artificial Intelligence nel marzo 2026 ha sostenuto che COCOMO II è fondamentalmente disallineato con lo sviluppo software assistito dall'AI, non solo come questione di calibrazione ma strutturalmente. Quando gli strumenti di codifica AI generano porzioni sostanziali di una codebase, i KLOC come proxy dell'impegno umano diventano fuorvianti. L'impegno si concentra ora su verifica, governance architetturale e revisione della sicurezza, nessuna delle quali è stata progettata per essere catturata dal framework dei driver di costo di COCOMO.
COCOMO non è l'unica opzione. Conoscere le alternative ti aiuta a scegliere l'approccio giusto per una determinata situazione.
Function Point Analysis (FPA) misura la complessità del sistema a partire da input e output rivolti all'utente, indipendentemente dal linguaggio di programmazione. Funziona bene quando hai requisiti solidi ma non ancora una stima dei KLOC. L'Early Design model di COCOMO II accetta i function point come input, quindi i due possono essere usati insieme.
Gli Story Point sono standard negli ambienti Agile. I team valutano le user story per complessità relativa, quindi tracciano la velocity per proiettare i progressi. Sono rapidi e specifici del team, ma non producono la baseline di costo totale necessaria per procurement e pianificazione a lungo termine. COCOMO e gli story point servono scopi diversi.
Strumenti parametrici come SEER-SEM e SLIM usano database di calibrazione proprietari e set di parametri più ampi. Gli studi rilevano che superano COCOMO II non calibrato in accuratezza. Il vantaggio di COCOMO è la trasparenza e la disponibilità aperta, che conta in contesti accademici o soggetti ad audit.
Stime basate sul machine learning sono un'area di ricerca attiva. Uno studio del gennaio 2026 ha rilevato che modelli ensemble che combinano random forest, support vector regression e reti neurali hanno superato i modelli della famiglia COCOMO su dati di progetti Agile in tutte e quattro le metriche di valutazione standard. Questi approcci si adattano ai loro dati di training anziché basarsi su costanti fissate decenni fa.
Sapere dove si colloca COCOMO rispetto ad altri metodi è utile, ma il modo migliore per capire come funziona davvero è fare i conti. Vediamo un calcolo completo di Basic COCOMO I usando la modalità Organic e un progetto stimato in 50 KLOC.
Le costanti per la modalità Organic sono: a = 2,4, b = 1,05, c = 2,5, d = 0,38.
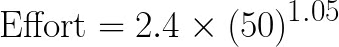
Per calcolare 501,05, usa il fatto che 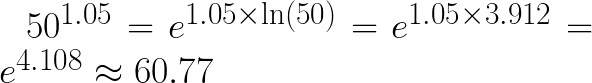 .
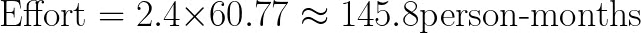
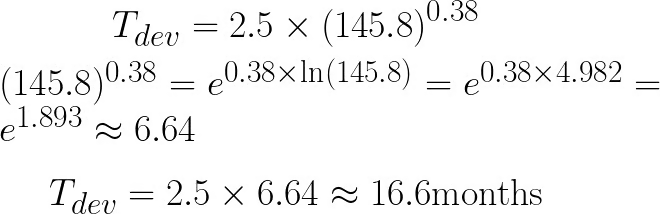
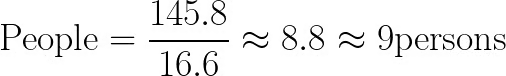
Riepilogo:
|
Output |
Valore |
|
Impegno |
~145,8 persone-mese |
|
Tempo di sviluppo |
~16,6 mesi |
|
Persone necessarie |
~9 persone |
Due cose da sottiolineare. Persone-mese e mesi di calendario sono unità diverse: 145,8 persone-mese in 16,6 mesi di calendario significano circa 9 persone che lavorano in parallelo. E dato che questo è Basic COCOMO, usa solo dimensione e modalità. Aggiungere valutazioni reali dei driver di costo tramite EAF sposterebbe la stima dell'impegno verso l'alto o verso il basso.
COCOMO compare in corsi accademici, esami universitari e colloqui per ruoli in ambito governativo, difesa e systems engineering. Raramente appare nelle aziende tech consumer agili.
La domanda più comune è COCOMO I contro COCOMO II: modalità fisse e costanti predefinite da 63 progetti contro cinque fattori di scala continui su un dataset moderno più ampio. Conoscere quella distinzione, le formule di base e i nomi delle tre modalità copre la maggior parte degli scenari. Talvolta gli intervistatori chiedono un calcolo di esempio, quindi vale la pena esercitarsi con l'esempio svolto sopra.
COCOMO resta utile dove le sue assunzioni valgono: sviluppo sequenziale, procurement formale e studio accademico. Dove il software moderno se ne discosta, il modello va in difficoltà.
Usa Basic COCOMO per un rapido controllo d'ordine di grandezza nelle fasi iniziali. Usa Intermediate COCOMO quando hai dati su team e ambiente con cui lavorare. Calibra sui tuoi storici di progetto prima di fare affidamento su qualsiasi output in un'offerta o piano reale. Come spiegato nella sezione Limitazioni, applicare le costanti di default a un progetto moderno senza calibrazione produce errori troppo grandi per essere operativi.
COCOMO III è in sviluppo presso il Boehm CSSE da circa il 2015, senza una release pubblica a marzo 2026. L'originale del 1981 e il suo aggiornamento del 2000 restano il punto di riferimento.
Vuoi andare oltre con lo sviluppo software? Abbiamo corsi su Principi di ingegneria del software in Python, Sviluppo software con Cursor e Sviluppo software con GitHub Copilot per aiutarti a mettere in pratica ciò che hai imparato qui.
Impara con DataCamp
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {blog} other {blogs}}
Tim Lu
12 min
{count, plural, one {blog} other {blogs}}
Abid Ali Awan
10 min
{count, plural, one {blog} other {blogs}}
Abid Ali Awan
15 min