{count, plural, one {Curso} other {Cursos}}
Princípios de Engenharia de Software em Python
{hours} h
70.6K
Você já teve que dizer quanto tempo um projeto de software vai levar e percebeu que sua melhor resposta era, na prática, um chute?
Era assim que a maioria dos times fazia estimativa de custos em engenharia de software nos anos 1970. Projetos estouravam orçamento e prazo com frequência, e os métodos usados, em geral julgamento de especialistas e analogias grosseiras, não se sustentavam conforme os sistemas cresciam em tamanho e complexidade.
O COCOMO surgiu para resolver isso. A sigla significa COnstructive COst MOdel. Barry W. Boehm o apresentou em seu livro de 1981, Software Engineering Economics, baseando as fórmulas em dados reais de projetos, não em intuição. Ele se tornou um dos modelos de estimativa algorítmica mais ensinados na área. Boehm, que faleceu em agosto de 2022, passou décadas refinando as ideias por trás do modelo.
Neste tutorial, vou mostrar como o modelo funciona, o que significam os diferentes tipos e níveis, e fazer um exemplo numérico completo para que os números façam sentido na prática.
COCOMO é um modelo paramétrico de estimativa de custos de software. Ele tem um insumo principal: o tamanho estimado do projeto medido em milhares de linhas de código (KLOC). A partir disso, prevê três coisas: esforço total em pessoa-mês (PM), tempo de desenvolvimento em meses e o número de pessoas necessárias.
O modelo assume que o tamanho do projeto é o principal preditor do esforço. Boehm definiu as constantes do modelo executando análise de regressão em dados históricos reais de projetos.
Dito isso, o COCOMO não estima o custo monetário diretamente. Ele estima o esforço. Para converter pessoa-mês em reais, você multiplica pelo custo médio de mão de obra por pessoa-mês na sua organização. O modelo entrega o esforço; você fornece a taxa.
Boehm atuava como Diretor de Pesquisa e Tecnologia de Software na TRW Aerospace, e a frustração era imediata e prática. Segundo um tributo publicado posteriormente pela Academia Nacional de Engenharia dos EUA, um vice-presidente da TRW disse a Boehm após revisar uma proposta competitiva de software: "Nunca mais quero ter que aprovar uma proposta de software baseada apenas em fé. Vá e invente uma forma crível de estimar o custo de desenvolver um produto de software."
Esse pedido virou o COCOMO. Boehm estudou 63 projetos concluídos na TRW, cobrindo softwares de 2.000 a 100.000 linhas de código, escritos em linguagens que iam de assembly a PL/I, todos desenvolvidos sob o modelo em cascata (waterfall). A regressão nesse conjunto de dados gerou as constantes usadas no COCOMO I, e o modelo foi publicado em 1981.
A matemática por trás do Basic COCOMO I é simples quando você entende o que cada termo representa.
A fórmula do esforço é:
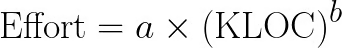
Aqui, o esforço é medido em pessoa-mês, KLOC é o tamanho estimado do software em milhares de linhas de código, e a e b são constantes que dependem do tipo de projeto em que você está trabalhando.
A fórmula do tempo de desenvolvimento deriva da estimativa de esforço:
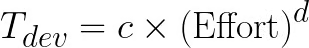
A constante d varia por modo, enquanto c é fixa em 2,5 nos três. Muitos tutoriais erram ao sugerir que todas as quatro constantes mudam. Com Esforço e calculados, você pode estimar o número médio de pessoas necessárias:
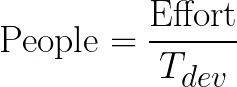
A tabela abaixo mostra as constantes verificadas para o Basic COCOMO I:
|
Modo do projeto |
a |
b |
c |
d |
|
Orgânico |
2.4 |
1.05 |
2.5 |
0.38 |
|
Semi-destacado |
3.0 |
1.12 |
2.5 |
0.35 |
|
Embarcado |
3.6 |
1.20 |
2.5 |
0.32 |
A variável-chave aqui é b. Para projetos orgânicos, b = 1,05, o que significa que o esforço cresce quase linearmente com o tamanho do projeto. Para projetos embarcados, b = 1,20, o que cria uma forte deseconomia de escala: dobrar o tamanho de um projeto embarcado mais do que dobra o esforço necessário.
O COCOMO I categoriza projetos de software em três modos de desenvolvimento. Cada modo reflete uma combinação diferente de experiência do time, complexidade do projeto e restrições operacionais. O modo escolhido determina quais constantes entram nas suas fórmulas.
Vale destacar logo de início: esses três modos se aplicam apenas ao COCOMO I. O COCOMO II, a atualização de 2000, os substituiu por uma abordagem diferente.
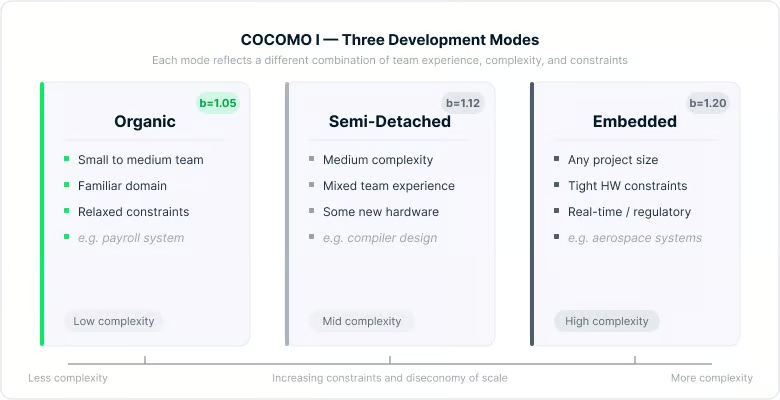
Três modos do COCOMO I comparados visualmente. Imagem do autor.
Os três modos ficam em uma escala de complexidade e restrição crescentes. O tipo de projeto e o contexto do seu time normalmente deixam claro qual se aplica.
O modo orgânico cobre projetos pequenos a médios em que o time tem boa experiência no domínio da aplicação, os requisitos são relativamente bem entendidos e não há grande pressão externa por restrições de hardware ou exigências regulatórias. Um sistema de folha de pagamento, um aplicativo de processamento de dados ou uma ferramenta de gestão de estoque normalmente entram aqui.
Como o time é experiente e o domínio é familiar, a sobrecarga de comunicação se mantém baixa mesmo com o crescimento do projeto. Por isso o expoente b é o menor dos três modos.
O modo semi-destacado fica no meio. Times nessa categoria têm experiência mista: alguns membros conhecem bem o domínio, outros não. O projeto tem complexidade moderada e pode haver alguma interação com novo hardware ou sistemas externos.
Desenvolvimento de compiladores, sistemas de processamento de transações e aplicativos corporativos de médio porte são exemplos comuns. A deseconomia de escala é mais perceptível aqui, com b = 1,12.
O modo embarcado se aplica a projetos com fortes restrições operacionais: requisitos rígidos de hardware, demandas de processamento em tempo real, normas regulatórias ou exigências aeroespaciais e de defesa. O time pode ser grande e tecnicamente qualificado, mas a complexidade de integração, testes e validação faz o esforço disparar conforme o projeto cresce.
Com b = 1,20, projetos embarcados têm a maior deseconomia de escala entre os três modos. O modo embarcado não depende do tamanho: mesmo um sistema embarcado relativamente pequeno se enquadra se operar sob restrições severas.
Além dos três modos de projeto, o COCOMO I tem três níveis de detalhamento da estimativa. Os modos dizem quais constantes usar; os níveis dizem a profundidade do modelo do projeto. Cada nível se apoia no anterior adicionando mais fatores ao cálculo, o que aumenta a precisão ao custo de mais dados de entrada.
Pense como um espectro: o Basic COCOMO dá um chute inicial rápido, enquanto o Detailed COCOMO permite planejar com precisão por fase.
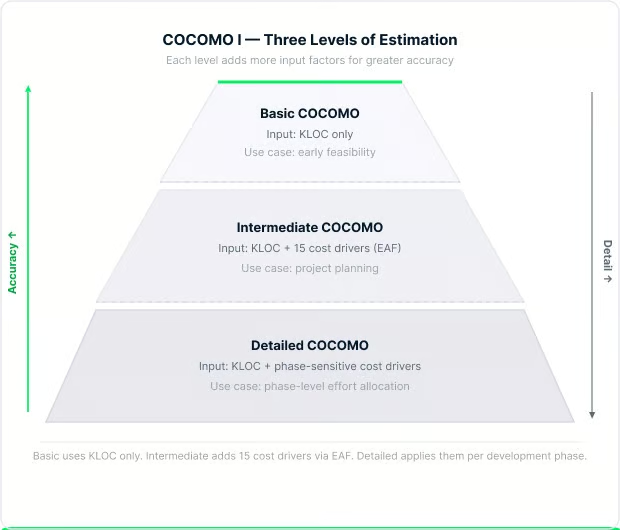
Níveis do COCOMO I por profundidade de detalhamento da estimativa. Imagem do autor.
Descer a pirâmide adiciona fatores ao cálculo, aumentando a precisão, mas exigindo mais dados para começar.
O Basic COCOMO usa apenas o tamanho do projeto em KLOC e o modo do projeto. Você insere o KLOC, aplica as constantes do modo escolhido e obtém uma estimativa de esforço. É útil em avaliações iniciais de viabilidade, quando ainda não há muitos detalhes sobre seu time ou ambiente de desenvolvimento.
O Intermediate COCOMO introduz um Fator de Ajuste de Esforço, normalmente escrito como EAF. A lista completa de multiplicadores (cost drivers) está documentada no COCOMO II Model Definition Manual. A fórmula de esforço fica:
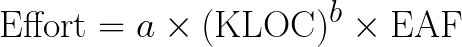
O EAF é o produto de 15 cost drivers, cada um avaliado numa escala de Muito Baixo a Extra Alto. Eles caem em quatro categorias: atributos do produto (confiabilidade, complexidade, tamanho do banco de dados), atributos de hardware (restrições de tempo de execução e armazenamento), atributos de pessoal (experiência e capacidade do time) e atributos de projeto (ferramentas, pressão de cronograma e práticas de desenvolvimento).
Um ponto sobre o Intermediate COCOMO: a constante a muda em relação aos valores do Basic. No modo orgânico, a vira 3,2 (não 2,4). No modo semi-destacado, permanece 3,0. No modo embarcado, cai para 2,8. Os expoentes b, c e d permanecem iguais entre os níveis Basic e Intermediate.
Cost drivers de pessoal são invertidos: maior capacidade implica multiplicador menor, reduzindo a estimativa de esforço. Um time experiente simplesmente precisa de menos pessoa-mês que um time iniciante para concluir o mesmo projeto.
O Detailed COCOMO, às vezes chamado de Advanced COCOMO, aplica multiplicadores de esforço no nível de cada fase, em vez de no projeto todo. Ou seja, os cost drivers para análise de requisitos, projeto detalhado, codificação e integração e testes são avaliados separadamente.
É o nível mais preciso e também o mais trabalhoso de usar. Faz sentido para projetos grandes em que times diferentes são donos de fases distintas e em que a distribuição de esforço por fase importa para o planejamento.
Em meados dos anos 1990, o COCOMO I já mostrava sinais da idade. O desenvolvimento de software migrou do waterfall em mainframes para programação orientada a objetos, bibliotecas de componentes reutilizáveis, prototipagem rápida e sistemas distribuídos. Aplicar dados de projetos dos anos 1970 a ambientes dos anos 1990 gerava estimativas pouco confiáveis.
Boehm e colegas no USC Center for Software Engineering passaram anos reconstruindo o modelo do zero. O resultado foi o COCOMO II, publicado em 2000 no livro Software Cost Estimation with COCOMO II, calibrado com um conjunto de 161 projetos, mais que o dobro dos 63 do modelo original.
As motivações por trás do COCOMO II incluíram desenvolvimento orientado a objetos e baseado em componentes, reutilização de software e integração de produtos prontos (COTS), modelos iterativos e espirais de desenvolvimento e ferramentas modernas. Um equívoco comum a esclarecer: o COCOMO II não foi criado para o Agile. O Agile como conhecemos hoje mal existia quando o modelo foi desenvolvido entre 1995 e 2000.
O COCOMO II oferece três submodelos, cada um adequado a uma fase do ciclo de vida do projeto.
O Application Composition Model foi pensado para prototipagem inicial, especialmente quando times usam construtores de GUI e bibliotecas de componentes. Em vez de KLOC, usa Object Points: telas, relatórios e componentes de linguagens de terceira geração ponderados por complexidade e ajustados para reutilização esperada. É um modelo linear, sem fatores de escala ou ajustes exponenciais.
O Early Design Model é usado antes da definição da arquitetura. Ele recebe Function Points não ajustados como entrada, converte para linhas de código equivalentes usando tabelas por linguagem e aplica sete cost drivers. Fornece uma estimativa razoável quando você sabe o que o sistema deve fazer, mas ainda não como será construído.
O Post-Architecture Model é o mais rigoroso. É aplicado após a definição da arquitetura, usando milhares de linhas de código-fonte (KSLOC) ou function points como entrada, 17 cost drivers e cinco fatores de escala. A fórmula de esforço é:
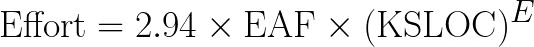
Onde E é um expoente dinâmico calculado como:
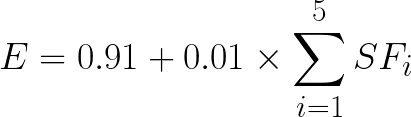
E a fórmula do cronograma é:
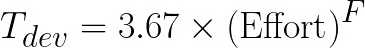
Onde:
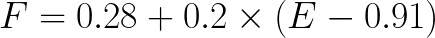
As constantes 2,94, 0,91, 3,67 e 0,28 vêm da calibração COCOMO II.2000. Algumas fontes antigas citam 2,5 em vez de 2,94; isso é pré-2000 e não deve ser usado com o modelo atual. A USC COCOMO II Web Tool em softwarecost.org é uma implementação gratuita e online do modelo Post-Architecture para você rodar estimativas sem fazer a conta na mão.
Dois mecanismos diferenciam o COCOMO II do COCOMO I: fatores de escala e cost drivers. Veja o papel de cada um.
No COCOMO I, o expoente b é fixo por modo: você escolhe Orgânico, Semi-destacado ou Embarcado e recebe um número pré-definido. O COCOMO II substitui isso por cinco fatores de escala continuamente avaliados, que calculam o expoente com base em como você pontua cada um.
Os cinco fatores de escala do COCOMO II são precedência (PREC), flexibilidade de desenvolvimento (FLEX), arquitetura e resolução de riscos (RESL), coesão do time (TEAM) e maturidade de processo (PMAT). Cada um é avaliado de Muito Baixo a Extra Alto, e a soma combinada determina E na fórmula de esforço. Uma soma maior indica um projeto menos maduro, menos familiar e mais arriscado, o que implica expoente maior e mais esforço.
Fatores de escala afetam o formato da curva de esforço. Já os cost drivers são ajustes multiplicativos aplicados ao esforço-base. O COCOMO II tem 17 cost drivers no modelo Post-Architecture, contra 15 no Intermediate COCOMO I. As adições no COCOMO II incluem fatores de reutilização requerida (RUSE), exigência de documentação (DOCU), volatilidade da plataforma (PVOL), continuidade de pessoal (PCON), experiência na aplicação (APEX), experiência na plataforma (PLEX), experiência em linguagem e ferramentas (LTEX) e desenvolvimento multi-site (SITE).
Um cost driver que vale o destaque é o SCED, que cobre o cronograma exigido. Se você comprime muito o cronograma, o multiplicador de esforço sobe acima de 1,0, ou seja, paradoxalmente são necessários mais pessoa-mês para entregar mais rápido. Isso bate com o que muitos engenheiros já sabem: forçar maratonas aumenta a sobrecarga de coordenação, erros e retrabalho, muitas vezes custando mais que o tempo “ganho”.
A principal força do modelo é a transparência. Diferente de ferramentas proprietárias, o COCOMO publica todas as equações, constantes e metodologia de calibração. Qualquer pessoa pode auditar entradas e verificar saídas. Isso o torna útil em compras públicas, defesa e aeroespacial, onde auditabilidade matemática costuma ser exigência legal ou contratual.
O modelo também pode ser recalibrado. Organizações que coletam seu próprio histórico de projetos podem ajustar as constantes para refletir seu ambiente específico, composição de time e stack tecnológico. Isso é importante porque as constantes padrão vêm de bases de dados de décadas atrás.
A estrutura em três níveis (Basic → Intermediate → Detailed) é outro benefício prático. No início, quando pouco se sabe, usa-se o Basic para uma estimativa de ordem de grandeza. Com a evolução do projeto e mais entendimento sobre time e ambiente, avança-se para Intermediate ou Detailed para um planejamento mais refinado.
A maior limitação é a dependência do COCOMO em KLOC. Para usar o COCOMO, é preciso estimar o tamanho em linhas de código antes de escrever qualquer código. Nas fases iniciais, justamente quando a estimativa mais importa, isso é notoriamente difícil de fazer com precisão.
Mesmo quando o KLOC é estimável, as constantes do COCOMO I vêm de 63 projetos construídos sob o modelo waterfall entre 1968 e 1979. As do COCOMO II vêm de 161 projetos dos anos 1990. Nenhum desses conjuntos inclui sistemas cloud-native, apps móveis, arquiteturas de microsserviços ou pipelines modernos de DevOps. Aplicar essas constantes diretamente a um projeto moderno sem calibração local gera estimativas pouco confiáveis.
Um estudo de 2025 quantificou isso. Um COCOMO Básico não calibrado aplicado a um dataset da NASA apresentou erro relativo médio de aproximadamente 100%, sem previsões dentro de 25% do esforço real. Não é uma margem pequena; reflete o uso do modelo fora das condições para as quais foi criado.
O modelo também não lida bem com desenvolvimento iterativo. O COCOMO assume um ciclo razoavelmente sequencial. Times ágeis que trabalham em sprints curtos com backlogs em evolução não se encaixam nas premissas waterfall embutidas na estrutura do COCOMO.
Há ainda um problema mais profundo. Um artigo publicado na Frontiers in Artificial Intelligence em março de 2026 argumentou que o COCOMO II está fundamentalmente desalinhado com o desenvolvimento de software assistido por IA, não só por calibração, mas estruturalmente. Quando ferramentas de IA geram partes substanciais do código, KLOC como proxy de esforço humano se torna enganoso. O esforço passa a se concentrar em verificação, governança de arquitetura e revisão de segurança — áreas que o framework de cost drivers do COCOMO não foi desenhado para capturar.
O COCOMO não é a única opção. Conhecer as alternativas ajuda a escolher a abordagem certa para cada situação.
Análise de Pontos de Função (FPA) mede a complexidade do sistema a partir de entradas e saídas ao usuário, independente da linguagem. Funciona bem quando você tem requisitos sólidos, mas ainda não uma estimativa de KLOC. O modelo Early Design do COCOMO II aceita function points como entrada, então ambos podem ser usados em conjunto.
Story Points são padrão em ambientes ágeis. Os times avaliam histórias por complexidade relativa e acompanham a velocidade para projetar o progresso. São rápidos e específicos do time, mas não geram a linha de base de custo total que compras e planejamento de longo prazo exigem. COCOMO e story points têm propósitos diferentes.
Ferramentas paramétricas como SEER-SEM e SLIM usam bases proprietárias de calibração e conjuntos de parâmetros mais amplos. Estudos indicam desempenho superior ao COCOMO II não calibrado em acurácia. A vantagem do COCOMO é a transparência e disponibilidade aberta, o que importa em contextos acadêmicos ou auditáveis.
Estimativa baseada em machine learning é uma área de pesquisa ativa. Um estudo de janeiro de 2026 mostrou que modelos em ensemble combinando random forests, support vector regression e redes neurais superaram modelos da família COCOMO em dados de projetos ágeis em todas as quatro métricas padrão. Essas abordagens se adaptam aos dados de treino, em vez de depender de constantes definidas décadas atrás.
Saber onde o COCOMO se encaixa em relação a outros métodos é útil, mas a melhor forma de entender como ele funciona é colocar os números. Vamos passar por um cálculo completo do Basic COCOMO I usando o modo orgânico e um projeto estimado em 50 KLOC.
As constantes do modo orgânico são: a = 2,4, b = 1,05, c = 2,5, d = 0,38.
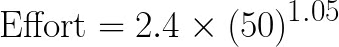
Para calcular 501,05, use o fato de que 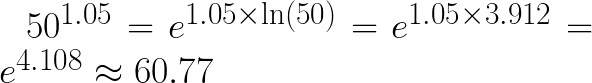 .
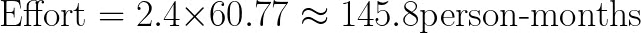
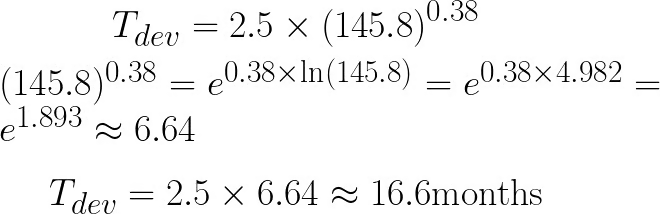
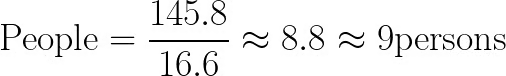
Resumo:
|
Saída |
Valor |
|
Esforço |
~145,8 pessoa-mês |
|
Tempo de desenvolvimento |
~16,6 meses |
|
Pessoas necessárias |
~9 pessoas |
Duas coisas que valem destacar. Pessoa-mês e mês de calendário são unidades diferentes: 145,8 pessoa-mês ao longo de 16,6 meses de calendário significa cerca de 9 pessoas trabalhando em paralelo. E como este é o Basic COCOMO, ele usa só tamanho e modo. Adicionar avaliações reais de cost drivers via EAF deslocaria a estimativa de esforço para cima ou para baixo a partir daí.
COCOMO aparece em cursos acadêmicos, provas universitárias e entrevistas para cargos em governo, defesa e engenharia de sistemas. Raramente surge em empresas de tecnologia de consumo com cultura ágil.
A pergunta mais comum é COCOMO I versus COCOMO II: modos fixos e constantes pré-definidas de 63 projetos versus cinco fatores de escala contínuos em um dataset moderno maior. Saber essa distinção, as fórmulas básicas e os três nomes de modos cobre a maioria dos cenários. Entrevistadores ocasionalmente pedem um cálculo de exemplo, então vale praticar o exercício acima.
O COCOMO continua útil onde suas premissas se mantêm: desenvolvimento sequencial, compras formais e estudo acadêmico. Onde o software moderno diverge dessas condições, ele perde força.
Use o Basic COCOMO para um check rápido de ordem de grandeza no início do projeto. Use o Intermediate COCOMO quando você já tiver dados sobre time e ambiente. Calibre com seu histórico antes de confiar em qualquer saída em uma proposta ou plano real. Como mostrei na seção de limitações, aplicar constantes padrão a um projeto moderno sem calibração gera erros grandes demais para orientar decisões.
O COCOMO III está em desenvolvimento no Boehm CSSE desde cerca de 2015, sem lançamento público até março de 2026. O original de 1981 e a atualização de 2000 seguem como referência.
Quer avançar em desenvolvimento de software? Temos cursos de Software Engineering Principles in Python, Software Development with Cursor e Software Development with GitHub Copilot para ajudar você a colocar em prática o que aprendeu aqui.
Aprenda com a DataCamp
{count, plural, one {Curso} other {Cursos}}
{count, plural, one {Curso} other {Cursos}}
{count, plural, one {Curso} other {Cursos}}
{count, plural, one {blog} other {blogs}}
Joyce Chiu
8 min
{count, plural, one {blog} other {blogs}}
Natassha Selvaraj
15 min
{count, plural, one {blog} other {blogs}}
Elena Kosourova
14 min
{count, plural, one {blog} other {blogs}}
Javier Canales Luna
14 min
{count, plural, one {Tutorial} other {Tutoriais}}
Abid Ali Awan
15 min
{count, plural, one {Tutorial} other {Tutoriais}}
Eladio Montero Porras
15 min