{count, plural, one {Cours} other {Cours}}
Principes de génie logiciel en Python
{hours} h
70.6K
Vous a-t-on déjà demandé combien de temps prendrait un projet logiciel et vous êtes-vous rendu compte que votre meilleure réponse relevait surtout de l’intuition ?
C’est ainsi que la plupart des équipes abordaient l’ingénierie logicielle et l’estimation des coûts dans les années 1970. Les projets dépassaient régulièrement les budgets et les délais, et les méthodes utilisées, principalement le jugement d’expert et des analogies approximatives, ne tenaient plus la route à mesure que les systèmes gagnaient en taille et en complexité.
COCOMO a été conçu pour corriger cela. Il signifie COnstructive COst MOdel. Barry W. Boehm l’a présenté dans son ouvrage de 1981, Software Engineering Economics, en fondant les formules sur des données de projets réels plutôt que sur l’intuition. Il est devenu l’un des modèles d’estimation algorithmique les plus enseignés dans le domaine. Boehm, décédé en août 2022, a passé des décennies à affiner les idées qui le sous-tendent.
Dans ce tutoriel, je vais vous expliquer le fonctionnement du modèle, la signification de ses différents types et niveaux, et dérouler un exemple numérique complet pour donner du sens aux chiffres en pratique.
COCOMO est un modèle paramétrique d’estimation des coûts logiciels. Il prend un intrant principal : la taille estimée d’un projet logiciel mesurée en milliers de lignes de code (KLOC), et l’utilise pour prédire trois éléments : l’effort total en hommes-mois (PM), le temps de développement en mois, et le nombre de personnes nécessaires.
Le modèle suppose que la taille du projet est le principal prédicteur de l’effort. Boehm a établi les constantes du modèle en réalisant une analyse de régression sur des données historiques de projets réels.
Cela dit, COCOMO n’estime pas directement le coût monétaire. Il estime l’effort. Pour convertir des hommes-mois en dollars, multipliez par le coût moyen de la main-d’œuvre par homme-mois dans votre organisation. Le modèle fournit l’effort ; vous fournissez le taux.
Boehm travaillait comme directeur de la recherche et de la technologie logicielles chez TRW Aerospace, et la frustration était immédiate et concrète. Selon un hommage publié plus tard par la National Academy of Engineering, un vice-président de TRW lui a dit après avoir examiné une offre logicielle concurrente : « Je ne veux plus jamais valider une offre logicielle sur la foi seule. Allez inventer un moyen crédible d’estimer le coût de développement d’un produit logiciel. »
Cette demande a donné naissance à COCOMO. Boehm a étudié 63 projets achevés chez TRW, couvrant des logiciels de 2 000 à 100 000 lignes de code, écrits dans des langages allant de l’assembleur à PL/I, tous conçus selon le modèle en cascade. L’analyse de régression sur cet ensemble de données a produit les constantes utilisées dans COCOMO I, et le modèle a été rendu public en 1981.
Les mathématiques derrière Basic COCOMO I sont simples dès lors que l’on comprend ce que représente chaque terme.
La formule de l’effort est :
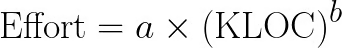
Ici, l’effort est mesuré en hommes-mois, KLOC est la taille logicielle estimée en milliers de lignes de code, et a et b sont des constantes qui dépendent du type de projet sur lequel vous travaillez.
La formule du temps de développement découle de l’estimation de l’effort :
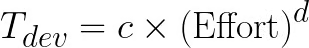
La constante d varie selon le mode, tandis que c est fixée à 2,5 dans les trois cas. Beaucoup de tutoriels se trompent en laissant entendre que les quatre constantes changent. Une fois que vous avez l’effort et , vous pouvez estimer le nombre moyen de personnes nécessaires :
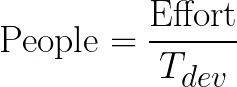
Le tableau ci-dessous présente les constantes vérifiées pour Basic COCOMO I :
|
Mode de projet |
a |
b |
c |
d |
|
Organic |
2,4 |
1,05 |
2,5 |
0,38 |
|
Semi-Detached |
3,0 |
1,12 |
2,5 |
0,35 |
|
Embedded |
3,6 |
1,20 |
2,5 |
0,32 |
La variable clé ici est b. Pour les projets Organic, b = 1,05, ce qui signifie que l’effort croît presque linéairement avec la taille. Pour les projets Embedded, b = 1,20, ce qui crée une forte déséconomie d’échelle : doubler la taille d’un projet embarqué plus que double l’effort requis.
COCOMO I classe les projets logiciels en trois modes de développement. Chaque mode reflète une combinaison différente d’expérience d’équipe, de complexité du projet et de contraintes opérationnelles. Le mode choisi détermine les constantes à utiliser dans vos formules.
À noter d’emblée : ces trois modes s’appliquent uniquement à COCOMO I. COCOMO II, la mise à jour de 2000, les a remplacés par une approche différente.
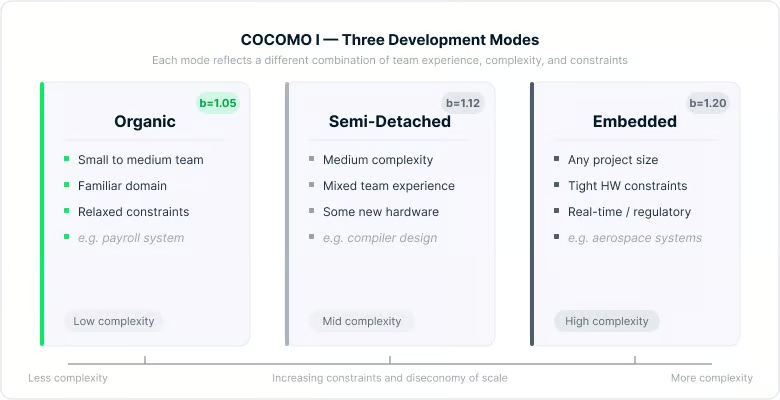
Comparaison visuelle des trois modes COCOMO I. Image de l’auteur.
Les trois modes s’inscrivent sur une échelle de complexité et de contraintes croissantes. Le type de projet et le contexte d’équipe rendent généralement évident celui qui s’applique.
Le mode Organic couvre les projets de petite à moyenne taille où l’équipe a une solide expérience du domaine d’application, où les exigences sont relativement bien comprises, et où il n’y a pas de fortes contraintes externes liées au matériel ou à la réglementation. Un système de paie, une application de traitement de données ou un outil de gestion d’inventaire relèvent typiquement de cette catégorie.
Parce que l’équipe est expérimentée et le domaine familier, la charge de communication reste faible même lorsque le projet grandit. C’est pourquoi l’exposant b est le plus petit des trois modes.
Le mode semi-detached se situe au milieu. Les équipes y ont une expérience mixte : certains membres maîtrisent bien le domaine, d’autres moins. Le projet a une complexité modérée, et peut impliquer des interactions avec du matériel nouveau ou des systèmes externes.
Le développement de compilateurs, les systèmes de traitement de transactions et les applications métiers de milieu de gamme en sont des exemples courants. La déséconomie d’échelle y est plus marquée, avec b = 1,12.
Le mode embedded s’applique aux projets soumis à de fortes contraintes opérationnelles : exigences matérielles strictes, besoins de traitement en temps réel, normes réglementaires, ou impératifs aérospatiaux et de défense. L’équipe peut être importante et très qualifiée, mais la complexité de l’intégration, des tests et de la validation fait grimper fortement l’effort à mesure que la taille du projet augmente.
Avec b = 1,20, les projets embedded présentent la plus forte déséconomie d’échelle des trois modes. Le mode embedded n’est pas non plus une question de taille : même un système embarqué relativement petit y entre s’il opère sous de fortes contraintes.
Au-delà des trois modes de projet, COCOMO I comporte trois niveaux de détail d’estimation. Les modes indiquent quelles constantes utiliser ; les niveaux indiquent la profondeur de modélisation du projet. Chaque niveau s’appuie sur le précédent en ajoutant des facteurs de calcul, ce qui accroît la précision au prix de davantage de données d’entrée.
Voyez cela comme un continuum : Basic COCOMO fournit une estimation rapide d’ordre de grandeur, tandis que Detailed COCOMO permet une planification précise par phase.
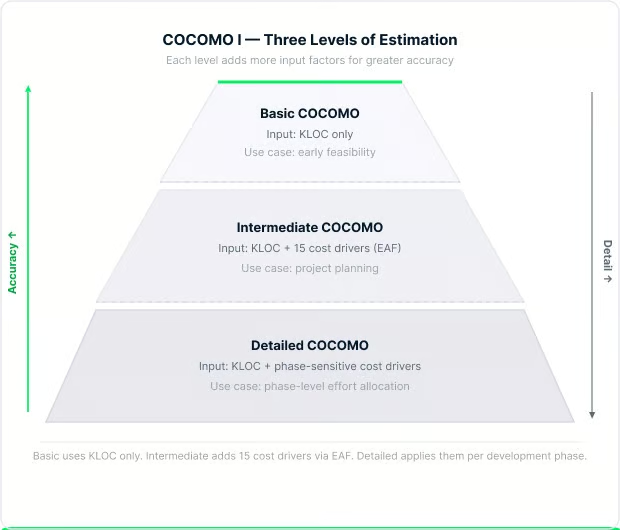
Niveaux COCOMO I par profondeur de détail d’estimation. Image de l’auteur.
Descendre dans la pyramide ajoute des facteurs au calcul, ce qui accroît la précision mais nécessite plus de données pour démarrer.
Basic COCOMO n’utilise que la taille du projet en KLOC et le mode de projet. Vous renseignez le KLOC, appliquez les constantes du mode choisi, et obtenez une estimation d’effort. C’est utile pour les évaluations de faisabilité initiales, quand vous ne disposez pas encore d’informations détaillées sur votre équipe ou votre environnement de développement.
Intermediate COCOMO introduit un facteur d’ajustement de l’effort, généralement noté EAF. La liste complète des multiplicateurs de facteurs de coût est documentée dans le COCOMO II Model Definition Manual. La formule d’effort devient :
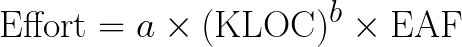
Le EAF est le produit de 15 facteurs de coût, chacun noté de Très faible à Extra élevé. Ils se répartissent en quatre catégories : attributs du produit (fiabilité, complexité, taille de base de données), attributs matériels (contraintes de temps d’exécution et de stockage), attributs du personnel (expérience et capacité de l’équipe), et attributs du projet (outillage, pression sur le planning, pratiques de développement).
Un point à connaître sur Intermediate COCOMO : la constante a change par rapport aux valeurs de Basic. Pour le mode Organic, a devient 3,2 (et non 2,4). Pour le mode semi-detached, elle reste à 3,0. Pour le mode Embedded, elle descend à 2,8. Les exposants b, c et d restent identiques entre Basic et Intermediate.
Les facteurs liés au personnel sont inversés : une plus grande capacité signifie un multiplicateur plus faible, ce qui réduit l’estimation d’effort. Une équipe de développeurs expérimentés a tout simplement besoin de moins d’hommes-mois pour terminer un projet qu’une équipe débutante.
Detailed COCOMO, parfois appelé Advanced COCOMO, applique les multiplicateurs d’effort au niveau de chaque phase plutôt qu’au projet dans son ensemble. Cela signifie que les facteurs de coût pour l’analyse des exigences, la conception détaillée, le codage, puis l’intégration et les tests sont évalués séparément.
C’est le niveau le plus précis, mais aussi le plus chronophage. Il est pertinent pour les grands projets où différentes équipes possèdent différentes phases et où la répartition de l’effort entre phases compte pour la planification.
À la moitié des années 1990, COCOMO I montrait ses limites. Le développement logiciel était passé de projets en cascade sur mainframes à la programmation orientée objet, aux bibliothèques de composants réutilisables, au prototypage rapide et aux systèmes distribués sur postes de travail. Appliquer des données de projets des années 1970 à des environnements logiciels des années 1990 produisait des estimations peu fiables.
Boehm et ses collègues du USC Center for Software Engineering ont passé plusieurs années à reconstruire le modèle depuis zéro. Le résultat fut COCOMO II, publié en 2000 dans le livre Software Cost Estimation with COCOMO II, étalonné sur un jeu de 161 projets, plus du double des 63 du modèle original.
Les motivations de COCOMO II incluent le développement orienté objet et basé sur composants, la réutilisation logicielle et l’intégration de progiciels, les modèles de développement itératifs et en spirale, et des outils modernes. Une idée reçue à corriger : COCOMO II n’a pas été conçu pour l’Agile. L’Agile tel que nous le connaissons aujourd’hui existait à peine lorsque le modèle a été élaboré entre 1995 et 2000.
COCOMO II propose trois sous-modèles, chacun adapté à une phase différente du cycle de vie d’un projet.
Le Application Composition Model est conçu pour le prototypage amont, notamment lorsque les équipes utilisent des constructeurs d’IHM et des bibliothèques de composants. Au lieu du KLOC, il utilise des Object Points : écrans, rapports et composants de langages de troisième génération, pondérés par complexité et ajustés pour la réutilisation prévue. C’est un modèle linéaire, sans facteurs d’échelle ni ajustements exponentiels.
Le Early Design Model s’utilise avant que l’architecture ne soit établie. Il prend en entrée des Function Points non ajustés, les convertit en lignes de code sources équivalentes via des tables spécifiques aux langages, et applique sept facteurs de coût. Il fournit une estimation raisonnable lorsque vous savez ce que le système doit faire sans encore savoir comment il sera construit.
Le Post-Architecture Model est le plus rigoureux des trois. Il s’emploie une fois l’architecture logicielle arrêtée, en utilisant des milliers de lignes de code source (KSLOC) ou des points de fonction en entrée, 17 facteurs de coût et cinq facteurs d’échelle. La formule d’effort est :
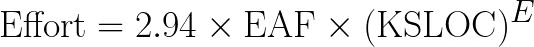
Où E est un exposant dynamique calculé comme suit :
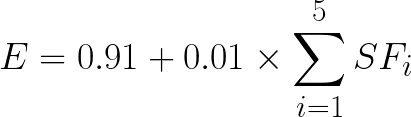
Et la formule du planning est :
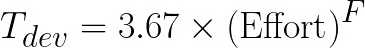
Où :
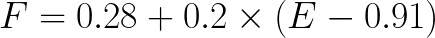
Les constantes 2,94, 0,91, 3,67 et 0,28 proviennent de l’étalonnage COCOMO II.2000. Certaines sources plus anciennes citent 2,5 au lieu de 2,94 : c’est une valeur antérieure à 2000 qui ne doit pas être utilisée avec le modèle actuel. Le USC COCOMO II Web Tool sur softwarecost.org est une implémentation gratuite et en ligne du modèle Post-Architecture si vous souhaitez faire des estimations sans calculer à la main.
Deux mécanismes distinguent COCOMO II de COCOMO I : les facteurs d’échelle et les facteurs de coût. Voici le rôle de chacun.
Dans COCOMO I, l’exposant b est fixé par mode : vous choisissez Organic, semi-detached ou Embedded, et vous obtenez une valeur prédéfinie. COCOMO II remplace cela par cinq facteurs d’échelle évalués de manière continue qui calculent l’exposant en fonction de vos notations.
Les cinq facteurs d’échelle de COCOMO II sont la précédence (PREC), la flexibilité de développement (FLEX), l’architecture et la résolution des risques (RESL), la cohésion d’équipe (TEAM) et la maturité des processus (PMAT). Chacun est noté de Très faible à Extra élevé, et leur somme combinée détermine E dans la formule d’effort. Une somme plus élevée signifie un projet moins mûr, moins familier et plus risqué, donc un exposant plus grand et davantage d’effort.
Les facteurs d’échelle influencent la forme de la courbe d’effort. Les facteurs de coût, eux, sont des ajustements multiplicatifs appliqués à l’effort de base. COCOMO II en compte 17 dans le modèle Post-Architecture, contre 15 dans COCOMO I intermédiaire. Les ajouts de COCOMO II incluent des facteurs de réutilisabilité requise (RUSE), d’exigences de documentation (DOCU), de volatilité de la plateforme (PVOL), de continuité du personnel (PCON), d’expérience applicative (APEX), d’expérience plateforme (PLEX), d’expérience langage et outils (LTEX), et de développement multisite (SITE).
Un facteur de coût à souligner est SCED, qui couvre le délai de développement requis. Si vous compressez fortement le planning, le multiplicateur d’effort dépasse 1,0, ce qui signifie qu’il faut en réalité plus d’hommes-mois pour aller plus vite. Cela confirme ce que la plupart des ingénieurs savent d’expérience : forcer l’équipe à sprinter génère de la coordination supplémentaire, des erreurs et des retours en arrière, qui coûtent souvent plus que le temps « gagné ».
La principale force du modèle est sa transparence. Contrairement aux outils d’estimation propriétaires, COCOMO publie toutes ses équations, constantes et méthodes d’étalonnage. Chacun peut auditer les entrées et vérifier les sorties. Cela le rend utile dans les marchés publics, la défense et l’aérospatial, où l’auditabilité mathématique est souvent une exigence légale ou contractuelle.
Le modèle peut aussi être ré-étalonné. Les organisations qui collectent leur propre historique projet peuvent ajuster les constantes pour refléter leur environnement, la composition de leurs équipes et leur stack technologique. C’est important, car les constantes par défaut proviennent de jeux de données désormais anciens.
La structure à trois niveaux (Basic → Intermediate → Detailed) est un autre atout pratique. En début de projet, quand on sait peu de choses, on utilise Basic pour une estimation grossière. À mesure que le projet mûrit et que l’on en sait plus sur l’équipe et l’environnement, on passe à Intermediate ou Detailed pour une planification plus fine.
La plus grande limite est la dépendance de COCOMO au KLOC. Pour l’utiliser, il faut estimer la taille d’un projet en lignes de code avant d’en écrire une seule. Aux premières étapes d’un projet, précisément quand l’estimation compte le plus, c’est notoirement difficile à faire avec précision.
Même lorsque le KLOC peut être estimé, les constantes de COCOMO I proviennent de 63 projets réalisés sous le modèle en cascade entre 1968 et 1979. Celles de COCOMO II viennent de 161 projets des années 1990. Aucun de ces ensembles n’inclut des systèmes cloud-native, des applications mobiles, des architectures microservices ou des pipelines DevOps modernes. Appliquer ces constantes directement à un projet actuel sans étalonnage local donne des estimations peu fiables.
Une étude de 2025 l’a quantifié. Un COCOMO de base non étalonné appliqué à un jeu de données de projets NASA a produit une erreur relative moyenne d’environ 100 %, sans prédictions dans une fourchette de ±25 % de l’effort réel. Ce n’est pas une petite marge d’erreur : cela reflète un modèle utilisé en dehors des conditions pour lesquelles il a été conçu.
Le modèle gère mal le développement itératif. COCOMO suppose un cycle de vie raisonnablement séquentiel. Les équipes Agile qui travaillent en sprints courts avec des backlogs évolutifs ne rentrent pas dans les hypothèses en cascade sur lesquelles COCOMO est bâti.
Il y a aussi un problème plus profond. Un article publié dans Frontiers in Artificial Intelligence en mars 2026 soutient que COCOMO II est fondamentalement mal aligné avec le développement logiciel assisté par l’IA, non seulement par un problème d’étalonnage mais structurellement. Lorsque des outils d’IA génèrent une part substantielle du code, le KLOC comme proxy de l’effort humain devient trompeur. L’effort se concentre alors sur la vérification, la gouvernance architecturale et la revue de sécurité, que le cadre des facteurs de coût de COCOMO ne capture pas.
COCOMO n’est pas la seule option. Connaître les alternatives aide à choisir l’approche adaptée à chaque situation.
L’analyse par points de fonction (FPA) mesure la complexité d’un système à partir des entrées et sorties côté utilisateur, indépendamment du langage. Elle fonctionne bien quand vous avez des exigences solides mais pas encore d’estimation KLOC. Le modèle Early Design de COCOMO II accepte les points de fonction en entrée, on peut donc les utiliser ensemble.
Les story points sont la norme en environnements Agile. Les équipes évaluent les user stories par complexité relative, puis suivent leur vélocité pour projeter l’avancement. C’est rapide et propre à chaque équipe, mais cela ne produit pas le référentiel de coût global nécessaire aux achats et à la planification à long terme. COCOMO et les story points servent des objectifs différents.
Les outils paramétriques comme SEER-SEM et SLIM utilisent des bases d’étalonnage propriétaires et des jeux de paramètres plus larges. Des études montrent qu’ils surpassent COCOMO II non étalonné en précision. L’avantage de COCOMO est sa transparence et sa disponibilité ouverte, ce qui compte dans les contextes académiques ou auditables.
L’estimation par apprentissage automatique est un domaine de recherche actif. Une étude de janvier 2026 a montré que des modèles d’ensemble combinant forêts aléatoires, régression à vecteurs de support et réseaux de neurones surpassaient les modèles de la famille COCOMO sur des données de projets Agile selon les quatre métriques d’évaluation standard. Ces approches s’adaptent à leurs données d’entraînement plutôt que de reposer sur des constantes fixées il y a des décennies.
Savoir où se situe COCOMO par rapport aux autres méthodes est utile, mais la meilleure façon de comprendre son fonctionnement est de faire les calculs. Parcourons un calcul complet de Basic COCOMO I en mode Organic pour un projet estimé à 50 KLOC.
Les constantes pour le mode Organic sont : a = 2,4, b = 1,05, c = 2,5, d = 0,38.
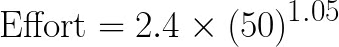
Pour calculer 501,05, utilisez le fait que 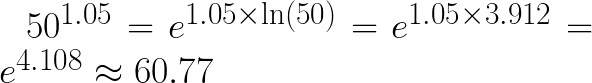 .
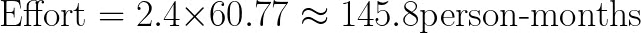
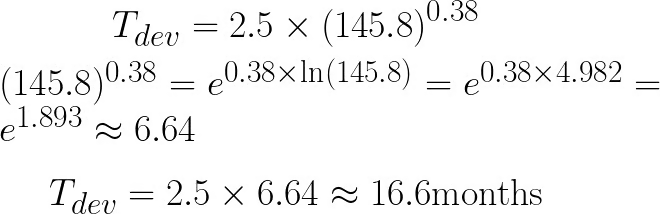
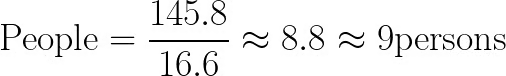
Récapitulatif :
|
Sortie |
Valeur |
|
Effort |
~145,8 hommes-mois |
|
Temps de développement |
~16,6 mois |
|
Personnes requises |
~9 personnes |
Deux points méritent d’être soulignés. Les hommes-mois et les mois calendaires sont des unités différentes : 145,8 hommes-mois sur 16,6 mois calendaires signifient environ 9 personnes travaillant en parallèle. Et comme il s’agit de Basic COCOMO, seules la taille et le mode sont utilisés. L’ajout de notations réelles des facteurs de coût via EAF déplacerait l’estimation d’effort à la hausse ou à la baisse.
COCOMO revient dans les cours académiques, les examens universitaires et les entretiens pour des rôles dans le secteur public, la défense et l’ingénierie des systèmes. Il apparaît rarement dans les entreprises tech grand public en mode agile.
La question la plus fréquente oppose COCOMO I et COCOMO II : des modes fixes et des constantes prédéfinies à partir de 63 projets, contre cinq facteurs d’échelle continus sur un jeu de données moderne plus large. Connaître cette distinction, les formules de base et les trois noms de mode couvre la plupart des cas. Les recruteurs demandent parfois un calcul d’exemple ; l’exemple détaillé ci-dessus vaut la peine d’être répété.
COCOMO reste utile lorsque ses hypothèses tiennent : développement séquentiel, achats formalisés et étude académique. Là où le logiciel moderne s’en écarte, il montre ses limites.
Utilisez Basic COCOMO pour une vérification rapide d’ordre de grandeur en début de projet. Utilisez Intermediate COCOMO lorsque vous disposez de données sur l’équipe et l’environnement. Étalonnez sur votre propre historique projet avant de vous appuyer sur une sortie dans une offre ou un plan réels. Comme je l’ai expliqué dans la section sur les limites, appliquer les constantes par défaut à un projet moderne sans étalonnage produit des erreurs trop importantes pour être exploitables.
COCOMO III est en développement au Boehm CSSE depuis environ 2015, sans publication publique à mars 2026. L’original de 1981 et sa mise à jour de 2000 restent la référence.
Envie d’aller plus loin en développement logiciel ? Consultez nos cours Software Engineering Principles in Python, Software Development with Cursor, et Software Development with GitHub Copilot pour mettre en pratique ce que vous avez appris ici.
Learn with DataCamp
{count, plural, one {Cours} other {Cours}}
{count, plural, one {Cours} other {Cours}}
{count, plural, one {Cours} other {Cours}}
{count, plural, one {blog} other {blogs}}
Kurtis Pykes
15 min
{count, plural, one {blog} other {blogs}}
{count, plural, one {Tutoriel} other {Tutoriels}}
Josef Waples
8 min
{count, plural, one {Tutoriel} other {Tutoriels}}
Josef Waples
3 min
{count, plural, one {Tutoriel} other {Tutoriels}}
Laiba Siddiqui
14 min
{count, plural, one {Tutoriel} other {Tutoriels}}
Samuel Shaibu
9 min