{count, plural, one {Kurs} other {Kurse}}
Grundlagen der Softwareentwicklung in Python
{hours} Std.
70.6K
Wurdest du schon mal gefragt, wie lange ein Softwareprojekt dauert – und musstest feststellen, dass deine beste Antwort im Grunde eine Schätzung war?
So haben die meisten Teams in den 1970er-Jahren die Kostenschätzung in der Softwaretechnik angegangen. Projekte liefen regelmäßig über Budget und Termin, und die verwendeten Methoden – hauptsächlich Expertenurteile und grobe Analogien – hielten dem Wachstum und der steigenden Komplexität von Systemen nicht stand.
COCOMO wurde entwickelt, um genau das zu ändern. Es steht für COnstructive COst MOdel. Barry W. Boehm stellte es 1981 in seinem Buch Software Engineering Economics vor und stützte die Formeln auf echte Projektdaten statt auf Intuition. Es wurde zu einem der am weitesten verbreiteten algorithmischen Schätzmodelle im Fach. Boehm, der im August 2022 verstarb, feilte jahrzehntelang an den dahinterstehenden Ideen.
In diesem Tutorial zeige ich dir, wie das Modell funktioniert, was die verschiedenen Typen und Stufen bedeuten, und führe ein komplettes Zahlenbeispiel durch, damit die Ergebnisse in der Praxis greifbar werden.
COCOMO ist ein parametrisches Modell zur Kostenschätzung von Software. Es nimmt eine zentrale Eingabe – die geschätzte Projektgröße in Tausend Codezeilen (KLOC) – und sagt damit drei Dinge voraus: den Gesamtaufwand in Personenmonaten (PM), die Entwicklungszeit in Monaten und die benötigte Teamgröße.
Das Modell nimmt an, dass die Projektgröße der wichtigste Prädiktor für den Aufwand ist. Boehm ermittelte die Konstanten des Modells, indem er Regressionsanalysen auf historischen Projektdaten durchführte.
COCOMO schätzt allerdings nicht direkt Geldkosten, sondern Aufwand. Um Personenmonate in Euro umzuwandeln, multiplizierst du mit den durchschnittlichen Personalkosten pro Personenmonat in deiner Organisation. Das Modell liefert den Aufwand, du den Kostensatz.
Boehm arbeitete als Director of Software Research and Technology bei TRW Aerospace – und die Herausforderung war unmittelbar und praktisch. Laut einem späteren Nachruf der National Academy of Engineering sagte ein TRW-Vizepräsident zu Boehm nach der Prüfung eines Softwareangebots eines Wettbewerbers: "Ich will nie wieder ein Softwareangebot nur auf Basis von Glauben abzeichnen müssen. Erfinde eine glaubwürdige Methode, die Kosten für die Entwicklung eines Softwareprodukts zu schätzen."
Aus dieser Bitte entstand COCOMO. Boehm untersuchte 63 abgeschlossene TRW-Projekte, von 2.000 bis 100.000 Codezeilen, in Sprachen von Assembler bis PL/I, alle nach dem Wasserfallmodell umgesetzt. Die Regression auf diesem Datensatz lieferte die Konstanten für COCOMO I, und 1981 wurde das Modell veröffentlicht.
Die Mathematik hinter Basic COCOMO I ist einfach, sobald klar ist, wofür die Terme stehen.
Die Aufwandsformel lautet:
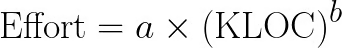
Hier wird der Aufwand in Personenmonaten gemessen, KLOC ist die geschätzte Softwaregröße in Tausend Codezeilen, und a und b sind Konstanten, die vom Projekttyp abhängen.
Die Formel für die Entwicklungszeit leitet sich aus dem Aufwand ab:
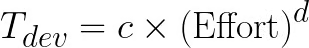
Die Konstante d variiert je nach Modus, während c in allen drei Modi mit 2,5 festgelegt ist. Viele Tutorials suggerieren fälschlich, dass alle vier Konstanten wechseln. Hast du Aufwand und , kannst du die durchschnittlich benötigte Personenzahl schätzen:
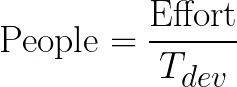
Die folgende Tabelle zeigt die verifizierten Konstanten für Basic COCOMO I:
|
Projektmodus |
a |
b |
c |
d |
|
Organic |
2.4 |
1.05 |
2.5 |
0.38 |
|
Semi-Detached |
3.0 |
1.12 |
2.5 |
0.35 |
|
Embedded |
3.6 |
1.20 |
2.5 |
0.32 |
Die entscheidende Variable ist hier b. Bei Organic-Projekten gilt b = 1,05, der Aufwand wächst also nahezu linear mit der Projektgröße. Bei Embedded-Projekten gilt b = 1,20 – es entsteht eine deutliche Größendegression: Verdoppelt sich die Größe eines Embedded-Projekts, mehr als verdoppelt sich der erforderliche Aufwand.
COCOMO I teilt Softwareprojekte in drei Entwicklungsmodi ein. Jeder Modus spiegelt eine andere Kombination aus Teamerfahrung, Projektkomplexität und betrieblichen Zwängen wider. Der gewählte Modus bestimmt, welche Konstanten in deinen Formeln verwendet werden.
Wichtig vorab: Diese drei Modi gelten nur für COCOMO I. COCOMO II, das Update von 2000, ersetzt sie durch einen anderen Ansatz.
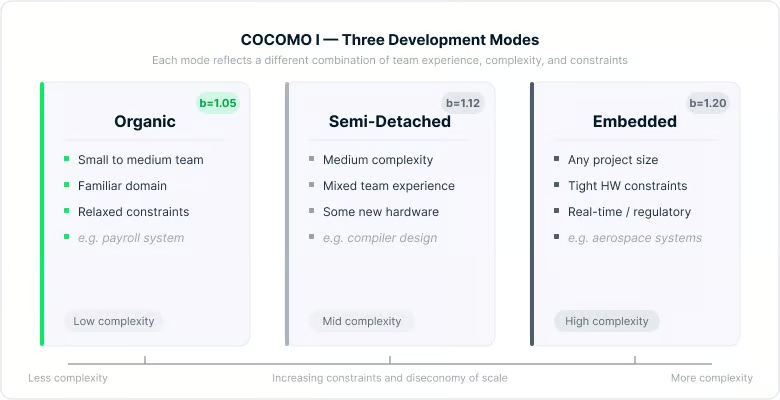
Drei COCOMO-I-Modi im Vergleich. Grafik: Autor.
Die drei Modi liegen auf einer Skala zunehmender Komplexität und Zwänge. Projekttyp und Teamkontext zeigen in der Regel klar, welcher Modus passt.
Organic umfasst kleine bis mittlere Projekte, bei denen das Team mit der Domäne vertraut ist, die Anforderungen relativ klar sind und keine starken externen Zwänge durch Hardware oder Regulierung bestehen. Typische Beispiele sind Lohn- und Gehaltssysteme, Datenverarbeitungsanwendungen oder Lagerverwaltung.
Weil Team und Domäne vertraut sind, bleibt der Kommunikationsaufwand auch mit wachsender Projektgröße gering. Deshalb ist der Exponent b hier der kleinste der drei Modi.
Semi-Detached liegt in der Mitte. Teams haben gemischte Erfahrung: Einige Mitglieder kennen die Domäne gut, andere weniger. Das Projekt ist moderat komplex, und es kann Interaktionen mit neuer Hardware oder externen Systemen geben.
Beispiele sind Compilerentwicklung, Transaktionsverarbeitungssysteme und Business-Anwendungen im mittleren Segment. Die Größendegression ist hier spürbarer, mit b = 1,12.
Embedded gilt für Projekte mit strengen Betriebszwängen: strikte Hardwareanforderungen, Echtzeitanforderungen, regulatorische Vorgaben oder Anforderungen aus Luft- und Raumfahrt sowie Verteidigung. Das Team kann groß und sehr kompetent sein, aber die Komplexität von Integration, Tests und Validierung lässt den Aufwand mit der Größe stark ansteigen.
Mit b = 1,20 weist Embedded die stärkste Größendegression auf. Embedded bezieht sich nicht auf die Projektgröße: Auch ein relativ kleines eingebettetes System fällt darunter, wenn es unter harten Zwängen arbeitet.
Neben den drei Modi hat COCOMO I drei Detailstufen der Schätzung. Die Modi legen die Konstanten fest; die Stufen bestimmen die Modellierungstiefe. Jede Stufe baut auf der vorherigen auf und erweitert die Berechnung um weitere Faktoren – höhere Genauigkeit gegen mehr Eingabedaten.
Du kannst es dir als Spektrum vorstellen: Basic COCOMO liefert schnell eine grobe Hausnummer, Detailed COCOMO erlaubt präzise Planung auf Phasenebene.
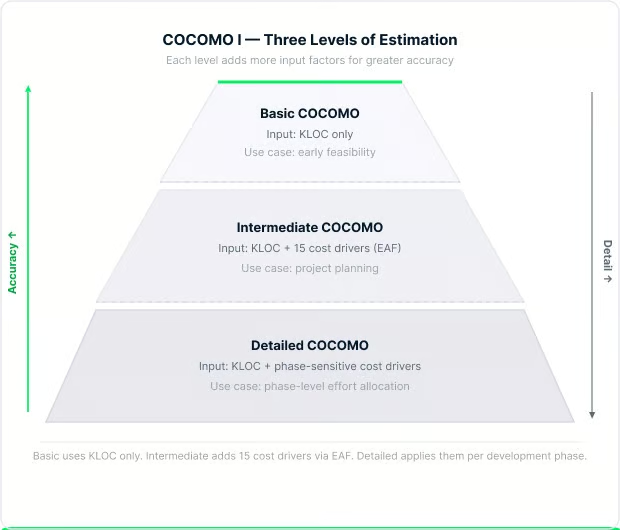
COCOMO-I-Stufen nach Schätzungstiefe. Grafik: Autor.
Je weiter unten in der Pyramide, desto mehr Faktoren gehen in die Berechnung ein – die Genauigkeit steigt, aber auch der Datenbedarf zum Start.
Basic COCOMO nutzt nur die Projektgröße in KLOC und den Projektmodus. Du setzt KLOC ein, wendest die Konstanten des Modus an und erhältst eine Aufwandschätzung. Nützlich für frühe Machbarkeitsprüfungen, wenn es noch keine Details zu Team oder Entwicklungsumfeld gibt.
Intermediate COCOMO führt einen Aufwandsanpassungsfaktor ein, meist als EAF geschrieben. Die vollständige Liste der Kostentreiber-Multiplikatoren ist im COCOMO II Model Definition Manual dokumentiert. Die Aufwandsformel lautet dann:
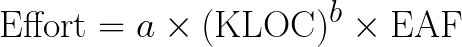
Der EAF ist das Produkt aus 15 Kostentreibern, jeweils bewertet von Very Low bis Extra High. Die Treiber fallen in vier Kategorien: Produkteigenschaften (Zuverlässigkeit, Komplexität, Datenbankgröße), Hardwareeigenschaften (Laufzeit- und Speicherzwänge), Personaleigenschaften (Teamerfahrung und -fähigkeit) und Projekteigenschaften (Tooling, Termindruck, Entwicklungspraktiken).
Wichtig bei Intermediate COCOMO: Die Konstante a ändert sich gegenüber Basic. Für Organic wird a zu 3,2 (nicht 2,4). Für Semi-Detached bleibt sie 3,0. Für Embedded sinkt sie auf 2,8. Die Exponenten b, c und d bleiben in Basic und Intermediate gleich.
Personalkostentreiber sind invertiert: Höhere Fähigkeit bedeutet einen kleineren Multiplikator und senkt die Aufwandschätzung. Ein erfahrenes Team braucht schlicht weniger Personenmonate als ein Anfängerteam.
Detailed COCOMO, auch Advanced COCOMO genannt, setzt Aufwandsmultiplikatoren auf Phasenebene an – nicht für das gesamte Projekt. Die Kostentreiber für Anforderungsanalyse, Feinentwurf, Codierung sowie Integration und Test werden getrennt bewertet.
Das ist die genaueste, aber auch aufwendigste Stufe. Sie lohnt sich für große Projekte, in denen unterschiedliche Teams verschiedene Phasen verantworten und die Aufwandsverteilung über die Phasen für die Planung zählt.
Mitte der 1990er zeigte COCOMO I Alterserscheinungen. Die Softwareentwicklung verlagerte sich vom Wasserfall auf Mainframes zu objektorientierter Programmierung, wiederverwendbaren Komponentenbibliotheken, Rapid Prototyping und verteilten Desktop-Systemen. Die Anwendung von Projektdaten aus den 1970ern auf die Softwareumgebungen der 1990er lieferte unzuverlässige Schätzungen.
Boehm und Kolleg:innen am USC Center for Software Engineering bauten das Modell daraufhin von Grund auf neu. Ergebnis war COCOMO II, veröffentlicht 2000 im Buch Software Cost Estimation with COCOMO II, kalibriert an 161 Projekten – mehr als doppelt so viele wie die 63 des Originalmodells.
Motivationen hinter COCOMO II waren objekt- und komponentenbasierte Entwicklung, Software-Wiederverwendung und COTS-Integration, iterative und Spiralmodelle sowie moderne Tools. Ein verbreitetes Missverständnis: COCOMO II wurde nicht für Agile gebaut. Agile, wie wir es heute kennen, existierte während der Entwicklung von 1995 bis 2000 kaum.
COCOMO II bietet drei Submodelle, jeweils passend zu einer Projektphase.
Das Application Composition Model ist für frühes Prototyping gedacht, besonders bei Einsatz von GUI-Buildern und Komponentenbibliotheken. Statt KLOC nutzt es Object Points: Screens, Reports und Komponenten in Drittgenerationssprachen, gewichtet nach Komplexität und angepasst um erwartete Wiederverwendung. Es handelt sich um ein lineares Modell ohne Skalierungsfaktoren oder Exponenten.
Das Early Design Model wird genutzt, bevor die Architektur steht. Es nimmt Unadjusted Function Points als Input, wandelt sie über sprachspezifische Tabellen in äquivalente Codezeilen um und wendet sieben Kostentreiber an. Es liefert eine brauchbare Schätzung, wenn du weißt, was das System tun soll, aber noch nicht, wie es gebaut wird.
Das Post-Architecture Model ist das strengste der drei. Es kommt nach Festlegung der Softwarearchitektur zum Einsatz, nutzt Tausend Quellcodezeilen (KSLOC) oder Function Points, 17 Kostentreiber und fünf Skalierungsfaktoren. Die Aufwandsformel lautet:
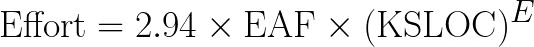
Dabei ist E ein dynamischer Exponent, berechnet als:
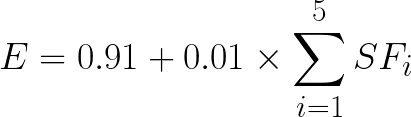
Und die Terminformel lautet:
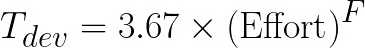
Wobei:
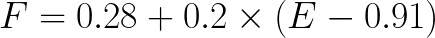
Die Konstanten 2,94, 0,91, 3,67 und 0,28 stammen aus der COCOMO II.2000-Kalibrierung. Einige ältere Quellen nennen 2,5 statt 2,94; das ist ein Vor-2000-Wert und sollte im aktuellen Modell nicht verwendet werden. Das USC COCOMO II Web Tool auf softwarecost.org ist eine kostenlose Live-Implementierung des Post-Architecture-Modells, wenn du Schätzungen ohne manuelle Berechnung testen willst.
Zwei Mechanismen unterscheiden COCOMO II grundlegend von COCOMO I: Skalierungsfaktoren und Kostentreiber. So wirken sie.
In COCOMO I ist der Exponent b durch den Modus fix: Du wählst Organic, Semi-Detached oder Embedded und bekommst einen festen Wert. COCOMO II ersetzt das durch fünf kontinuierlich bewertete Skalierungsfaktoren, die den Exponenten anhand deiner Bewertungen berechnen.
Die fünf Skalierungsfaktoren in COCOMO II sind Precedentedness (PREC), Entwicklungsflexibilität (FLEX), Architektur- und Risikolösung (RESL), Teamkohäsion (TEAM) und Prozessreife (PMAT). Sie werden von Very Low bis Extra High bewertet; ihre Summe bestimmt E in der Aufwandsformel. Eine höhere Summe bedeutet ein weniger reifes, weniger vertrautes, riskanteres Projekt – also einen höheren Exponenten und mehr Aufwand.
Skalierungsfaktoren beeinflussen die Form der Aufwandskurve. Kostentreiber hingegen sind multiplikative Anpassungen an den Basisaufwand. COCOMO II hat im Post-Architecture-Modell 17 Kostentreiber (gegenüber 15 bei Intermediate COCOMO I). Neu sind u. a. geforderte Wiederverwendbarkeit (RUSE), Dokumentationsanforderungen (DOCU), Plattformvolatilität (PVOL), Personalstabilität (PCON), Anwendungserfahrung (APEX), Plattform-Erfahrung (PLEX), Sprach- und Tool-Erfahrung (LTEX) und Entwicklung an verteilten Standorten (SITE).
Ein besonders wichtiger Kostentreiber ist SCED, der die geforderte Entwicklungsdauer abbildet. Wird ein Zeitplan stark komprimiert, steigt der Multiplikator über 1,0 – es werden also tatsächlich mehr Personenmonate benötigt, um schneller fertig zu werden. Das deckt sich mit der Erfahrung vieler Entwickler:innen: Dauer-Sprints erzeugen Koordinationsaufwand, Fehler und Nacharbeit, die die vermeintlich gesparte Zeit übersteigen.
Die größte Stärke ist Transparenz. Anders als proprietäre Tools veröffentlicht COCOMO all seine Gleichungen, Konstanten und die Kalibriermethodik. Jede:r kann Inputs prüfen und Outputs verifizieren. Das ist nützlich in Behörden-, Verteidigungs- und Luft-/Raumfahrtbeschaffung, wo mathematische Prüfbarkeit oft vorgeschrieben ist.
Das Modell ist zudem rekalibrierbar. Organisationen, die eigene Projekthistorien sammeln, können Konstanten an ihr Umfeld, ihre Teamstruktur und ihren Tech-Stack anpassen. Wichtig, weil die Standardkonstanten aus längst vergangenen Datensätzen stammen.
Auch die Dreistufigkeit (Basic → Intermediate → Detailed) ist praktisch. Früh im Projekt nutzt du Basic für eine grobe Schätzung. Mit wachsendem Wissen über Team und Umgebung wechselst du zu Intermediate oder Detailed für die Feinplanung.
Die größte Einschränkung ist die Abhängigkeit von KLOC. Um COCOMO zu nutzen, musst du die Größe eines Projekts in Codezeilen schätzen, bevor Code existiert. Genau in der frühen Phase, in der Schätzungen am wichtigsten sind, ist das berüchtigt schwierig.
Selbst wenn KLOC schätzbar ist, stammen die Konstanten in COCOMO I aus 63 Wasserfallprojekten von 1968 bis 1979. Die Konstanten in COCOMO II aus 161 Projekten der 1990er. Keiner der Datensätze umfasst Cloud-native Systeme, Mobile Apps, Microservices-Architekturen oder moderne DevOps-Pipelines. Die direkte Anwendung auf heutige Projekte ohne lokale Kalibrierung führt zu unzuverlässigen Schätzungen.
Eine Studie von 2025 untermauert das. Ein unkalibriertes Basic COCOMO auf einen NASA-Datensatz angewendet ergab einen durchschnittlichen relativen Fehler von etwa 100 %, ohne eine einzige Vorhersage innerhalb von 25 % des tatsächlichen Aufwands. Das ist kein kleiner Fehlerkorridor – das zeigt, dass das Modell außerhalb seiner Gültigkeitsbedingungen genutzt wurde.
Das Modell bildet iterative Entwicklung ebenfalls schlecht ab. COCOMO setzt einen weitgehend sequentiellen Lebenszyklus voraus. Agile Teams, die in kurzen Sprints mit sich entwickelnden Backlogs arbeiten, passen nicht zu den Wasserfallannahmen in COCOMOs Struktur.
Es gibt zudem ein tieferes Problem. Ein Paper in Frontiers in Artificial Intelligence vom März 2026 argumentiert, dass COCOMO II grundsätzlich nicht zu KI-unterstützter Softwareentwicklung passt – nicht nur kalibratorisch, sondern strukturell. Wenn KI-Coding-Tools große Teile eines Codebestands generieren, wird KLOC als Proxy für menschlichen Aufwand irreführend. Der Aufwand verlagert sich auf Verifikation, Architektur-Governance und Security-Reviews – Aspekte, die COCOMOs Kostentreiberrahmen nicht erfasst.
COCOMO ist nicht die einzige Option. Die Alternativen zu kennen hilft, die passende Methode je nach Situation zu wählen.
Function Point Analysis (FPA) misst die Systemkomplexität aus Nutzersicht (Inputs/Outputs), unabhängig von der Programmiersprache. Das funktioniert gut, wenn die Anforderungen klar sind, aber noch keine KLOC-Schätzung vorliegt. Das Early-Design-Modell von COCOMO II akzeptiert Function Points als Input – beides lässt sich kombinieren.
Story Points sind Standard in agilen Umgebungen. Teams bewerten User Stories relativ nach Komplexität und nutzen Velocity für Fortschrittsprognosen. Sie sind schnell und teamspezifisch, liefern aber nicht die Gesamtkostenbasis, die Beschaffung und Langfristplanung brauchen. COCOMO und Story Points dienen unterschiedlichen Zwecken.
Parametrische Tools wie SEER-SEM und SLIM nutzen proprietäre Kalibrierdatenbanken und breitere Parametersätze. Studien zeigen, dass sie unkalibriertes COCOMO II bei der Genauigkeit übertreffen. COCOMOs Vorteil ist Transparenz und Offenheit – wichtig in Wissenschaft und prüfbaren Kontexten.
Machine-Learning-basierte Schätzung ist ein aktives Forschungsfeld. Eine Studie von Januar 2026 fand, dass Ensemble-Modelle aus Random Forests, Support Vector Regression und Neuronalen Netzen COCOMO-Modelle bei agilen Projektdaten über alle vier Standardmetriken hinweg übertrafen. Diese Ansätze passen sich ihren Trainingsdaten an, statt sich auf Jahrzehnte alte Konstanten zu stützen.
Zu wissen, wo COCOMO im Vergleich zu anderen Methoden steht, ist hilfreich. Am besten verstehst du es jedoch, wenn du die Zahlen durchrechnest. Gehen wir eine vollständige Basic-COCOMO-I-Berechnung im Organic-Modus für ein Projekt mit 50 KLOC durch.
Die Konstanten für Organic sind: a = 2,4, b = 1,05, c = 2,5, d = 0,38.
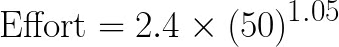
Für die Berechnung von 501,05 nutzt du, dass 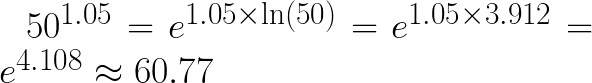 .
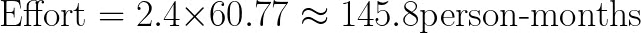
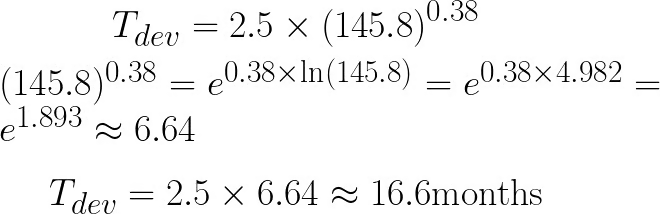
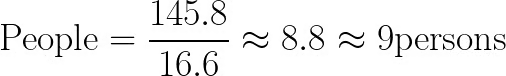
Zusammenfassung:
|
Output |
Wert |
|
Aufwand |
~145,8 Personenmonate |
|
Entwicklungszeit |
~16,6 Monate |
|
Benötigte Personen |
~9 Personen |
Zwei Dinge sind bemerkenswert. Personenmonate und Kalendermonate sind unterschiedliche Einheiten: 145,8 Personenmonate über 16,6 Kalendermonate bedeuten rund 9 parallel arbeitende Personen. Und da dies Basic COCOMO ist, fließen nur Größe und Modus ein. Reale Kostentreiber-Bewertungen über EAF würden die Aufwandschätzung nach oben oder unten verschieben.
COCOMO taucht in Studiengängen, Uni-Prüfungen sowie Interviews für Rollen im Behörden-, Verteidigungs- und Systemengineering-Kontext auf. Bei agilen Consumer-Tech-Unternehmen selten.
Die häufigste Frage: COCOMO I versus COCOMO II – feste Modi und vorgegebene Konstanten aus 63 Projekten versus fünf kontinuierliche Skalierungsfaktoren auf einem größeren, moderneren Datensatz. Wenn du diesen Unterschied, die Grundformeln und die drei Modenamen kennst, bist du meist gut vorbereitet. Manchmal wird eine Beispielrechnung abgefragt – das obige Beispiel lohnt sich zu üben.
COCOMO ist nützlich, wenn seine Annahmen gelten: sequentielle Entwicklung, formale Beschaffung, akademische Nutzung. Wo sich moderne Software davon entfernt, bricht die Aussagekraft ein.
Nutze Basic COCOMO früh im Projekt für einen schnellen Größenordnungscheck. Wechsle zu Intermediate, wenn Daten zu Team und Umgebung vorliegen. Kalibriere gegen deine eigene Projekthistorie, bevor du Ergebnisse in echten Angeboten oder Plänen verwendest. Wie im Abschnitt Grenzen beschrieben, führen Standardkonstanten ohne Kalibrierung bei modernen Projekten zu Fehlern, die zu groß für belastbare Entscheidungen sind.
COCOMO III ist seit etwa 2015 am Boehm CSSE in Entwicklung, ohne öffentliche Veröffentlichung mit Stand März 2026. Das Original von 1981 und das Update von 2000 bleiben der Maßstab.
Du willst in der Softwareentwicklung weiter einsteigen? Wir haben Kurse zu Software Engineering Principles in Python, Software Development with Cursor und Software Development with GitHub Copilot, mit denen du das Gelernte ausbauen kannst.
Lerne mit DataCamp
{count, plural, one {Kurs} other {Kurse}}
{count, plural, one {Kurs} other {Kurse}}
{count, plural, one {Kurs} other {Kurse}}
{count, plural, one {Blog} other {Blogs}}
{count, plural, one {Blog} other {Blogs}}
Matt Crabtree
14 Min.
{count, plural, one {Tutorial} other {Tutorials}}
Josef Waples
8 Min.
{count, plural, one {Tutorial} other {Tutorials}}
Josef Waples
3 Min.
{count, plural, one {Tutorial} other {Tutorials}}
Derrick Mwiti
10 Min.
{count, plural, one {Tutorial} other {Tutorials}}
Allan Ouko
11 Min.