Corso
Introduzione a Python
4 ore
7.1M
All’inizio del mese ho tenuto una diretta Facebook di Code Along in cui io (e chi ha codato insieme a me) abbiamo costruito diversi algoritmi di complessità crescente per prevedere se un determinato passeggero del Titanic è sopravvissuto oppure no, a partire da dati come la tariffa pagata, il porto d’imbarco e l’età.
In questo post ripercorrerai alcune delle cose affrontate nella sessione. Se vuoi rivederla o seguire questo post insieme al video, lo trovi qui:
In particolare, magari ricordi ancora che abbiamo costruito modelli di apprendimento supervisionato.
Il supervised learning è il ramo del Machine Learning (ML) che consiste nel prevedere etichette, come "Sopravvissuto" o "No". Questi modelli imparano da dati etichettati, cioè dati che includono se un passeggero è sopravvissuto (fase detta "addestramento del modello"), e poi effettuano previsioni su dati non etichettati.
Su Kaggle, una piattaforma per competizioni di modellazione predittiva e analytics, questi sono chiamati train e test set perché
Kaggle quindi ti indica la percentuale di risposte corrette: è quella che si chiama accuracy del tuo modello.
Come forse già sai, un buon modo per affrontare l’apprendimento supervisionato è il seguente:
In questa sessione di code along, hai fatto o farai tutti questi passaggi!
Nota: abbiamo anche dei corsi che ti mettono in pista con il machine learning sul dataset del Titanic in Python e R.
Un primo passo è sempre importare i dati per dare un’occhiata veloce a ciò con cui lavorerai. In questo caso importerai il pacchetto pandas e userai la funzione read_csv() per leggere i dati:
Nota: nei blocchi di codice qui sotto, altri pacchetti e moduli come matplotlib, sklearn e seaborn sono già stati importati. Li userai più estesamente dopo per la visualizzazione (statistica) dei dati e per il machine learning!
Usi anche il comando magico di IPython %matplotlib inline per far apparire i grafici direttamente nel notebook. Aggiungi inoltre sns.set() al blocco per impostare lo stile di visualizzazione allo stile base di Seaborn:
# Import modules
import pandas as pd
import matplotlib.pyplot as plt
import seaborn as sns
from sklearn import tree
from sklearn.metrics import accuracy_score

# Figures inline and set visualization style
%matplotlib inline
sns.set()
Senza ulteriori indugi, importiamo i dati e facciamo già il primo passo nell’esaminarli:
# Import test and train datasets
df_train = pd.read_csv('../data/train.csv')
df_test = pd.read_csv('../data/test.csv')

# View first lines of training data
df_train.head(n=4)
| PassengerId | Survived | Pclass | Name | Sex | Age | SibSp | Parch | Ticket | Fare | Cabin | Embarked | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | 1 | 0 | 3 | Braund, Mr. Owen Harris | male | 22.0 | 1 | 0 | A/5 21171 | 7.2500 | NaN | S |
| 1 | 2 | 1 | 1 | Cumings, Mrs. John Bradley (Florence Briggs Th... | female | 38.0 | 1 | 0 | PC 17599 | 71.2833 | C85 | C |
| 2 | 3 | 1 | 3 | Heikkinen, Miss. Laina | female | 26.0 | 0 | 0 | STON/O2. 3101282 | 7.9250 | NaN | S |
| 3 | 4 | 1 | 1 | Futrelle, Mrs. Jacques Heath (Lily May Peel) | female | 35.0 | 1 | 0 | 113803 | 53.1000 | C123 | S |
Se vuoi vedere cosa rappresentano tutte queste feature, consulta la documentazione dei dati di Kaggle qui.
Prima di continuare, è bene tenere a mente quanto segue in termini di terminologia:
Con questo in mente, puoi continuare a esplorare i tuoi dati con, per esempio, la funzione head(), che puoi usare per visualizzare le prime cinque righe del dataset:
# View first lines of test data
df_test.head()
| PassengerId | Pclass | Name | Sex | Age | SibSp | Parch | Ticket | Fare | Cabin | Embarked | |
|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | 892 | 3 | Kelly, Mr. James | male | 34.5 | 0 | 0 | 330911 | 7.8292 | NaN | Q |
| 1 | 893 | 3 | Wilkes, Mrs. James (Ellen Needs) | female | 47.0 | 1 | 0 | 363272 | 7.0000 | NaN | S |
| 2 | 894 | 2 | Myles, Mr. Thomas Francis | male | 62.0 | 0 | 0 | 240276 | 9.6875 | NaN | Q |
| 3 | 895 | 3 | Wirz, Mr. Albert | male | 27.0 | 0 | 0 | 315154 | 8.6625 | NaN | S |
| 4 | 896 | 3 | Hirvonen, Mrs. Alexander (Helga E Lindqvist) | female | 22.0 | 1 | 1 | 3101298 | 12.2875 | NaN | S |
Nota che il DataFrame df_test non ha la colonna 'Survived' perché è proprio ciò che cercherai di prevedere!
.info() per controllare tipi di dato, valori mancanti e altro (di df_train).df_train.info()
<class 'pandas.core.frame.DataFrame'>
RangeIndex: 891 entries, 0 to 890
Data columns (total 12 columns):
PassengerId    891 non-null int64
Survived       891 non-null int64
Pclass         891 non-null int64
Name           891 non-null object
Sex            891 non-null object
Age            714 non-null float64
SibSp          891 non-null int64
Parch          891 non-null int64
Ticket         891 non-null object
Fare           891 non-null float64
Cabin          204 non-null object
Embarked       889 non-null object
dtypes: float64(2), int64(5), object(5)
memory usage: 83.6+ KB
In questo caso, vedi che ci sono solo 714 valori non null per la colonna 'Age' in un DataFrame con 891 righe. Questo significa che ci sono 177 valori nulli o mancanti.
.describe() per controllare le statistiche descrittive delle colonne numeriche (di df_train).df_train.describe()
| PassengerId | Survived | Pclass | Age | SibSp | Parch | Fare | |
|---|---|---|---|---|---|---|---|
| count | 891.000000 | 891.000000 | 891.000000 | 714.000000 | 891.000000 | 891.000000 | 891.000000 |
| mean | 446.000000 | 0.383838 | 2.308642 | 29.699118 | 0.523008 | 0.381594 | 32.204208 |
| std | 257.353842 | 0.486592 | 0.836071 | 14.526497 | 1.102743 | 0.806057 | 49.693429 |
| min | 1.000000 | 0.000000 | 1.000000 | 0.420000 | 0.000000 | 0.000000 | 0.000000 |
| 25% | 223.500000 | 0.000000 | 2.000000 | 20.125000 | 0.000000 | 0.000000 | 7.910400 |
| 50% | 446.000000 | 0.000000 | 3.000000 | 28.000000 | 0.000000 | 0.000000 | 14.454200 |
| 75% | 668.500000 | 1.000000 | 3.000000 | 38.000000 | 1.000000 | 0.000000 | 31.000000 |
| max | 891.000000 | 1.000000 | 3.000000 | 80.000000 | 8.000000 | 6.000000 | 512.329200 |
Ora che hai un’idea dell’aspetto dei tuoi dati e hai controllato alcune statistiche, è il momento di visualizzarli anche con l’aiuto del pacchetto seaborn:
seaborn per costruire un bar plot sulla sopravvivenza sul Titanic, che è la tua variabile target.sns.countplot(x='Survived', data=df_train);
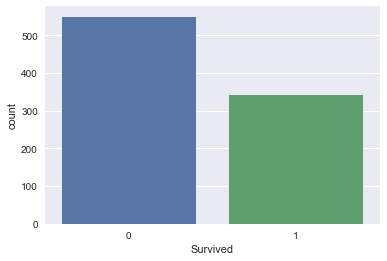
Conclusione: nel training set, meno persone sono sopravvissute rispetto a quante non lo sono. Costruiamo allora un primo modello che predice che nessuno è sopravvissuto.
È un modello scadente, perché sappiamo che alcune persone sono sopravvissute. Ma ci fornisce una baseline: qualunque modello che costruiremo dopo deve fare meglio di questo.
Puoi farlo seguendo questi passaggi:
'Survived' per df_test che codifichi "non sopravvissuto" per tutte le righe;'PassengerId' e 'Survived' di df_test in un .csv e invialo a Kaggle.df_test['Survived'] = 0
df_test[['PassengerId', 'Survived']].to_csv('data/predictions/no_survivors.csv', index=False)
Che accuracy ottieni? L’accuracy su Kaggle è 62,7.
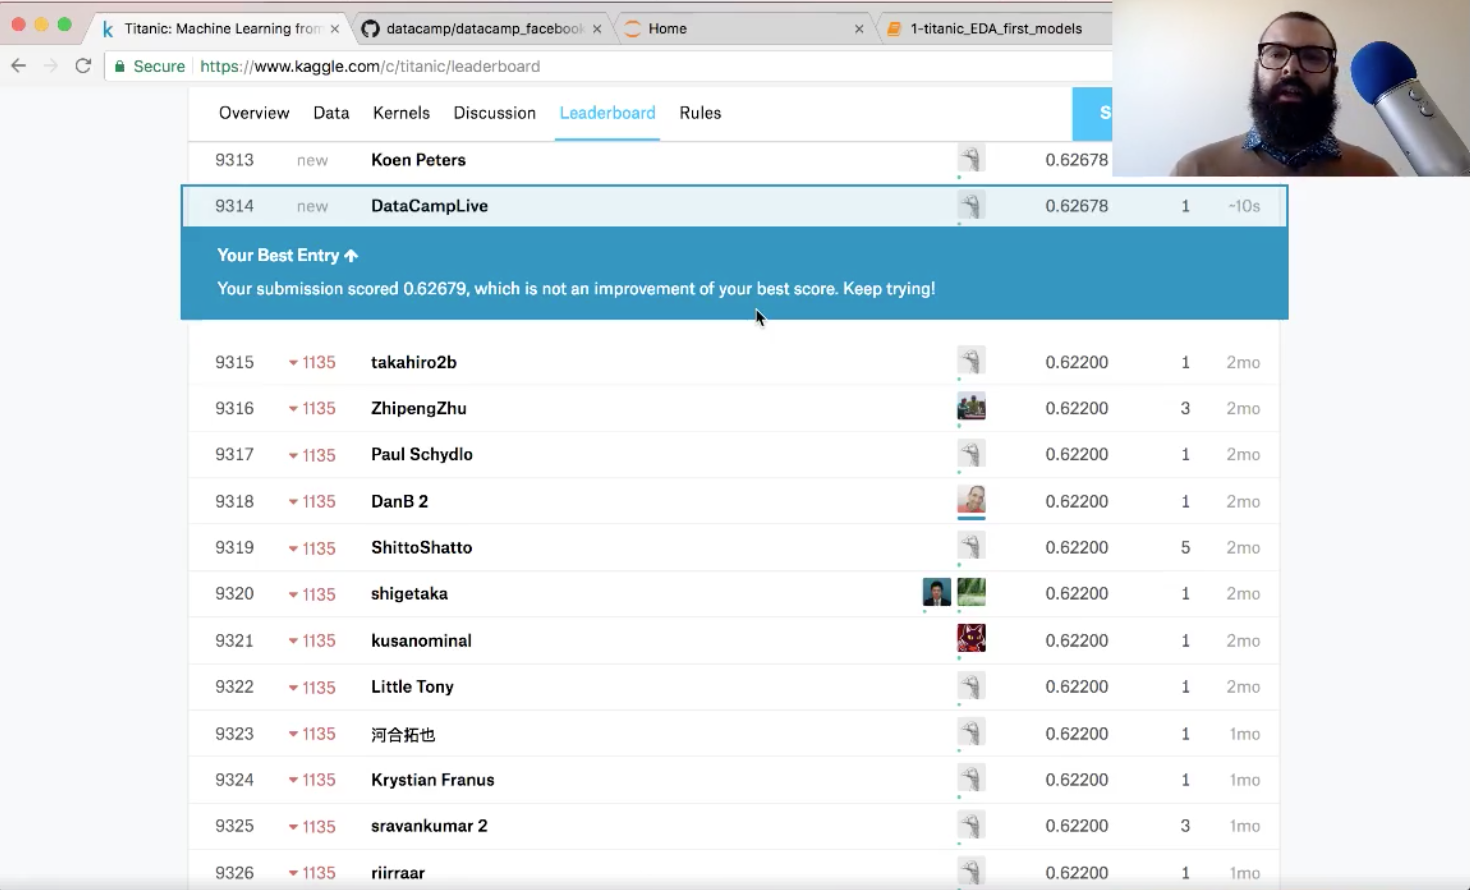
Niente male!
Nota essenziale! Vorrai anche usare metriche diverse dall’accuracy!
Ora che hai costruito un modello veloce e sporco, è il momento di iterare: facciamo un po’ più di analisi esplorativa e presto costruiremo un altro modello!
seaborn per costruire un bar plot della feature del dataset Titanic 'Sex' (di df_train).sns.countplot(x='Sex', data=df_train);
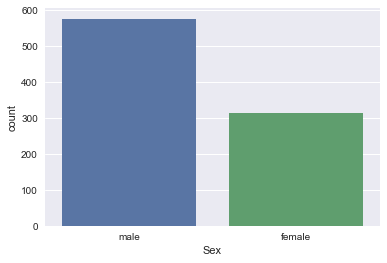
seaborn per costruire dei bar plot della feature 'Survived' del dataset Titanic, suddivisi (facet) in base alla feature 'Sex'.sns.factorplot(x='Survived', col='Sex', kind='count', data=df_train);
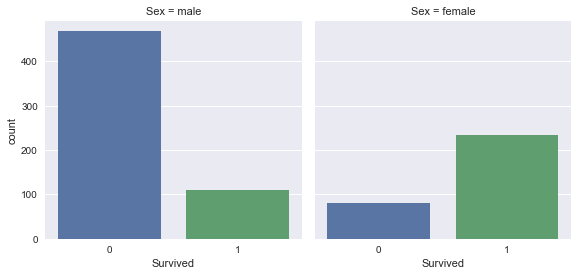
Conclusione: le donne avevano maggiori probabilità di sopravvivere rispetto agli uomini.
pandas per capire quante donne e quanti uomini sono sopravvissuti:df_train.groupby(['Sex']).Survived.sum()
Sex
female    233
male      109
Name: Survived, dtype: int64
pandas per calcolare la proporzione di donne sopravvissute e la proporzione di uomini:print(df_train[df_train.Sex == 'female'].Survived.sum()/df_train[df_train.Sex == 'female'].Survived.count())
print(df_train[df_train.Sex == 'male'].Survived.sum()/df_train[df_train.Sex == 'male'].Survived.count())
0.742038216561
0.188908145581
Il 74% delle donne è sopravvissuto, mentre il 19% degli uomini è sopravvissuto.
Costruiamo ora un secondo modello e prevediamo che tutte le donne siano sopravvissute e tutti gli uomini no. Anche questo è un modello irrealistico, ma fornirà una baseline con cui confrontare i modelli futuri.
'Survived' per df_test che codifichi la previsione di cui sopra.'PassengerId' e 'Survived' di df_test in un .csv e invialo a Kaggle.df_test['Survived'] = df_test.Sex == 'female'
df_test['Survived'] = df_test.Survived.apply(lambda x: int(x))
df_test.head()
| PassengerId | Pclass | Name | Sex | Age | SibSp | Parch | Ticket | Fare | Cabin | Embarked | Survived | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | 892 | 3 | Kelly, Mr. James | male | 34.5 | 0 | 0 | 330911 | 7.8292 | NaN | Q | 0 |
| 1 | 893 | 3 | Wilkes, Mrs. James (Ellen Needs) | female | 47.0 | 1 | 0 | 363272 | 7.0000 | NaN | S | 1 |
| 2 | 894 | 2 | Myles, Mr. Thomas Francis | male | 62.0 | 0 | 0 | 240276 | 9.6875 | NaN | Q | 0 |
| 3 | 895 | 3 | Wirz, Mr. Albert | male | 27.0 | 0 | 0 | 315154 | 8.6625 | NaN | S | 0 |
| 4 | 896 | 3 | Hirvonen, Mrs. Alexander (Helga E Lindqvist) | female | 22.0 | 1 | 1 | 3101298 | 12.2875 | NaN | S | 1 |
df_test[['PassengerId', 'Survived']].to_csv('../data/predictions/women_survive.csv', index=False)
Che accuracy ti ha dato questo modello quando lo invii a Kaggle?
L’accuracy su Kaggle è 76,6%:
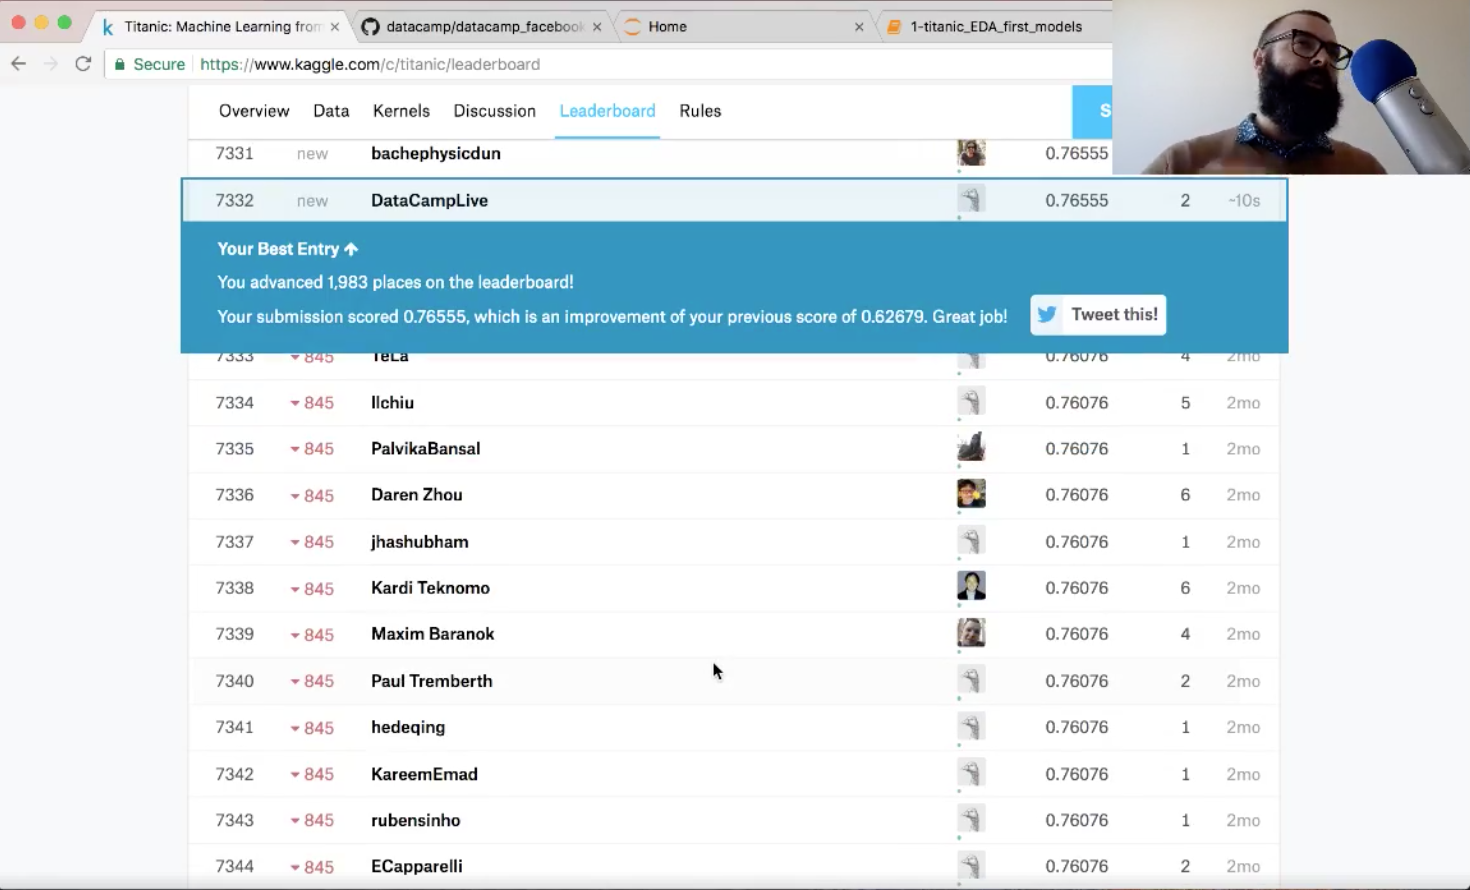
Con questa submission sei salito di circa 2.000 posizioni in classifica! E hai migliorato il tuo punteggio, quindi ottimo lavoro!
seaborn per costruire bar plot della feature 'Survived' del dataset Titanic, suddivisi (facet) in base alla feature 'Pclass'.sns.factorplot(x='Survived', col='Pclass', kind='count', data=df_train);
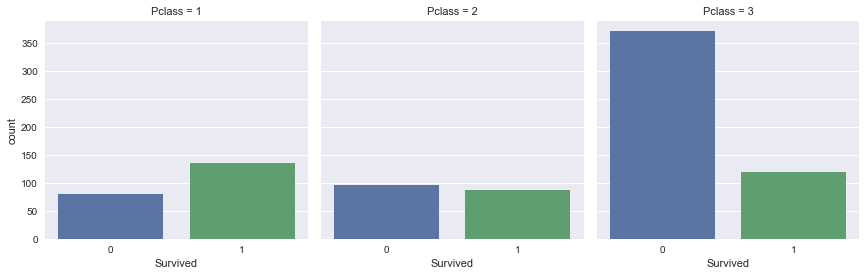
Conclusione: i passeggeri che viaggiavano in prima classe avevano maggiori probabilità di sopravvivere. Al contrario, chi viaggiava in terza classe aveva minori probabilità di sopravvivere.
seaborn per costruire bar plot della feature 'Survived' del dataset Titanic, suddivisi (facet) in base alla feature 'Embarked'.sns.factorplot(x='Survived', col='Embarked', kind='count', data=df_train);
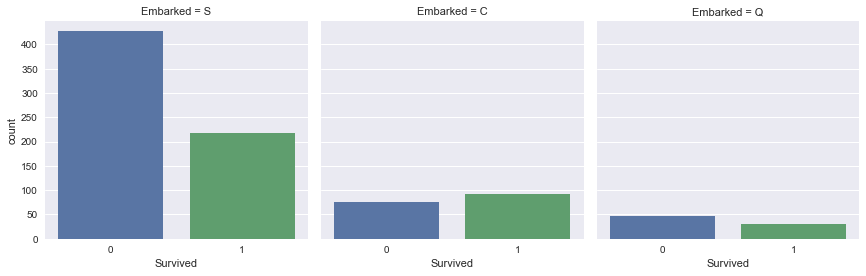
Conclusione: i passeggeri imbarcati a Southampton avevano minori probabilità di sopravvivere.
seaborn per tracciare un istogramma della colonna 'Fare' di df_train.sns.distplot(df_train.Fare, kde=False);
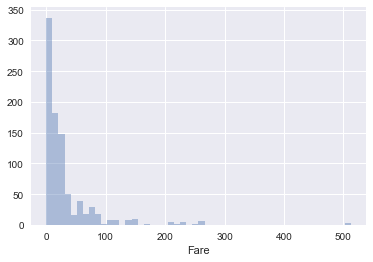
Conclusione: la maggior parte dei passeggeri ha pagato meno di 100 per viaggiare sul Titanic.
pandas per tracciare la colonna 'Fare' per ciascun valore di 'Survived' nello stesso grafico.df_train.groupby('Survived').Fare.hist(alpha=0.6);
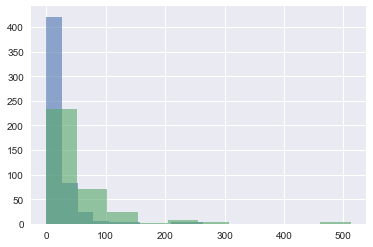
Conclusione: sembra che chi ha pagato di più avesse maggiori possibilità di sopravvivere.
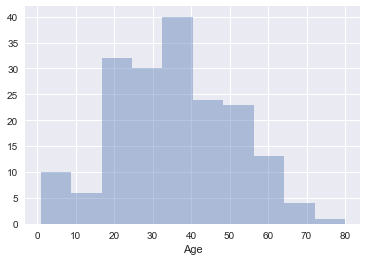
seaborn per tracciare un istogramma della colonna 'Age' di df_train. Dovrai rimuovere i valori nulli prima di farlo.df_train_drop = df_train.dropna()
sns.distplot(df_train_drop.Age, kde=False);
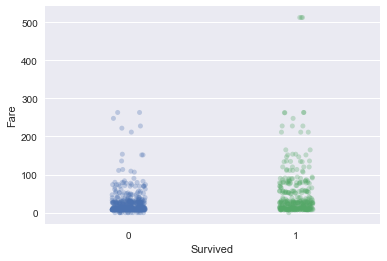
'Fare' con 'Survived' sull’asse x.sns.stripplot(x='Survived', y='Fare', data=df_train, alpha=0.3, jitter=True);
sns.swarmplot(x='Survived', y='Fare', data=df_train);
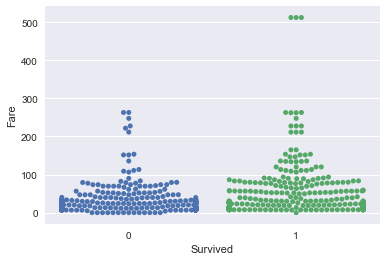
Conclusione: la tariffa sembra essere correlata alla sopravvivenza a bordo del Titanic.
.describe() per controllare le statistiche descrittive di 'Fare' in funzione della sopravvivenza.df_train.groupby('Survived').Fare.describe()
| count | mean | std | min | 25% | 50% | 75% | max | |
|---|---|---|---|---|---|---|---|---|
| Survived | ||||||||
| 0 | 549.0 | 22.117887 | 31.388207 | 0.0 | 7.8542 | 10.5 | 26.0 | 263.0000 |
| 1 | 342.0 | 48.395408 | 66.596998 | 0.0 | 12.4750 | 26.0 | 57.0 | 512.3292 |
seaborn per tracciare uno scatter plot di 'Age' contro 'Fare', colorato per 'Survived'.sns.lmplot(x='Age', y='Fare', hue='Survived', data=df_train, fit_reg=False, scatter_kws={'alpha':0.5});
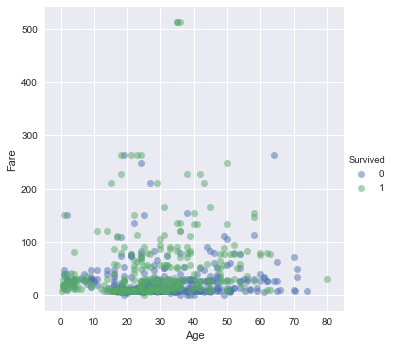
Conclusione: sembra che chi è sopravvissuto abbia pagato parecchio per il biglietto oppure fosse giovane.
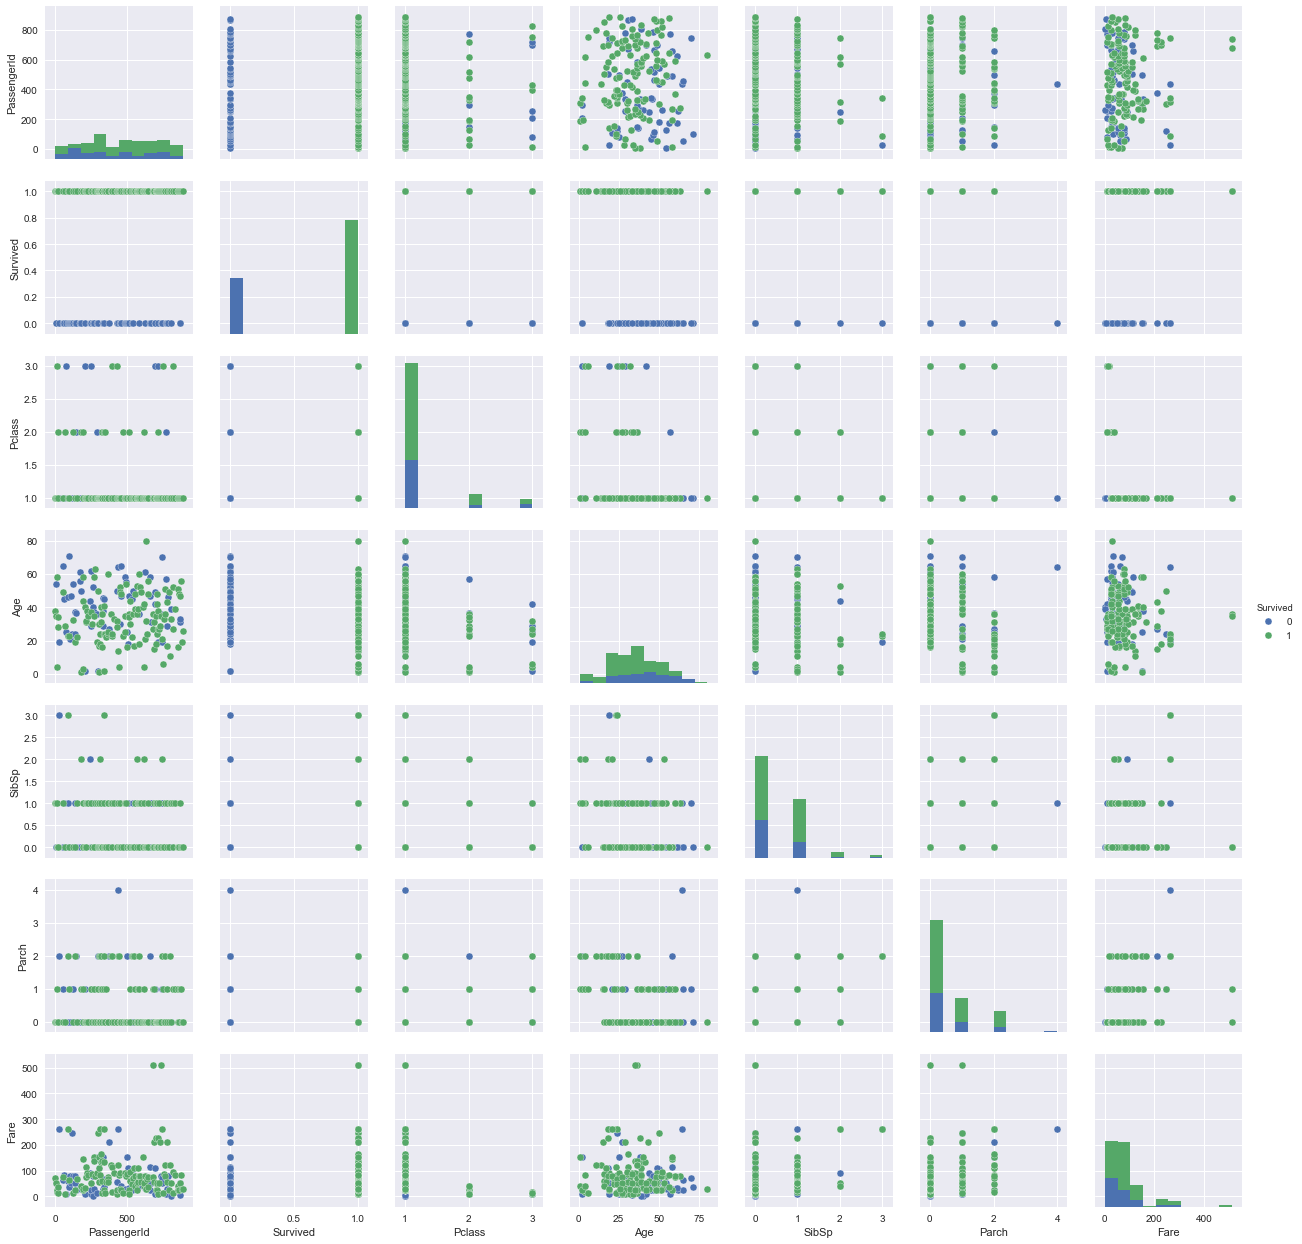
seaborn per creare una pairplot di df_train, colorata per 'Survived'. Una pairplot è un ottimo modo per mostrare in un’unica griglia la maggior parte delle informazioni che hai già scoperto.sns.pairplot(df_train_drop, hue='Survived');
In questo tutorial, hai fatto con successo:
Nel prossimo post, ti prenderai il tempo per costruire alcuni modelli di Machine Learning, in base a quanto hai imparato con l’EDA qui. Lo faremo nel prossimo post su questo progetto (in uscita il 27 dicembre).
Corsi Python
Corso
Corso
blog
Tim Lu
12 min
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min



