Curso
Introdução ao Python
4 h
7M
No início deste mês, fiz uma sessão de Live Code no Facebook em que eu (e todo mundo que programou junto) construí vários algoritmos, cada vez mais complexos, para prever se um passageiro do Titanic sobreviveu ou não, usando dados como a tarifa paga, o porto de embarque e a idade.
Neste post, você vai rever alguns dos pontos que cobrimos na sessão. Se quiser reassistir ou acompanhar o post junto com o vídeo, é só dar o play aqui:
Em especial, talvez você lembre que construímos modelos de aprendizado supervisionado.
Aprendizado supervisionado é a área de Machine Learning (ML) que envolve prever rótulos, como "Survived" ou "Not". Esses modelos aprendem com dados rotulados — ou seja, dados que indicam se um passageiro sobreviveu (o chamado "treinamento do modelo") — e depois fazem previsões em dados sem rótulo.
No Kaggle, uma plataforma de competições de modelagem preditiva e analytics, esses conjuntos são chamados de train e test porque
O Kaggle então informa a porcentagem de acertos: isso é conhecido como a acurácia do seu modelo.
Como você já deve saber, uma boa maneira de abordar aprendizado supervisionado é a seguinte:
Nesta sessão de code along, você fez — ou vai fazer — todas essas etapas!
Observação: também temos cursos para você começar com machine learning no dataset do Titanic em Python e R.
O primeiro passo é sempre importar os dados para entender rapidamente com o que você vai trabalhar. Aqui, você vai importar o pacote pandas e usar a função read_csv() para ler os dados:
Observação: nos blocos de código abaixo, outros pacotes e módulos como matplotlib, sklearn e seaborn já foram importados. Você vai usá-los mais à frente para visualização (estatística) de dados e para machine learning!
Você também usa o comando mágico do IPython %matplotlib inline para que os gráficos apareçam dentro do notebook. E adiciona sns.set() para aplicar o estilo base do Seaborn às visualizações:
# Import modules
import pandas as pd
import matplotlib.pyplot as plt
import seaborn as sns
from sklearn import tree
from sklearn.metrics import accuracy_score

# Figures inline and set visualization style
%matplotlib inline
sns.set()
Sem mais demora, vamos importar os dados e dar o primeiro passo na exploração:
# Import test and train datasets
df_train = pd.read_csv('../data/train.csv')
df_test = pd.read_csv('../data/test.csv')

# View first lines of training data
df_train.head(n=4)
| PassengerId | Survived | Pclass | Name | Sex | Age | SibSp | Parch | Ticket | Fare | Cabin | Embarked | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | 1 | 0 | 3 | Braund, Mr. Owen Harris | male | 22.0 | 1 | 0 | A/5 21171 | 7.2500 | NaN | S |
| 1 | 2 | 1 | 1 | Cumings, Mrs. John Bradley (Florence Briggs Th... | female | 38.0 | 1 | 0 | PC 17599 | 71.2833 | C85 | C |
| 2 | 3 | 1 | 3 | Heikkinen, Miss. Laina | female | 26.0 | 0 | 0 | STON/O2. 3101282 | 7.9250 | NaN | S |
| 3 | 4 | 1 | 1 | Futrelle, Mrs. Jacques Heath (Lily May Peel) | female | 35.0 | 1 | 0 | 113803 | 53.1000 | C123 | S |
Se quiser ver o que cada feature representa, confira a documentação dos dados no Kaggle aqui.
Antes de seguir, vale alinhar a terminologia:
Com isso em mente, você pode continuar explorando os dados usando, por exemplo, a função head(), que exibe as cinco primeiras linhas do seu dataset:
# View first lines of test data
df_test.head()
| PassengerId | Pclass | Name | Sex | Age | SibSp | Parch | Ticket | Fare | Cabin | Embarked | |
|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | 892 | 3 | Kelly, Mr. James | male | 34.5 | 0 | 0 | 330911 | 7.8292 | NaN | Q |
| 1 | 893 | 3 | Wilkes, Mrs. James (Ellen Needs) | female | 47.0 | 1 | 0 | 363272 | 7.0000 | NaN | S |
| 2 | 894 | 2 | Myles, Mr. Thomas Francis | male | 62.0 | 0 | 0 | 240276 | 9.6875 | NaN | Q |
| 3 | 895 | 3 | Wirz, Mr. Albert | male | 27.0 | 0 | 0 | 315154 | 8.6625 | NaN | S |
| 4 | 896 | 3 | Hirvonen, Mrs. Alexander (Helga E Lindqvist) | female | 22.0 | 1 | 1 | 3101298 | 12.2875 | NaN | S |
Note que o DataFrame df_test não tem a coluna 'Survived', porque é justamente o que você vai prever!
.info() do DataFrame para ver tipos de dados, valores ausentes e mais (de df_train).df_train.info()
<class 'pandas.core.frame.DataFrame'>
RangeIndex: 891 entries, 0 to 890
Data columns (total 12 columns):
PassengerId    891 non-null int64
Survived       891 non-null int64
Pclass         891 non-null int64
Name           891 non-null object
Sex            891 non-null object
Age            714 non-null float64
SibSp          891 non-null int64
Parch          891 non-null int64
Ticket         891 non-null object
Fare           891 non-null float64
Cabin          204 non-null object
Embarked       889 non-null object
dtypes: float64(2), int64(5), object(5)
memory usage: 83.6+ KB
Neste caso, dá para ver que há apenas 714 valores não nulos na coluna 'Age' em um DataFrame com 891 linhas. Isso significa que existem 177 valores nulos ou ausentes.
.describe() do DataFrame para ver estatísticas descritivas das colunas numéricas (de df_train).df_train.describe()
| PassengerId | Survived | Pclass | Age | SibSp | Parch | Fare | |
|---|---|---|---|---|---|---|---|
| count | 891.000000 | 891.000000 | 891.000000 | 714.000000 | 891.000000 | 891.000000 | 891.000000 |
| mean | 446.000000 | 0.383838 | 2.308642 | 29.699118 | 0.523008 | 0.381594 | 32.204208 |
| std | 257.353842 | 0.486592 | 0.836071 | 14.526497 | 1.102743 | 0.806057 | 49.693429 |
| min | 1.000000 | 0.000000 | 1.000000 | 0.420000 | 0.000000 | 0.000000 | 0.000000 |
| 25% | 223.500000 | 0.000000 | 2.000000 | 20.125000 | 0.000000 | 0.000000 | 7.910400 |
| 50% | 446.000000 | 0.000000 | 3.000000 | 28.000000 | 0.000000 | 0.000000 | 14.454200 |
| 75% | 668.500000 | 1.000000 | 3.000000 | 38.000000 | 1.000000 | 0.000000 | 31.000000 |
| max | 891.000000 | 1.000000 | 3.000000 | 80.000000 | 8.000000 | 6.000000 | 512.329200 |
Agora que você tem uma ideia do formato dos dados e conferiu algumas estatísticas, é hora de visualizar com a ajuda do seaborn:
seaborn para criar um gráfico de barras da sobrevivência no Titanic, que é sua variável-alvo.sns.countplot(x='Survived', data=df_train);
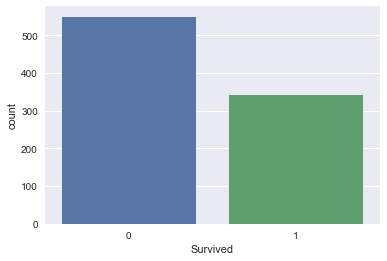
Conclusão: no conjunto de treino, menos pessoas sobreviveram do que não sobreviveram. Vamos então construir um primeiro modelo que prevê que ninguém sobreviveu.
Esse é um modelo ruim, porque sabemos que houve sobreviventes. Mas ele nos dá um baseline: qualquer modelo futuro precisa superar esse desempenho.
Você pode fazer assim:
'Survived' em df_test que codifique "não sobreviveu" para todas as linhas;'PassengerId' e 'Survived' de df_test em um .csv e envie ao Kaggle.df_test['Survived'] = 0
df_test[['PassengerId', 'Survived']].to_csv('data/predictions/no_survivors.csv', index=False)
Qual foi a acurácia? No Kaggle, a acurácia é de 62,7.
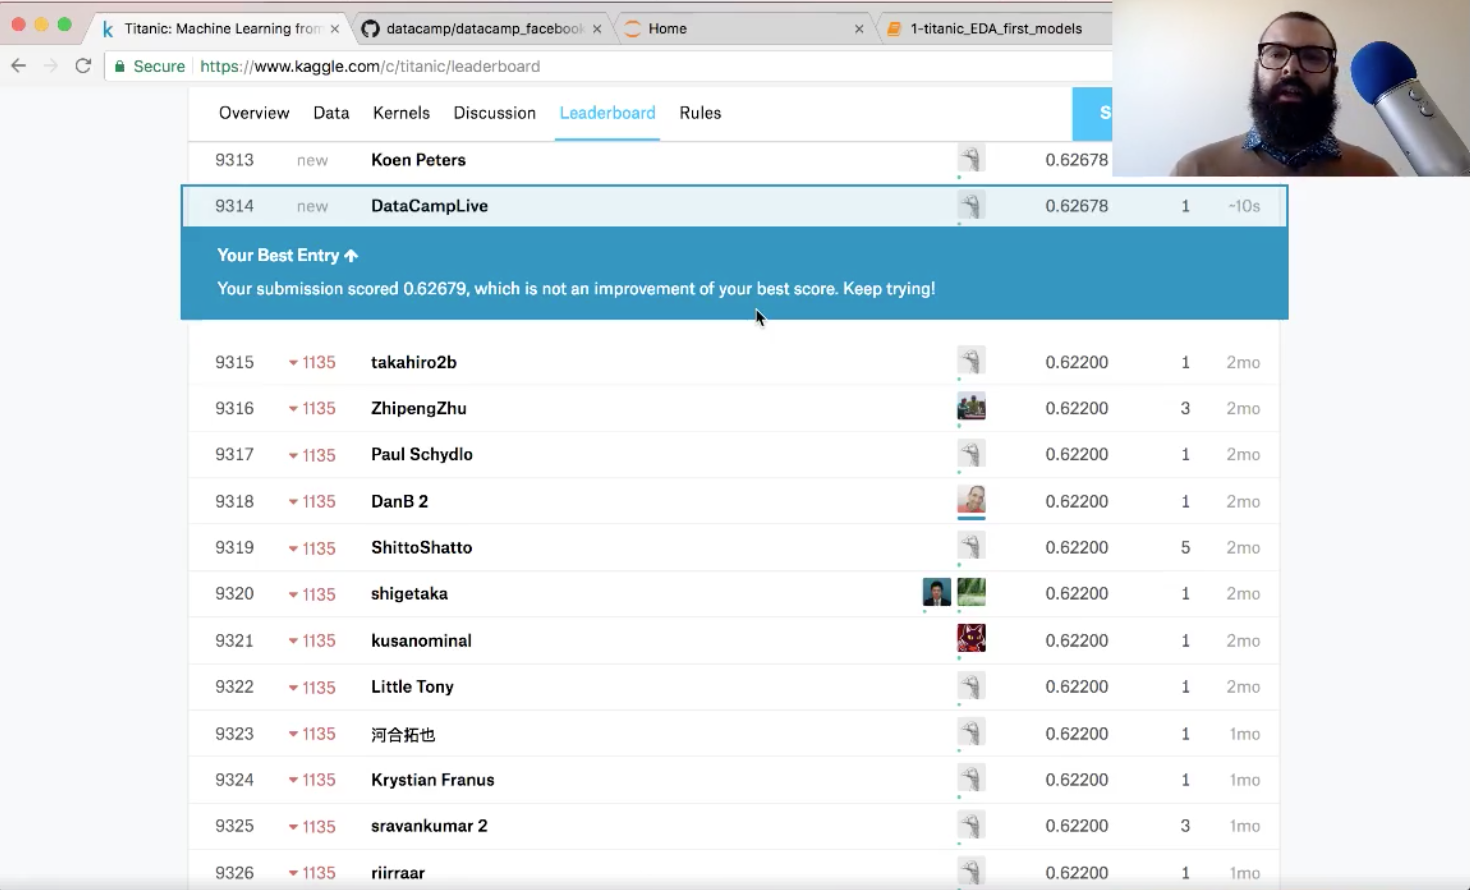
Nada mal!
Nota essencial! Você também vai querer usar métricas além de acurácia!
Agora que você criou um modelo "rápido e sujo", é hora de iterar: vamos fazer mais análise exploratória e logo construir outro modelo!
seaborn para criar um gráfico de barras da feature 'Sex' do Titanic (de df_train).sns.countplot(x='Sex', data=df_train);
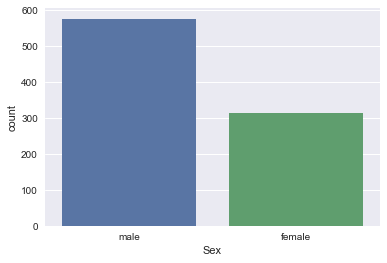
seaborn para criar gráficos de barras de 'Survived' segmentados (facetados) por 'Sex'.sns.factorplot(x='Survived', col='Sex', kind='count', data=df_train);
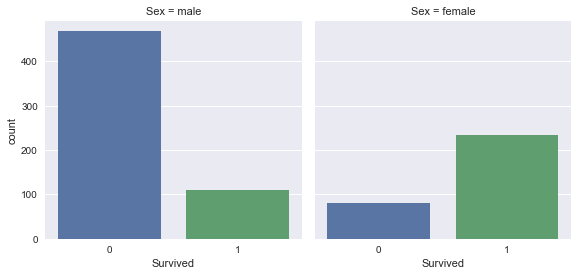
Conclusão: mulheres tinham mais chance de sobreviver do que homens.
pandas para ver quantas mulheres e quantos homens sobreviveram:df_train.groupby(['Sex']).Survived.sum()
Sex
female    233
male      109
Name: Survived, dtype: int64
pandas para calcular a proporção de mulheres que sobreviveram e a proporção de homens:print(df_train[df_train.Sex == 'female'].Survived.sum()/df_train[df_train.Sex == 'female'].Survived.count())
print(df_train[df_train.Sex == 'male'].Survived.sum()/df_train[df_train.Sex == 'male'].Survived.count())
0.742038216561
0.188908145581
74% das mulheres sobreviveram, enquanto 19% dos homens sobreviveram.
Agora vamos construir um segundo modelo e prever que todas as mulheres sobreviveram e todos os homens não. De novo, é um modelo irrealista, mas fornece um baseline para comparar os próximos.
'Survived' em df_test codificando a previsão acima.'PassengerId' e 'Survived' de df_test em um .csv e envie ao Kaggle.df_test['Survived'] = df_test.Sex == 'female'
df_test['Survived'] = df_test.Survived.apply(lambda x: int(x))
df_test.head()
| PassengerId | Pclass | Name | Sex | Age | SibSp | Parch | Ticket | Fare | Cabin | Embarked | Survived | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | 892 | 3 | Kelly, Mr. James | male | 34.5 | 0 | 0 | 330911 | 7.8292 | NaN | Q | 0 |
| 1 | 893 | 3 | Wilkes, Mrs. James (Ellen Needs) | female | 47.0 | 1 | 0 | 363272 | 7.0000 | NaN | S | 1 |
| 2 | 894 | 2 | Myles, Mr. Thomas Francis | male | 62.0 | 0 | 0 | 240276 | 9.6875 | NaN | Q | 0 |
| 3 | 895 | 3 | Wirz, Mr. Albert | male | 27.0 | 0 | 0 | 315154 | 8.6625 | NaN | S | 0 |
| 4 | 896 | 3 | Hirvonen, Mrs. Alexander (Helga E Lindqvist) | female | 22.0 | 1 | 1 | 3101298 | 12.2875 | NaN | S | 1 |
df_test[['PassengerId', 'Survived']].to_csv('../data/predictions/women_survive.csv', index=False)
E qual foi a acurácia desse modelo ao enviar para o Kaggle?
No Kaggle, a acurácia é de 76,6%:
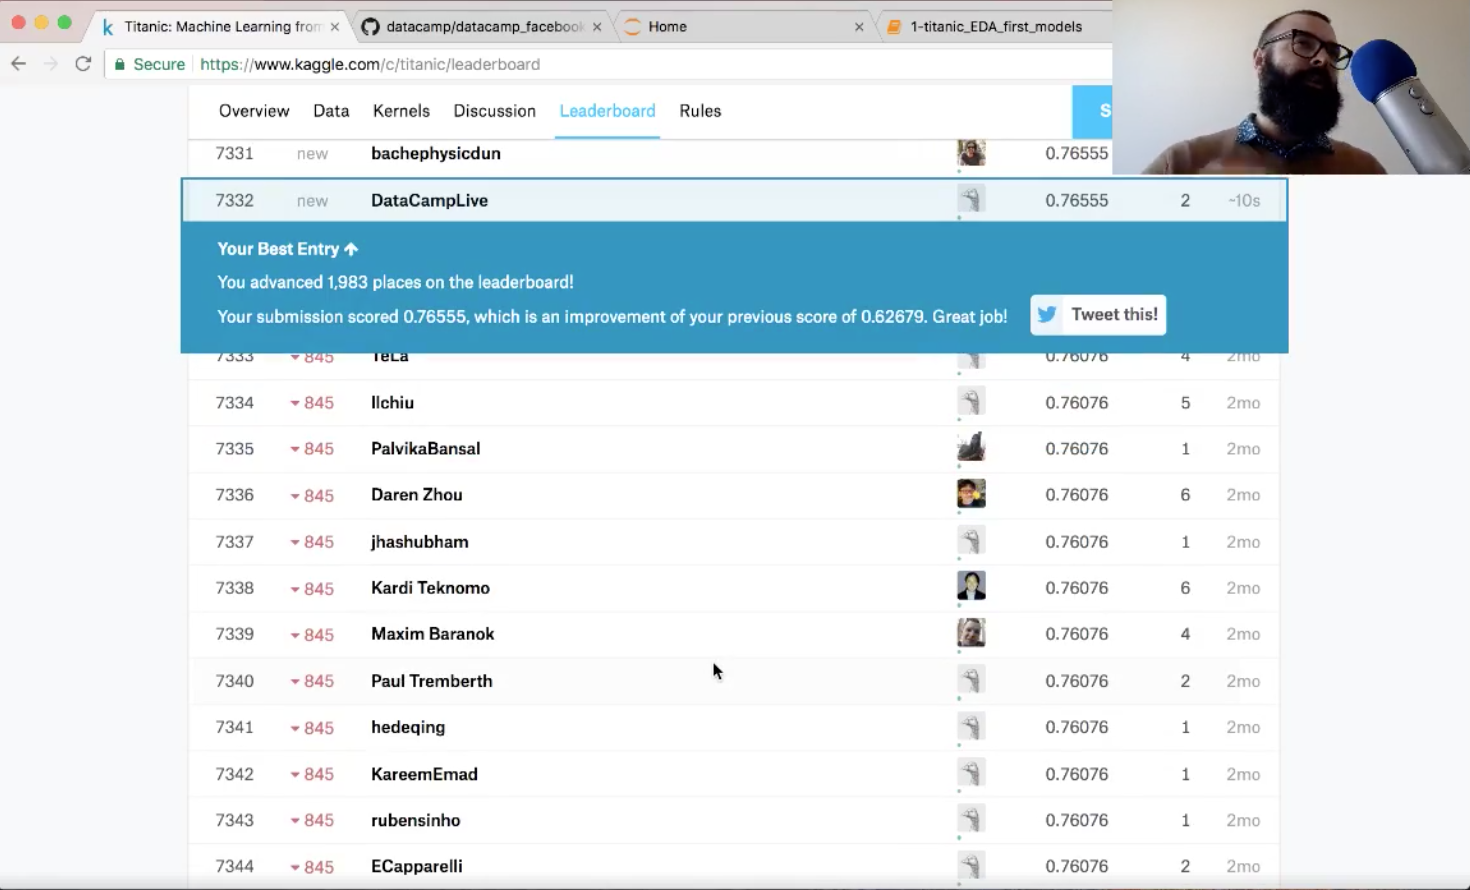
Com esse envio, você subiu cerca de 2.000 posições no ranking! Além disso, melhorou sua pontuação — ótimo trabalho!
seaborn para criar gráficos de barras de 'Survived' segmentados (facetados) por 'Pclass' no dataset do Titanic.sns.factorplot(x='Survived', col='Pclass', kind='count', data=df_train);
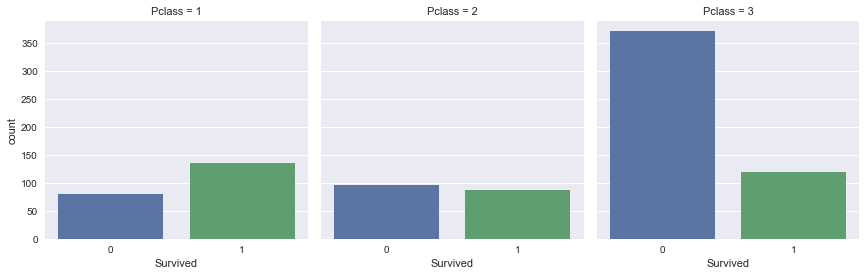
Conclusão: passageiros de primeira classe tinham mais chance de sobreviver. Já os da terceira classe tinham menos chance.
seaborn para criar gráficos de barras de 'Survived' segmentados (facetados) por 'Embarked'.sns.factorplot(x='Survived', col='Embarked', kind='count', data=df_train);
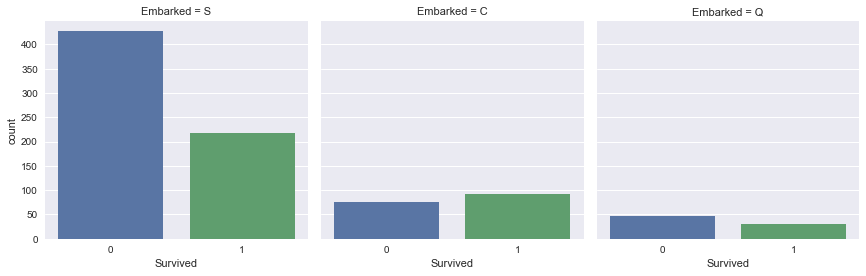
Conclusão: passageiros que embarcaram em Southampton tinham menos chance de sobreviver.
seaborn para plotar um histograma da coluna 'Fare' de df_train.sns.distplot(df_train.Fare, kde=False);
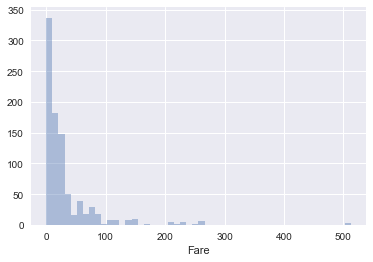
Conclusão: a maioria dos passageiros pagou menos de 100 para viajar no Titanic.
pandas para plotar a coluna 'Fare' para cada valor de 'Survived' no mesmo gráfico.df_train.groupby('Survived').Fare.hist(alpha=0.6);
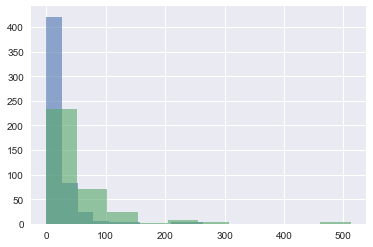
Conclusão: parece que quem pagou mais teve maior chance de sobreviver.
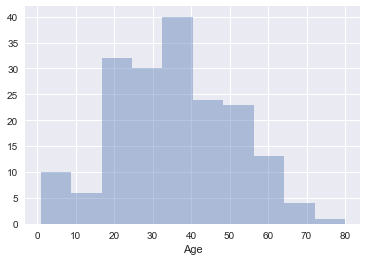
seaborn para plotar um histograma da coluna 'Age' de df_train. Primeiro, elimine os valores nulos.df_train_drop = df_train.dropna()
sns.distplot(df_train_drop.Age, kde=False);
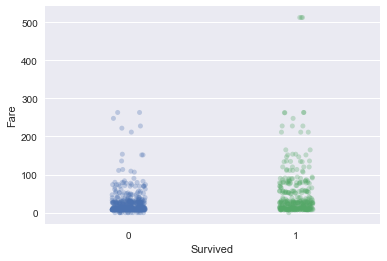
'Fare' com 'Survived' no eixo x.sns.stripplot(x='Survived', y='Fare', data=df_train, alpha=0.3, jitter=True);
sns.swarmplot(x='Survived', y='Fare', data=df_train);
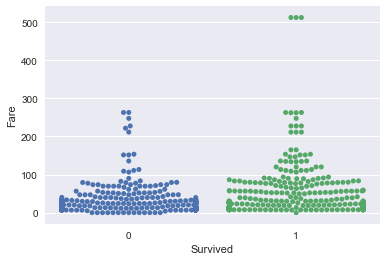
Conclusão: a tarifa (Fare) parece estar, de fato, correlacionada com a sobrevivência no Titanic.
.describe() para ver estatísticas descritivas de 'Fare' em função de 'Survived'.df_train.groupby('Survived').Fare.describe()
| count | mean | std | min | 25% | 50% | 75% | max | |
|---|---|---|---|---|---|---|---|---|
| Survived | ||||||||
| 0 | 549.0 | 22.117887 | 31.388207 | 0.0 | 7.8542 | 10.5 | 26.0 | 263.0000 |
| 1 | 342.0 | 48.395408 | 66.596998 | 0.0 | 12.4750 | 26.0 | 57.0 | 512.3292 |
seaborn para fazer um scatter plot de 'Age' contra 'Fare', colorido por 'Survived'.sns.lmplot(x='Age', y='Fare', hue='Survived', data=df_train, fit_reg=False, scatter_kws={'alpha':0.5});
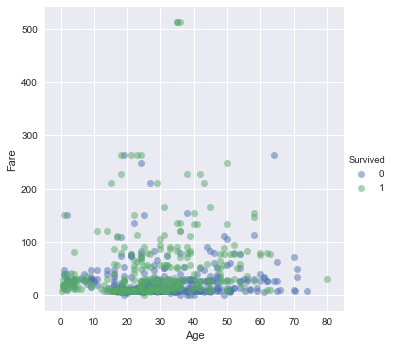
Conclusão: parece que quem sobreviveu ou pagou bem mais pela passagem, ou era mais jovem.
seaborn para criar um pairplot de df_train, colorido por 'Survived'. Um pairplot é ótimo para exibir, em uma única grade, boa parte do que você já descobriu.sns.pairplot(df_train_drop, hue='Survived');
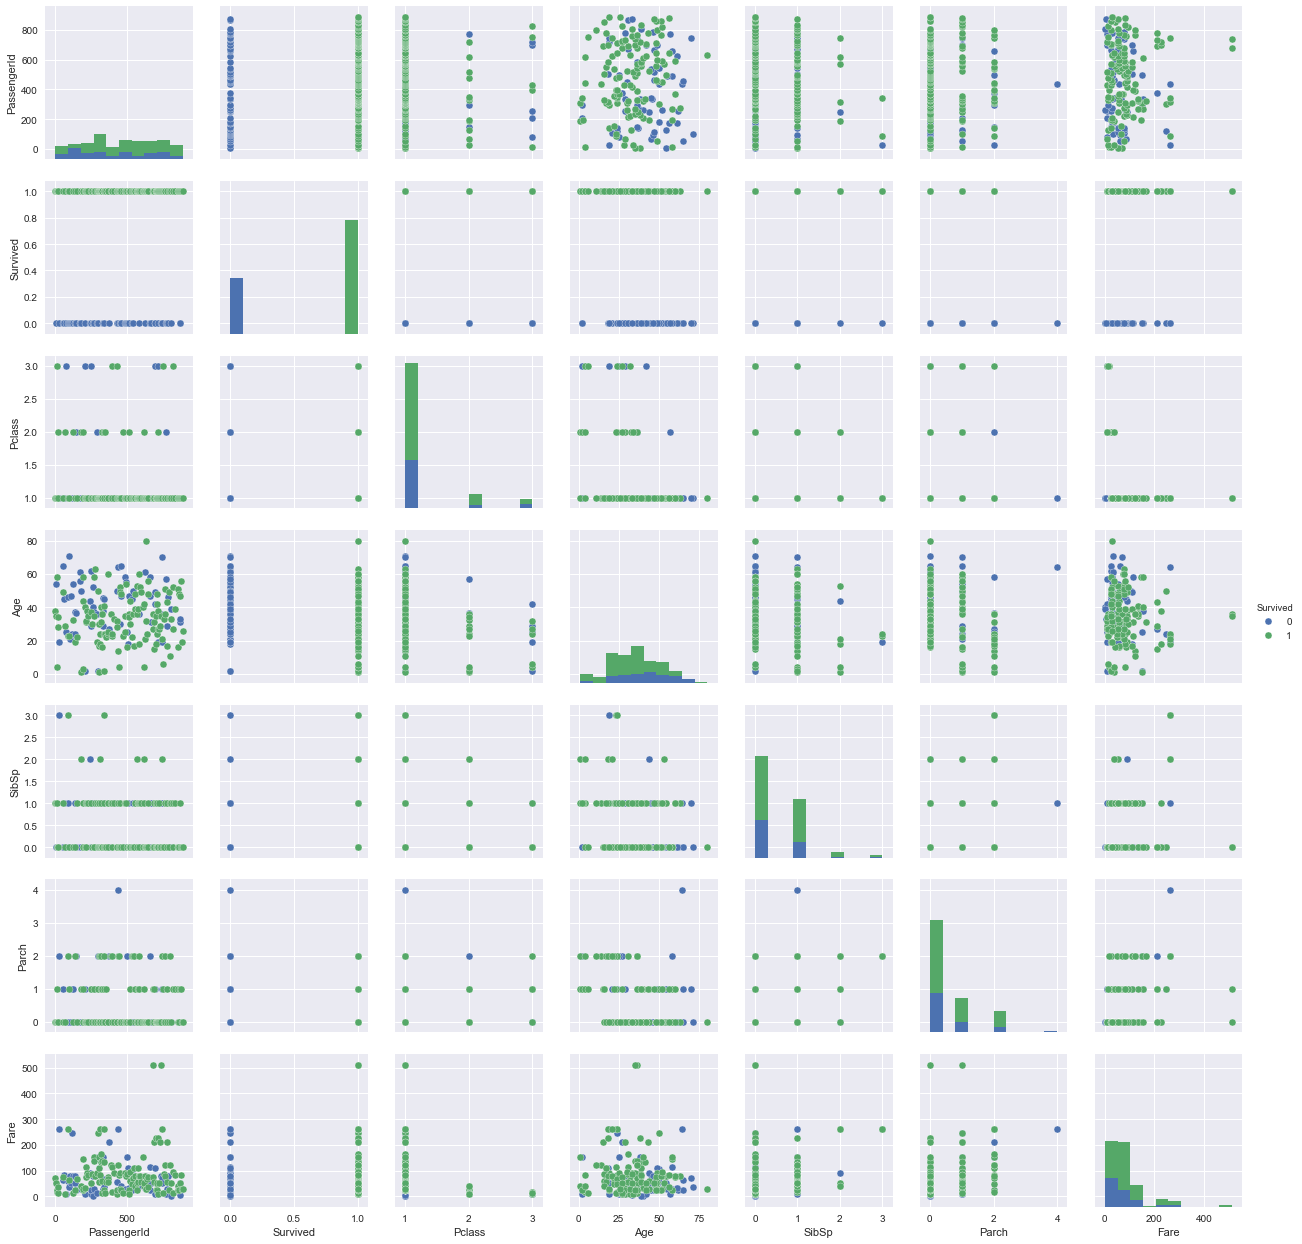
Neste tutorial, você:
No próximo post, você vai dedicar um tempo para construir alguns modelos de Machine Learning, com base no que aprendeu aqui na EDA. Vamos fazer isso no próximo post deste projeto (lançamento em 27 de dezembro).
Cursos de Python
Curso
Curso
Tutorial
Kevin Babitz
8 min
Tutorial
Moez Ali
14 min
Tutorial
Moez Ali
9 min
Tutorial
DataCamp Team
13 min
Tutorial
Karlijn Willems
15 min
Tutorial
Vidhi Chugh
15 min





