Curso
Introducción a Python
4 h
7M
A comienzos de este mes hice una sesión de Facebook Live Code Along en la que yo (y todas las personas que se unieron al código en directo) construimos varios algoritmos, cada vez más complejos, para predecir si un pasajero del Titanic sobrevivió o no, a partir de datos como la tarifa que pagó, el puerto de embarque o su edad.
En esta publicación repasaremos parte de lo que vimos en esa sesión. Si quieres volver a verla o seguir esta guía junto con el vídeo, puedes verlo aquí:
En concreto, quizá recuerdes que construimos modelos de aprendizaje supervisado.
El aprendizaje supervisado es la rama del Machine Learning (ML) que se centra en predecir etiquetas, como "Survived" o "Not". Estos modelos aprenden a partir de datos etiquetados —es decir, datos que incluyen si un pasajero sobrevivió (lo que llamamos "entrenamiento del modelo")— y luego predicen sobre datos sin etiquetar.
En Kaggle, una plataforma de competiciones de modelización predictiva y analítica, a estos conjuntos se les llama train y test porque
Kaggle te devuelve el porcentaje de aciertos: esto es la accuracy o precisión de tu modelo.
Como ya sabrás, un buen enfoque para el aprendizaje supervisado es el siguiente:
En esta sesión de code along, hiciste (o harás) todos estos pasos.
Nota: también tenemos cursos para que te pongas en marcha con machine learning para el dataset del Titanic en Python y R.
El primer paso siempre es importar los datos para revisar rápidamente con qué vas a trabajar. En este caso, importarás el paquete pandas y usarás la función read_csv() para leer los datos:
Nota: en los bloques de código de abajo ya se han importado otros paquetes y módulos como matplotlib, sklearn y seaborn. Más adelante los usarás en mayor profundidad para visualización (estadística) de datos y para machine learning.
También usas el comando mágico de IPython %matplotlib inline para que las gráficas aparezcan embebidas en el notebook. Además, añades sns.set() para aplicar el estilo base de Seaborn a las visualizaciones:
# Import modules
import pandas as pd
import matplotlib.pyplot as plt
import seaborn as sns
from sklearn import tree
from sklearn.metrics import accuracy_score

# Figures inline and set visualization style
%matplotlib inline
sns.set()
Sin más, vamos a importar los datos y dar el primer paso para examinarlos:
# Import test and train datasets
df_train = pd.read_csv('../data/train.csv')
df_test = pd.read_csv('../data/test.csv')

# View first lines of training data
df_train.head(n=4)
| PassengerId | Survived | Pclass | Name | Sex | Age | SibSp | Parch | Ticket | Fare | Cabin | Embarked | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | 1 | 0 | 3 | Braund, Mr. Owen Harris | male | 22.0 | 1 | 0 | A/5 21171 | 7.2500 | NaN | S |
| 1 | 2 | 1 | 1 | Cumings, Mrs. John Bradley (Florence Briggs Th... | female | 38.0 | 1 | 0 | PC 17599 | 71.2833 | C85 | C |
| 2 | 3 | 1 | 3 | Heikkinen, Miss. Laina | female | 26.0 | 0 | 0 | STON/O2. 3101282 | 7.9250 | NaN | S |
| 3 | 4 | 1 | 1 | Futrelle, Mrs. Jacques Heath (Lily May Peel) | female | 35.0 | 1 | 0 | 113803 | 53.1000 | C123 | S |
Si quieres ver qué significa cada una de estas variables, consulta la documentación de datos de Kaggle aquí.
Antes de seguir, conviene tener claras estas definiciones:
Con esto en mente, puedes seguir explorando tus datos con, por ejemplo, la función head(), que te muestra las primeras cinco filas del conjunto:
# View first lines of test data
df_test.head()
| PassengerId | Pclass | Name | Sex | Age | SibSp | Parch | Ticket | Fare | Cabin | Embarked | |
|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | 892 | 3 | Kelly, Mr. James | male | 34.5 | 0 | 0 | 330911 | 7.8292 | NaN | Q |
| 1 | 893 | 3 | Wilkes, Mrs. James (Ellen Needs) | female | 47.0 | 1 | 0 | 363272 | 7.0000 | NaN | S |
| 2 | 894 | 2 | Myles, Mr. Thomas Francis | male | 62.0 | 0 | 0 | 240276 | 9.6875 | NaN | Q |
| 3 | 895 | 3 | Wirz, Mr. Albert | male | 27.0 | 0 | 0 | 315154 | 8.6625 | NaN | S |
| 4 | 896 | 3 | Hirvonen, Mrs. Alexander (Helga E Lindqvist) | female | 22.0 | 1 | 1 | 3101298 | 12.2875 | NaN | S |
Fíjate en que el DataFrame df_test no tiene la columna 'Survived' porque justo eso es lo que vas a predecir.
.info() del DataFrame para ver tipos de datos, valores ausentes y más (de df_train).df_train.info()
<class 'pandas.core.frame.DataFrame'>
RangeIndex: 891 entries, 0 to 890
Data columns (total 12 columns):
PassengerId    891 non-null int64
Survived       891 non-null int64
Pclass         891 non-null int64
Name           891 non-null object
Sex            891 non-null object
Age            714 non-null float64
SibSp          891 non-null int64
Parch          891 non-null int64
Ticket         891 non-null object
Fare           891 non-null float64
Cabin          204 non-null object
Embarked       889 non-null object
dtypes: float64(2), int64(5), object(5)
memory usage: 83.6+ KB
En este caso, ves que solo hay 714 valores no nulos para la columna "Age" en un DataFrame con 891 filas. Esto significa que hay 177 valores nulos o ausentes.
.describe() del DataFrame para ver estadísticas descriptivas de las columnas numéricas (de df_train).df_train.describe()
| PassengerId | Survived | Pclass | Age | SibSp | Parch | Fare | |
|---|---|---|---|---|---|---|---|
| count | 891.000000 | 891.000000 | 891.000000 | 714.000000 | 891.000000 | 891.000000 | 891.000000 |
| mean | 446.000000 | 0.383838 | 2.308642 | 29.699118 | 0.523008 | 0.381594 | 32.204208 |
| std | 257.353842 | 0.486592 | 0.836071 | 14.526497 | 1.102743 | 0.806057 | 49.693429 |
| min | 1.000000 | 0.000000 | 1.000000 | 0.420000 | 0.000000 | 0.000000 | 0.000000 |
| 25% | 223.500000 | 0.000000 | 2.000000 | 20.125000 | 0.000000 | 0.000000 | 7.910400 |
| 50% | 446.000000 | 0.000000 | 3.000000 | 28.000000 | 0.000000 | 0.000000 | 14.454200 |
| 75% | 668.500000 | 1.000000 | 3.000000 | 38.000000 | 1.000000 | 0.000000 | 31.000000 |
| max | 891.000000 | 1.000000 | 3.000000 | 80.000000 | 8.000000 | 6.000000 | 512.329200 |
Ahora que ya te haces una idea del aspecto de los datos y has visto algunas estadísticas, es momento de visualizarlos con ayuda del paquete seaborn:
seaborn para crear un gráfico de barras de la variable de supervivencia del Titanic, que es tu variable objetivo.sns.countplot(x='Survived', data=df_train);
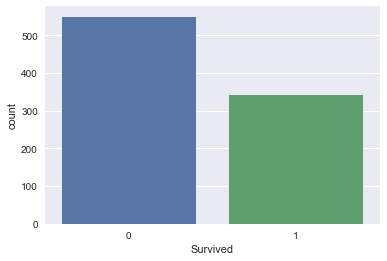
Conclusión: en el conjunto de entrenamiento, sobrevivió menos gente de la que no sobrevivió. Construyamos entonces un primer modelo que prediga que nadie sobrevivió.
Sabemos que es un mal modelo, porque hubo supervivientes. Pero nos da una referencia: cualquier modelo que construyamos después debe hacerlo mejor.
Puedes hacerlo siguiendo estos pasos:
'Survived' en df_test que codifique "no sobrevivió" para todas las filas;'PassengerId' y 'Survived' de df_test en un .csv y enviarlo a Kaggle.df_test['Survived'] = 0
df_test[['PassengerId', 'Survived']].to_csv('data/predictions/no_survivors.csv', index=False)
¿Qué precisión te dio esto? La accuracy en Kaggle es 62.7.
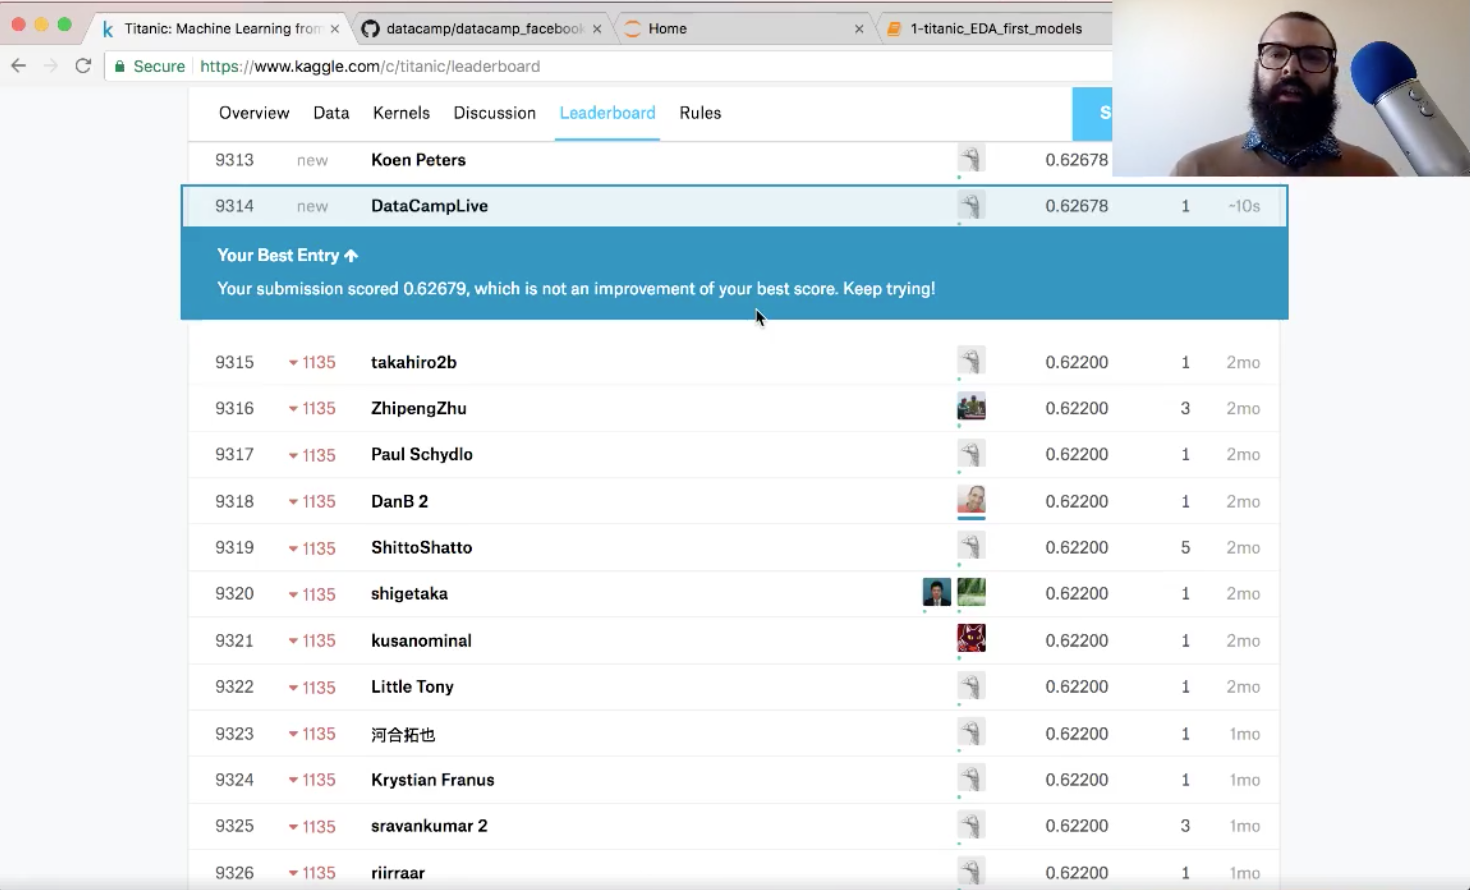
¡No está nada mal!
¡Nota importante! También querrás usar métricas distintas a la accuracy.
Ahora que tienes un modelo rápido, toca iterar: hagamos más análisis exploratorio y pronto construiremos otro modelo.
seaborn para crear un gráfico de barras de la variable 'Sex' del conjunto del Titanic (de df_train).sns.countplot(x='Sex', data=df_train);
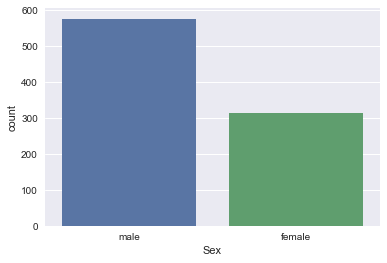
seaborn para crear gráficos de barras de 'Survived' segmentados (facetados) por 'Sex'.sns.factorplot(x='Survived', col='Sex', kind='count', data=df_train);
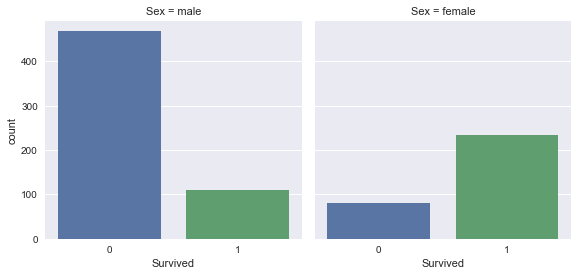
Conclusión: las mujeres tenían más probabilidades de sobrevivir que los hombres.
pandas para ver cuántas mujeres y cuántos hombres sobrevivieron:df_train.groupby(['Sex']).Survived.sum()
Sex
female    233
male      109
Name: Survived, dtype: int64
pandas para calcular la proporción de mujeres que sobrevivieron y la de hombres:print(df_train[df_train.Sex == 'female'].Survived.sum()/df_train[df_train.Sex == 'female'].Survived.count())
print(df_train[df_train.Sex == 'male'].Survived.sum()/df_train[df_train.Sex == 'male'].Survived.count())
0.742038216561
0.188908145581
El 74% de las mujeres sobrevivieron, frente al 19% de los hombres.
Ahora construyamos un segundo modelo y predigamos que todas las mujeres sobrevivieron y todos los hombres no. De nuevo, es un modelo irreal, pero nos da una referencia con la que comparar futuros modelos.
'Survived' en df_test que codifique la predicción anterior.'PassengerId' y 'Survived' de df_test en un .csv y envíalo a Kaggle.df_test['Survived'] = df_test.Sex == 'female'
df_test['Survived'] = df_test.Survived.apply(lambda x: int(x))
df_test.head()
| PassengerId | Pclass | Name | Sex | Age | SibSp | Parch | Ticket | Fare | Cabin | Embarked | Survived | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | 892 | 3 | Kelly, Mr. James | male | 34.5 | 0 | 0 | 330911 | 7.8292 | NaN | Q | 0 |
| 1 | 893 | 3 | Wilkes, Mrs. James (Ellen Needs) | female | 47.0 | 1 | 0 | 363272 | 7.0000 | NaN | S | 1 |
| 2 | 894 | 2 | Myles, Mr. Thomas Francis | male | 62.0 | 0 | 0 | 240276 | 9.6875 | NaN | Q | 0 |
| 3 | 895 | 3 | Wirz, Mr. Albert | male | 27.0 | 0 | 0 | 315154 | 8.6625 | NaN | S | 0 |
| 4 | 896 | 3 | Hirvonen, Mrs. Alexander (Helga E Lindqvist) | female | 22.0 | 1 | 1 | 3101298 | 12.2875 | NaN | S | 1 |
df_test[['PassengerId', 'Survived']].to_csv('../data/predictions/women_survive.csv', index=False)
Y ahora, ¿qué precisión te dio este modelo al enviarlo a Kaggle?
La accuracy en Kaggle es del 76.6%:
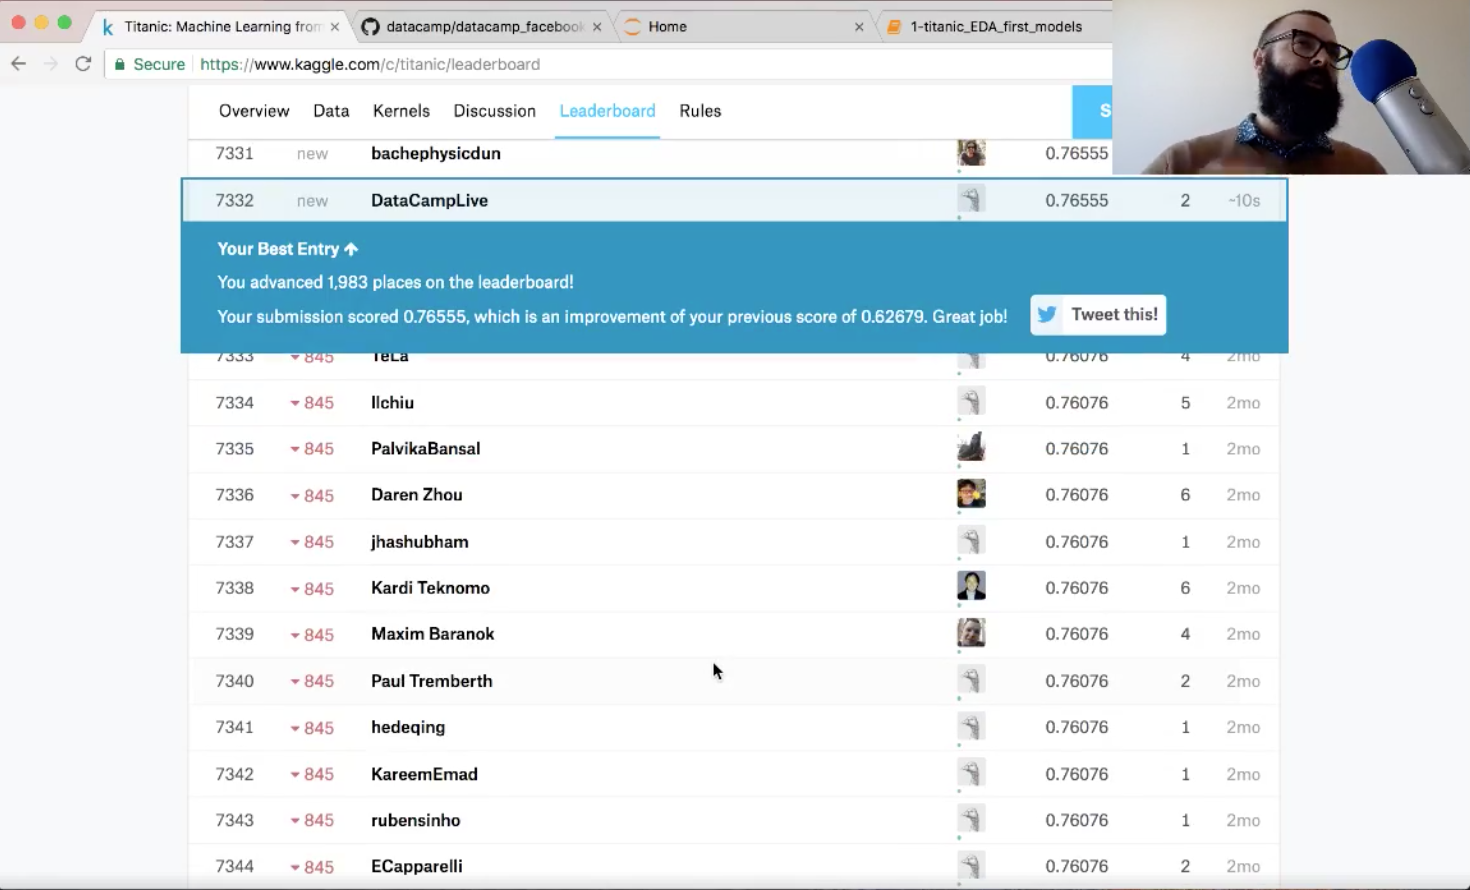
¡Con este envío subiste unas 2.000 posiciones en el ranking! Además, has mejorado tu puntuación, así que buen trabajo.
seaborn para crear gráficos de barras de 'Survived' segmentados por 'Pclass'.sns.factorplot(x='Survived', col='Pclass', kind='count', data=df_train);
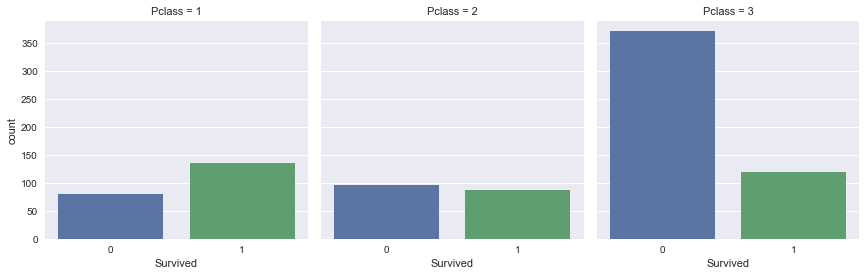
Conclusión: los pasajeros de primera clase tenían más probabilidades de sobrevivir. En cambio, quienes viajaban en tercera clase tenían menos probabilidades.
seaborn para crear gráficos de barras de 'Survived' segmentados por 'Embarked'.sns.factorplot(x='Survived', col='Embarked', kind='count', data=df_train);
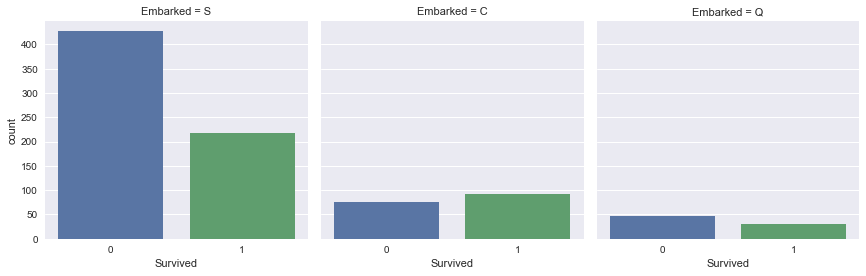
Conclusión: los pasajeros que embarcaron en Southampton tenían menos probabilidades de sobrevivir.
seaborn para dibujar un histograma de la columna 'Fare' de df_train.sns.distplot(df_train.Fare, kde=False);
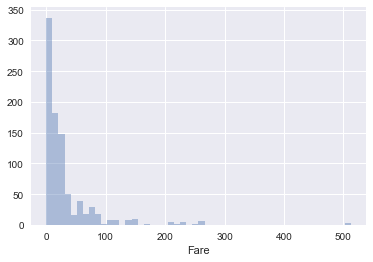
Conclusión: la mayoría de los pasajeros pagaron menos de 100 por viajar en el Titanic.
pandas para representar la columna 'Fare' para cada valor de 'Survived' en la misma gráfica.df_train.groupby('Survived').Fare.hist(alpha=0.6);
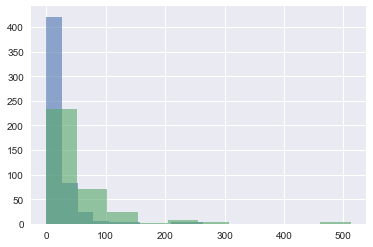
Conclusión: parece que quienes pagaron más tuvieron mayor probabilidad de sobrevivir.
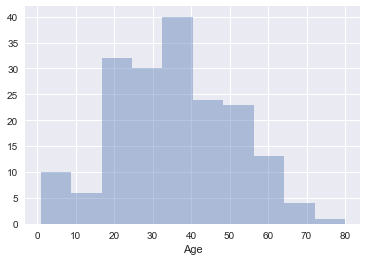
seaborn para dibujar un histograma de la columna 'Age' de df_train. Antes tendrás que eliminar los valores nulos.df_train_drop = df_train.dropna()
sns.distplot(df_train_drop.Age, kde=False);
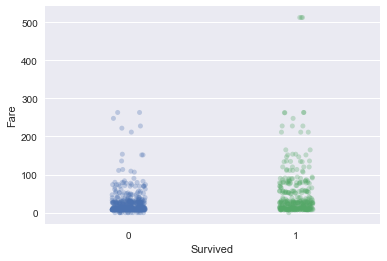
'Fare' con 'Survived' en el eje X.sns.stripplot(x='Survived', y='Fare', data=df_train, alpha=0.3, jitter=True);
sns.swarmplot(x='Survived', y='Fare', data=df_train);
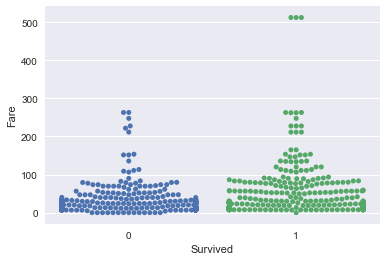
Conclusión: la tarifa parece estar claramente correlacionada con la supervivencia a bordo del Titanic.
.describe() del DataFrame para consultar estadísticas descriptivas de 'Fare' en función de 'Survived'.df_train.groupby('Survived').Fare.describe()
| count | mean | std | min | 25% | 50% | 75% | max | |
|---|---|---|---|---|---|---|---|---|
| Survived | ||||||||
| 0 | 549.0 | 22.117887 | 31.388207 | 0.0 | 7.8542 | 10.5 | 26.0 | 263.0000 |
| 1 | 342.0 | 48.395408 | 66.596998 | 0.0 | 12.4750 | 26.0 | 57.0 | 512.3292 |
seaborn para crear un diagrama de dispersión de 'Age' frente a 'Fare', coloreado por 'Survived'.sns.lmplot(x='Age', y='Fare', hue='Survived', data=df_train, fit_reg=False, scatter_kws={'alpha':0.5});
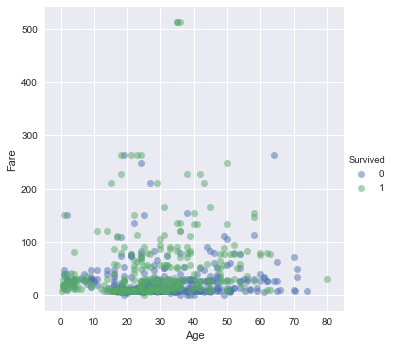
Conclusión: parece que quienes sobrevivieron o bien pagaron bastante por su billete o bien eran jóvenes.
seaborn para crear un pairplot de df_train coloreado por 'Survived'. Un pairplot es una forma estupenda de mostrar en una sola cuadrícula gran parte de lo que ya has descubierto.sns.pairplot(df_train_drop, hue='Survived');
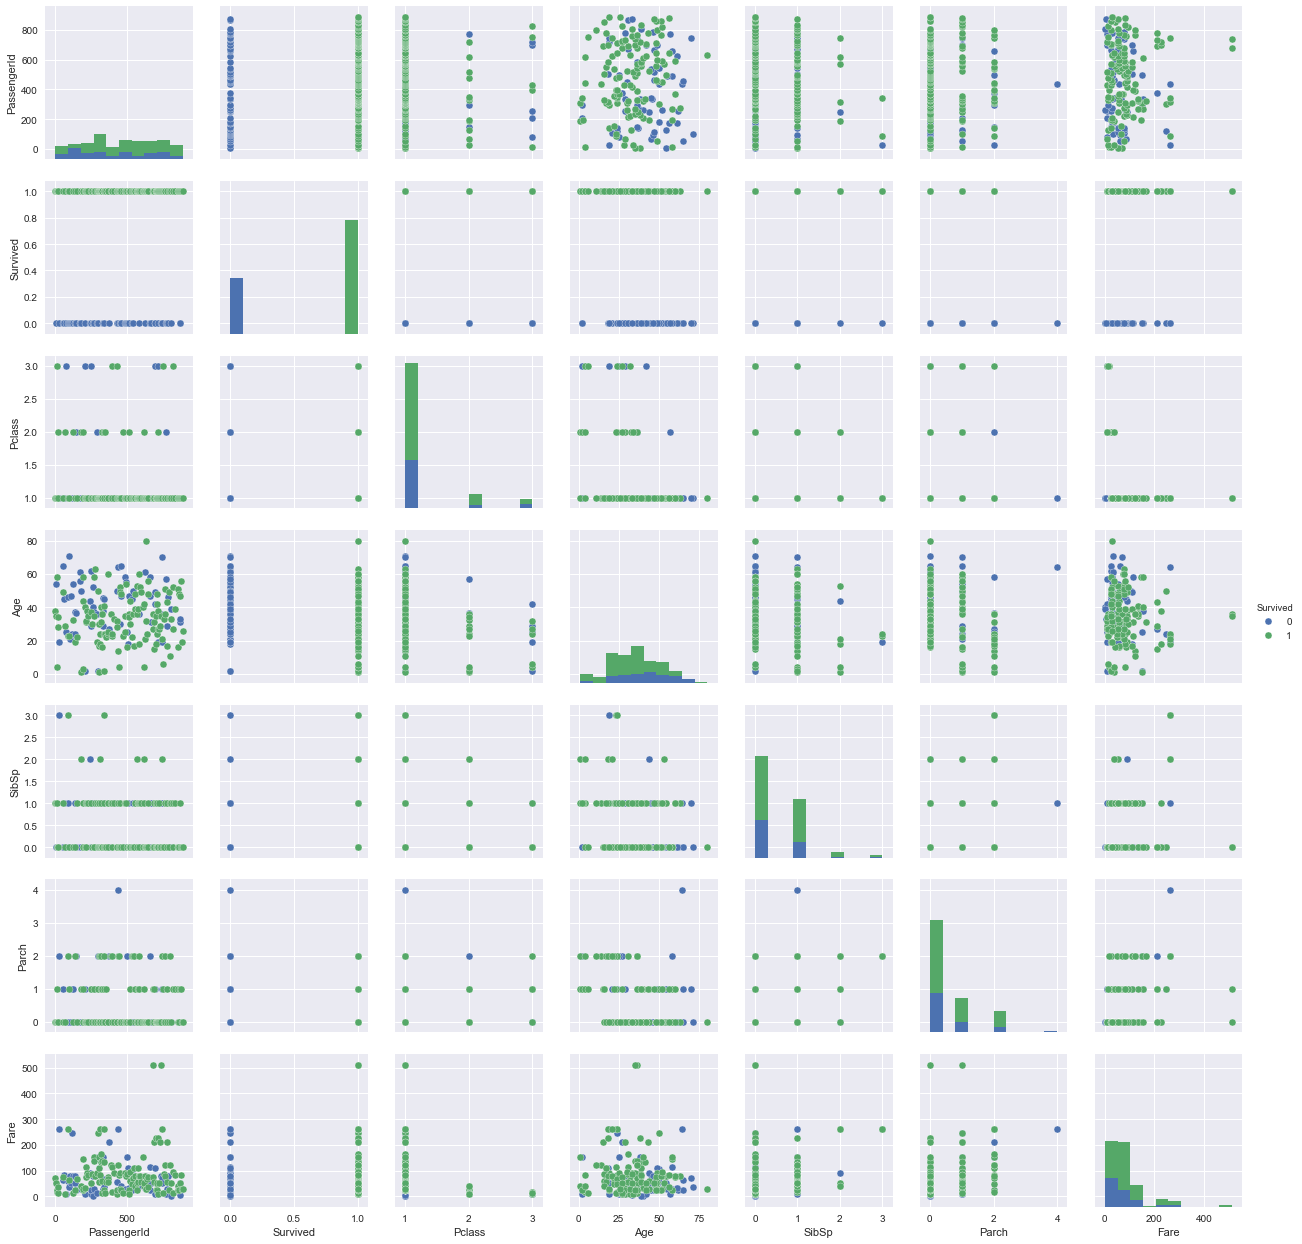
En este tutorial, has conseguido:
En la próxima publicación, te dedicarás a construir modelos de Machine Learning basados en lo que has aprendido aquí con el EDA. Lo haremos en el siguiente post de este proyecto (previsto para el 27 de diciembre).
Cursos de Python
Curso
Curso
Tutorial
Moez Ali
14 min
Tutorial
Kevin Babitz
8 min
Tutorial
Abid Ali Awan
15 min
Tutorial
Karlijn Willems
15 min
Tutorial
Duong Vu
11 min
Tutorial
Abid Ali Awan
13 min