Cours
Introduction à Python
4 h
7M
Au début du mois, j’ai animé une session Facebook Live Code Along au cours de laquelle nous avons construit, avec toutes les personnes qui suivaient en direct, plusieurs algorithmes de complexité croissante pour prédire si un passager du Titanic a survécu ou non, à partir d’informations comme le tarif payé, le port d’embarquement ou l’âge.
Dans cet article, nous revenons sur certains points abordés pendant la session. Si vous souhaitez revoir la vidéo ou suivre ce billet en parallèle, vous pouvez la regarder ici :
Plus précisément, vous vous souvenez sans doute que nous avons construit des modèles d’apprentissage supervisé.
L’apprentissage supervisé est la branche de l’apprentissage automatique (ML) qui vise à prédire des étiquettes, comme « Survived » ou « Not ». Ces modèles apprennent à partir de données étiquetées, c’est‑à‑dire des données indiquant si un passager a survécu (c’est la « phase d’entraînement du modèle »), puis prédisent sur des données non étiquetées.
Sur Kaggle, une plateforme de compétitions de modélisation prédictive et d’analytique, on parle de jeux d’entraînement et de test, car
Kaggle vous indique alors le pourcentage de bonnes réponses : c’est ce qu’on appelle la précision (accuracy) de votre modèle.
Comme vous le savez peut‑être déjà, une bonne manière d’aborder l’apprentissage supervisé consiste à :
Dans cette session code along, vous avez (ou allez) effectuer toutes ces étapes !
Remarque : nous proposons aussi des cours pour démarrer le machine learning sur le jeu Titanic en Python et en R.
La première étape consiste à importer vos données pour les examiner rapidement. Ici, vous allez importer le paquet pandas et utiliser la fonction read_csv() pour lire les données :
Remarque : dans les blocs de code ci‑dessous, d’autres packages et modules comme matplotlib, sklearn et seaborn ont déjà été importés. Vous les utiliserez plus largement ensuite pour la visualisation (statistique) des données et le machine learning.
Vous utilisez aussi la commande magique IPython %matplotlib inline pour afficher les graphiques directement dans votre notebook. Vous ajoutez sns.set() pour appliquer le style de base de Seaborn :
# Import modules
import pandas as pd
import matplotlib.pyplot as plt
import seaborn as sns
from sklearn import tree
from sklearn.metrics import accuracy_score

# Figures inline and set visualization style
%matplotlib inline
sns.set()
Sans plus attendre, importons les données et faisons un premier examen :
# Import test and train datasets
df_train = pd.read_csv('../data/train.csv')
df_test = pd.read_csv('../data/test.csv')

# View first lines of training data
df_train.head(n=4)
| PassengerId | Survived | Pclass | Name | Sex | Age | SibSp | Parch | Ticket | Fare | Cabin | Embarked | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | 1 | 0 | 3 | Braund, Mr. Owen Harris | male | 22.0 | 1 | 0 | A/5 21171 | 7.2500 | NaN | S |
| 1 | 2 | 1 | 1 | Cumings, Mrs. John Bradley (Florence Briggs Th... | female | 38.0 | 1 | 0 | PC 17599 | 71.2833 | C85 | C |
| 2 | 3 | 1 | 3 | Heikkinen, Miss. Laina | female | 26.0 | 0 | 0 | STON/O2. 3101282 | 7.9250 | NaN | S |
| 3 | 4 | 1 | 1 | Futrelle, Mrs. Jacques Heath (Lily May Peel) | female | 35.0 | 1 | 0 | 113803 | 53.1000 | C123 | S |
Pour obtenir la description de toutes ces variables, consultez la documentation des données Kaggle ici.
Avant d’aller plus loin, gardez en tête la terminologie suivante :
Avec cela en tête, poursuivez l’exploration de vos données, par exemple avec la fonction head(), qui affiche les cinq premières lignes de votre jeu de données :
# View first lines of test data
df_test.head()
| PassengerId | Pclass | Name | Sex | Age | SibSp | Parch | Ticket | Fare | Cabin | Embarked | |
|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | 892 | 3 | Kelly, Mr. James | male | 34.5 | 0 | 0 | 330911 | 7.8292 | NaN | Q |
| 1 | 893 | 3 | Wilkes, Mrs. James (Ellen Needs) | female | 47.0 | 1 | 0 | 363272 | 7.0000 | NaN | S |
| 2 | 894 | 2 | Myles, Mr. Thomas Francis | male | 62.0 | 0 | 0 | 240276 | 9.6875 | NaN | Q |
| 3 | 895 | 3 | Wirz, Mr. Albert | male | 27.0 | 0 | 0 | 315154 | 8.6625 | NaN | S |
| 4 | 896 | 3 | Hirvonen, Mrs. Alexander (Helga E Lindqvist) | female | 22.0 | 1 | 1 | 3101298 | 12.2875 | NaN | S |
Notez que le DataFrame df_test ne contient pas la colonne "Survived" : c’est justement ce que vous allez chercher à prédire !
.info() pour inspecter les types, les valeurs manquantes et plus encore (sur df_train).df_train.info()
<class 'pandas.core.frame.DataFrame'>
RangeIndex: 891 entries, 0 to 890
Data columns (total 12 columns):
PassengerId    891 non-null int64
Survived       891 non-null int64
Pclass         891 non-null int64
Name           891 non-null object
Sex            891 non-null object
Age            714 non-null float64
SibSp          891 non-null int64
Parch          891 non-null int64
Ticket         891 non-null object
Fare           891 non-null float64
Cabin          204 non-null object
Embarked       889 non-null object
dtypes: float64(2), int64(5), object(5)
memory usage: 83.6+ KB
Ici, vous constatez qu’il n’y a que 714 valeurs non nulles pour la colonne « Age » dans un DataFrame de 891 lignes. Cela signifie qu’il y a 177 valeurs nulles ou manquantes.
.describe() pour consulter les statistiques descriptives des colonnes numériques (de df_train).df_train.describe()
| PassengerId | Survived | Pclass | Age | SibSp | Parch | Fare | |
|---|---|---|---|---|---|---|---|
| count | 891.000000 | 891.000000 | 891.000000 | 714.000000 | 891.000000 | 891.000000 | 891.000000 |
| mean | 446.000000 | 0.383838 | 2.308642 | 29.699118 | 0.523008 | 0.381594 | 32.204208 |
| std | 257.353842 | 0.486592 | 0.836071 | 14.526497 | 1.102743 | 0.806057 | 49.693429 |
| min | 1.000000 | 0.000000 | 1.000000 | 0.420000 | 0.000000 | 0.000000 | 0.000000 |
| 25% | 223.500000 | 0.000000 | 2.000000 | 20.125000 | 0.000000 | 0.000000 | 7.910400 |
| 50% | 446.000000 | 0.000000 | 3.000000 | 28.000000 | 0.000000 | 0.000000 | 14.454200 |
| 75% | 668.500000 | 1.000000 | 3.000000 | 38.000000 | 1.000000 | 0.000000 | 31.000000 |
| max | 891.000000 | 1.000000 | 3.000000 | 80.000000 | 8.000000 | 6.000000 | 512.329200 |
Vous avez maintenant une idée de la structure des données et des premières statistiques. Il est temps de les visualiser avec le package seaborn :
seaborn pour tracer un diagramme en barres du taux de survie sur le Titanic, votre variable cible.sns.countplot(x='Survived', data=df_train);
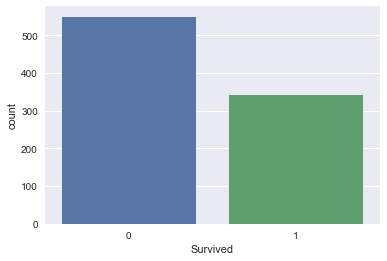
À retenir : dans le jeu d’entraînement, moins de personnes ont survécu que l’inverse. Construisons donc un premier modèle qui prédit que personne n’a survécu.
C’est un mauvais modèle, car vous savez que des passagers ont survécu. Mais il fournit une baseline : tout modèle ultérieur devra faire mieux.
Procédez ainsi :
'Survived' pour df_test qui code « n’a pas survécu » pour toutes les lignes ;'PassengerId' et 'Survived' de df_test au format .csv et soumettez‑les sur Kaggle.df_test['Survived'] = 0
df_test[['PassengerId', 'Survived']].to_csv('data/predictions/no_survivors.csv', index=False)
Quelle précision obtenez‑vous ? L’accuracy sur Kaggle est de 62,7.
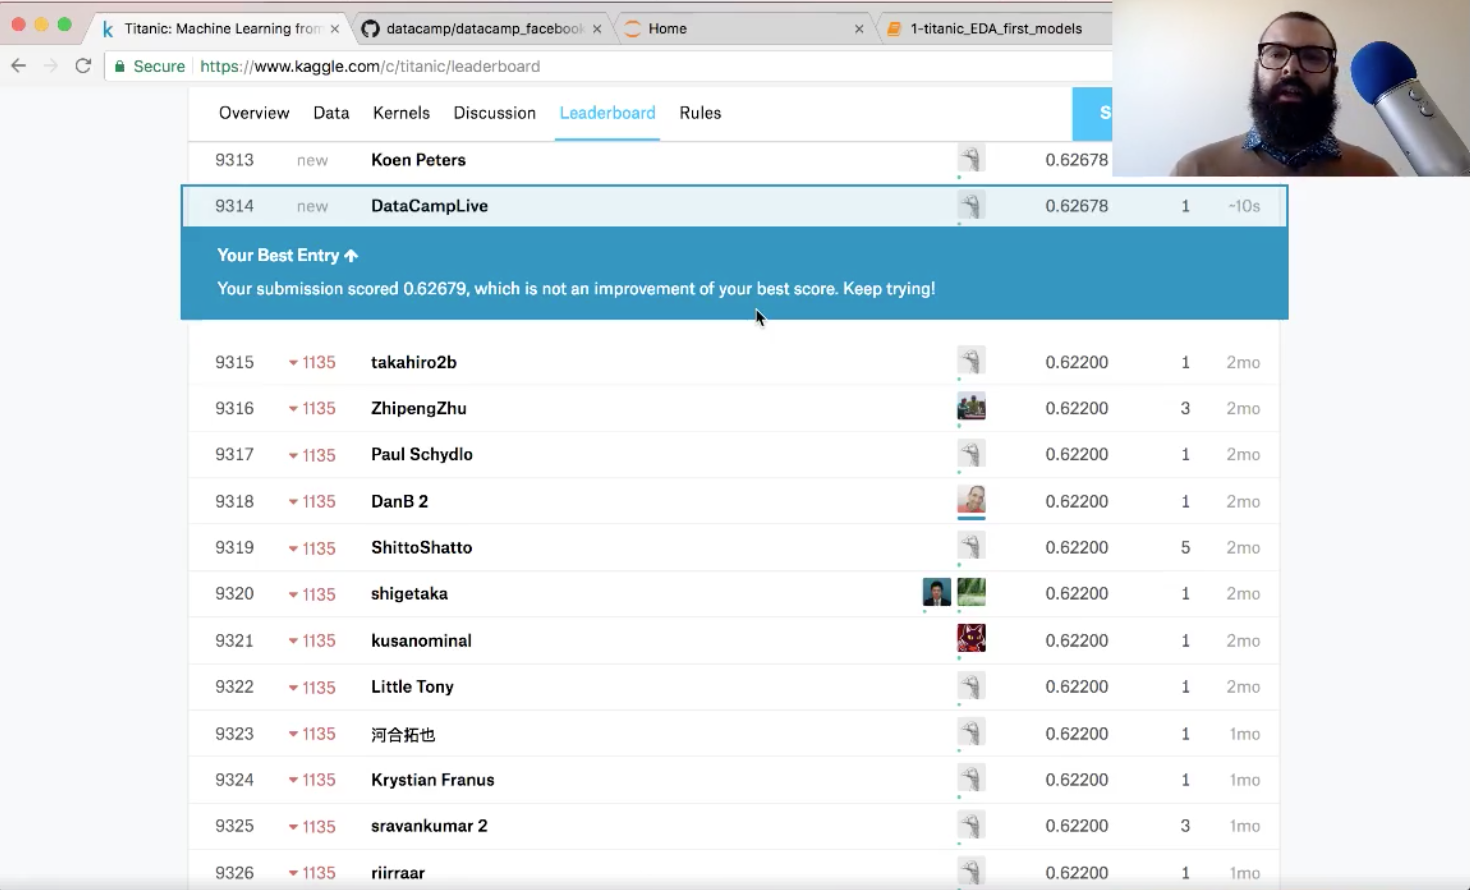
Pas si mal !
Note essentielle ! Pensez aussi à utiliser d’autres métriques que l’accuracy.
Maintenant que vous avez un modèle « vite fait », itérons : poursuivons l’EDA et construisons rapidement un autre modèle.
seaborn pour afficher un barplot de la variable 'Sex' du jeu Titanic (sur df_train).sns.countplot(x='Sex', data=df_train);
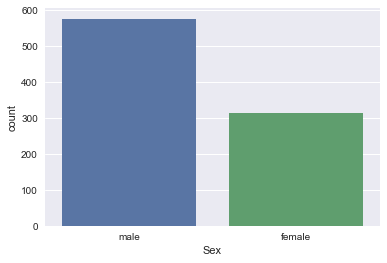
'Survived' ventilés (facettés) selon 'Sex'.sns.factorplot(x='Survived', col='Sex', kind='count', data=df_train);
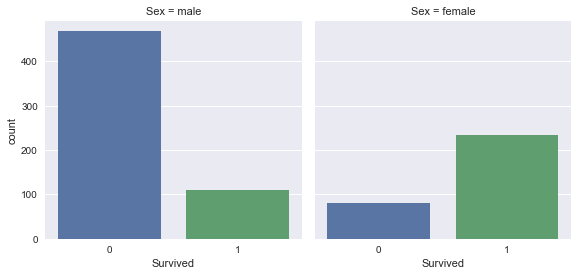
À retenir : les femmes avaient plus de chances de survivre que les hommes.
pandas pour compter combien de femmes et d’hommes ont survécu :df_train.groupby(['Sex']).Survived.sum()
Sex
female    233
male      109
Name: Survived, dtype: int64
print(df_train[df_train.Sex == 'female'].Survived.sum()/df_train[df_train.Sex == 'female'].Survived.count())
print(df_train[df_train.Sex == 'male'].Survived.sum()/df_train[df_train.Sex == 'male'].Survived.count())
0.742038216561
0.188908145581
74 % des femmes ont survécu, contre 19 % des hommes.
Construisons maintenant un deuxième modèle : prédisons que toutes les femmes ont survécu et que tous les hommes n’ont pas survécu. Là encore, le modèle est irréaliste, mais il fournit une baseline pour les comparaisons futures.
'Survived' pour df_test qui encode la prédiction ci‑dessus.'PassengerId' et 'Survived' de df_test en .csv et soumettez‑les à Kaggle.df_test['Survived'] = df_test.Sex == 'female'
df_test['Survived'] = df_test.Survived.apply(lambda x: int(x))
df_test.head()
| PassengerId | Pclass | Name | Sex | Age | SibSp | Parch | Ticket | Fare | Cabin | Embarked | Survived | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | 892 | 3 | Kelly, Mr. James | male | 34.5 | 0 | 0 | 330911 | 7.8292 | NaN | Q | 0 |
| 1 | 893 | 3 | Wilkes, Mrs. James (Ellen Needs) | female | 47.0 | 1 | 0 | 363272 | 7.0000 | NaN | S | 1 |
| 2 | 894 | 2 | Myles, Mr. Thomas Francis | male | 62.0 | 0 | 0 | 240276 | 9.6875 | NaN | Q | 0 |
| 3 | 895 | 3 | Wirz, Mr. Albert | male | 27.0 | 0 | 0 | 315154 | 8.6625 | NaN | S | 0 |
| 4 | 896 | 3 | Hirvonen, Mrs. Alexander (Helga E Lindqvist) | female | 22.0 | 1 | 1 | 3101298 | 12.2875 | NaN | S | 1 |
df_test[['PassengerId', 'Survived']].to_csv('../data/predictions/women_survive.csv', index=False)
Quelle précision ce modèle vous donne‑t‑il une fois soumis à Kaggle ?
L’accuracy sur Kaggle est de 76,6 % :
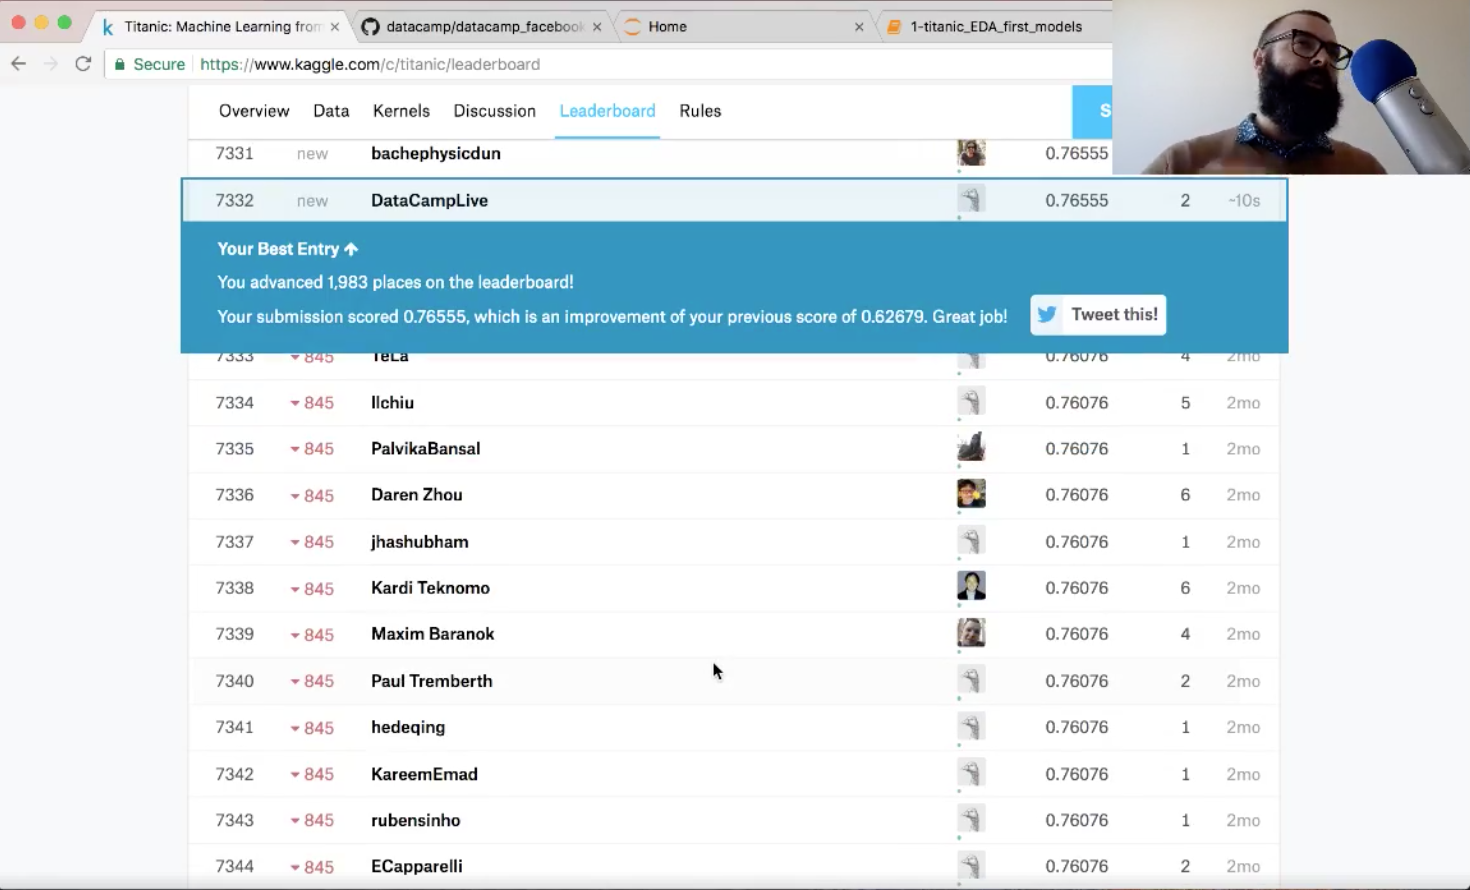
Avec cette soumission, vous grimpez d’environ 2 000 places au classement ! Et vous améliorez votre score : bravo !
seaborn pour tracer des barplots de 'Survived' facettés selon 'Pclass'.sns.factorplot(x='Survived', col='Pclass', kind='count', data=df_train);
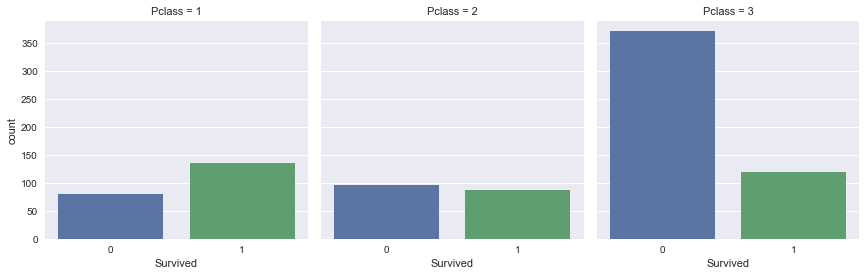
À retenir : les passagers de première classe avaient davantage de chances de survivre. À l’inverse, ceux de troisième classe étaient moins susceptibles de survivre.
seaborn pour afficher des barplots de 'Survived' facettés selon 'Embarked'.sns.factorplot(x='Survived', col='Embarked', kind='count', data=df_train);
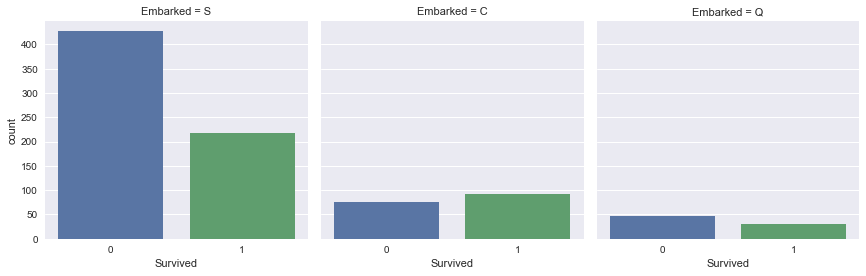
À retenir : les passagers embarqués à Southampton avaient moins de chances de survivre.
seaborn pour tracer un histogramme de la colonne 'Fare' de df_train.sns.distplot(df_train.Fare, kde=False);
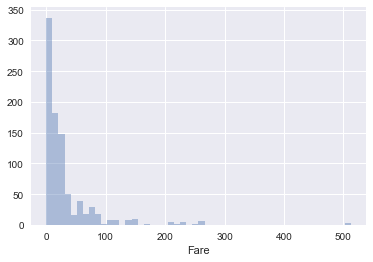
À retenir : la plupart des passagers ont payé moins de 100 pour voyager sur le Titanic.
pandas pour afficher la colonne 'Fare' pour chaque valeur de 'Survived' sur le même graphique.df_train.groupby('Survived').Fare.hist(alpha=0.6);
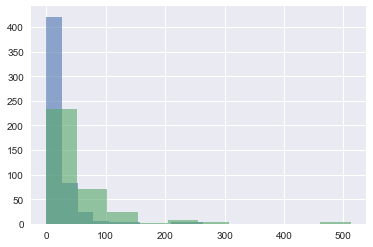
À retenir : il semble que ceux qui ont payé plus cher avaient une probabilité de survie plus élevée.
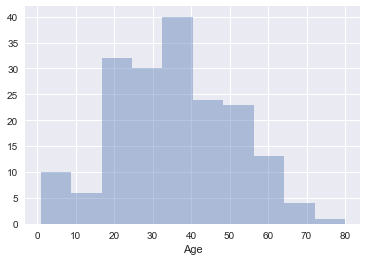
seaborn pour tracer un histogramme de la colonne 'Age' de df_train. Vous devrez d’abord supprimer les valeurs nulles.df_train_drop = df_train.dropna()
sns.distplot(df_train_drop.Age, kde=False);
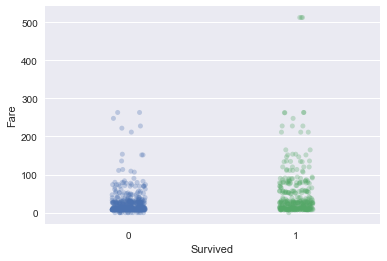
'Fare' avec 'Survived' en abscisse.sns.stripplot(x='Survived', y='Fare', data=df_train, alpha=0.3, jitter=True);
sns.swarmplot(x='Survived', y='Fare', data=df_train);
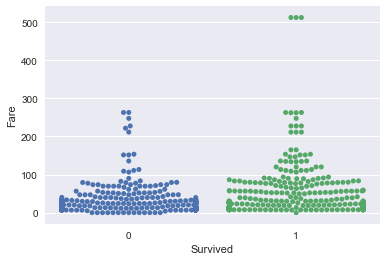
À retenir : le tarif (Fare) semble clairement corrélé à la survie à bord du Titanic.
.describe() pour consulter les statistiques descriptives de 'Fare' en fonction de la survie.df_train.groupby('Survived').Fare.describe()
| count | mean | std | min | 25% | 50% | 75% | max | |
|---|---|---|---|---|---|---|---|---|
| Survived | ||||||||
| 0 | 549.0 | 22.117887 | 31.388207 | 0.0 | 7.8542 | 10.5 | 26.0 | 263.0000 |
| 1 | 342.0 | 48.395408 | 66.596998 | 0.0 | 12.4750 | 26.0 | 57.0 | 512.3292 |
seaborn pour tracer un nuage de points de 'Age' en fonction de 'Fare', coloré par 'Survived'.sns.lmplot(x='Age', y='Fare', hue='Survived', data=df_train, fit_reg=False, scatter_kws={'alpha':0.5});
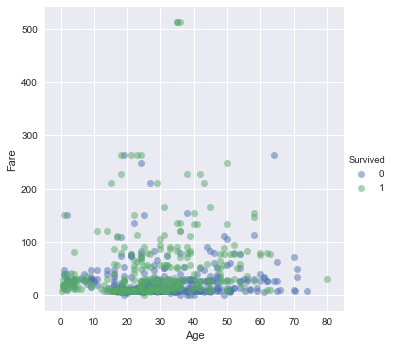
À retenir : il semble que les survivants aient soit payé un tarif élevé, soit été jeunes.
seaborn pour créer un pairplot de df_train, coloré par 'Survived'. Un pairplot permet de synthétiser, en une grille unique, l’essentiel des informations déjà observées.sns.pairplot(df_train_drop, hue='Survived');
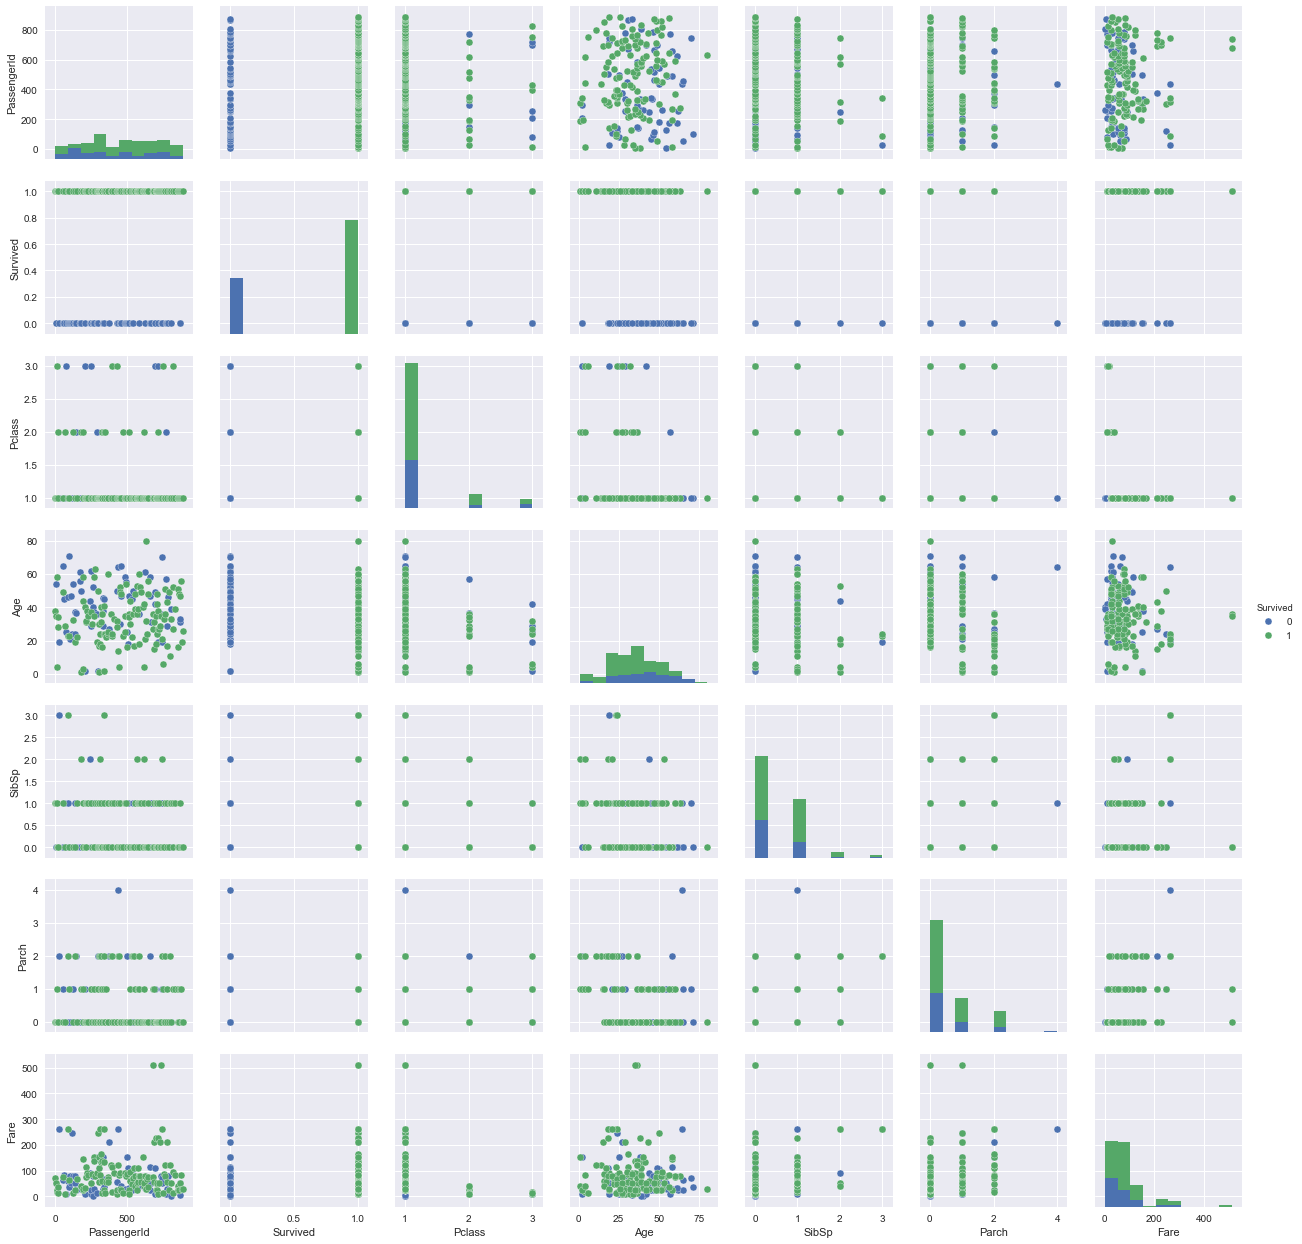
Dans ce tutoriel, vous avez :
Dans le prochain billet, vous prendrez le temps de construire des modèles de machine learning à partir de ce que vous avez appris ici avec l’EDA. Rendez‑vous dans le prochain article de ce projet (publication prévue le 27 décembre).
Cours Python
Cours
Cours