courses
생성형 AI 개념
2
117.3K
대규모 언어 모델(LLM)의 부상은 자연어 처리(NLP) 분야의 결정적 흐름으로, 다양한 애플리케이션에서 폭넓게 채택되고 있습니다. 그러나 이러한 발전은 종종 배타적으로 이루어져, 자원이 풍부한 기관이 개발한 대부분의 LLM이 대중에게는 접근 불가능한 상태로 남아 있었습니다.
이러한 배타성은 중요한 질문을 제기합니다. 이 강력한 언어 모델에 대한 접근을 민주화할 방법은 없을까요? 바로 여기에서 BLOOM이 등장합니다.
이 글은 먼저 BLOOM의 탄생 배경을 소개한 뒤, 기술 사양과 사용 방법을 살펴보고, 마지막으로 한계와 윤리적 고려사항을 짚는 등 BLOOM이 무엇인지 전반적으로 개관합니다.
BigScience Large Open-science Open-access Multilingual Language Model(약칭 BLOOM)은 언어 모델 기술의 민주화를 크게 앞당긴 성과입니다.
미국을 포함한 39개국 1200명 이상이 협력해 개발한 BLOOM은 전 세계적 노력이 응집된 결과물입니다. BigScience가 Hugging Face 및 프랑스 NLP 커뮤니티와 협력해 조정했으며, 지리적·기관적 경계를 뛰어넘는 프로젝트였습니다.
이 모델은 오픈 소스이며 디코더 전용 트랜스포머로, 1760억 매개변수를 갖추고 ROOTS 코퍼스에서 학습되었습니다. ROOTS는 59개 언어(구어 46개, 프로그래밍 언어 13개)에 걸친 수백 개 이상의 출처로 구성된 데이터셋입니다.
아래는 학습 언어 분포를 나타낸 원형 차트입니다.
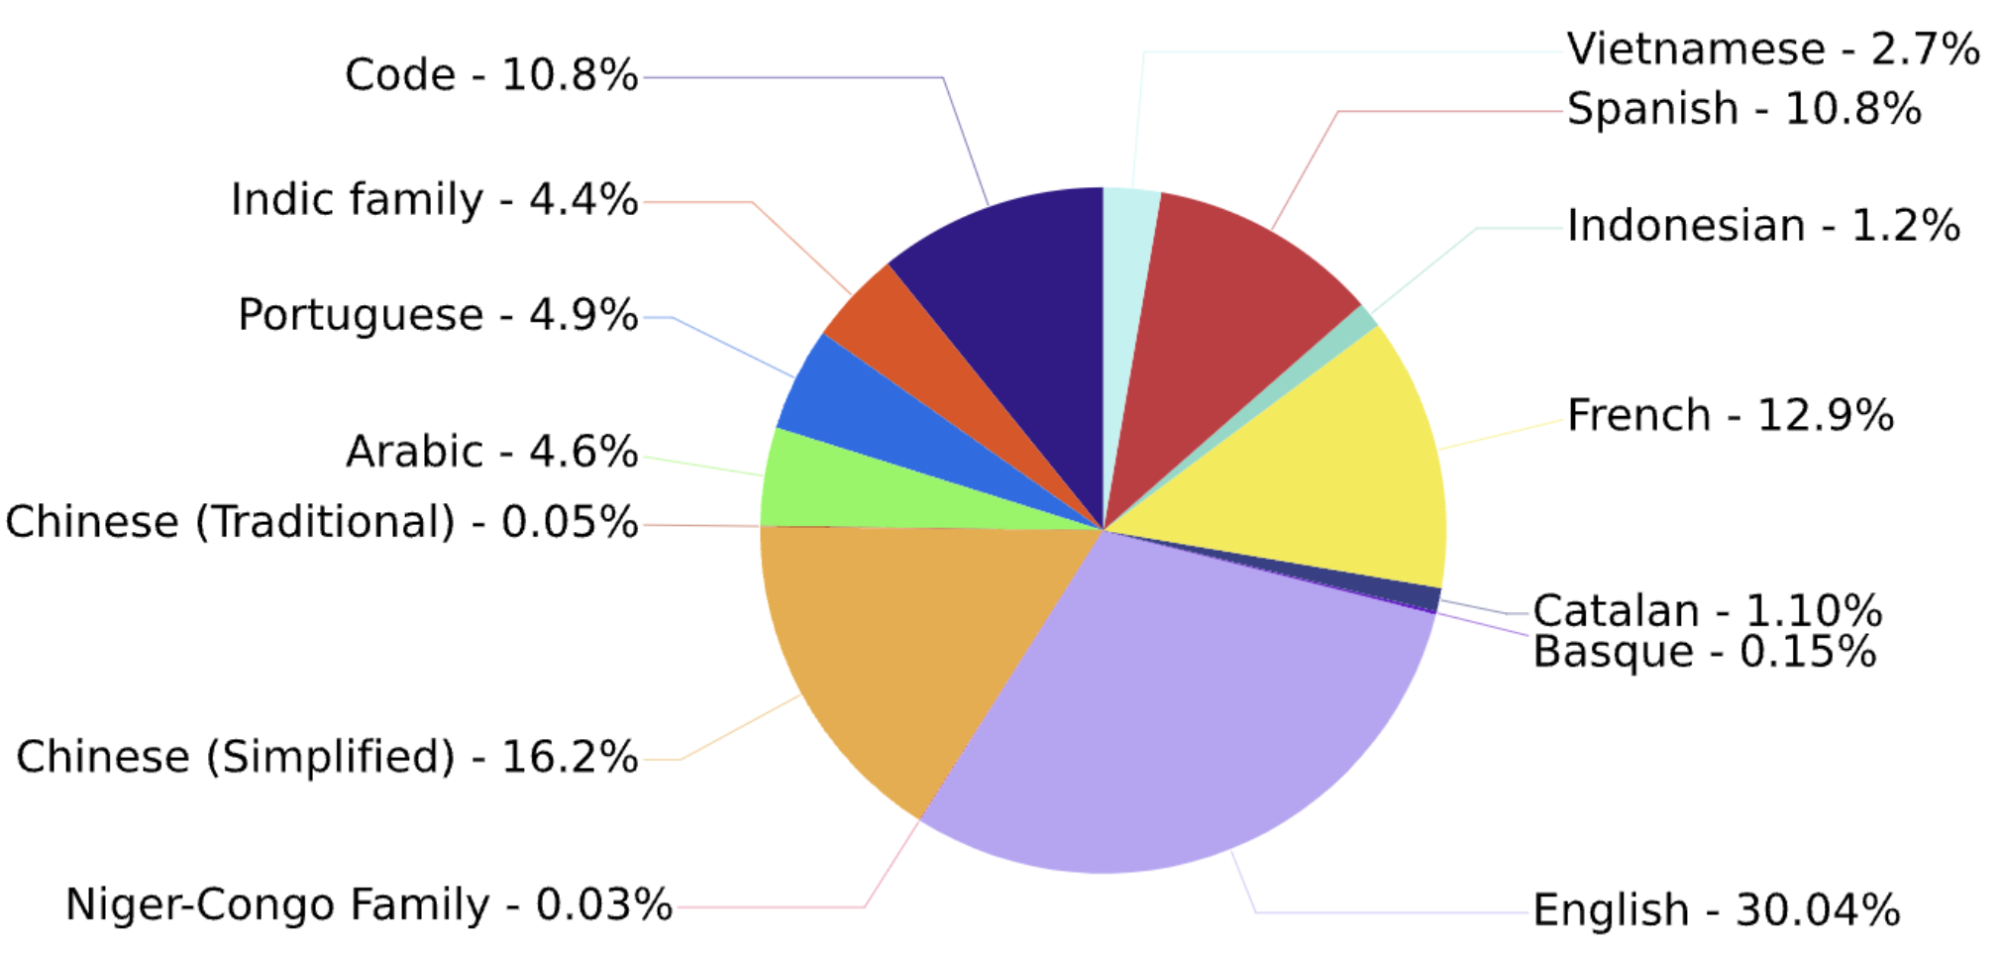
학습 언어의 분포(출처)
이 모델은 다양한 벤치마크에서 뛰어난 성능을 보였으며, 멀티태스크 프롬프트 기반 미세 조정 후 더 나은 결과를 달성했습니다.
프로젝트는 프랑스 연구기관 CNRS와 GENCI의 대규모 컴퓨팅 지원을 받아 파리의 Jean Zay 슈퍼컴퓨터에서 117일(3월 11일~7월 6일)간의 학습으로 결실을 맺었습니다.
BLOOM은 기술적 성취일 뿐만 아니라 국제 협력과 집단적 과학 추구의 상징이기도 합니다.
이제 여러 구성요소로 이루어진 BLOOM의 아키텍처를 좀 더 자세히 살펴보겠습니다.
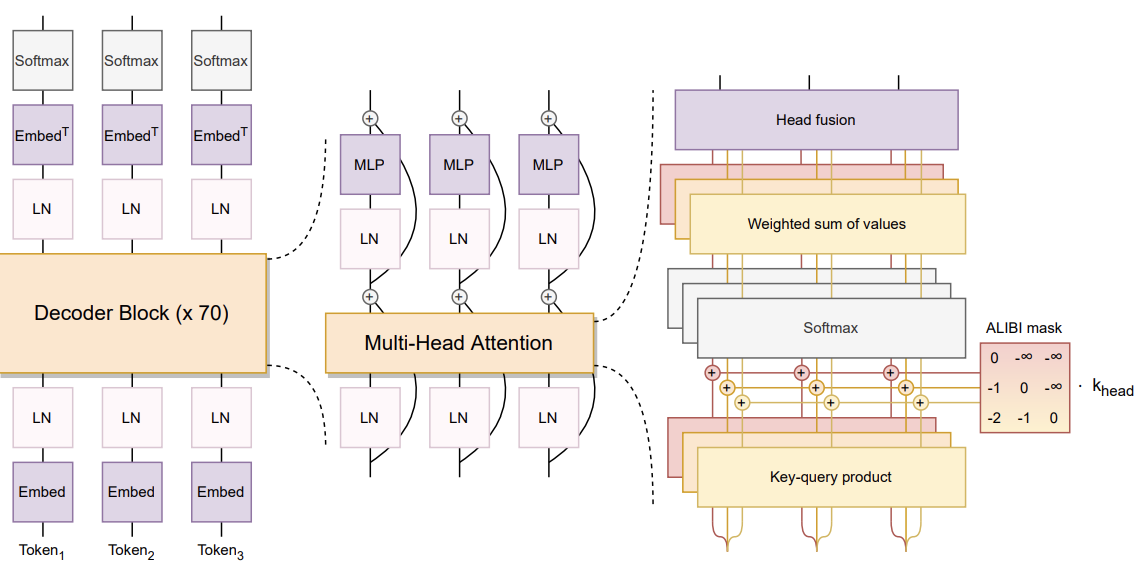
Bloom 아키텍처(출처)
논문에 상세히 소개된 BLOOM 아키텍처의 주목할 만한 특징은 다음과 같습니다.
이러한 구성요소는 검증된 기법과 혁신의 균형을 통해 성능과 안정성을 최적화하려는 팀의 초점을 반영합니다.
BLOOM의 아키텍처 구성 외에도, 데이터 전처리와 프롬프트 기반 데이터셋이라는 두 가지 추가 요소를 이해할 필요가 있습니다.
이 예시에서는 BLOOM을 사용해 창의적인 이야기를 생성합니다. 제공된 코드는 환경 설정, 모델 준비, 주어진 프롬프트에 기반한 텍스트 생성을 위해 구성되어 있습니다. 해당 소스 코드는 GitHub에서 확인할 수 있으며, amrrs의 튜토리얼에서 큰 영감을 받았습니다.
BLOOM 모델은 자원 소모가 크므로 워크스페이스의 적절한 구성이 중요합니다. 주요 단계는 아래와 같습니다.
먼저, transformer 라이브러리를 사용해 BLOOM 및 기타 트랜스포머 기반 모델을 다루기 위한 인터페이스를 제공합니다.
!pip install transformers -qnvidia-smi를 사용해 사용 가능한 GPU의 속성을 확인하여 모델 실행에 필요한 연산 자원이 확보되었는지 점검합니다.
!nvidia-smi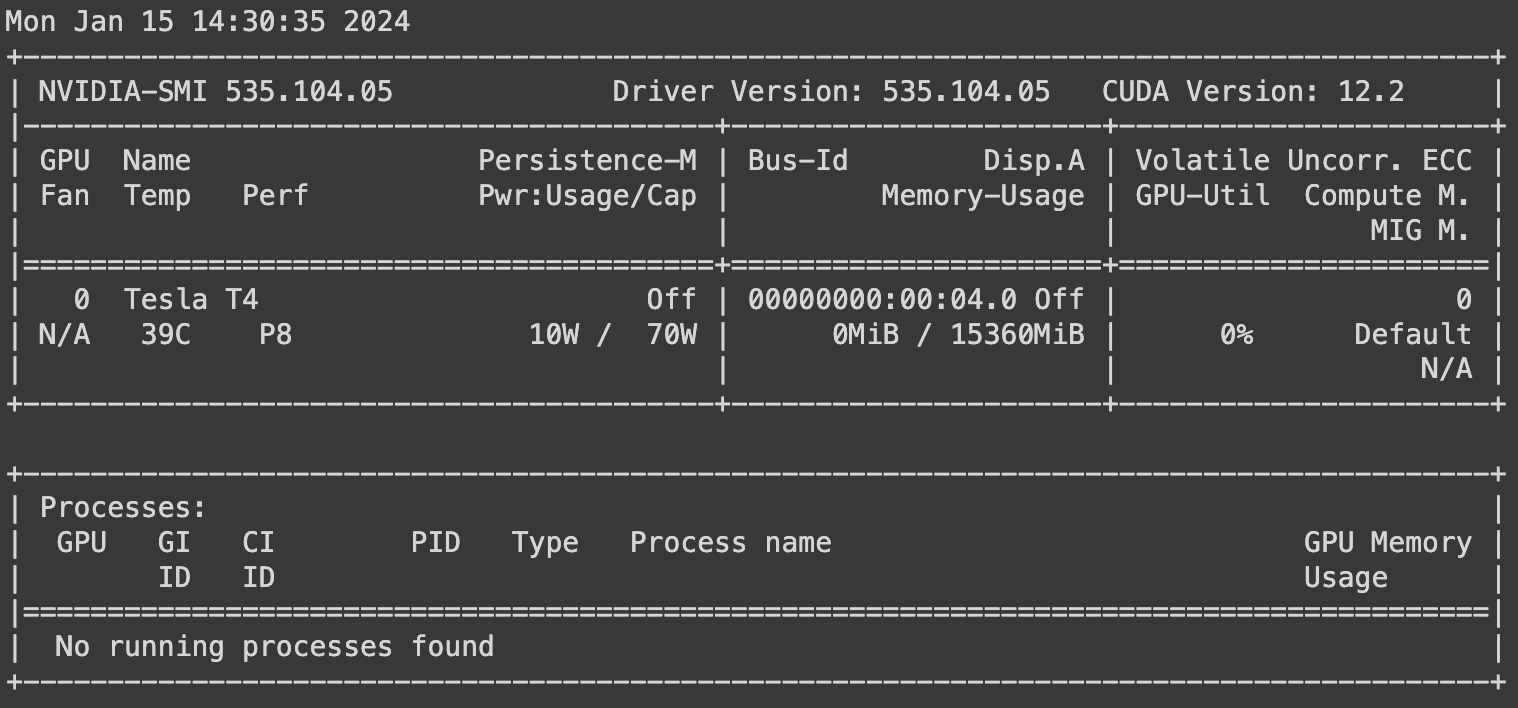
transformers와 torch에서 필요한 모듈을 임포트합니다. torch는 기본 텐서 타입을 설정해 GPU 가속을 활용하는 데 사용됩니다.
이후 GPU를 사용하므로, torch 라이브러리의 set_default_tensor_type 함수를 사용해 GPU 사용을 보장하도록 설정합니다.
from transformers import AutoModelForCausalLM, AutoTokenizer, set_seed
import torch
torch.set_default_tensor_type(torch.cuda.FloatTensor)이번에 사용하는 대상 모델은 7억 개 파라미터의 BLOOM 모델로, BigScience의 Hugging Face 저장소에서 bigscience/bloom-1b7라는 고유 식별자로 접근할 수 있습니다.
model_ID = "bigscience/bloom-1b7"다음으로 Hugging Face에서 사전학습된 BLOOM 모델과 토크나이저를 로드하고, set_seed 함수로 재현성을 위해 임의의 정수 값을 설정합니다. 값 자체는 중요하지 않지만, 부동소수점이 아닌 값을 사용하는 것이 중요합니다.
대규모 언어 모델의 잠재력을 활용하는 오픈 소스 Python 프레임워크 LangChain에 대해 더 알아보려면, 튜토리얼 How to Build LLM Applications with LangChain Tutorial을 참고하세요.
또한 데이터 엔지니어로서 데이터 애플리케이션을 위한 LangChain 활용에 관심이 있다면, Introduction to LangChain for Data Engineering & Data Applications 글에서 LangChain이 해결하는 문제와 데이터 활용 사례를 포함해 개요를 확인하실 수 있습니다.
model = AutoModelForCausalLM.from_pretrained(model_ID, use_cache=True)
tokenizer = AutoTokenizer.from_pretrained(model_ID)
set_seed(2024)
이제 생성할 이야기의 제목과 프롬프트를 정의합니다.
story_title = 'An Unexpected Journey Through Time'
prompt = f'This is a creative story about {story_title}.\n'
마지막으로 프롬프트를 토크나이즈하고 적절한 모델 디바이스에 매핑한 뒤, 디코딩을 거쳐 모델의 결과를 생성합니다.
input_ids = tokenizer(prompt, return_tensors="pt").to(0)

sample = model.generate(**input_ids,
                        max_length=200, top_k=1,
                        temperature=0, repetition_penalty=2.0)

generated_story = tokenizer.decode(sample[0], skip_special_tokens=True)
최종 결과는 textwrap 모듈로 줄당 최대 80자 폭으로 서식을 맞춰 가독성을 높입니다.
import textwrap
wrapper = textwrap.TextWrapper(width=80)
formated_story = wrapper.fill(text=generated_story)
print(formated_story)최종 결과는 아래와 같습니다.
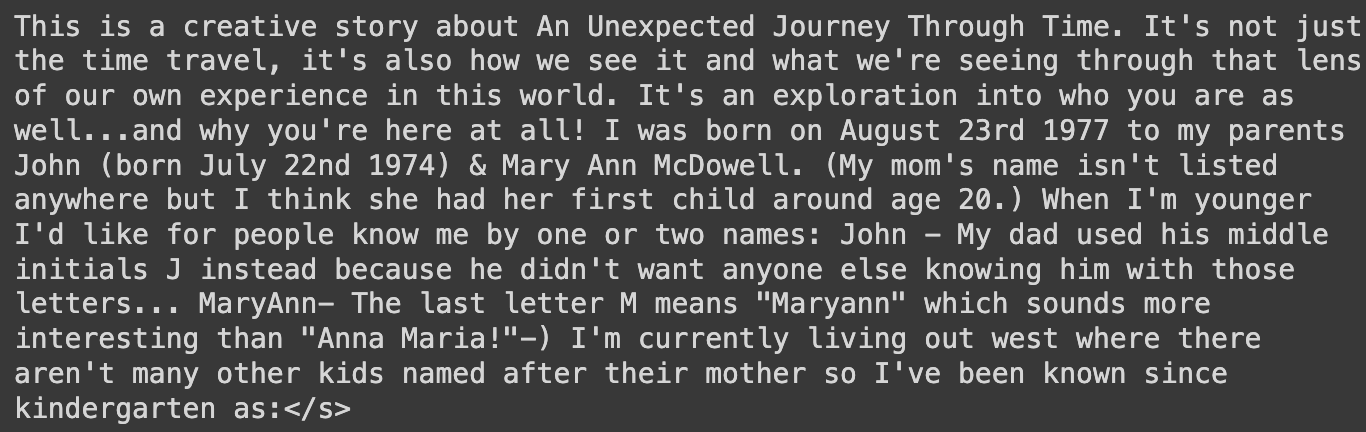
BLOOM 모델로 생성된 이야기
몇 줄의 코드만으로 BLOOM 모델을 사용해 의미 있는 콘텐츠를 생성할 수 있었습니다.
초기 설정부터 최종 구현까지, PyTorch로 대규모 언어 모델을 학습하는 전 과정을 숙달하고 싶다면, 튜토리얼 How to Train an LLM with PyTorch에서 목표 달성을 위한 완전한 가이드를 제공합니다.
모든 기술 발전과 마찬가지로, BLOOM에도 적합한 활용과 부적절한 활용이 존재합니다. 이 섹션에서는 BLOOM의 적절한 사용 사례와 피해야 할 사용 사례를 살펴보며, 능력이 가장 잘 발휘되는 영역과 주의가 필요한 영역을 강조합니다. 이러한 경계를 이해하는 것은 BLOOM의 잠재력을 책임감 있고 효과적으로 활용하는 데 중요합니다.
BLOOM은 언어 처리와 생성을 한 단계 확장하도록 설계된 다재다능한 도구입니다. 의도된 활용은 폭넓은 언어 역량을 바탕으로 여러 분야에 걸쳐 있습니다.
BLOOM의 한계를 이해하는 것은 윤리적·실용적 적용을 보장하는 데 중요합니다. 윤리적 고려 또는 기술적 제약으로 인해 BLOOM LLM의 의도된 범주를 벗어나는 사용 사례가 있습니다.
고급 대규모 언어 모델(LLM)인 BLOOM은 다양한 사용자 그룹에 폭넓은 혜택을 제공합니다. 그 역량은 특정 전문가와 부문에 직접적으로 영향을 미칠 뿐 아니라, 더 넓은 이해관계자에게 간접적으로도 영향을 줍니다.
이 섹션은 BLOOM의 사용자들을 살펴보며, 서로 다른 그룹이 이 혁신적 도구를 어떻게 활용하고 어떤 영향을 받는지 조명합니다.
BLOOM의 직접 사용자와 간접 사용자를 이해함으로써, 모델이 기술과 사회 발전에 기여하는 폭넓은 영향과 다양한 방식에 대한 이해가 깊어집니다.
BLOOM을 포함한 모든 대규모 언어 모델(LLM)의 배포에는 다양한 윤리적 고려사항과 한계가 따릅니다. 책임 있는 사용과 기술의 광범위한 영향을 예견하기 위해 이러한 측면을 이해하는 것이 중요합니다. 이 섹션에서는 BLOOM 사용에 수반되는 윤리적 함의, 위험, 고유 한계를 다룹니다.
BLOOM의 개발과 공개는 그 영향과 함께 논란을 야기하며 현실 세계에 중대한 함의를 지닙니다. 이 섹션에서는 BLOOM 연구 논문에서 얻은 통찰을 바탕으로 이러한 측면을 논의합니다.
빠르게 변화하는 인공지능(AI) 세계에서 BLOOM 같은 대규모 언어 모델(LLM)의 관련성은 지속적으로 논의되는 주제입니다.
국제 연구진의 대규모 협업으로 개발된 BLOOM은 언어 처리에서 중요한 도약이었습니다. 그러나 AI 환경은 끊임없이 진화하며, 새로운 모델이 등장하고 초점이 이동하고 있습니다.
치열한 이 분야에서 BLOOM이 여전히 입지를 유지하는지 살펴보겠습니다.
이 글은 대규모 언어 모델 분야의 발전에 크게 기여한 BLOOM 프로젝트를 개관했습니다.
BLOOM의 개발 과정과 기술 사양, 그리고 그 탄생을 이끈 협업을 살펴보았습니다. 또한 BLOOM에 접근하고 효과적으로 활용하는 방법을 안내하며, 적절한 사용처와 한계를 강조했습니다.
더 나아가 BLOOM AI 프로젝트의 윤리적 함의와 현실 세계의 영향을 다루고, 오늘날 AI 환경에서의 평가와 관련성에 대해 성찰했습니다. AI에 직접 관여하든 관심 있는 독자이든, BLOOM에 대한 이 탐구는 대규모 언어 모델의 복잡한 세계를 이해하는 데 필수적인 관점을 제공합니다.
고급 언어 모델에 대한 이해를 한층 심화하고자 한다면, 추가 과정인 Large Language Models (LLMs) Concepts에서 LLM 애플리케이션, 학습 방법론, 윤리적 고려사항, 최신 연구를 다루는 개념 과정을 통해 LLM의 잠재력을 폭넓게 탐구해 보세요.
지금 AI 여정을 시작하세요!
courses
courses
courses