course
जनरेटिव AI कॉन्सेप्ट्स
2 घंटा
117.2K
बड़े भाषा मॉडल (LLMs) का उदय नेचुरल लैंग्वेज प्रोसेसिंग (NLP) के क्षेत्र में एक निर्णायक प्रवृत्ति रहा है, जिससे उनका विभिन्न अनुप्रयोगों में व्यापक उपयोग हुआ है। हालांकि, यह प्रगति अक्सर विशिष्ट रही है, क्योंकि अधिकांश LLMs, जिन्हें समृद्ध संसाधनों वाले संगठनों ने विकसित किया है, आम जनता की पहुंच से दूर हैं।
यह विशिष्टता एक महत्वपूर्ण प्रश्न खड़ा करती है: क्या इन शक्तिशाली भाषा मॉडलों तक पहुंच का लोकतंत्रीकरण करने का कोई तरीका हो सकता है? यहीं पर BLOOM सामने आता है।
यह लेख BLOOM क्या है, उसका एक संपूर्ण अवलोकन प्रस्तुत करता है—पहले इसके उद्भव के बारे में अधिक विवरण देकर। इसके बाद, यह BLOOM की तकनीकी विशेषताओं और उपयोग-विधि से गुजरता है, और अंत में इसकी सीमाओं और नैतिक विचारों पर प्रकाश डालता है।
BigScience Large Open-science Open-access Multilingual Language Model (संक्षेप में BLOOM) भाषा मॉडल तकनीक के लोकतंत्रीकरण में एक महत्वपूर्ण प्रगति का प्रतिनिधित्व करता है।
39 देशों के 1200 से अधिक प्रतिभागियों द्वारा सहयोगात्मक रूप से विकसित, जिनमें से एक महत्वपूर्ण संख्या संयुक्त राज्य अमेरिका से थी, BLOOM एक वैश्विक प्रयास का परिणाम है। BigScience द्वारा Hugging Face और फ्रेंच NLP समुदाय के साथ मिलकर समन्वित यह प्रोजेक्ट भौगोलिक और संस्थागत सीमाओं से परे जाता है।
यह एक ओपन-सोर्स और केवल डिकोडर वाला ट्रांसफॉर्मर मॉडल है, जिसमें 176B पैरामीटर्स हैं और जिसे ROOTS कॉर्पस पर प्रशिक्षित किया गया है—यह 59 भाषाओं के सैकड़ों स्रोतों वाला डेटासेट है: 46 बोली जाने वाली भाषाएँ और 13 प्रोग्रामिंग भाषाएँ।
नीचे प्रशिक्षण भाषाओं के वितरण का पाई चार्ट दिया गया है।
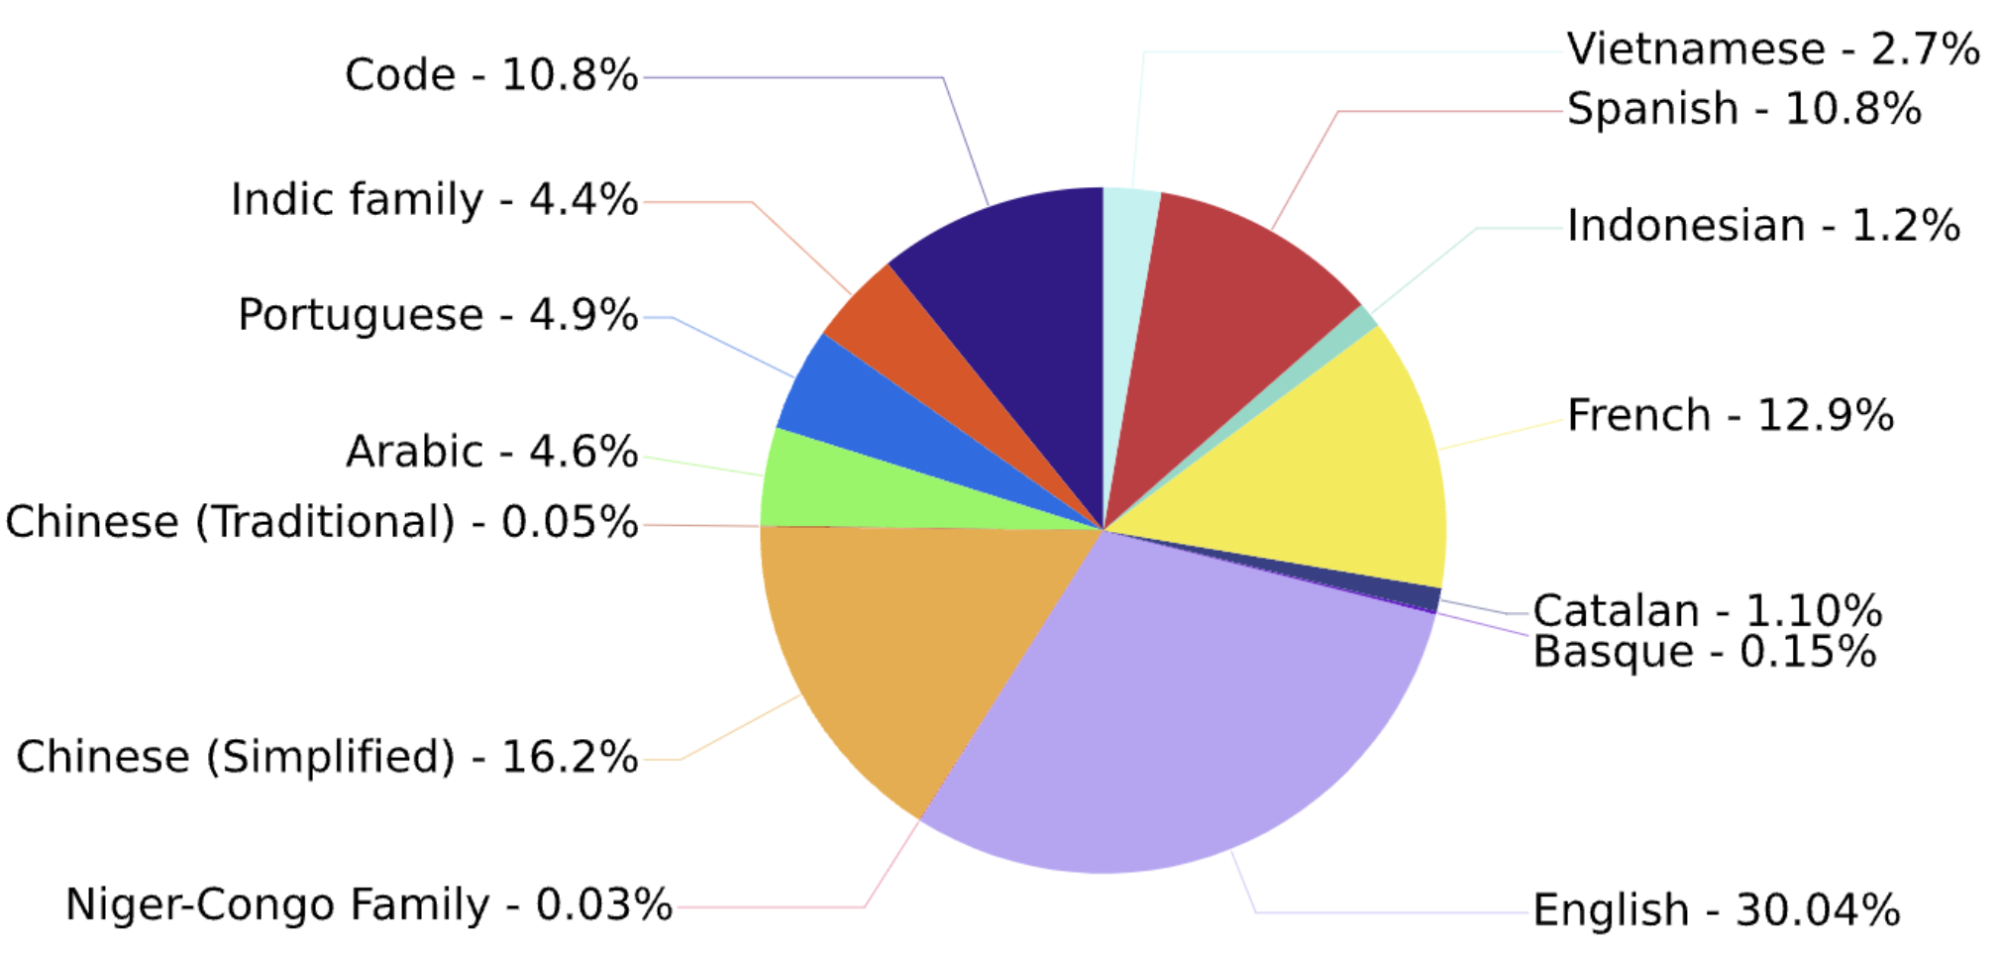
प्रशिक्षण भाषाओं का वितरण (स्रोत)
मॉडल ने विभिन्न बेंचमार्क्स पर उल्लेखनीय प्रदर्शन हासिल किया, और मल्टीटास्क प्रॉम्प्टेड फाइन-ट्यूनिंग के बाद और बेहतर परिणाम प्राप्त किए।
यह प्रोजेक्ट पेरिस के जाँ ज़े सुपरकंप्यूटर पर 117-दिन (11 मार्च - 6 जुलाई) के प्रशिक्षण सत्र में परिणत हुआ, जिसे फ्रांसीसी शोध एजेंसियों CNRS और GENCI से बड़े कंप्यूट ग्रांट का समर्थन मिला।
BLOOM न केवल एक तकनीकी चमत्कार है बल्कि अंतरराष्ट्रीय सहयोग और सामूहिक वैज्ञानिक प्रयास की शक्ति का प्रतीक भी है।
अब, आइए BLOOM की संरचना को अधिक विस्तृत तरीके से वर्णित करें, जिसमें कई अवयव शामिल हैं।
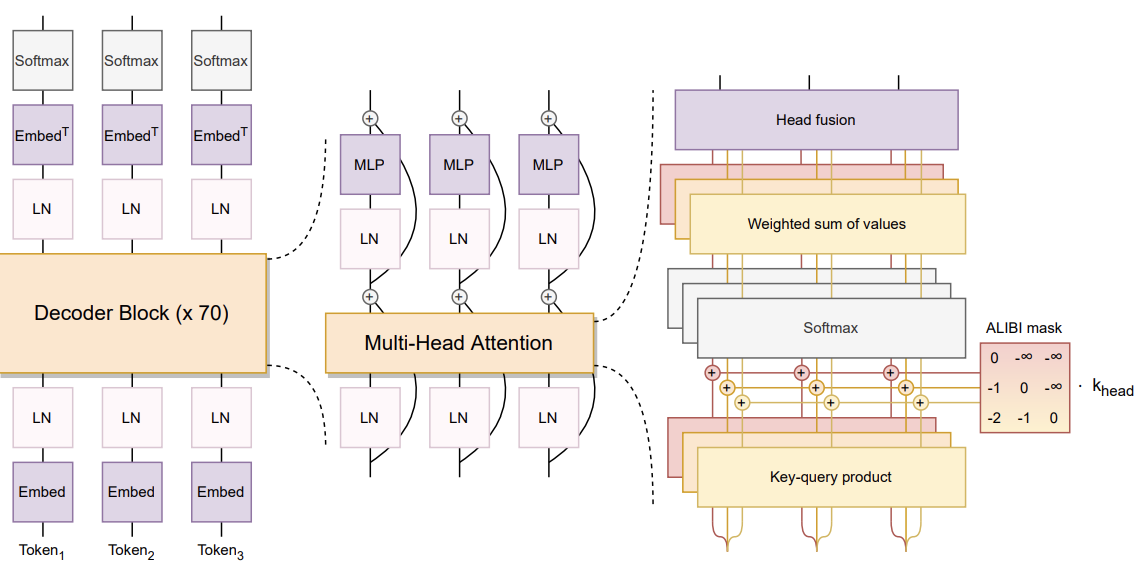
Bloom आर्किटेक्चर (स्रोत)
पेपर में वर्णित अनुसार, BLOOM मॉडल की आर्किटेक्चर में कई उल्लेखनीय पहलू शामिल हैं:
ये अवयव टीम के उस फोकस को दर्शाते हैं जिसमें प्रदर्शन और स्थिरता को अनुकूलित करने के लिए नवाचार और सिद्ध तकनीकों के बीच संतुलन साधा गया।
BLOOM की आर्किटेक्चरल इकाइयों के अतिरिक्त, दो और प्रासंगिक अवयवों को समझते हैं: डेटा प्रीप्रोसेसिंग और प्रॉम्प्टेड डेटासेट्स।
इस उदाहरण में, हम BLOOM का उपयोग एक रचनात्मक कहानी जनरेट करने के लिए करेंगे। दिया गया कोड पर्यावरण सेटअप, मॉडल की तैयारी, और दिए गए प्रॉम्प्ट के आधार पर पाठ जनरेट करने के लिए संरचित है। संबंधित सोर्स कोड GitHub पर उपलब्ध है, और यह amrrs के ट्यूटोरियल से प्रेरित है।
BLOOM मॉडल संसाधन-गहन है, इसलिए वर्कस्पेस का उचित कॉन्फ़िगरेशन महत्वपूर्ण है; मुख्य चरण नीचे वर्णित हैं।
सबसे पहले, transformer लाइब्रेरी BLOOM मॉडल और अन्य ट्रांसफॉर्मर-आधारित मॉडलों के साथ काम करने के लिए इंटरफेस उपलब्ध कराती है।
!pip install transformers -qnvidia-smi का उपयोग करके, हम उपलब्ध GPU के गुणों की जाँच करते हैं ताकि यह सुनिश्चित किया जा सके कि मॉडल चलाने के लिए आवश्यक संगणनात्मक संसाधन हमारे पास हैं।
!nvidia-smi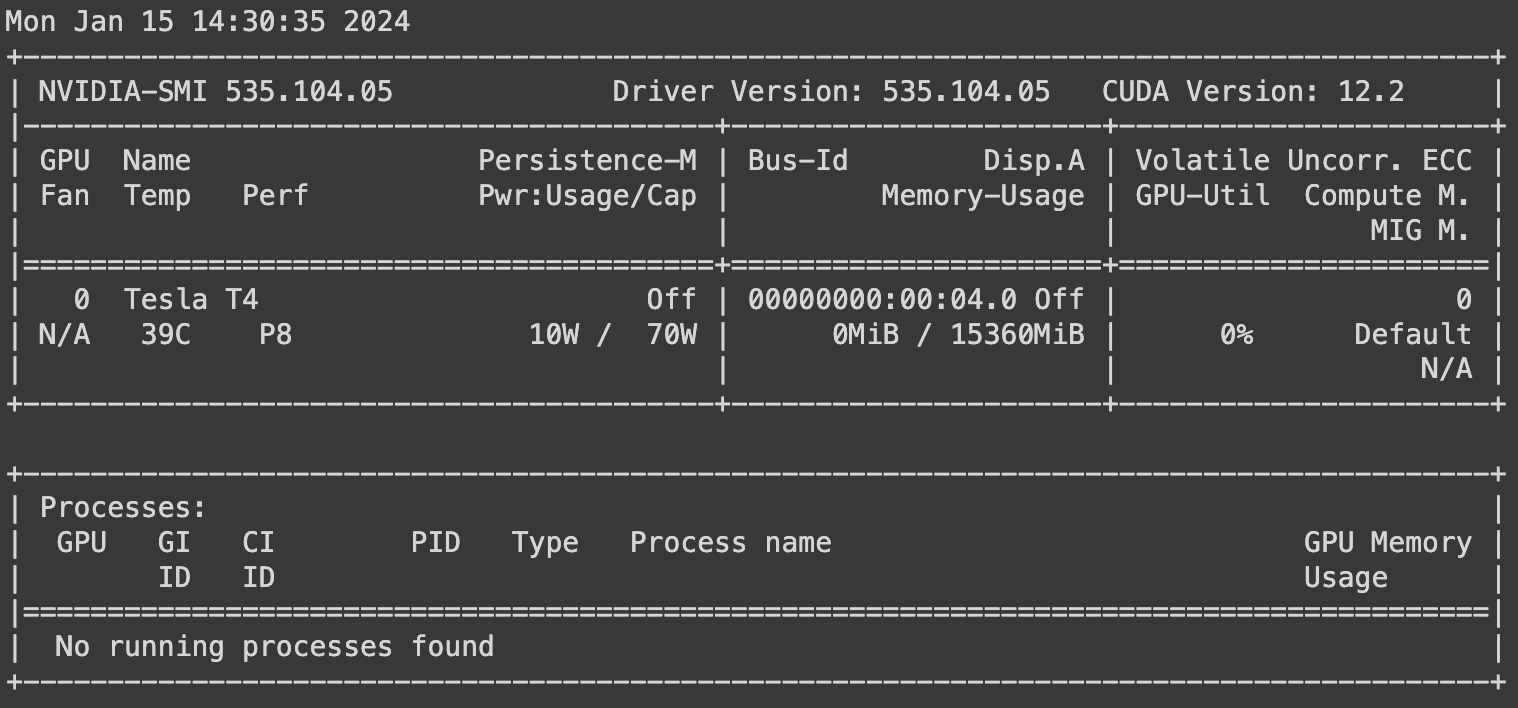
हम transformers और torch से आवश्यक मॉड्यूल इम्पोर्ट करते हैं। GPU त्वरण का लाभ लेने के लिए torch का उपयोग डिफ़ॉल्ट टेन्सर प्रकार सेट करने हेतु किया जाता है।
इसके बाद, चूंकि हम GPU का उपयोग कर रहे हैं, torch लाइब्रेरी को set_default_tensor_type फ़ंक्शन से सेट किया जाता है ताकि GPU का उपयोग सुनिश्चित हो।
from transformers import AutoModelForCausalLM, AutoTokenizer, set_seed
import torch
torch.set_default_tensor_type(torch.cuda.FloatTensor)यहाँ लक्ष्य मॉडल 7 बिलियन पैरामीटर वाला BLOOM मॉडल है, और यह BigScience के Hubbing Face रिपोजिटरी में bigscience/bloom-1b7 के अंतर्गत उपलब्ध है, जो मॉडल का यूनिक आइडेंटिफ़ायर है।
model_ID = "bigscience/bloom-1b7"अगले चरण में, हम Hugging Face से प्री-ट्रेंड BLOOM मॉडल और टोकनाइज़र लोड करते हैं, और set_seed फ़ंक्शन के जरिए पुनरुत्पादकता के लिए किसी एक संख्या से सीड सेट करते हैं। संख्या का विशिष्ट मान मायने नहीं रखता, बस यह गैर-फ्लोटिंग होना चाहिए।
LangChain, जो उन्नत AI एप्लिकेशन बनाने के लिए एक ओपन-सोर्स Python फ़्रेमवर्क है, के साथ बड़े भाषा मॉडलों की अनछुई संभावनाओं के बारे में अधिक जानने के लिए हमारा ट्यूटोरियल How to Build LLM Applications with LangChain Tutorial सही मार्गदर्शिका है।
इसके अलावा, यदि आप डेटा इंजीनियर हैं और डेटा अनुप्रयोगों के लिए LangChain के उपयोग में रुचि रखते हैं, तो हमारा लेख Introduction to LangChain for Data Engineering & Data Applications यह बताता है कि आप LangChain से क्या कर सकते हैं, किन समस्याओं को यह हल करता है, और डेटा उपयोग मामलों के उदाहरण।
model = AutoModelForCausalLM.from_pretrained(model_ID, use_cache=True)
tokenizer = AutoTokenizer.from_pretrained(model_ID)
set_seed(2024)
अब, हम जनरेट की जाने वाली कहानी का शीर्षक और प्रॉम्प्ट परिभाषित कर सकते हैं।
story_title = 'An Unexpected Journey Through Time'
prompt = f'This is a creative story about {story_title}.\n'
अंत में, हम प्रॉम्प्ट को टोकनाइज़ करते हैं और उपयुक्त मॉडल डिवाइस पर मैप करते हैं, फिर डिकोडिंग के बाद मॉडल का परिणाम जनरेट करते हैं।
input_ids = tokenizer(prompt, return_tensors="pt").to(0)

sample = model.generate(**input_ids,
                        max_length=200, top_k=1,
                        temperature=0, repetition_penalty=2.0)

generated_story = tokenizer.decode(sample[0], skip_special_tokens=True)
अंतिम परिणाम को textwrap मॉड्यूल का उपयोग करके फ़ॉर्मेट किया जाता है, ताकि बेहतर पठनीयता के लिए प्रति पंक्ति अधिकतम 80 अक्षर रहें।
import textwrap
wrapper = textwrap.TextWrapper(width=80)
formated_story = wrapper.fill(text=generated_story)
print(formated_story)अंतिम परिणाम नीचे दिया गया है:
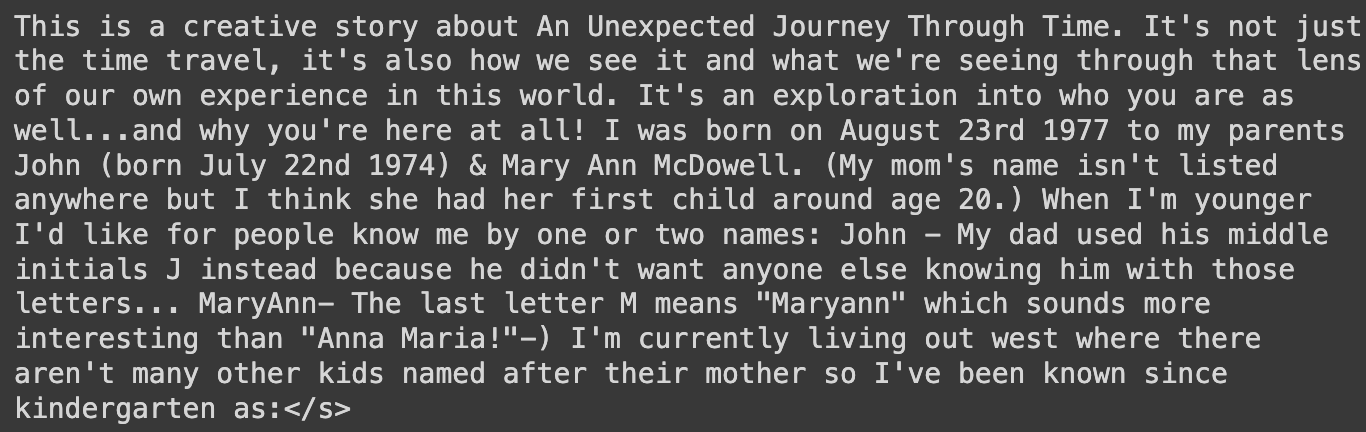
BLOOM मॉडल का उपयोग कर जनरेट की गई कहानी
कुछ पंक्तियों के कोड से, हम BLOOM मॉडल का उपयोग करके सार्थक सामग्री जनरेट करने में सक्षम हुए।
यदि आप PyTorch का उपयोग करके बड़े भाषा मॉडलों को प्रशिक्षित करने की प्रक्रिया—प्रारंभिक सेटअप से अंतिम कार्यान्वयन तक—में निपुण होना चाहते हैं, तो हमारा ट्यूटोरियल How to Train an LLM with PyTorch उस लक्ष्य तक पहुँचने के लिए एक संपूर्ण मार्गदर्शिका प्रदान करता है।
हर तकनीकी प्रगति की तरह, BLOOM के भी उपयुक्त और अनुपयुक्त अनुप्रयोगों का अपना सेट है। यह अनुभाग इसके उपयुक्त और अनुचित उपयोग मामलों पर चर्चा करता है—जहाँ इसकी क्षमताओं का सर्वोत्तम उपयोग हो सकता है और जहाँ सावधानी बरतनी चाहिए। इन सीमाओं को समझना BLOOM की क्षमताओं का जिम्मेदारीपूर्वक और प्रभावी ढंग से उपयोग करने के लिए महत्वपूर्ण है।
BLOOM भाषा प्रोसेसिंग और जनरेशन की सीमाओं को आगे बढ़ाने के लिए डिज़ाइन किया गया एक बहुमुखी उपकरण है। इसके उद्देश्यित उपयोग विभिन्न डोमेन में फैले हुए हैं, जो इसकी व्यापक भाषा क्षमताओं का लाभ उठाते हैं।
BLOOM की सीमाओं को समझना इसके नैतिक और व्यावहारिक अनुप्रयोग के लिए आवश्यक है। कुछ उपयोग मामले BLOOM LLM के उद्देश्यित दायरे से बाहर आते हैं, मुख्यतः नैतिक विचारों या तकनीकी बाधाओं के कारण।
एक उन्नत Large Language Model (LLM) के रूप में, BLOOM विभिन्न उपयोगकर्ता समूहों तक फैले व्यापक लाभ प्रदान करता है। इसकी क्षमताएँ न केवल कुछ पेशेवरों और क्षेत्रों को सीधे प्रभावित करती हैं, बल्कि व्यापक स्तर पर विभिन्न हितधारकों पर परोक्ष प्रभाव भी डालती हैं।
BLOOM के उपयोगकर्ताओं की यह पड़ताल दर्शाती है कि अलग-अलग समूह इस नवाचारपूर्ण उपकरण का कैसे लाभ उठाते हैं और इससे कैसे प्रभावित होते हैं।
BLOOM के प्रत्यक्ष और परोक्ष उपयोगकर्ताओं को समझकर, हम मॉडल के व्यापक प्रभाव और उन विविध तरीकों की सराहना कर सकते हैं जिनसे यह तकनीक और समाज को आगे बढ़ाने में योगदान देता है।
BLOOM जैसे किसी भी Large Language Model (LLM) की तैनाती अपने साथ कई नैतिक विचारों और सीमाओं को लेकर आती है। जिम्मेदार उपयोग और तकनीक के व्यापक प्रभाव का पूर्वानुमान लगाने के लिए इन पहलुओं को समझना अत्यंत महत्वपूर्ण है। यह अनुभाग BLOOM के उपयोग से जुड़े नैतिक निहितार्थ, जोखिम और अंतर्निहित सीमाओं को संबोधित करता है।
BLOOM का विकास और रिलीज़ वास्तविक दुनिया में महत्वपूर्ण निहितार्थ रखता है—इसके प्रभाव के साथ-साथ उत्पन्न होने वाले विवादों के संदर्भ में। यह अनुभाग BLOOM के शोध-पत्र से मिली अंतर्दृष्टियों के आधार पर इन पहलुओं पर चर्चा करता है।
कृत्रिम बुद्धिमत्ता (AI) की तेज़ रफ्तार दुनिया में, BLOOM जैसे Large Language Models (LLMs) की प्रासंगिकता पर चर्चा जारी है।
अंतरराष्ट्रीय शोधकर्ताओं की बड़ी टीम द्वारा विकसित, BLOOM भाषा प्रोसेसिंग में एक महत्वपूर्ण छलांग था। हालांकि, AI परिदृश्य लगातार विकसित हो रहा है—नए मॉडलों के उभरने से फोकस बदलता रहता है।
आइए देखें कि क्या BLOOM अब भी इस प्रतिस्पर्धी क्षेत्र में अपनी पकड़ बनाए हुए है।
इस लेख में BLOOM प्रोजेक्ट का अवलोकन प्रस्तुत किया गया—जो Large Language Models के विकसित होते क्षेत्र में एक महत्वपूर्ण योगदान है।
हमने BLOOM के विकास, उसकी तकनीकी विशिष्टताओं और उसके निर्माण के पीछे के सहयोग पर प्रकाश डाला। लेख ने BLOOM तक पहुँचने और उसे प्रभावी ढंग से उपयोग करने के लिए एक मार्गदर्शिका के रूप में भी कार्य किया, जिसमें इसके उपयुक्त उपयोगों और सीमाओं पर जोर दिया गया।
इसके अलावा, इसमें BLOOM AI प्रोजेक्ट के नैतिक निहितार्थ और वास्तविक दुनिया पर प्रभाव को शामिल किया गया, और आज के AI परिदृश्य में इसकी स्वीकृति और प्रासंगिकता पर विचार किया गया। चाहे आप सीधे AI से जुड़े हों या उत्साही हों, BLOOM की यह पड़ताल बड़े भाषा मॉडलों की जटिल दुनिया में मार्गदर्शन के लिए आवश्यक दृष्टिकोण प्रदान करती है।
जो लोग उन्नत भाषा मॉडलों के साथ अपनी भागीदारी को और गहरा करना चाहते हैं, उनके लिए हमारा अतिरिक्त कोर्स Large Language Models (LLMs) Concepts LLM अनुप्रयोगों, प्रशिक्षण पद्धतियों, नैतिक विचारों और नवीनतम शोध को कवर करने वाले हमारे वैचारिक कोर्स के साथ LLMs की पूरी क्षमता खोजने का मार्ग प्रदान करता है।
आज ही अपनी AI यात्रा शुरू करें!
course
course
course