course
Koncepcje generatywnej AI
2 godz.
117.2K
Wzrost popularności dużych modeli językowych (LLM) to jeden z najważniejszych trendów w przetwarzaniu języka naturalnego (NLP), który doprowadził do ich szerokiego zastosowania w wielu obszarach. Jednak ten postęp często był ekskluzywny, a większość LLM tworzonych przez organizacje dysponujące dużymi zasobami pozostawała niedostępna dla ogółu.
Taka ekskluzywność rodzi istotne pytanie: co, jeśli dałoby się zdemokratyzować dostęp do tych potężnych modeli językowych? Tu na scenę wchodzi BLOOM.
Ten artykuł to pełny przegląd tego, czym jest BLOOM. Najpierw przedstawiamy więcej szczegółów o jego genezie, następnie omawiamy specyfikację techniczną BLOOM i sposób korzystania z niego, a na końcu podkreślamy jego ograniczenia oraz kwestie etyczne.
BigScience Large Open-science Open-access Multilingual Language Model (w skrócie BLOOM) to znaczący krok w kierunku demokratyzacji technologii modeli językowych.
Opracowany wspólnie przez ponad 1200 uczestników z 39 krajów, w tym znaczną liczbę z USA, BLOOM jest efektem globalnego wysiłku. Projekt był koordynowany przez BigScience we współpracy z Hugging Face i francuską społecznością NLP, przekraczając granice geograficzne i instytucjonalne.
To otwartoźródłowy model typu transformer zawierający wyłącznie dekoder, z 176 mld parametrów, wytrenowany na korpusie ROOTS, czyli zbiorze danych obejmującym setki źródeł w 59 językach: 46 językach mówionych i 13 językach programowania.
Poniżej przedstawiono wykres kołowy rozkładu języków treningowych.
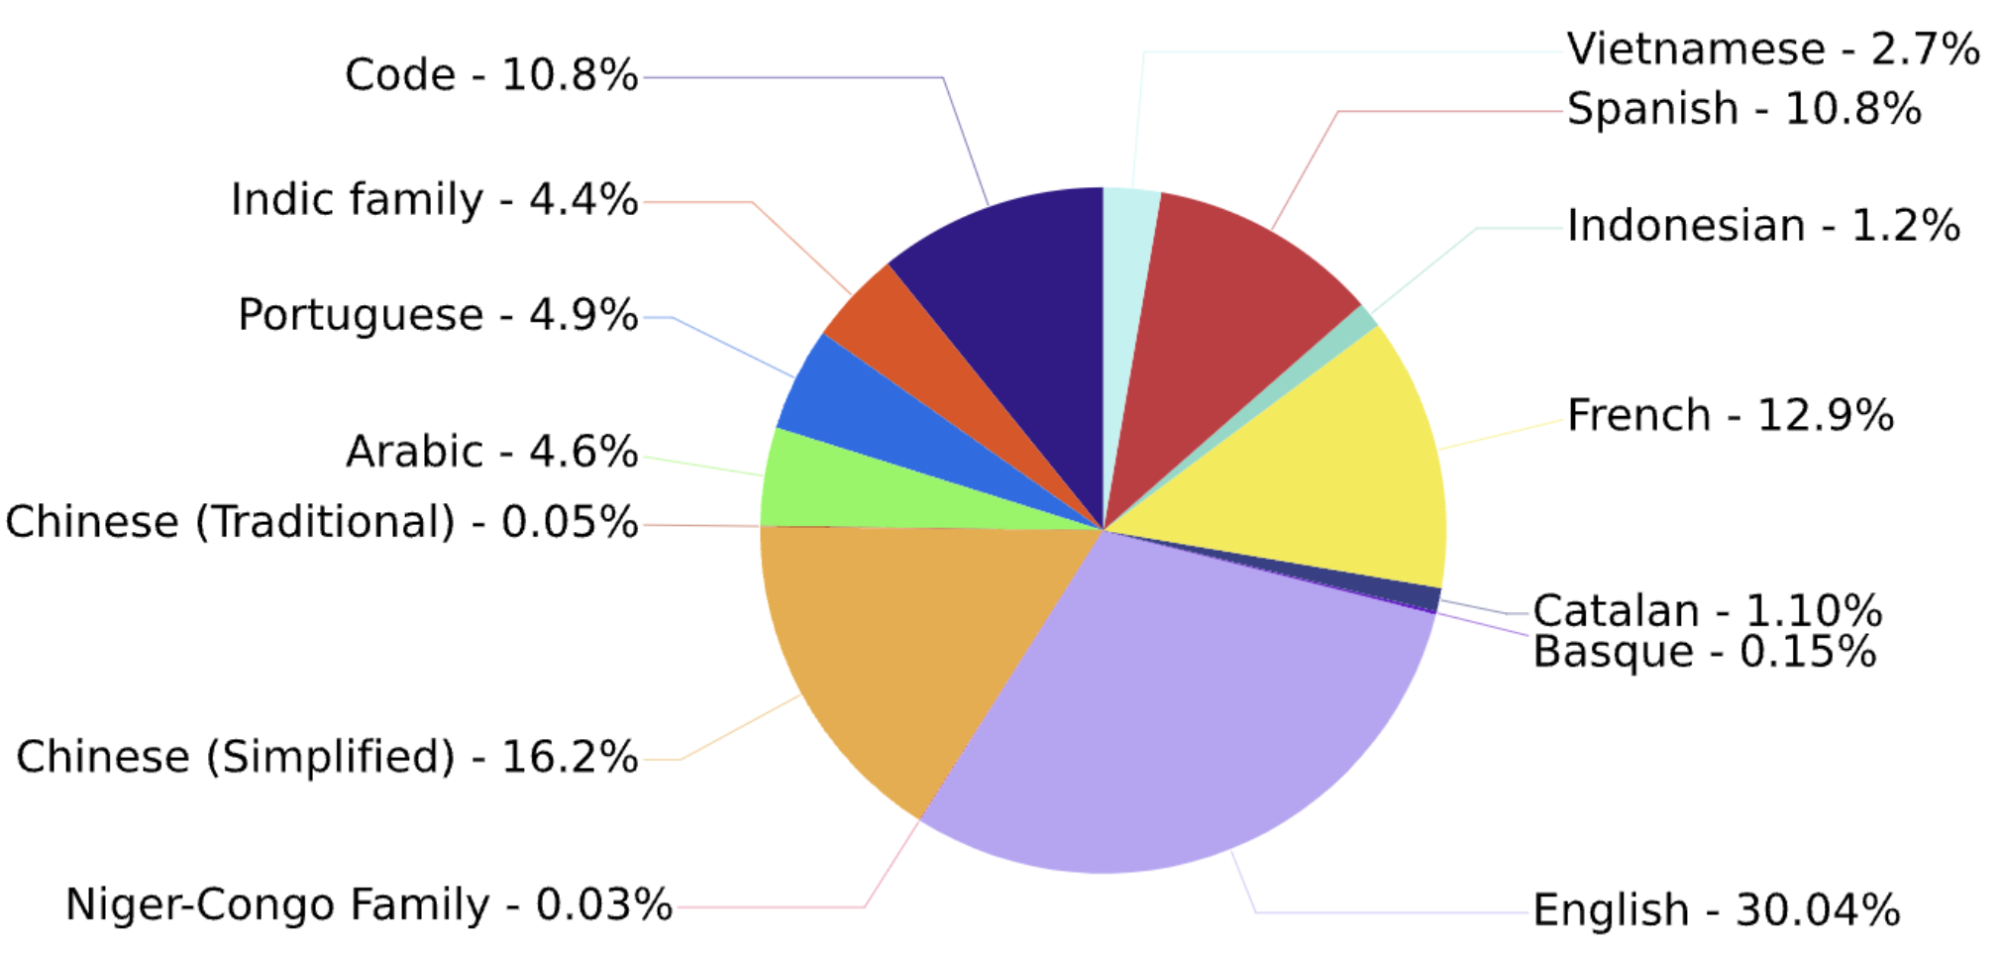
Rozkład języków treningowych (źródło)
Model osiągnął znakomite wyniki w szerokim spektrum benchmarków, a po dostrojeniu z użyciem promptów dla wielu zadań rezultaty były jeszcze lepsze.
Projekt zwieńczyła 117-dniowa (11 marca – 6 lipca) sesja treningowa na superkomputerze Jean Zay w Paryżu, wsparta znaczącym grantem obliczeniowym od francuskich agencji badawczych CNRS i GENCI.
BLOOM to nie tylko techniczny majstersztyk, ale i symbol międzynarodowej współpracy oraz siły wspólnego dążenia naukowego.
Teraz opiszmy architekturę BLOOM w bardziej szczegółowy sposób, obejmującą kilka komponentów.
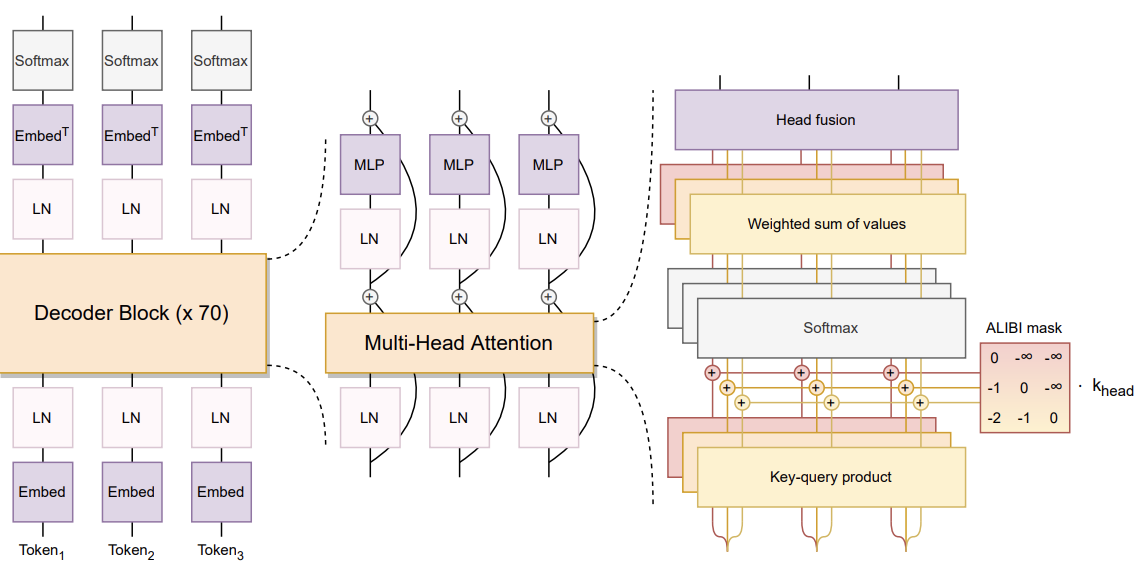
Architektura BLOOM (źródło)
Architektura modelu BLOOM, zgodnie z opisem w publikacji, obejmuje kilka istotnych aspektów:
Te elementy odzwierciedlają dążenie zespołu do wyważenia innowacji ze sprawdzonymi technikami w celu optymalizacji wydajności i stabilności modelu.
Poza komponentami architektonicznymi BLOOM, przyjrzyjmy się dwóm dodatkowym, istotnym elementom: przetwarzaniu danych i zbiorom z promptami.
W tym przykładzie użyjemy BLOOM do wygenerowania kreatywnej opowieści. Kod służy do przygotowania środowiska, wczytania modelu i wygenerowania tekstu na podstawie podanego promptu. Odpowiedni kod źródłowy jest dostępny na GitHubie i jest mocno inspirowany tutorialem amrrs.
Model BLOOM jest wymagający zasobowo, dlatego właściwa konfiguracja środowiska jest kluczowa. Główne kroki opisano poniżej.
Najpierw biblioteka transformers zapewnia interfejsy do pracy z modelem BLOOM i innymi modelami opartymi na transformerach.
!pip install transformers -qZa pomocą nvidia-smi sprawdzamy właściwości dostępnego GPU, aby upewnić się, że dysponujemy zasobami obliczeniowymi potrzebnymi do uruchomienia modelu.
!nvidia-smi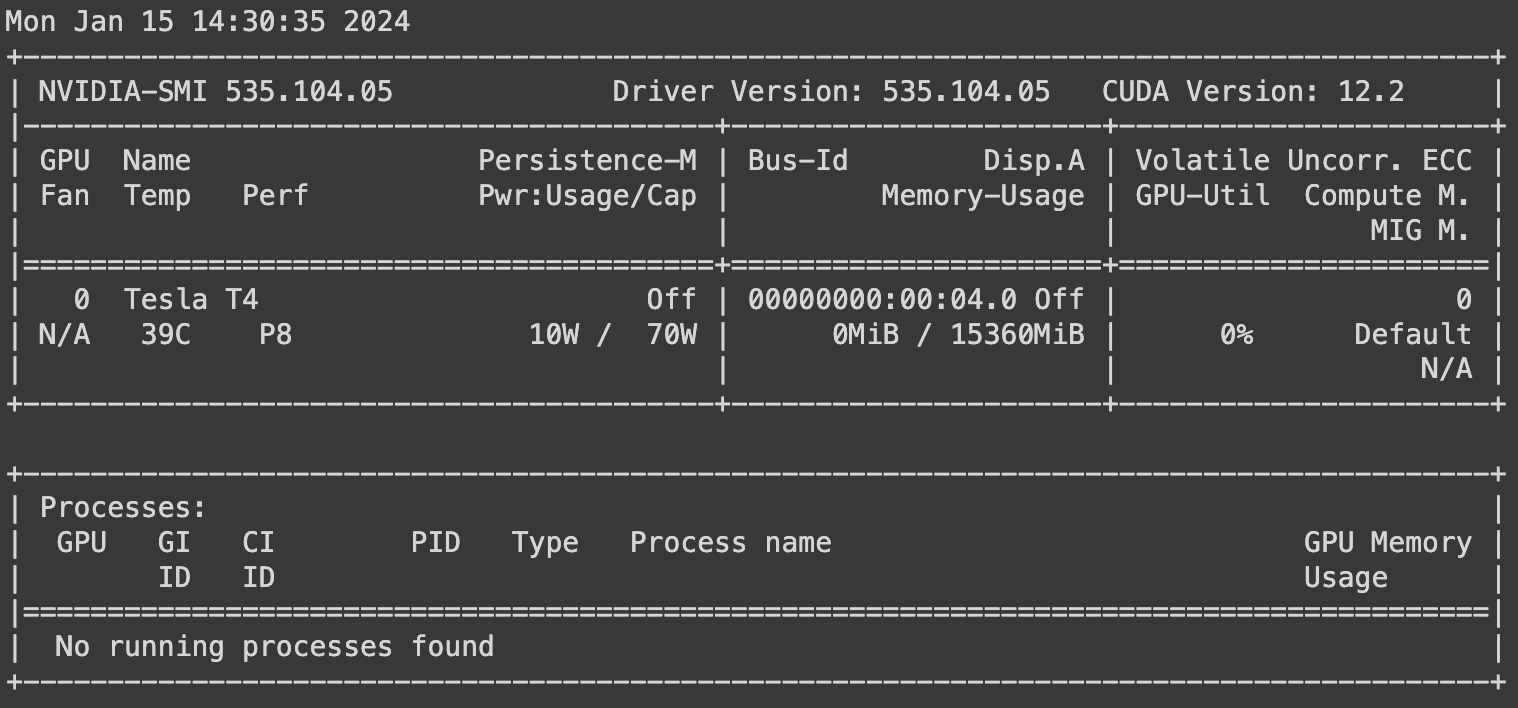
Importujemy wymagane moduły z transformers oraz torch. torch służy do ustawienia domyślnego typu tensora, aby wykorzystać akcelerację GPU.
Następnie, ponieważ używamy GPU, biblioteka torch jest skonfigurowana za pomocą funkcji set_default_tensor_type, aby wymusić użycie GPU.
from transformers import AutoModelForCausalLM, AutoTokenizer, set_seed
import torch
torch.set_default_tensor_type(torch.cuda.FloatTensor)Docelowym modelem jest BLOOM z 7 miliardami parametrów, dostępnym w repozytorium BigScience na Hugging Face pod identyfikatorem bigscience/bloom-1b7, który odpowiada unikatowemu identyfikatorowi modelu.
model_ID = "bigscience/bloom-1b7"Następnie ładujemy wstępnie wytrenowany model BLOOM i tokenizer z Hugging Face oraz ustawiamy ziarno losowości dla odtwarzalności za pomocą funkcji set_seed z dowolną liczbą. Sama wartość nie ma znaczenia, ważne, by nie była zmiennoprzecinkowa.
Aby poznać niewykorzystany potencjał dużych modeli językowych z LangChain, otwartoźródłowym frameworkiem Pythona do budowy zaawansowanych aplikacji AI, polecamy nasz poradnik How to Build LLM Applications with LangChain Tutorial.
Ponadto, jeśli jesteś inżynierem danych i interesuje cię użycie LangChain w aplikacjach danych, nasz artykuł Introduction to LangChain for Data Engineering & Data Applications przedstawia przegląd możliwości LangChain, w tym problemy, które rozwiązuje, oraz przykłady zastosowań danych.
model = AutoModelForCausalLM.from_pretrained(model_ID, use_cache=True)
tokenizer = AutoTokenizer.from_pretrained(model_ID)
set_seed(2024)
Teraz możemy zdefiniować tytuł opowiadania do wygenerowania wraz z promptem.
story_title = 'An Unexpected Journey Through Time'
prompt = f'This is a creative story about {story_title}.\n'
Na koniec tokenizujemy prompt i mapujemy go na odpowiednie urządzenie modelu, a następnie generujemy wynik i dekodujemy go.
input_ids = tokenizer(prompt, return_tensors="pt").to(0)

sample = model.generate(**input_ids,
                        max_length=200, top_k=1,
                        temperature=0, repetition_penalty=2.0)

generated_story = tokenizer.decode(sample[0], skip_special_tokens=True)
Końcowy wynik formatujemy modułem textwrap, aby maksymalna liczba znaków w wierszu wynosiła 80 dla lepszej czytelności.
import textwrap
wrapper = textwrap.TextWrapper(width=80)
formated_story = wrapper.fill(text=generated_story)
print(formated_story)Ostateczny rezultat przedstawiono poniżej:
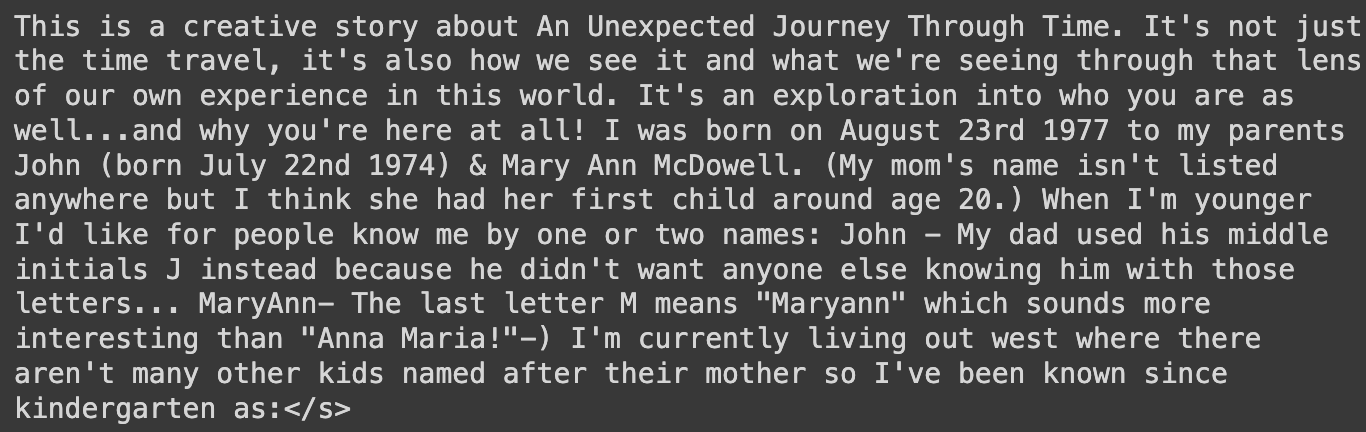
Opowiadanie wygenerowane modelem BLOOM
Kilka linijek kodu wystarczyło, by wygenerować sensowną treść przy użyciu modelu BLOOM.
Jeśli chcesz opanować proces trenowania dużych modeli językowych w PyTorch — od konfiguracji po wdrożenie — nasz poradnik How to Train an LLM with PyTorch stanowi kompletny przewodnik do osiągnięcia tego celu.
Jak każda zaawansowana technologia, BLOOM ma zestaw właściwych i niewłaściwych zastosowań. W tej części omawiamy odpowiednie i nieodpowiednie przypadki użycia, wskazując, gdzie najlepiej wykorzystać możliwości modelu, a gdzie zalecana jest ostrożność. Zrozumienie tych granic jest kluczowe, by odpowiedzialnie i skutecznie korzystać z BLOOM.
BLOOM to wszechstronne narzędzie zaprojektowane, by przesuwać granice przetwarzania i generowania języka. Jego zamierzone zastosowania obejmują różne domeny, wykorzystujące szerokie możliwości językowe modelu.
Zrozumienie ograniczeń BLOOM jest kluczowe, by zapewnić etyczne i praktyczne użycie. Niektóre przypadki wykraczają poza to, do czego BLOOM jest przeznaczony, głównie z powodów etycznych lub technicznych.
BLOOM, jako zaawansowany duży model językowy (LLM), oferuje szerokie korzyści dla różnych grup użytkowników. Jego możliwości wpływają bezpośrednio na określonych profesjonalistów i sektory, a także mają szerszy, pośredni efekt na większe grono interesariuszy.
Celem tego przeglądu użytkowników BLOOM jest pokazanie, jak różne grupy korzystają z tego innowacyjnego narzędzia i jak są przez nie kształtowane.
Rozumiejąc użytkowników bezpośrednich i pośrednich BLOOM, możemy docenić rozległy wpływ modelu i różnorodne sposoby, w jakie przyczynia się on do rozwoju technologii i społeczeństwa.
Wdrażanie BLOOM, jak każdego dużego modelu językowego, wiąże się z szeregiem kwestii etycznych i ograniczeń. Zrozumienie ich jest kluczowe dla odpowiedzialnego użycia i przewidywania szerszego wpływu technologii. W tej części omawiamy implikacje etyczne, ryzyka i wrodzone ograniczenia związane z korzystaniem z BLOOM.
Rozwój i udostępnienie BLOOM mają istotne konsekwencje w świecie rzeczywistym — zarówno pod względem wpływu, jak i kontrowersji, które wywołują. W tej części omawiamy te kwestie, opierając się na wnioskach z pracy badawczej o BLOOM.
W szybko zmieniającym się świecie sztucznej inteligencji (AI) znaczenie dużych modeli językowych (LLM), takich jak BLOOM, pozostaje tematem dyskusji.
Stworzony przez rozległy zespół międzynarodowych badaczy, BLOOM był znaczącym krokiem naprzód w przetwarzaniu języka. Jednak krajobraz AI stale ewoluuje — pojawiają się nowe modele, przesuwając punkt ciężkości.
Przyjrzyjmy się, czy BLOOM nadal utrzymuje pozycję w tym konkurencyjnym obszarze.
W tym artykule przedstawiliśmy przegląd projektu BLOOM — istotnego wkładu w rozwijającą się dziedzinę dużych modeli językowych.
Omówiliśmy rozwój BLOOM, podkreślając specyfikację techniczną oraz współpracę stojącą za jego powstaniem. Artykuł pełnił też rolę przewodnika po dostępie do BLOOM i skutecznym korzystaniu z niego, z naciskiem na odpowiednie zastosowania i ograniczenia.
Ponadto poruszyliśmy kwestie etyczne i wpływ BLOOM w świecie rzeczywistym, zastanawiając się nad jego odbiorem i znaczeniem w dzisiejszym krajobrazie AI. Niezależnie od tego, czy bezpośrednio pracujesz z AI, czy jesteś entuzjastą, ten przegląd BLOOM oferuje kluczowe perspektywy pomocne w poruszaniu się po złożonym świecie dużych modeli językowych.
Dla osób, które chcą pogłębić swoją przygodę z zaawansowanymi modelami językowymi, nasz dodatkowy kurs Large Language Models (LLMs) Concepts pozwala odkryć pełen potencjał LLM — obejmuje zastosowania, metody treningu, kwestie etyczne i najnowsze badania.
Rozpocznij dziś swoją przygodę z AI!
course
course
course