Cours
Concepts d'IA générative
2 h
117.3K
La montée en puissance des grands modèles de langue (LLM) est l'une des tendances marquantes du traitement automatique du langage naturel (NLP), entraînant une adoption massive dans de nombreux cas d'usage. Pourtant, ces avancées sont souvent restées l'apanage d'organisations disposant de ressources considérables, rendant la plupart des LLM inaccessibles au grand public.
Cette exclusivité soulève une question majeure : et s'il existait un moyen d'ouvrir l'accès à ces modèles puissants ? C'est là que BLOOM entre en scène.
Cet article propose une vue d'ensemble de BLOOM : son origine, ses spécifications techniques et sa prise en main, avant d'aborder ses limites et les considérations éthiques.
BigScience Large Open-science Open-access Multilingual Language Model (BLOOM), représente une avancée majeure vers la démocratisation des modèles de langue.
Développé de manière collaborative par plus de 1 200 participantes et participants issus de 39 pays, dont un grand nombre des États-Unis, BLOOM est le fruit d'un effort mondial. Coordonné par BigScience en collaboration avec Hugging Face et la communauté française du NLP, ce projet dépasse les frontières géographiques et institutionnelles.
Il s'agit d'un modèle open source de type transformer « decoder-only » comptant 176 milliards de paramètres, entraîné sur le corpus ROOTS, un jeu de données issu de centaines de sources en 59 langues : 46 langues parlées et 13 langages de programmation.
Ci-dessous, le diagramme circulaire de la répartition des langues d'entraînement.
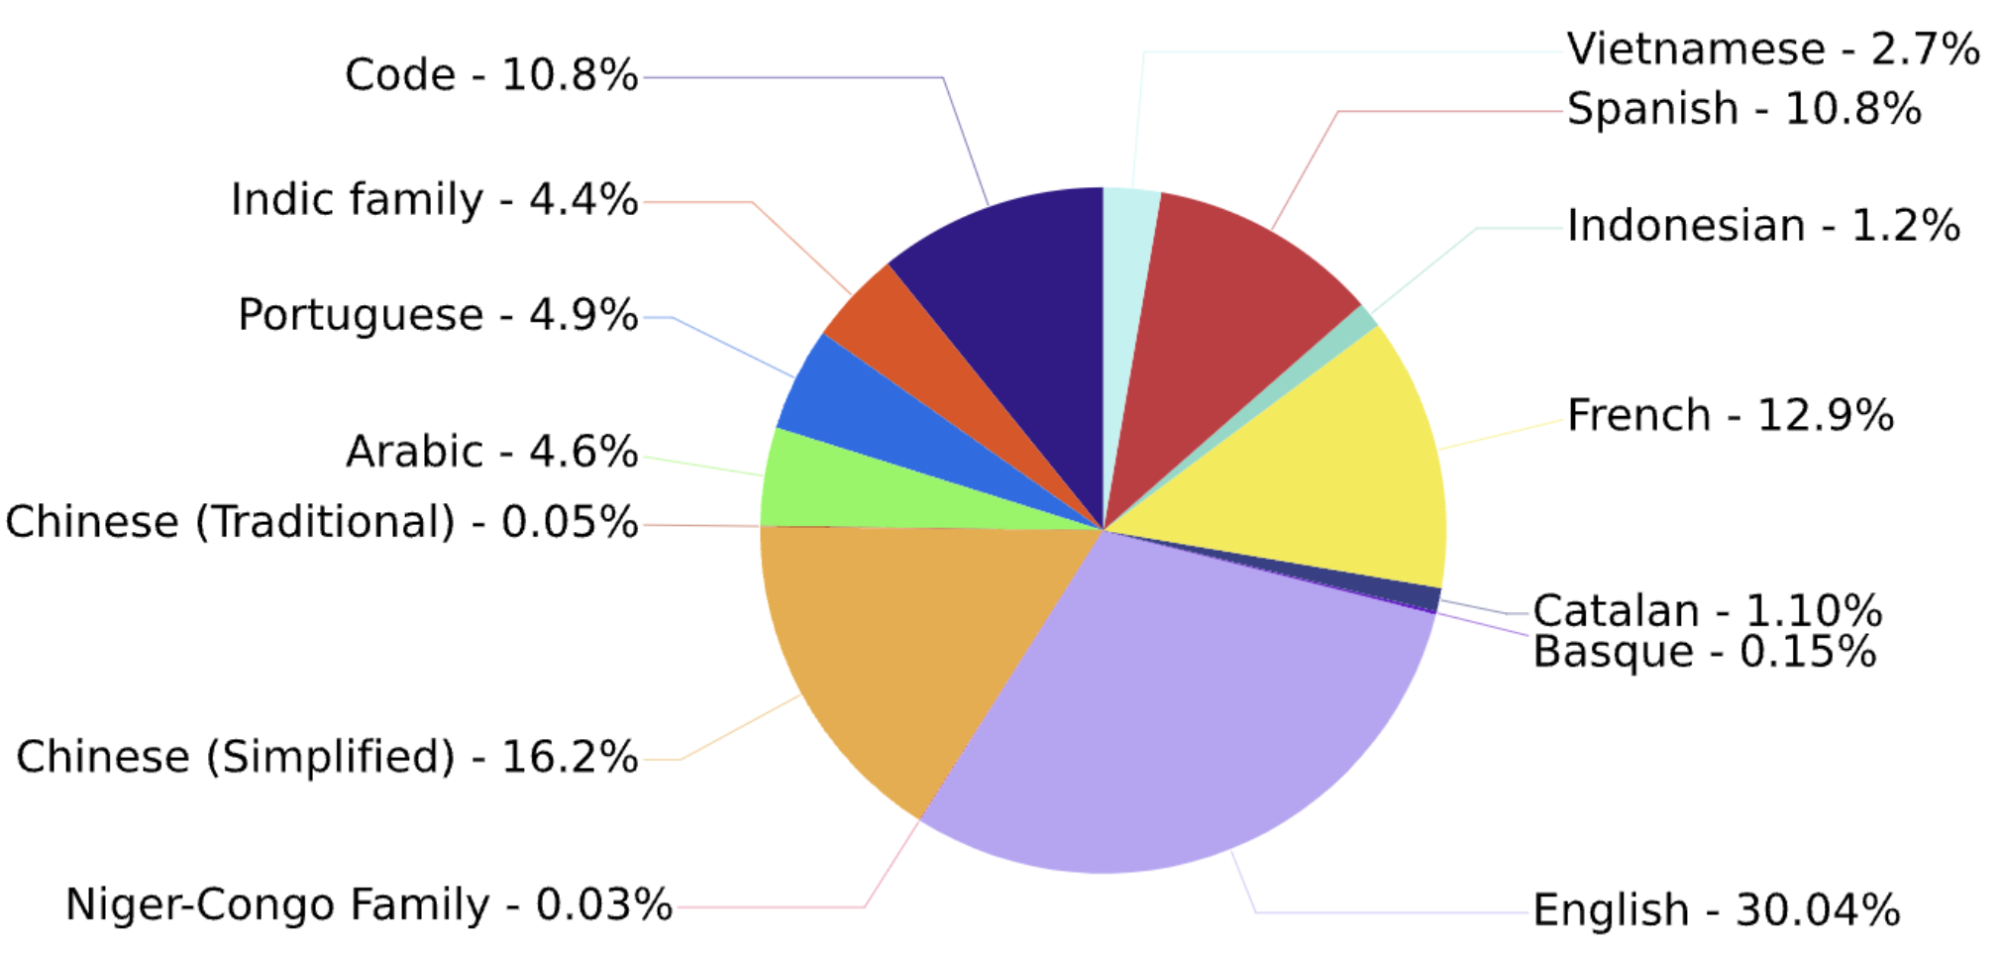
Répartition des langues d'entraînement (source)
Le modèle affiche des performances remarquables sur un large éventail de benchmarks, avec des résultats renforcés après un affinement multitâche par invites (prompted finetuning).
Le projet a culminé avec 117 jours d'entraînement (du 11 mars au 6 juillet) sur le supercalculateur Jean Zay à Paris, rendus possibles par une généreuse allocation de calcul des organismes de recherche français CNRS et GENCI.
BLOOM n'est pas seulement une prouesse technologique ; c'est aussi un symbole de coopération internationale et de la force de l'effort scientifique collectif.
Passons maintenant à une description plus détaillée de l'architecture de BLOOM, qui repose sur plusieurs composants.
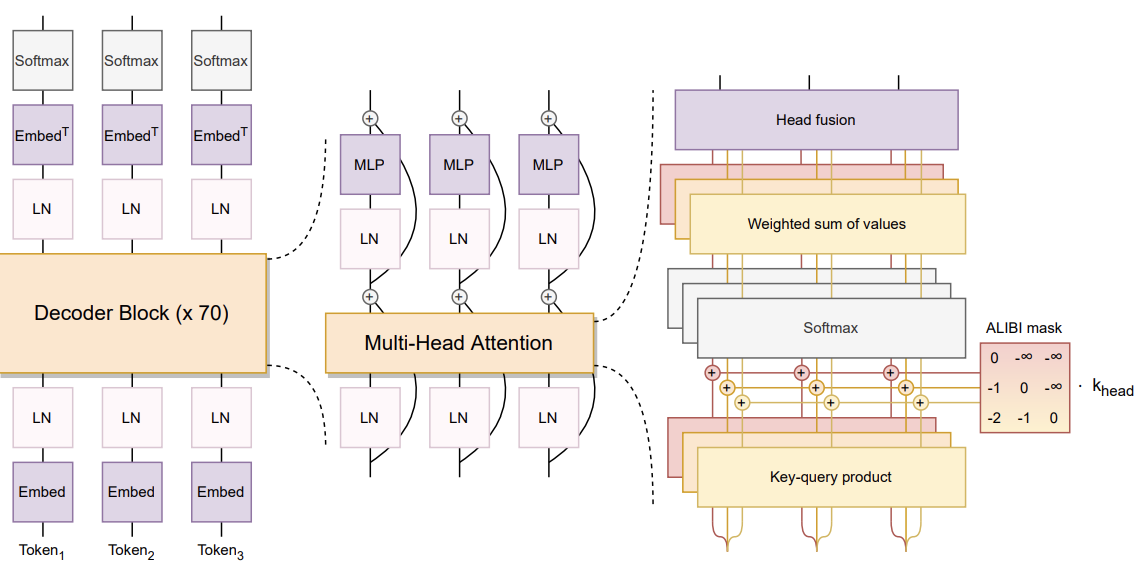
Architecture de BLOOM (source)
L'architecture de BLOOM, telle que décrite dans l'article, comprend plusieurs points notables :
Ces composants illustrent la volonté de l'équipe d'équilibrer innovation et techniques éprouvées pour optimiser performances et stabilité.
Au-delà de l'architecture de BLOOM, examinons deux éléments complémentaires : le prétraitement des données et les jeux de données pour l'apprentissage par invites.
Dans cet exemple, nous allons utiliser BLOOM pour générer une histoire créative. Le code ci-dessous prépare l'environnement, charge le modèle, puis génère du texte à partir d'une invite. Le code source correspondant est disponible sur GitHub, et s'inspire fortement du tutoriel d'amrrs.
Le modèle BLOOM est gourmand en ressources ; une configuration adéquate de l'environnement est donc essentielle. Les principales étapes sont décrites ci-dessous.
Tout d'abord, la bibliothèque transformers fournit les interfaces pour travailler avec BLOOM et, plus largement, avec les modèles de type transformer.
!pip install transformers -qAvec nvidia-smi, nous vérifions les caractéristiques du GPU disponible afin de s'assurer de disposer de la puissance de calcul nécessaire.
!nvidia-smi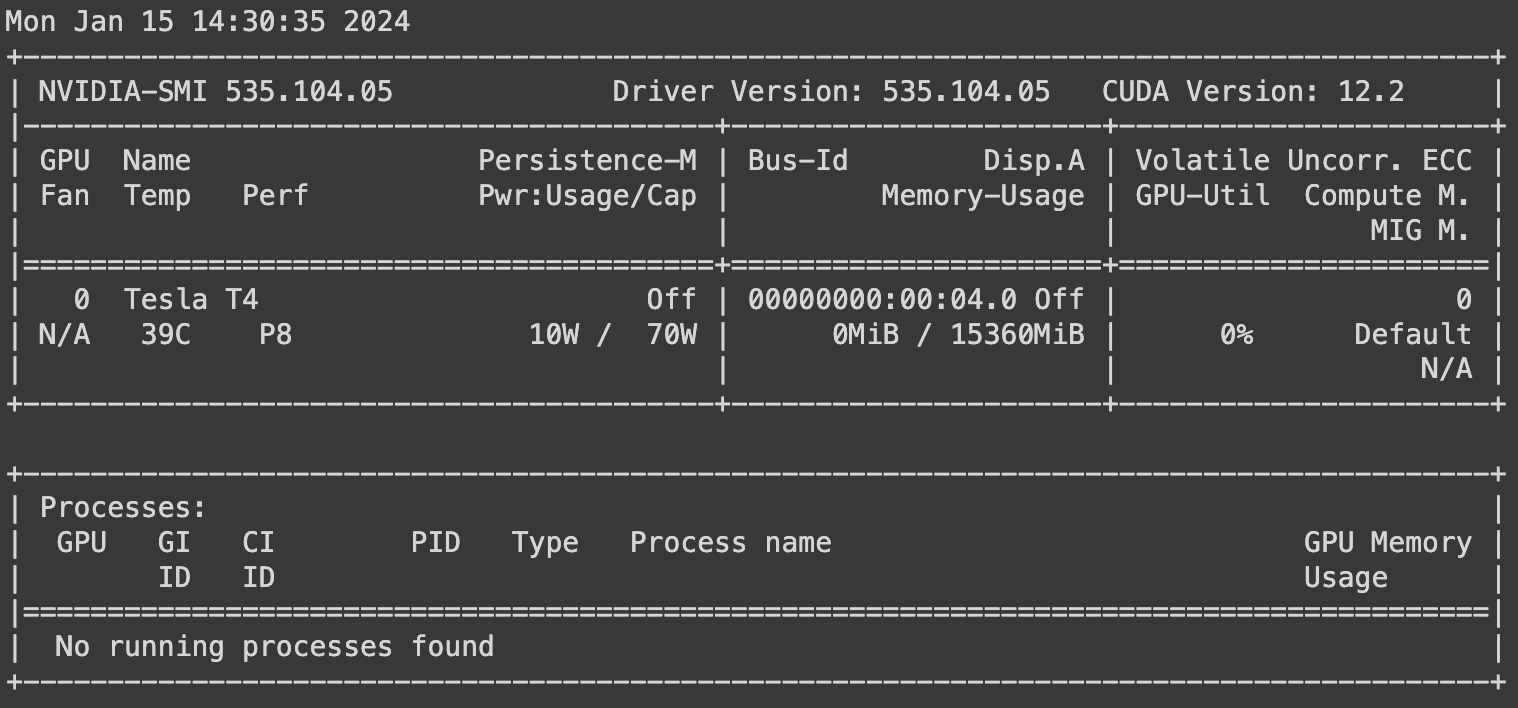
Nous importons les modules requis depuis transformers et torch. torch est utilisé pour définir le type de tenseur par défaut, afin de tirer parti de l'accélération GPU.
Puis, puisque nous utilisons un GPU, la bibliothèque torch est configurée via la fonction set_default_tensor_type pour garantir l'usage du GPU.
from transformers import AutoModelForCausalLM, AutoTokenizer, set_seed
import torch
torch.set_default_tensor_type(torch.cuda.FloatTensor)Le modèle ciblé ici est la version à 7 milliards de paramètres, accessible sur le dépôt Hugging Face de BigScience sous l'identifiant bigscience/bloom-1b7, qui correspond à l'ID unique du modèle.
model_ID = "bigscience/bloom-1b7"Nous chargeons ensuite le modèle BLOOM préentraîné et son tokenizer depuis Hugging Face, et fixons la graine aléatoire pour la reproductibilité avec la fonction set_seed et un nombre entier quelconque.
Pour aller plus loin sur le potentiel des LLM avec LangChain, un framework Python open source pour construire des applications d'IA avancées, consultez notre tutoriel How to Build LLM Applications with LangChain Tutorial.
Par ailleurs, si vous êtes data engineer et souhaitez utiliser LangChain pour des applications data, notre article Introduction to LangChain for Data Engineering & Data Applications présente les problèmes que LangChain adresse et des exemples de cas d'usage data.
model = AutoModelForCausalLM.from_pretrained(model_ID, use_cache=True)
tokenizer = AutoTokenizer.from_pretrained(model_ID)
set_seed(2024)
Nous pouvons maintenant définir le titre de l'histoire à générer, ainsi que l'invite.
story_title = 'An Unexpected Journey Through Time'
prompt = f'This is a creative story about {story_title}.\n'
Enfin, nous tokenisons l'invite, l'envoyons sur le bon périphérique, puis générons le résultat du modèle avant de le décoder.
input_ids = tokenizer(prompt, return_tensors="pt").to(0)

sample = model.generate(**input_ids,
                        max_length=200, top_k=1,
                        temperature=0, repetition_penalty=2.0)

generated_story = tokenizer.decode(sample[0], skip_special_tokens=True)
Le résultat final est mis en forme avec le module textwrap, pour limiter chaque ligne à 80 caractères et améliorer la lisibilité.
import textwrap
wrapper = textwrap.TextWrapper(width=80)
formated_story = wrapper.fill(text=generated_story)
print(formated_story)Voici le rendu final :
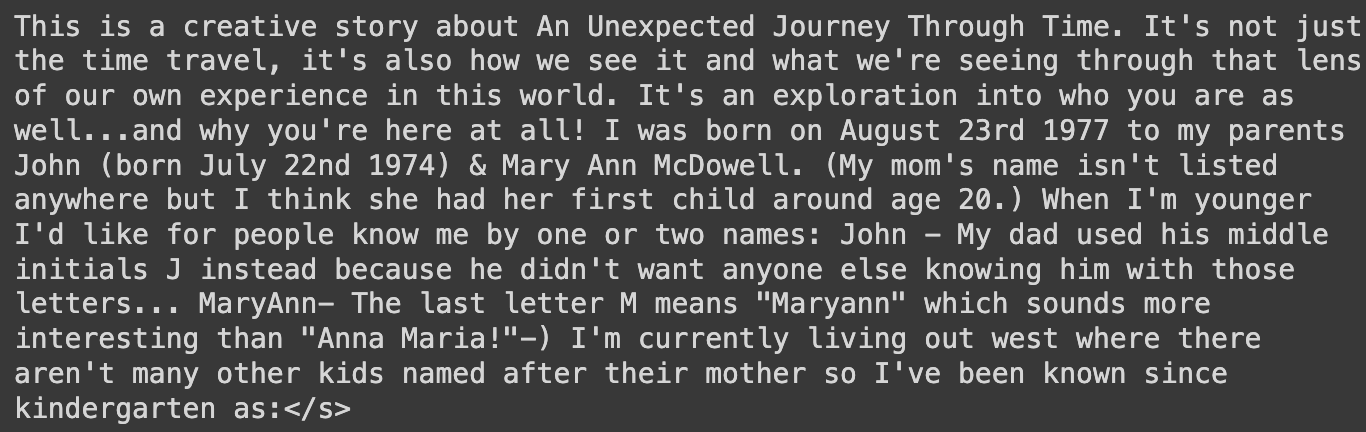
Histoire générée avec le modèle BLOOM
Avec quelques lignes de code, nous avons pu générer un contenu pertinent à l'aide de BLOOM.
Si vous souhaitez maîtriser l'entraînement de grands modèles de langue avec PyTorch, de la préparation à la mise en production, notre tutoriel How to Train an LLM with PyTorch est le guide qu'il vous faut.
Comme toute avancée technologique, BLOOM s'accompagne d'usages adaptés et d'autres inappropriés. Cette section détaille les cas d'usage pertinents et ceux à éviter, afin d'indiquer où ses capacités apportent le plus de valeur et où la prudence s'impose. Comprendre ces limites est essentiel pour exploiter BLOOM de manière responsable et efficace.
BLOOM est un outil polyvalent qui repousse les frontières de l'analyse et de la génération de texte. Ses usages attendus couvrent plusieurs domaines, chacun tirant parti de ses vastes capacités linguistiques.
Connaître les limites de BLOOM est crucial pour en garantir un emploi éthique et pertinent. Certains cas d'usage ne relèvent pas de son périmètre, pour des raisons éthiques ou techniques.
BLOOM, en tant que grand modèle de langue, apporte des bénéfices à de nombreux profils. Ses capacités ont un impact direct sur certains métiers et secteurs, et un effet plus large sur d'autres parties prenantes.
Cette exploration des utilisateurs de BLOOM met en lumière la manière dont différents groupes l'exploitent ou en sont impactés.
En identifiant les utilisateurs directs et indirects, on mesure l'ampleur de son influence et la diversité de ses contributions au progrès technologique et à la société.
Comme tout grand modèle de langue, BLOOM soulève des considérations éthiques et présente des limites. Les comprendre est essentiel pour un usage responsable et pour anticiper ses impacts. Cette section traite des implications éthiques, des risques et des limites inhérentes à BLOOM.
Le développement et la publication de BLOOM ont des implications concrètes, tant en termes d'impact que de controverses. Cette section en dresse un panorama, appuyé sur l'article de recherche dédié.
Dans un secteur de l'intelligence artificielle (IA) en perpétuelle accélération, la pertinence de LLM comme BLOOM fait l'objet de débats constants.
Fruit d'une vaste collaboration internationale, BLOOM a constitué un saut important en traitement du langage. Cependant, le paysage évolue sans cesse, avec l'émergence de nouveaux modèles qui déplacent l'attention.
Voyons si BLOOM tient encore son rang dans cet environnement compétitif.
Cet article a proposé un tour d'horizon du projet BLOOM, une contribution majeure au champ des grands modèles de langue.
Nous avons retracé son développement, mis en avant ses spécifications techniques et la collaboration qui l'a rendu possible. Nous avons également présenté comment y accéder et l'utiliser efficacement, en insistant sur ses usages adaptés et ses limites.
Enfin, nous avons abordé ses implications éthiques et son impact réel, ainsi que sa place dans l'écosystème actuel de l'IA. Que vous œuvriez directement dans l'IA ou que vous soyez curieux du sujet, cette exploration de BLOOM fournit des repères essentiels pour naviguer dans l'univers des LLM.
Pour approfondir votre maîtrise des grands modèles de langue, notre cours complémentaire Large Language Models (LLMs) Concepts vous permettra d'explorer tout le potentiel des LLM : applications, méthodes d'entraînement, considérations éthiques et dernières avancées de la recherche.
Commencez votre parcours en IA dès aujourd'hui !
Cours
Cours
Cours
blog
blog
Lynn Heidmann
blog
Kurtis Pykes
9 min
blog
Kurtis Pykes
15 min
blog
Nisha Arya Ahmed
15 min
Tutoriel