course
Koncept inom generativ AI
2 timmar
117.2K
Uppgången för stora språkmodeller (LLM) har varit en avgörande trend inom Natural Language Processing (NLP) och lett till att de har fått brett genomslag i en mängd olika tillämpningar. Denna utveckling har dock ofta varit exklusiv, där de flesta LLM:er som utvecklats av resursstarka organisationer förblivit otillgängliga för allmänheten.
Denna exklusivitet väcker en viktig fråga: Tänk om det fanns ett sätt att demokratisera tillgången till dessa kraftfulla språkmodeller? Det är här BLOOM kommer in i bilden.
Den här artikeln ger en fullständig översikt av vad BLOOM är, genom att först ge mer detaljer om dess uppkomst. Därefter går den igenom BLOOM:s tekniska specifikationer och hur du använder den, innan den lyfter fram dess begränsningar och etiska överväganden.
BigScience Large Open-science Open-access Multilingual Language Model (förkortat BLOOM) utgör ett betydande framsteg i att demokratisera språkmodellteknik.
BLOOM utvecklades i samarbete av över 1200 deltagare från 39 länder, inklusive ett betydande antal från USA, och är resultatet av en global insats. Projektet koordinerades av BigScience i samarbete med Hugging Face och den franska NLP-gemenskapen och överskrider geografiska och institutionella gränser.
Det är en öppen källkodsmodell och en transformer med enbart avkodare med 176 miljarder parametrar, tränad på ROOTS-korpuset, vilket är en datamängd med hundratals källor på 59 språk: 46 talade språk och 13 programmeringsspråk.
Nedan visas ett cirkeldiagram över fördelningen av träningsspråken.
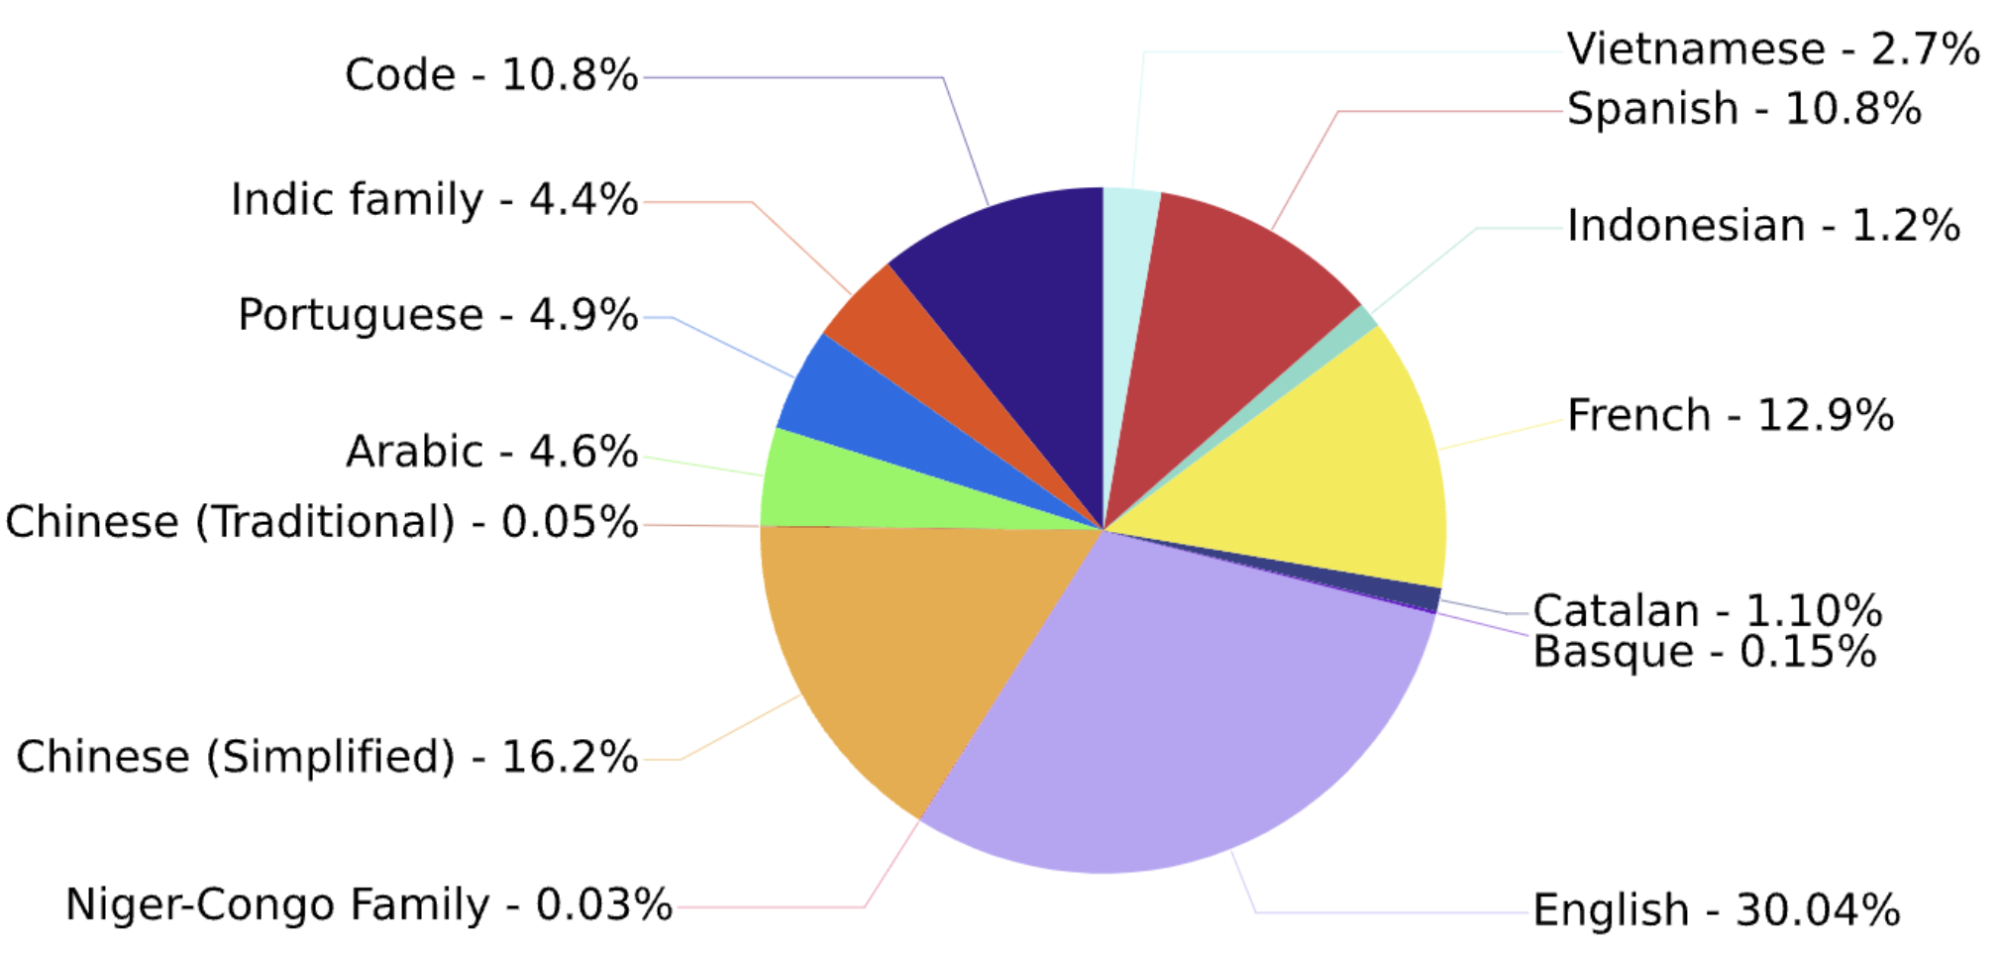
Fördelning av träningsspråken (källa)
Modellen uppnådde anmärkningsvärd prestanda på en mängd olika benchmarktester och nådde ännu bättre resultat efter multitask-baserad finjustering med promptar.
Projektet kulminerade i en 117 dagar lång (11 mars–6 juli) träningssession på superdatorn Jean Zay i Paris, möjliggjord av ett betydande beräkningsbidrag från de franska forskningsorganen CNRS och GENCI.
BLOOM står inte bara som ett teknologiskt underverk utan också som en symbol för internationellt samarbete och kraften i kollektiv vetenskaplig strävan.
Nu ska vi beskriva BLOOM:s arkitektur mer ingående, som består av flera komponenter.
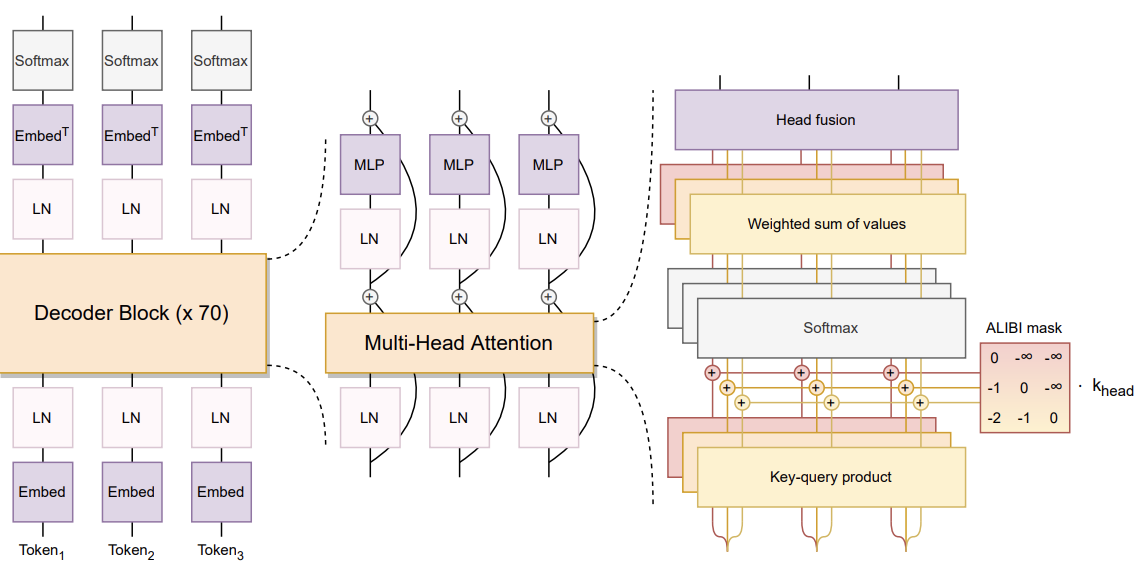
Bloom-arkitektur (källa)
Arkitekturen för BLOOM-modellen, som beskrivs i artikeln, inkluderar flera anmärkningsvärda aspekter:
Dessa komponenter speglar teamets fokus på att balansera innovation med beprövade tekniker för att optimera modellens prestanda och stabilitet.
Utöver BLOOM:s arkitekturkomponenter ska vi förstå två ytterligare relevanta komponenter: datapreprocessning och promptade datamängder.
I det här exemplet använder vi BLOOM för att generera en kreativ berättelse. Koden är strukturerad för att sätta upp miljön, förbereda modellen och generera text baserat på en given prompt. Motsvarande källkod finns på GitHub, och den är starkt inspirerad av amrrs handledning.
BLOOM-modellen är resurskrävande, därför är en korrekt konfiguration av arbetsytan avgörande, och huvudstegen beskrivs nedan.
Först används biblioteket transformer för att tillhandahålla gränssnitt för att arbeta med BLOOM-modellen, och andra transformerbaserade modeller i allmänhet.
!pip install transformers -qMed nvidia-smi kontrollerar vi egenskaperna hos tillgänglig GPU för att säkerställa att vi har nödvändiga beräkningsresurser för att köra modellen
!nvidia-smi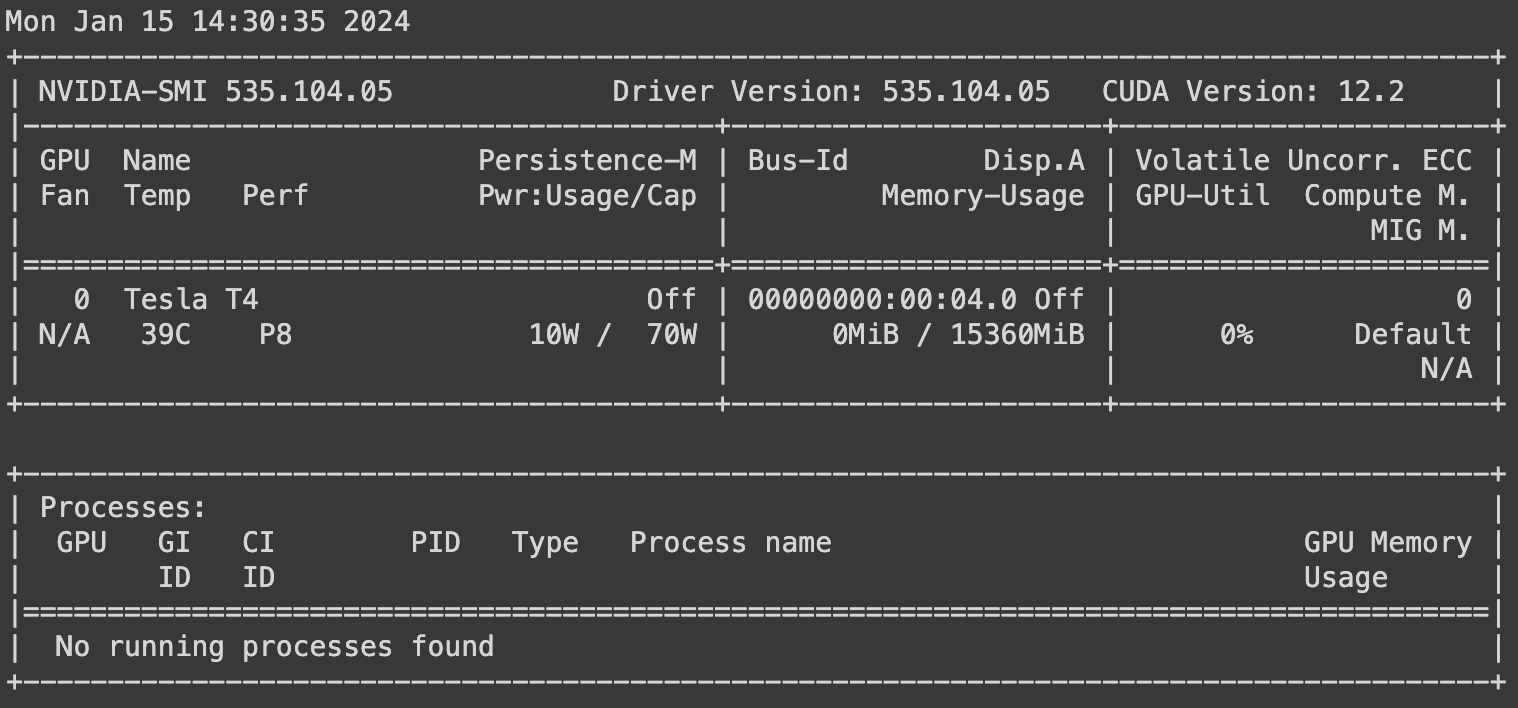
Vi importerar nödvändiga moduler från transformers och torch. torch används för att ställa in standardtyp för tensorer för att utnyttja GPU-acceleration.
Eftersom vi använder en GPU ställs sedan torch-biblioteket in med funktionen set_default_tensor_type för att säkerställa att GPU:n används.
from transformers import AutoModelForCausalLM, AutoTokenizer, set_seed
import torch
torch.set_default_tensor_type(torch.cuda.FloatTensor)Den målfasta modell som används är BLOOM-modellen med 7 miljarder parametrar, och den är tillgänglig från BigScience’s Hubbing Face-förråd under bigscience/bloom-1b7, vilket motsvarar modellens unika identifierare.
model_ID = "bigscience/bloom-1b7"Därefter laddar vi den förtränade BLOOM-modellen och dess tokenizer från Hugging Face, och sätter ett frö för reproducerbarhet med funktionen set_seed med valfritt tal. Själva talets värde spelar ingen roll, men det är viktigt att använda ett icke-flyttal.
För att lära dig mer om outnyttjad potential hos stora språkmodeller med LangChain, som är ett Python-ramverk med öppen källkod för att bygga avancerade AI-applikationer, är vår handledning How to Build LLM Applications with LangChain Tutorial rätt vägledning.
Om du dessutom är dataingenjör och intresserad av att använda LangChain för dataapplikationer ger vår artikel Introduction to LangChain for Data Engineering & Data Applications en översikt över vad du kan göra med LangChain, inklusive vilka problem LangChain löser och exempel på datadrivna användningsfall.
model = AutoModelForCausalLM.from_pretrained(model_ID, use_cache=True)
tokenizer = AutoTokenizer.from_pretrained(model_ID)
set_seed(2024)
Nu kan vi definiera titeln på berättelsen som ska genereras, tillsammans med prompten.
story_title = 'An Unexpected Journey Through Time'
prompt = f'This is a creative story about {story_title}.\n'
Slutligen tokeniserar vi prompten och mappar till rätt modellenhet innan vi genererar modellens resultat efter avkodning.
input_ids = tokenizer(prompt, return_tensors="pt").to(0)

sample = model.generate(**input_ids,
                        max_length=200, top_k=1,
                        temperature=0, repetition_penalty=2.0)

generated_story = tokenizer.decode(sample[0], skip_special_tokens=True)
Slutresultatet formateras med modulen textwrap, för att säkerställa att maxantalet tecken per rad är 80 för bättre läsbarhet.
import textwrap
wrapper = textwrap.TextWrapper(width=80)
formated_story = wrapper.fill(text=generated_story)
print(formated_story)Slutresultatet visas nedan:
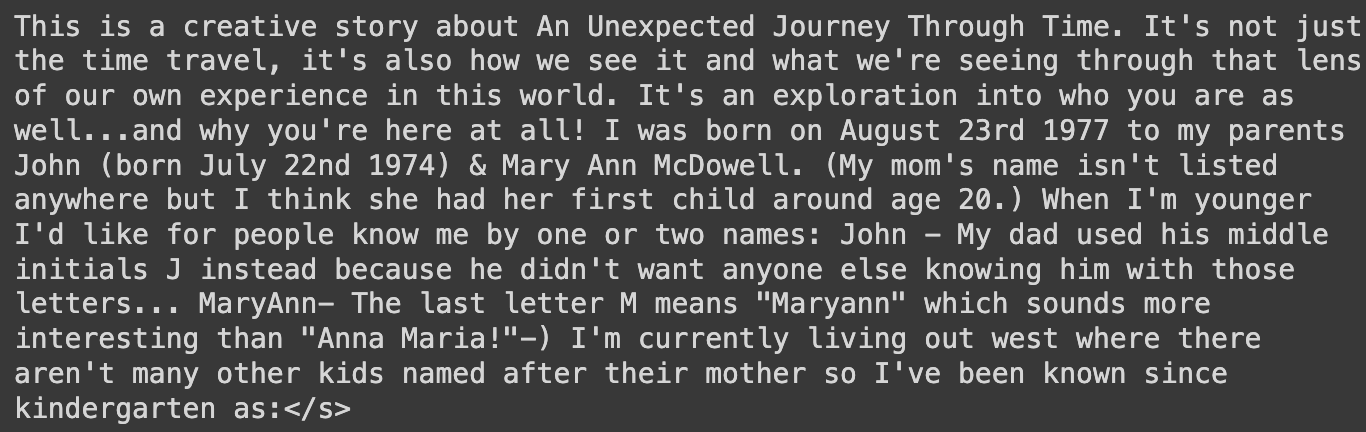
Berättelse genererad med BLOOM-modellen
Med några rader kod kunde vi generera meningsfullt innehåll med BLOOM-modellen.
Om du vill bemästra processen att träna stora språkmodeller med PyTorch, från initial setup till slutlig implementering, ger vår handledning How to Train an LLM with PyTorch en komplett guide för att nå det målet.
Liksom alla tekniska framsteg har BLOOM sina egna uppsättningar av lämpliga och olämpliga användningsområden. Det här avsnittet fördjupar sig i dess ändamålsenliga och olämpliga användningsfall och belyser var dess kapacitet bäst kan utnyttjas och var försiktighet rekommenderas. Att förstå dessa gränser är avgörande för att utnyttja BLOOM:s potential ansvarsfullt och effektivt.
BLOOM är ett mångsidigt verktyg utformat för att tänja på gränserna för språkbehandling och -generering. Dess avsedda användningar sträcker sig över flera domäner, där var och en drar nytta av dess omfattande språkkapacitet.
Att förstå BLOOM:s begränsningar är avgörande för att säkerställa etisk och praktisk tillämpning. Vissa användningsfall ligger utanför vad BLOOM-LLM är avsedd för, främst på grund av etiska överväganden eller tekniska begränsningar.
BLOOM, som en avancerad stor språkmodell (LLM), erbjuder en rad fördelar som sträcker sig över olika användargrupper. Dess förmågor påverkar inte bara vissa yrkesgrupper och sektorer direkt, utan har också en bredare effekt som indirekt påverkar en större krets av intressenter.
Den här genomgången av BLOOM:s användare syftar till att belysa hur olika grupper utnyttjar och påverkas av detta innovativa verktyg.
Genom att förstå BLOOM:s direkta och indirekta användare kan vi uppskatta modellens omfattande inflytande och de olika sätt på vilka den bidrar till att driva på utvecklingen av teknik och samhälle.
Införandet av BLOOM, liksom varje stor språkmodell (LLM), för med sig en rad etiska överväganden och begränsningar. Dessa aspekter är avgörande att förstå för ett ansvarsfullt användande och för att förutse teknikens bredare påverkan. Det här avsnittet behandlar de etiska implikationerna, riskerna och de inneboende begränsningarna med att använda BLOOM.
Utvecklingen och släppet av BLOOM har betydande implikationer i verkligheten, både vad gäller dess påverkan och de kontroverser den väcker. Det här avsnittet diskuterar dessa aspekter, förankrade i insikter från BLOOM:s forskningsartikel.
I den snabbrörliga världen av artificiell intelligens (AI) är relevansen för stora språkmodeller (LLM) som BLOOM ett ämne för pågående diskussion.
Utvecklad av ett stort team av internationella forskare var BLOOM ett betydande språng framåt inom språkbehandling. Men AI-landskapet utvecklas ständigt, med nya modeller som dyker upp och förändrar fokus.
Låt oss undersöka om BLOOM fortfarande hävdar sin position i detta konkurrensutsatta område.
Den här artikeln gav en översikt över BLOOM-projektet, ett betydande bidrag till det ständigt utvecklande området för stora språkmodeller.
Vi utforskade BLOOM:s utveckling och lyfte fram dess tekniska specifikationer och samarbetet bakom dess tillkomst. Artikeln fungerade också som en guide för att få tillgång till och effektivt utnyttja BLOOM, med betoning på dess lämpliga användningar och begränsningar.
Dessutom behandlade den de etiska implikationerna och den verkliga påverkan av BLOOM AI-projektet, med reflektioner över dess mottagande och relevans i dagens AI-landskap. Oavsett om du arbetar direkt med AI eller är entusiast ger denna genomgång av BLOOM viktiga perspektiv för att navigera i den komplexa världen av stora språkmodeller.
För dig som vill fördjupa engagemanget i avancerade språkmodeller erbjuder vår ytterligare kurs, Large Language Models (LLMs) Concepts, en väg att upptäcka LLM:ers fulla potential med vår konceptuella kurs som täcker LLM-tillämpningar, träningsmetoder, etiska överväganden och den senaste forskningen.
Starta din AI-resa i dag!
course
course
course