
Kurs
Konzeptuelle Einführung in generative KI
2 Std.
117.2K
Der Aufstieg großer Sprachmodelle (LLMs) ist ein prägender Trend im Bereich der Natural Language Processing (NLP) und hat zu einem breiten Einsatz in unterschiedlichsten Anwendungen geführt. Diese Entwicklung war jedoch oft exklusiv: Viele von ressourcenstarken Organisationen entwickelte LLMs bleiben der Allgemeinheit verwehrt.
Diese Exklusivität wirft eine zentrale Frage auf: Was wäre, wenn sich der Zugang zu diesen leistungsstarken Sprachmodellen demokratisieren ließe? Genau hier kommt BLOOM ins Spiel.
Dieser Artikel bietet einen vollständigen Überblick darüber, was BLOOM ist: Zunächst gehen wir auf die Entstehung ein, anschließend auf die technischen Spezifikationen und die Nutzung in der Praxis – gefolgt von den Grenzen des Modells und ethischen Überlegungen.
BigScience Large Open-science Open-access Multilingual Language Model (kurz BLOOM) steht für einen bedeutenden Schritt hin zu einer demokratisierten Sprachmodell-Technologie.
Gemeinsam entwickelt von über 1.200 Teilnehmenden aus 39 Ländern – darunter viele aus den USA – ist BLOOM das Ergebnis einer weltweiten Kollaboration. Koordiniert wurde das Projekt von BigScience in Zusammenarbeit mit Hugging Face und der französischen NLP-Community und überschreitet geografische wie institutionelle Grenzen.
Es handelt sich um ein Open-Source-Transformer-Modell im Decoder-Only-Design mit 176 Milliarden Parametern, trainiert auf dem ROOTS-Korpus – einem Datensatz aus Hunderten Quellen in 59 Sprachen: 46 gesprochene Sprachen und 13 Programmiersprachen.
Unten siehst du ein Kreisdiagramm zur Verteilung der Trainingssprachen.
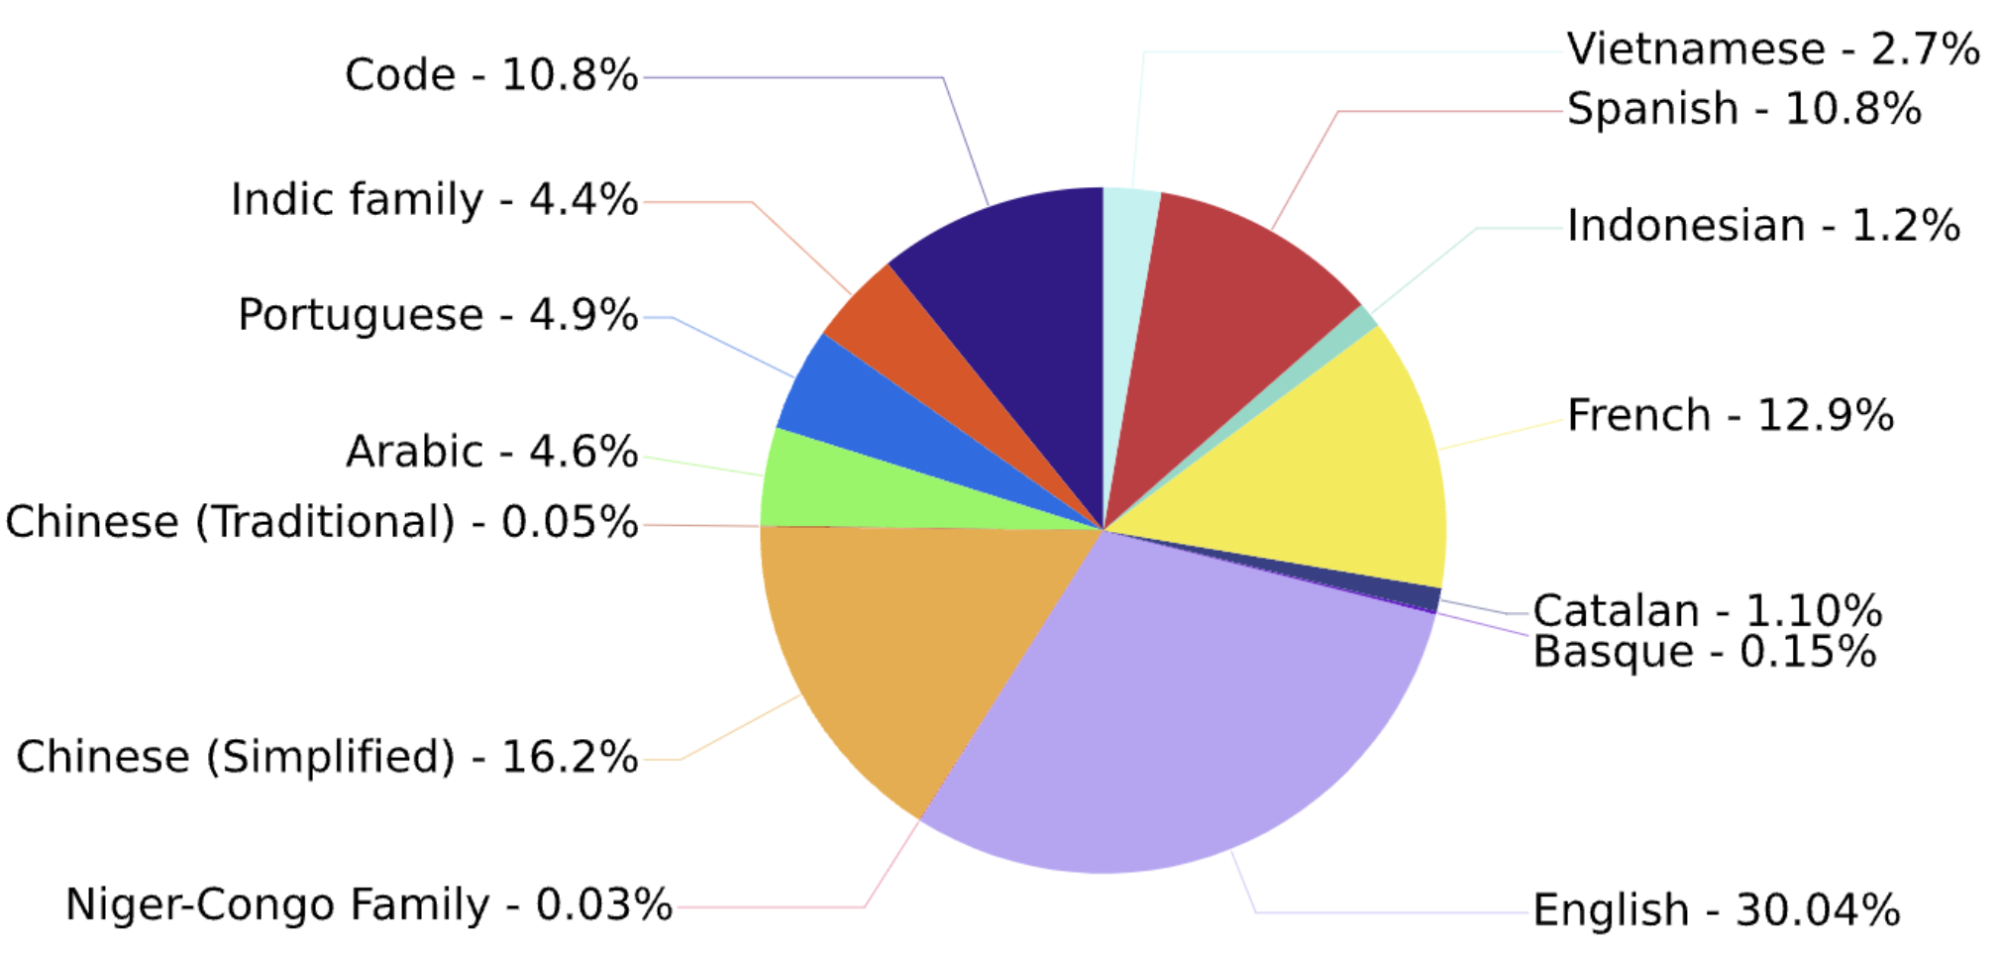
Verteilung der Trainingssprachen (Quelle)
Das Modell zeigte in einer Vielzahl von Benchmarks bemerkenswerte Leistungen und erzielte nach Multitask-Prompt-Finetuning nochmals bessere Ergebnisse.
Das Projekt gipfelte in einer 117-tägigen Trainingsphase (11. März – 6. Juli) auf dem Jean-Zay-Supercomputer in Paris, unterstützt durch einen umfangreichen Compute-Zuschuss der französischen Forschungsagenturen CNRS und GENCI.
BLOOM ist damit nicht nur ein technologisches Meisterstück, sondern auch ein Symbol für internationale Zusammenarbeit und die Kraft gemeinschaftlicher Forschung.
Schauen wir uns nun BLOOMs Architektur im Detail an – sie setzt sich aus mehreren Komponenten zusammen.
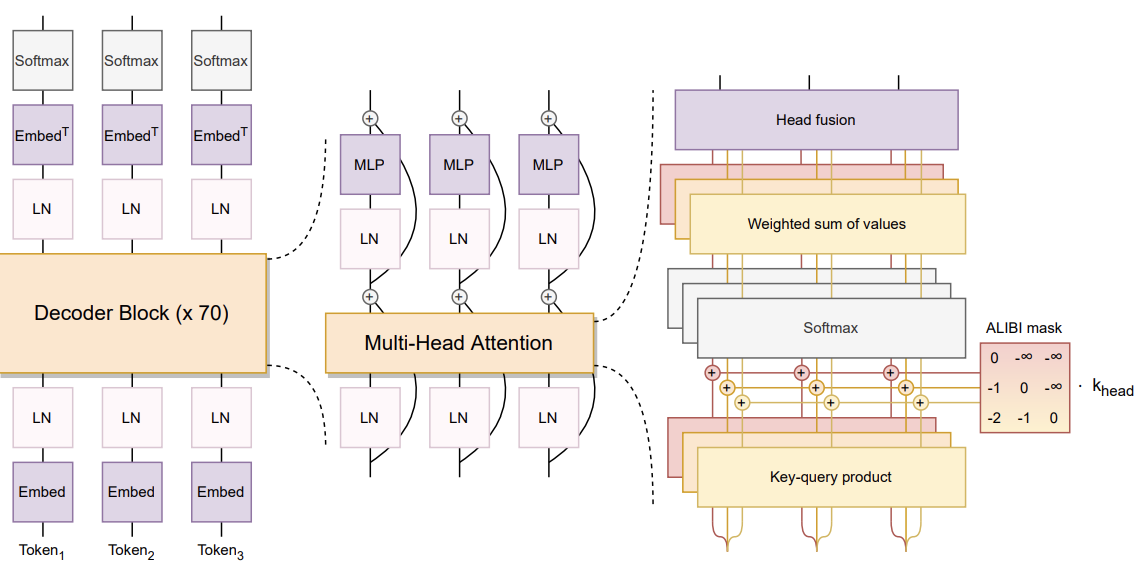
Bloom-Architektur (Quelle)
Die Architektur des BLOOM-Modells umfasst laut Paper mehrere besonders erwähnenswerte Aspekte:
Diese Bausteine zeigen, wie das Team Innovation mit bewährten Techniken ausbalanciert hat, um Leistung und Stabilität zu maximieren.
Zusätzlich zur Architektur von BLOOM betrachten wir zwei weitere relevante Bereiche: Datenvorverarbeitung und Prompt-basierte Datensätze.
Im folgenden Beispiel erzeugen wir mit BLOOM eine kreative Geschichte. Der Code richtet die Umgebung ein, lädt das Modell und generiert Text auf Basis eines Prompts. Der vollständige Code steht auf GitHub bereit und ist stark vom Tutorial von amrrs inspiriert.
Das BLOOM-Modell ist ressourcenintensiv, daher ist eine saubere Einrichtung der Umgebung entscheidend. Die wichtigsten Schritte findest du unten.
Zuerst nutzen wir die Bibliothek transformers, die Schnittstellen für BLOOM und andere Transformer-Modelle bereitstellt.
!pip install transformers -qMit nvidia-smi prüfen wir anschließend die Eigenschaften der verfügbaren GPU, um sicherzustellen, dass genügend Rechenressourcen vorhanden sind.
!nvidia-smi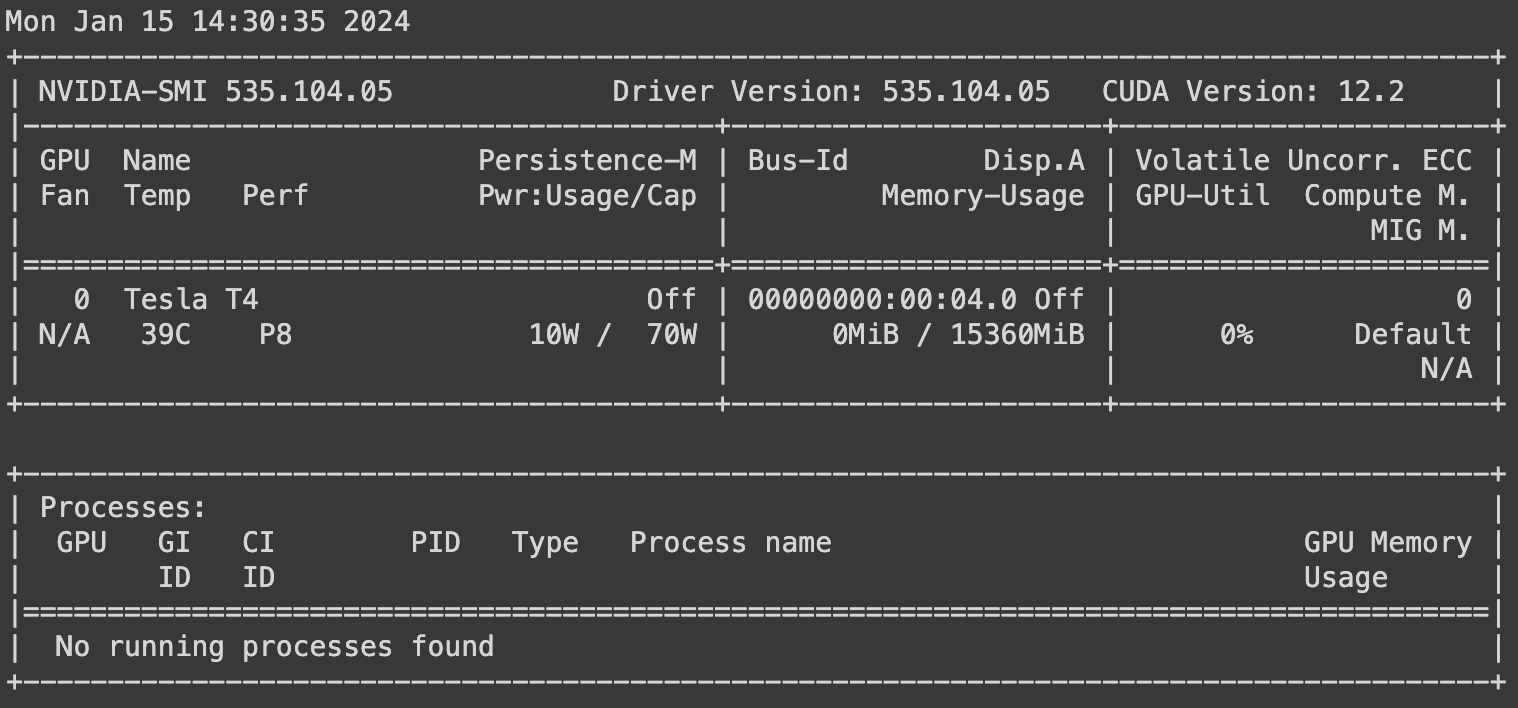
Wir importieren die benötigten Module aus transformers und torch. Torch dient dazu, den Standard-Tensortyp zu setzen und so die GPU zu nutzen.
Da wir eine GPU verwenden, konfigurieren wir torch über die Funktion set_default_tensor_type, damit die GPU tatsächlich zum Einsatz kommt.
from transformers import AutoModelForCausalLM, AutoTokenizer, set_seed
import torch
torch.set_default_tensor_type(torch.cuda.FloatTensor)In diesem Beispiel nutzen wir das BLOOM-Modell mit 7 Milliarden Parametern. Es ist im Hugging-Face-Repository von BigScience unter bigscience/bloom-1b7 verfügbar – das ist die eindeutige Modell-ID.
model_ID = "bigscience/bloom-1b7"Als Nächstes laden wir das vortrainierte BLOOM-Modell und den Tokenizer von Hugging Face und setzen den Seed für Reproduzierbarkeit mit set_seed auf eine beliebige ganze Zahl.
Wenn du mehr über das Potenzial von Large Language Models mit LangChain erfahren willst – einem Open-Source-Python-Framework für fortgeschrittene KI-Anwendungen –, ist unser Tutorial How to Build LLM Applications with LangChain Tutorial der richtige Einstieg.
Interessierst du dich als Data Engineer für den Einsatz von LangChain in Datenanwendungen, liefert dir unser Artikel Introduction to LangChain for Data Engineering & Data Applications einen Überblick über Einsatzfelder, gelöste Probleme und konkrete Daten-Use-Cases.
model = AutoModelForCausalLM.from_pretrained(model_ID, use_cache=True)
tokenizer = AutoTokenizer.from_pretrained(model_ID)
set_seed(2024)
Nun definieren wir den Titel der zu generierenden Geschichte sowie den Prompt.
story_title = 'An Unexpected Journey Through Time'
prompt = f'This is a creative story about {story_title}.\n'
Zum Schluss tokenisieren wir den Prompt, mappen ihn auf das passende Device und generieren dann die Ausgabe des Modells, die wir anschließend decodieren.
input_ids = tokenizer(prompt, return_tensors="pt").to(0)

sample = model.generate(**input_ids,
                        max_length=200, top_k=1,
                        temperature=0, repetition_penalty=2.0)

generated_story = tokenizer.decode(sample[0], skip_special_tokens=True)
Das finale Ergebnis formatieren wir mit dem Modul textwrap, damit maximal 80 Zeichen pro Zeile für bessere Lesbarkeit verwendet werden.
import textwrap
wrapper = textwrap.TextWrapper(width=80)
formated_story = wrapper.fill(text=generated_story)
print(formated_story)Das Ergebnis sieht so aus:
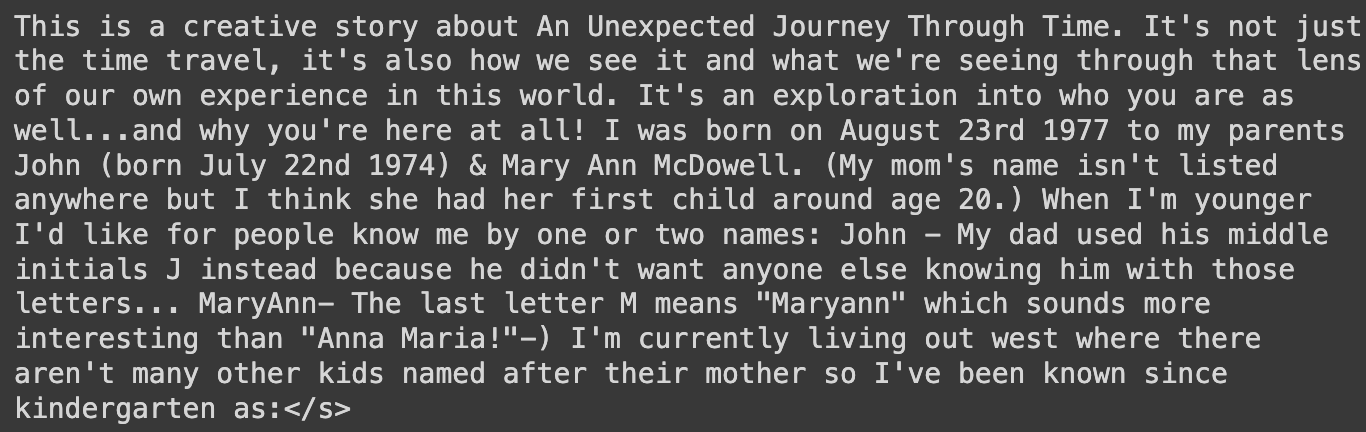
Mit BLOOM generierte Geschichte
Mit wenigen Zeilen Code konnten wir mit BLOOM sinnvollen Inhalt erzeugen.
Wenn du den Trainingsprozess großer Sprachmodelle mit PyTorch – von Setup bis Umsetzung – meistern möchtest, führt dich unser Tutorial How to Train an LLM with PyTorch Schritt für Schritt ans Ziel.
Wie jede Technologie hat auch BLOOM passende und unpassende Einsatzszenarien. In diesem Abschnitt zeigen wir, wo BLOOM seine Stärken ausspielt – und wo Vorsicht geboten ist. Diese Grenzen zu kennen, ist entscheidend, um BLOOM verantwortungsvoll und wirkungsvoll zu nutzen.
BLOOM ist ein vielseitiges Werkzeug, das die Grenzen der Sprachverarbeitung und -generierung erweitert. Die vorgesehenen Einsatzfelder reichen über viele Domänen und nutzen die breite Sprachkompetenz des Modells.
Die Grenzen von BLOOM zu kennen, ist wichtig für eine ethische und praktikable Nutzung. Einige Use Cases liegen außerhalb des vorgesehenen Rahmens – aus ethischen Gründen oder wegen technischer Beschränkungen.
Als fortgeschrittenes Large Language Model (LLM) bietet BLOOM vielfältigen Gruppen Mehrwert. Seine Fähigkeiten wirken direkt auf bestimmte Berufsrollen und Branchen – und indirekt auf ein breiteres Umfeld von Stakeholdern.
Dieser Überblick zeigt, wie unterschiedliche Gruppen BLOOM nutzen und davon beeinflusst werden.
Indem wir direkte und indirekte Nutzende betrachten, wird der große Wirkungskreis von BLOOM deutlich – und die vielen Wege, wie das Modell Technologie und Gesellschaft voranbringt.
Wie jedes Large Language Model (LLM) bringt auch BLOOM ethische Fragestellungen und Einschränkungen mit sich. Sie sind entscheidend für verantwortungsvolle Nutzung und für das Verständnis der breiteren Auswirkungen. Dieser Abschnitt beleuchtet ethische Implikationen, Risiken und inhärente Grenzen.
Die Entwicklung und Veröffentlichung von BLOOM hat spürbare reale Auswirkungen – und wirft kontroverse Fragen auf. Dieser Abschnitt ordnet beides ein, basierend auf den Erkenntnissen aus dem BLOOM-Paper.
In der schnelllebigen Welt der Künstlichen Intelligenz (KI) wird die Relevanz von LLMs wie BLOOM fortlaufend diskutiert.
BLOOM, entwickelt von einem großen internationalen Team, war ein bedeutender Sprung nach vorn in der Sprachverarbeitung. Doch das KI-Feld entwickelt sich rasant weiter – neue Modelle erscheinen und verschieben den Fokus.
Schauen wir, ob BLOOM in diesem Wettbewerbsumfeld weiterhin besteht.
Dieser Artikel gab einen Überblick über das BLOOM-Projekt – einen wichtigen Beitrag im sich rasant entwickelnden Feld der Large Language Models.
Wir haben die Entstehung und die technischen Eckpunkte beleuchtet sowie die Zusammenarbeit hinter dem Projekt. Zudem diente der Artikel als Leitfaden für Zugang und effektive Nutzung und zeigte passende Einsatzfelder und Grenzen auf.
Darüber hinaus haben wir die ethischen Implikationen und die reale Wirkung des BLOOM-KI-Projekts betrachtet und seine Rolle in der heutigen KI-Landschaft eingeordnet. Ob du direkt mit KI arbeitest oder dich einfach dafür begeisterst – dieser Blick auf BLOOM liefert dir wichtige Perspektiven für den Umgang mit großen Sprachmodellen.
Wenn du tiefer in fortgeschrittene Sprachmodelle einsteigen willst, zeigt dir unser Kurs Large Language Models (LLMs) Concepts, wie du das volle Potenzial von LLMs ausschöpfst – mit Anwendungsfällen, Trainingsmethoden, ethischen Aspekten und Einblicken in aktuelle Forschung.
Starte noch heute deine KI-Reise!
Kurs
Kurs
Kurs
Blog
Blog
Hesam Sheikh Hassani
15 Min.
Blog
Nisha Arya Ahmed
15 Min.
Tutorial
Javier Canales Luna
11 Min.
Tutorial
Matt Crabtree
5 Min.
Tutorial
Laiba Siddiqui
6 Min.






