Ir al contenido principal

Explorando BLOOM: guía completa del gran modelo lingüístico multilingüe

Descubre BLOOM, un gran modelo lingüístico multilingüe: su creación, especificaciones técnicas, uso y aspectos éticos para democratizar la IA.
Actualizado 31 ago 2026  · 13 min leer

Explorar con IA

ChatGPTClaudePerplexity

El auge de los grandes modelos lingüísticos (LLM) ha marcado un antes y un después en el procesamiento del lenguaje natural (NLP), impulsando su adopción en multitud de aplicaciones. Sin embargo, este avance ha sido a menudo exclusivo: la mayoría de LLM desarrollados por organizaciones con grandes recursos siguen siendo inaccesibles para el público.

Esta exclusividad plantea una cuestión clave: ¿y si hubiera una forma de democratizar el acceso a estos potentes modelos de lenguaje? Ahí es donde entra en juego BLOOM.

Este artículo ofrece una visión completa de qué es BLOOM, empezando por su origen. Después, repasamos sus especificaciones técnicas y cómo usarlo, para terminar con sus limitaciones y consideraciones éticas.

¿Qué es BLOOM?

BigScience Large Open-science Open-access Multilingual Language Model (BLOOM, por sus siglas en inglés) supone un gran paso adelante para democratizar la tecnología de modelos de lenguaje.

Desarrollado de forma colaborativa por más de 1200 participantes de 39 países, con una presencia destacada de Estados Unidos, BLOOM es el resultado de un esfuerzo global. Coordinado por BigScience en colaboración con Hugging Face y la comunidad francesa de NLP, el proyecto trasciende fronteras geográficas e institucionales.

Es un modelo open source y un transformer solo decodificador con 176.000 millones de parámetros entrenado sobre el corpus ROOTS, un conjunto de datos con cientos de fuentes en 59 lenguas: 46 lenguas habladas y 13 lenguajes de programación.

A continuación, el gráfico circular con la distribución de los idiomas de entrenamiento.
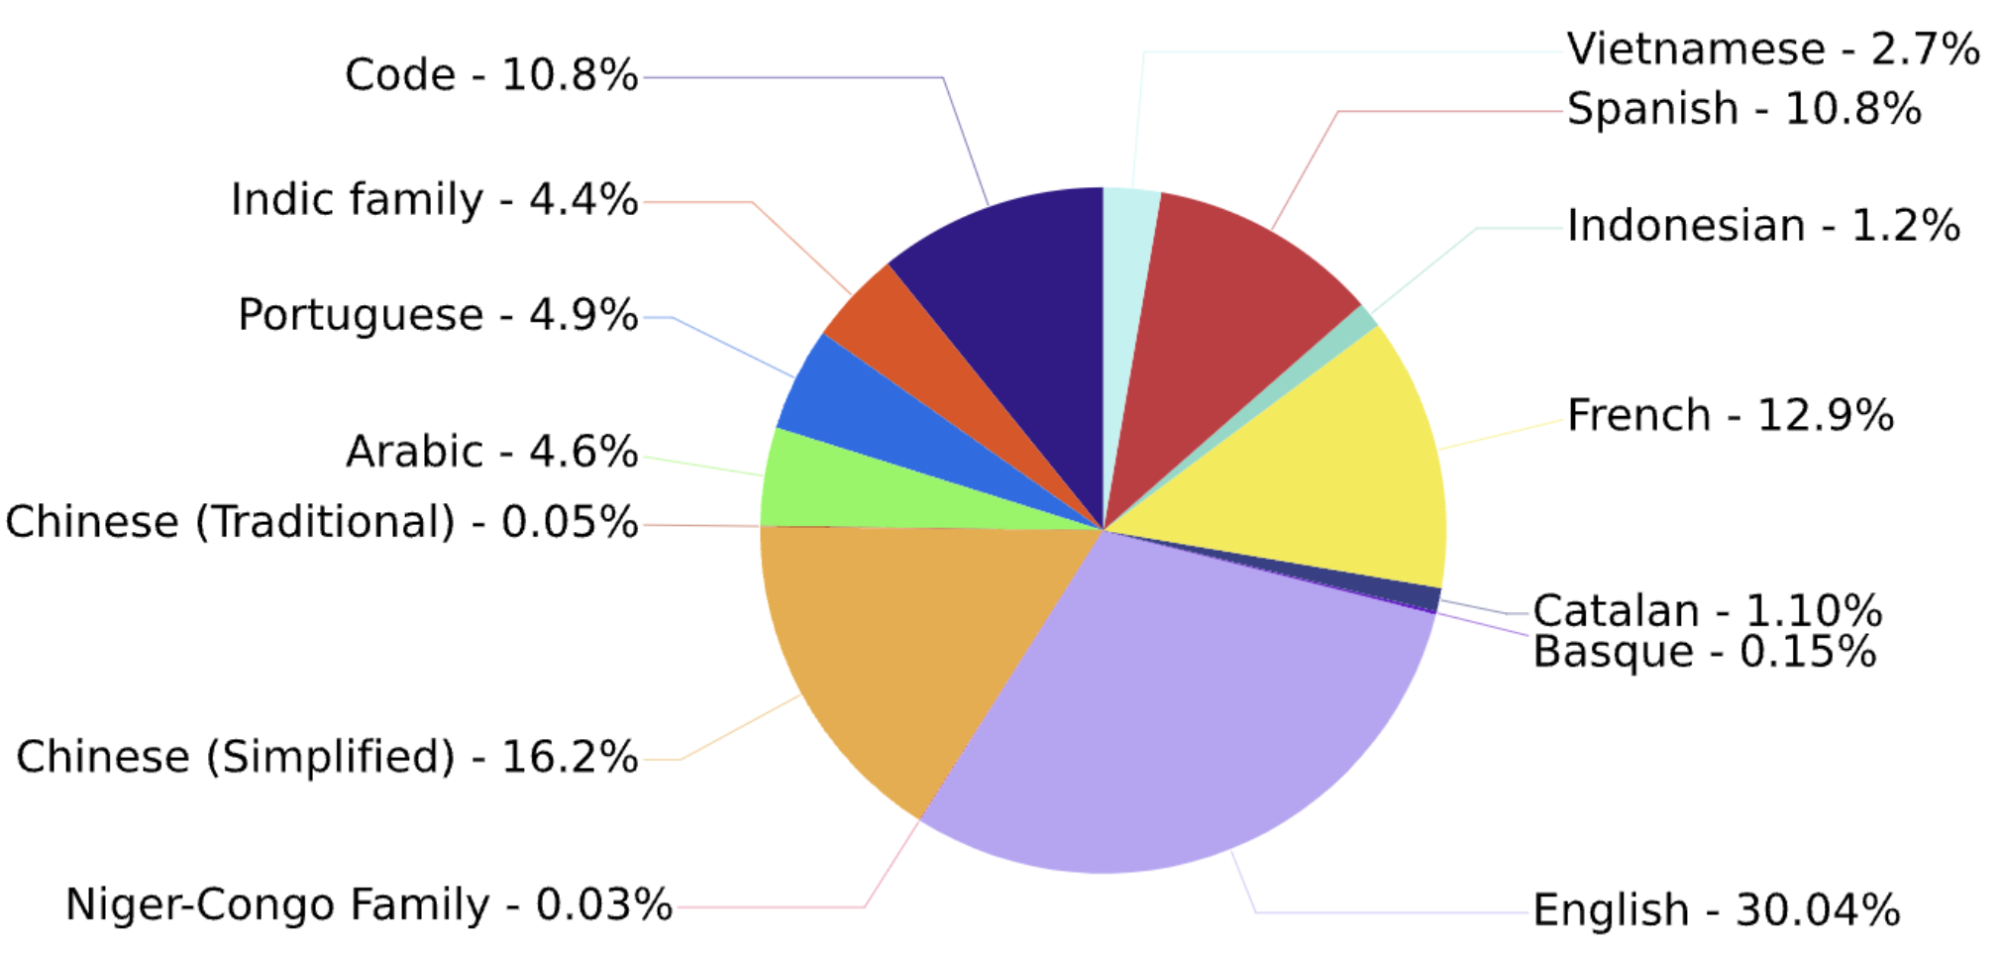
Distribución de los idiomas de entrenamiento

Distribución de los idiomas de entrenamiento (fuente)

El modelo demostró un rendimiento notable en una amplia variedad de benchmarks, y mejoró aún más tras el ajuste fino multitarea con prompts.

El proyecto culminó en 117 días de entrenamiento (del 11 de marzo al 6 de julio) en el superordenador Jean Zay, en París, gracias a una importante concesión de cómputo de los organismos de investigación franceses CNRS y GENCI.

BLOOM no solo es una proeza tecnológica: también simboliza la cooperación internacional y el poder de la ciencia en colaboración.

Arquitectura del modelo BLOOM

Veamos ahora la arquitectura de BLOOM con más detalle, que comprende varios componentes.
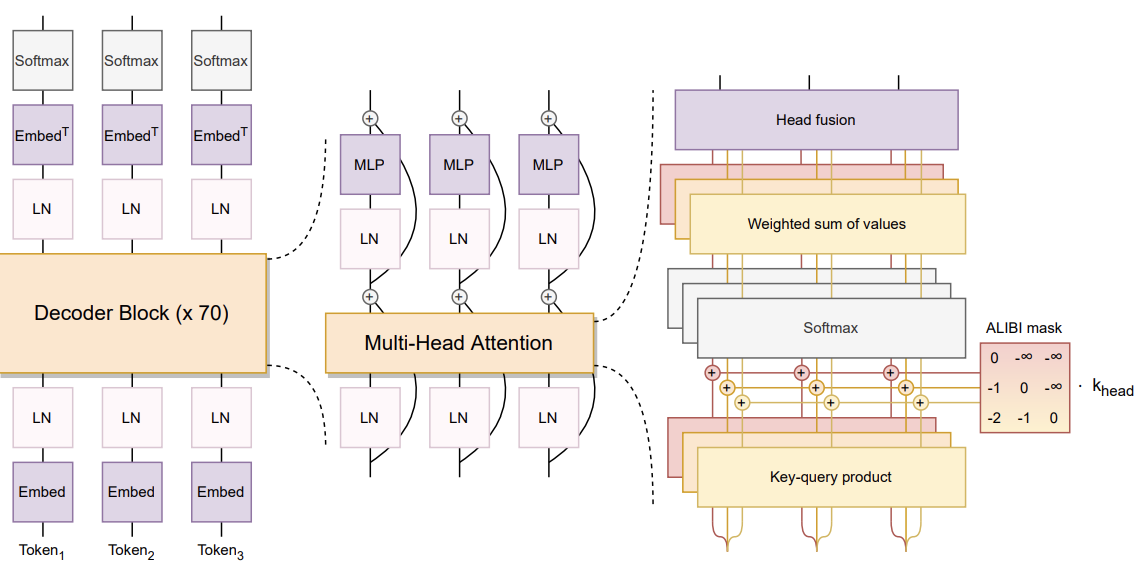
Arquitectura de BLOOM

Arquitectura de BLOOM (fuente)

La arquitectura de BLOOM, según se detalla en el paper, incluye varios aspectos reseñables:

  • Metodología de diseño: El equipo se centró en familias de modelos escalables con soporte en herramientas y bases de código públicas, y llevó a cabo experimentos de ablación en modelos más pequeños para optimizar componentes e hiperparámetros. La generalización zero-shot fue una métrica clave para evaluar las decisiones arquitectónicas.
  • Arquitectura y objetivo de preentrenamiento: BLOOM se basa en la arquitectura Transformer, concretamente en un modelo causal solo decodificador. Esta aproximación se validó como la más eficaz para capacidades de generalización zero-shot frente a arquitecturas encoder-decoder y otras solo decodificador.
  • Detalles de modelado:
    • Embeddings posicionales ALiBi: Se eligió ALiBi frente a los embeddings posicionales tradicionales, ya que atenúa directamente las puntuaciones de atención según la distancia entre keys y queries. Esto dio lugar a un entrenamiento más suave y mejor rendimiento.
    • LayerNorm tras el embedding: Se añadió una normalización de capa inmediatamente después de la capa de embedding, lo que mejoró la estabilidad del entrenamiento. Esta decisión estuvo influida en parte por el uso de bfloat16 en el entrenamiento final, más estable que float16.

Estos componentes reflejan el foco del equipo por equilibrar innovación con técnicas contrastadas para optimizar el rendimiento y la estabilidad del modelo.

Además de la arquitectura de BLOOM, conviene entender dos elementos adicionales: el preprocesado de datos y los conjuntos de datos con prompts.

  • Preprocesado de datos: Incluyó pasos clave como la desduplicación y el anonimizado, especialmente para fuentes con mayor riesgo de privacidad.
  • Datasets con prompts: BLOOM emplea ajuste fino multitarea con prompts, que ha mostrado una gran capacidad de generalización zero-shot.

Cómo usar BLOOM

En este ejemplo, usaremos BLOOM para generar un relato creativo. El código prepara el entorno, carga el modelo y genera texto a partir de un prompt. El código fuente correspondiente está disponible en GitHub y está muy inspirado en el tutorial de amrrs.

Configurar el entorno de trabajo

BLOOM consume muchos recursos, por lo que es clave configurar bien el entorno. A continuación, los pasos principales.

Primero, la librería transformers proporciona las interfaces para trabajar con BLOOM y con otros modelos basados en transformers en general.

!pip install transformers -q

Con nvidia-smi comprobamos las propiedades de la GPU disponible para asegurarnos de que contamos con los recursos necesarios para ejecutar el modelo.

!nvidia-smi
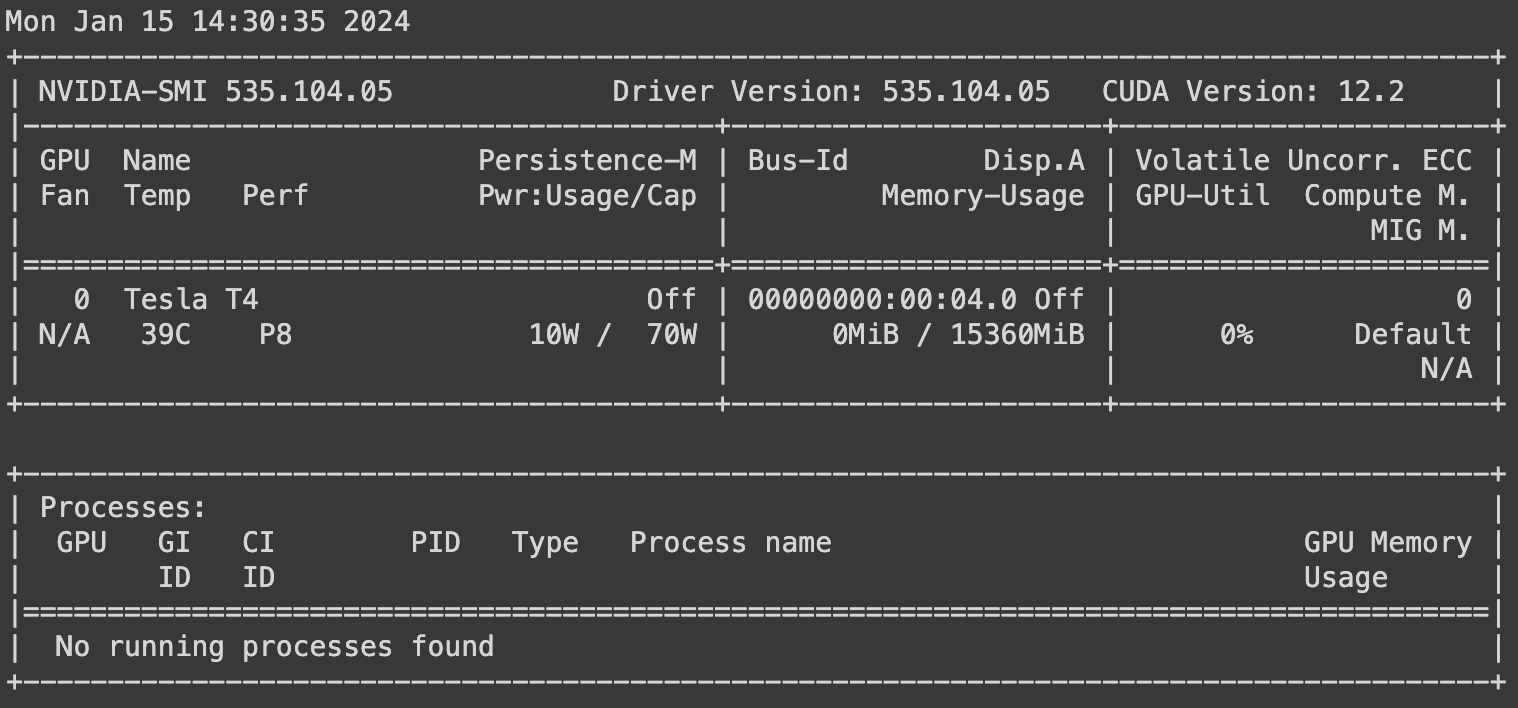
Propiedades de la GPU

Importamos los módulos necesarios de transformers y torch. Usamos torch para establecer el tipo de tensor por defecto y así aprovechar la aceleración por GPU.

Dado que usamos una GPU, configuramos la librería torch con la función set_default_tensor_type para garantizar su uso.

from transformers import AutoModelForCausalLM, AutoTokenizer, set_seed
import torch
torch.set_default_tensor_type(torch.cuda.FloatTensor)

Usar el modelo BLOOM

El modelo objetivo en este ejemplo es BLOOM de 7.000 millones de parámetros, accesible desde el repositorio de Hugging Face de BigScience bajo bigscience/bloom-1b7, que es el identificador único del modelo.

model_ID = "bigscience/bloom-1b7"

A continuación, cargamos el modelo BLOOM preentrenado y su tokenizer desde Hugging Face, y fijamos la semilla para la reproducibilidad con la función set_seed usando cualquier número entero. El valor en sí no importa, pero conviene que no sea un número en coma flotante.

Si quieres descubrir el potencial aún por explotar de los LLM con LangChain, un framework open source de Python para crear aplicaciones de IA avanzadas, nuestro tutorial How to Build LLM Applications with LangChain Tutorial es la guía perfecta.

Además, si eres data engineer y te interesa usar LangChain para aplicaciones de datos, nuestro artículo Introduction to LangChain for Data Engineering & Data Applications ofrece una vista general de lo que puedes hacer con LangChain, incluidos los problemas que resuelve y ejemplos de casos de uso en datos.

model = AutoModelForCausalLM.from_pretrained(model_ID, use_cache=True) 
tokenizer = AutoTokenizer.from_pretrained(model_ID)
set_seed(2024)

Ahora definimos el título del relato a generar, junto con el prompt.

story_title = 'An Unexpected Journey Through Time' 
prompt = f'This is a creative story about {story_title}.\n'

Por último, tokenizamos el prompt y lo asignamos al dispositivo del modelo antes de generar el resultado y decodificarlo.

input_ids = tokenizer(prompt, return_tensors="pt").to(0)

sample = model.generate(**input_ids, 
                        max_length=200, top_k=1, 
                        temperature=0, repetition_penalty=2.0)

generated_story = tokenizer.decode(sample[0], skip_special_tokens=True)

El resultado final se formatea con el módulo textwrap para asegurar un máximo de 80 caracteres por línea y mejorar la legibilidad.

import textwrap  
wrapper = textwrap.TextWrapper(width=80)
formated_story = wrapper.fill(text=generated_story)
print(formated_story)

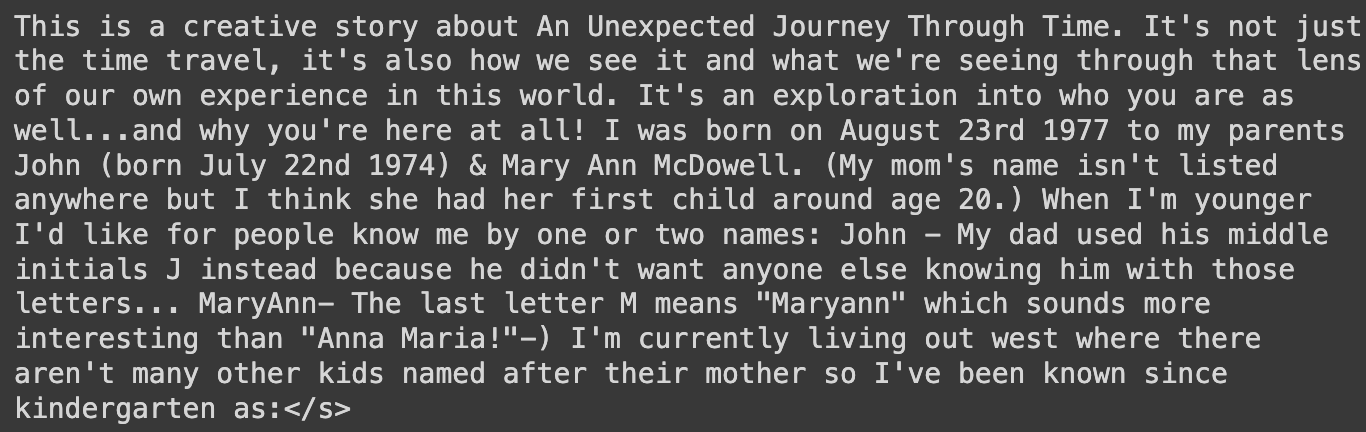
El resultado final es el siguiente:

image2.png

Relato generado con el modelo BLOOM

Con unas pocas líneas de código, hemos podido generar contenido con sentido usando BLOOM.

Si te interesa dominar el proceso de entrenamiento de LLM con PyTorch, desde la configuración inicial hasta la implementación final, nuestro tutorial How to Train an LLM with PyTorch te ofrece una guía completa para conseguirlo.

Usos previstos y no recomendados

Como cualquier avance tecnológico, BLOOM tiene aplicaciones adecuadas y otras que no lo son. En esta sección repasamos los casos de uso apropiados e inapropiados, destacando dónde puede aprovecharse mejor su capacidad y dónde conviene extremar la precaución. Entender estos límites es clave para aprovechar BLOOM de forma responsable y eficaz.

Usos previstos de BLOOM

BLOOM es una herramienta versátil diseñada para llevar más lejos el procesamiento y la generación de lenguaje. Sus usos previstos abarcan varios ámbitos, aprovechando su amplia competencia lingüística.

  • Generación de contenido multilingüe: Con dominio de 59 idiomas, BLOOM destaca creando contenido diverso e inclusivo. Esto resulta especialmente valioso en comunicación global, educación y medios, donde la inclusividad lingüística es crucial.
  • Programación y desarrollo de software: Su entrenamiento en lenguajes de programación lo convierte en un aliado en desarrollo: puede ayudar a generar código, depurar y servir como herramienta didáctica para quienes empiezan.
  • Investigación y academia: En entornos académicos, BLOOM es un recurso potente para análisis lingüístico e investigación en IA, aportando información sobre patrones del lenguaje, comportamiento de la IA y más.

Usos fuera de alcance de BLOOM

Comprender las limitaciones de BLOOM es esencial para garantizar su aplicación ética y práctica. Algunos casos quedan fuera de lo previsto para el LLM BLOOM, principalmente por consideraciones éticas o limitaciones técnicas.

  • Tratamiento de datos sensibles: BLOOM no está diseñado para procesar datos personales sensibles ni información confidencial. El riesgo potencial para la privacidad lo hace inadecuado para estos fines.
  • Toma de decisiones de alto impacto: usar BLOOM en escenarios que requieren precisión crítica, como diagnósticos médicos o decisiones legales, no es recomendable. Sus limitaciones, comunes a muchos LLM, pueden conducir a resultados inexactos o engañosos en áreas sensibles.
  • Sustitución de la interacción humana: BLOOM no debe verse como un reemplazo de la interacción humana, especialmente en ámbitos que requieren inteligencia emocional, como la orientación psicológica, la diplomacia o la docencia personalizada. Carece del entendimiento matizado y la empatía que aporta una persona.

Usuarios directos e indirectos

BLOOM, como LLM avanzado, ofrece una amplia gama de beneficios para distintos grupos de usuarios. Sus capacidades influyen directamente en ciertos perfiles y sectores, y también tienen un efecto más amplio que impacta de forma indirecta a otras partes interesadas.

Este repaso a los usuarios de BLOOM busca mostrar cómo distintos colectivos aprovechan y se ven afectados por esta herramienta innovadora.

Al entender quiénes son los usuarios directos e indirectos de BLOOM, podemos apreciar su influencia y las múltiples formas en que contribuye al avance de la tecnología y la sociedad.

Usuarios directos de BLOOM

  • Desarrolladores y data scientists: Profesionales del desarrollo de software y la ciencia de datos son usuarios principales. Utilizan BLOOM para asistencia en código, depuración y análisis de datos.
  • Investigadores y académicos: Incluye lingüistas, investigadores en IA y personal académico que emplea BLOOM para estudios del lenguaje, análisis de comportamiento de la IA y para avanzar la investigación en NLP.
  • Creadores de contenido y traductores: Escritores, periodistas y traductores usan BLOOM para generar y traducir contenido en distintos idiomas, ampliando su productividad y alcance.

Usuarios indirectos de BLOOM

  • Empresas y organizaciones: Compañías de diversos sectores se benefician indirectamente de BLOOM mediante servicios mejorados con IA, mejor interacción con clientes y un manejo de datos más eficiente.
  • Instituciones educativas: Estudiantes y docentes se benefician de forma indirecta a través de herramientas y recursos educativos que incorporan sus capacidades de procesamiento del lenguaje para el aprendizaje y la enseñanza.
  • Público general: La ciudadanía en general se beneficia indirectamente gracias a mejores experiencias tecnológicas, acceso a contenido multilingüe y aplicaciones de software más capaces.

Consideraciones éticas y limitaciones

La puesta en producción de BLOOM, como cualquier LLM, conlleva consideraciones éticas y limitaciones. Entenderlas es crucial para un uso responsable y para anticipar su impacto. Esta sección aborda implicaciones éticas, riesgos y limitaciones inherentes al uso de BLOOM.

Consideraciones éticas

  • Sesgos y equidad: Una de las principales preocupaciones es que BLOOM pueda perpetuar o amplificar sesgos presentes en sus datos de entrenamiento. Esto afecta a la imparcialidad de sus salidas, generando retos éticos en escenarios donde la neutralidad es crítica.
  • Privacidad: Aunque BLOOM no está diseñado explícitamente para manejar información personal sensible, la magnitud de sus datos de entrenamiento podría incluirla de forma inadvertida. Existe riesgo de violaciones de privacidad si genera salidas que revelen datos sensibles.

Riesgos asociados al uso

  • Desinformación y manipulación: Las capacidades avanzadas de BLOOM pueden malutilizarse para generar información engañosa o contenido manipulador, con riesgos relevantes en medios, política y opinión pública.
  • Dependencia y pérdida de competencias: Una dependencia excesiva de BLOOM para tareas como redacción o traducción puede degradar estas habilidades en humanos, afectando a la creatividad y a las competencias lingüísticas.

Limitaciones de BLOOM

  • Comprensión contextual: Pese a su sofisticación, BLOOM puede carecer del entendimiento contextual y cultural profundo necesario en ciertas tareas, lo que conlleva inexactitudes o salidas inapropiadas en escenarios sutiles.
  • Naturaleza evolutiva del lenguaje: Al estar entrenado en un conjunto de datos estático, puede no seguir el ritmo de la evolución del lenguaje, como nueva jerga, términos o referencias culturales.

Impacto real y controversias

El desarrollo y la publicación de BLOOM tienen implicaciones significativas, tanto por su impacto como por las controversias que suscita. Aquí abordamos estos aspectos basándonos en el paper de BLOOM.

Impacto real de BLOOM

  • Democratización de la tecnología de IA: BLOOM supone un avance hacia la democratización de la IA. Desarrollado por BigScience, un esfuerzo colaborativo con más de 1200 personas de 38 países, es un modelo de acceso abierto entrenado en un corpus diverso que cubre 59 lenguas. Esta amplia participación y accesibilidad marcan un cambio frente a la exclusividad habitual en el desarrollo de LLM.
  • Diversidad e inclusión: Destaca el compromiso del proyecto con la diversidad lingüística, geográfica y científica. El corpus ROOTS abarca un amplio abanico de lenguas y lenguajes de programación, reflejando un énfasis en la inclusión y la representación en el desarrollo de IA.

Controversias y retos

  • Preocupaciones sociales y éticas: El desarrollo de BLOOM reconoce las limitaciones sociales y los retos éticos de los LLM. El workshop de BigScience adoptó una Carta Ética para guiar el proyecto, enfatizando inclusión, diversidad, apertura, reproducibilidad y responsabilidad, principios integrados en todo: desde la curación del dataset hasta la evaluación del modelo.
  • Impacto ambiental y de recursos: El desarrollo de LLM como BLOOM ha generado preocupación ambiental por los grandes recursos computacionales que requieren. El entrenamiento de estos modelos, normalmente al alcance solo de organizaciones con muchos recursos, tiene implicaciones en consumo energético y huella de carbono.

¿Sigue siendo relevante BLOOM hoy?

En el vertiginoso mundo de la inteligencia artificial (IA), la relevancia de LLM como BLOOM es un debate constante.

Desarrollado por un amplio equipo internacional, BLOOM supuso un salto importante en el procesamiento del lenguaje. Sin embargo, el panorama de la IA evoluciona sin parar, con nuevos modelos que van cambiando el foco.

Veamos si BLOOM sigue manteniendo el tipo en este entorno tan competitivo.

  • Cambio de foco: Pese a ser un hito en su momento, BLOOM ha quedado a la sombra de modelos más recientes. A diferencia de IAs conversacionales como ChatGPT, BLOOM está orientado a completar contenido más que a la comunicación interactiva.
  • Restricciones de hardware: Las altas demandas de hardware de BLOOM limitan su accesibilidad frente a LLM más fáciles de integrar, como GPT-3.5 y GPT-4.
  • Competencia al alza: La llegada de modelos como LLaMA y herramientas como Alpaca ha democratizado el acceso a LLM, ofreciendo capacidades con menos requisitos de recursos y, por tanto, mayor adopción.
  • Capacidad multilingüe: Su gran baza sigue siendo su amplio entrenamiento en múltiples idiomas, lo que lo hace valioso para traducción y creación de contenido multilingüe.

Conclusión

Este artículo ha ofrecido una panorámica del proyecto BLOOM, una contribución relevante al campo en evolución de los grandes modelos lingüísticos.

Hemos repasado su desarrollo, resaltando sus especificaciones técnicas y la colaboración que lo hizo posible. También hemos explicado cómo acceder y utilizar BLOOM de forma eficaz, subrayando sus usos adecuados y sus límites.

Además, hemos tratado sus implicaciones éticas y su impacto real, reflexionando sobre su acogida y su vigencia en el panorama actual de la IA. Tanto si trabajas directamente con IA como si eres entusiasta del tema, esta exploración de BLOOM te ofrece claves esenciales para orientarte en el complejo mundo de los LLM.

Si quieres profundizar en los modelos de lenguaje avanzados, nuestro curso Large Language Models (LLMs) Concepts te ayudará a descubrir todo el potencial de los LLM, con un programa conceptual que cubre aplicaciones, metodologías de entrenamiento, consideraciones éticas e investigación reciente.


Zoumana Keita 's photo
Author
Zoumana Keita
LinkedIn
Twitter

Zoumana desarrolla herramientas de IA LLM para ayudar a las empresas a llevar a cabo la diligencia debida en materia de sostenibilidad y evaluaciones de riesgos. Anteriormente trabajó como científico de datos e ingeniero de aprendizaje automático en Axionable e IBM. Zoumana es la fundadora de la plataforma tecnológica educativa de aprendizaje entre iguales ETP4Africa. Ha escrito más de 20 tutoriales para DataCamp.

Temas
Inteligencia Artificial

¡Empieza hoy tu camino en IA!

Curso

Conceptos de la IA generativa

2 h
117.2K
Aprovecha la IA generativa con responsabilidad, aprende cómo se desarrollan estos modelos de IA y cómo afectarán a la sociedad en el futuro.
Ver detallesRight Arrow
Iniciar Curso
Ver másRight Arrow