Courses
แนวคิด Generative AI
2 ชม.
117.2K
การเติบโตของโมเดลภาษาขนาดใหญ่ (LLMs) เป็นแนวโน้มสำคัญในโลกของการประมวลผลภาษาธรรมชาติ (NLP) จนนำไปสู่การใช้งานอย่างแพร่หลายในแอปพลิเคชันหลากหลาย อย่างไรก็ตาม ความก้าวหน้านี้มักมีลักษณะเฉพาะกลุ่ม โดย LLMs ส่วนใหญ่ที่พัฒนาโดยองค์กรที่มีทรัพยากรมากยังคงไม่เปิดให้สาธารณะเข้าถึงได้
ความเป็นเอกสิทธิ์นี้ทำให้เกิดคำถามสำคัญว่า จะเป็นอย่างไรหากมีวิธีทำให้ทุกคนสามารถเข้าถึงโมเดลภาษาทรงพลังเหล่านี้ได้อย่างเท่าเทียม? นี่คือจุดที่ BLOOM เข้ามามีบทบาท
บทความนี้ให้ภาพรวมครบถ้วนว่า BLOOM คืออะไร โดยเริ่มจากที่มาของโครงการ ต่อจากนั้นจะอธิบายสเปกทางเทคนิค วิธีใช้งาน ก่อนปิดท้ายด้วยข้อจำกัดและข้อพิจารณาด้านจริยธรรม
BigScience Large Open-science Open-access Multilingual Language Model (ชื่อย่อ BLOOM) คือความก้าวหน้าอย่างยิ่งในการทำให้เทคโนโลยีโมเดลภาษาถูกทำให้เป็นประชาธิปไตย
พัฒนาร่วมกันโดยผู้มีส่วนร่วมกว่า 1200 คนจาก 39 ประเทศ รวมถึงจำนวนมากจากสหรัฐฯ BLOOM เป็นผลผลิตของความร่วมมือระดับโลก โครงการนี้ประสานงานโดย BigScience ร่วมกับ Hugging Face และชุมชน NLP ฝรั่งเศส ข้ามพรมแดนทั้งทางภูมิศาสตร์และสถาบัน
เป็นโอเพนซอร์สและเป็นโมเดลทรานส์ฟอร์เมอร์แบบดีโค้ดเดอร์เท่านั้น มีพารามิเตอร์ 176B ที่เทรนบนคอร์ปัส ROOTS ซึ่งเป็นชุดข้อมูลจากแหล่งที่มากกว่าหลายร้อยแหล่งใน 59 ภาษา: 46 ภาษาในชีวิตจริงและ 13 ภาษาสำหรับเขียนโปรแกรม
ด้านล่างเป็นไพชาร์ตแสดงสัดส่วนภาษาที่ใช้ในการเทรน
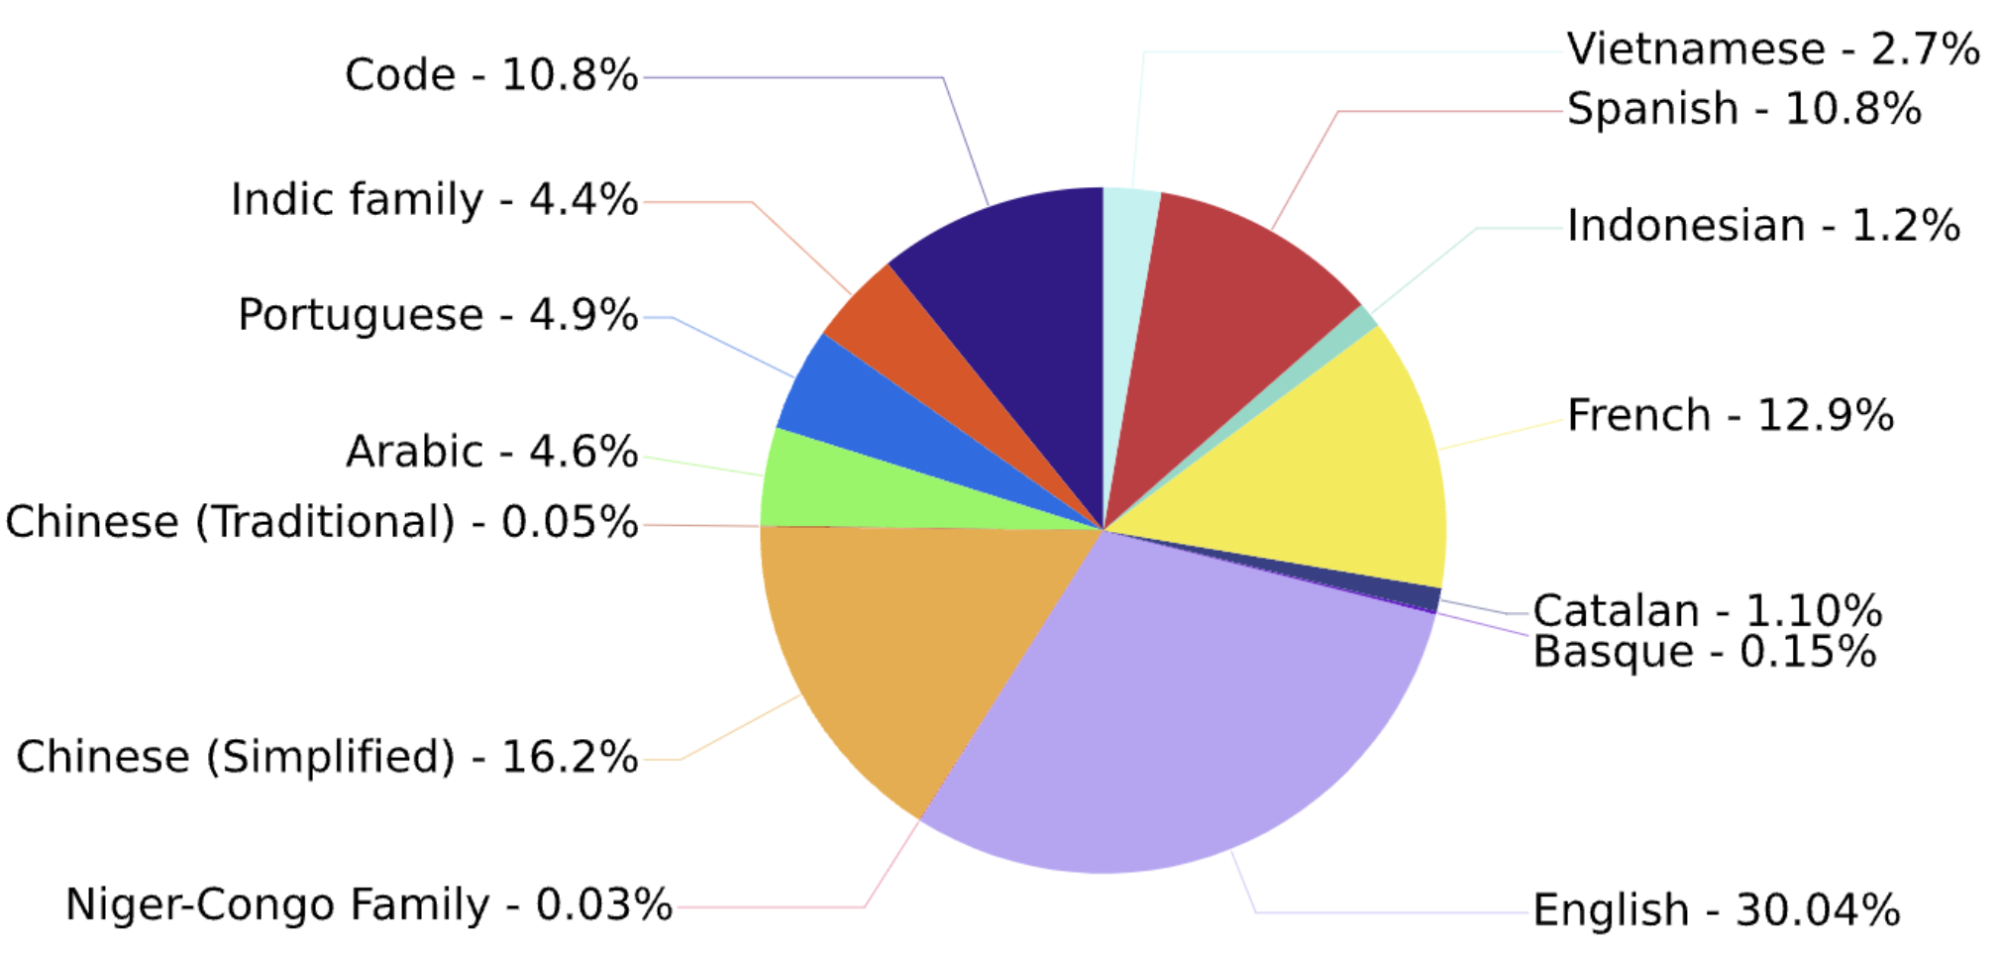
สัดส่วนภาษาที่ใช้ในการเทรน (ที่มา)
โมเดลให้ผลการทำงานที่โดดเด่นบนเบนช์มาร์กหลากหลาย และได้ผลลัพธ์ที่ดียิ่งขึ้นหลังการปรับจูนแบบ multitask prompted finetuning
โครงการนี้ปิดฉากด้วยการเทรนต่อเนื่อง 117 วัน (11 มีนาคม - 6 กรกฎาคม) บนซูเปอร์คอมพิวเตอร์ Jean Zay ในปารีส ด้วยการสนับสนุนทรัพยากรคอมพิวต์อย่างมากจากหน่วยงานวิจัยของฝรั่งเศส CNRS และ GENCI
BLOOM ไม่เพียงเป็นความมหัศจรรย์ทางเทคโนโลยี แต่ยังเป็นสัญลักษณ์ของความร่วมมือระหว่างประเทศและพลังของการแสวงหาวิทยาศาสตร์ร่วมกัน
ต่อไปจะอธิบายสถาปัตยกรรมของ BLOOM อย่างละเอียดขึ้น ซึ่งประกอบด้วยองค์ประกอบหลายส่วน
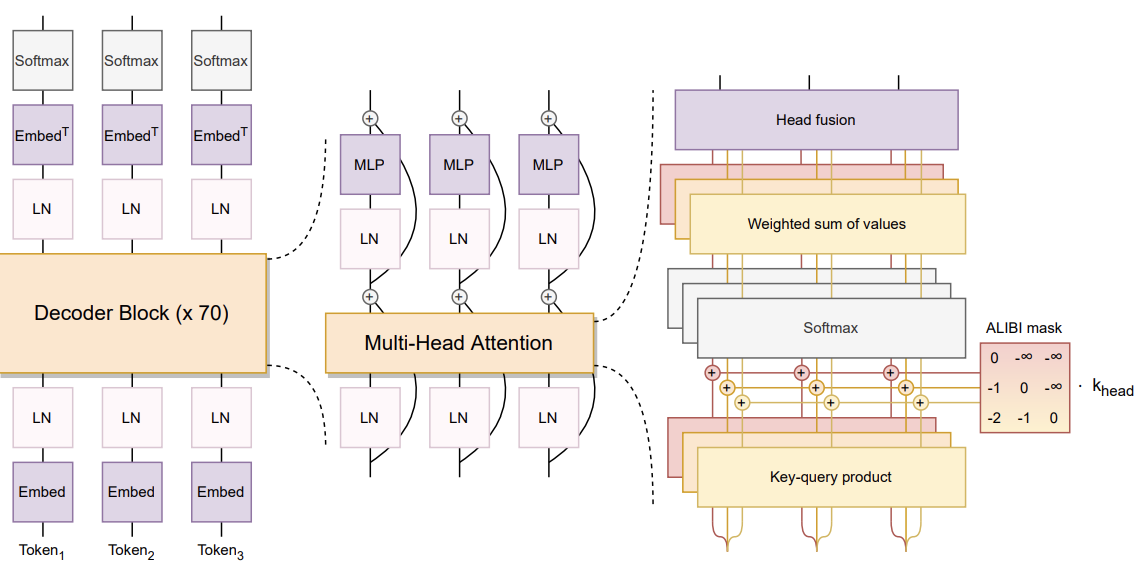
สถาปัตยกรรม Bloom (ที่มา)
สถาปัตยกรรมของโมเดล BLOOM ตามที่ระบุไว้ในงานวิจัย มีประเด็นน่าสนใจหลายส่วน:
องค์ประกอบเหล่านี้สะท้อนถึงการผสมผสานนวัตกรรมเข้ากับเทคนิคที่พิสูจน์แล้ว เพื่อเพิ่มประสิทธิภาพและเสถียรภาพของโมเดล
นอกเหนือจากสถาปัตยกรรมของ BLOOM มาดูอีกสององค์ประกอบที่เกี่ยวข้องคือ การเตรียมข้อมูลและชุดข้อมูลที่มีพรอมต์
ในตัวอย่างนี้จะใช้ BLOOM เพื่อสร้างเรื่องสั้นเชิงสร้างสรรค์ โค้ดถูกจัดโครงสร้างเพื่อเตรียมสภาพแวดล้อม เตรียมโมเดล และสร้างข้อความจากพรอมต์ที่กำหนด ซอร์สโค้ดฉบับเต็มดูได้บน GitHub และแรงบันดาลใจหลักมาจาก บทเรียนของ amrrs
โมเดล BLOOM ใช้ทรัพยากรสูง จึงต้องตั้งค่าพื้นที่ทำงานอย่างเหมาะสม ขั้นตอนหลักมีดังนี้
ก่อนอื่น ไลบรารี transformer ใช้สำหรับอินเทอร์เฟซในการทำงานกับโมเดล BLOOM และโมเดลประเภททรานส์ฟอร์เมอร์อื่น ๆ โดยทั่วไป
!pip install transformers -qใช้ nvidia-smi เพื่อตรวจสอบคุณสมบัติของ GPU ที่มีอยู่ให้แน่ใจว่ามีทรัพยากรคำนวณเพียงพอสำหรับรันโมเดล
!nvidia-smi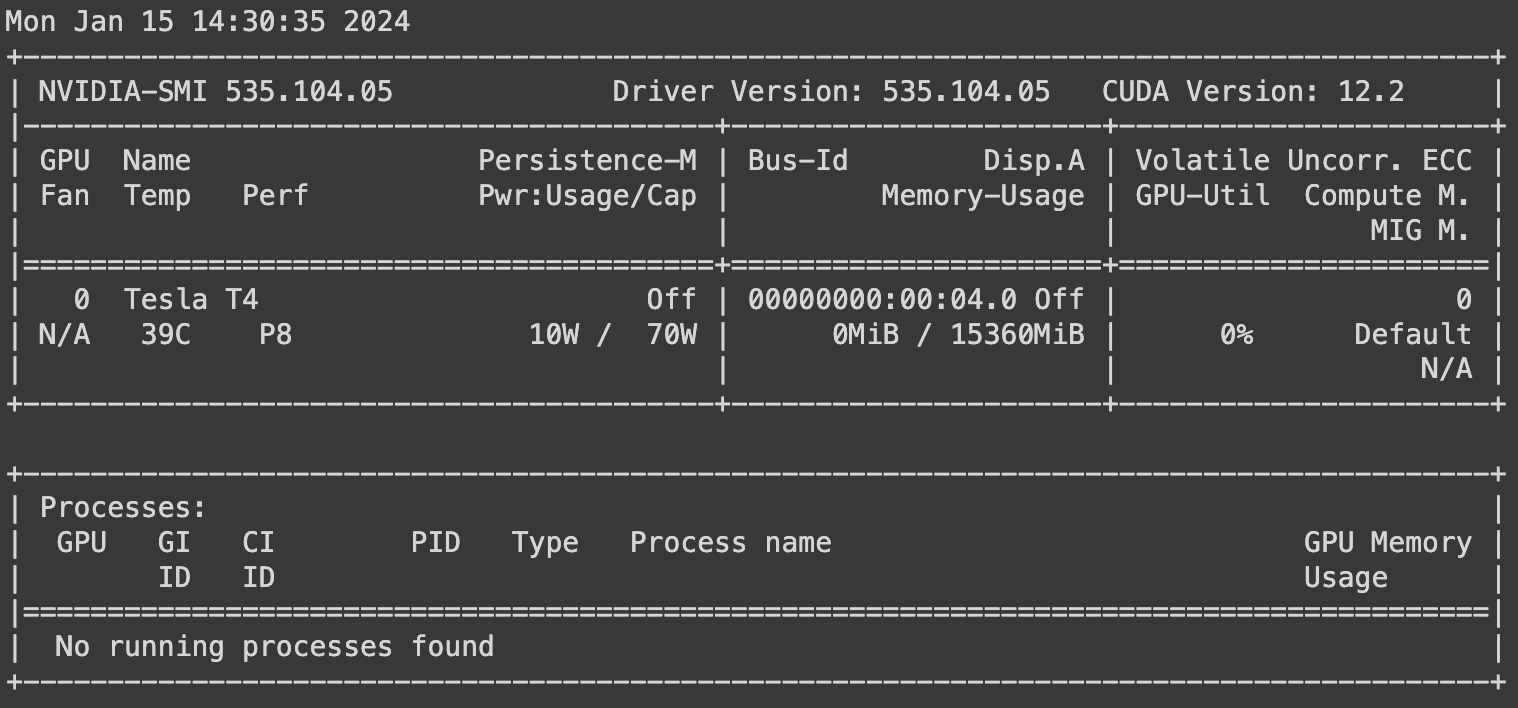
นำเข้ามอดูลที่ต้องใช้จาก transformers และ torch โดย torch ใช้สำหรับตั้งค่า default tensor type เพื่อใช้ประโยชน์จากการเร่งด้วย GPU
จากนั้น ในเมื่อใช้ GPU จึงตั้งค่าไลบรารี torch ผ่านฟังก์ชัน set_default_tensor_type เพื่อให้แน่ใจว่าใช้ GPU
from transformers import AutoModelForCausalLM, AutoTokenizer, set_seed
import torch
torch.set_default_tensor_type(torch.cuda.FloatTensor)โมเดลเป้าหมายที่ใช้คือ BLOOM ขนาด 7 พันล้านพารามิเตอร์ สามารถเข้าถึงได้จากที่เก็บของ BigScience บน Hubbing Face ภายใต้ bigscience/bloom-1b7 ซึ่งเป็นตัวระบุเฉพาะของโมเดล
model_ID = "bigscience/bloom-1b7"ถัดไป โหลดโมเดลและโทเคไนเซอร์ของ BLOOM ที่พรีเทรนจาก Hugging Face และตั้งค่า seed เพื่อการทำซ้ำผลลัพธ์ด้วยฟังก์ชัน set_seed โดยใช้ตัวเลขใดก็ได้ ค่าตัวเลขไม่สำคัญนัก แต่ควรเป็นค่าจำนวนเต็มไม่ใช่ทศนิยม
หากต้องการเรียนรู้ศักยภาพที่ยังไม่ถูกใช้ของโมเดลภาษาขนาดใหญ่ร่วมกับ LangChain ซึ่งเป็นเฟรมเวิร์ก Python แบบโอเพนซอร์สสำหรับสร้างแอปพลิเคชัน AI ขั้นสูง บทเรียน How to Build LLM Applications with LangChain Tutorial คือแนวทางที่เหมาะสม
นอกจากนี้ หากเป็นวิศวกรข้อมูลและสนใจการใช้ LangChain สำหรับแอปด้านข้อมูล บทความ Introduction to LangChain for Data Engineering & Data Applications จะให้ภาพรวมของสิ่งที่ทำได้ด้วย LangChain รวมถึงปัญหาที่ LangChain แก้ไขและตัวอย่างกรณีใช้งานด้านข้อมูล
model = AutoModelForCausalLM.from_pretrained(model_ID, use_cache=True)
tokenizer = AutoTokenizer.from_pretrained(model_ID)
set_seed(2024)
ตอนนี้สามารถกำหนดชื่อเรื่องของเรื่องสั้นที่จะสร้าง พร้อมกับพรอมต์ได้
story_title = 'An Unexpected Journey Through Time'
prompt = f'This is a creative story about {story_title}.\n'
สุดท้าย ทำการโทเคไนซ์พรอมต์และแมปไปยังอุปกรณ์ของโมเดลที่เหมาะสม ก่อนจะสร้างผลลัพธ์ของโมเดลและถอดรหัส
input_ids = tokenizer(prompt, return_tensors="pt").to(0)

sample = model.generate(**input_ids,
                        max_length=200, top_k=1,
                        temperature=0, repetition_penalty=2.0)

generated_story = tokenizer.decode(sample[0], skip_special_tokens=True)
ผลลัพธ์สุดท้ายถูกจัดรูปแบบด้วยมอดูล textwrap เพื่อจำกัดจำนวนอักขระสูงสุดต่อบรรทัดไว้ที่ 80 เพื่อให้อ่านง่าย
import textwrap
wrapper = textwrap.TextWrapper(width=80)
formated_story = wrapper.fill(text=generated_story)
print(formated_story)ผลลัพธ์สุดท้ายเป็นดังนี้:
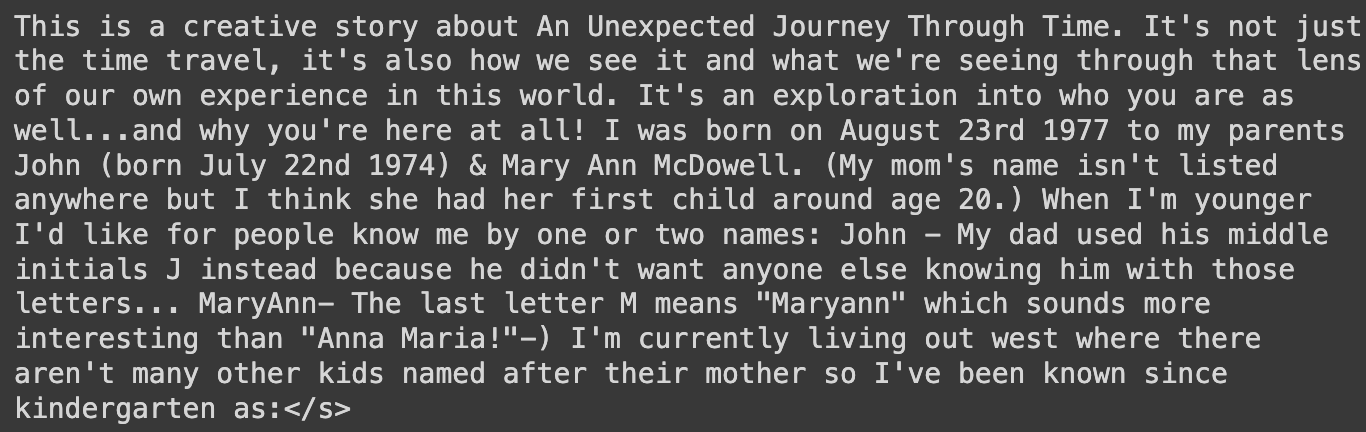
เรื่องสั้นที่สร้างด้วยโมเดล BLOOM
ด้วยโค้ดเพียงไม่กี่บรรทัด ก็สามารถสร้างเนื้อหาที่มีความหมายด้วยโมเดล BLOOM ได้
หากสนใจเรียนรู้กระบวนการเทรนโมเดลภาษาขนาดใหญ่ด้วย PyTorch ตั้งแต่ตั้งค่าจนถึงใช้งานจริง บทเรียน How to Train an LLM with PyTorch มีคู่มือครบถ้วนเพื่อไปถึงเป้าหมายนั้น
เช่นเดียวกับความก้าวหน้าทางเทคโนโลยีทุกชนิด BLOOM มาพร้อมชุดการใช้งานที่เหมาะสมและไม่เหมาะสม ส่วนนี้จะกล่าวถึงกรณีการใช้งานทั้งสองด้าน ชี้ให้เห็นว่าควรใช้ความสามารถของมันที่ใดและควรระวังที่ใด การเข้าใจขอบเขตเหล่านี้สำคัญต่อการใช้ BLOOM อย่างรับผิดชอบและมีประสิทธิผล
BLOOM เป็นเครื่องมืออเนกประสงค์ที่ออกแบบมาเพื่อขยายขอบเขตของการประมวลผลและการสร้างภาษาธรรมชาติ การใช้งานที่ตั้งใจไว้ครอบคลุมหลายสาขา โดยใช้ประโยชน์จากความสามารถด้านภาษาที่กว้างขวาง
การเข้าใจข้อจำกัดของ BLOOM เป็นสิ่งสำคัญเพื่อให้ใช้งานได้อย่างมีจริยธรรมและปฏิบัติได้จริง บางกรณีอยู่นอกเหนือวัตถุประสงค์ของ BLOOM LLM ด้วยเหตุผลด้านจริยธรรมหรือข้อจำกัดทางเทคนิค
BLOOM ในฐานะโมเดลภาษาขนาดใหญ่ขั้นสูง มอบประโยชน์มากมายแก่กลุ่มผู้ใช้หลากหลาย ความสามารถของมันไม่เพียงส่งผลต่อผู้เชี่ยวชาญและภาคส่วนบางกลุ่มโดยตรง แต่ยังมีผลกว้างไกลที่ส่งผลต่อผู้มีส่วนได้ส่วนเสียวงกว้างโดยอ้อม
การสำรวจผู้ใช้ของ BLOOM นี้มุ่งชี้ให้เห็นว่ากลุ่มต่าง ๆ ใช้ประโยชน์และได้รับผลกระทบจากเครื่องมือใหม่นี้อย่างไร
ด้วยการทำความเข้าใจผู้ใช้โดยตรงและโดยอ้อมของ BLOOM เราจะเห็นอิทธิพลอันกว้างขวางของโมเดล และแนวทางหลากหลายที่ช่วยผลักดันเทคโนโลยีและสังคมให้ก้าวหน้า
การใช้งาน BLOOM เช่นเดียวกับโมเดลภาษาขนาดใหญ่อื่น ๆ มาพร้อมข้อพิจารณาและข้อจำกัดด้านจริยธรรมหลายประการ ประเด็นเหล่านี้สำคัญต่อการใช้อย่างรับผิดชอบและการคาดการณ์ผลกระทบในวงกว้าง ส่วนนี้จะกล่าวถึงนัยยะทางจริยธรรม ความเสี่ยง และข้อจำกัดที่ติดตัวมากับการใช้ BLOOM
การพัฒนาและการปล่อย BLOOM มีนัยสำคัญในโลกจริง ทั้งด้านผลกระทบและข้อถกเถียงที่เกิดขึ้น ส่วนนี้จะกล่าวถึงประเด็นเหล่านั้น โดยอ้างอิงจากข้อค้นพบในงานวิจัยของ BLOOM
ในโลก AI ที่ก้าวเร็ว ความเกี่ยวข้องของโมเดลภาษาขนาดใหญ่อย่าง BLOOM เป็นหัวข้อที่ถูกพูดถึงอย่างต่อเนื่อง
BLOOM ซึ่งพัฒนาโดยทีมวิจัยนานาชาติขนาดใหญ่ เป็นก้าวกระโดดสำคัญด้านการประมวลผลภาษา แต่ภูมิทัศน์ของ AI ก็กำลังเปลี่ยนแปลงอยู่เสมอ โดยมีโมเดลใหม่ ๆ ปรากฏและเปลี่ยนจุดสนใจ
มาดูกันว่า BLOOM ยังยืนหยัดได้หรือไม่ในสนามที่แข่งขันสูงนี้
บทความนี้นำเสนอภาพรวมของโครงการ BLOOM ซึ่งเป็นผลงานสำคัญในสาขาโมเดลภาษาขนาดใหญ่ที่กำลังพัฒนาอย่างต่อเนื่อง
เราได้สำรวจพัฒนาการของ BLOOM เน้นสเปกทางเทคนิคและความร่วมมือเบื้องหลังการสร้าง บทความยังทำหน้าที่เป็นคู่มือในการเข้าถึงและใช้งาน BLOOM อย่างมีประสิทธิภาพ โดยเน้นการใช้งานที่เหมาะสมและข้อจำกัด
ยิ่งไปกว่านั้น ยังครอบคลุมประเด็นจริยธรรมและผลกระทบในโลกจริงของโครงการ BLOOM AI สะท้อนการตอบรับและความเกี่ยวข้องในภูมิทัศน์ AI ปัจจุบัน ไม่ว่าจะทำงานด้าน AI โดยตรงหรือเป็นผู้สนใจ การสำรวจ BLOOM ครั้งนี้มอบมุมมองสำคัญเพื่อก้าวผ่านโลกที่ซับซ้อนของโมเดลภาษาขนาดใหญ่
สำหรับผู้ที่ต้องการต่อยอดการเรียนรู้เกี่ยวกับโมเดลภาษาขั้นสูง หลักสูตร Large Language Models (LLMs) Concepts จะพาไปค้นหาศักยภาพของ LLMs ด้วยคอร์สแนวคิดที่ครอบคลุมการใช้งาน วิธีการเทรน ประเด็นจริยธรรม และงานวิจัยล่าสุด
เริ่มต้นเส้นทาง AI วันนี้เลย!
Courses
Courses
Courses