
Curso
Conceitos de IA Generativa
2 h
117.1K
A ascensão dos Large Language Models (LLMs) tem sido uma tendência marcante em Processamento de Linguagem Natural (NLP), levando à sua adoção ampla em várias aplicações. No entanto, esse avanço muitas vezes foi exclusivo, com a maioria dos LLMs desenvolvidos por organizações com muitos recursos permanecendo inacessíveis ao público.
Essa exclusividade levanta uma questão importante: e se houvesse uma forma de democratizar o acesso a esses poderosos modelos de linguagem? É aqui que o BLOOM entra em cena.
Este artigo traz uma visão completa do que é o BLOOM, começando por sua gênese. Em seguida, apresenta as especificações técnicas do BLOOM e como usá-lo, antes de destacar suas limitações e considerações éticas.
BigScience Large Open-science Open-access Multilingual Language Model (BLOOM, na forma abreviada) representa um avanço considerável na democratização da tecnologia de modelos de linguagem.
Desenvolvido de forma colaborativa por mais de 1.200 participantes de 39 países, incluindo um número significativo dos Estados Unidos, o BLOOM é fruto de um esforço global. Coordenado pela BigScience em colaboração com a Hugging Face e a comunidade francesa de NLP, o projeto transcende fronteiras geográficas e institucionais.
É um modelo open source e um transformer apenas decodificador, com 176 bilhões de parâmetros, treinado no corpus ROOTS — um conjunto de dados com centenas de fontes em 59 idiomas: 46 línguas faladas e 13 linguagens de programação.
Abaixo está o gráfico de pizza com a distribuição dos idiomas de treinamento.
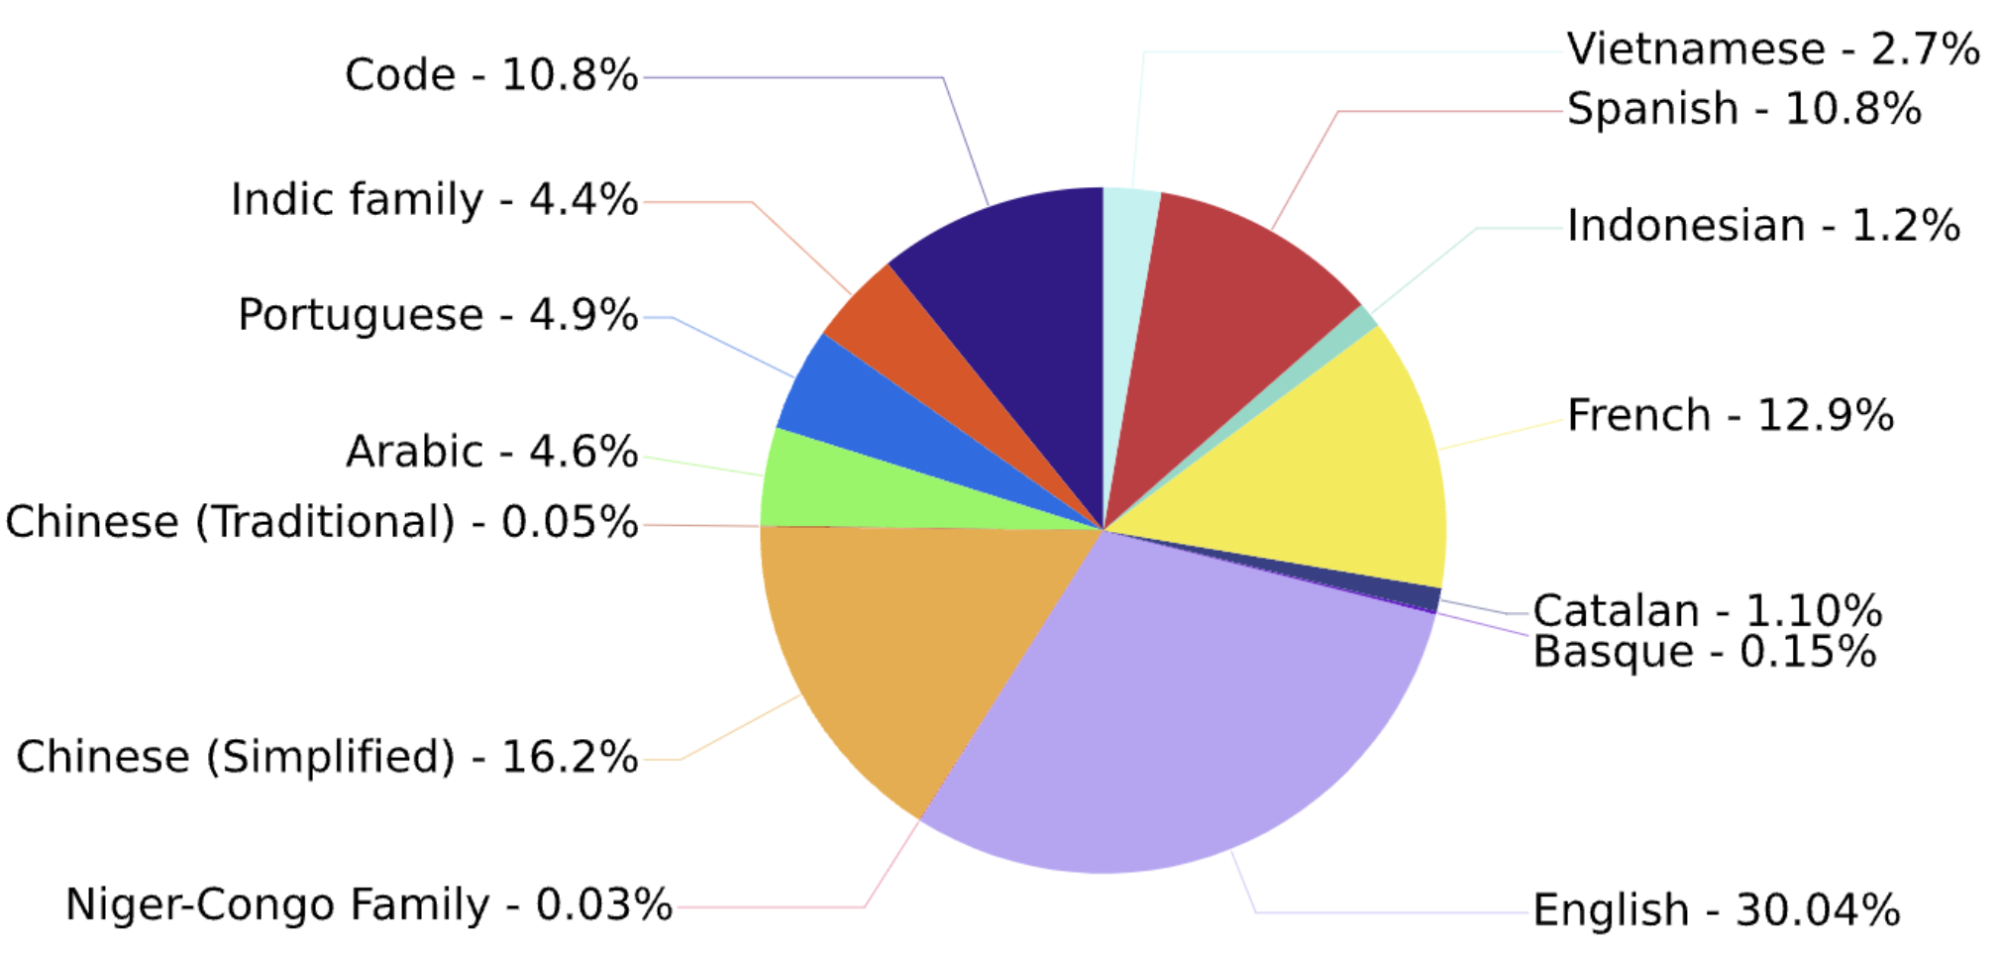
Distribuição dos idiomas de treinamento (fonte)
O modelo apresentou desempenho notável em uma ampla variedade de benchmarks e alcançou resultados ainda melhores após o finetuning multitarefa com prompts.
O projeto culminou em uma sessão de 117 dias de treinamento (11 de março a 6 de julho) no supercomputador Jean Zay, em Paris, apoiado por uma grande concessão de computação das agências francesas de pesquisa CNRS e GENCI.
O BLOOM é não apenas uma façanha tecnológica, mas também um símbolo de cooperação internacional e do poder da ciência colaborativa.
Agora, vamos descrever a arquitetura do BLOOM com mais detalhes, passando por seus principais componentes.
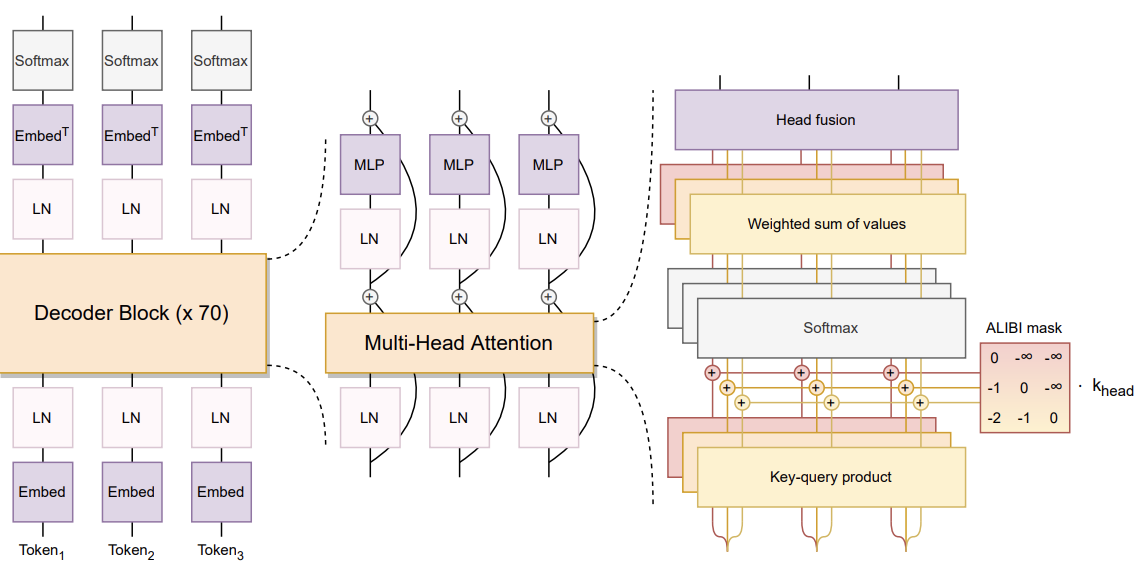
Arquitetura do BLOOM (fonte)
A arquitetura do BLOOM, conforme detalhado no artigo, inclui diversos pontos notáveis:
Esses componentes refletem o foco do time em equilibrar inovação com técnicas comprovadas para otimizar desempenho e estabilidade.
Além dos componentes de arquitetura do BLOOM, vale entender dois elementos adicionais relevantes: pré-processamento de dados e datasets com prompts.
Neste exemplo, vamos usar o BLOOM para gerar uma história criativa. O código a seguir configura o ambiente, prepara o modelo e gera texto com base em um prompt. O código correspondente está disponível no GitHub e é fortemente inspirado no tutorial do amrrs.
O modelo BLOOM exige muitos recursos; por isso, uma configuração adequada do ambiente é crucial. Os passos principais estão abaixo.
Primeiro, a biblioteca transformers é usada para fornecer interfaces para trabalhar com o BLOOM e outros modelos baseados em transformers.
!pip install transformers -qUsando o nvidia-smi, verificamos as propriedades da GPU disponível para garantir os recursos computacionais necessários para executar o modelo.
!nvidia-smi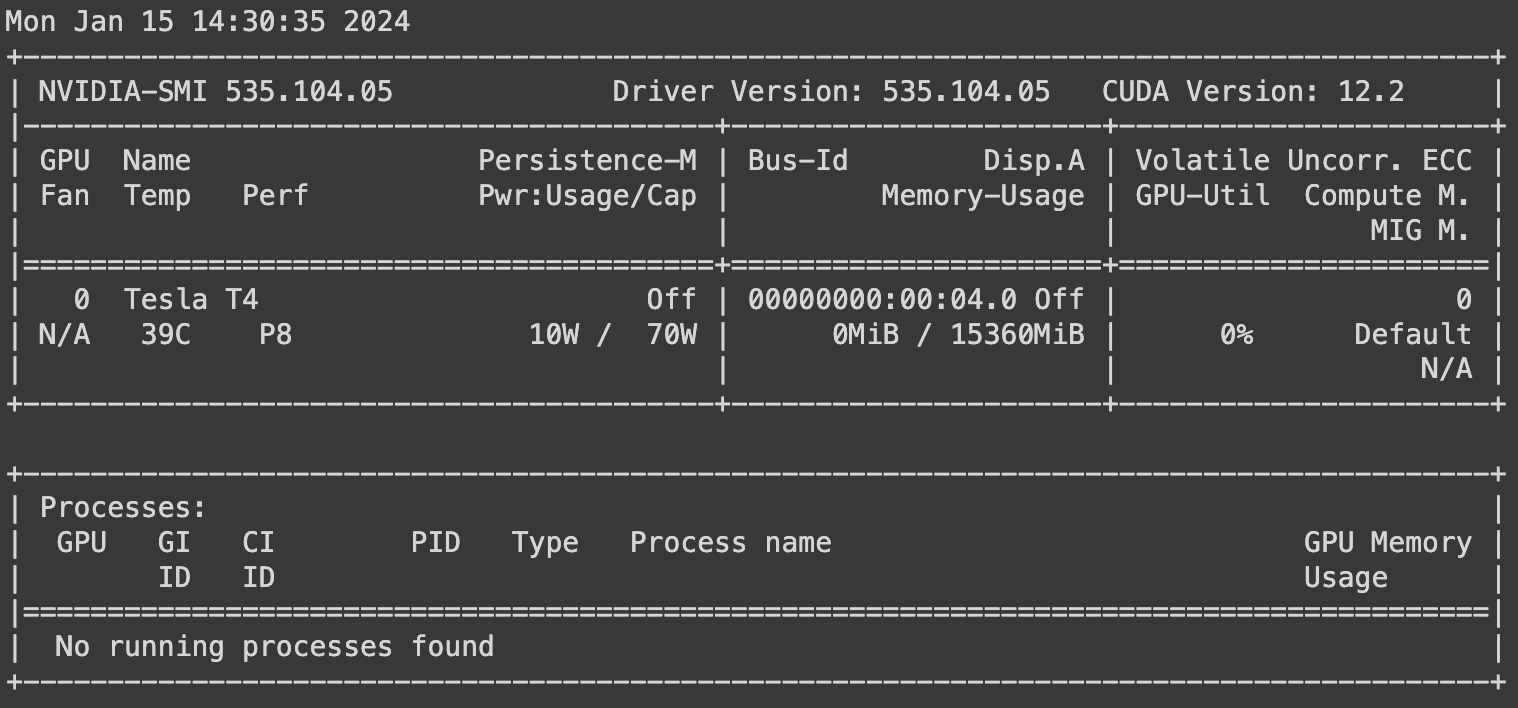
Importamos os módulos necessários de transformers e torch. O torch é usado para definir o tipo padrão de tensor e aproveitar a aceleração da GPU.
Como estamos usando GPU, a biblioteca torch é configurada com a função set_default_tensor_type para garantir o uso da GPU.
from transformers import AutoModelForCausalLM, AutoTokenizer, set_seed
import torch
torch.set_default_tensor_type(torch.cuda.FloatTensor)O modelo alvo usado é o BLOOM com 7 bilhões de parâmetros, acessível no repositório da BigScience no Hugging Face sob bigscience/bloom-1b7, que corresponde ao identificador único do modelo.
model_ID = "bigscience/bloom-1b7"Em seguida, carregamos o modelo BLOOM e o tokenizer pré-treinados do Hugging Face e definimos a semente para reprodutibilidade com a função set_seed com qualquer número inteiro. O valor em si não importa, mas é importante não usar um valor de ponto flutuante.
Para saber mais sobre os potenciais pouco explorados dos Large Language Models com LangChain, um framework open source em Python para construir aplicações avançadas de IA, nosso tutorial How to Build LLM Applications with LangChain Tutorial é o guia certo.
Além disso, se você é data engineer e se interessa pelo uso do LangChain em aplicações de dados, nosso artigo Introduction to LangChain for Data Engineering & Data Applications apresenta uma visão geral do que é possível fazer com o LangChain, incluindo os problemas que ele resolve e exemplos de casos de uso em dados.
model = AutoModelForCausalLM.from_pretrained(model_ID, use_cache=True)
tokenizer = AutoTokenizer.from_pretrained(model_ID)
set_seed(2024)
Agora podemos definir o título da história a ser gerada, junto com o prompt.
story_title = 'An Unexpected Journey Through Time'
prompt = f'This is a creative story about {story_title}.\n'
Por fim, tokenizamos o prompt e mapeamos para o dispositivo apropriado do modelo antes de gerar o resultado e decodificá-lo.
input_ids = tokenizer(prompt, return_tensors="pt").to(0)

sample = model.generate(**input_ids,
                        max_length=200, top_k=1,
                        temperature=0, repetition_penalty=2.0)

generated_story = tokenizer.decode(sample[0], skip_special_tokens=True)
O resultado final é formatado usando o módulo textwrap, garantindo no máximo 80 caracteres por linha para melhor leitura.
import textwrap
wrapper = textwrap.TextWrapper(width=80)
formated_story = wrapper.fill(text=generated_story)
print(formated_story)O resultado final é mostrado abaixo:
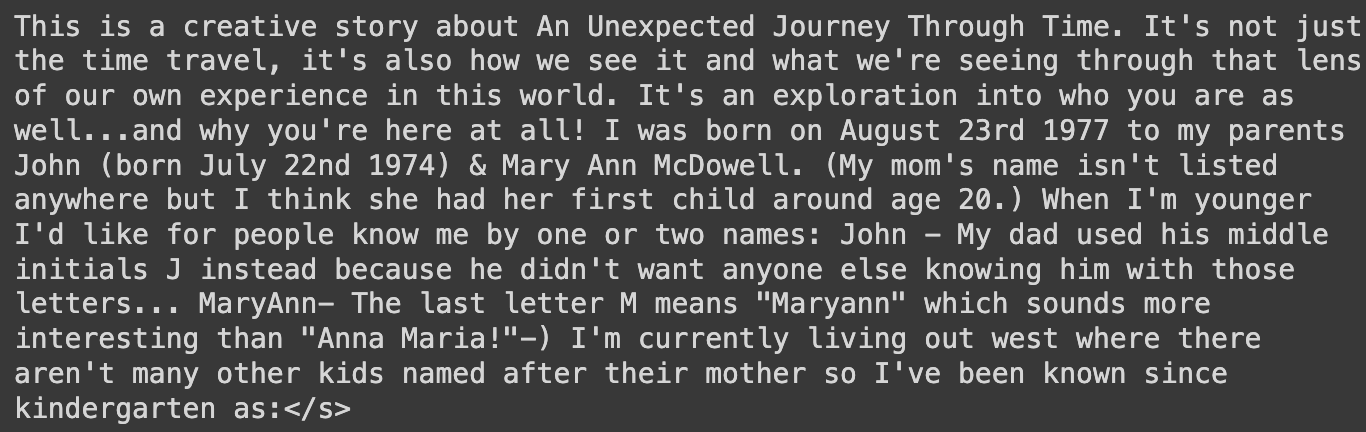
História gerada com o modelo BLOOM
Com poucas linhas de código, conseguimos gerar um conteúdo significativo usando o BLOOM.
Se você quer dominar o processo de treinar LLMs usando PyTorch, do setup inicial à implementação final, nosso tutorial How to Train an LLM with PyTorch traz um guia completo para chegar lá.
Como todo avanço tecnológico, o BLOOM traz seus próprios usos apropriados e inadequados. Nesta seção, exploramos quando e como aproveitar melhor suas capacidades e onde é preciso cautela. Entender esses limites é essencial para usar o BLOOM de forma responsável e eficaz.
O BLOOM é uma ferramenta versátil, projetada para expandir os limites do processamento e da geração de linguagem. Seus usos pretendidos abrangem diversos domínios, cada um aproveitando seu amplo repertório linguístico.
Entender as limitações do BLOOM é essencial para garantir seu uso ético e prático. Alguns casos de uso ficam fora do escopo do LLM BLOOM, principalmente por considerações éticas ou restrições técnicas.
Como um LLM avançado, o BLOOM oferece uma ampla gama de benefícios para diferentes grupos. Suas capacidades influenciam diretamente certos profissionais e setores, e também impactam indiretamente um conjunto mais amplo de stakeholders.
Esta análise dos usuários do BLOOM mostra como diferentes grupos aproveitam e são afetados por essa ferramenta inovadora.
Ao entender os usuários diretos e indiretos do BLOOM, podemos apreciar sua influência e as diversas formas como contribui para o avanço da tecnologia e da sociedade.
A adoção do BLOOM, como qualquer LLM, traz uma série de considerações éticas e limitações. Esses pontos são essenciais para um uso responsável e para antecipar impactos mais amplos da tecnologia. Esta seção aborda implicações éticas, riscos e limitações inerentes ao uso do BLOOM.
O desenvolvimento e o lançamento do BLOOM têm implicações relevantes no mundo real, tanto em seu impacto quanto nas controvérsias que suscita. Esta seção discute esses aspectos, com base nos insights do artigo de pesquisa do BLOOM.
No mundo acelerado da inteligência artificial (IA), a relevância de LLMs como o BLOOM é um tema em constante debate.
Desenvolvido por um grande time internacional de pesquisadores, o BLOOM foi um salto importante no processamento de linguagem. Porém, o cenário da IA evolui continuamente, com novos modelos surgindo e mudando o foco.
Vamos analisar se o BLOOM ainda se sustenta nesse domínio competitivo.
Este artigo trouxe uma visão geral do projeto BLOOM, uma contribuição significativa para o campo em evolução dos Large Language Models.
Exploramos o desenvolvimento do BLOOM, destacando suas especificações técnicas e a colaboração por trás de sua criação. O artigo também serviu como um guia para acessar e utilizar o BLOOM de forma eficaz, enfatizando seus usos apropriados e limitações.
Além disso, cobrimos as implicações éticas e o impacto do projeto BLOOM no mundo real, refletindo sobre sua recepção e relevância no cenário atual de IA. Seja você um profissional da área ou um entusiasta, esta exploração do BLOOM oferece perspectivas essenciais para navegar o universo dos LLMs.
Para aprofundar seu contato com modelos de linguagem avançados, nosso curso adicional, Large Language Models (LLMs) Concepts, mostra como descobrir todo o potencial dos LLMs com um curso conceitual que cobre aplicações, metodologias de treinamento, considerações éticas e as pesquisas mais recentes.
Comece sua jornada em IA hoje mesmo!
Curso
Curso
Curso
blog
Nisha Arya Ahmed
12 min
blog
Abid Ali Awan
8 min
blog
Stanislav Karzhev
9 min
blog
Bhavishya Pandit
8 min
Tutorial
Josep Ferrer
11 min
Tutorial
Moez Ali
12 min



