Course
Концепции генеративного ИИ
2 ч
117.1K
Рост больших языковых моделей (LLM) стал определяющим трендом в области обработки естественного языка (NLP), что привело к их широкому применению в самых разных задачах. Однако это развитие часто оставалось эксклюзивным: большинство LLM, созданных обеспеченными ресурсами организациями, недоступны широкой публике.
Такая закрытость поднимает важный вопрос: что если можно было бы сделать доступ к этим мощным моделям более открытым? Здесь на сцену выходит BLOOM.
Эта статья — полный обзор того, что такое BLOOM: сначала — подробности о её зарождении, затем — технические характеристики и способы использования, после чего — ограничения и этические соображения.
BigScience Large Open-science Open-access Multilingual Language Model (сокращённо BLOOM) — значительный шаг к демократизации технологий языковых моделей.
Разработанная совместно более чем 1200 участниками из 39 стран, включая значительное число исследователей из США, BLOOM — результат глобального усилия. Проект координировался BigScience в сотрудничестве с Hugging Face и французским сообществом NLP, выходя за географические и институциональные границы.
Это модель с открытым исходным кодом и трансформер типа decoder-only с 176 млрд параметров, обученная на корпусе ROOTS — наборе данных из сотен источников на 59 языках: 46 естественных и 13 языках программирования.
Ниже представлена круговая диаграмма распределения языков обучения.
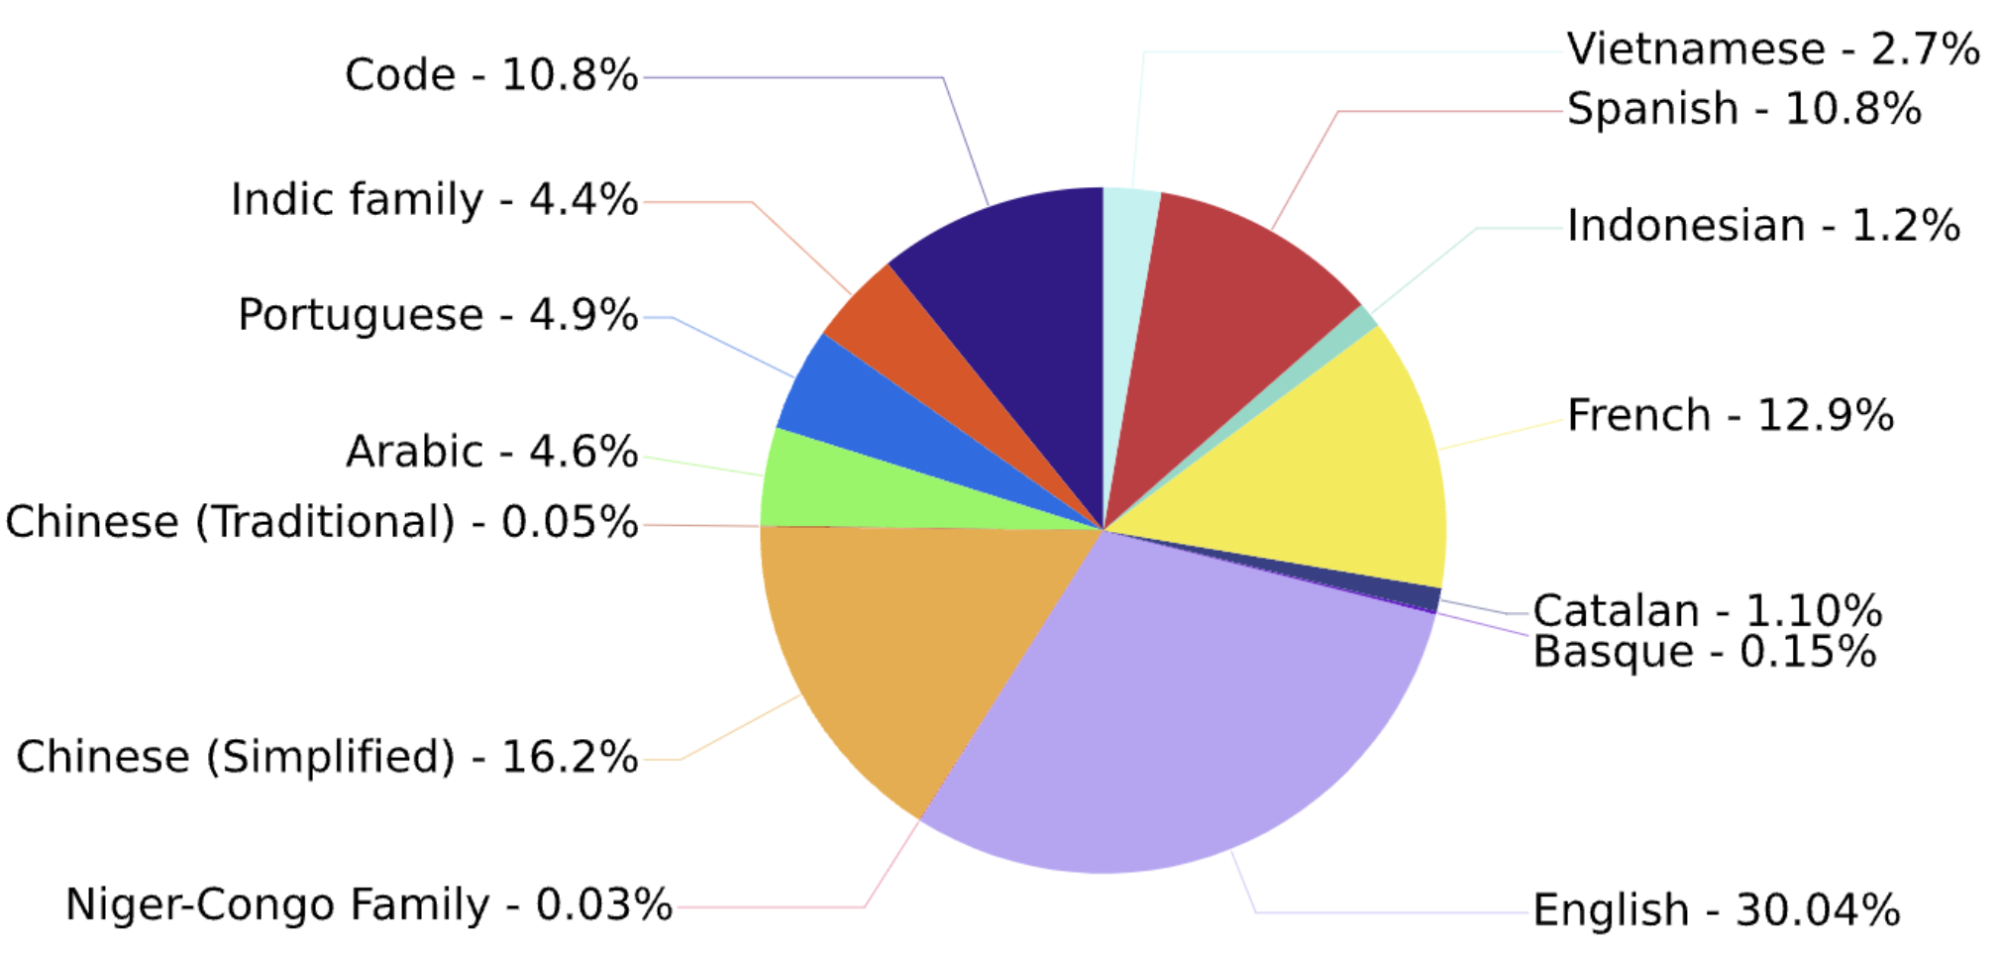
Распределение языков обучения (источник)
Модель показала выдающиеся результаты на широком спектре бенчмарков, а после мультитасковой донастройки по подсказкам результаты стали ещё лучше.
Проект завершился 117-дневной (11 марта — 6 июля) сессией обучения на суперкомпьютере Jean Zay в Париже при поддержке значительного гранта на вычислительные ресурсы от французских исследовательских агентств CNRS и GENCI.
BLOOM — это не только технологическое достижение, но и символ международного сотрудничества и силы коллективного научного поиска.
Теперь опишем архитектуру BLOOM более детально — она включает несколько компонентов.
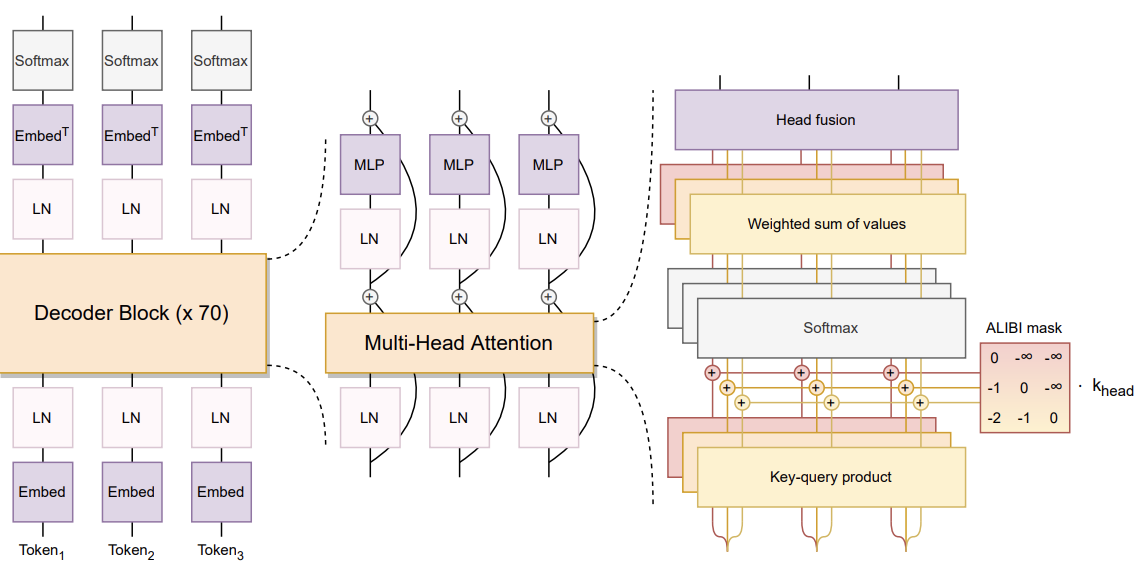
Архитектура Bloom (источник)
Как описано в статье, архитектура BLOOM включает несколько примечательных аспектов:
Эти компоненты отражают стремление команды сбалансировать инновации с проверенными техниками для оптимизации производительности и стабильности модели.
Помимо архитектурных компонентов BLOOM, важно понять ещё два связанных элемента: предварительную обработку данных и датасеты с подсказками.
В этом примере мы используем BLOOM для генерации креативной истории. Приведённый код настраивает окружение, подготавливает модель и генерирует текст по заданной подсказке. Исходный код доступен на GitHub и в значительной мере вдохновлён учебником amrrs.
Модель BLOOM ресурсоёмка, поэтому корректная настройка окружения критична. Основные шаги описаны ниже.
Сначала библиотека transformer используется для интерфейсов работы с моделью BLOOM и другими моделями на базе трансформеров.
!pip install transformers -qС помощью nvidia-smi проверяем характеристики доступного GPU, чтобы убедиться, что есть необходимые ресурсы для запуска модели.
!nvidia-smi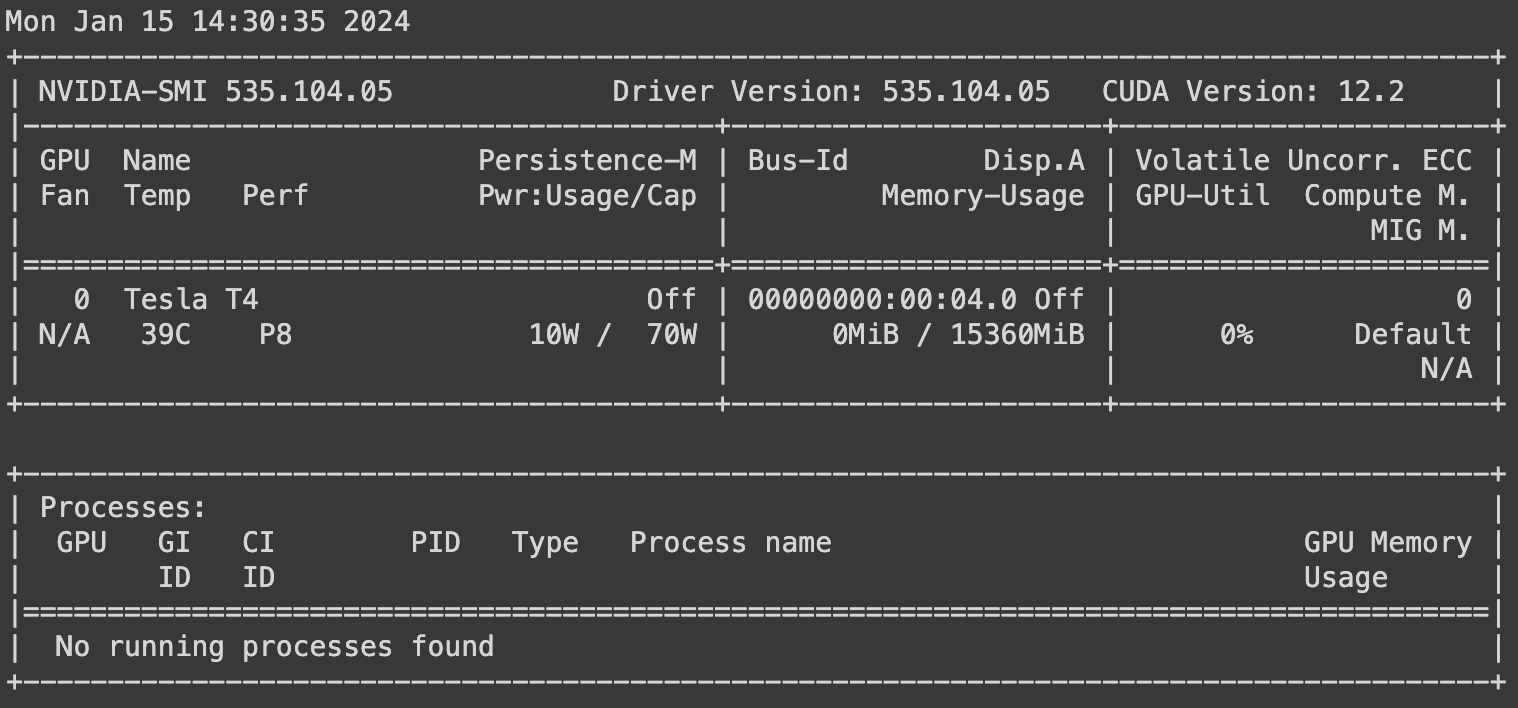
Импортируем необходимые модули из transformers и torch. torch используется для задания типа тензора по умолчанию, чтобы задействовать ускорение на GPU.
Затем, поскольку мы используем GPU, библиотека torch настраивается с помощью функции set_default_tensor_type для обеспечения использования GPU.
from transformers import AutoModelForCausalLM, AutoTokenizer, set_seed
import torch
torch.set_default_tensor_type(torch.cuda.FloatTensor)В качестве целевой используется модель BLOOM с 7 миллиардами параметров, доступная в репозитории BigScience на Hubbing Face под идентификатором bigscience/bloom-1b7, который соответствует уникальному идентификатору модели.
model_ID = "bigscience/bloom-1b7"Далее загружаем предобученную модель BLOOM и токенизатор из Hugging Face и устанавливаем зерно генератора для воспроизводимости с помощью функции set_seed с любым числом. Само значение числа не важно, но важно, чтобы оно было целым.
Чтобы узнать больше о нереализованном потенциале больших языковых моделей с LangChain — открытой Python-фреймворком для построения продвинутых ИИ-приложений — рекомендуем наш учебник How to Build LLM Applications with LangChain Tutorial.
Кроме того, если вы дата-инженер и вас интересует использование LangChain для дата-приложений, наша статья Introduction to LangChain for Data Engineering & Data Applications даёт обзор возможностей LangChain, в том числе решаемых задач и примеров кейсов обработки данных.
model = AutoModelForCausalLM.from_pretrained(model_ID, use_cache=True)
tokenizer = AutoTokenizer.from_pretrained(model_ID)
set_seed(2024)
Теперь можно определить заголовок генерируемой истории и подсказку.
story_title = 'An Unexpected Journey Through Time'
prompt = f'This is a creative story about {story_title}.\n'
Наконец, мы токенизируем подсказку и переносим её на соответствующее устройство модели, после чего генерируем и декодируем результат.
input_ids = tokenizer(prompt, return_tensors="pt").to(0)

sample = model.generate(**input_ids,
                        max_length=200, top_k=1,
                        temperature=0, repetition_penalty=2.0)

generated_story = tokenizer.decode(sample[0], skip_special_tokens=True)
Финальный результат форматируется модулем textwrap, чтобы обеспечить не более 80 символов в строке для лучшей читаемости.
import textwrap
wrapper = textwrap.TextWrapper(width=80)
formated_story = wrapper.fill(text=generated_story)
print(formated_story)Окончательный результат приведён ниже:
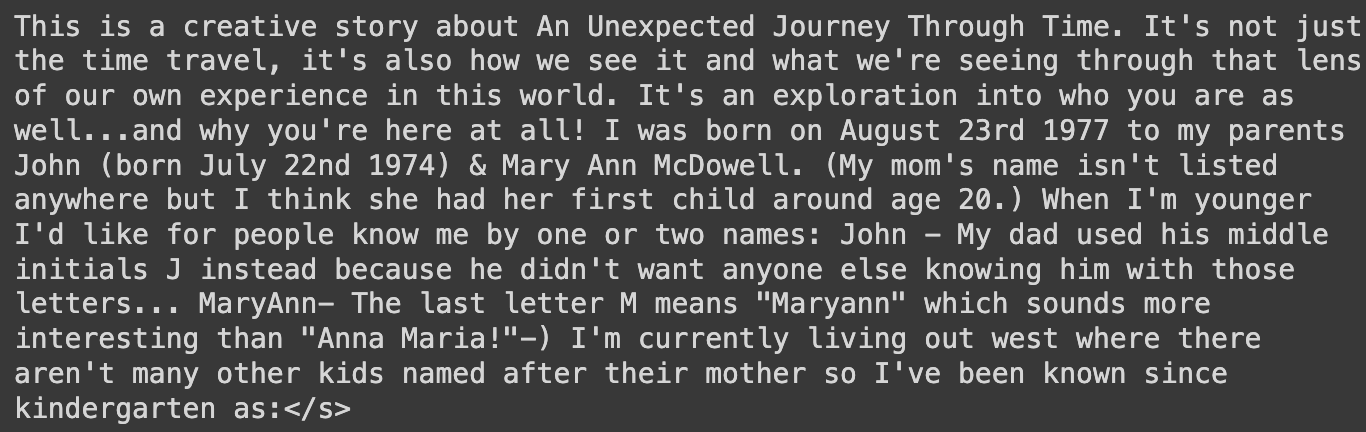
История, сгенерированная моделью BLOOM
Всего несколькими строками кода мы смогли сгенерировать содержательный текст с помощью модели BLOOM.
Если вы хотите освоить процесс обучения больших языковых моделей с использованием PyTorch — от начальной настройки до финальной реализации — наш учебник How to Train an LLM with PyTorch предоставляет полное руководство для достижения этой цели.
Как и у любой технологической новинки, у BLOOM есть подходящие и неподходящие области применения. В этом разделе рассматриваются уместные и неуместные сценарии, где её возможности наиболее полезны и где следует проявлять осторожность. Понимание этих границ важно для ответственного и эффективного использования BLOOM.
BLOOM — универсальный инструмент, призванный расширять границы обработки и генерации текста. Её предполагаемые применения охватывают разные домены, используя широкие языковые возможности.
Понимание ограничений BLOOM важно для её этичного и практичного применения. Некоторые случаи выходят за рамки предназначения BLOOM, главным образом из-за этических соображений или технических ограничений.
BLOOM, как продвинутая большая языковая модель, приносит пользу широкому кругу пользователей. Её возможности напрямую влияют на определённые профессии и секторы, а также оказывают более широкий, косвенный эффект на другие группы заинтересованных сторон.
Этот обзор пользователей BLOOM показывает, как разные группы используют и на них влияет этот инновационный инструмент.
Понимая прямых и косвенных пользователей BLOOM, мы лучше осознаём масштаб её влияния и разнообразные способы, которыми она способствует развитию технологий и общества.
Внедрение BLOOM, как и любой большой языковой модели, сопровождается рядом этических вопросов и ограничений. Их важно понимать для ответственного использования и прогнозирования более широкого влияния технологии. В этом разделе рассматриваются этические аспекты, риски и присущие ограничения при использовании BLOOM.
Разработка и выпуск BLOOM имеют существенные последствия в реальном мире — как по влиянию, так и по возникающим спорам. Здесь обсуждаются эти аспекты на основе выводов из исследовательской статьи о BLOOM.
В стремительно развивающемся мире искусственного интеллекта (ИИ) актуальность LLM вроде BLOOM остаётся предметом обсуждения.
Созданная большой международной командой исследователей, BLOOM стала серьёзным шагом вперёд в обработке языка. Однако ландшафт ИИ постоянно меняется: появляются новые модели и смещают фокус.
Рассмотрим, сохраняет ли BLOOM свои позиции в этой конкурентной среде.
В этой статье дан обзор проекта BLOOM — значимого вклада в развивающуюся область больших языковых моделей.
Мы рассмотрели разработку BLOOM, её технические характеристики и сотрудничество, стоящее за созданием. Статья также была руководством по доступу и эффективному использованию BLOOM, с акцентом на уместные применения и ограничения.
Кроме того, затронуты этические аспекты и реальное влияние проекта BLOOM, его восприятие и актуальность в современном ИИ-ландшафте. Независимо от того, работаете ли вы напрямую с ИИ или просто интересуетесь темой, этот обзор BLOOM даёт важные ориентиры для навигации в мире больших языковых моделей.
Тем, кто хочет углубиться в продвинутые языковые модели, наш дополнительный курс Large Language Models (LLMs) Concepts поможет раскрыть полный потенциал LLM: приложения, методы обучения, этические вопросы и актуальные исследования.
Начните путь в ИИ уже сегодня!
Course
Course
Course