大型语言模型(LLMs)的兴起已成为自然语言处理(NLP)领域的标志性趋势,推动其在各类应用中的广泛采用。然而,这一进步往往带有排他性,多数由资源雄厚机构开发的 LLM 仍难以向公众开放。
这种排他性引出了一个重要问题:是否有办法让大众也能使用这些强大的语言模型?这正是 BLOOM 登场的背景。
本文将全面介绍 BLOOM:首先回顾其起源与历程,之后梳理 BLOOM 的技术规格及使用方式,最后强调其局限性与伦理考量。
什么是 BLOOM?
BigScience Large Open-science Open-access Multilingual Language Model(简称 BLOOM),在推动语言模型技术的普惠化方面迈出了重要一步。
BLOOM 由来自 39 个国家的 1200 多名参与者协作开发,其中包括大量来自美国的贡献者。这一由 BigScience 牵头、联合 Hugging Face 与法国 NLP 社区的全球性项目,跨越了地域与机构的边界。
它是一个开源、仅解码器(decoder-only)的 Transformer 模型,拥有 1760 亿参数,基于 ROOTS 语料库进行训练。该语料库涵盖 59 种语言的数百个数据来源:包括 46 种自然语言和 13 种编程语言。
下图为训练语言的分布饼图。
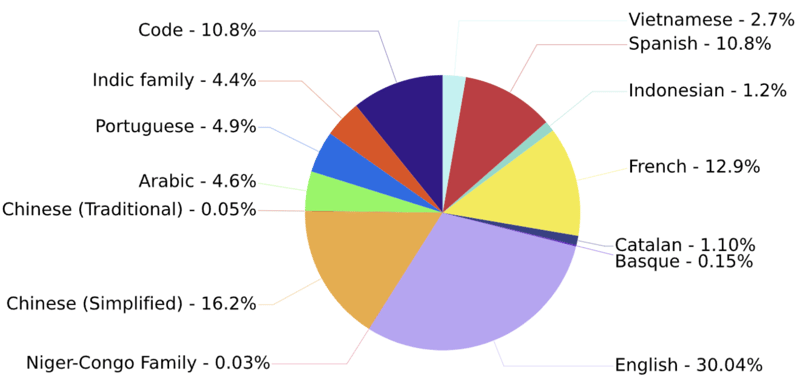
训练语言的分布(来源)
在多种基准测试上,该模型均展现出卓越表现,并在进行多任务提示式微调后取得了更佳结果。
项目最终在巴黎的 Jean Zay 超级计算机上进行了为期 117 天(3 月 11 日至 7 月 6 日)的训练,得到了法国科研机构 CNRS 与 GENCI 的大量算力资助。
BLOOM 不仅是技术奇迹,也象征着国际合作与集体科研力量。
BLOOM 模型架构
现在,我们以更细致的方式介绍 BLOOM 的架构,它由多种组件构成。
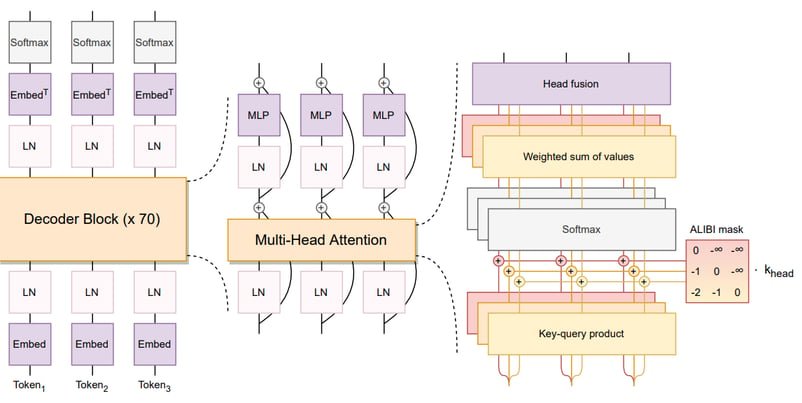
Bloom 架构(来源)
论文详细描述的 BLOOM 架构包括以下要点:
- 设计方法论:团队专注于可扩展的模型家族,依托公开可用的工具与代码库,并在小规模模型上进行消融实验,以优化组件与超参数。零样本泛化能力是评估架构决策的关键指标。
- 架构与预训练目标:BLOOM 基于 Transformer 架构,具体为因果型的仅解码器模型。与编解码器以及其他仅解码器架构相比,这一方案被验证为最有利于零样本泛化能力。
- 建模细节:
- ALiBi 位置嵌入:相比传统位置嵌入,ALiBi 直接基于键与查询的距离衰减注意力分数,从而带来更平滑的训练与更佳性能。
- Embedding LayerNorm:在嵌入层之后立即加入额外的层归一化,有助于提升训练稳定性。此决策部分受到最终训练采用 bfloat16 的影响,其相较于 float16 具有更高的稳定性。
这些组件体现了团队在创新与成熟技术之间的平衡,旨在优化模型的性能与稳定性。
除 BLOOM 的架构组件外,我们再了解两个相关环节:数据预处理与提示式数据集。
- 数据预处理:包括去重与隐私信息的编辑遮蔽,尤其针对隐私风险较高的数据来源。
- 提示式数据集:BLOOM 采用多任务提示式微调,已展现出较强的零样本任务泛化能力。
如何使用 BLOOM
在本示例中,我们将使用 BLOOM 生成一篇创意故事。代码结构包括环境配置、模型准备以及基于给定提示生成文本。相应源码可在 GitHub 获取,并深受 amrrs 的教程启发。
配置工作区
BLOOM 模型资源消耗较大,因此正确配置工作环境至关重要,主要步骤如下所示。
首先,使用 transformer 库,它为使用 BLOOM 及其他基于 Transformer 的模型提供接口。
!pip install transformers -q技术支持
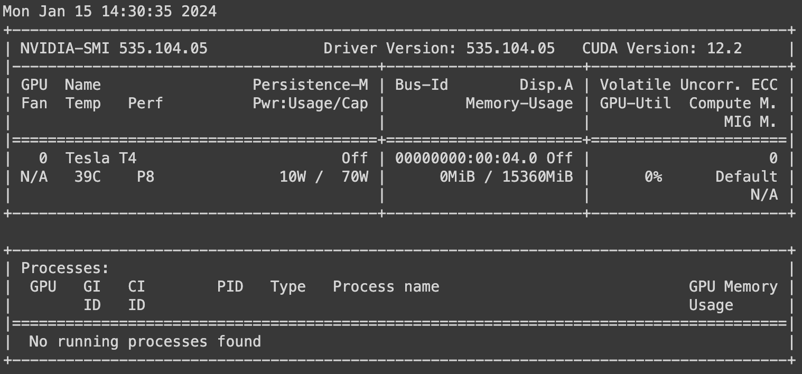
使用 nvidia-smi 检查可用 GPU 的属性,确保具备运行模型所需的计算资源。
!nvidia-smi技术支持
我们从 transformers 与 torch 导入所需模块。torch 用于设置默认张量类型,以利用 GPU 加速。
随后,由于我们使用 GPU,通过 set_default_tensor_type 函数配置 torch 库以确保使用 GPU。
from transformers import AutoModelForCausalLM, AutoTokenizer, set_seed
import torch
torch.set_default_tensor_type(torch.cuda.FloatTensor)技术支持
使用 BLOOM 模型
本例选用的目标模型为 17 亿参数的 BLOOM 变体,可通过 BigScience 在 Hugging Face 的仓库 bigscience/bloom-1b7 获取,这是模型的唯一标识符。
model_ID = "bigscience/bloom-1b7"技术支持
接下来,我们从 Hugging Face 加载预训练的 BLOOM 模型与分词器,并使用 set_seed 函数设置随机种子以保证可复现性,传入任意整数即可,数值本身无特殊要求,但需为非浮点数。
若想进一步了解结合 LangChain 释放大语言模型潜力的方式——LangChain 是一个用于构建高级 AI 应用的开源 Python 框架——请参阅我们的教程《How to Build LLM Applications with LangChain Tutorial》。
此外,若您是数据工程师并对在数据应用中使用 LangChain 感兴趣,可阅读我们的文章《Introduction to LangChain for Data Engineering & Data Applications》,了解 LangChain 能做什么、能解决哪些问题,以及数据相关用例示例。
model = AutoModelForCausalLM.from_pretrained(model_ID, use_cache=True)
tokenizer = AutoTokenizer.from_pretrained(model_ID)
set_seed(2024)
技术支持
现在,我们可以定义要生成的故事标题与相应提示。
story_title = 'An Unexpected Journey Through Time'
prompt = f'This is a creative story about {story_title}.\n'技术支持
最后,对提示进行分词并映射到合适的模型设备上,然后在解码后得到模型输出。
input_ids = tokenizer(prompt, return_tensors="pt").to(0)

sample = model.generate(**input_ids,
                        max_length=200, top_k=1,
                        temperature=0, repetition_penalty=2.0)

generated_story = tokenizer.decode(sample[0], skip_special_tokens=True)技术支持
最终结果使用 textwrap 模块进行格式化,将每行的最大字符数设置为 80,以提升可读性。
import textwrap
wrapper = textwrap.TextWrapper(width=80)技术支持
formated_story = wrapper.fill(text=generated_story)
print(formated_story)技术支持
最终结果如下所示:
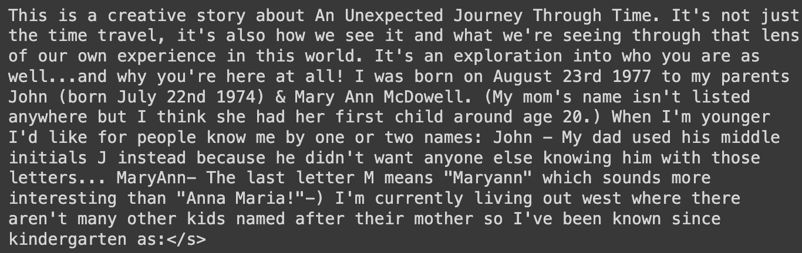
使用 BLOOM 模型生成的故事
只需几行代码,我们便能借助 BLOOM 生成有意义的内容。
如果您想从环境搭建到最终落地,系统掌握使用 PyTorch 训练大型语言模型的流程,我们的教程《How to Train an LLM with PyTorch》将提供完整指南。
预期用途与不适用场景
与所有技术进步一样,BLOOM 也有其适用与不适用的场景。本节将探讨其合理与不当的使用方式,指出其能力最能发挥之处与需要谨慎之处。理解这些边界对于负责任、有效地发挥 BLOOM 的潜力至关重要。
BLOOM 的预期用途
BLOOM 是一款用途广泛的工具,旨在推动语言处理与生成的边界。其预期用途覆盖多个领域,各自借助其强大的语言能力。
- 多语言内容生成:凭借覆盖 59 种语言的能力,BLOOM 擅长创作多元且包容的内容。这在全球化沟通、教育与媒体等重视语言包容性的场景尤为重要。
- 编程与软件开发:由于接受过编程语言训练,BLOOM 在软件开发中可发挥作用,如辅助代码生成、调试,并作为新手程序员的教学工具。
- 科研与学术:在学术领域,BLOOM 可用于语言学分析与 AI 研究,为语言模式、AI 行为等提供洞见。
BLOOM 的不适用场景
了解 BLOOM 的限制对于其伦理与实际应用至关重要。一些用例超出了 BLOOM 设计目标的范围,主要因伦理因素或技术约束。
- 敏感数据处理:BLOOM 并非为处理敏感个人数据或机密信息而设计。存在隐私泄露或数据被滥用的可能,因此不适合此类用途。
- 高风险决策:在需要高度准确性的场景(如医疗诊断或法律裁决)中使用 BLOOM 并不可取。与多数大型语言模型一样,其局限性可能导致在敏感领域产生不准确或误导性的结果。
- 替代人际互动:不应将 BLOOM 视为人际交往的替代,尤其是在需要情感智慧的领域,如咨询、外交或个性化教学。模型缺乏人类所具备的细腻理解与共情能力。
直接与间接用户
作为先进的大型语言模型(LLM),BLOOM 为多个用户群体带来广泛益处。其能力不仅直接影响某些专业与行业,也通过更广泛的影响间接惠及更多利益相关方。
本节将探讨 BLOOM 的用户群体,展示不同群体如何利用并受益于这一创新工具。
通过了解 BLOOM 的直接与间接用户,我们可以更好地认识其广泛影响,以及其在推动技术与社会进步方面的多样贡献。
BLOOM 的直接用户
- 开发者与数据科学家:软件开发与数据科学专业人士是主要用户。他们使用 BLOOM 进行代码辅助、调试与数据分析等任务。
- 研究人员与学者:包括语言学家、AI 研究人员与学者,利用 BLOOM 开展语言研究、AI 行为分析与推动 NLP 研究。
- 内容创作者与翻译人员:作家、记者与译者使用 BLOOM 生成与翻译多语言内容,以提升生产力与覆盖面。
BLOOM 的间接用户
- 企业与组织:各行业公司通过更强大的 AI 驱动服务、更优的客户互动与更高效的数据处理而间接受益于 BLOOM。
- 教育机构:学生与教育者通过集成 BLOOM 语言处理能力的教学工具与资源而间接受益,提升学习与教学效果。
- 公众:更广泛的社区通过更佳的技术体验、获取多语言内容与更强的软件应用而间接受益。
伦理考量与局限
与任何大型语言模型(LLM)一样,部署 BLOOM 伴随着一系列伦理考量与局限。理解这些方面有助于负责任地使用,并预判其更广泛的社会影响。本节将讨论使用 BLOOM 所涉及的伦理影响、风险与内在限制。
伦理考量
- 数据偏见与公平性:首要伦理关切在于 BLOOM 可能延续或放大训练数据中的偏见。这会影响输出的公平与中立性,在需要无偏处理的场景中带来挑战。
- 隐私问题:尽管 BLOOM 并非专为处理敏感个人信息而设计,但其庞大的训练数据可能无意中包含此类信息。若 BLOOM 基于或泄露敏感数据生成输出,存在隐私风险。
使用相关风险
- 虚假信息与操纵:BLOOM 的强大生成能力可能被滥用于制造误导或操纵性内容,在媒体、政治与公共舆论领域带来显著风险。
- 依赖性与技能退化:过度依赖 BLOOM 进行内容创作或翻译等任务,可能导致人类在这些方面的技能退化,影响创造力与语言能力。
BLOOM 的局限
- 语境理解:尽管模型复杂,BLOOM 仍可能缺乏对特定任务所需的深层语境与文化理解,在细微语境中可能出现不准确或不当输出。
- 语言的演化:BLOOM 基于静态数据集训练,可能难以及时跟进语言的演化,包括新俚语、新术语或新文化指涉。
现实影响与争议
BLOOM 的开发与发布在现实世界中具有重要影响,同时也引发一些争议。以下讨论基于 BLOOM 研究论文中的洞见。
BLOOM 的现实影响
- 推动 AI 技术普惠:BLOOM 是迈向 AI 技术普惠的重要一步。该模型由 BigScience 牵头、来自 38 个国家的 1200 余人协作开发,并基于覆盖 59 种语言的多样化语料进行开放获取训练。这种广泛参与与可及性,打破了大型语言模型开发通常的排他性。
- 多样性与包容性:项目强调语言、地域与科研的多元化。用于训练 BLOOM 的 ROOTS 语料覆盖大量自然语言与编程语言,体现出在 AI 开发中对包容与代表性的重视。
争议与挑战
- 社会与伦理关切:BLOOM 的开发认可了大型语言模型在社会与伦理层面的局限。BigScience 研讨会以伦理宪章为指导原则,强调包容性、多样性、开放性、可复现性与责任,将这些原则贯穿于数据集策划到模型评估的各个环节。
- 环境与资源问题:类似 BLOOM 的大型语言模型开发需要巨量算力,引发环境方面的担忧。其训练通常仅对资源充足的机构可负担,对能耗与碳足迹带来影响。
BLOOM 今日仍具相关性吗?
在快速发展的人工智能(AI)领域,像 BLOOM 这样的大型语言模型(LLM)的现实相关性始终是讨论焦点。
BLOOM 由庞大的国际团队共同研发,曾在语言处理方面实现重大跃进。然而,AI 版图持续演变,新模型不断涌现并改变焦点。
让我们来评估 BLOOM 在这一竞争激烈的领域中是否仍然站得住脚。
- 焦点转移:作为最初的重大突破,BLOOM 现已被更新模型所掩映。与 ChatGPT 等对话式 AI 不同,BLOOM 更偏向内容补全而非交互式沟通。
- 硬件约束:BLOOM 对硬件要求较高,与更易集成于各类应用的 GPT-3.5 与 GPT-4 等 LLM 相比,其可用性受限。
- 竞争加剧:LLaMA 等模型与 Alpaca 等工具的出现,降低了使用 LLM 的资源门槛,进一步扩大了其吸引力与使用范围。
- 多语言能力:BLOOM 的独特优势在于其广泛的多语言训练,使其在翻译与多语言内容创作方面具有重要价值。
结语
本文概述了 BLOOM 项目,这一成果为大型语言模型这一不断演进的领域做出了重要贡献。
我们探讨了 BLOOM 的发展历程,重点介绍其技术规格与背后的协作机制。本文亦作为指南,帮助读者获取并有效使用 BLOOM,同时强调其适用场景与局限性。
此外,文章还覆盖了 BLOOM 项目的伦理影响与现实影响,反映其在当今 AI 领域的反响与相关性。无论您是否直接参与 AI 工作,抑或仅是爱好者,对 BLOOM 的这番探究都为您理解大型语言模型这一复杂世界提供了关键视角。
如果您希望进一步深入前沿语言模型,我们的进阶课程《Large Language Models (LLMs) Concepts》将带您系统了解 LLM 的应用、训练方法、伦理考量与最新研究,释放 LLM 的全部潜力。
大型语言模型(LLMs)的兴起已成为自然语言处理(NLP)领域的标志性趋势,推动其在各类应用中的广泛采用。然而,这一进步往往带有排他性,多数由资源雄厚机构开发的 LLM 仍难以向公众开放。
这种排他性引出了一个重要问题:是否有办法让大众也能使用这些强大的语言模型?这正是 BLOOM 登场的背景。
本文将全面介绍 BLOOM:首先回顾其起源与历程,之后梳理 BLOOM 的技术规格及使用方式,最后强调其局限性与伦理考量。
什么是 BLOOM?
BigScience Large Open-science Open-access Multilingual Language Model(简称 BLOOM),在推动语言模型技术的普惠化方面迈出了重要一步。
BLOOM 由来自 39 个国家的 1200 多名参与者协作开发,其中包括大量来自美国的贡献者。这一由 BigScience 牵头、联合 Hugging Face 与法国 NLP 社区的全球性项目,跨越了地域与机构的边界。
它是一个开源、仅解码器(decoder-only)的 Transformer 模型,拥有 1760 亿参数,基于 ROOTS 语料库进行训练。该语料库涵盖 59 种语言的数百个数据来源:包括 46 种自然语言和 13 种编程语言。
下图为训练语言的分布饼图。
训练语言的分布(来源)
在多种基准测试上,该模型均展现出卓越表现,并在进行多任务提示式微调后取得了更佳结果。
项目最终在巴黎的 Jean Zay 超级计算机上进行了为期 117 天(3 月 11 日至 7 月 6 日)的训练,得到了法国科研机构 CNRS 与 GENCI 的大量算力资助。
BLOOM 不仅是技术奇迹,也象征着国际合作与集体科研力量。
BLOOM 模型架构
现在,我们以更细致的方式介绍 BLOOM 的架构,它由多种组件构成。
Bloom 架构(来源)
论文详细描述的 BLOOM 架构包括以下要点:
这些组件体现了团队在创新与成熟技术之间的平衡,旨在优化模型的性能与稳定性。
除 BLOOM 的架构组件外,我们再了解两个相关环节:数据预处理与提示式数据集。
如何使用 BLOOM
在本示例中,我们将使用 BLOOM 生成一篇创意故事。代码结构包括环境配置、模型准备以及基于给定提示生成文本。相应源码可在 GitHub 获取,并深受 amrrs 的教程启发。
配置工作区
BLOOM 模型资源消耗较大,因此正确配置工作环境至关重要,主要步骤如下所示。
首先,使用 transformer 库,它为使用 BLOOM 及其他基于 Transformer 的模型提供接口。
使用 nvidia-smi 检查可用 GPU 的属性,确保具备运行模型所需的计算资源。
我们从 transformers 与 torch 导入所需模块。torch 用于设置默认张量类型,以利用 GPU 加速。
随后,由于我们使用 GPU,通过 set_default_tensor_type 函数配置 torch 库以确保使用 GPU。
使用 BLOOM 模型
本例选用的目标模型为 17 亿参数的 BLOOM 变体,可通过 BigScience 在 Hugging Face 的仓库 bigscience/bloom-1b7 获取,这是模型的唯一标识符。
接下来,我们从 Hugging Face 加载预训练的 BLOOM 模型与分词器,并使用 set_seed 函数设置随机种子以保证可复现性,传入任意整数即可,数值本身无特殊要求,但需为非浮点数。
若想进一步了解结合 LangChain 释放大语言模型潜力的方式——LangChain 是一个用于构建高级 AI 应用的开源 Python 框架——请参阅我们的教程《How to Build LLM Applications with LangChain Tutorial》。
此外,若您是数据工程师并对在数据应用中使用 LangChain 感兴趣,可阅读我们的文章《Introduction to LangChain for Data Engineering & Data Applications》,了解 LangChain 能做什么、能解决哪些问题,以及数据相关用例示例。
现在,我们可以定义要生成的故事标题与相应提示。
最后,对提示进行分词并映射到合适的模型设备上,然后在解码后得到模型输出。
最终结果使用 textwrap 模块进行格式化,将每行的最大字符数设置为 80,以提升可读性。
最终结果如下所示:
使用 BLOOM 模型生成的故事
只需几行代码,我们便能借助 BLOOM 生成有意义的内容。
如果您想从环境搭建到最终落地,系统掌握使用 PyTorch 训练大型语言模型的流程,我们的教程《How to Train an LLM with PyTorch》将提供完整指南。
预期用途与不适用场景
与所有技术进步一样,BLOOM 也有其适用与不适用的场景。本节将探讨其合理与不当的使用方式,指出其能力最能发挥之处与需要谨慎之处。理解这些边界对于负责任、有效地发挥 BLOOM 的潜力至关重要。
BLOOM 的预期用途
BLOOM 是一款用途广泛的工具,旨在推动语言处理与生成的边界。其预期用途覆盖多个领域,各自借助其强大的语言能力。
BLOOM 的不适用场景
了解 BLOOM 的限制对于其伦理与实际应用至关重要。一些用例超出了 BLOOM 设计目标的范围,主要因伦理因素或技术约束。
直接与间接用户
作为先进的大型语言模型(LLM),BLOOM 为多个用户群体带来广泛益处。其能力不仅直接影响某些专业与行业,也通过更广泛的影响间接惠及更多利益相关方。
本节将探讨 BLOOM 的用户群体,展示不同群体如何利用并受益于这一创新工具。
通过了解 BLOOM 的直接与间接用户,我们可以更好地认识其广泛影响,以及其在推动技术与社会进步方面的多样贡献。
BLOOM 的直接用户
BLOOM 的间接用户
伦理考量与局限
与任何大型语言模型(LLM)一样,部署 BLOOM 伴随着一系列伦理考量与局限。理解这些方面有助于负责任地使用,并预判其更广泛的社会影响。本节将讨论使用 BLOOM 所涉及的伦理影响、风险与内在限制。
伦理考量
使用相关风险
BLOOM 的局限
现实影响与争议
BLOOM 的开发与发布在现实世界中具有重要影响,同时也引发一些争议。以下讨论基于 BLOOM 研究论文中的洞见。
BLOOM 的现实影响
争议与挑战
BLOOM 今日仍具相关性吗?
在快速发展的人工智能(AI)领域,像 BLOOM 这样的大型语言模型(LLM)的现实相关性始终是讨论焦点。
BLOOM 由庞大的国际团队共同研发,曾在语言处理方面实现重大跃进。然而,AI 版图持续演变,新模型不断涌现并改变焦点。
让我们来评估 BLOOM 在这一竞争激烈的领域中是否仍然站得住脚。
结语
本文概述了 BLOOM 项目,这一成果为大型语言模型这一不断演进的领域做出了重要贡献。
我们探讨了 BLOOM 的发展历程,重点介绍其技术规格与背后的协作机制。本文亦作为指南,帮助读者获取并有效使用 BLOOM,同时强调其适用场景与局限性。
此外,文章还覆盖了 BLOOM 项目的伦理影响与现实影响,反映其在当今 AI 领域的反响与相关性。无论您是否直接参与 AI 工作,抑或仅是爱好者,对 BLOOM 的这番探究都为您理解大型语言模型这一复杂世界提供了关键视角。
如果您希望进一步深入前沿语言模型,我们的进阶课程《Large Language Models (LLMs) Concepts》将带您系统了解 LLM 的应用、训练方法、伦理考量与最新研究,释放 LLM 的全部潜力。