Courses
生成 AI の基本概念
2時間
117.2K
大規模言語モデル(LLM)の台頭は自然言語処理(NLP)分野を象徴するトレンドとなり、さまざまなアプリケーションで広く採用されています。しかし、この進歩はしばしば排他的で、資源の豊富な組織が開発した多くの LLM は一般にはアクセスできません。
この排他性は重要な問いを投げかけます。これらの強力な言語モデルへのアクセスを民主化する方法があるとしたら? ここで BLOOM の出番です。
本記事では、まずその誕生の経緯を詳しく説明し、次に BLOOM の技術仕様と使い方を解説し、最後にその限界と倫理的配慮を取り上げることで、BLOOM の全体像を紹介します。
BigScience Large Open-science Open-access Multilingual Language Model(略して BLOOM)は、言語モデル技術の民主化における大きな前進です。
米国を含む39か国から1200人以上が参加して共同開発された BLOOM は、グローバルな取り組みの産物です。Hugging Face とフランスの NLP コミュニティが協力する BigScience により統括され、地理的・制度的な垣根を越えています。
これはオープンソースのデコーダ専用 Transformer モデルで、1760億パラメータを持ち、ROOTS コーパス(59言語、内訳は46の自然言語と13のプログラミング言語にわたる数百のソースから成るデータセット)で学習されています。
以下は学習言語の分布を示す円グラフです。
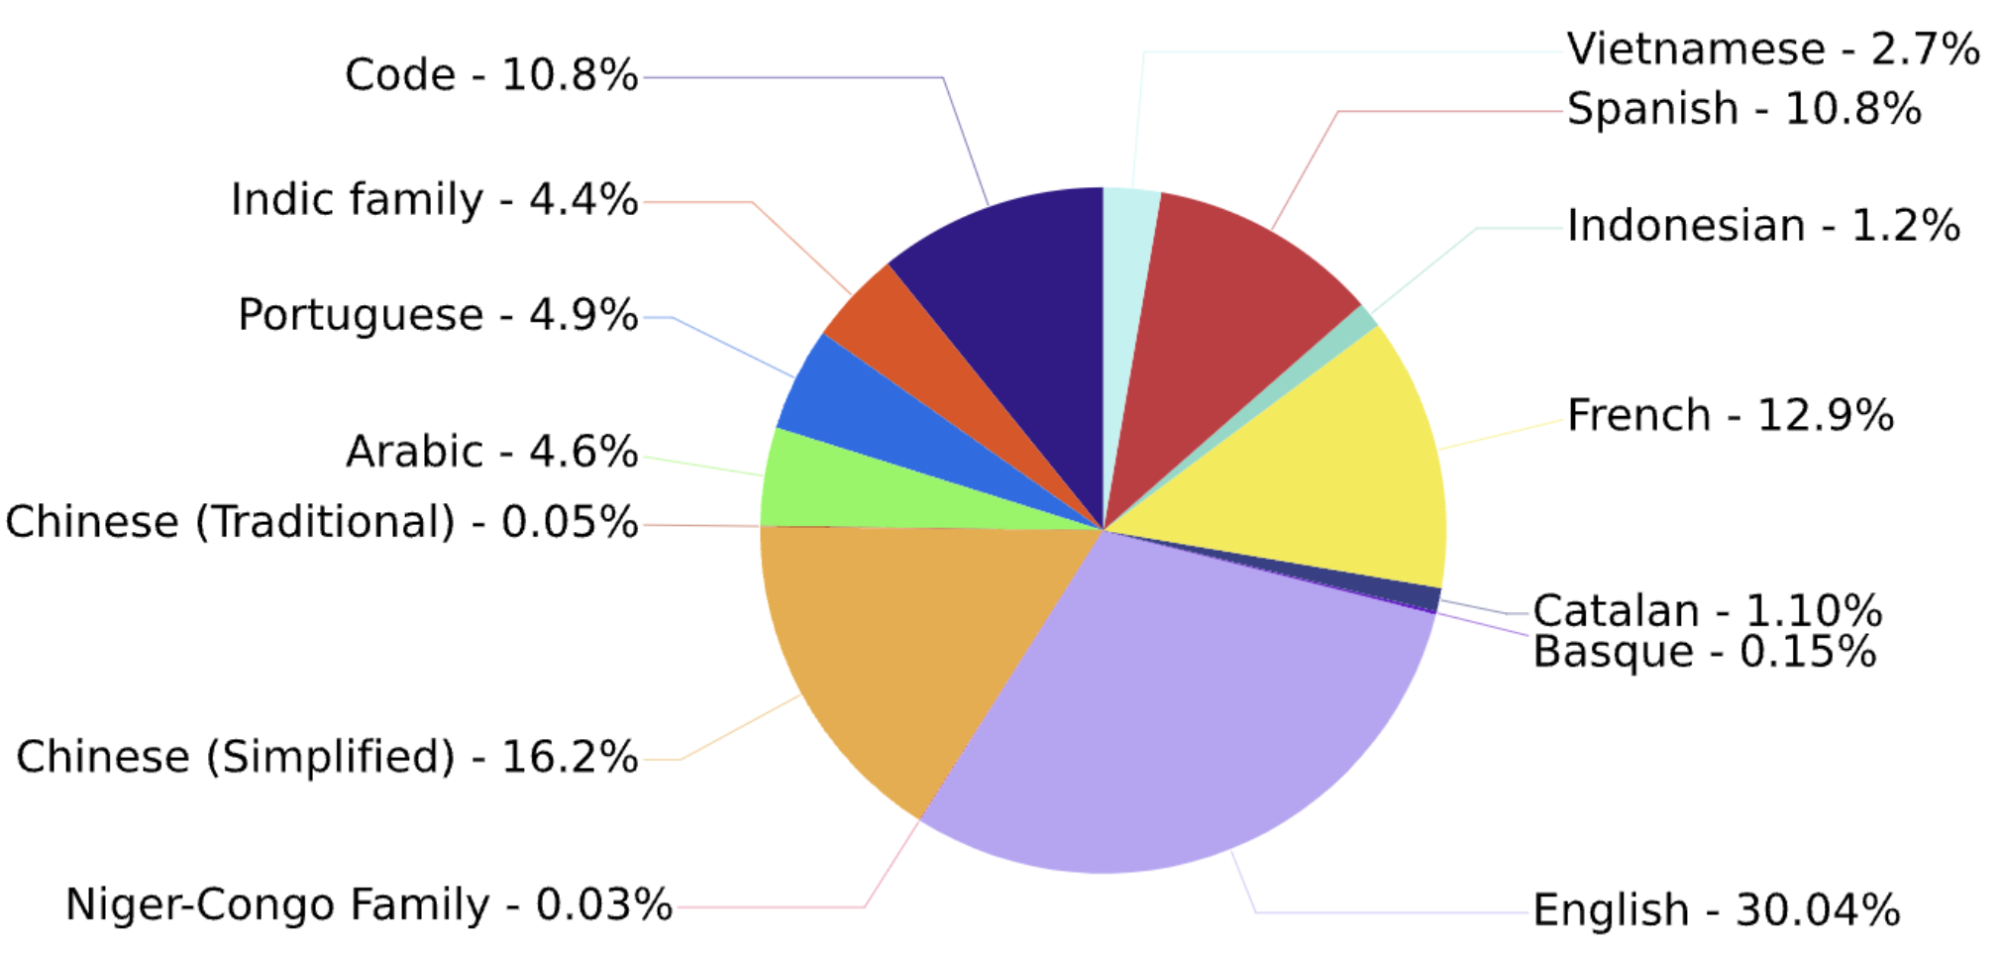
学習言語の分布(出典)
本モデルは多様なベンチマークで顕著な性能を示し、マルチタスクのプロンプト微調整後にはさらに良好な結果に到達しました。
プロジェクトは、CNRS と GENCI というフランスの研究機関からの大規模な計算資源助成を受け、パリの Jean Zay スパコン上で117日間(3月11日~7月6日)の学習を行って結実しました。
BLOOM は技術的偉業であると同時に、国際協力と科学の集合的追求の力の象徴でもあります。
ここでは BLOOM のアーキテクチャを、複数の要素に分けてもう少し詳しく説明します。
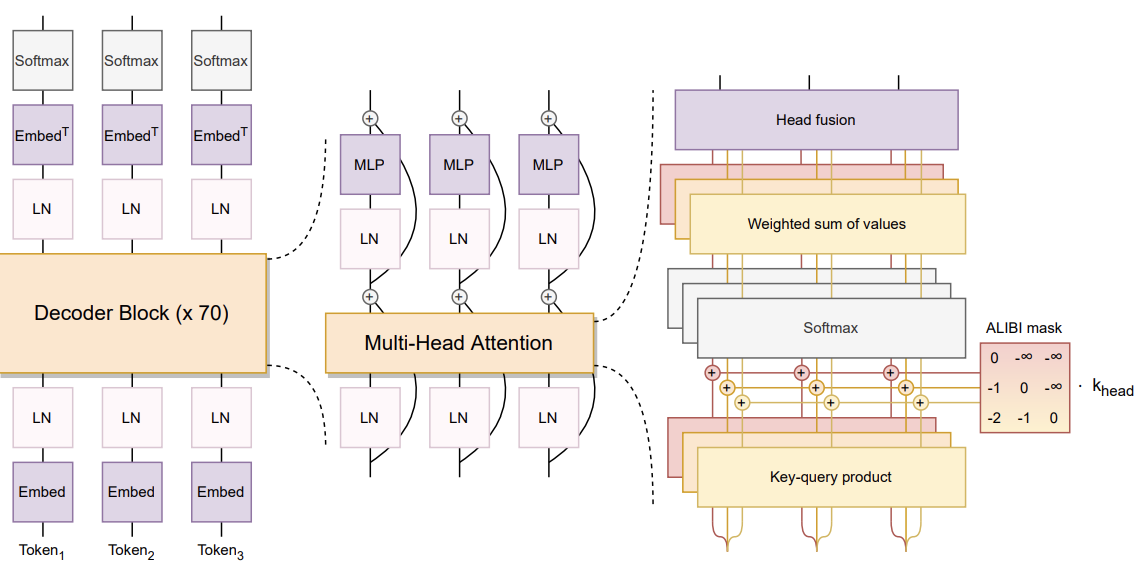
Bloom のアーキテクチャ(出典)
論文で詳述されている BLOOM のアーキテクチャには、いくつか注目すべき点があります。
これらの要素は、実証済みの手法と革新性のバランスを取りつつ、性能と安定性を最適化するというチームの方針を反映しています。
BLOOM のアーキテクチャ要素に加えて、関連する2つの要素、データ前処理とプロンプト付きデータセットについても理解しておきましょう。
この例では、BLOOM を使って創作ストーリーを生成します。以下のコードは、環境のセットアップ、モデルの準備、与えられたプロンプトに基づくテキスト生成という構成になっています。対応するソースコードは GitHub で公開されており、amrrs の チュートリアル に強く着想を得ています。
BLOOM はリソース要求が大きいため、ワークスペースを適切に構成することが重要です。主な手順は以下のとおりです。
まず、transformer ライブラリを使用して BLOOM などの Transformer 系モデルを扱うためのインターフェースを提供します。
!pip install transformers -qnvidia-smi を使って、利用可能な GPU の特性を確認し、モデルを実行するのに必要な計算資源があるか検証します。
!nvidia-smi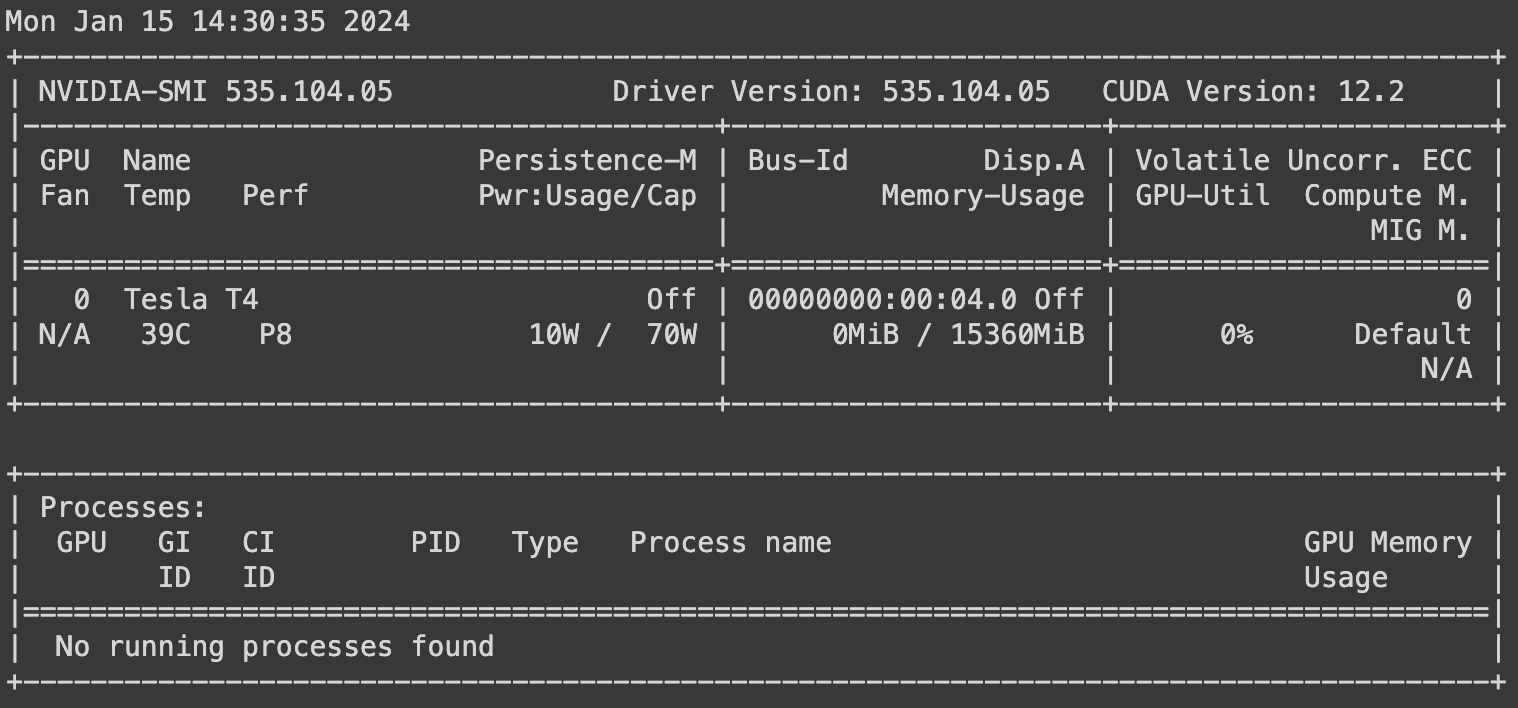
次に、transformers と torch から必要なモジュールをインポートします。torch は GPU アクセラレーションを活用するためにデフォルトのテンソル型を設定するのに使用します。
GPU を使用するため、torch ライブラリの set_default_tensor_type 関数で GPU を使うように設定します。
from transformers import AutoModelForCausalLM, AutoTokenizer, set_seed
import torch
torch.set_default_tensor_type(torch.cuda.FloatTensor)ここで使用するのは 7 億(1b7)のパラメータを持つ BLOOM モデルで、BigScience の Hugging Face リポジトリの bigscience/bloom-1b7 という識別子で利用できます。
model_ID = "bigscience/bloom-1b7"続いて、Hugging Face から事前学習済みの BLOOM モデルとトークナイザーを読み込み、set_seed 関数で再現性のための乱数シードを任意の整数で設定します。数値自体の値は重要ではありませんが、浮動小数ではない値を使用することが大切です。
オープンソースの Python フレームワークである LangChain により、大規模言語モデルの潜在能力を活用する方法については、チュートリアル How to Build LLM Applications with LangChain Tutorial をご覧ください。
また、データエンジニアの方でデータアプリケーションにおける LangChain の活用に関心がある場合は、記事 Introduction to LangChain for Data Engineering & Data Applications で、LangChain が解決する課題やデータ関連のユースケース例を含む概要を紹介しています。
model = AutoModelForCausalLM.from_pretrained(model_ID, use_cache=True)
tokenizer = AutoTokenizer.from_pretrained(model_ID)
set_seed(2024)
次に、生成するストーリーのタイトルとプロンプトを定義します。
story_title = 'An Unexpected Journey Through Time'
prompt = f'This is a creative story about {story_title}.\n'
最後に、プロンプトをトークナイズして適切なデバイスにマップし、デコード後にモデルの出力を生成します。
input_ids = tokenizer(prompt, return_tensors="pt").to(0)

sample = model.generate(**input_ids,
                        max_length=200, top_k=1,
                        temperature=0, repetition_penalty=2.0)

generated_story = tokenizer.decode(sample[0], skip_special_tokens=True)
最終結果は textwrap モジュールで整形し、読みやすさのため1行あたり最大80文字となるようにします。
import textwrap
wrapper = textwrap.TextWrapper(width=80)
formated_story = wrapper.fill(text=generated_story)
print(formated_story)最終結果は次のとおりです。
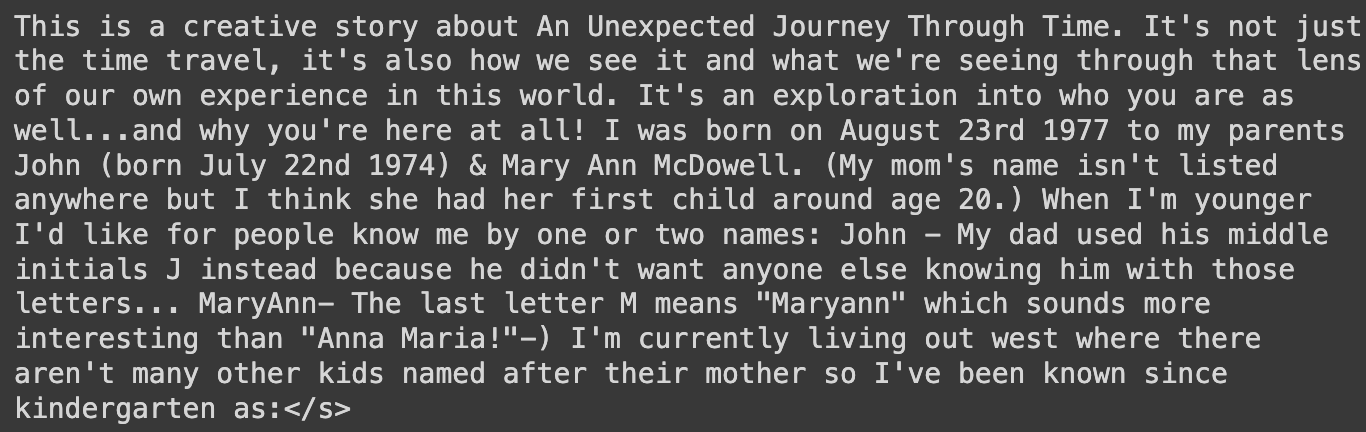
BLOOM モデルで生成したストーリー
わずかなコードで、BLOOM を用いて意味のあるコンテンツを生成できました。
PyTorch を使って大規模言語モデルを学習するプロセスを、初期セットアップから最終実装まで習得したい方には、チュートリアル How to Train an LLM with PyTorch が目標達成のための完全なガイドとなります。
あらゆる技術の進歩と同様に、BLOOM にも適切な用途と不適切な用途があります。本節では、その能力を最大限に活用できる場面と注意が必要な場面を掘り下げます。これらの境界を理解することは、BLOOM の可能性を責任ある形で効果的に活用するうえで不可欠です。
BLOOM は、言語処理と生成の限界を押し広げるために設計された多用途のツールです。その想定用途は多岐にわたり、いずれも広範な言語能力を活かします。
BLOOM の限界を理解することは、倫理的かつ実務的な運用のために重要です。主に倫理面や技術的制約により、BLOOM LLM の想定範囲外となるユースケースがあります。
先進的な大規模言語モデル(LLM)である BLOOM は、多様なユーザー層に幅広い利点をもたらします。その能力は、特定の専門家やセクターに直接影響するだけでなく、より広い関係者にも間接的な影響を及ぼします。
本節では、BLOOM のユーザー像を探り、この革新的ツールを各層がどのように活用し、影響を受けているかを明らかにします。
BLOOM の直接ユーザーと間接ユーザーを理解することで、モデルの広範な影響力と、技術と社会の前進に寄与する多様な形を把握できます。
他の大規模言語モデル(LLM)と同様、BLOOM の導入には多様な倫理的配慮と限界が伴います。これらは責任ある利用のため、また技術の広範な影響を見越すために重要です。本節では、BLOOM の使用に伴う倫理的含意、リスク、内在的な限界を扱います。
BLOOM の開発と公開は、影響と論争の両面で実社会に重要な含意を持ちます。本節では、BLOOM 論文の見識に基づいてこれらを論じます。
スピードの速い人工知能(AI)の世界では、BLOOM のような大規模言語モデル(LLM)の有用性は継続的に議論されています。
国際的な大規模チームにより開発された BLOOM は、言語処理における大きな飛躍でした。しかし AI の状況は常に進化しており、新しいモデルの登場により焦点も移り変わります。
BLOOM がこの競争領域で今も地位を保っているかを見ていきましょう。
本記事では、進化を続ける大規模言語モデル分野への重要な貢献である BLOOM プロジェクトの概要を紹介しました。
BLOOM の開発について、その技術仕様と共同開発の取り組みを取り上げました。また、BLOOM へのアクセス方法と効果的な活用法をガイドし、適切な用途と限界を強調しました。
さらに、BLOOM AI プロジェクトの倫理的含意と実社会への影響を扱い、今日の AI 情勢における受け止め方と有用性について考察しました。AI に直接関わっている方も愛好家の方も、BLOOM の探究は大規模言語モデルという複雑な世界を歩むうえで不可欠な視点を提供します。
先進的な言語モデルへの理解をさらに深めたい方には、追加コース Large Language Models (LLMs) Concepts をおすすめします。LLM のアプリケーション、学習手法、倫理的配慮、最新研究を扱うコンセプトコースで、LLM の可能性を余すことなく探求できます。
今日から AI の学習を始めましょう!
Courses
Courses
Courses