course
Concepte de AI generativ
2 oră
117.2K
Ascensiunea modelelor lingvistice mari (LLM) a fost o tendință definitorie în domeniul Procesării Limbajului Natural (NLP), ducând la adoptarea lor pe scară largă în diverse aplicații. Totuși, acest progres a fost adesea unul exclusivist, majoritatea LLM-urilor dezvoltate de organizații cu resurse rămânând inaccesibile publicului.
Această exclusivitate ridică o întrebare importantă: ce-ar fi dacă am putea democratiza accesul la aceste modele lingvistice puternice? Aici intră în scenă BLOOM.
Acest articol oferă o prezentare completă a ceea ce este BLOOM, începând cu detalii despre geneza sa. Apoi trece prin specificațiile tehnice ale BLOOM și modul de utilizare, înainte de a evidenția limitările și considerațiile etice.
BigScience Large Open-science Open-access Multilingual Language Model (prescurtat BLOOM) reprezintă un progres considerabil în democratizarea tehnologiei modelelor lingvistice.
Dezvoltat colaborativ de peste 1200 de participanți din 39 de țări, inclusiv un număr semnificativ din Statele Unite, BLOOM este produsul unui efort global. Coordonat de BigScience în colaborare cu Hugging Face și comunitatea franceză de NLP, acest proiect transcende granițe geografice și instituționale.
Este open-source și este un model transformer doar cu decodor, cu 176 de miliarde de parametri, antrenat pe corpusul ROOTS, un set de date din sute de surse în 59 de limbi: 46 de limbi vorbite și 13 limbaje de programare.
Mai jos este diagrama tip plăcintă a distribuției limbilor de antrenare.
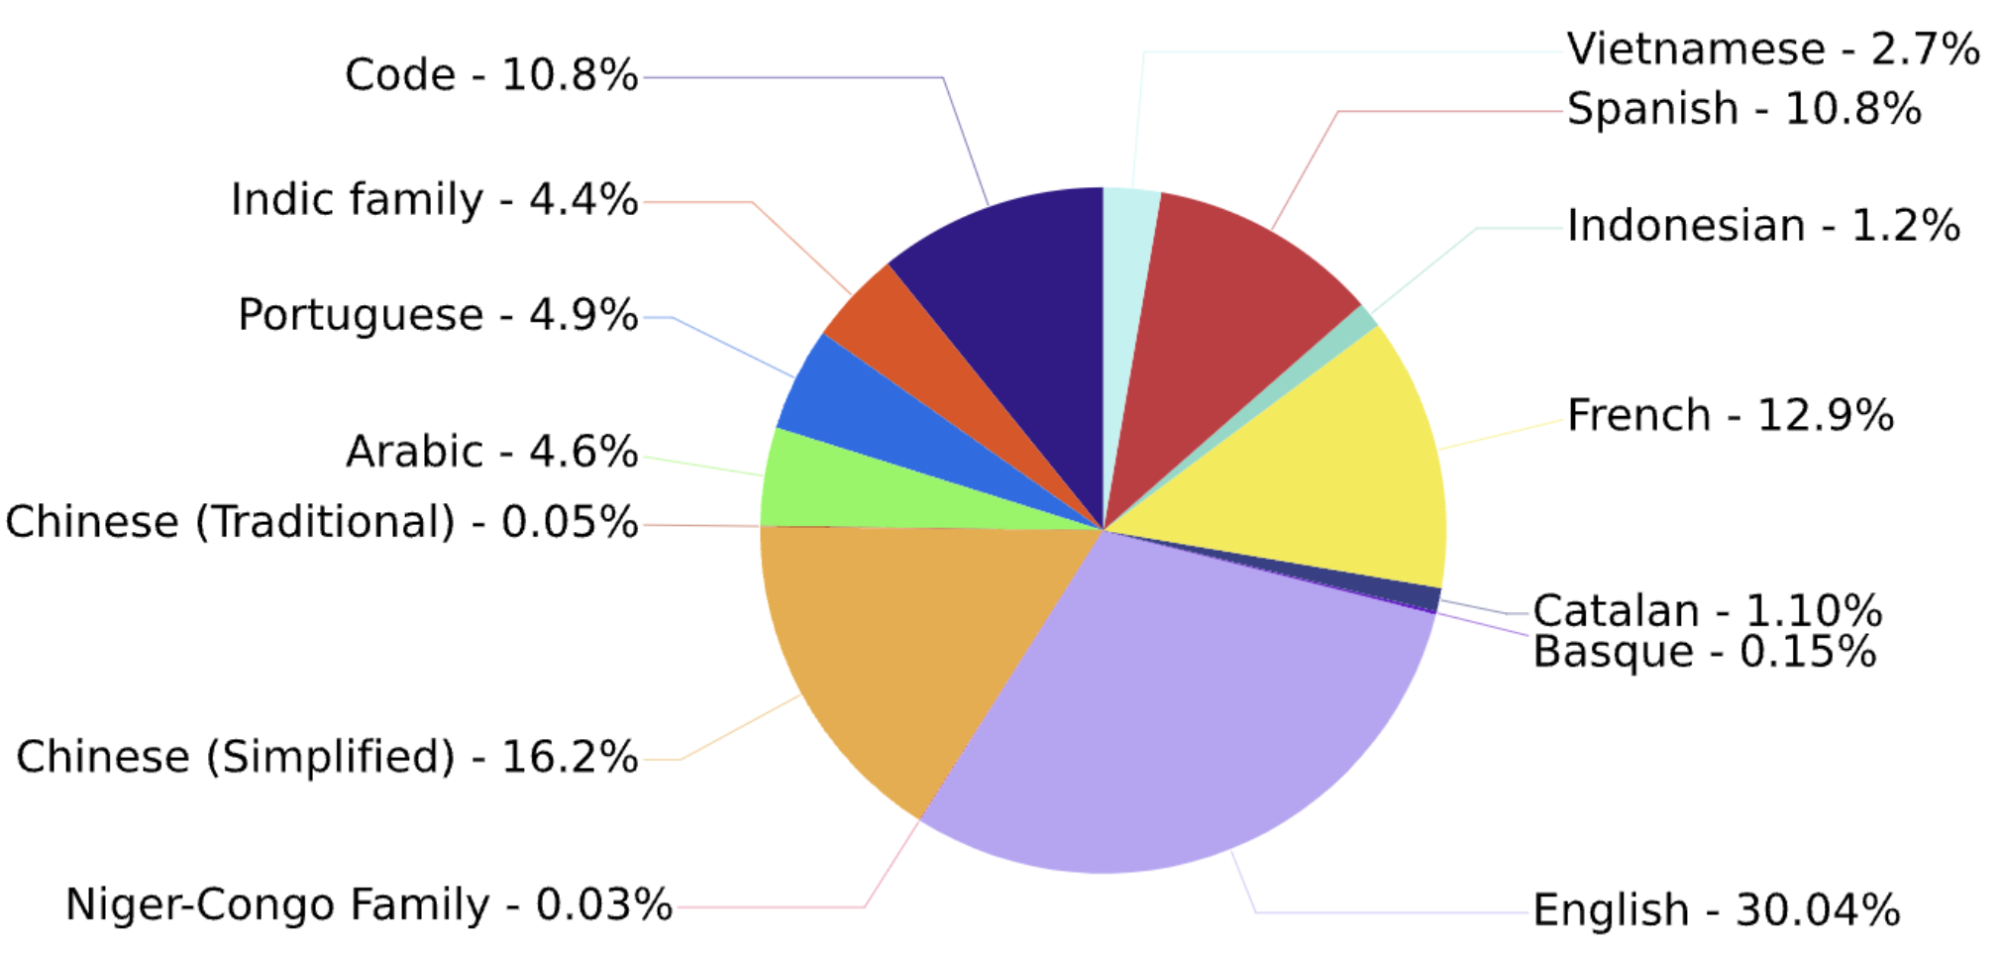
Distribuția limbilor de antrenare (sursă)
S-a constatat că modelul obține performanțe remarcabile pe o mare varietate de benchmarkuri și a atins rezultate mai bune după finetuning cu prompturi multitask.
Proiectul a culminat cu o sesiune de antrenare de 117 zile (11 martie – 6 iulie) pe supercomputerul Jean Zay din Paris, susținută de un grant substanțial de calcul din partea agențiilor franceze de cercetare CNRS și GENCI.
BLOOM nu este doar un miracol tehnologic, ci și un simbol al cooperării internaționale și al puterii efortului științific colectiv.
Acum, hai să descriem arhitectura BLOOM într-un mod mai detaliat, care implică mai multe componente.
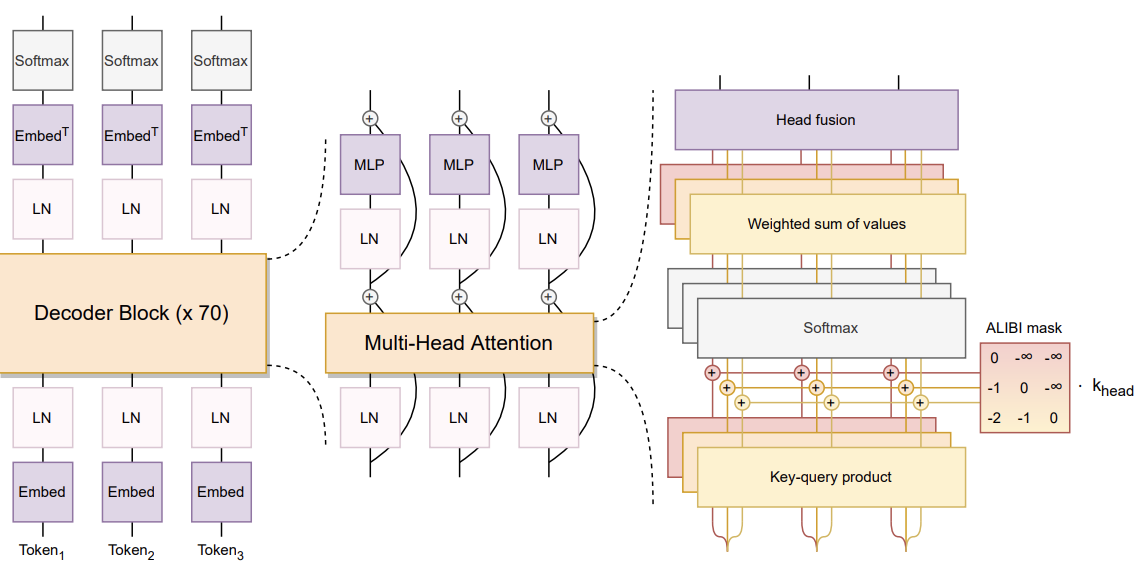
Arhitectura Bloom (sursă)
Arhitectura modelului BLOOM, așa cum este detaliată în lucrare, include câteva aspecte notabile:
Aceste componente reflectă accentul echipei pe echilibrarea inovației cu tehnici validate pentru a optimiza performanța și stabilitatea modelului.
Pe lângă componentele de arhitectură ale BLOOM, să înțelegem încă două componente relevante: preprocesarea datelor și seturile de date cu prompturi.
În acest exemplu, vom folosi BLOOM pentru a genera o poveste creativă. Codul oferit este structurat pentru a configura mediul, a pregăti modelul și a genera text pe baza unui prompt dat. Codul sursă aferent este disponibil pe GitHub și este puternic inspirat de tutorialul lui amrrs.
Modelul BLOOM consumă multe resurse, așadar o configurare corectă a spațiului de lucru este esențială, iar pașii principali sunt descriși mai jos.
Mai întâi, biblioteca transformer este folosită pentru a furniza interfețe de lucru cu modelul BLOOM și, în general, cu alte modele bazate pe transformer.
!pip install transformers -qFolosind nvidia-smi, verificăm proprietățile GPU-ului disponibil pentru a ne asigura că avem resursele de calcul necesare pentru a rula modelul
!nvidia-smi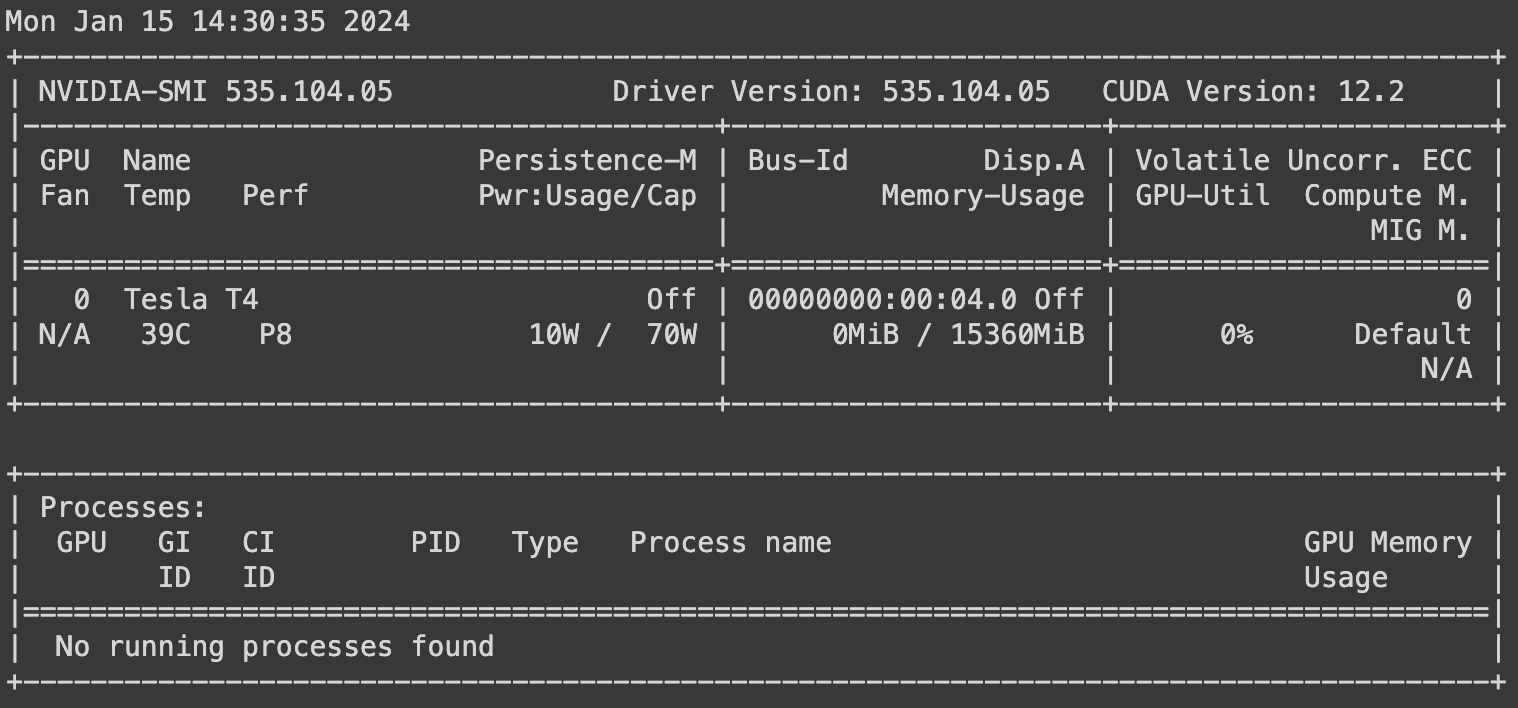
Importăm modulele necesare din transformers și torch. torch este folosit pentru a seta tipul implicit de tensori, pentru a valorifica accelerarea pe GPU.
Apoi, deoarece folosim un GPU, biblioteca torch este configurată prin funcția set_default_tensor_type pentru a asigura utilizarea GPU-ului.
from transformers import AutoModelForCausalLM, AutoTokenizer, set_seed
import torch
torch.set_default_tensor_type(torch.cuda.FloatTensor)Modelul țintă folosit este varianta BLOOM cu 7 miliarde de parametri, accesibil din depozitul BigScience de pe Hubbing Face sub bigscience/bloom-1b7, care corespunde identificatorului unic al modelului.
model_ID = "bigscience/bloom-1b7"În continuare, încărcăm modelul BLOOM pre-antrenat și tokenizerul de pe Hugging Face și setăm sămânța pentru reproductibilitate folosind funcția set_seed cu orice număr. Valoarea numărului în sine nu contează, dar este important să folosești o valoare nenfractoară.
Pentru a afla mai multe despre potențialul neexploatat al modelelor lingvistice mari cu LangChain, un framework Python open-source pentru construirea de aplicații AI avansate, tutorialul nostru Cum să construiești aplicații LLM cu LangChain este ghidul potrivit.
Mai mult, dacă ești data engineer și te interesează utilizarea LangChain pentru aplicații de date, articolul nostru Introducere în LangChain pentru ingineria datelor și aplicații de date oferă o privire de ansamblu asupra a ceea ce poți face cu LangChain, inclusiv problemele pe care le rezolvă și exemple de cazuri de utilizare pe date.
model = AutoModelForCausalLM.from_pretrained(model_ID, use_cache=True)
tokenizer = AutoTokenizer.from_pretrained(model_ID)
set_seed(2024)
Acum, putem defini titlul poveștii care va fi generată, împreună cu promptul.
story_title = 'An Unexpected Journey Through Time'
prompt = f'This is a creative story about {story_title}.\n'
În final, tokenizăm promptul și îl mapăm pe dispozitivul potrivit al modelului, înainte de a genera rezultatul modelului după decodare.
input_ids = tokenizer(prompt, return_tensors="pt").to(0)

sample = model.generate(**input_ids,
                        max_length=200, top_k=1,
                        temperature=0, repetition_penalty=2.0)

generated_story = tokenizer.decode(sample[0], skip_special_tokens=True)
Rezultatul final este formatat folosind modulul textwrap, pentru a te asigura că numărul maxim de caractere pe linie este 80, pentru o lizibilitate mai bună.
import textwrap
wrapper = textwrap.TextWrapper(width=80)
formated_story = wrapper.fill(text=generated_story)
print(formated_story)Rezultatul final este redat mai jos:
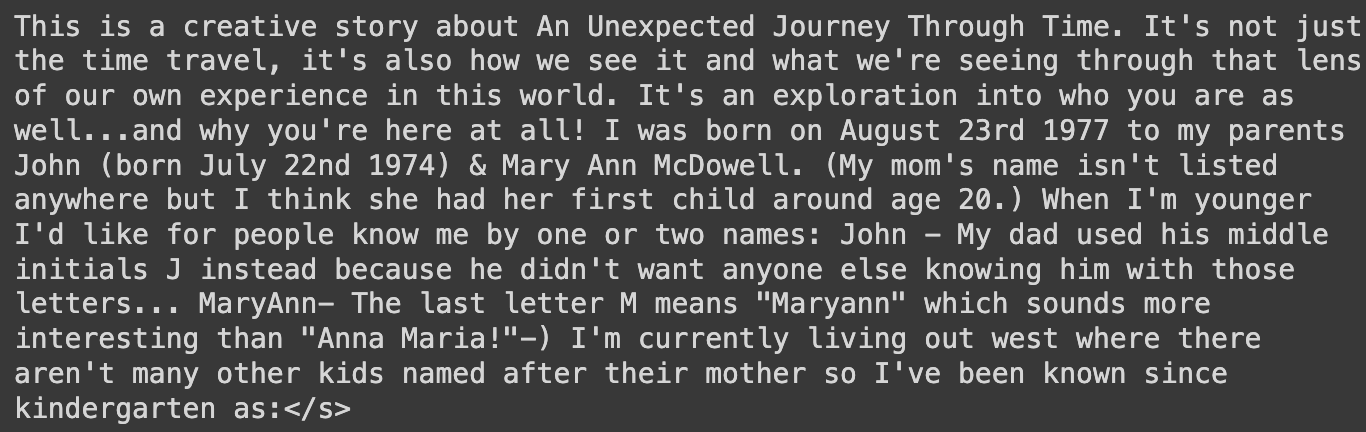
Poveste generată folosind modelul BLOOM
Cu doar câteva linii de cod, am reușit să generăm conținut semnificativ folosind modelul BLOOM.
Dacă vrei să stăpânești procesul de antrenare a modelelor lingvistice mari folosind PyTorch, de la configurarea inițială până la implementarea finală, tutorialul nostru Cum să antrenezi un LLM cu PyTorch oferă un ghid complet pentru atingerea acestui obiectiv.
Ca orice progres tehnologic, BLOOM vine cu propriul set de aplicații potrivite și nepotrivite. Această secțiune aprofundează cazurile de utilizare adecvate și inadecvate, evidențiind unde potențialul său poate fi valorificat cel mai bine și unde e nevoie de prudență. Înțelegerea acestor limite este esențială pentru a valorifica potențialul BLOOM în mod responsabil și eficient.
BLOOM este un instrument versatil conceput pentru a împinge limitele procesării și generării de limbaj. Utilizările sale intenționate acoperă diverse domenii, valorificându-i capacitățile lingvistice extinse.
Înțelegerea limitărilor BLOOM este esențială pentru a-i asigura aplicarea etică și practică. Unele cazuri de utilizare ies din sfera a ceea ce își propune BLOOM LLM, în principal din considerente etice sau constrângeri tehnice.
BLOOM, ca model lingvistic mare (LLM) avansat, oferă o gamă largă de beneficii care se extind către diverse grupuri de utilizatori. Capabilitățile sale influențează direct anumiți profesioniști și sectoare, dar au și un efect mai larg, impactând indirect o gamă mai variată de părți interesate.
Această explorare a utilizatorilor BLOOM își propune să evidențieze cum diferite grupuri valorifică și sunt afectate de acest instrument inovator.
Înțelegând utilizatorii direcți și indirecți ai BLOOM, putem aprecia influența sa extinsă și modurile diverse în care contribuie la avansarea tehnologiei și societății.
Implementarea BLOOM, ca orice model lingvistic mare (LLM), aduce cu sine o serie de considerații etice și limitări. Aceste aspecte sunt cruciale pentru o utilizare responsabilă și pentru a anticipa impactul mai larg al tehnologiei. Această secțiune abordează implicațiile etice, riscurile și limitările inerente asociate utilizării BLOOM.
Dezvoltarea și lansarea BLOOM au implicații semnificative în lumea reală, atât în ceea ce privește impactul, cât și controversele pe care le ridică. Această secțiune discută aceste aspecte, bazându-se pe perspectivele din lucrarea de cercetare BLOOM.
În lumea accelerată a inteligenței artificiale (AI), relevanța modelelor lingvistice mari (LLM) precum BLOOM este un subiect de discuție continuă.
Dezvoltat de o echipă vastă de cercetători internaționali, BLOOM a reprezentat un salt important înainte în procesarea limbajului. Totuși, peisajul AI evoluează constant, cu modele noi care apar și mută centrul de greutate.
Să analizăm dacă BLOOM își păstrează poziția în acest domeniu competitiv.
Acest articol a oferit o prezentare a proiectului BLOOM, o contribuție semnificativă la domeniul în continuă evoluție al modelelor lingvistice mari.
Am explorat dezvoltarea BLOOM, evidențiind specificațiile tehnice și colaborarea din spatele creării sale. Articolul a servit, de asemenea, drept ghid pentru accesarea și utilizarea eficientă a BLOOM, subliniind utilizările potrivite și limitările.
În plus, am acoperit implicațiile etice și impactul în lumea reală al proiectului BLOOM AI, reflectând asupra receptării și relevanței sale în peisajul AI de astăzi. Fie că ești implicat direct în AI sau pasionat de domeniu, această explorare a BLOOM oferă perspective esențiale pentru a naviga în lumea complexă a modelelor lingvistice mari.
Pentru cei care vor să își aprofundeze implicarea în modelele lingvistice avansate, cursul nostru suplimentar, Concepte despre modelele lingvistice mari (LLM), oferă o cale de a descoperi întregul potențial al LLM-urilor cu un curs conceptual care acoperă aplicațiile LLM, metodologiile de antrenare, considerațiile etice și cele mai recente cercetări.
Începe-ți călătoria în AI chiar azi!
course
course
course