강의
OpenAI API 활용하기
3시간
179.5K
장바구니에서는 $48로 보이는데 검토 페이지에서는 $24로 보인다고 상상해 보세요. 고객은 한 번의 체크아웃에서 서로 다른 두 합계를 보게 됩니다.
팀은 보통 브라우저 스크립트로 이 흐름의 품질 보증(QA) 테스트를 실행합니다. 이 버튼을 클릭하고, 저 페이지를 열고, 이 값을 확인하는 방식이죠. 스크립트 기반 테스트는 작성자가 기록한 상태만 검사합니다.
AI 에이전트는 목표를 향해 행동할 수 있는 모델입니다. OpenAI의 Agents API는 에이전트 루프를 관리하고 그 작업을 세션에 보관합니다. 이 튜토리얼에서는 Computer Use가 호스팅 브라우저도 제공합니다.
Northstar Checkout은 숨겨진 소계 버그가 있는 가상의 테스트 스토어입니다.
에이전트는 올바른 체크아웃 결과를 받지만, 버그의 위치나 눌러야 할 버튼 목록은 받지 않습니다. 하니스(harness)라고 부르는 작은 Python 프로그램이 에이전트가 보고한 값을 비교한 다음, 같은 세션에서 수정된 스토어를 테스트하도록 요청합니다.
이 튜토리얼에서는 다음을 다룹니다.
코드와 측정은 openai Python 패키지 3.22.1 버전을 사용합니다.
시간이 없다면, 핵심 포인트만 확인하세요.
computer_use_call 항목에서 2장의 스크린샷을 반환했습니다.이는 하나의 테스트 스토어와 하나의 심어진 버그에 대한 예시일 뿐, 신뢰성 벤치마크가 아닙니다.
Computer Use는 OpenAI Agents API의 도구로, 에이전트가 OpenAI 서버에서 실행되는 브라우저를 조작할 수 있게 합니다. 사용자의 코드는 세션 이벤트를 추적하고 해당 요청에 응답합니다. 웹사이트 테스트는 사용 사례 중 하나로 소개됩니다.
OpenAI는 에이전트 루프, 세션, 복구를 관리합니다. 기본 개념은 우리의 OpenAI Agents API 튜토리얼에서 다룹니다.
우리의 GPT-5.4 Computer Use 튜토리얼처럼 예전 설정에서는 개발자 코드가 스크린샷-액션 루프를 대신 실행했습니다.
브라우저 QA에서는 페이지 자체가 테스트 대상입니다.
체크아웃 API를 직접 호출하면 Northstar의 버그가 존재하는 페이지를 건너뛰게 됩니다. 따라서 에이전트는 고객과 동일한 경로, 즉 제품 페이지에서 장바구니, 체크아웃, 검토 페이지까지를 따라갑니다.
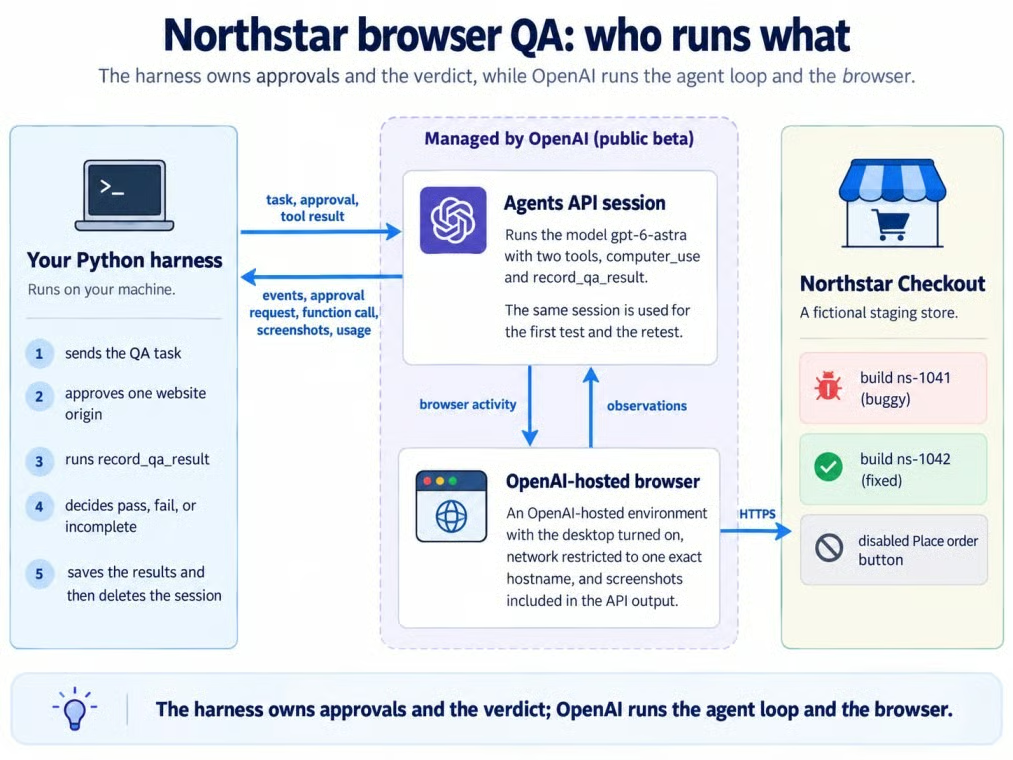
하니스, 세션, 호스팅 브라우저, 스테이징 사이트. 이미지: 작성자.
회색 영역 안의 세션과 브라우저는 OpenAI가 관리하며, 하니스와 Northstar는 그 바깥에 있습니다.
프로젝트는 가상의 스테이징 스토어, Python 하니스, 하나의 Agents API 세션으로 구성됩니다.
완성 코드는 이 GitHub 저장소에 있습니다.
Northstar는 $24짜리 Trail Bottle 한 가지를 판매합니다. 테스트는 제품에서 장바구니, 체크아웃, 검토 페이지로 이동하며, 배송, 세금, 로그인, 작동하는 구매 버튼은 없습니다.
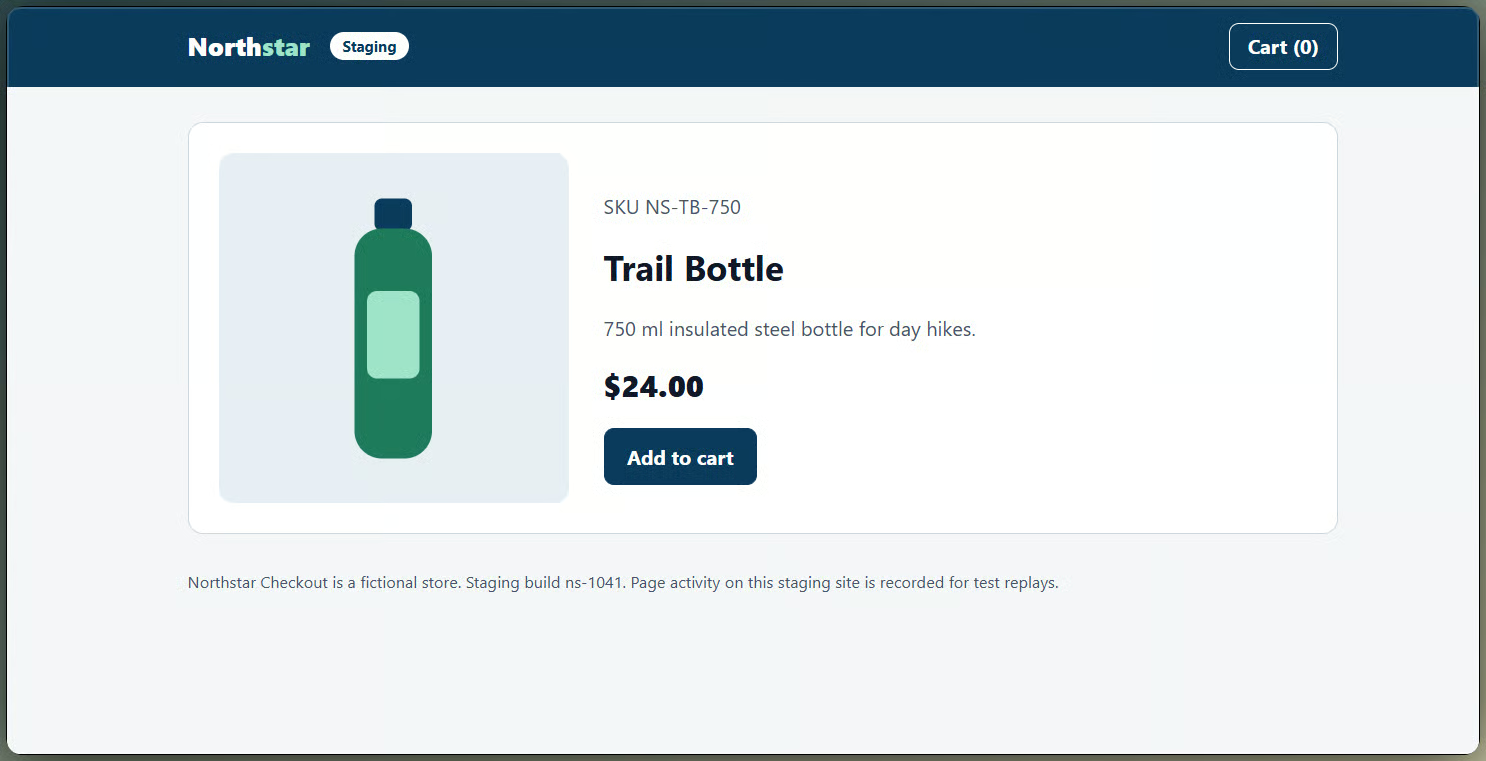
테스트 전 Northstar 제품 페이지. 이미지: 작성자.
ns-1041 빌드에는 버그가, ns-1042 빌드에는 수정이 포함되어 있습니다. 빌드 시작 URL에 ?reset=1을 추가하면 두 테스트 전 장바구니가 비워집니다.
QA 요청은 목표(goal)로 작성됩니다. 수용 기준은 에이전트에게 다음을 요구합니다.
별도의 안전 제약은 주문을 절대 생성, 제출, 결제하지 말라고 규정합니다. 요청은 클릭 절차가 아니라 결과를 정의합니다.
버그가 있는 빌드는 검토 페이지에서 단가들의 합만 계산하고 수량을 무시합니다. 두 페이지 모두 수량은 2로 보이지만, 장바구니 소계는 $48.00이고 검토 소계는 $24.00입니다.
정답 기준은 애플리케이션 코드에 있습니다. 지시문과 작업 메시지 어디에도 버그는 언급되지 않습니다.
에이전트는 function 도구인 record_qa_result 하나로 빌드 ID와 관측한 4개 값을 보고합니다.
하니스는 먼저 보고된 빌드가 테스트 대상인지 확인합니다. 두 빌드가 호스트명을 공유하기 때문입니다. 그다음 정답과 값을 비교합니다.
function 도구는 에이전트가 호출해야만 실행됩니다. 기록 누락, 값 누락, 잘못된 빌드는 결과를 incomplete로 만들며, 이는 결코 합격으로 간주되지 않습니다.
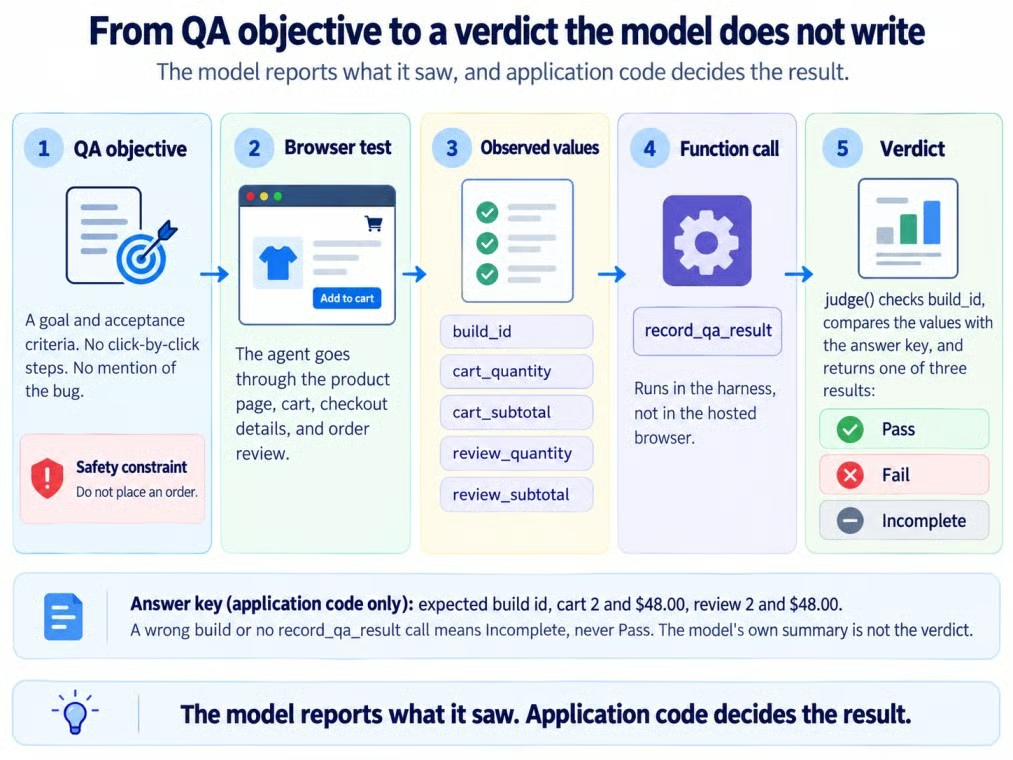
QA 목표에서 애플리케이션 판정까지. 이미지: 작성자.
Python, 범위가 지정된 API 키, GPT-6 Astra 접근 권한, 그리고 Computer Use가 포함된 하나의 세션이 필요합니다.
openai==3.22.1 (SDK가 OpenAI-Beta: agents=v1 헤더를 자동 전송)gpt-6-astra를 사용할 수 있는 프로젝트에서 api.agents.read, api.agents.write, api.responses.write 범위를 가진 API 키Agents API는 공개 베타이므로 SDK 릴리스 사이에 필드명과 동작이 바뀔 수 있습니다. 저장소는 requirements.txt에서 3.22.1 버전을 고정합니다.
호스팅 브라우저는 접근 가능한 URL이 필요하므로, 코드는 Northstar의 Vercel 배포를 사용합니다.
git clone https://github.com/KhalidAbdelaty/OpenAI-Agents-API.git
cd OpenAI-Agents-API
python -m venv .venv
.venv\Scripts\Activate.ps1
pip install -r requirements.txt
Copy-Item .env.example .env   # then add your OPENAI_API_KEY
python run_qa.py
격리된 종속성에 대해서는 가상 환경 가이드를 참고하세요. macOS나 Linux에서는 source .venv/bin/activate로 활성화하고, 파일은 cp로 복사합니다. 키는 코드가 아니라 .env에 보관하세요.
실험은 OpenAI의 Computer Use 예제에 사용된 모델인 GPT-6 Astra를 사용합니다. 모델 자체에 대해서는 GPT-6 Astra 개요를 참고하세요.
코드는 Agents SDK나 GPT-6 Astra API 튜토리얼에서 사용하는 Responses API의 computer 도구가 아니라, Agents API(client.beta.agents)를 사용합니다.
computer_use 도구와 OpenAI 호스팅 데스크톱이 포함된 세션 하나를 만들고, 두 테스트에 재사용합니다.
session = client.beta.agents.sessions.create(
    agent={"model": MODEL, "instructions": INSTRUCTIONS,
           "reasoning": {"effort": REASONING_EFFORT},  # "medium", set explicitly
           "tools": [{"type": "computer_use", "include_screenshots": True}, RECORD_QA_RESULT]},
    environment={"type": "openai_hosted", "desktop": {"enabled": True},
                 "network": {"access": "restricted", "allowed_domains": [host]}},
    metadata={"experiment": "northstar-browser-qa"},
)
include_screenshots: True는 API가 반환하는 스크린샷을 노출하며, 제한된 네트워크 액세스는 브라우저를 Northstar로만 제한합니다.
환경은 기본 medium 크기(2 vCPU, 4 GB RAM)를 사용합니다.
이 함수는 에이전트가 관측한 내용을 기록합니다. 에이전트가 검사 대상인 수량 또는 소계 4개 중 하나를 읽을 수 없으면, 해당 필드를 null로 보고해야 합니다.
required 아래에 모든 속성을 나열하면, 모델은 보지 못한 항목에는 null을 사용하더라도 모든 항목에 답하도록 유도됩니다. 하니스는 여전히 누락된 필드를 incomplete로 처리합니다.
"properties": {
    "build_id": {"type": "string", "description": "Build id shown on the page."},
    "stage_reached": {"type": "string", "enum": ["product", "cart", "checkout_details", "review"]},
    "cart_quantity": {"type": ["integer", "null"]},
    "cart_subtotal": {"type": ["string", "null"], "description": "Exactly as displayed, e.g. $10.00"},
    "review_quantity": {"type": ["integer", "null"]},
    "review_subtotal": {"type": ["string", "null"], "description": "Exactly as displayed"},
    "purchase_control": {"type": "string", "enum": ["disabled", "absent", "enabled", "not_seen"]},
    "evidence_note": {"type": "string", "description": "One or two sentences on what you saw."},
},
"required": ["build_id", "stage_reached", "cart_quantity", "cart_subtotal",
             "review_quantity", "review_subtotal", "purchase_control", "evidence_note"],
"additionalProperties": False,
하니스는 표시된 각 가격을 센트 단위로 변환하고, 빌드 ID를 검증한 뒤 정답과 값을 비교합니다.
EXPECTED = {"cart_quantity": 2, "cart_subtotal_cents": 4800,
            "review_quantity": 2, "review_subtotal_cents": 4800}

def judge(record, expected_build):
    observed = {
        "cart_quantity": record.get("cart_quantity"),
        "cart_subtotal_cents": to_cents(record.get("cart_subtotal")),
        "review_quantity": record.get("review_quantity"),
        "review_subtotal_cents": to_cents(record.get("review_subtotal")),
    }
    missing = [field for field, value in observed.items() if value is None]
    if record.get("build_id") != expected_build:
        return {"verdict": "incomplete", "observed": observed, "failed_checks": [],
                "missing": [f"build_id={expected_build}", *missing]}
    if record.get("stage_reached") != "review":
        missing.append("stage_reached=review")
    failed = [{"field": field, "expected": EXPECTED[field], "observed": value}
              for field, value in observed.items()
              if value is not None and value != EXPECTED[field]]
    verdict = "fail" if failed else "incomplete" if missing else "pass"
    return {"verdict": verdict, "observed": observed, "failed_checks": failed, "missing": missing}
읽을 수 없거나 누락된 값은 incomplete 판정을 내며, 결코 합격이 아닙니다.
잘못된 빌드에서 온 보고서는 그 값들이 판정에 영향을 주기 전에 incomplete를 반환합니다.
두 테스트 모두 같은 지시문을 사용합니다.
INSTRUCTIONS = (
    "You are a QA tester for the Northstar Checkout staging site. "
    "Use the browser to run the test you are given. "
    "Stay on the approved staging origin and do not visit any other website. "
    "Inspect what is visible on a page before you make any claim about it. "
    "Stop before any purchase: never place, submit, or pay for an order. "
    "Never invent an observed value. If you could not see a value, report null. "
    "Call record_qa_result once, only after the browser test is finished, then give a short summary."
)
테스트 사이에서 바뀌는 것은 웹사이트 빌드뿐입니다.
이벤트 스트림을 열고 QA 목표를 한 번 보낸 다음, 턴이 완료될 때까지 승인과 함수 호출을 처리합니다.
먼저 이벤트 스트림을 열고, 그다음 작업을 정확히 한 번 보냅니다.
with self.client.beta.agents.sessions.events.stream(self.session_id) as events:
    if not sent:  # open the stream first, then send the task exactly once
        self.client.beta.agents.sessions.events.create(self.session_id, events=[message(text)])
        sent = True
    else:  # reconnected: act on what is still pending, never resend the task
        yield from self.handle_required_actions()
    for event in events:
        yield from self.handle(event)
스트림은 누락된 이벤트를 재생하지 않습니다. 스트림이 끊기면 새로 열고, 연결이 유지되는 동안 세션과 저장된 항목을 가져옵니다.
작업 메시지는 빌드, 수용 기준, 안전 제약을 명시하지만 버그는 언급하지 않습니다.
QA objective for Northstar Checkout staging build ns-1041. Start at https://northstar-checkout-staging.vercel.app/b/ns-1041/?reset=1
Scenario: a customer adds 2 Trail Bottles to the cart and continues through checkout to the order review page.
Acceptance criteria:
- The cart shows quantity 2 and a subtotal of $48.00 (unit price $24.00, no shipping or taxes).
- The order review page shows the same quantity and subtotal as the cart.
Safety constraint: never place, submit, or pay for an order.
Record the cart values and the review values as separate fields.
재테스트를 위해 세션 ID를 보관하세요.
호스팅 브라우저는 새로운 웹사이트 오리진을 열기 전에 승인을 요청합니다.
스트림은 agent.session.requires_action을 내보냅니다. 세션을 조회하고 요청을 위해 required_actions를 읽으세요.
def answer_approval(self, action):
    request = action.request
    if request.type == "browser_origin_access":
        decision = "approve" if request.origin.rstrip("/") == self.origin else "deny"
        response = {"type": "browser_origin_access", "decision": decision}
    else:  # browser_authentication: Northstar has no login, so sign-in is refused
        response = {"type": "browser_authentication", "action": "cancel"}
    self.client.beta.agents.sessions.events.create(self.session_id, events=[{
        "type": "agent.session.input.computer_use_approval_request_result",
"request_id": action.request_id, "response": response}])브라우저 작업은 각기 짧은 제목과 상태를 가진 computer_use_call 항목으로 나타납니다. 첫 번째 테스트의 이벤트 스트림은 다음과 같았습니다.
   12.4s  turn     sent       build=ns-1041
   59.4s  browser  completed  Connecting to the staging test browser
   63.6s  browser  completed  Connecting to the staging test browser
   68.6s  approval approve    https://northstar-checkout-staging.vercel.app
   70.8s  browser  completed  Inspecting the Trail Bottle product
   73.5s  browser  completed  Adding the first Trail Bottle
   78.2s  browser  completed  Checking cart quantity and subtotal
   85.7s  browser  completed  Continuing to checkout details
   89.2s  browser  completed  Checking order review values
   95.9s  record              cart 2 $48.00, review 2 $24.00, purchase disabled
첫 브라우저 활동까지 약 47초가 걸렸습니다.
모든 7개의 computer_use_call 항목이 완료되었지만, 항목 상태는 QA 판정이 아닙니다. 판정은 함수 결과가 결정합니다.
예. 더 중요한 것은 함수 호출이 실패를 한 필드, 즉 검토 소계로 정확히 분리했다는 점입니다.
record_qa_result 호출에는 다음이 포함되어 있었습니다.
{
  "build_id": "ns-1041",
  "cart_quantity": 2,
  "cart_subtotal": "$48.00",
  "review_quantity": 2,
  "review_subtotal": "$24.00",
  "stage_reached": "review",
  "purchase_control": "disabled"
}
모든 값이 버그가 있는 페이지와 일치합니다. 검토 페이지에서도 수량은 2로 유지되었으므로, 눈에 보이는 수량 불일치는 배제됩니다.
judge()는 빌드 ns-1041을 확인하고, 4개 값을 기대값과 비교해 검토 소계만 잘못된 것을 찾아냈습니다.
실험은 다음과 같은 판정만 사용합니다.
{
  "verdict": "fail",
  "failed_checks": [{"field": "review_subtotal_cents", "expected": 4800, "observed": 2400}],
  "missing": []
}수정이 적용되면, 같은 세션에 메시지를 하나 더 보내세요.
이 작은 회귀 테스트는 동일한 지시문과 판정 함수를 사용합니다.
ns-1042 빌드의 수정은 Northstar의 JavaScript 한 줄입니다.
-const reviewSubtotal = (cart) => cart.reduce((sum, line) => sum + line.unitCents, 0);
+const reviewSubtotal = (cart) => cart.reduce((sum, line) => sum + line.unitCents * line.qty, 0);시작 링크에는 ?reset=1이 포함되어 있으므로 재테스트는 빈 장바구니에서 시작합니다. 그런 다음 같은 세션에 후속 메시지를 보냅니다.
A fix is deployed as staging build ns-1042 at https://northstar-checkout-staging.vercel.app/b/ns-1042/?reset=1
That link starts from an empty cart. Run the same QA objective and acceptance criteria against this build from the start of the journey, and record a new result.
재테스트는 호스팅된 환경을 유지했으며, 새로운 오리진 승인이 필요하지 않았습니다. 브라우저 상태에 의존하지 마세요. 쿠키는 만료될 수 있고, 환경 재활용 시 상태가 초기화됩니다.
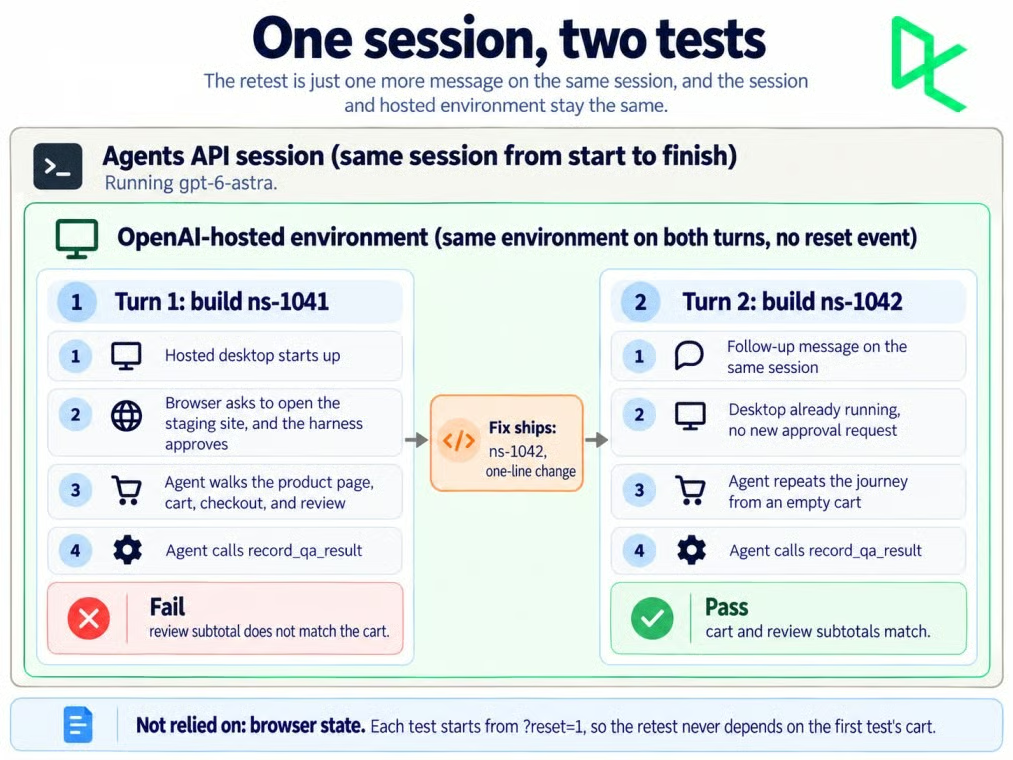
하나의 세션이 두 QA 테스트를 처리했습니다. 이미지: 작성자.
활동과 keep-alive가 1시간 동안 중단되면 호스팅 샌드박스가 삭제될 수 있습니다. agent.session.environment.reset을 주시하고, 각 재테스트는 알려진 상태에서 시작하세요.
예. 재테스트는 장바구니 수량 2와 $48.00, 검토 수량 2와 $48.00을 보고했고, judge()는 실패 항목 없이 통과를 반환했습니다.
브라우저 활동 항목 5개로 38.9초가 걸렸습니다. 첫 테스트는 활동 시작 전 47초 대기 포함 총 96.5초와 7개 항목이었습니다.
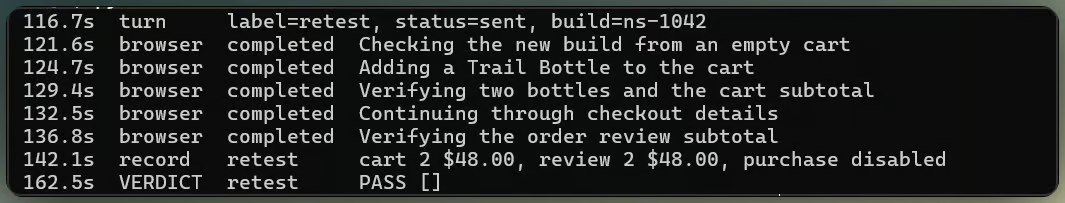
새 승인 없이 재테스트 통과. 이미지: 작성자.
반드시 그렇지는 않습니다. include_screenshots를 설정해도, 첫 테스트는 7개 브라우저 활동에서 2장, 재테스트는 5개 활동에서 2장을 반환했습니다.
일부 항목은 output: null을 반환하므로, 활동마다 그림이 있다고 가정하면 안 됩니다.
이벤트 스트림은 호스팅 브라우저의 연속 비디오 피드가 아니라, 브라우저 활동 항목과 가용할 때의 스크린샷을 반환합니다.
Northstar는 rrweb을 사용해 DOM 변경과 상호작용을 캡처하고 같은 호스트로 전송한 뒤, 아래에서 두 여정을 재생합니다.
두 스테이징 빌드에서 에이전트의 브라우저. 영상: 작성자.
리플레이는 ns-1041에서 수량 2와 $24.00, 이어서 ns-1042에서 $48.00을 보여줍니다. 비활성화된 구매 버튼은 그대로 유지됩니다.
저장소에는 저장된 판정, 브라우저 증거, 세션 세부 정보, 비용, 이벤트 로그를 보는 작은 Streamlit 뷰어도 포함되어 있습니다.
최선 추정 사용량 카운터는 두 테스트 합계 기준의 표준 요금 토큰 추정치로 $0.9469를 산출했습니다.
| 지표 | 테스트 1 (ns-1041) |
재테스트 (ns-1042) |
|---|---|---|
| 입력 토큰 | 255,550 | 223,533 |
| 캐시된 입력 토큰 | 217,041 (84.9%) | 219,449 (98.2%) |
| 출력 토큰 | 982 | 708 |
| 추정 토큰 비용 | $0.6512 | $0.2957 |
| 턴 시간 | 96.5초 | 38.9초 |
| 브라우저 활동 항목 | 7 | 5 |
재테스트는 더 적은 입력 토큰을 사용했고, 그중 98.2%가 프롬프트 캐시에서 왔습니다. 두 테스트 합계 비용은 $0.9469였습니다.
관측 가능성 가이드에 따르면 사용량이 미확정일 때는 null일 수 있고 기록된 수치가 변경될 수 있으므로, 세션을 삭제하기 전에 다시 확인하세요.
테스트 당시 OpenAI 요금 페이지에서의 GPT-6 Astra 표준 요금은 다음과 같았습니다.
| 토큰 유형 | 백만 토큰당 요금 |
|---|---|
| 입력 | $10.00 |
| 캐시된 입력 | $1.00 |
| 캐시 쓰기 | $12.50 |
| 출력 | $50.00 |
272K 롱 컨텍스트 임계값은 요청당 적용됩니다. 두 턴의 입력 합계는 그 이하였으므로, 어느 한 요청도 더 높은 롱 컨텍스트 요금을 발생시키지 않았습니다.
여전히 Agents API 사용량은 최선 추정이며 별도의 캐시 쓰기 카운트를 노출하지 않기 때문에, 최종 청구서를 그대로 재현할 수는 없습니다.
호스팅 샌드박스는 표준 컨테이너 요금으로 별도 청구됩니다. 요금 페이지는 4 GB medium 컨테이너를 20분 세션당 $0.12로 안내하며, 해당 컨테이너 세션은 분 단위로 과금되고 최소 5분이 적용됩니다.
안전은 브라우저가 접근할 수 있는 대상과 페이지가 허용하는 동작에 달려 있습니다.
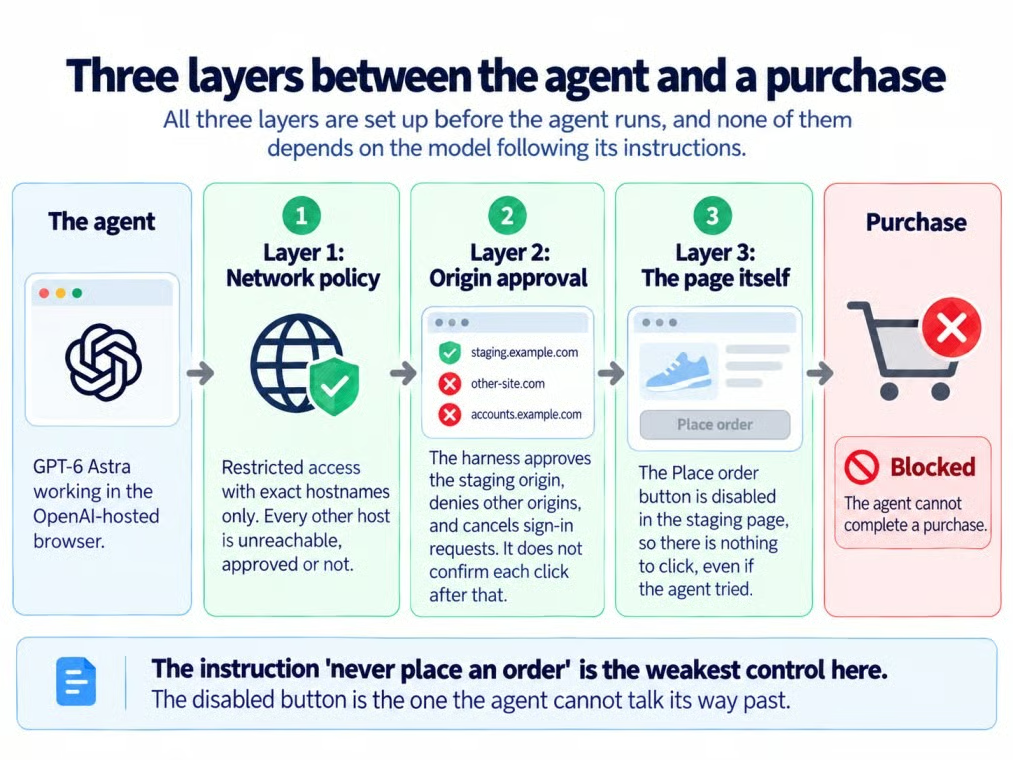
에이전트와 체크아웃 사이의 세 가지 계층. 이미지: 작성자
네트워크 정책은 브라우저가 접근할 수 있는 호스트를 제어하고, 오리진 승인은 각 새로운 오리진을 열 수 있는지를 결정합니다. 둘 다 개별 브라우저 동작을 승인하지는 않습니다.
따라서 northstar-checkout-staging.vercel.app를 승인한다고 해서 각 클릭이 별도로 승인되는 것은 아닙니다.
구매 금지 규칙은 안전 제약이며, purchase_control은 수용 기준으로 판정하기보다 증거로 저장됩니다. Northstar의 비활성화된 "Place order" 버튼이 이를 강제하는 장치입니다.
restricted에서 브라우저는 나열한 호스트명에만 접근할 수 있습니다.
OpenAI 샌드박스 가이드는 와일드카드, 프로토콜, 경로, 포트 없이 정확한 호스트명 1~100개를 허용합니다. CDN, 하위 도메인, 리디렉션 대상은 별도 항목이 필요합니다.
스크린샷과 rrweb 녹화에는 페이지에 표시되는 모든 내용이 포함됩니다. 그래서 Northstar는 가상의 데이터를 사용하고, 로그인이 없으며, 푸터에 녹화를 고지합니다.
레코더는 입력값을 마스킹하지만, 프로덕션 배포에서는 페이지에 맞는 데이터 정책과 마스킹이 여전히 필요합니다.
Agents API는 데이터 레지던시를 미국에만 지원하며, 자체 호스팅 샌드박스를 사용해도 Zero Data Retention(ZDR) 대상이 아닙니다.
필요한 결과와 스크린샷을 저장한 뒤, 세션을 삭제해 스테이징 체크아웃이 유지된 세션 상태로 남지 않게 하세요.
Agents API 세션을 삭제해도 사이트에 저장된 rrweb 녹화는 삭제되지 않습니다. 녹화 정책에 따라 별도로 제거하세요.
Northstar는 장바구니와 검토 소계가 갈라졌을 때 실패했고, 같은 세션에서 수정 후 통과했습니다. 두 판정 모두 모델 요약이 아니라 하니스가 결정했습니다.
이미 알려진 불변 조건에 대해서는 스크립트 기반 회귀 테스트를 유지하고, assertion으로 표현하기 어려운 탐색적 여정에는 목표 기반 브라우저 에이전트를 쓰길 권합니다. 에이전트는 탐색하고, 애플리케이션 코드는 판정합니다.
API 기초는 우리의 Working with the OpenAI API 과정을 추천합니다.
Top DataCamp Courses
강의
트랙
강의